 网硕互联帮助中心
一、项目介绍
摘 要
随着互联网的普及和电子邮件成为人们日常通信的重要工具,电子邮箱中的垃圾邮件问题日益严重,对用户的正常使用造成了极大的干扰。因此,对电子邮箱进行有效的分类,特别是识别和过滤垃圾邮件,成为了一个亟待解决的问题。基于Python的电子邮箱分类系统,利用Flask框架和TensorFlow深度学习库,可以实现对电子邮箱内容的自动分类,提高邮件处理的效率和准确性。本文的主要内容包括:首先,分析了电子邮箱分类的背景和意义,阐述了垃圾邮件对用户和社会的影响,以及自动分类系统的必要性。接着,详细描述了系统的功能模块设计,包括邮件数据预处理、特征提取、模型训练、邮件分类等模块。然后,介绍了系统的技术架构和实现细节,包括Flask框架的使用、TensorFlow模型的构建、邮件数据的处理等。最后,通过系统测试和实验结果,验证了系统的实用性和有效性。
本项目采取的技术路线是:采用Flask框架作为Web应用开发工具,构建系统的前端界面和后端逻辑;使用TensorFlow深度学习库构建邮件分类模型,实现邮件的自动分类;结合自然语言处理技术进行邮件数据的预处理和特征提取。具体情况是:首先,通过Flask框架设计系统的Web界面,提供用户友好的操作体验。然后,利用TensorFlow构建卷积神经网络(CNN)模型,对邮件数据进行训练和分类。在模型训练过程中,采用交叉验证和网格搜索等方法优化模型参数,提高分类准确率。最后,结合自然语言处理技术对邮件内容进行预处理,提取文本特征,输入到训练好的模型中进行分类。系统的实现不仅能提高电子邮箱分类的准确性和效率,也为邮件处理的自动化和智能化提供了有力的技术支持。
关键字:Flask框架;卷积神经网络(CNN);电子邮箱分类系统;Python;TensorFlow
课题背景与意义
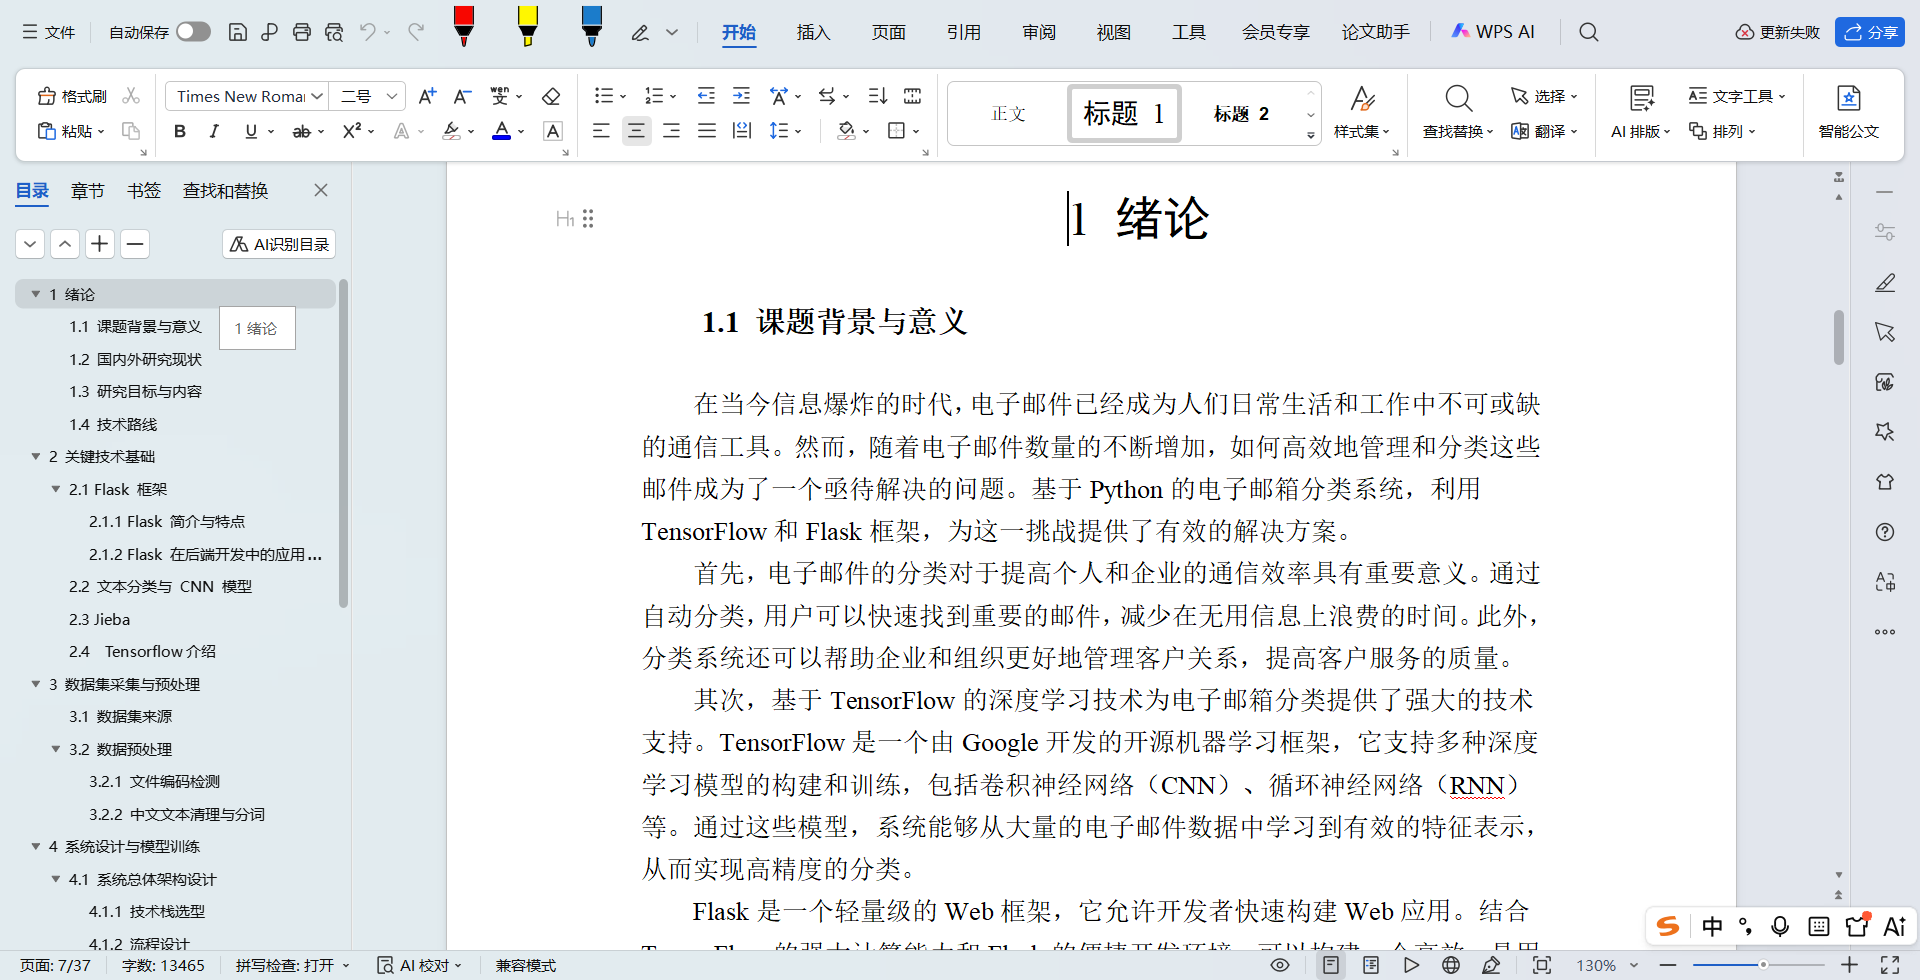
在当今信息爆炸的时代,电子邮件已经成为人们日常生活和工作中不可或缺的通信工具。然而,随着电子邮件数量的不断增加,如何高效地管理和分类这些邮件成为了一个亟待解决的问题。基于Python的电子邮箱分类系统,利用TensorFlow和Flask框架,为这一挑战提供了有效的解决方案。
首先,电子邮件的分类对于提高个人和企业的通信效率具有重要意义。通过自动分类,用户可以快速找到重要的邮件,减少在无用信息上浪费的时间。此外,分类系统还可以帮助企业和组织更好地管理客户关系,提高客户服务的质量。
其次,基于TensorFlow的深度学习技术为电子邮箱分类提供了强大的技术支持。TensorFlow是一个由Google开发的开源机器学习框架,它支持多种深度学习模型的构建和训练,包括卷积神经网络(CNN)、循环神经网络(RNN)等。通过这些模型,系统能够从大量的电子邮件数据中学习到有效的特征表示,从而实现高精度的分类。
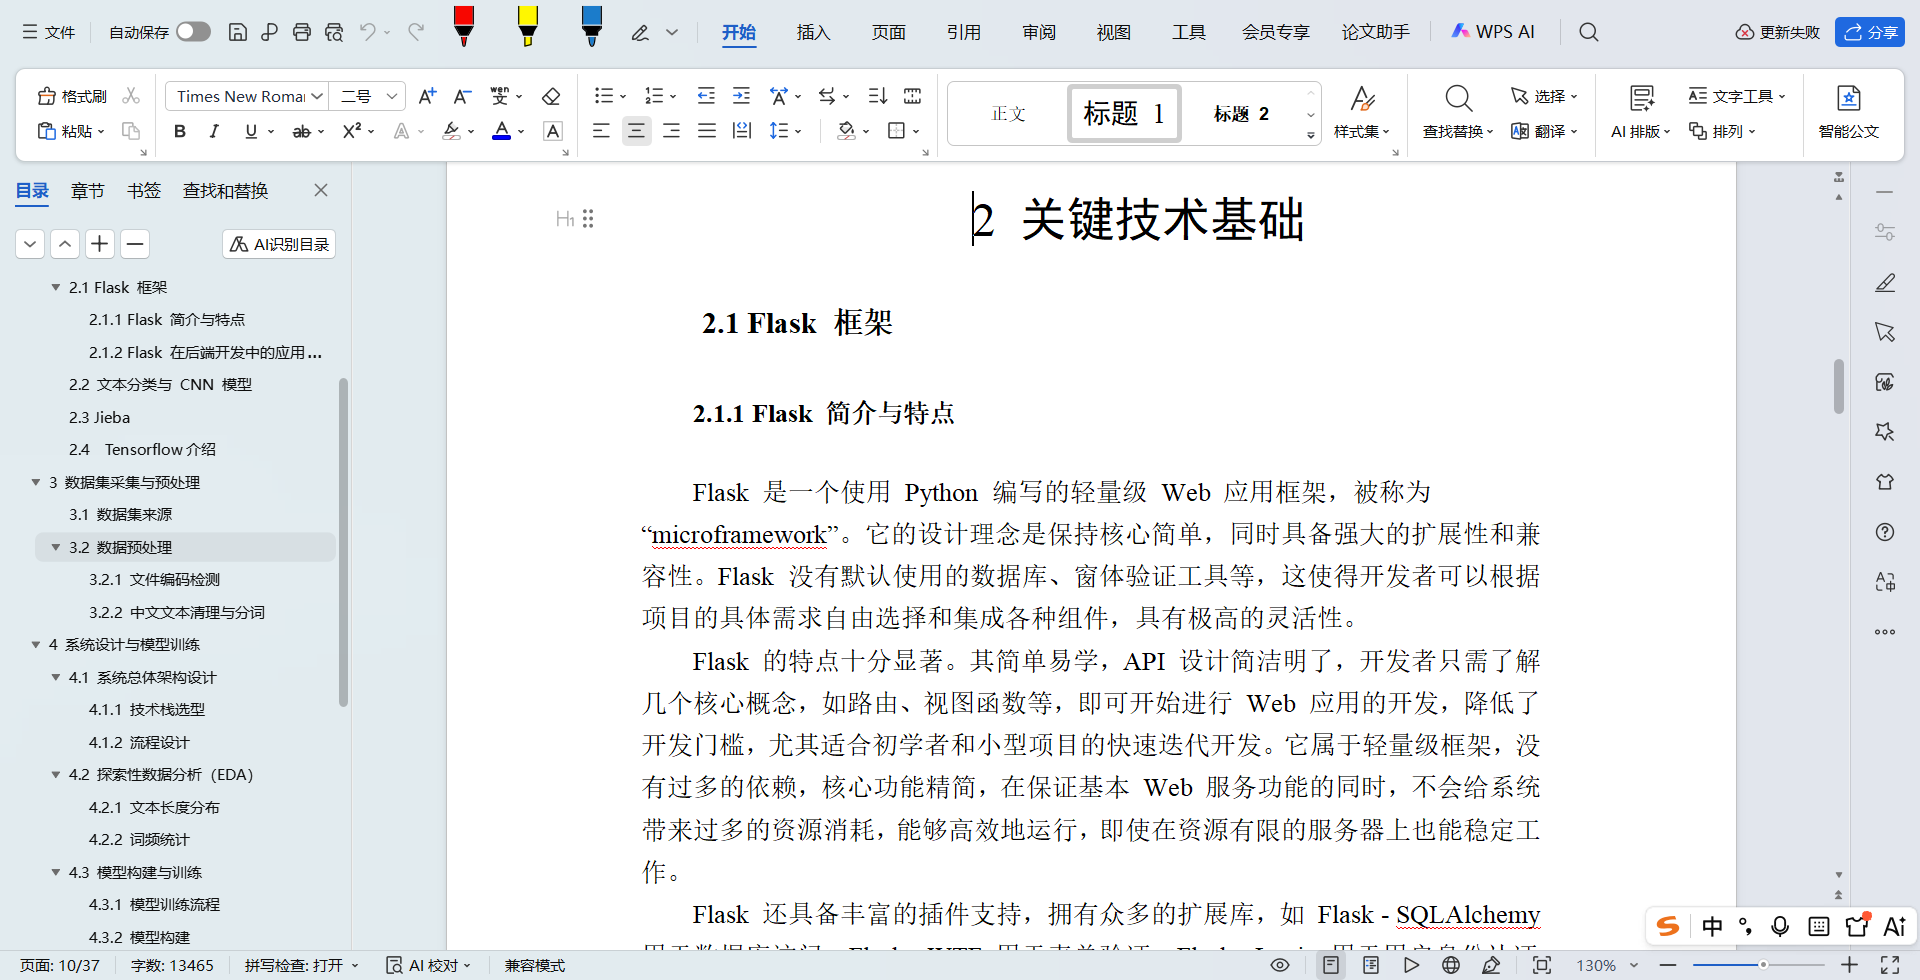
Flask是一个轻量级的Web框架,它允许开发者快速构建Web应用。结合TensorFlow的强大计算能力和Flask的便捷开发环境,可以构建一个高效、易用的电子邮箱分类系统。用户可以通过Web界面方便地上传和分类电子邮件,系统会自动处理并返回分类结果。
此外,该系统的研究和开发对于推动人工智能技术在通信领域的应用具有重要意义。通过不断优化模型和算法,可以提高分类的准确性和效率,进一步推动智能通信技术的发展。同时,该系统的研究也为其他文本分类任务提供了参考和借鉴,具有重要的学术价值。
综上所述,该系统结合TensorFlow和Flask框架,具有重要的实际应用价值和学术研究意义。它不仅能够提高电子邮件的管理效率,还能推动人工智能技术在通信领域的应用和发展。
研究目标与内容
本毕设项目旨在开发一个高效、准确的分类系统,能够自动识别和分类电子邮箱为垃圾邮件或正常邮件。为了实现这一目标,将利用TensorFlow构建深度学习模型,并结合Flask框架开发一个易于使用的Web应用程序。
研究内容主要包括以下几个方面:
数据收集与预处理:收集大量的电子邮箱数据集,并进行清洗和预处理,包括去除无用信息、分词、词嵌入等,为模型训练提供高质量的数据。
特征提取:利用深度学习模型自动提取文本特征,特别是使用卷积神经网络(CNN)来捕捉局部语义信息。
模型训练与优化:基于TensorFlow构建和训练文本分类模型,通过调整超参数和学习率等优化模型性能。
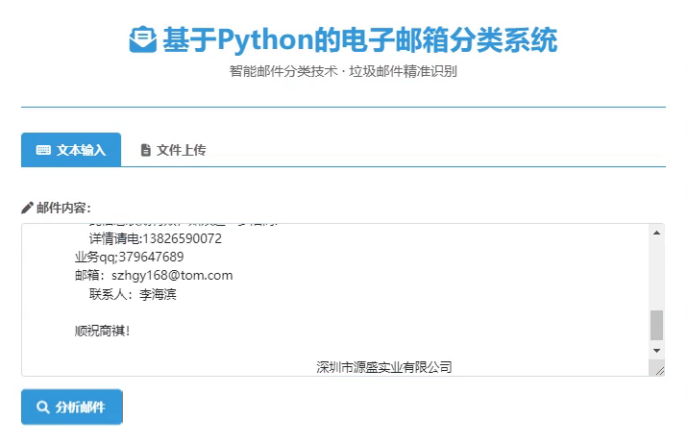
系统实现:使用Flask框架开发一个Web应用程序,实现电子邮箱的自动分类功能,并提供用户友好的界面。
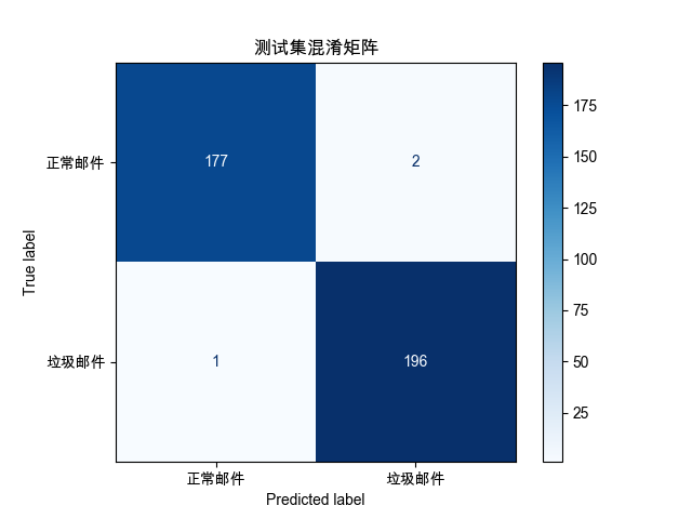
测试与评估:利用测试数据集评估模型的性能,包括准确率、召回率、F1分数等指标,并根据评估结果进行模型优化。
通过这些研究内容,期望能够开发出一个既高效又准确的电子邮箱分类系统,为用户节省时间,提高通信效率。同时,该系统的研究也将为自然语言处理领域提供有价值的参考和借鉴。
Jieba
Jieba是一款非常流行的中文分词工具,它基于Python语言开发,支持多种分词模式,包括精确模式、全模式、搜索引擎模式等,能够满足不同场景下的中文分词需求。Jieba的分词效果优异,广泛应用于自然语言处理领域,如文本挖掘、情感分析、机器翻译等。
Jieba的分词原理主要基于Trie树和图扫描算法。Trie树是一种用于快速检索的树形数据结构,Jieba利用Trie树来存储字典中的词汇,从而实现快速匹配。图扫描算法则用于处理中文中的歧义切分问题,通过构建一个词图,然后在词图中寻找最优路径来实现分词。
除了基本的分词功能外,Jieba还提供了词性标注、关键词提取、自定义词典等功能。词性标注可以对分词结果进行词性分类,如名词、动词、形容词等,这对于理解文本的语法结构和语义信息非常有帮助。关键词提取则可以从文本中提取出重要的词汇,用于文本摘要、信息检索等应用。自定义词典功能允许用户添加自己的词汇到Jieba的字典中,从而提高分词的准确性和适应性。
Jieba的安装和使用非常简单,可以通过pip命令轻松安装,并且只需要几行代码就可以实现基本的分词功能。Jieba的文档也非常丰富,提供了详细的API说明和使用示例,方便用户快速上手。
总的来说,Jieba是一款功能强大、易于使用的中文分词工具,它为中文自然语言处理领域的研究和应用提供了重要的支持。
Tensorflow介绍
TensorFlow是一个由Google开发的开源机器学习框架,它支持多种深度学习模型的构建和训练,包括卷积神经网络(CNN)、循环神经网络(RNN)等。在基于Python的电子邮箱分类任务中,TensorFlow提供了一个灵活、高效的平台,用于构建和训练文本分类模型。
TensorFlow的核心特点是它的计算图(Graph)和会话(Session)机制。计算图是一个由节点和边组成的图结构,节点表示数学运算,边表示数据流。会话则负责执行计算图中的运算。这种设计使得TensorFlow能够有效地管理计算资源,支持分布式计算和GPU加速,从而提高模型的训练效率。
在电子邮箱分类任务中,TensorFlow可以用来构建TextCNN模型。TextCNN模型通过词嵌入层将文本转换为数值向量,然后利用卷积层和池化层提取特征,最后通过全连接层和Softmax激活函数进行分类。TensorFlow提供了丰富的API,支持用户自定义模型结构和训练过程,同时也提供了一些预训练模型和优化算法,方便用户快速搭建和训练模型。
TensorFlow的另一个重要特点是它的可扩展性和灵活性。它支持多种编程语言,包括Python、C++等,并且可以方便地与其他Python库(如NumPy、Pandas等)集成。此外,TensorFlow还提供了TensorBoard等可视化工具,方便用户监控模型的训练过程和性能表现。
总的来说,TensorFlow在基于Python的电子邮箱分类任务中发挥了重要作用。它提供了一个强大的机器学习平台,支持用户构建和训练复杂的深度学习模型,同时也提供了丰富的工具和API,方便用户进行模型开发和优化。
数据集来源
在基于Python的电子邮箱分类任务中,数据集的构建是模型训练的基础。通过将垃圾邮件与正常邮件的文本数据合并,构建了一个综合的数据集。首先,使用Tokenizer对文本数据进行词汇表的构建,这一步骤将文本中的单词转换为数字索引,形成词汇表。接着,利用texts_to_sequences()方法将文本数据转化为数字序列,每个单词对应词汇表中的一个数字。由于邮件的长度不一,使用pad_sequences()对序列进行填充,确保每个序列具有相同的长度,以便于后续的模型处理。
具体实现中,定义了一个名为serialization_numeralization的函数,该函数接受垃圾邮件和正常邮件的数据作为输入,并返回填充后的数字序列。在函数内部,首先将垃圾邮件和正常邮件分别转换为数字序列,然后对序列进行填充,使其长度一致。填充后的序列将作为模型的输入数据,用于训练和测试。
通过这样的数据集构建过程,能够将文本数据转换为模型可以处理的数字形式,并且确保数据的一致性和可处理性。这一步骤对于后续的模型训练至关重要,因为它直接影响到模型的学习效果和分类性能。在构建数据集的过程中,还进行了数据清洗和预处理,包括去除停用词、标点符号和特殊字符等,以提高数据的质量和模型的准确性。
总之,通过将垃圾邮件与正常邮件的文本数据合并,并使用Tokenizer和pad_sequences等方法进行数据转换和填充,构建了一个适合模型训练的数据集。这一过程不仅确保了数据的一致性和可处理性,还为后续的模型训练和优化提供了坚实的基础。
def serialization_numeralization(spam_data, normal_data):
x_train_spam = tokenizer.texts_to_sequences(spam_data)
x_train_normal = tokenizer.texts_to_sequences(normal_data)
x_train_spam_pad = pad_sequences(x_train_spam, max_sequence_length)
x_train_normal_pad = pad_sequences(x_train_normal, max_sequence_length)
二、文档介绍

三、项目设计与实现
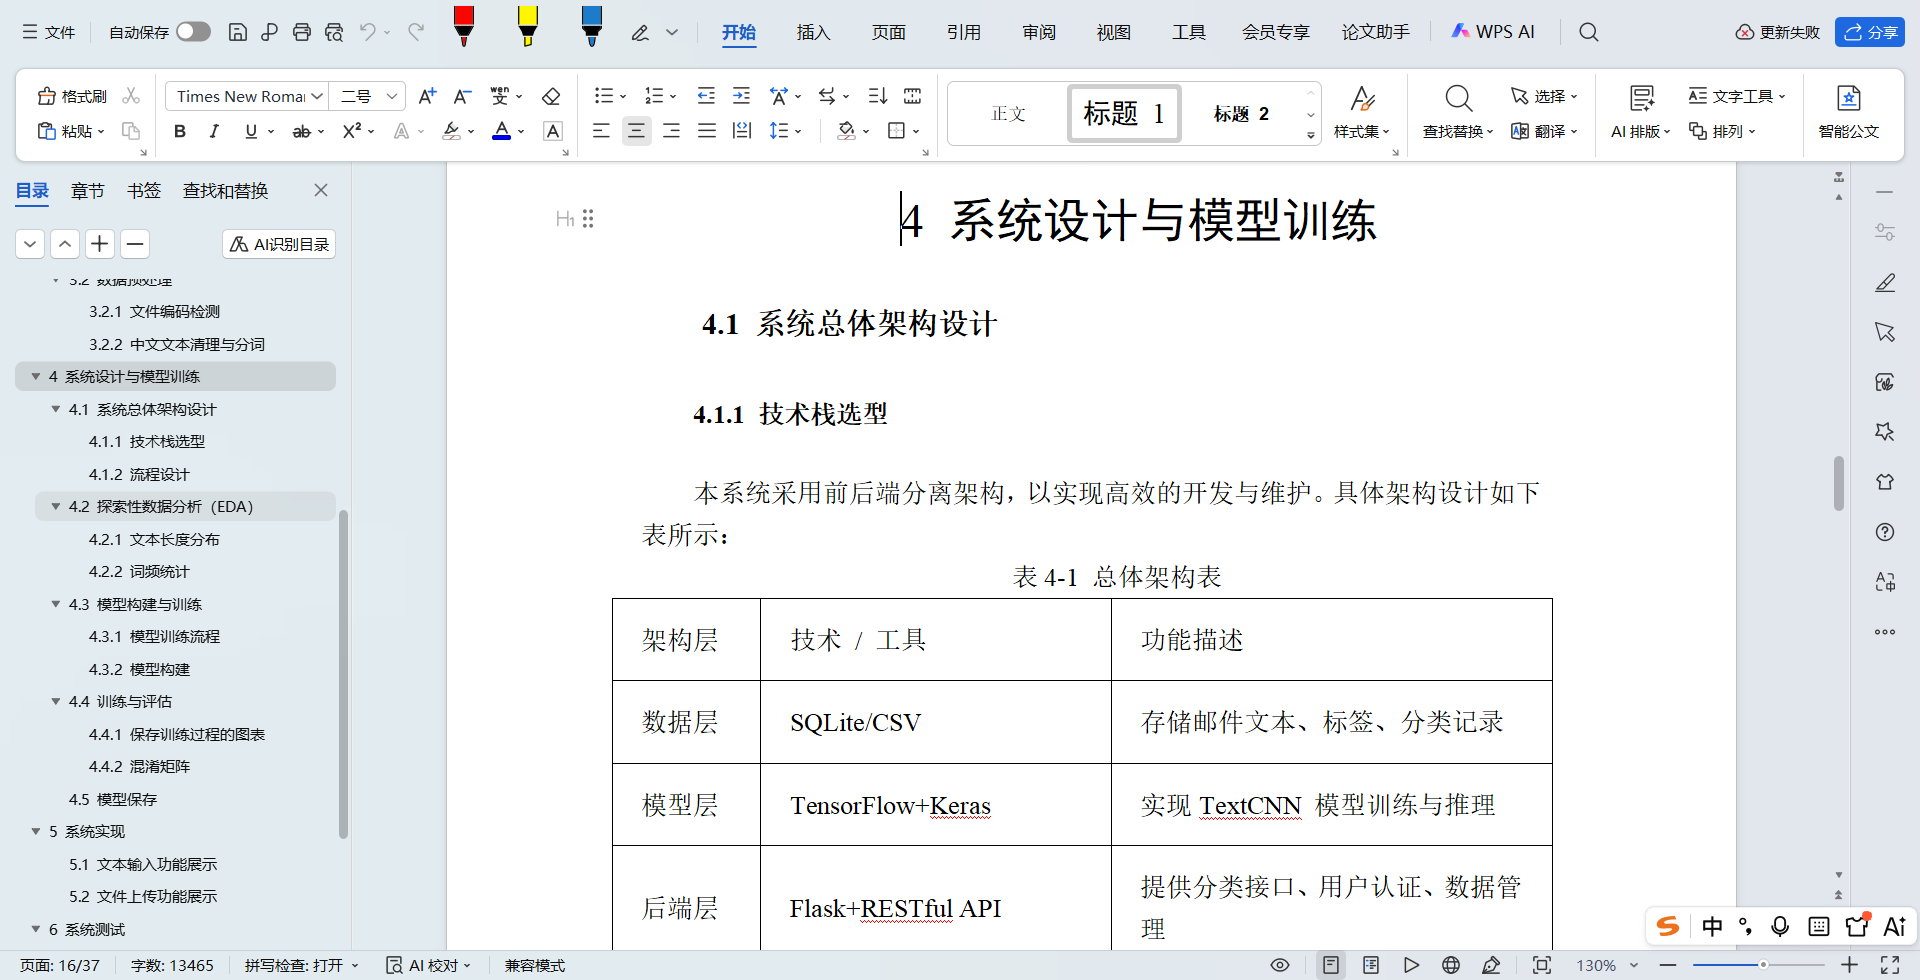
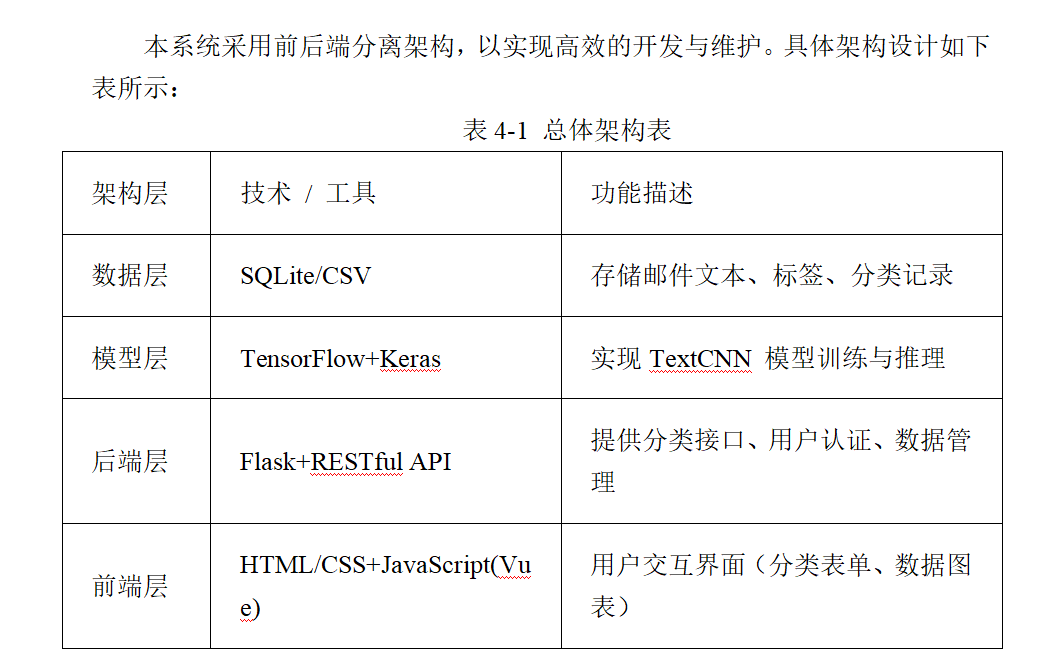
技术栈选型
 文本长度分布
的分析。通过统计垃圾邮件和正常邮件中单词数量的分布,并绘制直方图,可以直观地观察到两类邮件在文本长度上的差异。例如,垃圾邮件可能倾向于使用更短的文本,以便快速传达信息并避免被察觉;而正常邮件则可能包含更多的细节和上下文信息,因此文本长度可能更长。通过绘制直方图,可以清晰地看到这种差异,并据此对模型进行调整。例如,如果发现垃圾邮件的文本长度普遍较短,可以在模型中加入对文本长度的考虑,使其在分类时更加关注这一特征。此外,文本长度分布的分析还可以帮助识别一些异常值,这些异常值可能是由于数据收集或预处理过程中的错误导致的,需要进行进一步的检查和处理。通过分析文本长度分布,可以更好地理解数据的特征,为后续的模型训练和优化提供有价值的参考信息。例如,如果发现垃圾邮件的文本长度普遍较短,可以在模型中加入对文本长度的考虑,使其在分类时更加关注这一特征。此外,文本长度分布的分析还可以识别一些异常值,这些异常值可能是由于数据收集或预处理过程中的错误导致的,需要进行进一步的检查和处理。通过分析文本长度分布,可以更好地理解数据的特征,为后续的模型训练和优化提供有价值的参考信息。
词频统计
词频统计的分析。通过统计并可视化垃圾邮件和正常邮件中最常见的词汇,可以深入了解邮件内容的特点。例如,垃圾邮件可能频繁使用一些特定的词汇,如“免费”、“立即购买”等,以吸引收件人的注意;而正常邮件则可能使用更加多样化和复杂的词汇。通过可视化这些词汇的频率,可以发现一些有趣的现象和规律。例如,某些词汇可能只在垃圾邮件中出现,而在正常邮件中几乎不出现,这些词汇就可以作为区分两类邮件的重要特征。此外,词频统计还可以识别一些常见的停用词,这些词在不同类型的邮件中都频繁出现,但对分类任务并没有太大的帮助,因此在预处理阶段可以考虑去除这些停用词,以减少噪声,提高模型的性能。通过词频统计的分析,可以更好地理解邮件内容的特点,为后续的模型训练和优化提供有价值的参考信息。例如,如果发现某些词汇在垃圾邮件中频繁出现,而在正常邮件中很少出现,可以在模型中加入对这些词汇的关注,使其在分类时更加关注这些特征。此外,词频统计还可以识别一些常见的停用词,这些词在不同类型的邮件中都频繁出现,但对分类任务并没有太大的帮助,因此在预处理阶段可以考虑去除这些停用词,以减少噪声,提高模型的性能。通过词频统计的分析,可以更好地理解邮件内容的特点,为后续的模型训练和优化提供有价值的参考信息。
综上所述,探索性数据分析(EDA)在基于Python的电子邮箱分类任务中发挥着重要作用。通过分析文本长度分布和词频等特征,可以深入了解数据的特点和规律,为后续的模型训练和优化提供有价值的参考信息。这些分析不仅可以帮助设计出更有效的分类模型,还可以提高对数据的质量和可靠性的信心,从而确保最终的分类结果既准确又可靠。
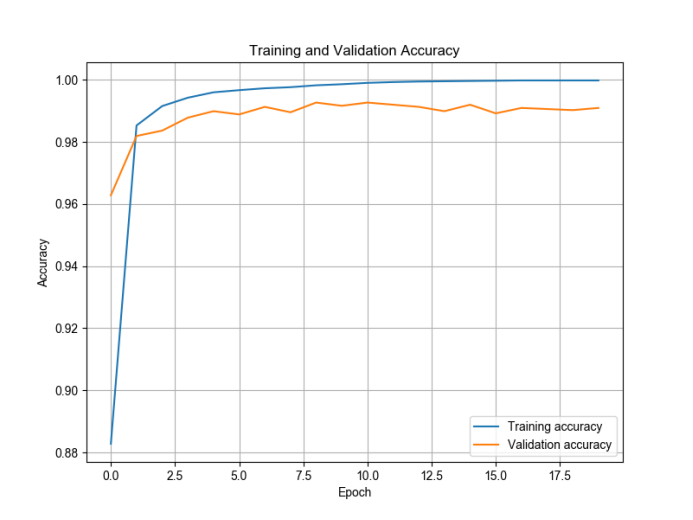
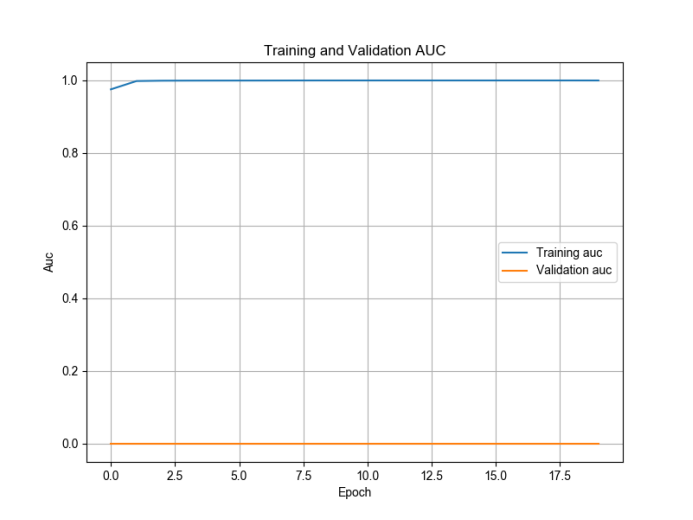
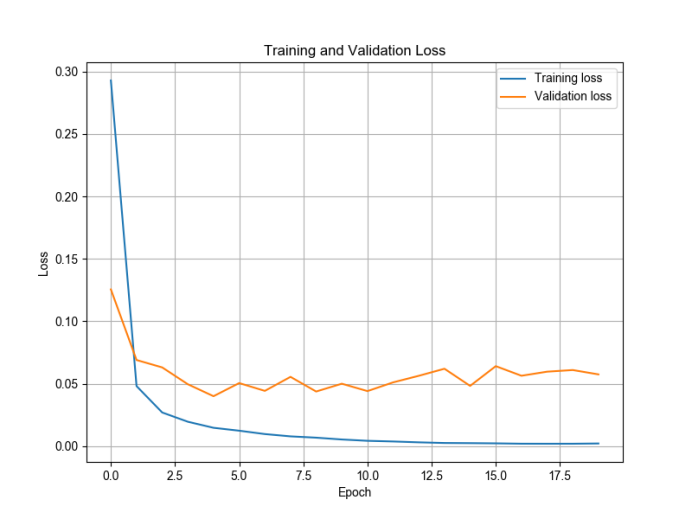
def plot_metrics(history):
metrics = ['accuracy', 'loss', 'precision', 'recall', 'f1_score', 'auc']
titles = ['Training and Validation Accuracy', 'Training and Validation Loss', 'Training and Validation Precision', 'Training and Validation Recall', 'Training and Validation F1 Score', 'Training and Validation AUC']
for metric, title in zip(metrics, titles):
plt.figure(figsize=(8, 6))
plt.plot(history.history[metric], label='Training ' + metric)
plt.plot(history.history['val_' + metric], label='Validation ' + metric)
plt.savefig(f'./web/src/assets/algorithm/train/{metric}_plot.png')
plt.close()
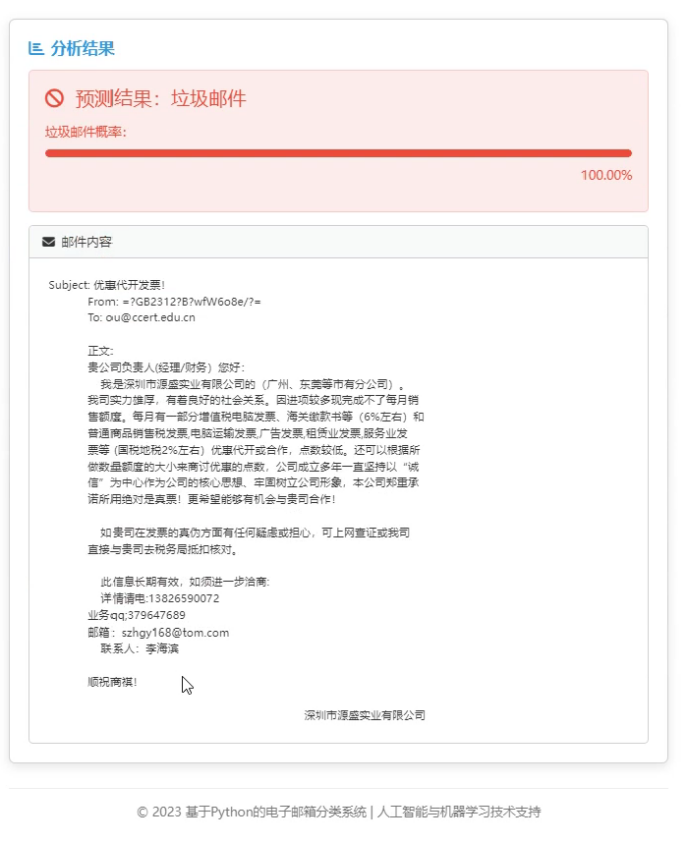
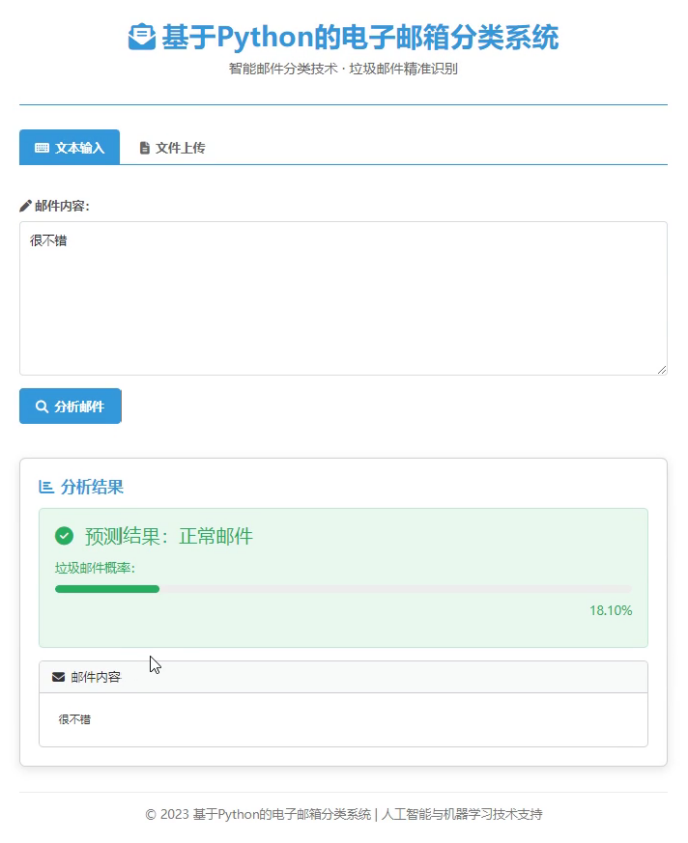
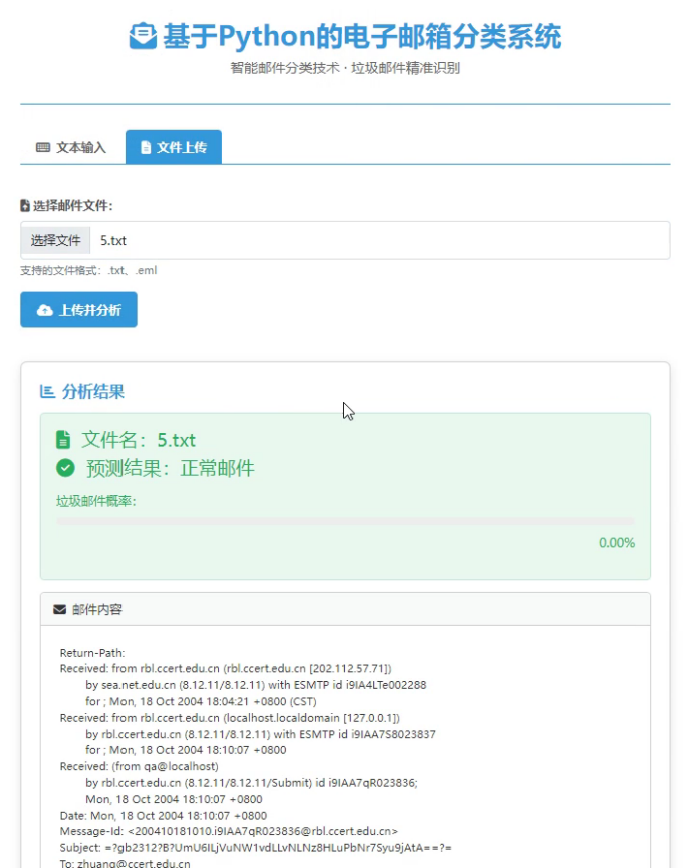
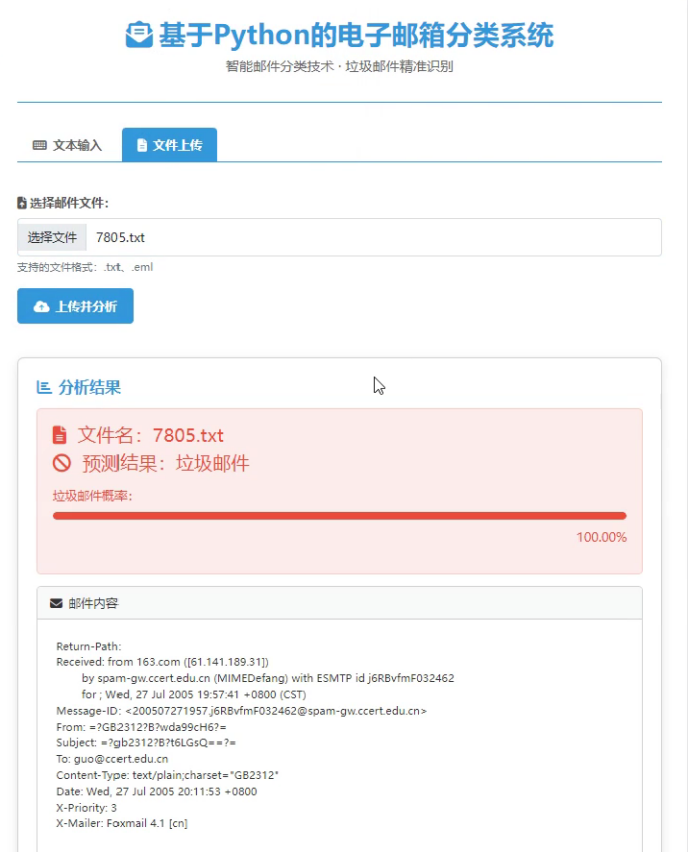
本项目使用Python进行开发,Flask 框架进行搭建,实现了电子邮箱分类系统完整功能。该面向对象的设计语言具有良好的可移植性和可重复性。在性能和安全方面,也具有良好的表现。本电子邮箱的分类投入使用后,可以满足用户电子邮箱分类管理的需求,也使得更多的用户参与进来。系统使用的技术可以完全满足本系统的开发需求,本人通过对技术的探索和动手实践也提升了自己的编程能力,并在此过程也查阅了许多查看资料,更进一步提升了编程能力和理论基础。
在需求分析阶段,通过功能性需求和非功能性需求进行介绍,并采用流程设计图进行铺垫,为系统的开发提供了基础保障。在设计和实现阶段,通过整体的框架设计,详细的功能设计以及模型训练,然后通过编程得以功能模块的实现,最后通过测试来完成系统的最后阶段。完成系统后,进行服务器部署,客户端只需要通过浏览器访问即可。总之,本系统从理论基础到设计、模型训练、实现和测试,展现了整个软件开发的过程。系统的投入具有一定的实际运用价值,可以广泛的进行推广。
本系统是本人第一次开发尝试,虽然付出了一定的精力,但是也存在一些问题,主要表现在以下几个方面。
系统的界面设计较为简单,颜色搭配欠佳,没有经过专业的美工实践,所以界面的美观需要进一步提高。
最后系统目前实现了基于PC端的搭建,但是目前逐渐向移动开发方面发展,所以后期需要设计响应式界面风格来适应多平台的使用。



评论前必须登录!
注册