 网硕互联帮助中心
【深度学习数据集推荐】青光眼检测数据集,包含眼底图像与650条标注记录,附Python代码及毕设题目
今天分享一个适合医学影像分析、深度学习图像分类、计算机视觉和计算机毕业设计的公开数据集
该数据集主要用于青光眼相关影像识别研究,包含ACRIMA、ORIGA等数据目录,以及记录图像名称、视杯盘比和青光眼标签的CSV文件。
对于计算机、人工智能、医学信息工程、生物医学工程等专业的同学,可以围绕青光眼图像分类、迁移学习、多模型性能对比、视杯盘比辅助分析和医学影像识别系统开展毕业设计。
一、数据集基本介绍
1.1 数据集概况
| 中文名称 | 青光眼检测数据集 |
| 数据大小 | 454.78MB |
| 页面文件总数 | 2,662个 |
| 数据目录 | ACRIMA、Fundus_Train_Val_Data、ORIGA |
| 标签文件 | glaucoma.csv |
| CSV记录数量 | 650条 |
| CSV字段数量 | 5列 |
| 主要任务 | 青光眼二分类 |
| 扩展任务 | ExpCDR指标分析、模型对比 |
| 推荐算法 | ResNet、DenseNet、EfficientNet、MobileNet |
1.2 什么是青光眼?
青光眼是一组可能造成视神经损伤的眼部疾病,是不可逆视力损伤的重要原因之一。
在眼底影像分析中,视盘、视杯等结构可以为青光眼风险评估提供一定参考。
深度学习模型可以学习眼底图像中的视觉特征,开展青光眼相关分类研究。
但需要强调,图像分类结果不能直接替代临床青光眼诊断。真实诊断还需要结合眼压、视野检查、视神经评估等临床信息。

二、数据集包含哪些内容?
根据提供的Kaggle目录信息,主要包含以下内容:
Detection/
├── ACRIMA/
├── Fundus_Train_Val_Data/
├── ORIGA/
└── glaucoma.csv
不同目录可能具有不同的图像组织方式、标签形式和数据来源。
因此,建议先完成目录检查,再确定采用哪个子集进行训练。
2.1 glaucoma.csv字段说明
CSV包含5个字段:
| Filename | 图像文件名称 | 关联图像 |
| ExpCDR | 专家评估的杯盘比相关数值 | 辅助特征分析 |
| Eye | 左眼或右眼标识 | 数据统计 |
| Set | 数据集分组标识 | 数据分组分析 |
| Glaucoma | 青光眼标签 | 分类目标 |
例如:
| 001.jpg | 0.7097 | OD | A | 0 |
| 002.jpg | 0.6953 | OS | A | 0 |
| 036.jpg | 0.5097 | OD | A | 1 |
| 041.jpg | 0.6131 | OD | B | 1 |
以上记录来自提供的数据预览。
其中:
- OD:右眼。
- OS:左眼。
- ExpCDR:视杯盘比相关指标。
- Glaucoma:二分类标签,0和1。
这里的Set字段出现A、B两种取值,但仅凭预览不能确认其具体划分含义,需要查看原始数据说明。
三、青光眼标签分布
根据glaucoma.csv提供的统计:
| 0 | 非青光眼 | 482 | 74.15% |
| 1 | 青光眼 | 168 | 25.85% |
| 合计 | 650 | 100% |
可以看出,非青光眼样本数量明显多于青光眼样本。
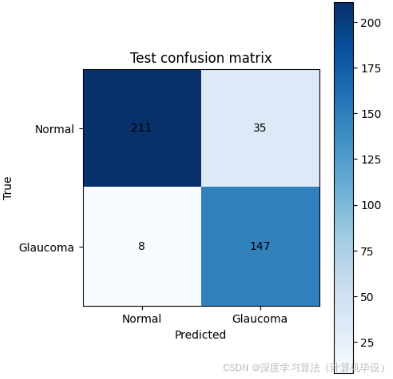
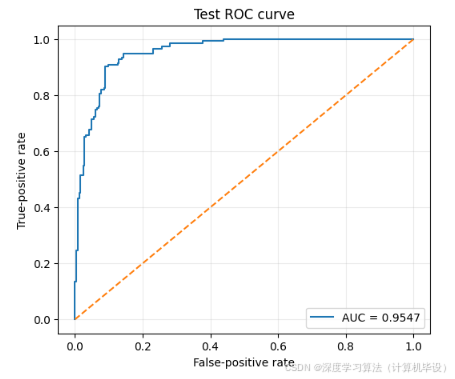
因此,训练模型时不能只关注Accuracy,还应重点评价青光眼类别的Recall、Precision、F1-score和ROC-AUC。
尤其是医学影像分类任务,漏检与误检的实际影响不同,需要结合研究目标合理选择评价指标。
四、ExpCDR指标有什么作用?
ExpCDR是这份数据集比较有研究价值的字段。
CDR通常指杯盘比(Cup-to-Disc Ratio),用于描述视杯与视盘之间的相对比例。
数据预览中的ExpCDR取值大约分布在0.16至0.96之间。
可以围绕该指标开展以下分析:
需要注意:
ExpCDR不能单独作为青光眼诊断的绝对标准。
此外,CSV中已经提供的是专家评估数值,不等于数据集提供了视盘、视杯的像素级分割标注。
如果希望训练U-Net自动分割视盘和视杯,需要额外确认是否有可用分割掩膜。
五、适合使用哪些深度学习算法?
| 自定义CNN | 结构简单 | 基础分类模型 |
| ResNet18 | 参数量适中 | 基线模型 |
| ResNet50 | 特征提取能力较强 | 模型对比 |
| DenseNet121 | 特征复用充分 | 医学影像分类对比 |
| EfficientNet-B0 | 兼顾性能和模型规模 | 优化实验 |
| MobileNetV3 | 轻量化网络 | 部署实验 |
| ViT | Transformer视觉模型 | 扩展研究 |
本科毕业设计建议采用:
ResNet18作为基线,DenseNet121和EfficientNet-B0作为对比模型。
如果希望增加研究内容,可以进一步研究类别不平衡处理、数据增强、注意力机制以及Grad-CAM可解释性分析。
六、使用该数据集可以做哪些毕业设计?
推荐以下8个方向:
| 1 | 基于ResNet的青光眼眼底图像识别系统设计与实现 | ResNet18 | ★★★ |
| 2 | 基于DenseNet的青光眼眼底图像分类研究 | DenseNet121 | ★★★ |
| 3 | 基于迁移学习的青光眼图像分类模型对比研究 | ResNet、EfficientNet | ★★★ |
| 4 | 基于注意力机制的青光眼眼底图像识别研究 | ResNet+CBAM | ★★★★ |
| 5 | 基于MobileNetV3的轻量化青光眼图像分类研究 | MobileNetV3 | ★★★★ |
| 6 | 基于Grad-CAM的青光眼分类模型可解释性研究 | ResNet+Grad-CAM | ★★★★ |
| 7 | 融合视杯盘比特征的青光眼辅助分类方法研究 | CNN+MLP | ★★★★ |
| 8 | 基于深度学习的青光眼眼底图像分析与可视化系统 | PyTorch+Flask+Vue | ★★★ |
推荐题目1:基于ResNet的青光眼眼底图像识别系统设计与实现
推荐指数:★★★★★
适合本科计算机、软件工程和人工智能专业。
主要研究内容:
最终实现上传眼底图片,系统输出模型预测类别、分类置信度及可视化结果。
推荐题目2:基于注意力机制的青光眼眼底图像分类研究
推荐指数:★★★★☆
如果希望增加算法研究内容,可以考虑这个方向。
研究目标:
在ResNet模型中加入注意力模块,研究不同特征提取方式对青光眼图像分类效果的影响。
实验设计:
| Baseline | ResNet18 |
| 实验1 | ResNet18+SE |
| 实验2 | ResNet18+CBAM |
| 实验3 | ResNet18+ECA |
重点比较Accuracy、Recall、F1-score和ROC-AUC。
推荐题目3:融合视杯盘比特征的青光眼辅助分类方法研究
推荐指数:★★★★★
这个方向可以利用数据集中提供的ExpCDR字段,区别于普通的图像分类项目。
研究目标:
结合眼底图像特征和ExpCDR数值,构建多模态特征融合分类模型。
技术流程:
眼底图像 ──→ ResNet ──→ 图像特征 ──┐
├──→ 特征融合 ──→ 二分类
ExpCDR数值 ──→ MLP ──→ 数值特征 ───┘
推荐对比实验:
| 实验1 | 仅使用ExpCDR+逻辑回归 |
| 实验2 | 仅使用眼底图像+ResNet |
| 实验3 | 图像特征+ExpCDR融合 |
| 实验4 | 图像特征+ExpCDR+注意力模块 |
需要注意,融合模型依赖ExpCDR作为额外输入。如果实际系统没有专家提供的ExpCDR数值,就不能直接使用这一融合模型完成预测,除非另行开发可靠的杯盘比估计方法。
七、Python代码:分析CSV标签分布
首先对glaucoma.csv进行基础统计。
7.1 安装依赖
pip install pandas numpy matplotlib seaborn scikit-learn
7.2 读取数据
import pandas as pd
df = pd.read_csv("glaucoma.csv")
print("数据形状:", df.shape)
print(df.head())
print("\\n缺失值:")
print(df.isnull().sum())
print("\\n标签分布:")
print(df["Glaucoma"].value_counts())
print("\\nExpCDR统计:")
print(df["ExpCDR"].describe())
7.3 可视化青光眼标签分布
import matplotlib.pyplot as plt
counts = df["Glaucoma"].value_counts().sort_index()
plt.figure(figsize=(6, 4))
plt.bar(
["Non-Glaucoma", "Glaucoma"],
[counts.get(0, 0), counts.get(1, 0)]
)
plt.xlabel("Class")
plt.ylabel("Count")
plt.title("Glaucoma Class Distribution")
plt.tight_layout()
plt.show()
7.4 ExpCDR与青光眼标签分析
import seaborn as sns
import matplotlib.pyplot as plt
sns.boxplot(
data=df,
x="Glaucoma",
y="ExpCDR"
)
plt.title("ExpCDR by Glaucoma Label")
plt.xlabel("Glaucoma")
plt.ylabel("ExpCDR")
plt.show()
通过箱线图可以观察不同类别的ExpCDR分布差异。
但这种差异只能说明数据中的统计关联,不能直接证明因果关系或临床诊断价值。
八、Python代码:使用ExpCDR建立机器学习分类基线
除了图像分类,还可以先利用CSV中的数值特征构建一个简单的机器学习模型。
这里使用Logistic Regression。
import pandas as pd
from sklearn.model_selection import train_test_split
from sklearn.preprocessing import StandardScaler
from sklearn.linear_model import LogisticRegression
from sklearn.pipeline import Pipeline
from sklearn.metrics import classification_report, roc_auc_score
df = pd.read_csv("glaucoma.csv")
df = df.dropna(
subset=["ExpCDR", "Glaucoma"]
)
X = df[["ExpCDR"]]
y = df["Glaucoma"].astype(int)
X_train, X_test, y_train, y_test = train_test_split(
X,
y,
test_size=0.2,
random_state=42,
stratify=y
)
model = Pipeline([
("scaler", StandardScaler()),
("classifier", LogisticRegression(
max_iter=1000,
class_weight="balanced"
))
])
model.fit(X_train, y_train)
y_pred = model.predict(X_test)
y_prob = model.predict_proba(X_test)[:, 1]
print(classification_report(
y_test,
y_pred,
digits=4,
zero_division=0
))
print("ROC-AUC:", roc_auc_score(y_test, y_prob))
这个实验可以作为后续深度学习图像分类模型的辅助对照。
但需要注意,如果同一受试者存在双眼数据,应尽可能按患者分组划分,而不是直接随机划分记录。当前CSV预览未提供明确的患者ID,正式研究需要核对数据来源和关联信息。
九、Python代码:ResNet18青光眼图像分类训练
对于图像分类,可以使用PyTorch中的ResNet18。
但由于数据集包含多个目录,首先需要将图片与对应标签匹配。
以下示例假设已经根据原始标签整理为:
Project/
├── dataset/
│ ├── train/
│ │ ├── normal/
│ │ └── glaucoma/
│ ├── val/
│ │ ├── normal/
│ │ └── glaucoma/
│ └── test/
│ ├── normal/
│ └── glaucoma/
└── train.py
这里的normal和glaucoma是整理后的示例目录名称,并非断言原始Kaggle数据就是这一结构。
9.1 安装依赖
pip install torch torchvision scikit-learn pillow
9.2 ResNet18训练代码
import copy
import torch
import torch.nn as nn
from torchvision import datasets, transforms, models
from torch.utils.data import DataLoader
from sklearn.metrics import classification_report
DATA_DIR = "dataset"
EPOCHS = 20
BATCH_SIZE = 16
LR = 1e-4
device = torch.device(
"cuda" if torch.cuda.is_available() else "cpu"
)
train_transform = transforms.Compose([
transforms.Resize((224, 224)),
transforms.RandomHorizontalFlip(),
transforms.RandomRotation(10),
transforms.ToTensor(),
transforms.Normalize(
[0.485, 0.456, 0.406],
[0.229, 0.224, 0.225]
)
])
eval_transform = transforms.Compose([
transforms.Resize((224, 224)),
transforms.ToTensor(),
transforms.Normalize(
[0.485, 0.456, 0.406],
[0.229, 0.224, 0.225]
)
])
train_dataset = datasets.ImageFolder(
f"{DATA_DIR}/train",
transform=train_transform
)
val_dataset = datasets.ImageFolder(
f"{DATA_DIR}/val",
transform=eval_transform
)
test_dataset = datasets.ImageFolder(
f"{DATA_DIR}/test",
transform=eval_transform
)
assert train_dataset.classes == val_dataset.classes
assert train_dataset.classes == test_dataset.classes
classes = train_dataset.classes
train_loader = DataLoader(
train_dataset,
batch_size=BATCH_SIZE,
shuffle=True
)
val_loader = DataLoader(
val_dataset,
batch_size=BATCH_SIZE,
shuffle=False
)
test_loader = DataLoader(
test_dataset,
batch_size=BATCH_SIZE,
shuffle=False
)
model = models.resnet18(
weights=models.ResNet18_Weights.DEFAULT
)
model.fc = nn.Linear(
model.fc.in_features,
2
)
model = model.to(device)
criterion = nn.CrossEntropyLoss()
optimizer = torch.optim.Adam(
model.parameters(),
lr=LR
)
best_acc = –1
best_state = None
for epoch in range(EPOCHS):
model.train()
train_loss = 0
for images, labels in train_loader:
images = images.to(device)
labels = labels.to(device)
optimizer.zero_grad()
outputs = model(images)
loss = criterion(outputs, labels)
loss.backward()
optimizer.step()
train_loss += loss.item()
model.eval()
correct = 0
total = 0
with torch.no_grad():
for images, labels in val_loader:
images = images.to(device)
labels = labels.to(device)
outputs = model(images)
preds = outputs.argmax(dim=1)
correct += (preds == labels).sum().item()
total += labels.size(0)
val_acc = correct / total
print(
f"Epoch {epoch+1}/{EPOCHS} "
f"Loss={train_loss/len(train_loader):.4f} "
f"Val Acc={val_acc:.4f}"
)
if val_acc > best_acc:
best_acc = val_acc
best_state = copy.deepcopy(
model.state_dict()
)
torch.save(
{
"model_state_dict": best_state,
"classes": classes
},
"best_resnet18.pth"
)
model.load_state_dict(best_state)
model.eval()
y_true = []
y_pred = []
with torch.no_grad():
for images, labels in test_loader:
images = images.to(device)
outputs = model(images)
preds = outputs.argmax(dim=1)
y_true.extend(labels.numpy().tolist())
y_pred.extend(preds.cpu().numpy().tolist())
print(classification_report(
y_true,
y_pred,
target_names=classes,
digits=4,
zero_division=0
))
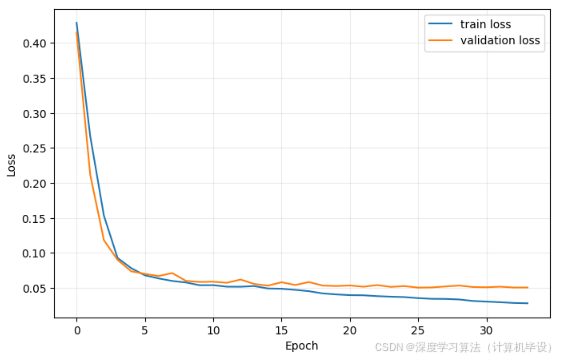
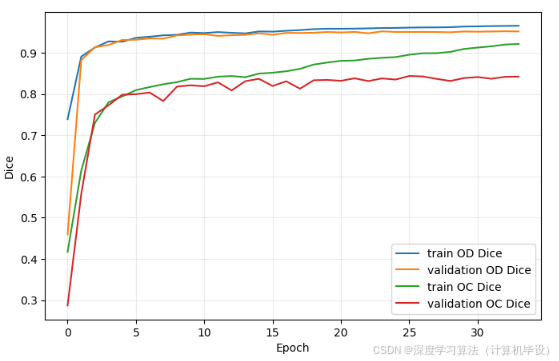
上述代码用于完成基础图像二分类实验。
正式实验应重点保证图像标签正确、患者级数据隔离,以及训练集、验证集和测试集之间不存在重复样本。
十、毕业设计可以增加哪些优化实验?
10.1 多模型对比
| ResNet18 | 待实验 | 待实验 | 待实验 | 待实验 |
| ResNet50 | 待实验 | 待实验 | 待实验 | 待实验 |
| DenseNet121 | 待实验 | 待实验 | 待实验 | 待实验 |
| EfficientNet-B0 | 待实验 | 待实验 | 待实验 | 待实验 |
| MobileNetV3 | 待实验 | 待实验 | 待实验 | 待实验 |
10.2 类别不平衡优化
针对CSV中青光眼样本较少的问题,可以比较:
- 普通交叉熵。
- 加权交叉熵。
- Focal Loss。
- WeightedRandomSampler。
10.3 数据增强实验
可以比较:
- 基础预处理。
- 随机翻转。
- 小角度旋转。
- 亮度和对比度调整。
- 不同增强组合。
医学影像增强应尽量保留真实解剖结构,避免不合理变换影响研究结果。
10.4 Grad-CAM可解释性分析
通过Grad-CAM生成模型关注区域热力图,分析模型是否关注视盘附近区域或其他图像特征。
需要注意,热力图仅表示模型关注区域,不能直接作为临床病灶定位依据。
十一、如果开发Web系统,可以设计哪些功能?
推荐技术架构:
PyTorch + ResNet18 + Flask + Vue + ECharts
| 系统首页 | 展示数据集和模型信息 |
| 图像上传 | 上传眼底图像 |
| 青光眼分类 | 输出模型预测结果 |
| 置信度展示 | 展示分类概率 |
| 批量识别 | 批量处理多张图片 |
| ExpCDR分析 | 展示杯盘比数值与统计 |
| 模型切换 | 切换ResNet、DenseNet等模型 |
| 模型评价 | 展示Accuracy、Recall、F1、AUC |
| 训练结果 | 展示Loss和Accuracy曲线 |
| Grad-CAM | 展示模型关注区域 |
| 历史记录 | 保存识别结果 |
| 数据可视化 | 展示标签和指标分布 |
系统工作流程:
眼底图像上传
↓
图像预处理
↓
ResNet / DenseNet分类模型
↓
青光眼二分类预测
↓
预测概率与热力图展示
↓
结果保存与可视化
如果选择ExpCDR融合方向,则需要增加数值输入和特征融合模块。



评论前必须登录!
注册