 网硕互联帮助中心
先说结论
深度扫描跑完,结果列表里跳出四千多个文件,时间从二〇一五年一直排到二〇二六年。里面有你今年丢的那份合同,也有七八年前的旧简历、已经拆掉的项目、别人用过的照片,还有一堆根本打不开的碎片。
这时候最容易做的两个动作,都很浪费:一是全选导出,然后在一堆同名文件里挑到崩溃;二是被几千个陌生文件名吓住,干脆放弃。
原因其实很简单——你扫的不是"一个文件夹",是这块盘十几年的全部历史。
一块盘被格式化过三次、重装过两次系统、中间还调整过一次分区。每一次操作都只重写了最前面那点索引结构,底下的数据层几乎没动。深度扫描不认年代,它按内容特征把整块盘翻一遍,于是三代、四代住户的东西全被摆到了同一张桌子上。
挑出你要的那一批,靠的不是眼力,是三条能用命令读出来的线索。这篇文章讲的就是怎么先用十分钟划出"哪一段是哪一代",再决定扫哪一段、导哪一段。
一、四千个文件,时间从二〇一五排到二〇二六
一块 4TB 的台式机硬盘,装机时是二〇一五年,中间重装过两次系统,去年把 D 盘格式化过一次,今年误删了一个装着客户资料和设计图纸的文件夹。
扫描跑了六个小时,出来四千三百多个结果。
列表按时间排序一看:最早的是二〇一五年的照片,文件名还是当年相机的编号;中间夹着一批二〇一八年的文档,看名字像是某个已经结束的项目;二〇二一年的最多,几百个文件;最后是今年的几十个。
问题是,今年的那几十个里,只有二十来个是他真正要的。剩下的大部分是同一份图纸的不同版本、扫描时拼出来的半成品、以及一些名字看着像但打开是乱码的东西。
如果直接把四千个全导出来,会得到一堆重名冲突(同一个文件名出现十几次),然后要花一整晚逐个打开筛选。
二、一块盘上住着好几代"住户"
要理解这件事,得先知道格式化到底做了什么。
格式化分两种。快速格式化只重写最前面那一小段索引结构,把"这里原来有什么"的记录清空,数据区一个字节都不动。完整格式化会额外做一次全盘写零,那种情况确实什么都不剩了。
绝大多数人做的是快速格式化。它的实际效果相当于:把一栋楼的门牌号全部撕掉,重新贴一批新的,但楼里的家具原封不动。
于是就有了一件很有意思的事:这块盘上现在这套文件夹结构,只是最新一代。在它之前,还躺着好几代。
具体躺着什么:
- 旧分区的起始位置和引导信息。 每次重新分区,新分区会从某个位置开始,在那个位置写入一小段引导信息。旧分区的那段引导信息,如果没被新数据压到,就还留在原地。
- 旧的文件索引区。 每个分区都有一块地方专门存"哪个文件在哪",这块区域在格式化时会被清理,但只清理新分区的范围。如果新分区比旧分区小,或者起始位置不同,旧的那块索引区就露在外面,内容还在。
- 旧的数据区。 这部分最顽强。只要没被新内容覆盖,几年前的文档、照片、视频就原样躺在扇区里。
所以"扫出十一个年头的文件"这件事一点都不奇怪。扫描器做的是"把这块盘上所有能认出特征的内容都列出来",它没有"这一代"和"上一代"的概念。
三、为什么扫描器分不清年代
深度扫描的原理,是在扇区里寻找文件内容的内部特征:文档有文档的结构,表格有表格的结构,图片有图片的开头标记,视频有自己的封装头。
找到之后,它把这些内容按类型导出来。名字往往是从内容里猜的,或者干脆按序号编。时间戳则要看运气——如果那条文件记录还在,能读出原始时间;如果记录已经没了,扫描器只能填一个扫描当时的时间,或者填零。
这就是为什么列表里的时间经常看起来很怪:同一个项目的文件,有的显示二〇二一年,有的显示今天。
结论:扫描结果里的"修改时间"不能当年代依据。 它只说明扫描器从哪儿读到了什么,不说明这个文件真实属于哪一年。
那用什么?往下看。
四、第一步:先划出每一代的范围
这一步的产出是一张简单的表:这块盘上曾经有过几个分区,各自从哪个位置开始、到哪个位置结束。有了这张表,你就知道该扫哪一段。
判断依据是分区起始位置。这里有个非常好用的历史规律:
老系统创建的分区,起始位置通常在第六十三个扇区附近;后来的系统为了对齐,默认从第二百零四十八个扇区开始。
这两个位置差了一千九百多个扇区,差不多一兆。所以只要看一个分区的起始位置,就能大致判断它是哪一代系统、哪个年代装出来的。
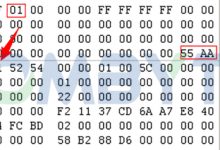
怎么找这些位置?最直接的办法是搜引导信息的特征字节。分区开头那段引导信息有固定的结构,开头几个字节是跳转指令,结尾两个字节是固定的标志。
# 找出所有 NTFS 分区引导信息可能出现的位置
sudo grep -abo $'\\xeb\\x52\\x90' /dev/sdb | head -20
输出的每一行是"字节偏移量:匹配内容"。把偏移量除以五百一十二,就得到扇区号。看到几个不同的扇区号,就说明这块盘上留下过几代分区。
对应的,老式文件系统的引导信息特征字节不一样,可以换一组再搜:
# 找出 FAT32 分区引导信息可能出现的位置
sudo grep -abo $'\\xeb\\x58\\x90' /dev/sdb | head -20
搜出来之后,把偏移量折算成分区范围。同一代的分区通常是一组挨着的数字,比如一个从 2048 开始、一个从 976773168 开始,这两个就属于同一次分区动作产生的两个分区。
如果不想敲命令,也有一些现成的分区分析工具可以只读地列出这块盘上探测到的历史分区结构。用的时候只做"分析",不要点任何"写入"或者"应用"。
五、第二步:用内容里的时间,不用文件的时间
范围划出来之后,判断"这个文件属于哪一代",最可靠的依据是内容自身携带的时间,而不是文件属性上的时间。
按格式分开看:
照片。 拍摄时间几乎一定写在文件内部。绝大多数相机和手机拍出来的照片都带这个信息,而且它是拍摄那一刻写进去的,之后无论怎么复制、怎么删除、怎么恢复,都不会变。这个时间可以直接用来定代——二〇一五年的照片,拍摄时间就是二〇一五年。
文档和表格。 这类文件的内部结构里通常记录了创建时间、最后修改时间、作者名。同样的道理,这些信息跟着内容走。打开文件看属性面板里的"详细信息",里面那一栏和外面属性栏的不是同一个来源。
视频。 有些带拍摄时间,有些只带创建时间。手机拍的通常有,专业设备拍的要看格式。
压缩包。 里面每一个成员都带着自己的原始时间,解开之后仍然保留原来的时间信息。
反过来,什么是不可靠的?就是你在扫描结果列表里看到的那一列时间。原因前面说过:记录还在的时候它是真的,记录没了的时候它是扫描器临时填的。同一个文件夹里的文件,会出现一部分真实、一部分是今天的混合状态。
一个简单的验证办法:随便挑三个显示为"今年"的文件,打开看内容里的时间。如果三个都对得上,说明这一批的记录是完整的;如果对不上,说明这一列不能用,得靠内容判断。
举三个真实会遇到的场景,体会一下这条判断线怎么用。
场景一: 列表里有八十个文件显示为今天,打开看内容,其中六十个的内部时间是二〇二一年三月,另外二十个打不开。结论是这一批里六十个是真实的旧文件、时间戳被扫描器覆盖了;二十个是碎片,优先处理那六十个。
场景二: 有一批照片文件名是连续编号,拍摄时间集中在某年夏天,中间缺了十几个号。结论是这批照片属于一次完整的拍摄,缺少的那十几个已经被后来的写入覆盖,不必再花时间找。
场景三: 有一批文档名字都带同一个项目缩写,内部创建时间前后差两个月,最后修改时间集中在一周内。结论是这是同一个项目的完整周期,从立项到结项,这一整批都值得保留。
这三个场景的共同点是:判断依据全部来自内容,没有一条来自列表里那列时间。
六、第三步:三条线索交叉验证
单一线索都可能出错,三条对得上,基本可以确认。
线索一,文件编号的连续性。 相机和手机拍的照片,文件名是一串递增编号。如果你要的那批是某个连续区间(比如某次旅行从 2301 到 2789),那这中间的编号应该都能找到,缺的那几个就是被覆盖的。这个规律在筛选时特别好用:按编号排序,一眼就能看出哪一段是完整的。
线索二,内容的上下文。 同一个项目的文件,内容里会互相提到——图纸的文件名会出现在说明文档里,合同的甲方会出现在附件里,照片的场景是连贯的。把这些串起来,能确认某批文件属于同一个时期、同一件事。
线索三,所在位置。 同一次操作删掉的文件,在盘上的位置通常挨得比较近。如果某几个文件在扫描结果里排在一起,它们大概率是同一批。
三条线索里,线索一最快、线索二最准、线索三用来处理线索一失效的情况(比如文档没有连续编号)。
七、分层导出:别让三批文件混在一个文件夹里
确认了范围,导出这一步要按"代"分开。
具体做法是:把扫描范围限定在第四步划出来的那一段,导出到一个单独的文件夹里;换一段范围,再导出到另一个文件夹。每一代一个文件夹,互不干扰。
这样做有三个好处。一是避免重名冲突——不同年代的同名文件不会互相覆盖。二是方便验收——某一代导出后打开一看全是十年前的垃圾,直接整个删掉,不用一个个看。三是出错时好回退——哪一代导错了,重来那一代就行,不影响别的。
这一步也是软件用得上的地方:扫描对象选镜像文件或者只读挂载的分区,把范围限定在目标区间,按类型勾选要恢复的格式,扫完在结果里按时间排序、按类型分组,预览确认后整批导出到另一块盘。轻虾数据恢复软件支持按范围、按类型限定扫描目标,正是为了应对这种"盘上躺着好几代"的场面——不限定范围的全盘深度扫描,在这种盘上跑一天也未必能出结果。
还有一个细节:导出时把"保留原文件夹结构"打开。能保留多少算多少,哪怕只保留了一部分,也比全部平铺成一堆散文件强——有层级就意味着有上下文,有上下文才判断得出这批东西属于哪一代。
导出完成后,建议顺手做一张对照表,一行一代,记四列:范围(起始和结束扇区)、导出数量、可正常打开的数量、明显属于哪一年。这张表不用半小时,但它能让后面所有判断都有据可依。
表格做出来之后,往往会看到一个很有意思的现象:越早的那几代,可正常打开的比例越低。原因不难理解——它们在这块盘上躺得最久,经历的重写次数最多。所以如果目标文件在第三代没找到,往第二代、第一代翻的时候,要把预期调低一些,别指望还能整批完好。
八、七个会挑错代的动作
第一个,按列表里那列时间排序就直接下判断。 前面说过,这一列可能是混合的,一半真一半假。
第二个,把四千个文件全选导出。 重名冲突、磁盘占满、筛选崩溃,三件事会一起发生。
第三个,只扫最新一代的范围。 如果误删发生在格式化之前、或者文件夹在调整分区时丢的,目标可能在更早的那一代里。
第四个,看到十一年前的文件就当垃圾删掉。 有些老文件是唯一一份,删掉之后再没有第二次机会。导出后先留着,确认没用再清理。
第五个,反复对整块盘做全盘深度扫描。 每一次都是全盘读取,对状态不佳的盘是持续加压。范围确认了就扫范围,别每次都从头来。
第六个,把扫描范围限定得太窄。 有些文件跨在分区边界附近,范围卡得太死会把它们排除掉。划定范围时前后各留一点余量。
第七个,导出后发现文件全是同一个时间。 这通常意味着这些文件是从内容特征扫出来的无名碎片,记录已经彻底没了。这批文件的优先级要往后放,先处理那些有时间、有名字、有层级的。
九、恢复过程的归档路径建议
这种"多代混在一起"的盘,归档结构要按代来分,不能按文件类型分。
D:\\RESCUE_20261102\\
├─ 00_镜像\\
│ ├─ disk.img
│ └─ disk.map
├─ 01_分区世代表.txt
├─ 02_第一代_2015-2018\\
├─ 03_第二代_2018-2021\\
├─ 04_第三代_2021-至今\\
│ └─ 目标内容\\
├─ 05_时间存疑\\
└─ 99_处置说明.txt
01_分区世代表.txt 是这份归档的灵魂。里面写三列:起始扇区、结束扇区、推断年代。这张表是后面所有操作的依据,也是送修时最有用的一页纸。
05_时间存疑 单独放那些时间戳明显不可靠、内容也判断不出年代的文件。这类文件不要混进任何一代里,否则会污染整批的可靠性。
04_第三代 下面再开一层 目标内容,只放确认是这次要救的东西。恢复过程中很容易"顺手多救一点",但顺手救的东西会稀释注意力,最后真正需要的反而找不到。
十、常见疑问
问:为什么我扫出来的文件时间是今天?
因为那些文件的索引记录已经不存在了,扫描器是从内容特征里认出来的,没有原始时间可读,只能填当前时间。文件本身是旧的,时间戳是新的。
问:怎么知道这块盘被格式化过几次?
看分区起始位置有几种不同的规律。起始位置在六十三个扇区附近的一批,属于老式对齐;在两千零四十八个扇区附近的一批,属于新式对齐。两组都出现,说明至少经历过一次跨代的分区调整。
问:只想要今年的文件,能不能直接跳过老的?
能,但要知道跳过的是哪一段。先按第四节划范围,把最新一代的区间找出来,只扫那一段。不划范围直接凭时间列筛,会漏掉时间显示错误的那些。
问:格式化之后又用了一段时间,还能扫出格式化前的东西吗?
能扫出一部分,取决于格式化之后写了多少新内容。写得多,覆盖得多,能扫出来的就少。所以发现得越早越有利。
问:为什么同一个文件会出现好几个版本?
同一份文档在不同时期被保存过多次,每次保存占用的位置不同。删除之后,这些历史版本都还躺在盘上,扫描时会全部列出来。判断哪个是最终版,看内容里的修改时间和文档内部的修订信息。
问:不同代的文件混在一起导出,会互相覆盖吗?
同名文件会。系统的导出逻辑遇到同名通常有两种处理:覆盖或者自动加序号。两种都不理想——覆盖会丢东西,加序号会让你面对一堆"文件(1)(2)(3)"。按代分开导出能避开这个问题。
问:这块盘还能继续用吗?
能,但不建议再放唯一一份。它的历史上已经发生过多次结构重写,说明使用强度不低,而且这次的误删已经证明它没有冗余保护。
最后
数据恢复里最容易被忽略的一件事,是"时间"这个东西在盘上其实有多层。
你以为是"我上个月删的文件",盘的回答是"这块地方住过四户人家,你要找哪一户"。
扫描器不会替你做这个区分,它只负责把能认出来的都摆出来。真正决定成败的,是你在按下"全选导出"之前,有没有先花十分钟问一句:这些文件里,哪一批才是我要找的那个年代。
问对了,四千个文件会缩成四十个。问错了,四十个文件也会淹没在四千个里。
而这块盘最有意思的地方在于,它从不忘记。你删掉的东西、换过的系统、改过的分区,它都一层层压着。你只需要知道怎么往下翻。


评论前必须登录!
注册