 网硕互联帮助中心
RAM、ROM、Flash 到底有什么区别?从 STM32 看懂代码、变量与函数存在哪里
写 STM32 程序时,我们常听到两句话:“程序放在 Flash,变量放在 RAM。”
这可以作为入门印象,却解释不了下面的问题:
- Flash 可以反复烧录,为什么有人把它叫 ROM?
- int count = 10; 的初值在哪里?修改后能不能掉电保存?
- 全局变量、局部变量、static、const 分别占用什么空间?
- 函数放在 Flash,为什么调用函数又会消耗 RAM?
- 编译结果里的 Code、RO-data、RW-data、ZI-data 到底代表什么?
要回答这些问题,需要分清三个层次:硬件存储器、程序的组织方式,以及 C 语言对象的生命周期。
本文以 C 语言和常见 STM32 裸机工程为主,默认程序烧录到内部 Flash、运行数据使用 SRAM。文中的存储位置是常见工具链配置下的结果,并非 C 语言强制规定。开启优化或修改链接配置后,实际结果可能不同。
一、先分清 RAM、ROM、Flash:它们不是三个完全并列的概念
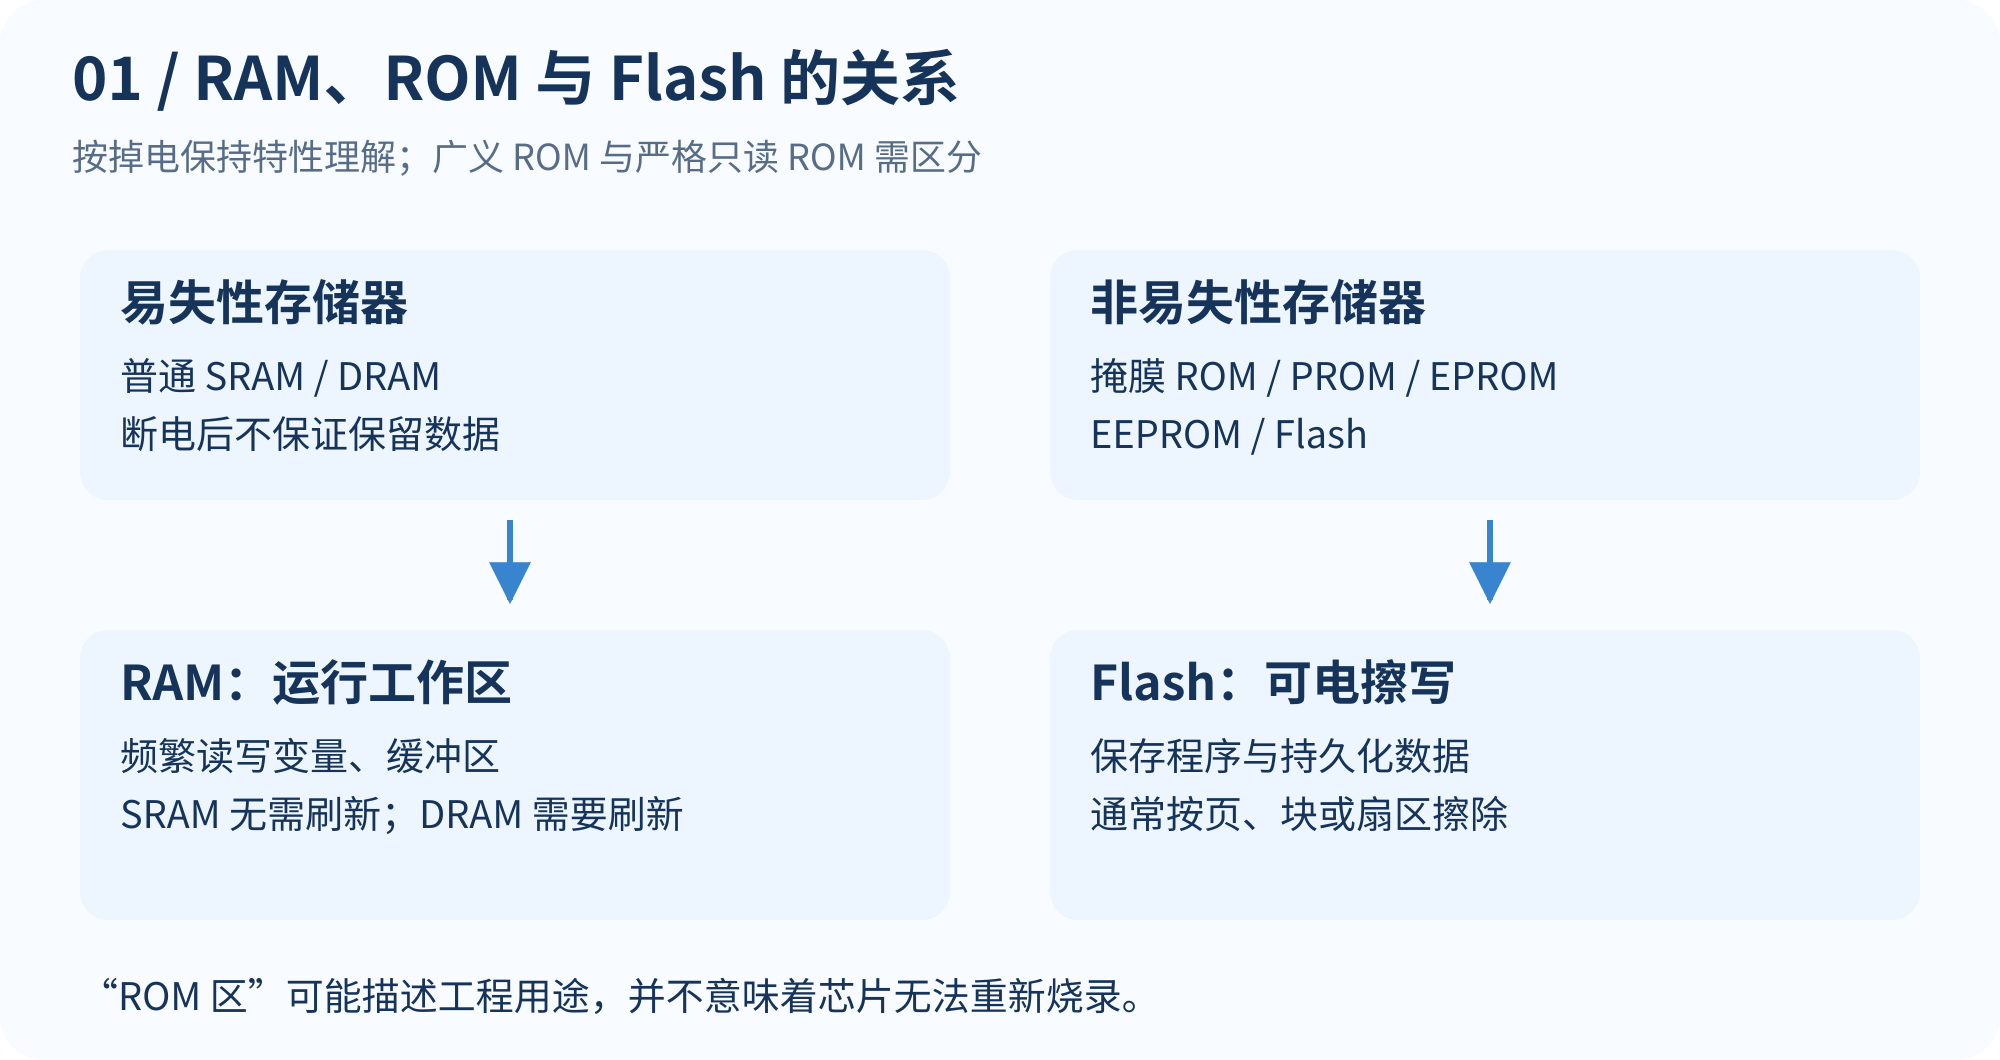
1. RAM:程序运行时的工作空间
RAM 全称是 Random Access Memory,随机存取存储器。
“随机存取”不是随机存数据,而是可以按地址直接访问目标位置,不必从头顺序查找。
在常见 MCU 中,RAM 主要用于存放运行过程中需要改变的数据,例如 ADC 采样数组、串口接收缓存、控制算法的中间结果,以及函数调用所需的数据。
常见的两类 RAM 是:
| SRAM,静态 RAM | 使用保持电路状态的存储单元 | 保持供电时不需要周期刷新 | MCU 片内 RAM、缓存 |
| DRAM,动态 RAM | 依靠电荷保存数据 | 需要周期刷新 | 计算机内存、部分外接大容量内存 |
STM32F407 的片内运行内存主要是 SRAM。这里“静态”不表示掉电后还能保存;普通 SRAM 和 DRAM 都属于易失性存储器。
2. ROM:需要结合语境理解“只读”
ROM 全称是 Read-Only Memory,只读存储器。
严格来说,传统掩膜 ROM 的内容在制造时确定,用户不能像写 RAM 那样修改。后来出现了 PROM、EPROM、EEPROM 等可编程非易失性存储器,“ROM”也常被用作这个技术家族的宽泛称呼。
因此,资料中的“ROM”可能表示:
- 严格意义上的只读存储器。
- 广义的非易失性程序存储器。
- 工具链中的只读存储区域,并不指定某一种物理器件。
看到 ROM 时,先判断它描述的是器件类型,还是工程里的存储用途。
3. Flash:可以电擦写的非易失性存储器
Flash 即闪存,属于非易失性存储器,通常放在电可擦写存储器家族中讨论。
它与常见 EEPROM 的一个重要区别,是 Flash 通常按页、块或扇区擦除,而不是像 RAM 一样随时按任意地址覆盖数据。具体编程单位和擦除单位由器件决定。
以 STM32 内部 Flash 的常见机制为例:擦除后数据位为 1,编程使指定数据位由 1 变为 0;要恢复为 1,通常需要擦除相应区域。实际操作还必须满足芯片对编程宽度、供电、电压和操作顺序的要求。
所以,Flash 可以保存程序,也可以保存校准参数、设备编号等数据,但有擦写寿命与操作耗时限制,不适合直接替代高频更新的 RAM 变量。
4. 放在同一张表里比较
| 掉电保持 | 否 | 是 | 是 | 是 |
| 用户修改 | 普通读写即可 | 通常不能 | 通过规定的写入流程 | 通过编程、擦除流程 |
| 更新粒度 | 通常支持字节、半字、字访问 | 不适用 | 常支持字节更新,也可能支持页写 | 编程粒度与擦除粒度通常不同 |
| 速度特点 | 适合频繁读写 | 适合读取固定内容 | 写入通常比读取慢 | 编程、擦除通常比读取慢 |
| 典型用途 | 变量、缓冲区、栈、堆 | 固定程序或数据 | 少量配置参数 | 固件、资源、持久化数据 |
Flash 还可分为 NOR Flash、NAND Flash。前者常用于代码存储和直接读取,后者常用于大容量存储。本文讨论的是 STM32 内部程序 Flash 的使用方式,不能把它直接等同于所有闪存设备。
二、以 STM32 为例:芯片内部有哪些存储区域?
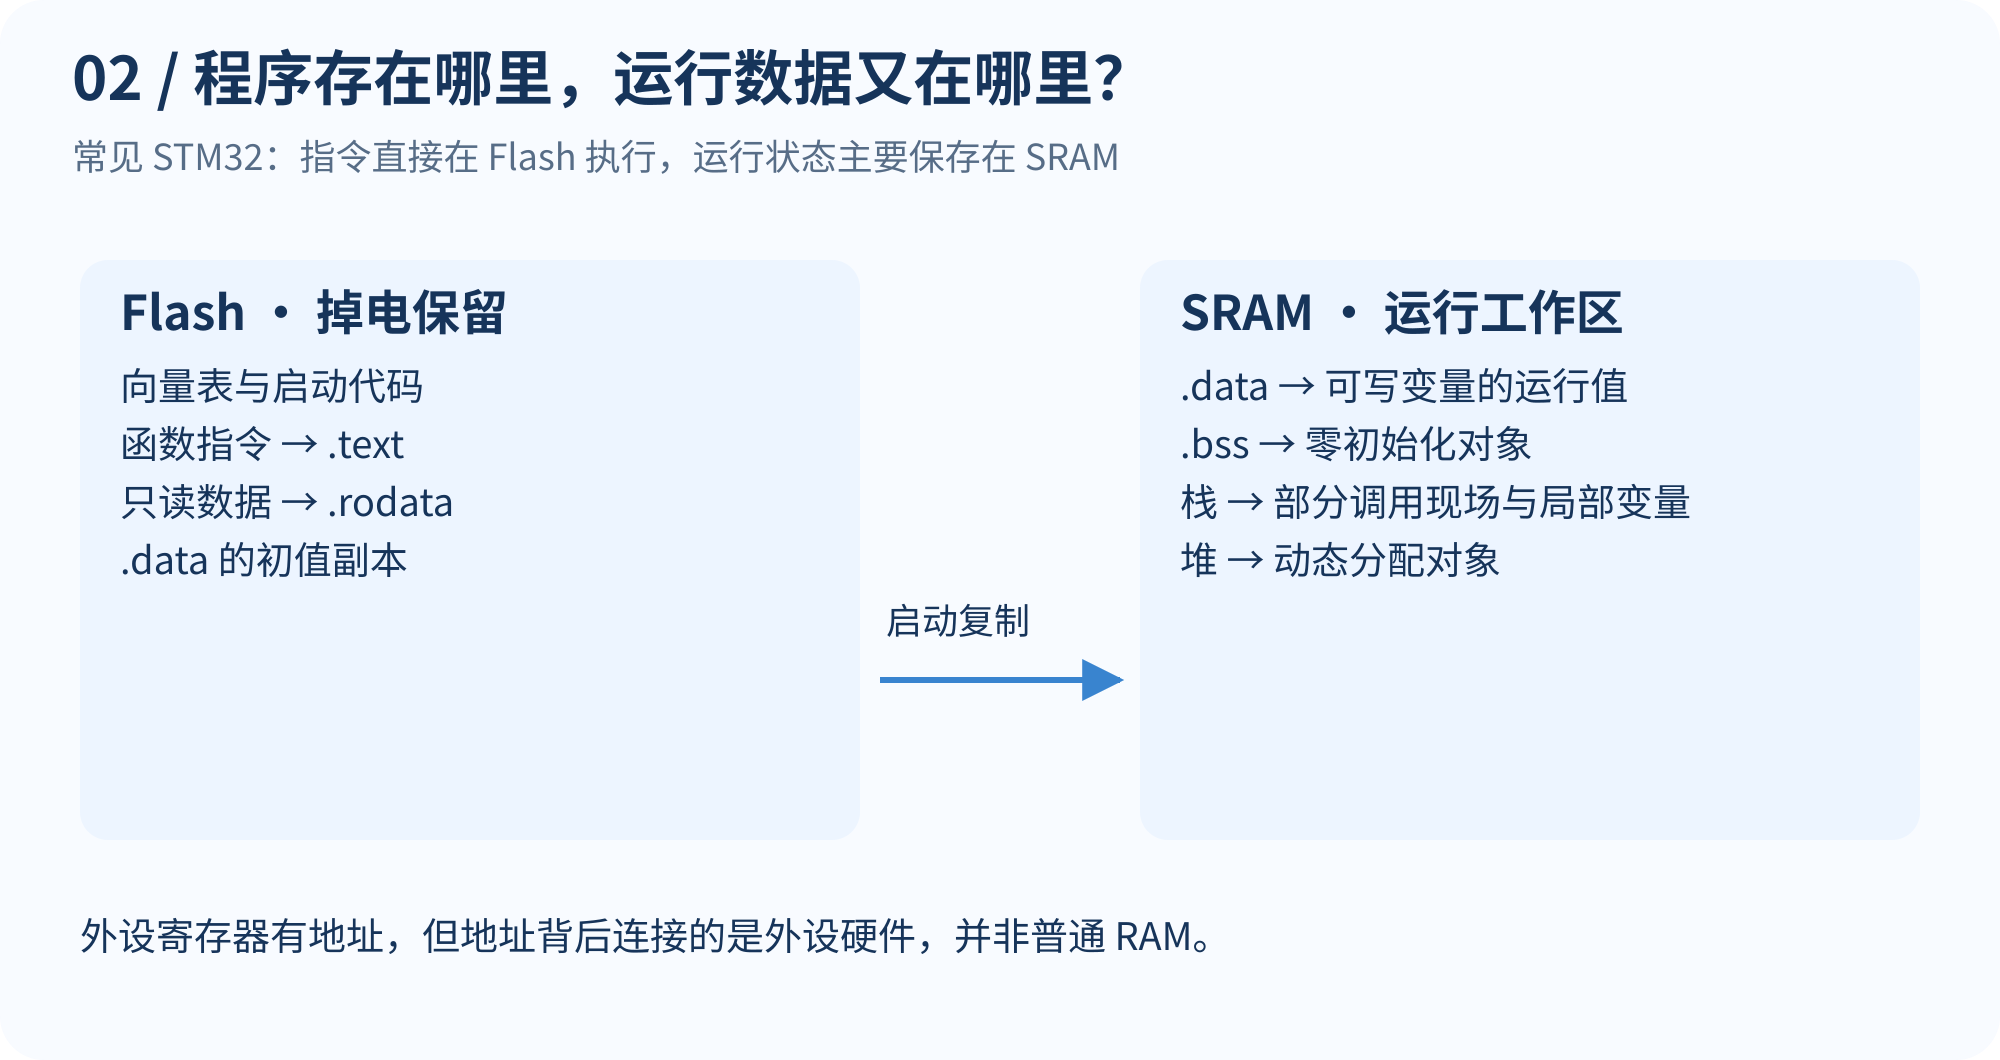
1. 主 Flash:保存用户程序与初始内容
常见 STM32 工程中,主 Flash 通常保存:
- 中断向量表与启动代码。
- 函数编译后的机器指令。
- 只读表格、字符串等数据。
- 需要复制到 RAM 的变量初值。
CPU 通常直接从 Flash 取指执行,不需要先把整个程序复制到 RAM。
特定函数也可以通过链接配置安排到可执行 SRAM 中运行,但需要正确处理其加载、复制和执行地址。
2. SRAM:保存运行中的可变状态
SRAM 通常承载全局变量、静态变量、栈、堆和各种缓冲区。
需要注意:同一芯片里的不同 RAM 区域,访问能力未必相同。
以 STM32F407 为例,其 SRAM1、SRAM2 与 CCM 数据 RAM 不在同一地址区间。CCM 只供 CPU 通过数据通路访问,不能把需要 DMA 访问的缓冲区随意放进去,也不能把它当成普通可执行 SRAM 使用。[1]
这对 ADC + DMA 尤其重要:缓冲区“放在 RAM”还不够,还必须放在 DMA 能访问的 RAM 中。
3. 系统存储器:厂商预置 Bootloader
STM32 的系统存储器中通常预置 ST 的启动加载程序,用于芯片支持的系统下载方式。具体支持哪些接口,要查对应型号的启动模式资料。
它与自己编写、烧录到用户 Flash 中的 Bootloader 是两回事。
4. 外设寄存器:有地址,不代表属于 RAM
例如:
GPIOA->ODR = 0x0001;
这次写操作访问的是 GPIO 外设寄存器。地址译码电路把访问送到 GPIO 硬件,从而改变相关输出状态。
RAM、Flash、外设寄存器都可以出现在 CPU 的地址空间中,但地址背后连接的硬件不同。
| 地址空间 | CPU 能使用哪些地址表示访问目标? |
| 物理存储器 | 芯片实际实现了哪些存储硬件? |
| 存储容量 | 某块存储器实际能保存多少数据? |
32 位地址可以表示很大的地址范围,不意味着芯片内部真的装有同等容量的 RAM。
三、源码变成程序后,为什么会分成不同的“段”?
1. 编译器与链接器分别做什么?
源代码中的函数和变量,不是按照书写顺序直接塞进 Flash。
编译器将源码转换为目标代码,并把指令、只读数据、可写数据等分到不同节区;链接器再合并目标文件与库,解析函数和变量之间的引用,根据链接配置分配地址。
链接脚本或 Keil 的 scatter 文件,决定各类内容最终放到哪块存储区域。Keil 的 Target 设置也可以为链接器提供 ROM、RAM 区域配置。[2]
2. 常见区域分别存放什么?
| .text | 函数的机器指令 | Flash | 是 |
| .rodata | 只读对象、字符串字面量、常量表 | Flash | 是 |
| .data | 通常为具有非零初值的可写静态存储期对象 | SRAM | 是,保存初值 |
| .bss | 通常为零初始化的可写静态存储期对象 | SRAM | 不逐字节保存零值 |
| 栈 | 调用现场、部分参数和自动变量等 | SRAM | 通常不需要 |
| 堆 | 动态申请的内存 | SRAM | 通常不需要 |
这里沿用常见的“程序段”说法,更严格地说,.text 等通常是目标文件或可执行文件中的节(section)名称,不同工具链的命名、合并方式并不完全一致。
栈和堆则是运行时使用内存的方式,可以由链接器预留,也可以由运行库或系统管理,不一定与上面四个节处于同一分类层级。
3. 为什么 .bss 能节省 Flash?
考虑一个全局数组:
unsigned char rx_buffer[1024];
它具有静态存储期,启动时应被初始化为零。工具链通常把它放入 .bss。
程序只需要记录这片区域的地址和长度,在启动时清零,无须在 Flash 中额外保存 1024 个零。因此它通常占用 1024 字节 RAM,却不需要同样大小的 Flash 初值副本。
这不意味着初始化“完全免费”:描述信息、清零代码,以及启动时执行清零的时间仍然存在。
四、重点:代码里的变量、函数,到底放在哪里?
1. 用一段代码建立对应关系
下面是用于分析的示例,不是地址分配的保证。未被使用的对象可能被优化或链接删除。
#include <stdlib.h>
#define BUFFER_SIZE 128
int g_count = 10;
int g_zero = 0;
int g_uninit;
static int s_mode = 2;
const int g_limit = 100;
char g_name[] = "STM32";
void demo(int input)
{
int local = input + 1;
int temp;
static int calls = 0;
const int limit = 20;
char text[] = "ABC";
const char *message = "Hello";
int *p = malloc(4 * sizeof *p);
calls++;
if (p != NULL)
{
p[0] = local + limit;
free(p);
}
}
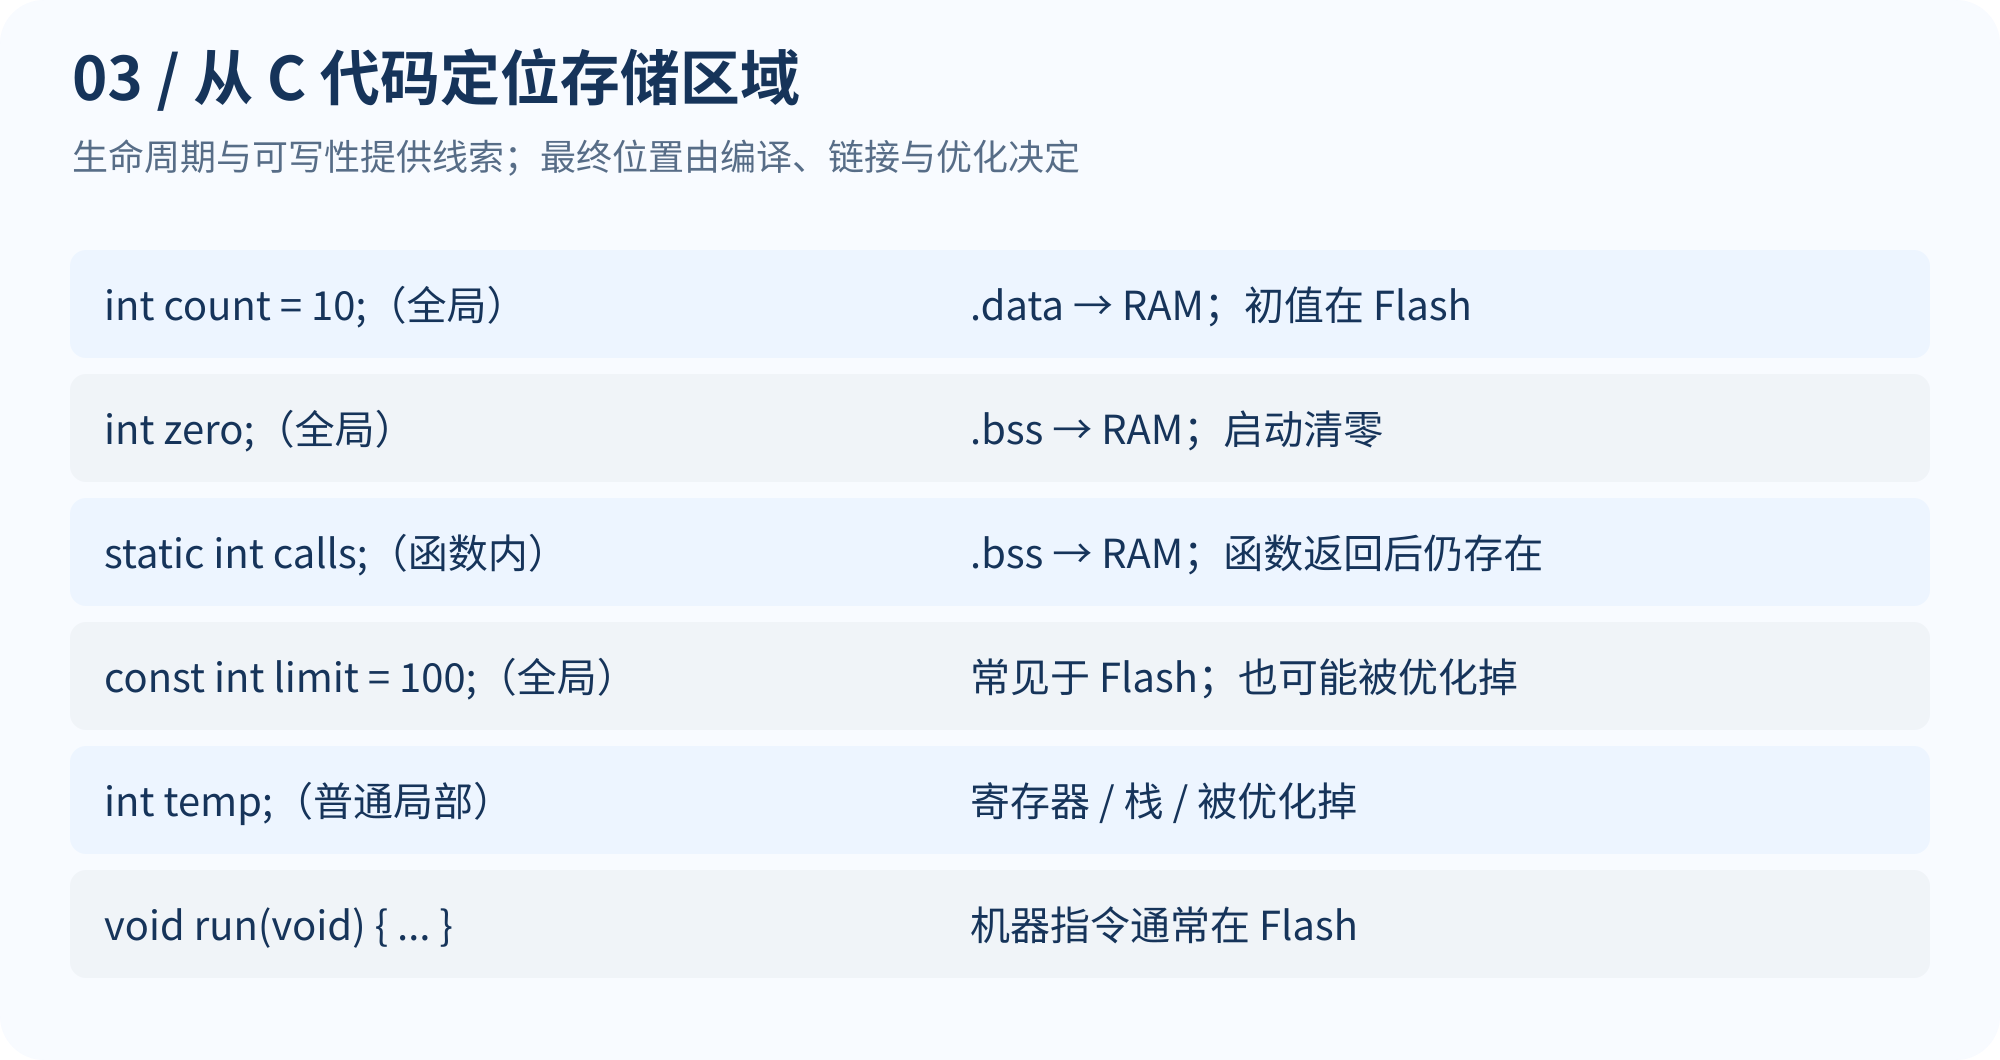
| g_count | .data,运行时位于 RAM | 初值 10 通常保存在 Flash |
| g_zero | .bss | 显式初始化为零,也通常使用清零机制 |
| g_uninit | .bss | 未显式初始化的全局变量会被零初始化 |
| s_mode | .data | 文件作用域的 static 限制链接可见性,不意味着只读 |
| g_limit | 常见于 Flash 中的只读区域 | 也可能被常量折叠或移除 |
| g_name | .data | 它是可修改数组,包含末尾的 \\0,共 6 字节 |
| input | 寄存器或栈 | 由调用约定、类型和优化结果决定 |
| local、temp | 寄存器或栈,也可能消失 | 普通自动变量,temp 未赋值前不能当有效数据使用 |
| calls | .bss | 虽然写在函数内,生命周期覆盖整个程序运行期间 |
| 局部 limit | 可能直接成为指令中的常量 | const 不保证独立的 Flash 存储位置 |
| text | 通常是栈上的数组 | 数组内容可修改,初始化方式由编译器决定 |
| message | 寄存器或栈中的指针 | 指向通常位于只读区域的字符串字面量 |
| p | 寄存器或栈中的指针 | 指向动态分配区,并不意味着指针本身在堆里 |
| malloc() 分配的空间 | 堆或运行库管理的动态内存区 | 需检查失败并按所有权规则释放 |
| demo() 的机器指令 | 通常在 Flash 的代码区域 | 与它调用时产生的数据分开存放 |
2. 作用域、生命周期、存储位置要分开看
这三个问题分别是:
- 作用域: 在源码的哪些地方能通过这个名字访问对象?
- 生命周期: 对象从什么时候存在,到什么时候结束?
- 存储位置: 最终使用哪块物理内存或哪个寄存器?
例如 calls:名字只能在函数内部使用,对象却不会在函数返回时消失,常见实现中保存在 RAM 的静态数据区域。
所以,“写在函数里”不能直接推导出“放在栈上”。
3. const 不等于“强制放进 Flash”
const 主要约束通过相应类型进行修改的行为,并不直接指定物理存储器。
全局只读数组通常很适合放在 Flash,例如:
const unsigned short sine_table[4] = {0, 1000, 2000, 1000};
但局部 const int limit = 20; 可能直接被编译器替换成常量 20,根本没有独立存储空间;需要实际存储时,也未必位于 Flash。
还要区分:
const char *p1; // 不能通过 p1 修改它所指向的字符
char * const p2 = buf; // p2 本身不能再改指向,buf 须已定义
第一种限制指向的数据,第二种限制指针对象。两者都不能单凭写法判断最终地址。
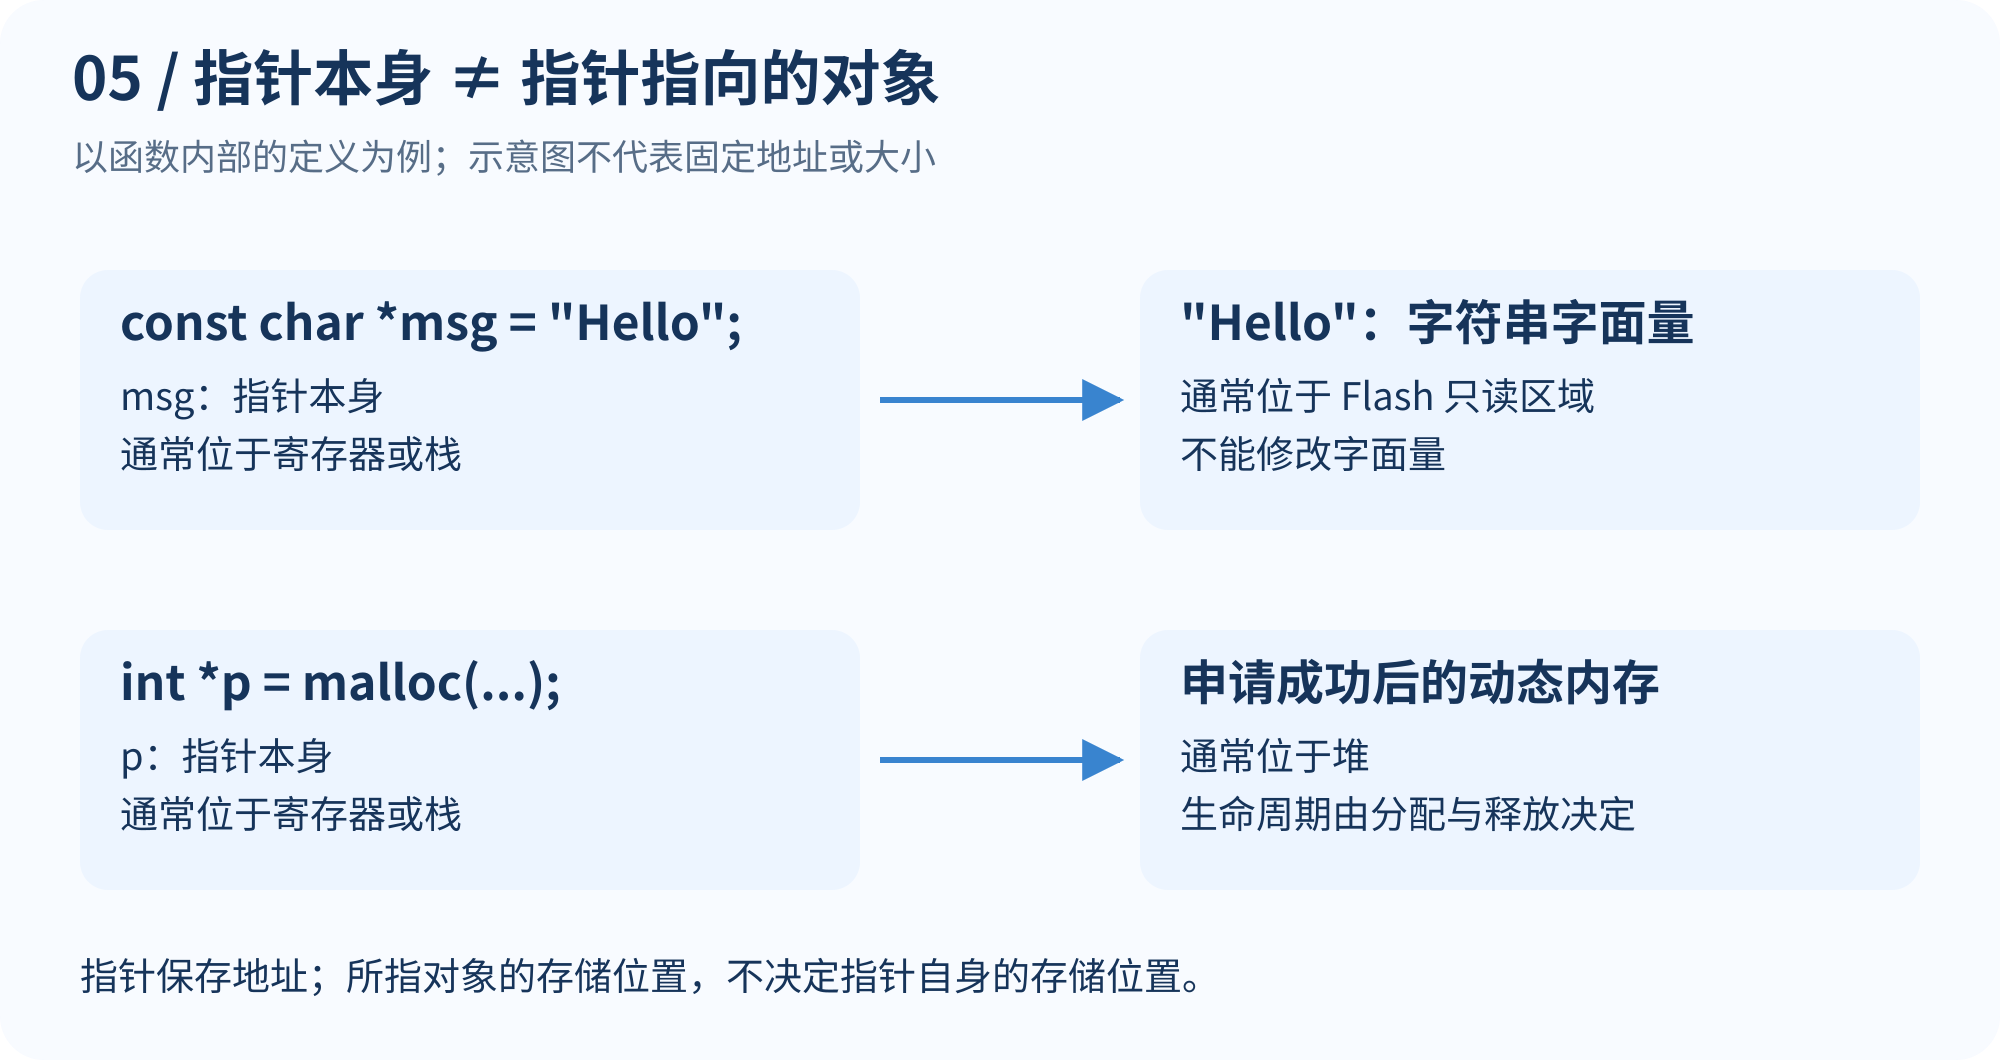
4. 字符串字面量与字符数组不是同一个对象
char a[] = "ABC";
const char *b = "ABC";
若它们定义在函数内,a 是一个包含 4 个字符的可写自动数组,通常位于栈;b 是指针,指向具有静态存储期的字符串字面量。
可以执行 a[0] = 'X';,但不能修改字符串字面量。即使通过类型转换绕过类型检查,尝试修改字面量依然属于未定义行为。[3]
5. 三个常被误解的关键字
| #define N 100 | 预处理阶段的文本替换 | 不会因为定义了宏就生成一个名为 N 的变量 |
| volatile int flag | 对该对象访问的优化约束 | 不指定放在哪,不保证原子性或线程安全 |
| register int x | 传统 C 中向实现提供快速访问的建议,并限制取地址 | 不保证一定占用 CPU 寄存器 |
宏展开后的表达式、字符串或代码仍然可能占用空间。“宏本身不是变量”不等于“使用宏不会增加程序大小”。
五、为什么一个变量会同时涉及 Flash 和 RAM?
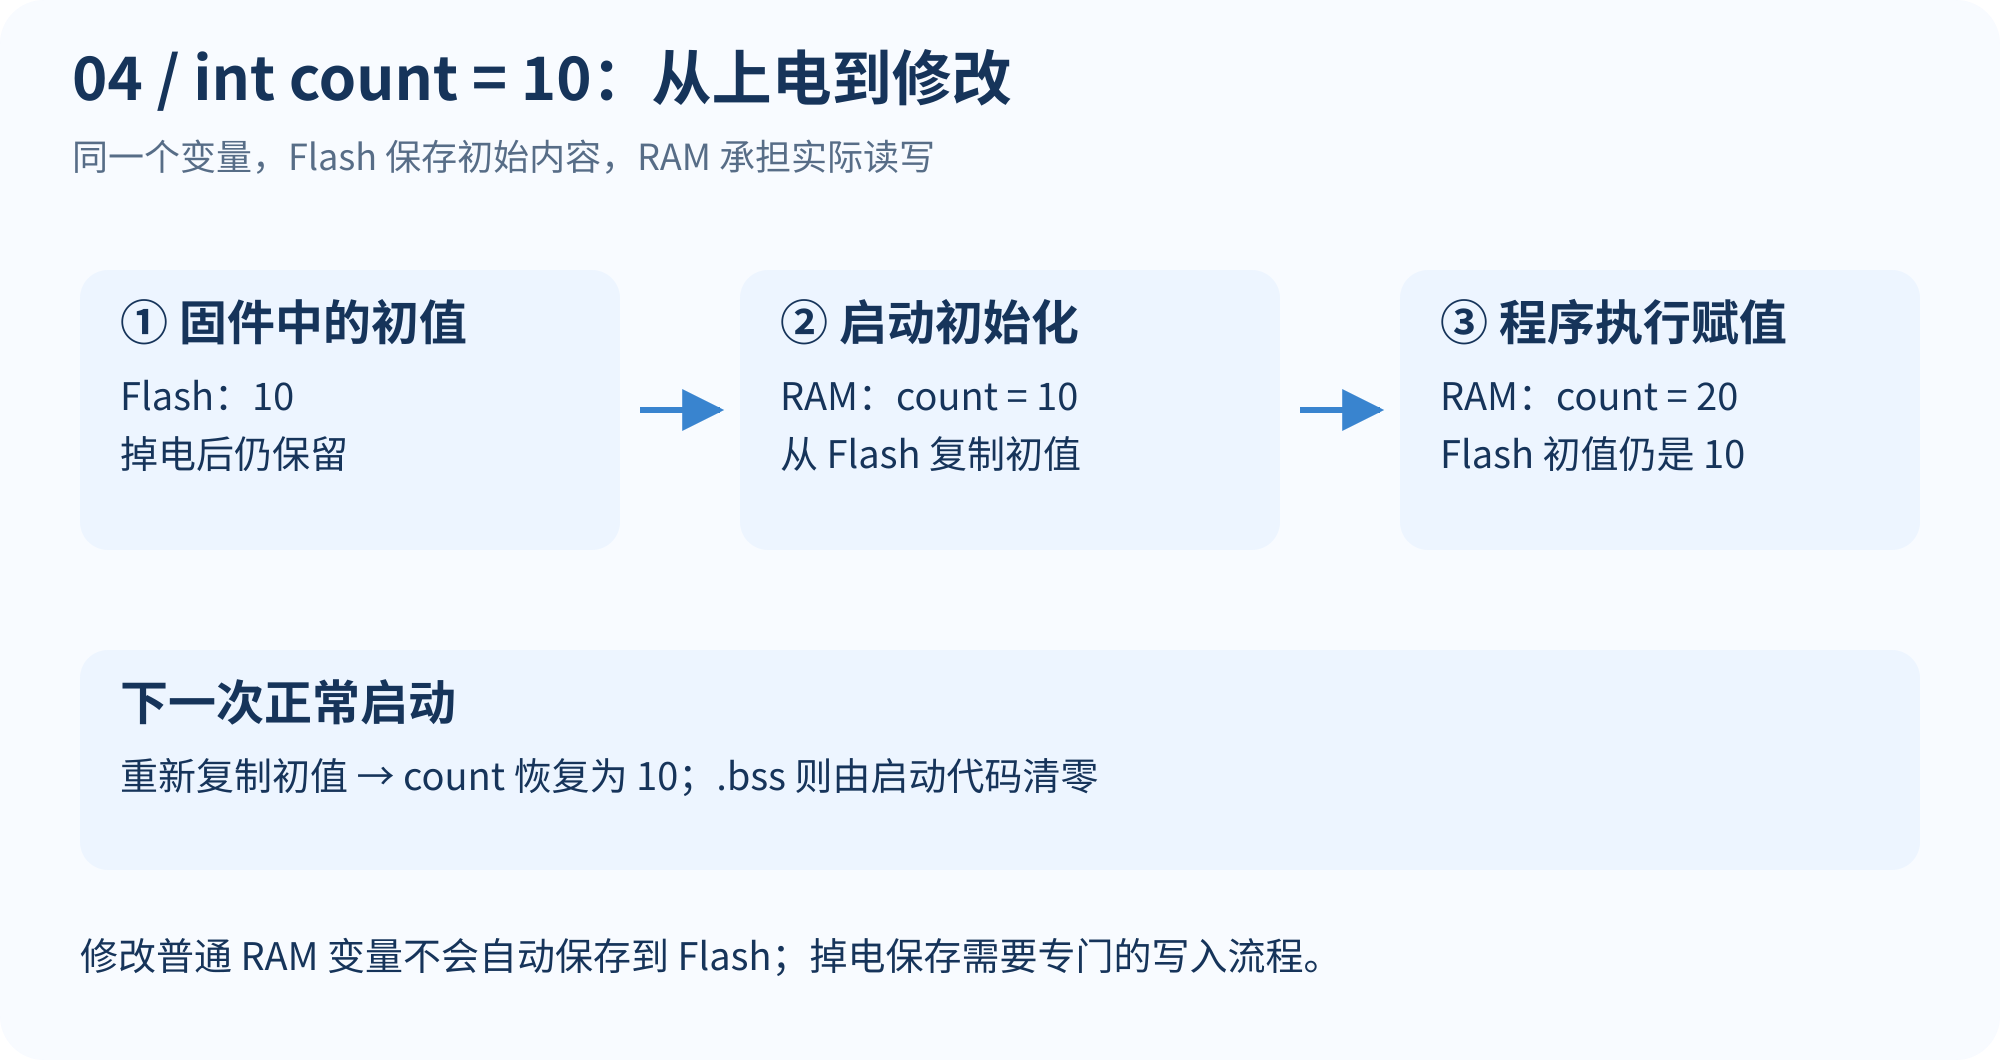
1. 从 int count = 10; 看两份不同职责的内容
假设这是一条全局定义:
int count = 10;
在常见工程中,Flash 保存它的初始内容,RAM 保存程序实际读写的对象。启动时,初始化代码把初值复制到变量的 RAM 地址。
执行:
count = 20;
修改的是 RAM 中的运行值,不会自动更新 Flash 中的初值。下次按正常启动流程重新初始化后,count 又会变成 10。
若想掉电保存 20,需要显式执行非易失性存储操作,并设计存储格式、擦写与恢复流程。
2. 加载地址与运行地址
| 加载地址,LMA | 固件中初始内容保存的位置,通常位于 Flash |
| 运行地址,VMA | 程序实际访问对象的位置,通常位于 RAM |
对于直接在 Flash 执行的代码,加载地址和运行地址通常相同。对于先保存在 Flash、再复制到 SRAM 执行的函数,它们也可以不同。
因此,“一个对象属于哪个段”和“这个段加载、运行在哪里”需要结合起来理解。
3. 从复位到 main(),发生了什么?
可以按下面的概念流程理解:
具体工程中,系统时钟初始化、运行库初始化等调用顺序可能不同,不能只凭一个函数名推断全部流程。Keil 工程通常还需要继续查看复位处理程序调用的运行库入口,而不是只在启动汇编里找一段明显的复制循环。
4. 为什么全局变量默认是零,普通局部变量却不是?
int global_value;
void test(void)
{
int local_value;
}
global_value 具有静态存储期,C 语言要求它得到默认初始化。对于这里的整数类型,结果是零;STM32 工程通常通过启动时清零 .bss 来实现。
local_value 是未初始化的自动对象,不能把它当成已有有效数值来读取。把它解释为“随机数”也不严谨:涉及的是不确定值及相应的语言规则,某些读取会产生未定义行为。
全局变量初始为零,是语言规则与启动初始化共同保证的结果,不是 RAM 上电后天然全零。
另外,某些工程会显式设置 noinit 区域用于特定保留用途,这属于专门配置,需要另外建立有效性判断,不能套用普通 .bss 的结论。
六、函数运行时,栈和堆到底发生了什么?
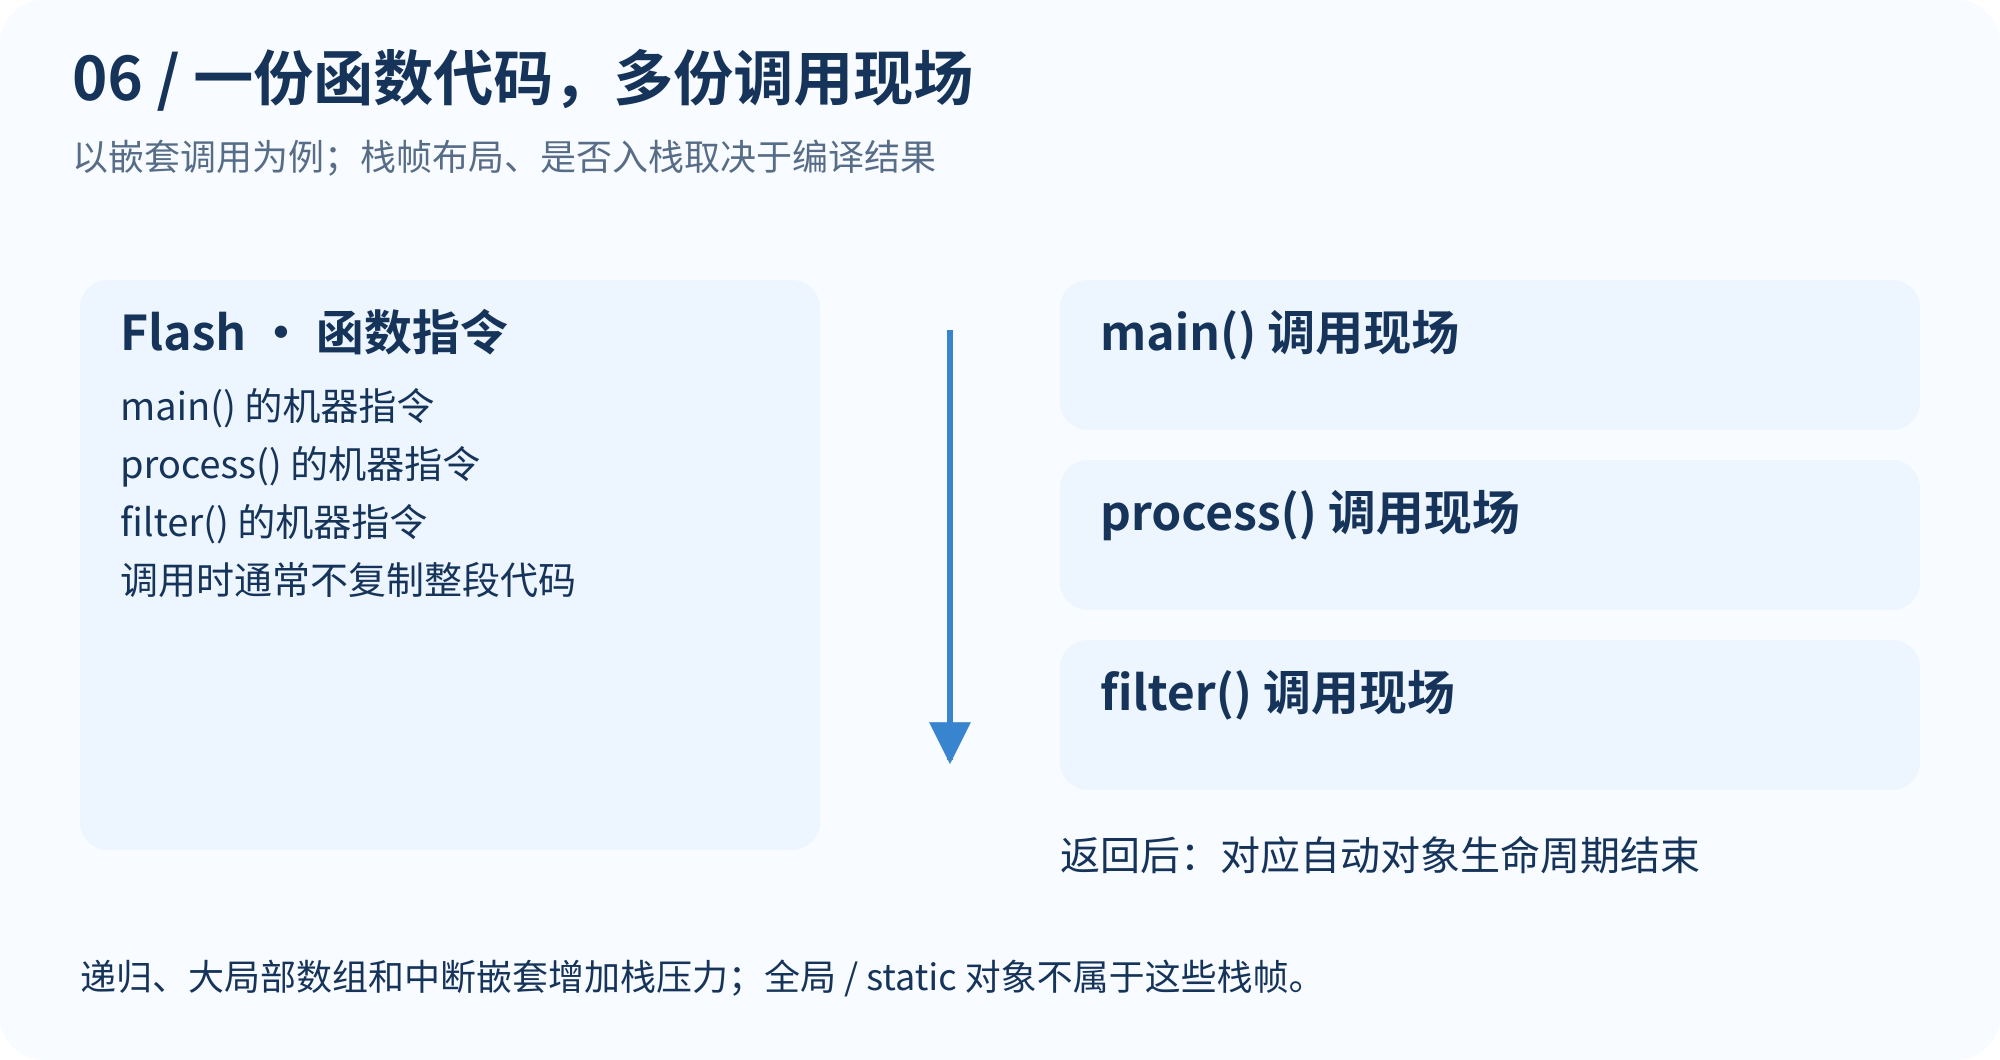
1. 函数代码与调用现场分开存储
int add(int a, int b)
{
int result = a + b;
return result;
}
add() 编译后的加法、返回等机器指令通常位于 Flash。调用它时,参数、结果和必要的现场数据则可能位于 CPU 寄存器或 RAM 中的栈。
函数的每次调用并不会把机器指令重新复制一遍。递归时通常是多份调用现场共用同一份函数代码。
简单函数经过优化后,参数和结果可能全部通过寄存器传递,甚至被内联,未必建立独立栈帧。对 Cortex-M 来说,返回信息也可能先保存在链接寄存器中,仅在需要时入栈。
2. 为什么不能返回普通局部变量的地址?
int *wrong(void)
{
int value = 123;
return &value; // 错误示例
}
函数返回后,value 的生命周期结束。即使那片内存的字节暂时没有变化,也不能继续通过该地址访问已经结束生命周期的对象。
常见改法是返回值本身,或让调用者提供缓冲区。改成 static 虽能延长生命周期,却也会让所有调用共享同一对象,需要考虑重入和并发访问问题。
3. 大数组和递归为什么容易耗尽栈?
void process(void)
{
unsigned char buffer[4096];
// 假设后续实际使用该数组
}
如果该数组被实际保留在栈上,单它就需要约 4 KiB,再加上其他局部数据、保存的寄存器以及中断嵌套开销,可能超出栈空间。
改成 static 通常能把它移到静态数据区,但它仍然占用 RAM,而且整段程序运行期间都要保留。它解决的是栈压力,并不会让总 RAM 开销消失。
4. 堆:对象何时消失由分配与释放流程决定
int *p = malloc(100 * sizeof *p);
if (p != NULL)
{
p[0] = 123;
free(p);
p = NULL;
}
p 若是局部指针,其自身通常在寄存器或栈中;申请到的空间则由动态分配器管理。
malloc() 不保证返回零初始化的内存,也可能分配失败。函数返回不会自动释放成功申请的那块空间。free() 后再访问该空间属于错误;把 p 设为 NULL 也不会自动修复其他指向同一块内存的指针。
对于嵌入式控制程序,还应关注动态分配的时间波动、管理开销和碎片问题。固定大小缓冲区、内存池或启动时集中分配,往往更容易分析资源上限。
5. 优化会改变“看起来应该存在”的变量
int calculate(void)
{
int a = 10;
int b = 20;
return a + b;
}
编译器可能直接生成“返回 30”的代码。此时并不需要为 a 和 b 分配独立 RAM 空间。
因此,调试器提示变量被优化掉,不一定是程序出错。存储位置必须以最终构建结果为准。
七、如何验证,而不是只背结论?
1. 先看 Keil 的大小统计
例如:
Program Size: Code=12000 RO-data=2000 RW-data=100 ZI-data=3000
| Code | 代码统计类别,主要包含机器指令 |
| RO-data | 只读数据 |
| RW-data | 有初始内容的可写数据 |
| ZI-data | 零初始化数据统计类别 |
在普通、未压缩、代码与只读数据位于 Flash 的配置下,可以先作近似估算:[4]
Flash 占用 ≈ Code + RO-data + RW-data
RAM 中已统计的 RW/ZI 区域 ≈ RW-data + ZI-data
这个例子得到 Flash 约 14100 字节,RW/ZI 区域约 3100 字节。
但是,不能只凭第二个数就宣布“运行时 RAM 一定够用”。
- 栈和堆是否已经作为预留区计入统计,要看工程的启动文件、链接配置与 map 文件。
- 若已计入,不能再重复相加;若未计入,则需要单独预算。
- 实际栈峰值与调用深度、中断嵌套有关,不能只看预留空间的大小。
- 对齐、填充、数据压缩、自定义段及 RAM 执行代码可能使简单公式与最终装载范围不同。
2. 查看 .map 文件
生成链接 map 文件后,可以搜索变量名或函数名,重点看:
对常见 STM32F407 工程来说,主 Flash 从 0x08000000 开始,普通 SRAM 区从 0x20000000 开始,CCM 数据 RAM 从 0x10000000 开始。实际有效范围与容量需要结合具体型号及手册判断,不能仅凭地址前缀确认所有地址都有效。[1]
函数与变量的地址也不是由源码顺序固定决定的。增加一个库函数、调整优化等级或修改链接配置,都可能改变布局。
3. 做一个小实验
准备以下定义,并在 main() 中实际使用它们:
int g_a = 123;
int g_b;
const int g_c = 456;
void inspect(void)
{
int local = 789;
static int persistent;
const char *text = "STM32";
// 在此设置断点,结合 Watch、Memory、反汇编观察
g_b = local + g_c;
persistent++;
g_a += text[0] + persistent;
}
建议先使用便于调试的较低优化设置,再做以下观察:
| &g_a、&g_b | 可写全局对象的运行地址通常在 RAM |
| &g_c | 被实际保留的只读对象是否位于 Flash |
| &persistent | 函数内 static 的地址通常属于静态数据区 |
| &local | 自动变量被实际分配到内存后的地址 |
| text 与 &text | 字符串地址与指针对象自身的地址不同 |
| 反汇编窗口 | 哪些值通过寄存器传递,哪些对象被优化掉 |
注意:在源码中增加取地址操作,尤其把地址传给其他函数时,可能迫使对象实际落到内存;调试器也不一定能为寄存器中的对象提供可取的内存地址。实验得到的是当前代码、当前配置下的结果。
另外,普通“复位”不代表所有 SRAM 物理字节都会被硬件清零;调试器也可能参与初始化。判断变量恢复原因时,要区分断电、复位,以及启动代码重新执行这几件事。
文末速查:C 语言对象通常存在哪里?
下表沿用本文的常见 STM32 配置,掉电保持指实际运行值能否保留。
| 函数机器指令 | Flash,代码区 | 是,指令内容保留 | 烧录 |
| 全局只读常量、常量表 | Flash,只读区 | 是,若对象被保留在此 | 烧录 |
| 字符串字面量 | 通常在 Flash,只读区 | 通常是 | 烧录 |
| 非零初始化的可写全局、静态变量 | RAM,.data | 否,Flash 仅保存初始内容 | 启动时复制初值 |
| 零初始化或未显式初始化的可写全局、静态变量 | RAM,.bss | 否 | 启动时清零 |
| 普通局部变量、参数 | 寄存器或栈,也可能被优化掉 | 否 | 按声明、赋值或调用过程建立 |
| 局部字符数组 | 通常在栈,也可能被优化 | 否 | 进入相应执行路径时初始化 |
| 动态分配对象 | 堆或其他动态内存区 | 否 | malloc() 不负责清零 |
| 外设寄存器 | 对应外设硬件 | 通常不能作为掉电保存手段 | 依复位规则及配置写入 |
遇到一段 C 代码时,可以按这个顺序判断:先看对象的生命周期和可写性,再看编译后的节区,最后用链接配置和 map 文件确认物理位置。
这比简单记忆“程序放 Flash,变量放 RAM”更可靠,也能直接帮助定位 RAM 不足、栈溢出、DMA 缓冲区不可访问,以及启动初始化异常等实际问题。


评论前必须登录!
注册