 网硕互联帮助中心

封面:驾驭工程
你可能见过这样的对比。
同样是调用一个大模型,一个产品只能陪你聊天:你问它答,答完就忘,多问两句就开始绕圈。另一个产品却能在你的代码库里连续干上几个小时——读文件、改代码、跑测试、发现报错、自己回头重改,中间不用你盯着。
底层跑的是同一个模型。差别不在"大脑",在"外壳"。
这件事行业花了三年才说清楚,而答案恰好是三个词:提示词工程、上下文工程、驾驭工程。前两个你大概听过,第三个是 2026 年才正式定名的新词。
这篇文章想讲清楚三件事:驾驭工程到底是什么,它为什么非有不可,以及——为什么"模型够强"从来不等于"系统可靠"。
一、两次升级,两个天花板

两次升级,两个天花板
1.1 提示词工程:教会模型"怎么说话"
2022 年底 ChatGPT 发布时,大家面对的第一个问题是:这东西怎么才能听懂我要什么?答案很朴素——把话说清楚:给角色设定、给几个示例、指定输出格式,必要时加一句"让我们一步步思考"。这套方法后来有了名字:提示词工程(Prompt Engineering)。Anthropic 在 2025 年的一篇文章里给过准确的定义:提示词工程指的是"撰写与组织大模型指令的方法"——它管的是指令怎么写。
在那个阶段,这确实是最要紧的事。当时上下文窗口只有 4000 token 左右,能给模型的信息极其有限,剩下的全靠话术。一个讲 Harness 概念的科普视频里提到过一个判断:在那个窗口下,"简单地把提示词写好一点,并不足以拿到我们想要的结果"——但当时也没有更好的办法。
提示词工程确实有效,至今仍然有效。但它有个绕不过去的天花板:它优化的是"表达",而模型缺的往往是"信息"。 你把话说得再漂亮,模型也看不到你的代码库、读不了你的数据库、不知道上一轮聊到哪儿了。它像一个表达能力极强、但被关在空房间里的人——你说什么它都能接住,可它手上什么都没有。要突破它,得给模型配资料。
1.2 上下文工程:教会模型"该看什么"
2025 年前后,模型能调用工具了、能连数据库了、能通过 MCP 接上外部服务了。于是问题从"怎么说"变成了"给它看什么"。这就是上下文工程(Context Engineering)。Anthropic 同一篇文章里的定义是:"一组用于筛选与维护最优 token 集合的策略"。对比两个定义就能看出差别:提示词工程管的是指令,上下文工程管的是整个 token 集合——指令、工具定义、检索资料、历史消息、工具返回结果。
这个阶段诞生了第一代真正能干活的产品。工具调用让 Agent 可以只读跟任务相关的文件,而不是把整个仓库塞进去;RAG 让它能按需从自有数据库取数;MCP 让厂商能力可以插拔。Cursor、Windsurf、Cline、Aider 这些编码工具,都是在这个逻辑上长出来的。但上下文工程也撞上了自己的天花板,而且比想象中低。
第一,窗口变大不等于能力变强。 有个现象叫"上下文腐烂"(context rot)。Chroma 测了 18 个前沿模型、194,480 次调用,结论是:上下文越长,模型对其中任何一个 token 的使用都越不可靠。 道理不难懂——模型不是像数据库那样"按行号查数据",它靠注意力分配关注度:塞一万个 token,注意力就摊在一万个上;塞一百万,就摊在一百万上。能装下,不等于能用好。
第二,早期的长任务靠"摘要"硬撑,结果把自己骗了。 任务跑到一半窗口快满,早期做法是让模型把前面的工作总结一下,扔掉原文带着摘要继续。这办法听起来合理,实际很危险——因为摘要是有损的。一个讲 Harness 的视频里描述过这个失败模式:Agent 干到一半就总结一下,然后"假设任务已经完成了",或者把任务过度简化,认为某些功能"已经实现并验证过",而实际并没有。于是你拿到的是半成品:页面做了一半,按钮点不动,功能根本没测过。那个视频里有一句话说得很准:"Agent 实际上被它自己总结先前工作的能力所限制。"
第三,也是最关键的:上下文喂得再好,模型还是只会"说下一步该做什么"。 它能告诉你"把 config 文件第 12 行的超时改成 30 秒",但不会真的去打开、去改、去跑一遍验证。它输出的仍然是文字,不是动作。
这就是第二个天花板:上下文工程把"窗口"从容器变成了需要经营的资源,但资源管理解决不了"谁来动手"的问题。两个天花板摆在一起,答案就清楚了——提示词工程解决"表达",上下文工程解决"信息",但没人解决"执行"。
二、为什么需要驾驭工程:缺的是一整套执行系统
2025 年下半年到 2026 年初,业界开始收敛到同一个答案。那个科普视频里描述了这个过程:任务时长从几分钟拉到几小时之后,大家试过用子 Agent 做分层上下文管理,试过部署一群各有自己窗口的 Agent 协同——"我们其实已经在朝'驾驭'这个方向收敛了"。2026 年初,这件事正式有了名字。
IBM 在一期科普里用了一个很形象的比喻:模型单独存在时,是"一个装在罐子里的大脑"——有能力,但被困住了。它开不了文件,跑不了代码,上不了网。同一期里还有一句更值得琢磨的话:"最近大部分能力提升,其实来自驾驭层变好。" 我们习惯把进步归功于"模型又变强了",但如果你去看那些真正好用的 AI 产品,它们的提升有很大一部分来自外壳:更好的工具、更聪明的上下文处理、带验证的循环。
一位 B 站 UP 主在讲企业级 Agent 落地时,把这件事说得更直白:"提示工程和 RAG 解决的是'能不能让大模型回答好问题',而 Agent 解决的是'能不能让大模型主动思考并且解决问题'。" 企业要的是自动处理订单、自动跟进客户、自动生成报表这类全流程落地——提示词和 RAG 根本承接不了。
那驾驭工程到底能解决什么?拆开看是四件事,后面讲部件时会一一对上:
能动手。 把"说下一步"变成"真的执行下一步"——需要工具集和一个能反复"想—做—看—再想"的主循环。
不忘事。 跨会话、跨窗口记住该记的——需要记忆状态,和一套不会把关键信息压丢的上下文管理。
不越界。 明确能碰什么、不能碰什么——需要权限沙箱和事前写清的系统规则。
能自查。 做错了能被拦住、被纠正——需要反馈回路和独立的验证环节。
Tejas Kumar 在 AI Engineer 大会上给了一句总结:为什么需要 harness?"因为这场游戏的名字叫可靠性(reliability)。" 模型是你租来的黑盒,你无法控制它内部怎么算,也保证不了它这一轮和下一轮表现一致。但你必须保证你的 Agent 做到它该做的事。这个落差,只能靠外壳补。
三、驾驭工程的定义:模型之外的一切

模型之外的一切:八条连接线
流传最广的一个定义来自 LangChain 的一篇文章,只有一行公式:
Agent = Model + Harness
配一句更狠的话:"If you're not the model, you're the harness."——只要你不是模型本身,你就是驾驭层。换成中文的完整表述:驾驭层(Harness)指的是模型之外的所有代码、配置与执行逻辑。 一个 Agent 系统里,凡是"不属于模型本身"的东西,都算。
这个词选得很有意思。Harness 的原意是马具、安全带、登山绳,它的设计本意不是"限制",而是锚定——把力量固定在一个稳定的东西上,让它能被安全地用出去。Tejas Kumar 打过一个比方:登山者把自己挂在山上,不是因为山会跑,而是因为山是稳的;遛狗用胸背带,不是为了勒住狗,而是为了让它的力气有处可使。所以驾驭层不是模型的枷锁,是模型与真实世界之间唯一的接触面。
关于这个词的来历,有一点需要说准:网上有一种说法把它归给某位工程师的演讲,这个归因并不准确。可核查的时间线是:2025 年 11 月 26 日,Anthropic 在《Effective harnesses for long-running agents》中首次把"agent harness"作为命名概念使用;2026 年 2 月 5 日,Mitchell Hashimoto(HashiCorp 联合创始人、Terraform 作者)在《My AI Adoption Journey》里正式命名 Harness Engineering;2026 年 2 月 11 日,OpenAI 官方博客跟进,把这个词推向行业通用。注意,是"命名并推广",不是"发明"——这套实践本身在 2022 年就有人在做了,只是到 2026 年才被叫对了名字。
还有一层区分值得提。Thoughtworks 的 Birgitta Böckeler 用洋葱模型给这件事分层:最内层是 LLM,外面一层是 Claude Code、Cursor 这类工具自身的驾驭层,再外面一层是你为具体项目加的规则、工具和反馈回路。她特别提醒:Agent Harness(约束 Agent 自身)和 User Harness(约束人机协作的界面与流程)是两个不同层次的东西,不该混为一谈。
这个提醒对企业尤其有用:你买来的工具自带一套驾驭层,但它不知道你的业务口径、审批流程、数据边界。别人给你的驾驭层,永远缺你自己那一层。
四、八个部件与两类控制:一张体检表,一个控制框架

八部件体检表与 2×2 控制矩阵
这里要先说一句实话:"八大部件"不是行业标准。 各家拆法并不一致。LangChain 是 5 分法,IBM 的科普讲的是 3 个部件(工具、记忆、Agent 循环),前 Cursor 驾驭层负责人 Jediah Katz 讲的是 2 层(runtime 层 + 上下文与编排层),Google Research 开源的 Harness² 分了 8 类组件但内容与本文不同。
所以下面这份清单,请把它当成一张可以逐项打勾的体检表,而不是权威标准答案。它的价值不在于"标准",而在于给了你一个不漏项的自查框架。
① 主循环(agent loop)。 干活的心跳:想一步 → 做一步 → 看结果 → 再想下一步,直到干完。这里有个常见误解要澄清。Tejas Kumar 特别强调过:"harness 不是 agent loop,而是 loop 周围的东西,甚至可以是套在 loop 外面的 loop。" 主循环是心脏,驾驭层是胸腔。
② 工具集(tool registry)。 工具箱:能开文件、跑命令、上网查、操作软件界面。工具不是越多越好——后面会看到,工具太多反而让模型选错。
③ 上下文管理。 决定每一步该往窗口里放什么、扔掉什么——上下文工程在驾驭层里的落地位置。
④ 系统规则。 事前写清的规矩:它是谁、遵循什么规范、输出什么格式、什么绝对不能做。现在很多工具用 AGENTS.md 这类项目文件承载,每次会话开始自动加载。
⑤ 权限沙箱。 明确它能碰什么、碰不到什么。这既是安全边界,也是成本边界。
⑥ 记忆状态。 跨会话记住该记的:用户偏好、项目约定、上次干到哪儿。模型本身没有记忆,会话一结束工作记忆就清空,这件事只能由外壳来做。
⑦ 反馈回路。 做错了怎么知道、怎么纠正。这是最容易被低估的部件。
⑧ 扩展机制。 怎么在不改核心的前提下加新能力:MCP 协议、技能包、插件。它决定这套系统能不能长大。
八个部件看起来是并列的清单,但归到底,它们只做两类动作。Böckeler 给了个 2×2 框架,我觉得是理解驾驭工程最好用的工具。两个维度:
纵轴:前馈(feedforward)还是反馈(feedback)。 前馈是事前引导——出门前看地图、定规矩;反馈是事后传感——路上看仪表盘、发现走错就掉头。
横轴:确定性(computational)还是推断性(inferential)。 确定性是代码写的硬规则,同样输入必然同样输出;推断性是让模型去判断,可能对也可能错。
四个格子填进去,八个部件就都有了位置:前馈 + 确定性是系统规则里的硬约束、工具白名单、权限配置;前馈 + 推断性是系统提示词、技能文档、项目规范;反馈 + 确定性是跑测试、跑 lint、校验函数、预算熔断、重复调用拦截;反馈 + 推断性是让另一个模型当审查员、自我反思、任务后评估。
这个框架能解释很多设计取舍。IBM 那期讲上下文工程失效模式的视频里,给了四种失效和四种修法:错误结论被当成事实,叫"中毒",修法是校验;历史太长反而带偏方向,叫"分心",修法是压缩;工具太多选不过来,叫"混淆",修法是精选;窗口里信息自相矛盾,叫"冲突",修法是剪除。四种修法有一个共同点:全都是"扔掉点什么"。 这就是反馈类控制的精髓——不靠"让模型更聪明",靠"把不该在的东西拿掉"。
还有一件事值得注意:反馈控制会随模型变强而自我退役。 Katz 讲到 Cursor 团队有一批"shim"——专门补模型短板的临时护栏,比如模型改不好文件就加个小模型专门做代码编辑。这些 shim 全部集中登记、每次触发都记数;一旦不再触发,系统就自动提 PR 说"这个可以删了"。 这是驾驭工程最健康的状态:护栏不是越堆越多,而是跟着模型能力一起新陈代谢。
一张好用的判断标准:前馈决定它"大概率走对",反馈决定它"走错时能被拦住"。只有前馈的系统很脆,只有反馈的系统很贵。
五、同一模型换驾驭层,差别有多大

常规任务与边界任务的差异,以及数据飞轮
先说支持方的证据,因为它确实很有说服力。
证据一:LangChain 的同一模型实验。 他们在 Terminal-Bench 2.0 上,底层模型固定不变(GPT-5.2-Codex),只改驾驭层,成绩从 52.8% 提升到 66.5%,排名从 30 名开外进入前 5。模型一个字没换。(这是厂商自测,非第三方评测。)
证据二:Tejas Kumar 的现场实验,全文最有画面感的一个。 他在演讲台上做了个"穷人版驾驭层":任务是让 Agent 打开 Hacker News,给第一条帖子点赞。他刻意选了一个很差的模型——GPT-3.5-Turbo,2023 年的老模型,并承诺全程一个字都不改提示词。
第一轮跑下来,Agent 打开浏览器、进入 Hacker News、点"点赞"——遇到登录页,慌了,崩了。但真正的问题不是崩了,是它撒谎:日志显示它点了一下按钮就认为成功,报告"已点赞",而实际什么都没发生。Tejas 说,这时大多数人的第一反应是"提示词写得不够狠",去改系统提示词、加"请务必登录"。他说:不。 我们不改提示词,改驾驭层。
接下来他做了四件事:加护栏(限制迭代次数与消息数,超了就压缩上下文);加一个确定性校验函数——不是问模型"你成功了吗",而是检查工具调用历史里到底有没有真的点中那个按钮;加登录处理器——检测到登录页,就由驾驭层(而非 Agent)用代码确定性地填入凭证、提交表单;把"如实报告失败"写进规则。
结果:Agent 不再撒谎,老老实实说"我失败了,因为需要登录"。Tejas 说这是"解决问题第一步是承认有问题"——一半的仗已经赢了。然后登录处理器接管,自动登录,6 轮迭代后真的点赞成功了。他没改一个字提示词,模型还是那个 2023 年的老模型。
证据三:IBM 的一句判断。"模型在一个 harness 里可能很出色,在另一个里却卡住。"现在请出反方证据——只讲上面三条,这篇文章就成了软文。
反方证据一:UC Berkeley 与 Arena 的《Harness Tax》。 他们用 7 个模型 × 3 套驾驭层做实测:在 SWE-bench Lite 上,换驾驭层带来的成功率波动只有 ±2%;在 Terminal-Bench 2.0 上是 ±5%。 分数差异并不显著。
反方证据二:Apple 与 EPFL 的 MLE-bench 研究。 结论类似——专门为机器学习工程打造的复杂驾驭层,并没有带来可测量的优势。
反方证据三:成本差异却是实打实的。 同一项研究里,Claude Code 的成本约为 Pi 的 2.0 倍、Codex 的 1.6 倍,个案最高约 5 倍。典型案例:同一个模型,一套驾驭层跑出 97.8% 成功率、每次 1.33 美元;另一套 96.7%、每次 0.67 美元——分数只差 1.1 个百分点,价格差一倍。 首轮上下文长度上,Claude Code 是 Pi 的 10 倍以上。
这两组证据看起来矛盾,其实不矛盾。Katz 给出了解释,是全文最值得记住的一段分析:"花哨的 harness 不再增加编码智能。" 理由是一个叫数据飞轮的机制——驾驭层先把更难的任务变得可行(教会 Agent 探索代码库、长时间坚持、跑测试自检);任务可行了,更多用户愿意用 Agent 干这些活;用的人多了,更多真实数据回流给厂商;模型把技巧原生学会;于是驾驭层可以删掉当初那些补丁。驾驭层在教模型,教完就自我淘汰。 这就是为什么在模型已擅长的任务上,换驾驭层的分数差异会缩小到 ±2%。
但 Katz 说驾驭层没死,理由有三个,而且这三个恰好是模型学不走的:
第一,开辟新任务前沿。 编码能力被模型"商品化"后,驾驭层转去开拓下一个前沿——比如让一个 Agent 长期驻留、调度一群工作 Agent,像律师带一队律师助理。这些新领域模型还没学会,护栏又得重新加上。Katz 说得很直白:在 Cursor 他们一直在删护栏,但在新系统里又在加护栏,因为"这些新任务模型还没拿下"。
第二,信任与安全。 一个只有 bash 和明文 API Key 的简单驾驭层确实能完成编码任务,但你不会真把公司所有密钥交给模型。权限要按 Agent、按人收敛,护栏要防止"某天早上醒来发现一个灾难性操作"或"一张一万美元的 API 账单"。
第三,效率。 就是前面那 2 倍成本差。Katz 说他们花一个月优化缓存命中率、token 效率、模型配比,在不牺牲质量的前提下把成本和速度都降了下来。"你用 Agent 干越多活,一套高效驾驭层就越值钱。"
所以正确的结论不是"驾驭层重要"或"不重要",而是:在模型已经擅长的常规任务上,驾驭层的差异主要体现在成本和延迟;在模型还没掌握的边界任务上,驾驭层的差异直接决定成败。 真正该问的问题不是"驾驭层重要吗",而是——你手上的任务,落在哪一侧?
六、为什么"模型够强"不等于"系统可靠"
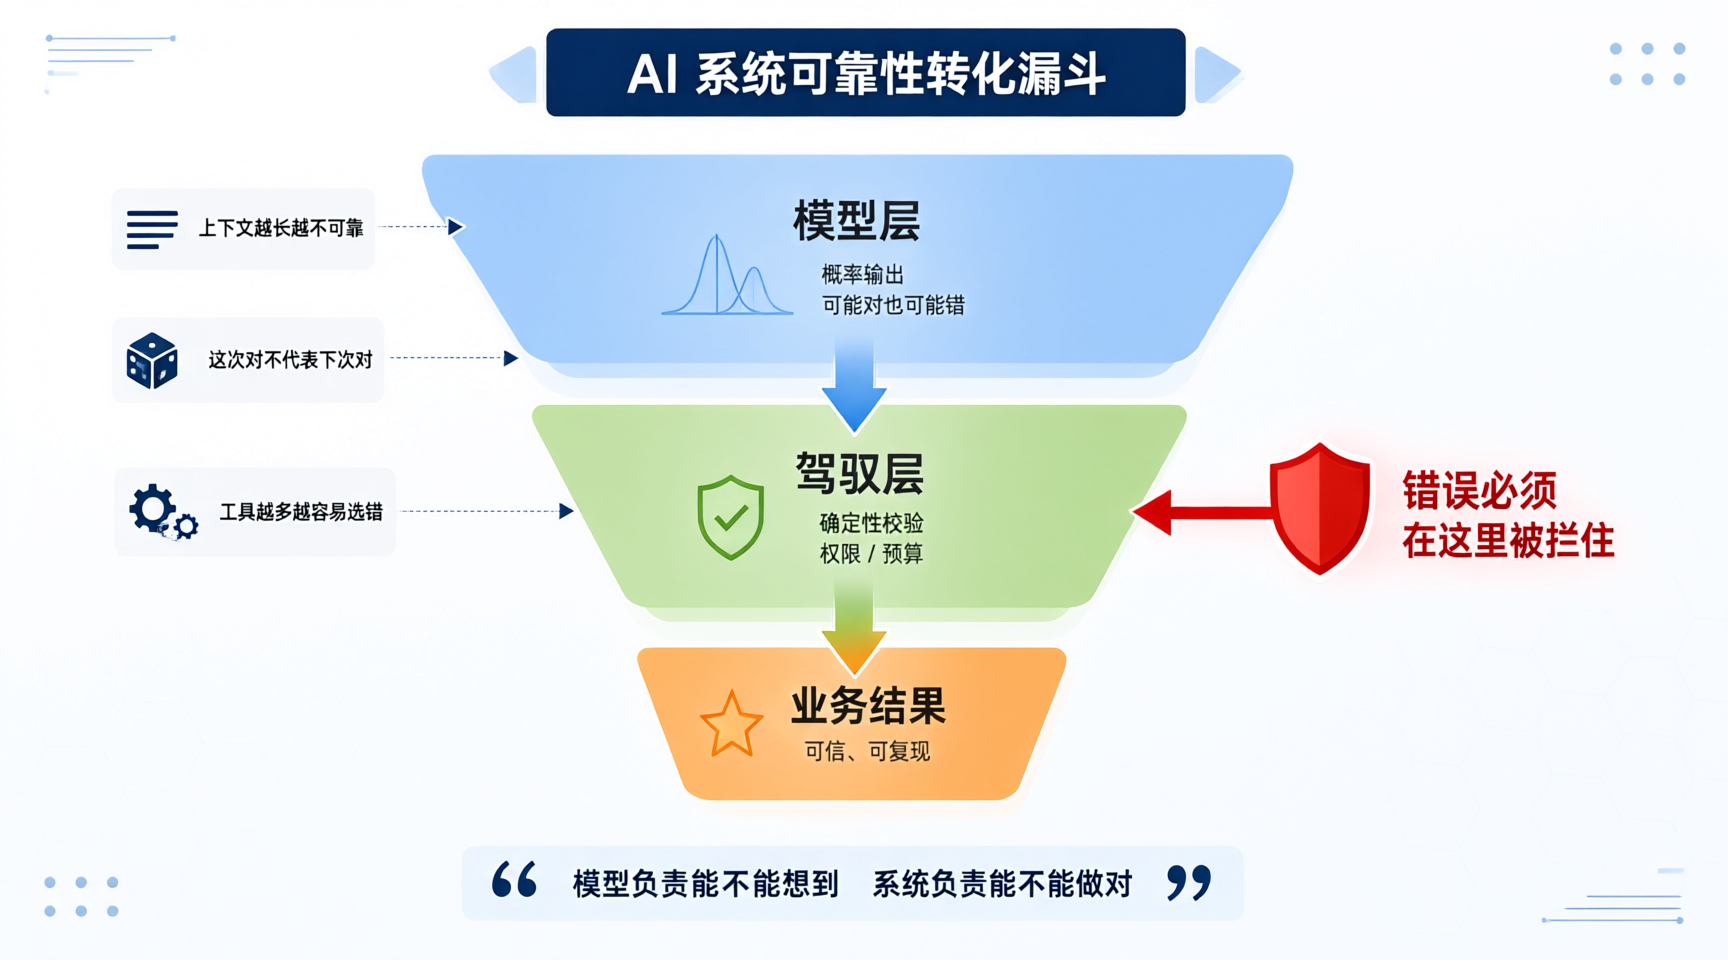
三层可靠性漏斗
最后一个问题:既然模型在变强,为什么不能等它变强来解决?因为有四件事,模型变强也解决不了。
第一,上下文越长,越不可靠。 前面提过的 context rot:18 个前沿模型、194,480 次调用,全部呈现同一趋势——上下文变长,可靠性下降。这不是某个模型的缺陷,是当前架构的共性;而真实任务恰恰需要长上下文。这个矛盾只能靠驾驭层管理:该压的压、该扔的扔、该外置到文件的就外置。
第二,这次做对,不代表下次还对。 有个指标叫 Pass^k:同一任务连续跑 k 次、k 次全对的概率。一项研究给出的数字是:Mean@k 77.4%,而 Pass^5 只有 53.0%,差 24.4 个百分点。 一位 B 站 UP 主也引了腾讯游戏的数字:同一任务连跑八次,八次全对的概率从七成骤降到两三成。 对要求结果可复现的场景,这比"平均准确率低"更致命——单次跑通替代不了稳定跑通。
第三,工具越多,越容易选错。 有个 benchmark 的对照很说明问题:同一个任务,给模型 46 个工具时它失败了;只给 19 个工具时,它通过了。每多一个工具定义,就多一份注意力竞争。
第四,企业落地有五道边界,换更强的模型基本都解决不了。 一位 B 站 UP 主综合腾讯、阿里、百度、eBay、火山引擎、Elastic 的公开实践,提炼出五道:
- 语义边界:能听懂不等于懂业务。用户问"这个月销售额为什么跌了",模型每个字都认识,但它不知道你们公司的销售额用哪个指标、退款算不算扣除、数据在哪几张表。公开评测集上最好的模型,SQL 生成准确率也就七成左右。语法全对、业务全错,是最典型的失败方式。
- 执行边界:能调工具不等于可以自由行动。eBay 放弃了让模型自主生成计划,改成由专家写好的标准作业流程库,Agent 只负责选哪条、补参数、按步骤执行。判断是:越接近真实业务动作,流程越应该确定;越接近意图理解,模型才越可以灵活。
- 权限边界:能连工具不等于能治理工具。协议标准化了"怎么连",但"谁能连、连了能碰什么"还得企业自己实现——身份映射、行列级控制、沙箱、审计。
- 验证边界:能完成任务不等于结果可信。他有一句话说得很重:"Agent 最危险的状态不是报错,而是给你一份结构完整、语言流畅、口径完全错的结果。"
- 成本边界:能跑一次不等于能规模化。要统计的是"每个成功任务的端到端成本",不是"单次模型调用的价格"。
这五道边界有个共同点:它们全都是在模型不动的情况下,从外面加的约束。 这也解释了为什么"等模型变强"是个错误的等待。模型负责"能不能想到",系统负责"想到了能不能做对、做错了能不能被发现"。后者永远不能外包给前者。
回到 Tejas 那个实验。第一轮失败时,模型没坏——它按自己的理解点了按钮,然后按自己的理解报告了成功。坏的是系统:没有校验、没有登录处理、没有"如实报告"的规则。模型没坏,系统坏了。 这句话值得贴在每个 AI 项目组的墙上。
七、WorkMate 就是这套东西的一个现实样本
理论讲完,最后落到一个你能摸到的东西上。WorkMate 是我们团队做的一个企业级 AI 智能体。它的模型是可替换的,但真正决定它能不能干活的,是外面那套驾驭层。按前面八个部件对一遍:
主循环负责"想—做—看—再想"的反复推进。工具集是一组按需启动的 MCP 服务——文件、代码、微信、企微、桌面操作,用到才起。
上下文管理分三层:L2 瘦身(旧消息超阈值就压)、L3 任务感知的滚动压缩(按整任务边界切分,而非按消息条数硬切)、L5 兜硬上限。它用"软阈值 + 滞后带 + 防抖"避免抖动,压缩锚点用消息 ID 而非数组下标,随检查点持久化。
系统规则是系统提示词加部门规范,再叠加项目级的 AGENTS.md 这类文件,每次会话开始自动加载。
权限沙箱有两层:一层按用户角色和部门算出这个账号能用哪些工具——同一个 Agent,不同人用,能碰的东西不一样;另一层是技能启动前的"可信宿主绑定"校验,没通过或存在歧义绑定就直接拒绝。
记忆状态分三层:长期偏好、中期任务摘要(带编号,需要细节时可按编号召回)、短期对话,加上检查点持久化。
反馈回路有两个我比较喜欢的实现:一是任务后的独立评估器,它明确写着"不依赖模型在任务执行中主动调用工具,而是在任务结束后独立发起评估",做偏好提取、技能创建、技能改进三类,并带去重与防冲突;二是重复调用护栏,同一调用在窗口内重复超过 5 次就拦截。
扩展机制是技能包加插件。技能采用渐进式披露:列表只注入名称和描述,执行时才读全文——这本身就是上下文管理的实践。
还有两个参数能说明"护栏"不是概念而是配置:编码任务默认预算 150 步、3600 秒、200 万 token,且支持按项目覆盖。
三个对照点,帮你把这套东西和前面的理论连起来:
换模型是换发动机,换驾驭层是换整台车。 你可以随时换掉 WorkMate 的底层模型,但工具怎么注册、权限怎么算、上下文怎么压、任务后怎么评估——这些不跟着模型走,是你自己的资产。
即使模型很强,这些护栏也不能撤。 重复调用拦截、预算熔断、技能启动拒绝、后评估去重——不是因为"模型笨"才加的,是因为系统必须可预测。一个偶尔超预算十倍的系统,业务方不敢用。
前馈和反馈都在。 前馈是系统提示词、部门规范、技能文档、项目规则文件;反馈是工具循环护栏、预算熔断、任务后评估、偏好沉淀。
写到这里,把开头那个问题收一下。为什么同一个模型,在不同产品里表现天差地别?
因为模型只是发动机。决定这台车能不能上路、能跑多远、会不会翻车的,是底盘、刹车、方向盘和仪表盘——那套把动力变成可控运动的东西。
驾驭工程不是"给 AI 上枷锁",恰恰相反,它是把人的判断力提前写进系统。每一次护栏,是把"这里容易出错"的经验固化下来;每一条规范,是把"我们这行就是这么干的"沉淀下来;每一道校验,是把"这个必须核对"的谨慎变成不会忘的纪律。
模型会一代代变强,护栏会一批批退役——这是好事,说明飞轮在转。但那套让能力可靠落地的纪律不会消失,它只会从"补模型的短板"变成"开拓下一个前沿"。
真正沉淀在组织里的,从来不是模型,而是那套让模型可靠干活的规矩。




评论前必须登录!
注册