 网硕互联帮助中心
上一篇讨论上下文压缩:把冗余文字删掉,同时保留条件、例外和引用。这次往前看一步——如果交给压缩器的候选片段本来就排错了,最值得保留的证据甚至没有进入最终上下文,再精细的压缩也救不回来。
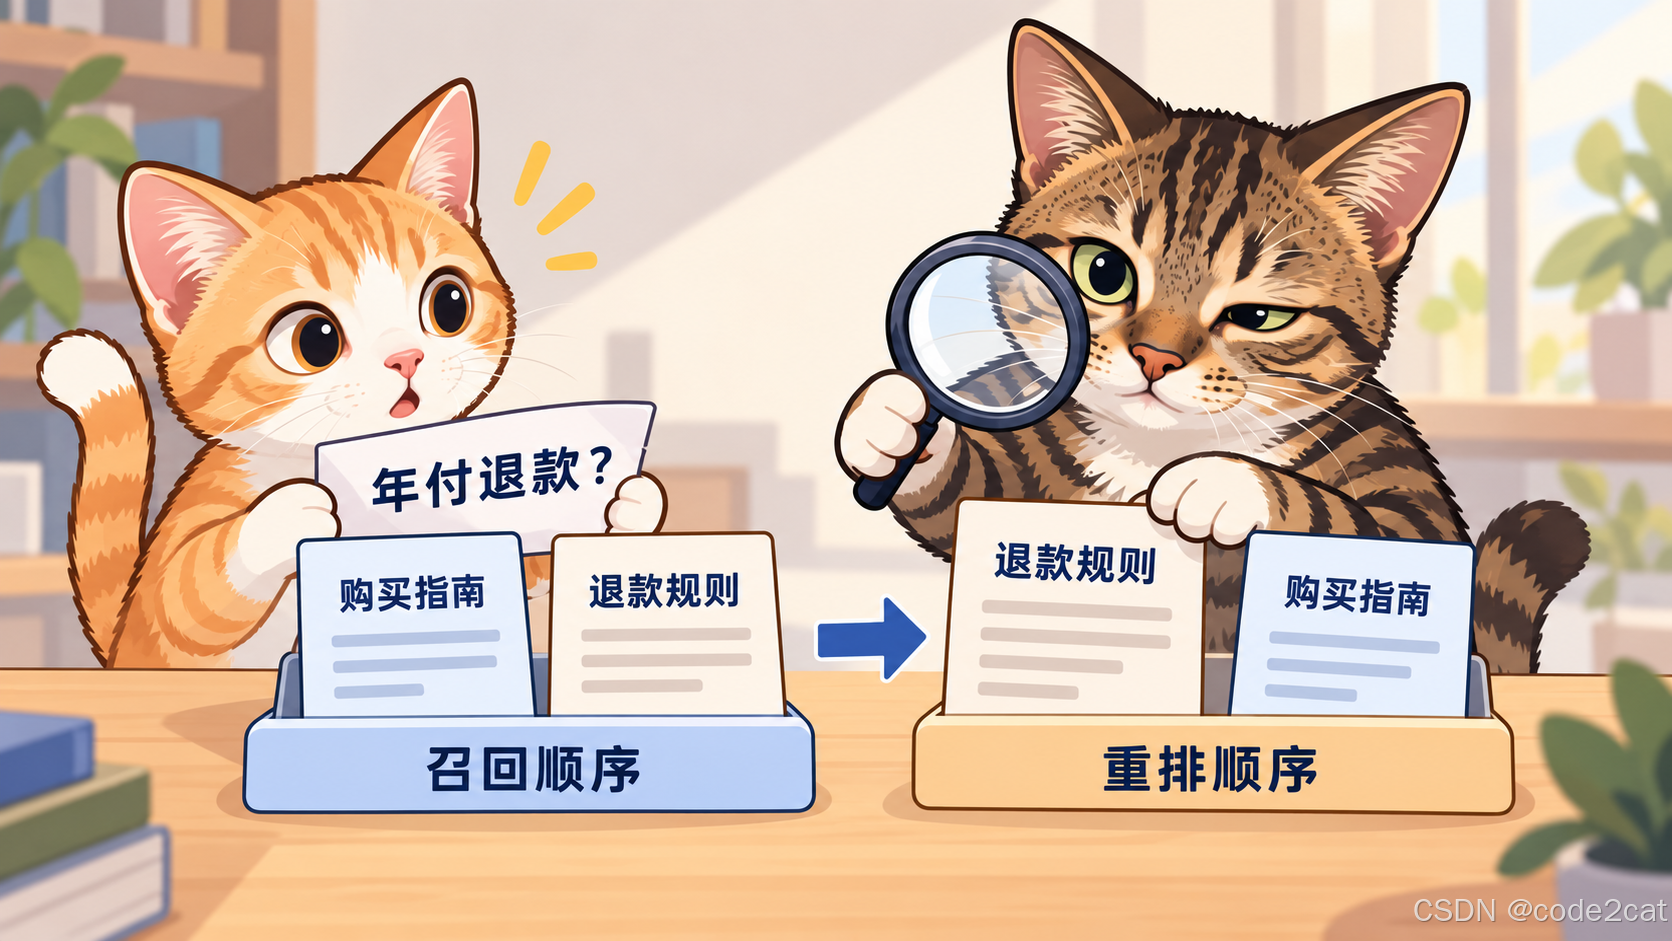
用户问“年付套餐可以退款吗”,召回第一名却是“年付套餐购买指南”,真正的退款规则排在后面。这类问题适合在召回与组装上下文之间加入重排(Reranking)。它重新比较问题与候选片段的相关性,让有限的上下文预算优先容纳有用证据。
一、重排解决的是顺序,召回决定了候选范围
一条完整检索链可以拆成:权限与业务范围约束、召回候选、去重、相关性重排、选择片段、压缩与引用、生成回答。
召回阶段面对大量文档,需要较低成本地找出候选。重排只处理这批候选,可以花更多计算去判断“这一段是否真正回答这个问题”。两阶段的职责不同,不能只看最终前几名就忽略候选是否覆盖了答案。
假设候选顺序如下:
| d1 | 年付套餐购买入口与支付方式 | 1 |
| d2 | 年付套餐退款条件和例外 | 2 |
| d3 | 另一个租户的内部退款规则 | 3 |
| d4 | 已失效的旧版退款条款 | 4 |
d1与问题共享“年付套餐”,但d2才直接涉及退款。d3和d4则不是低相关性问题:它们不符合租户或版本条件,应该被过滤,不能指望模型给低分后自然消失。
重排只能调整输入候选,不能找回没有召回的文档。 如果d2根本不在候选中,应检查切分、查询、过滤与召回覆盖率,单独换更强的重排器无法补上这个缺口。
二、双编码器与交叉编码器分别在做什么
常见的向量召回使用双编码器:文档向量可以预先计算,问题到来时计算问题向量,再搜索邻近向量。这样适合大规模候选检索。
交叉编码器把问题与一个候选片段一起输入模型,直接输出这对输入的相关性分数。联合处理可以观察问题词语与片段内容之间的关系,代价是每个候选都需要参与评分,不能像独立文档向量那样直接复用整个比较过程。Sentence Transformers的两阶段检索说明给出了这种结构。
这里不要把所有分数都理解成概率。不同模型的输出层、激活方式和训练目标不同,可能输出logit,也可能输出经过变换的值。部署时应按具体模型定义处理,不能把“0.8”跨模型解释为相同的可信程度,更不能把相关性分数当作答案正确率。
三、先把候选边界做对,再接模型
重排器接到的每条候选至少应有稳定编号、可引用原文、版本和权限上下文。把分数与这些信息绑定,后续排序才不会丢失来源。
工程上有四个容易出错的连接点:
下面先验证这些连接规则,再展示实际模型接法。这样更换模型时,权限过滤、去重和结果校验仍能沿用。
四、完整示例:候选过滤、评分与排序
示例使用Python标准库,可以直接保存为rerank_demo.py运行。数据是教学用的候选片段;fixture提供固定分数,用来检查执行流程,不代表模型测评结果。
from dataclasses import dataclass
from math import isfinite
@dataclass(frozen=True)
class Hit:
id: str
tenant: str
version: str
text: str
recall_score: float
def rerank(hits, tenant, version, scorer, top_k):
if top_k <= 0:
raise ValueError('top_k must be positive')
candidates = []
seen = set()
for hit in hits:
if hit.tenant != tenant or hit.version != version:
continue
if hit.id in seen:
continue
seen.add(hit.id)
candidates.append(hit)
if not candidates:
return []
scores = scorer([hit.text for hit in candidates])
if len(scores) != len(candidates):
raise ValueError('score count mismatch')
if any(not isfinite(s) for s in scores):
raise ValueError('invalid score')
ranked = sorted(zip(candidates, scores),
key=lambda pair: (–pair[1], pair[0].id))
return ranked[:top_k]
def main():
hits = [
Hit('d1', 't1', 'v2', 'Annual plan purchase guide', 0.92),
Hit('d2', 't1', 'v2', 'Annual plan refund rules', 0.81),
Hit('d3', 't2', 'v2', 'Private refund rules', 0.98),
Hit('d4', 't1', 'v1', 'Old refund rules', 0.95),
Hit('d2', 't1', 'v2', 'Annual plan refund rules', 0.81),
]
# Controlled fixture: tests the pipeline, not a learned model.
def fixture(texts):
assert texts == ['Annual plan purchase guide',
'Annual plan refund rules']
return [0.2, 0.9]
result = rerank(hits, 't1', 'v2', fixture, 2)
print('ranked=', [hit.id for hit, _ in result], sep='')
assert [hit.id for hit, _ in result] == ['d2', 'd1']
assert rerank([], 't1', 'v2', fixture, 2) == []
for bad in (lambda _: [0.5], lambda _: [float('nan'), 0.3]):
try:
rerank(hits, 't1', 'v2', bad, 2)
except ValueError as ex:
print('rejected:', ex)
else:
raise AssertionError('bad scores accepted')
print('checks passed')
if __name__ == '__main__':
main()
本次实际运行输出:
ranked=['d2', 'd1']
rejected: score count mismatch
rejected: invalid score
checks passed
这段程序验证了五件具体事情:跨租户片段被过滤;旧版本片段被过滤;重复d2只保留一次;排序后的第一条为d2;数量错误和NaN分数会被拒绝。空候选直接返回空列表,不额外调用评分器。
相同分数用片段编号作为次级排序条件,保证测试结果稳定。这里的编号仅承担确定性排序,不表达业务优先级;如果业务需要按来源权威性或发布时间排序,应把规则单独定义,不能通过改编号暗中实现。
真实权限通常不止tenant一个字段,还包括用户组、文档可见范围和撤权状态。这些条件应由检索服务在数据访问层执行,示例中的过滤只是最小结构。尤其不要先把未授权原文传给外部重排服务,再在结果阶段过滤。
五、把固定评分器替换为交叉编码器
主流程只要求scorer接收文本列表并返回等长的有限分数列表,因此可以换成真实模型适配器。以下采用Sentence Transformers官方模型卡中的CrossEncoder接口:
from sentence_transformers import CrossEncoder
model = CrossEncoder('cross-encoder/ms-marco-MiniLM-L6-v2')
query = 'Can I get a refund for an annual subscription?'
def model_scorer(texts):
pairs = [(query, text) for text in texts]
return model.predict(pairs).tolist()
把model_scorer传给rerank即可接入。该段需要安装sentence-transformers并下载模型;上一节验证管道逻辑,这一步接入模型推理。模型示例面向英文检索,中文业务应选择支持相应语言的模型,并用自己的标注问题集验证。
集成时应把模型名称、修订版本、输入截断配置和依赖版本固定进部署记录。升级模型可能改变分数分布,即使排序总体变好,旧阈值也不能直接视作已经验证。
如果使用远程重排API,适配器还要处理超时、限流、结果结构错误和服务不可用。失败策略要明确:允许回退原召回顺序的场景,应标记回退并保留原始排序;要求严格证据质量的场景,可以返回“当前未取得足够证据”并停止生成。不能在异常后默认把空结果当作已经证明没有答案。
六、Top K不是越小越好,证据也不止第一名
候选数量N决定重排需要处理多少对输入;最终保留K条决定上下文的规模。增大N有机会让正确证据进入重排,但增加评分工作;减小K节省上下文,却可能删除必要例外或互补说明。
例如d2写“购买后七天内可申请”,另一个片段写“已经使用专属权益的情况除外”。如果只留下d2,回答会遗漏限制。可以用同一规则的分组标识补齐相关片段,再在预算内压缩;这与上一篇保留条件和引用的要求衔接。
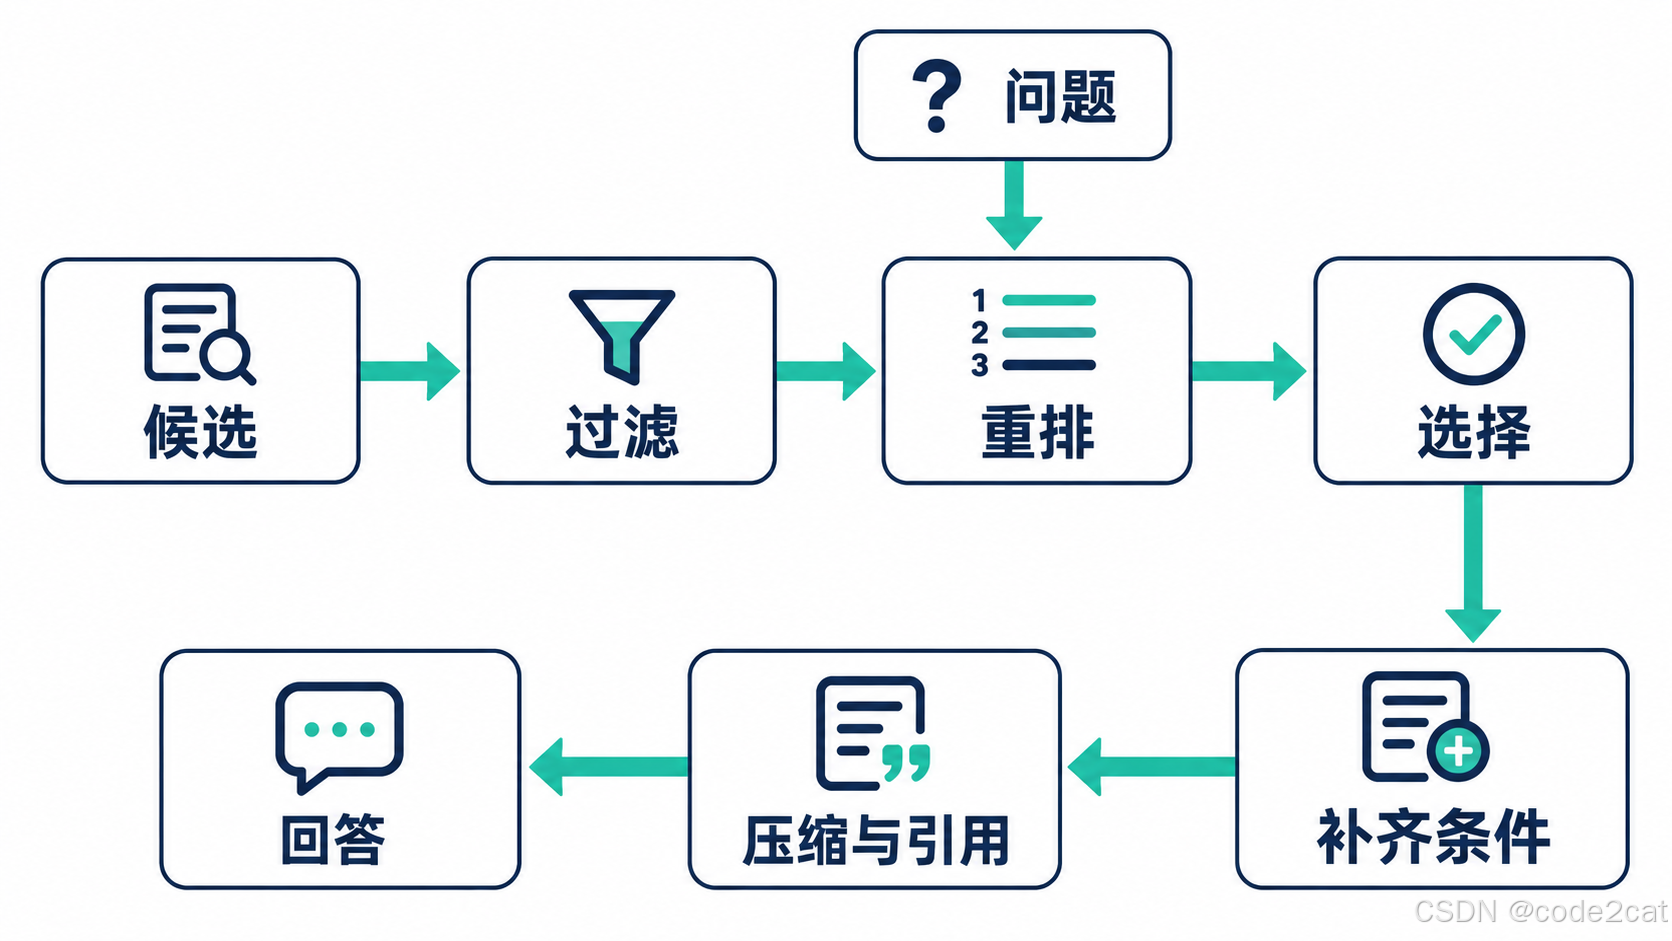
相似片段还会占用多个名额。单纯取最高K分可能得到五段重复表述,而没有覆盖用户问题的另一个子问题。应区分重复去除与多样性选择:前者合并同一片段,后者控制已选证据之间的重复程度。对于复合问题,可以按子问题分别检查证据覆盖,再合并来源。
评分器判断的是相关性,不能替代业务事实核验。标题与问题很像的广告页、过期条款和缺少来源的摘要都可能排得靠前。日期、权限、版本与来源类型应作为可解释的条件处理。
七、怎样判断重排值得加入
先准备与实际业务接近的问题及相关片段标注,保留无答案、模糊条件、长问题、近义表达和跨版本问题。评估可以分三层:
| 候选覆盖 | 正确证据是否进入N条候选 | Recall@N |
| 排序质量 | 有用证据是否来到前面 | MRR、nDCG@K、前K条覆盖 |
| 端到端效果 | 回答是否更完整且引用正确 | 条件遗漏、错误引用、延迟与成本 |
对比实验固定候选集合,先比较重排前后的顺序,才能把排序收益与召回变化区分开。随后再测完整链路,看增加评分步骤后,延迟分位数和调用成本是否符合要求。
MRR关注首个相关结果的排名,适合观察“是否迅速找到至少一条有用证据”;需要多条证据共同回答的问题,不能只靠MRR下结论。nDCG可以使用分级相关性标注,但标注标准也应稳定。最终仍要核对生成答案是否保留关键条件,而不是仅仅把检索指标提高了。
上线后保留问题、候选编号、过滤原因、模型版本、评分与选择结果的可审计记录,同时按隐私要求控制原文记录范围。这样出现答错时,能够定位到召回缺失、排序错误、预算裁剪或生成阶段,而不是只看到最后一句错误答案。
八、🧠 思维导图
#mermaid-svg-BFAszCZiGOrpeSi2{font-family:\”trebuchet ms\”,verdana,arial,sans-serif;font-size:16px;fill:#333;}@keyframes edge-animation-frame{from{stroke-dashoffset:0;}}@keyframes dash{to{stroke-dashoffset:0;}}#mermaid-svg-BFAszCZiGOrpeSi2 .edge-animation-slow{stroke-dasharray:9,5!important;stroke-dashoffset:900;animation:dash 50s linear infinite;stroke-linecap:round;}#mermaid-svg-BFAszCZiGOrpeSi2 .edge-animation-fast{stroke-dasharray:9,5!important;stroke-dashoffset:900;animation:dash 20s linear infinite;stroke-linecap:round;}#mermaid-svg-BFAszCZiGOrpeSi2 .error-icon{fill:#552222;}#mermaid-svg-BFAszCZiGOrpeSi2 .error-text{fill:#552222;stroke:#552222;}#mermaid-svg-BFAszCZiGOrpeSi2 .edge-thickness-normal{stroke-width:1px;}#mermaid-svg-BFAszCZiGOrpeSi2 .edge-thickness-thick{stroke-width:3.5px;}#mermaid-svg-BFAszCZiGOrpeSi2 .edge-pattern-solid{stroke-dasharray:0;}#mermaid-svg-BFAszCZiGOrpeSi2 .edge-thickness-invisible{stroke-width:0;fill:none;}#mermaid-svg-BFAszCZiGOrpeSi2 .edge-pattern-dashed{stroke-dasharray:3;}#mermaid-svg-BFAszCZiGOrpeSi2 .edge-pattern-dotted{stroke-dasharray:2;}#mermaid-svg-BFAszCZiGOrpeSi2 .marker{fill:#333333;stroke:#333333;}#mermaid-svg-BFAszCZiGOrpeSi2 .marker.cross{stroke:#333333;}#mermaid-svg-BFAszCZiGOrpeSi2 svg{font-family:\”trebuchet ms\”,verdana,arial,sans-serif;font-size:16px;}#mermaid-svg-BFAszCZiGOrpeSi2 p{margin:0;}#mermaid-svg-BFAszCZiGOrpeSi2 .label{font-family:\”trebuchet ms\”,verdana,arial,sans-serif;color:#333;}#mermaid-svg-BFAszCZiGOrpeSi2 .cluster-label text{fill:#333;}#mermaid-svg-BFAszCZiGOrpeSi2 .cluster-label span{color:#333;}#mermaid-svg-BFAszCZiGOrpeSi2 .cluster-label span p{background-color:transparent;}#mermaid-svg-BFAszCZiGOrpeSi2 .label text,#mermaid-svg-BFAszCZiGOrpeSi2 span{fill:#333;color:#333;}#mermaid-svg-BFAszCZiGOrpeSi2 .node rect,#mermaid-svg-BFAszCZiGOrpeSi2 .node circle,#mermaid-svg-BFAszCZiGOrpeSi2 .node ellipse,#mermaid-svg-BFAszCZiGOrpeSi2 .node polygon,#mermaid-svg-BFAszCZiGOrpeSi2 .node path{fill:#ECECFF;stroke:#9370DB;stroke-width:1px;}#mermaid-svg-BFAszCZiGOrpeSi2 .rough-node .label text,#mermaid-svg-BFAszCZiGOrpeSi2 .node .label text,#mermaid-svg-BFAszCZiGOrpeSi2 .image-shape .label,#mermaid-svg-BFAszCZiGOrpeSi2 .icon-shape .label{text-anchor:middle;}#mermaid-svg-BFAszCZiGOrpeSi2 .node .katex path{fill:#000;stroke:#000;stroke-width:1px;}#mermaid-svg-BFAszCZiGOrpeSi2 .rough-node .label,#mermaid-svg-BFAszCZiGOrpeSi2 .node .label,#mermaid-svg-BFAszCZiGOrpeSi2 .image-shape .label,#mermaid-svg-BFAszCZiGOrpeSi2 .icon-shape .label{text-align:center;}#mermaid-svg-BFAszCZiGOrpeSi2 .node.clickable{cursor:pointer;}#mermaid-svg-BFAszCZiGOrpeSi2 .root .anchor path{fill:#333333!important;stroke-width:0;stroke:#333333;}#mermaid-svg-BFAszCZiGOrpeSi2 .arrowheadPath{fill:#333333;}#mermaid-svg-BFAszCZiGOrpeSi2 .edgePath .path{stroke:#333333;stroke-width:2.0px;}#mermaid-svg-BFAszCZiGOrpeSi2 .flowchart-link{stroke:#333333;fill:none;}#mermaid-svg-BFAszCZiGOrpeSi2 .edgeLabel{background-color:rgba(232,232,232, 0.8);text-align:center;}#mermaid-svg-BFAszCZiGOrpeSi2 .edgeLabel p{background-color:rgba(232,232,232, 0.8);}#mermaid-svg-BFAszCZiGOrpeSi2 .edgeLabel rect{opacity:0.5;background-color:rgba(232,232,232, 0.8);fill:rgba(232,232,232, 0.8);}#mermaid-svg-BFAszCZiGOrpeSi2 .labelBkg{background-color:rgba(232, 232, 232, 0.5);}#mermaid-svg-BFAszCZiGOrpeSi2 .cluster rect{fill:#ffffde;stroke:#aaaa33;stroke-width:1px;}#mermaid-svg-BFAszCZiGOrpeSi2 .cluster text{fill:#333;}#mermaid-svg-BFAszCZiGOrpeSi2 .cluster span{color:#333;}#mermaid-svg-BFAszCZiGOrpeSi2 div.mermaidTooltip{position:absolute;text-align:center;max-width:200px;padding:2px;font-family:\”trebuchet ms\”,verdana,arial,sans-serif;font-size:12px;background:hsl(80, 100%, 96.2745098039%);border:1px solid #aaaa33;border-radius:2px;pointer-events:none;z-index:100;}#mermaid-svg-BFAszCZiGOrpeSi2 .flowchartTitleText{text-anchor:middle;font-size:18px;fill:#333;}#mermaid-svg-BFAszCZiGOrpeSi2 rect.text{fill:none;stroke-width:0;}#mermaid-svg-BFAszCZiGOrpeSi2 .icon-shape,#mermaid-svg-BFAszCZiGOrpeSi2 .image-shape{background-color:rgba(232,232,232, 0.8);text-align:center;}#mermaid-svg-BFAszCZiGOrpeSi2 .icon-shape p,#mermaid-svg-BFAszCZiGOrpeSi2 .image-shape p{background-color:rgba(232,232,232, 0.8);padding:2px;}#mermaid-svg-BFAszCZiGOrpeSi2 .icon-shape .label rect,#mermaid-svg-BFAszCZiGOrpeSi2 .image-shape .label rect{opacity:0.5;background-color:rgba(232,232,232, 0.8);fill:rgba(232,232,232, 0.8);}#mermaid-svg-BFAszCZiGOrpeSi2 .label-icon{display:inline-block;height:1em;overflow:visible;vertical-align:-0.125em;}#mermaid-svg-BFAszCZiGOrpeSi2 .node .label-icon path{fill:currentColor;stroke:revert;stroke-width:revert;}#mermaid-svg-BFAszCZiGOrpeSi2 :root{–mermaid-font-family:\”trebuchet ms\”,verdana,arial,sans-serif;}
RAG重排
召回候选
权限与版本过滤
去重保留来源
相关性评分
问题与片段联合输入
分数校验
选择证据
Top K与预算
压缩保留条件
评估
召回覆盖率
排序质量与延迟
九、总结
总结要点
召回决定范围,重排决定优先级。 先确认正确证据进入候选,再评估排序器是否把它提前。权限和版本是硬约束,不能交给相关性分数代替。
模型接入需要稳定的数据契约。 输入去重、分数数量、有限数值与来源保留都应校验;模型更换不应破坏这些基础规则。
最终目标是完整证据。 Top K与预算需要同时考虑互补条件、例外和引用。排序指标、回答质量与延迟成本一起看,才能判断重排是否适合当前系统。
下一篇讨论RAG混合检索:关键词与向量各自擅长什么,怎样合并候选并保留可解释的排序依据。
👉 如果你觉得这篇文章对你有所帮助,欢迎点赞、收藏、分享!😊







评论前必须登录!
注册