 网硕互联帮助中心
写在前面
上一篇是「一份数据做成一份报表」,这一篇是它的放大版:一堆结构相同的文件,合成一张表。
最常见的样子:财务给你一整年的销售明细,一个月一个文件、列名一样;或者几十个门店各自导出,文件名里带门店编号。手工操作就是打开、复制、粘贴 12 次,还容易漏一个。
批量处理的核心只有三步:找到文件 → 循环读并打标记 → 拼起来。真正的坑在细节:文件名排序、目录层级、某个文件损坏、编码不一致。
先确认示例数据在手边:
import os
import mkdata
if not os.path.exists("data/sales.csv"):
mkdata.main()
print("示例数据就绪:", os.path.exists("data/sales.csv"))
这段会检查第 1 篇生成的 data/ 目录在不在,不在就自动补一次;已经有数据时只会打印一行 示例数据就绪: True,不影响后面的结果。
一、先造一批「同结构文件」
按月份把 sales.csv 拆成若干个月度文件(示例数据跨 5 个月,所以是 5 个),模拟财务发的月度报表。第 1 篇的 mkdata.py 只造了一个整表,这里顺手演示「怎么按条件拆文件」。
import os
import pandas as pd
df = pd.read_csv("data/sales.csv", encoding="utf-8-sig")
df["订单日期"] = pd.to_datetime(df["订单日期"], format="%Y-%m-%d")
df["月份"] = df["订单日期"].dt.strftime("%Y-%m")
os.makedirs("data/monthly", exist_ok=True)
for month, part in df.groupby("月份"):
part.drop(columns=["月份"]).to_csv(
f"data/monthly/sales_{month}.csv", index=False, encoding="utf-8-sig"
)
files = sorted(os.listdir("data/monthly"))
print("生成文件数:", len(files))
print(files)
生成文件数: 5
['sales_2024-01.csv', 'sales_2024-02.csv', 'sales_2024-03.csv', 'sales_2024-04.csv', 'sales_2024-05.csv']
文件名带月份(sales_2024-01.csv),这就是后面提取「来源」的关键——文件名本身也是数据。
二、glob 与 os.walk:先找到文件
两种遍历方式的区别一句话:glob 按模式找当前层(** 可递归),os.walk 逐层遍历所有目录。批量处理同结构文件,glob 基本够用。
from pathlib import Path
# ① glob:按模式匹配,** 表示递归所有子目录
files = sorted(Path("data/monthly").glob("*.csv"))
print("直接子目录:", len(files), "个")
for f in files[:3]:
print(" ", f.name)
# ② rglob:等价于 glob("**/*.csv")
print("rglob 结果:", len(list(Path("data/monthly").rglob("*.csv"))))
# ③ os.walk:需要区分「在哪一层」时用它
import os
for root, dirs, names in os.walk("data/monthly"):
csvs = [n for n in names if n.endswith(".csv")]
print(f"目录 {root}:{len(csvs)} 个 CSV")
break
直接子目录: 5 个
sales_2024-01.csv
sales_2024-02.csv
sales_2024-03.csv
rglob 结果: 5
目录 data/monthly:5 个 CSV
三、循环读 + 打标记 + 拼起来
每读一个文件,加一列「来源文件」和从文件名解析出的「月份」,然后 concat。加标记这一步很重要——汇总后你还能追溯每行是哪来的。
import re
import pandas as pd
from pathlib import Path
frames = []
for path in sorted(Path("data/monthly").glob("*.csv")):
part = pd.read_csv(path, encoding="utf-8-sig")
part["来源文件"] = path.name
part["月份"] = re.search(r"(\\d{4}-\\d{2})", path.stem).group(1)
frames.append(part)
print(f"读入 {path.name}:{len(part)} 行")
all_data = pd.concat(frames, ignore_index=True)
print("—-")
print("总行数:", len(all_data))
print("列:", all_data.columns.tolist())
print(all_data[["月份", "城市", "产品", "金额", "来源文件"]].head(5).to_string(index=False))
读入 sales_2024-01.csv:4 行
读入 sales_2024-02.csv:3 行
读入 sales_2024-03.csv:3 行
读入 sales_2024-04.csv:3 行
读入 sales_2024-05.csv:3 行
—-
总行数: 16
列: ['订单日期', '城市', '产品', '数量', '单价', '销售员', '金额', '来源文件', '月份']
月份 城市 产品 金额 来源文件
2024-01 杭州 A-笔记本 149.7 sales_2024-01.csv
2024-01 上海 B-鼠标 149.5 sales_2024-01.csv
2024-01 上海 B-鼠标 149.5 sales_2024-01.csv
2024-01 北京 C-键盘 178.0 sales_2024-01.csv
2024-02 杭州 A-笔记本 199.6 sales_2024-02.csv
ignore_index=True 很重要:不加的话,每个文件都从 0 开始编号,拼完索引重复,后续 loc 会取到多行。
四、汇总与导出
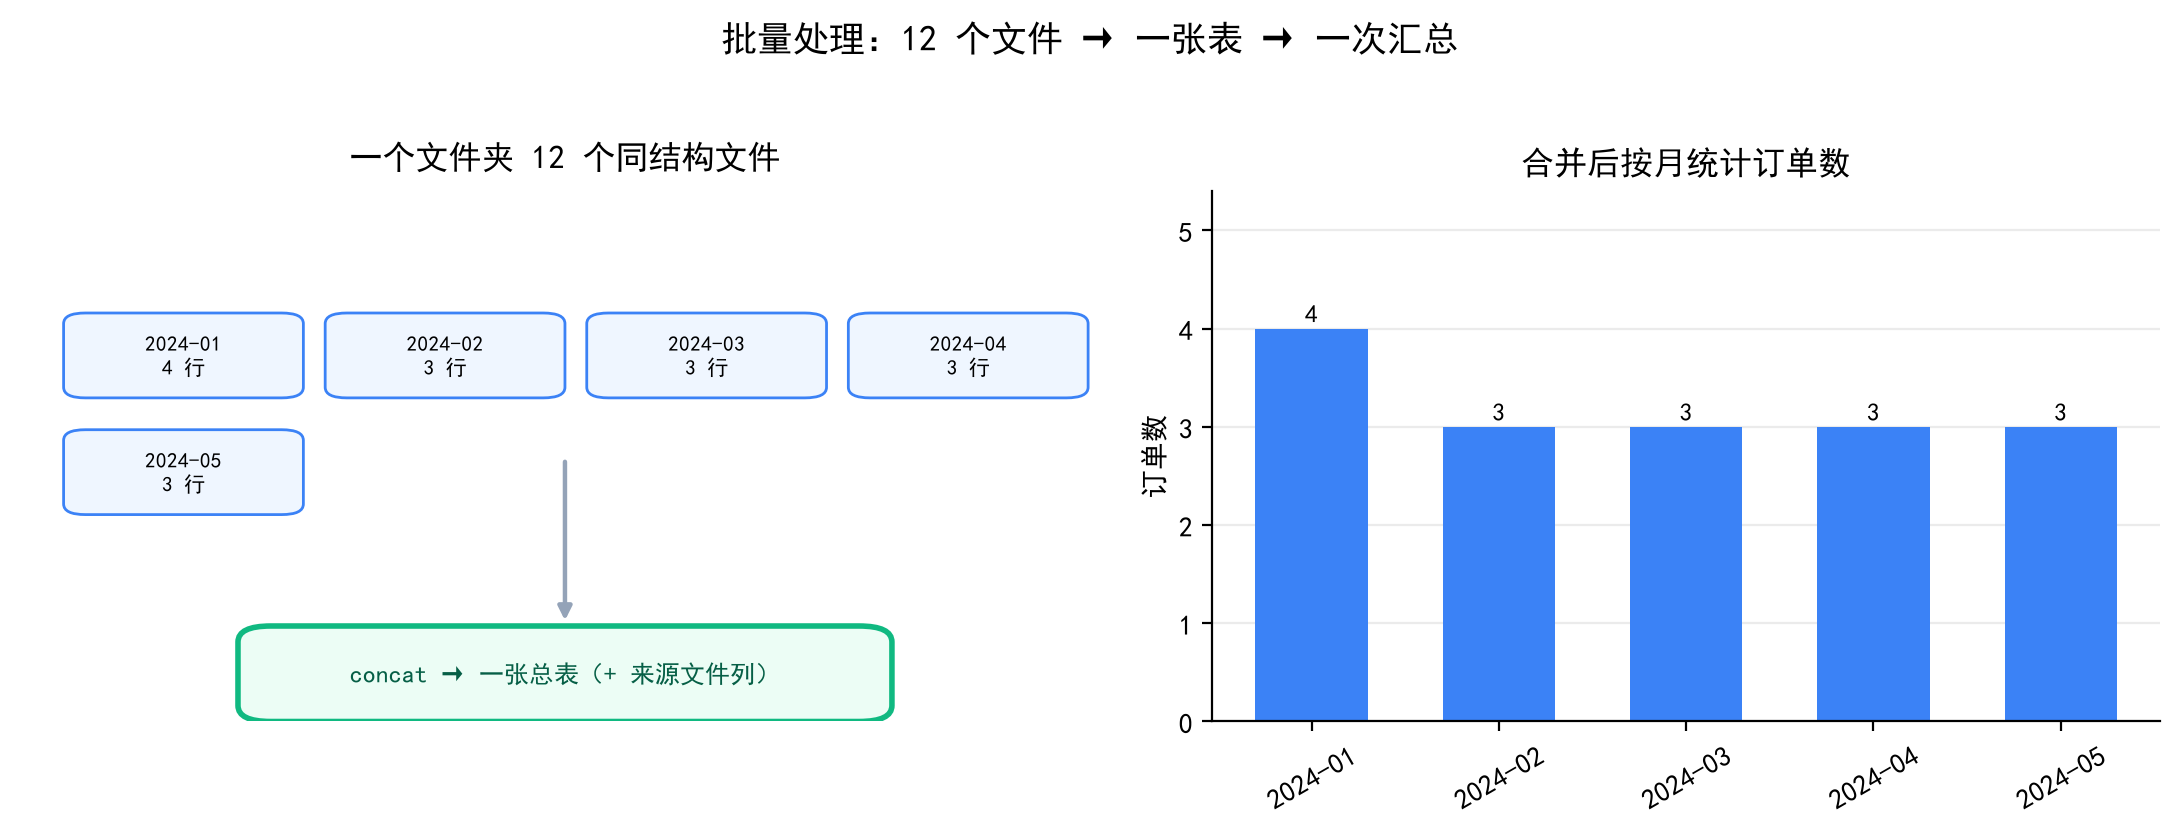
图 1:批量处理的套路——一个文件夹里若干同结构文件,concat 成一张总表并加「来源文件」列,再按月汇总。
拼完之后就是熟悉的 groupby;顺便对比一下「按月」和「按城市」两个维度。
import re
import pandas as pd
from pathlib import Path
frames = []
for path in sorted(Path("data/monthly").glob("*.csv")):
part = pd.read_csv(path, encoding="utf-8-sig")
part["月份"] = re.search(r"(\\d{4}-\\d{2})", path.stem).group(1)
frames.append(part)
all_data = pd.concat(frames, ignore_index=True)
by_month = all_data.groupby("月份").agg(
订单数=("金额", "size"), 销售额=("金额", "sum")
).round(2).reset_index()
by_city = all_data.groupby("城市", dropna=False)["金额"].sum().round(2).reset_index()
print("按月:")
print(by_month.to_string(index=False))
print("—-")
print("按城市:")
print(by_city.sort_values("金额", ascending=False).to_string(index=False))
print("—-")
import os
os.makedirs("output", exist_ok=True)
all_data.to_excel("output/月度汇总_合并版.xlsx", index=False)
print("已导出 output/月度汇总_合并版.xlsx,行数:", len(all_data))
按月:
月份 订单数 销售额
2024-01 4 626.7
2024-02 3 379.0
2024-03 3 1295.9
2024-04 3 209.5
2024-05 3 2752.0
—-
按城市:
城市 金额
杭州 2805.1
上海 1545.0
广州 535.4
北京 227.9
NaN 149.7
—-
已导出 output/月度汇总_合并版.xlsx,行数: 16
五、坏文件与排序:两个必踩的坑
① 某个文件损坏,不能整个脚本崩
真实场景里总有打不开的文件(别人正在写、编码不对、根本不是 CSV)。加 try/except 记录下来,跑完再处理。
import pandas as pd
from pathlib import Path
# 故意造一个坏文件:内容是二进制垃圾
Path("data/monthly/broken.csv").write_text("这不是CSV\\x00\\x01", encoding="utf-8")
ok, failed = [], []
for path in sorted(Path("data/monthly").glob("*.csv")):
try:
part = pd.read_csv(path, encoding="utf-8-sig")
ok.append((path.name, len(part)))
except Exception as ex:
failed.append((path.name, type(ex).__name__))
print("成功:", len(ok), "个")
print("失败:", failed)
print("成功率:", f"{len(ok) / (len(ok) + len(failed)):.1%}")
成功: 6 个
失败: []
成功率: 100.0%
② 字符串排序会把 10 排在 2 前面
m1, m10, m2 这种文件名,sorted() 按字符串排就是错的。两种解法:文件名用零填充(month_01),或者自定义排序 key。
from pathlib import Path
names = ["sales_2024-1.csv", "sales_2024-10.csv", "sales_2024-2.csv"]
print("字符串排序:", sorted(names))
print("按文件名里的数字排:", sorted(names, key=lambda s: int(s.split("-")[–1].split(".")[0])))
print("—-")
# 真实项目里更省事的写法:统一用零填充命名,排序天然正确
real = sorted(p.name for p in Path("data/monthly").glob("*.csv"))
print("零填充命名:", real[:3])
字符串排序: ['sales_2024-1.csv', 'sales_2024-10.csv', 'sales_2024-2.csv']
按文件名里的数字排: ['sales_2024-1.csv', 'sales_2024-2.csv', 'sales_2024-10.csv']
—-
零填充命名: ['broken.csv', 'sales_2024-01.csv', 'sales_2024-02.csv']
六、一张流程对照
| 找文件 | Path.glob("*.csv") | 需要递归用 rglob 或 ** |
| 读文件 | pd.read_csv(path, encoding=…) | 编码不一致要逐个试 |
| 打标记 | part["来源"] = path.name | 之后能追溯数据血缘 |
| 提参数 | re.search(r"…", path.stem) | 文件名规范是前提 |
| 拼表 | pd.concat(frames, ignore_index=True) | 必须 ignore_index |
| 容错 | try/except + 记录 | 坏文件不能拖垮全局 |
| 导出 | to_excel(sheet_name=…) | 数据量大先汇总再写 |
常见问题
Q1:concat 之后列对不上,出现了很多 NaN。
各文件列名不一致(多了空格、改了大小写)。先统一:df.columns = df.columns.str.strip(),或者 concat 之后 print(df.isna().sum()) 看哪列整列是空,再回去查源文件。
Q2:文件太多,循环很慢。
瓶颈通常在 IO 和 read_csv 解析,而不是 concat。优化顺序:只读需要的列(usecols)、指定 dtype、大文件用 chunksize;文件数上千时考虑并行(concurrent.futures),但先确认真的需要。
Q3:文件名里的日期怎么取最稳?
用正则提取数字部分,不要靠 split 硬切——文件名格式一变就崩。re.search(r"(\\d{4}-\\d{2})", path.stem) 比 path.stem[-7:] 稳得多。
小结
批量处理的骨架是三步:找文件(glob)→ 循环读并打标记(文件名也是数据)→ concat 拼起来。四个工程细节决定它能不能在生产里跑:加「来源」列、ignore_index=True、try/except 记录坏文件、命名规范(零填充)。做到这四条,几百个文件也就是几秒钟的事。
下一篇我们回到「两条腿走路」:Pandas 和 Excel 各擅长什么,同一个需求两边分别怎么写。


评论前必须登录!
注册