 网硕互联帮助中心
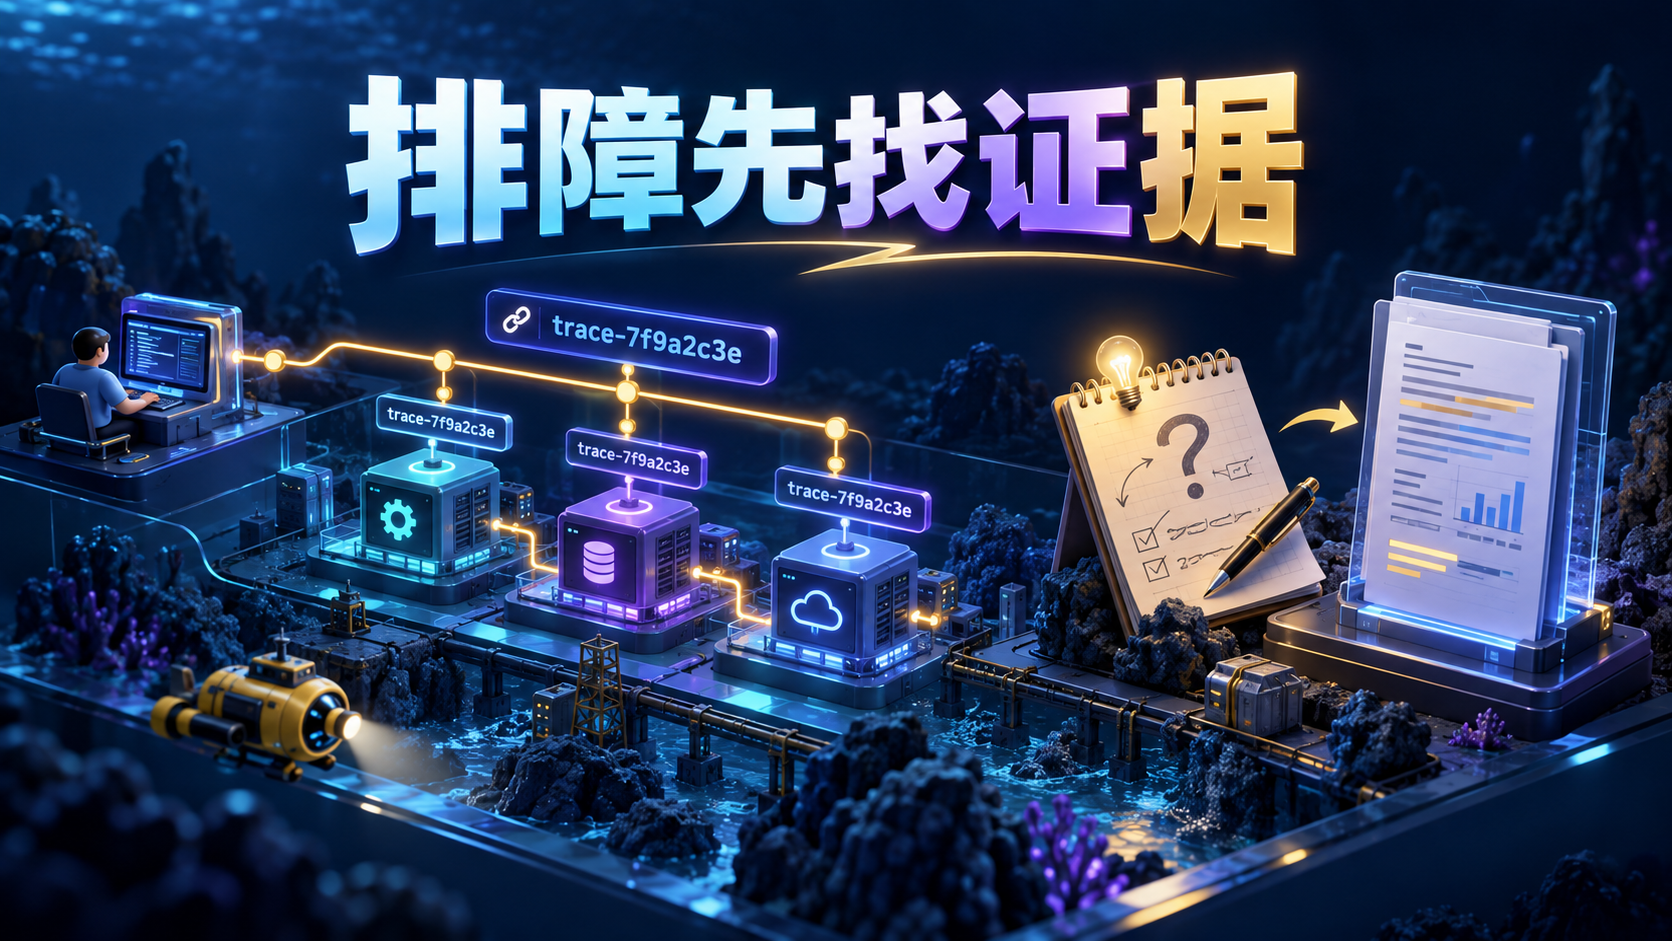
Agent看到一条慢Trace,建议“把连接池翻倍”。这句话可能碰巧正确,也可能让数据库更快耗尽连接。排障建议要有用,必须能从观察走到假设,再走到验证,而不是从一个异常数字直接跳到操作。
Trace里有什么,缺什么
OpenTelemetry把Span作为一次工作单元,Trace把相关Span串起来。父子关系、时间和事件能帮助还原请求经过的步骤,但采样、缺失埋点和跨异步边界都会影响解释。两个Span同时变慢,不足以证明其中一个导致另一个。
给Agent的输入可以缩小成三组材料:脱敏后的Span摘要;同期流量、错误与资源状态;最近变更和已知限制。不要默认把完整请求体、凭证或用户信息送进去。

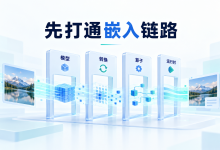
图中为教学示意,编号经过缩写,不是完整Trace ID;卡片内容不是实际故障记录。
要求它给出可反驳的假设
一份值得继续调查的回答应该长这样:
| 观察 | 请求等待连接的Span增长,SQL执行Span没有同比增长 |
| 假设 | 连接竞争可能贡献了延迟 |
| 反例 | 若等待只是埋点边界改变,连接池并未饱和 |
| 补证 | 比较活跃连接、等待队列、数据库上限与变更记录 |
| 小实验 | 在隔离环境限制并发,观察等待与错误变化 |
| 禁止动作 | 没有批准不得修改生产连接池 |
“可能贡献”不是客套。假设能被反驳,才知道下一步要收集什么证据。若缺少数据库侧信号,就写证据不足,不应补一句“经验判断就是连接池问题”。
十月的新工具能力怎样接进来
Anthropic在10月14日发布了OpenTelemetry beta。其文档区分SDK侧和API侧的追踪覆盖:客户端工具与服务端工具并不由同一侧自动完整记录。接入时要核对实际采集范围,而不是因为日志里出现Trace ID,就声称模型到生产工具已经全链路可观测。
对AI排障系统,我会把“建议”与“证据链接”分别存储。建议保留模型和输入摘要,证据保留查询条件、时间范围和脱敏规则。这样在建议失效后,仍能查明是数据缺失、推理错误,还是环境已经改变。
本文没有连接真实遥测后端,也没有验证任何根因。它提供的是证据审查流程。是否扩容、回滚或调整超时,仍应在明确影响范围后由有权限的人决定。
参考
- OpenTelemetry:Trace与Span
- Anthropic OpenTelemetry文档


评论前必须登录!
注册