 网硕互联帮助中心
目录
一、场景介绍:为什么超声 AI 的评估,不能照搬其他影像模态
1.1 评估对象的任务边界
二、指标体系构建:一个 AUC 不够用,我们需要一套"效能立方体"
2.1 维度一:诊断性能——模型"看得准不准"
2.2 维度二:操作者依赖——超声 AI 的"必答题"
2.3 维度三:基层泛化——换个地方,还能不能用
2.4 维度四:效率与卫生经济学——落地要算经济账
2.5 怎么给这些指标排座次:权重建议
三、指标数据处理:垃圾进,垃圾出——先把数据洗干净
3.1 数据来源与分层划分:先划好"训练""考试""高考"三道线
3.2 标注标准化与金标准:答案本身得是对的
3.3 数据质控与预处理:四道必做的工序
3.4 统计处理要点:别让数字骗了你
四、评估模型选取:统计工具箱与实验范式
4.1 诊断性能比较:DeLong 检验
4.2 黄金标准实验范式:MRMC 多阅片者多病例研究
4.3 跨域泛化评估模型
4.4 操作者依赖评估模型
4.5 可解释性与公平性评估
4.6 报告规范对齐
五、评估结果分析:如何读懂一份超声AI效能报告
5.1 主线一:诊断性能是否站得住
5.2 主线二:操作者依赖——AI 到底帮了谁
5.3 主线三:基层泛化——性能衰减的可接受边界
5.4 主线四:人机协同的真实收益与风险
5.5 "红黄绿"判读框架与落地决策
5.6 局限性与下一步
摘要:本文以操作者依赖与基层泛化为两条主线,提出包含诊断性能、操作者依赖、基层泛化、效率与卫生经济学的"效能立方体"指标体系,覆盖域外性能保持率、OOD拒绝率、年资分层ΔAUC等核心指标。文章依次说明三集划分、前瞻性数据、多层级标注等数据处理方法,DeLong检验、MRMC多阅片者多病例研究、分层混合模型等统计范式,以及TRIPOD+AI报告规范的对齐要点,最后给出分维度"红黄绿"判读框架。核心结论是:超声AI的价值不在专家手上的锦上添花,而在新手手上的雪中送炭,以及基层环境中的性能保持。
一、场景介绍:为什么超声 AI 的评估,不能照搬其他影像模态
如果你做过超声,一定有过这种体验:同一位患者,换个医生扫,出来的图像可能判若两人——有人切得正、病灶清清楚楚,有人扫出来的图全是噪点和声影,连边界都看不清。这不是设备的问题,而是超声这门技术自带的基因决定的。我们把它拆成三个绕不开的现实。
1. 超声是"手法成像",结果全靠手上功夫
CT、DR 一按快门,图像就定型了,谁来拍都差不多。超声不一样:探头往哪儿放、压多大力、转多少度、增益和深度怎么调、切哪个面,全靠医生当场一瞬间决定。也就是说,图像不是"拍"出来的,是"做"出来的。
更麻烦的是,B 超图像天生带着一层斑点状噪声(speckle),它和组织的种类有关,会压低对比度、糊掉边界。于是同一张图上的分割、测量,全看采集参数能不能保持一致。这也是为什么甲状腺、乳腺的 BI-RADS 分级里,不同医生之间、甚至同一个医生前后两次的判断,都可能出现明显分歧。
2. 很多高分 AI,赢在了"别人替它选好了图"
翻翻现在的超声 AI 论文,你会发现大量研究用的是"回顾性静态图库"——这些图已经被专家提前筛过一轮:最佳声窗、标准切面,全都就位了。在这种"满分考卷"上测出来的 0.95 级 AUC,听起来很漂亮,但一放进真实世界就露怯:新手扫的图、基层便携设备扫的图、带着运动伪影、声影、混响、切歪了的图,模型一下子就不会了。
有篇创伤超声 AI 的范围综述说得很直白:文献里动辄报告的 86%–100% 的敏感度,几乎都来自专家预先采集的静态图或精选视频环。它们评估的其实是一个"最优切面已经就位"的人工起点,根本反映不出从扫查到诊断这条完整流水线到底能不能跑通。
3. 下沉到基层,会遇到三道坎
全国人大代表李龙倜在 2026 年两会上点出了这个痛点:超声检查太依赖医生的手法和经验,基层超声医生缺、扫查不规范、诊断不准,结果大量检查白做了,或者不得不重复做。
拆开来看,就是三道坎:人——缺有资质的扫查人员;设备——高精度机器成本下不去;模型——碰到少见病、复杂病例就露怯。这也解释了国家卫健委 2025 年《关于促进和规范"人工智能+医疗卫生"应用发展的实施意见》为什么把"人工智能+基层应用"排在首位,提出到 2030 年基层诊疗智慧辅助应用基本全覆盖;配套的《医疗卫生强基工程实施方案》也明确要依托县域医共体推广医学影像智能辅助诊断。政策的方向很明确:超声 AI 的价值,最终要由基层来兑现。
所以,评估的问题变了
过去我们问的是:"这个模型准不准?"这其实只是第一问。
真正要紧的第二问是:当扫查的人从专家换成新手,设备从三甲的高端机换成便携探头,医院从教学医院换成乡镇卫生院,它的性能掉了多少?掉在哪个环节?能不能用工程手段补回来?
这四个字——掉在哪、怎么补——就是本文整套效能评估体系的出发点。
1.1 评估对象的任务边界
超声 AI 的评估必须"按任务说话"。结合近年获批与在研产品的功能分布,可把待评估任务划分为四类,其指标口径差异极大:
|
图像分析类(CADe/CADx) |
心脏 EF、胎儿生物参数、甲乳结节自动测量与风险分级 |
连续测量值 / 风险概率 |
区分度、校准度、测量误差 |
|
扫查引导类 |
标准切面获取指导、POCUS 操作引导、图像质量评估(IQA) |
实时引导指令 / 质量分 |
采集成功率、标准切面识别率、新手提升幅度 |
|
辅助识别类 |
甲状腺、乳腺结节良恶性鉴别与 BI-RADS/TI-RADS 分级 |
分级建议 |
敏感度、特异度、Kappa 一致性 |
|
介入操作类 |
穿刺路径规划、消融导航 |
空间坐标 |
定位误差、安全边界 |
本文以辅助识别 + 扫查引导这两类最能体现"操作者依赖"与"基层泛化"痛点的任务为主线展开,其余任务可类比套用。
下面是改写后的版本。整体思路是:先讲清楚"为什么要有这些指标",再列指标——因为读者只有理解了背后的动机,那一串英文缩写才不会变成天书。同时把术语做了"名词 + 一句大白话解释"的处理,长列表改成表格,读起来不那么喘。
二、指标体系构建:一个 AUC 不够用,我们需要一套"效能立方体"
先说一个很多团队踩过的坑:把 AUC 当成模型好坏的唯一答案。
AUC 是什么?通俗点讲,它衡量的是"模型给病人排风险,能不能把真有病的排在前面"。这个数字很重要,但它有个致命缺陷——它不告诉你问题出在哪。
举个真实的例子:一个甲状腺结节模型,在内部测试集上 AUC 高达 0.93,看着相当亮眼。可一放到基层,性能就塌了。问题来了:到底是扫查的人拍得差、算法本身扛不住、还是医生拿到建议后没用好?AUC 这个数字一个字都不会告诉你。它就像体检报告上只有一个"总分",不拆项,你根本不知道该治哪儿。
所以,超声 AI 需要的不是"一个分数",而是"一套能定位问题的仪表盘"。我们把它叫做效能立方体,从五个角度同时给模型打分。
2.1 维度一:诊断性能——模型"看得准不准"
这是地基。国际上评价临床预测模型有一套通行标准(叫 TRIPOD+AI),核心就三件事:分得清、说得准、用得上。我们逐项拆开。
(1)分得清:区分度
以"判断结节是良性还是恶性"这类二选一任务为例,光报一个 AUC 是远远不够的,至少要同时报这几项:
|
敏感度 |
真有病的,被找出来多少 |
别漏诊 |
|
特异度 |
没病的,被正确放过多少 |
别吓人 |
|
阳性/阴性预测值(PPV / NPV) |
说你有病,有多大概率真有 |
和患病率强相关 |
|
准确率 / F1 |
综合打分 |
类别不平衡时看 F1 更稳 |
|
ROC-AUC(带 95% 置信区间) |
风险排序能力 |
区间越窄越可信 |
注意两个细节:
- 多分类任务(比如 BI-RADS 2/3/4A/4B/4C/5 六级分类),除了看总体准确率,还得看每一类单独召回了多少,否则模型靠"全猜最常见那一类"也能拿到高准确率,纯属糊弄。
- 不是所有任务都是分类。如果是"把结节勾出来"的分割任务,就要用 Dice 系数、Jaccard 指数、Hausdorff 距离来衡量"画得准不准"——行业公认 Dice 超过 0.8 才算临床可用;如果是"在一整段视频里找出病灶"的检测任务,就看 Precision、Recall、F1 和 mAP(平均精度均值),比如肩关节超声的实时引导系统报告过 mAP=0.89。
(2)说得准:校准度——这一步,大多数论文都缺
这是最容易被忽视、却最要命的一项。
什么叫校准?打个比方:模型说"这个结节恶性概率 80%",那在所有它给了 80% 分的病人里,真的得癌的大概也得是八成左右。如果不一致——比如它说 80% 其实只有 30% 是真癌——那这个数字医生根本没法拿来决策。分数不真实,比分数低更可怕。
所以必须报告这些:
- 校准曲线:把"模型预测的概率"和"实际发病率"画在同一张图上,越贴近对角线越好;
- 校准斜率和截距:斜率的理想值是 1,截距的理想值是 0,偏得越远说明越不准;
- 最大校准误差 E_max 和 预期校准误差(ECE):用一个数字概括整体偏差有多大。业内新出的超声 AI 评测基准 BUST-AI Bench,已经把 ECE 列为核心考核项了。
(3)用得上:临床效用
模型再准,如果放到临床决策里没有净收益,也是白搭。这一步用决策曲线分析(DCA)来算"净获益"——简单说就是:在医生愿意接受的患病风险阈值范围内,用这个模型,到底能多救多少人、少做多少无用检查。
(4)和医生像不像:一致性
- 分类判断上,看 AI 和医生的一致程度,用 Cohen's Kappa 来衡量:大于 0.75 算高度一致,0.40–0.75 算中等。有个实际的例子——NMPA(国家药监局)的一份注册审评报告里,器械辅助医生阅片的 Kappa 是 0.8248,据此判定两种方法的结论是一致的。
- 连续数值上(比如测射血分数 EF、算孕周),用组内相关系数(ICC)。日本一项多中心手持超声研究就是用 ICC=0.81,证明 AI 的测量结果和传统双平面圆盘法是一致的。
2.2 维度二:操作者依赖——超声 AI 的"必答题"
这一维,是超声 AI 和其他影像 AI 最不一样的地方,也是本文最核心的创新点。
它的本质是问一个问题:模型的水平,会不会跟着扫查的人走? 理想的状态是——不管谁来扫,模型都能把结果拉到同一个水准,让新手靠它追平专家。
围绕"采集—判读—采纳"三个环节,我们一层层建指标。
(1)采集端:图是怎么来的
|
标准切面识别率 |
模型认出标准切面的准确率(如胸骨旁长轴 PLAX、心尖四腔 A4C) |
现代模型在内部、外部数据集上都能做到 >95% |
|
图像质量通过率 |
AI 质量模块判为"能用来诊断"的图占多少 |
创伤超声 FAST 视图充分性分类达 88.7% 准确率 |
|
操作时长 |
新手有/无 AI 引导,各要扫多久 |
肩关节研究中小住院医从 15.26 分钟降到 10.06 分钟,降了 34%,效率和专家带教相当 |
|
扫描拒绝率 |
扫出来没法用的比例 |
谷歌盲扫孕龄研究里,内罗毕站点培训 6 小时后,拒绝率从 7.9% 降到 1.8% |
这几项合起来的意思是:AI 有没有让"扫"这件事变得更标准、更快、更省心。
(2)判读端:不同年资的医生,各提升了多少
这是检验"补平效应"最直接的证据。做法很简单:把医生按年资分组(比如低年资不到 5 年、高年资 15 年以上),分别看"有 AI"和"没 AI"时的 AUC 差了多少(也就是 ΔAUC)。
如果低年资那一组涨得多、高年资那一组涨得少,甚至基本没涨——就说明 AI 真的在帮新手补短板。乳腺超声研究里就有这样的证据:AI 让低年资医生的 AUC 从 0.839 升到 0.874(P<0.001),而且 BI-RADS 4a 这类最难拿捏的肿块,判断准确率从 57.50% 提到了 73.91%。
此外还要看观察者间/内变异系数——AI 用上前后,不同医生之间、同一个医生前后的判断,是不是更一致了。一致了,说明 AI 把人为的波动压下去了。
(3)人机协同:医生和 AI 怎么相处
这里藏着两个容易被忽略的风险:
- 自动化偏倚:医生会不会因为有了 AI,就开始"无脑跟"?有意思的是,《自然·医学》2026 年的一项研究发现了一个相反的现象——急诊科医生对 AI 的输出其实挺认可,但随着用的时间变长,采纳率反而下降了,也就是"工具用久了反而不信了"。这说明采纳率要持续跟踪,不能只报一个静态数字。
- 正确否决率:医生推翻 AI 结论的时候,有多少次是翻对了的。这才是最健康的协作状态——AI 不是高高在上的裁判,而是可以被质疑的助手。胸片的一项 MRMC 多中心读者研究里,医生正确否决了 92% 的模型假阳性,且没有观察到系统性的自动化偏倚,这就是一个好的信号。
- 医生信任校准度:用"AI 有多确信"和"医生采不采纳"之间的一致程度来衡量——模型越自信医生越该听,模型犹豫时医生该多想想。
2.3 维度三:基层泛化——换个地方,还能不能用
泛化的本质,就是模型遇到"和自己学过的长得不一样的数据"(专业上叫分布漂移)时,还能不能扛住。
我们参照眼科 Reti-Pioneer 的"四重泛化"思路,从四个方向分别验证:
|
机构泛化 |
换一家医院、换一批病人 |
独立多中心外部验证是公认的"黄金标准" |
|
设备泛化 |
换厂商、换探头(高端推车机 vs 手持便携) |
日本多中心研究用手持设备 KOSMOS 采集,以高端设备的标准方法为参照 |
|
人群泛化 |
换地域、换族裔、换体型 |
母体 BMI 会影响声波衰减,直接决定胎儿结构看不看得清——这是最容易被低估的干扰因素 |
|
质量泛化 |
换图像质量(好 / 可用 / 差) |
基层的现实是"差图是常态,不是例外",模型得学会把差图里的有效信息"榨"出来,而不是简单扔掉 |
光分类不够,还要能算出来。对应四个量化指标:
最后还有一个很实用的分析技巧,叫切片发现(Slice Discovery)+ 结构化分层:把 pixel spacing、BMI 这些采集参数单独剥出来,看它们对性能的真实影响,而不是一看到性能掉,就草率地归因于"某个人群不行"。
2.4 维度四:效率与卫生经济学——落地要算经济账
技术再好,算不过账也落不了地。这一维看四件事:
- 全流程耗时:AI 跑一帧要多久 + 医生审核修改要多久。江苏省质控中心专门强调过,"平均 AI 报告等候时间"必须把这两块都算进去,才是真实的效率。胸片 AI 研究里,单份报告解读时间缩短了约 18%,也就是大约 27 秒。
- 非必要操作规避率:省了多少没必要的检查。乳腺 AI 的一个实际案例——把 15 枚 BI-RADS 4a 结节做了降级,其中 86.67% 事后证实是良性,也就是说帮这十几位病人免掉了穿刺活检。
- 危症报警命中率:每天靠 AI 揪出多少需要及时处理的危重病例。这是最能体现临床价值的数字之一。
- 基层适配成本:设备要多少钱、对算力要求高不高(能不能在普通显卡甚至手机上实时跑)、培训要多久上手。这三项直接决定产品下不下得去。
2.5 怎么给这些指标排座次:权重建议
五个维度,不可能平均用力。我们建议用 AHP(层次分析法) 或 熵权法 来科学赋权,最终合成一个"加权效能总分"。
如果目标是优先下沉基层,可以参考这样一套权重:
|
诊断性能 |
35% |
AUC 15% + 校准 10% + 一致性 10% |
|
操作者依赖稳健性 |
25% |
— |
|
基层跨域泛化 |
25% |
— |
|
效率与卫生经济学 |
15% |
— |
不过要特别提醒一句:权重不是死的,得跟着产品 intended use(预期用途)走。比如一个用在床旁分诊(POCUS)的产品,"扫得快不快、切面标得准不准"比"分级有多细"重要得多,那就该把采集端的权重大幅上调。评估体系要服务产品定位,而不是反过来。
下面是改写后的版本。这一章的改动重点是:把统计学术语翻译成"为什么必须这么做"的通俗解释,尤其是 3.4 里那几个最容易劝退人的概念(置信区间、多重比较、非劣效检验),我全部用"考试分数""连猜好几道题""差 1 天算不算失败"这类生活类比讲清楚。
三、指标数据处理:垃圾进,垃圾出——先把数据洗干净
指标体系搭好了,接下来就是数据。这一环最容易被轻视,也最容易把整个评估搞垮。
一个道理大家都听过:垃圾进,垃圾出(Garbage In, Garbage Out)。模型再先进,喂进去的是脏数据,跑出来的结论就是假的。而超声数据有它自己一套"脏法"——同一个病灶,不同医生标的不一样;图像带着病人姓名和医院水印;拿来测试的数据其实早就悄悄参与过训练……这些问题不处理,后面所有漂亮的数字都是空中楼阁。
下面按四步走,一层层治理。
3.1 数据来源与分层划分:先划好"训练""考试""高考"三道线
最重要的一条规矩:训练集、内部验证集、外部测试集,必须完全分开,谁也别碰谁。
打个比方:训练集是"上课学的例题",内部验证集是"平时的模拟考"——用它来调参数、选模型,模型会反复看它;而外部测试集是"从没见过的高考试卷",模型一次都不能提前瞄一眼。
为什么这么较真?因为内部验证集参与了调参,模型对它多少有点"背答案"。只有完全独立、甚至来自别家医院的外部测试集,才能代表真实世界。把这两类数据搅在一起,得出的 AUC 再高也是自欺欺人。
小样本情况下,可以用 K 折交叉验证——把有限的数据分成 K 份,轮流拿其中一份当"模拟考"、其余当"例题",最后把 K 次成绩平均。这样既能多利用数据,又能得到一个比较稳的内部成绩。
数据要"新鲜",尽量用前瞻性的真实世界数据。
什么叫前瞻性?就是先定好方案,再去医院实时收病人、实时扫图,而不是翻几年前的旧病历、挑几张好看的图拼个图库。后者叫回顾性,虽然好做,但水分大。
有份甲状腺超声的汇总研究(meta 分析)把两类研究对比了一下,结论很直白:前瞻性的、多中心的、带外部验证的研究,结果普遍更可信;而回顾性单中心研究,存在明显的发表偏倚和异质性——它的敏感度 I² 高达 78.3%、特异度 I² 达 82.1%。
这里插一句 I² 是什么:它衡量的是"不同研究之间的差异,有多大比例是真实差异,而不是运气"。超过 50% 就算明显异质,超过 75% 就是高度异质。78.3% 和 82.1% 意味着这些研究的结论彼此对不上,参考时要打个大大的问号。
谷歌那项盲扫孕龄研究就是个正面典型:芝加哥 + 内罗毕两个中心、多中心、前瞻性,专门让新手拿便携探头在真实场景里实时跑 AI,最后得出平均误差(MAE)4.2 天,不比临床标准的 4.5 天差。这种证据,说服力完全不一样。
病例不能只挑"好做的",也不能完全随机堆。
这里有个两难:
- 全随机收:筛查队列里得病的人本来就少,可能 1000 例里才几十例恶性的,要凑够统计效力得收几万例,不现实;
- 适度富集:把恶性比例提到 25%–50%,用相对少的样本就能把统计做扎实。
但不能为了好做而作弊——必须同时把"难例"收进来:不典型的、藏得深的、只有微小钙化的、边界模糊的病灶。否则你等于只挑"一眼癌"来测,模型分数虚高,一到临床就露馅。
3.2 标注标准化与金标准:答案本身得是对的
谁来标?怎么解决医生之间的分歧?
答案是:分层标注 + 仲裁。
具体做法:让低年资和高年资医生各自独立标注,谁也别看谁的,碰到分歧,交给第五位资深专家来拍板。业内新的评测基准 BUST-AI Bench 就是这么做的——2 名低年资(<5 年)+ 2 名高年资(>15 年)独立标,分歧仲裁。
这样做有两个好处:一是模拟真实世界里"不同医生看法不同"的现状;二是仲裁机制保证了最终的"标准答案"有权威性。
"金标准"要分级,不能一刀切。
什么叫金标准?就是用来判定模型对错的"最终依据"。不同任务,依据不同:
|
判断良性 / 恶性 |
恶性必须有病理或细胞学证实;良性要有病理,或至少 1–2 年影像随访证实是稳定的 |
|
测量类(如射血分数、孕周) |
以高端设备的标准方法为参照(比如双平面圆盘法) |
为什么要随访 1–2 年?因为良性结节不是靠一次检查定性的,要看它"一直没变"才能放心。拿一个只随访了三个月的"良性"当金标准,很可能把将来会变坏的结节放跑了。
给病例分难度:T1 / T2 / T3
用一个很实用的技巧——跨架构共识:拿两个不一样的模型去判同一个病例,按结果分成三层:
|
T1 |
两个都对 |
简单病例,谁都能做对 |
|
T2 |
一对一错 |
疑难病例,能分出模型高下 |
|
T3 |
两个都错 |
高难病例,暴露模型的真实天花板 |
这三层的用处在于:帮你精准定位模型的失效边界。如果模型在 T1 上刷到 99%、在 T3 上一塌糊涂,你就知道它的短板在哪一类病人身上,而不是被一个笼统的平均分糊住。
合规是底线:脱敏 + 协议
图像里往往嵌着病人的姓名、出生日期、医院水印——这些必须彻底脱敏。国内要守数据安全法,国际上要守 HIPAA、GDPR。多中心协作时,各家医院之间必须签数据共享协议,白纸黑字写清楚数据怎么用、谁能用、用完怎么办。
3.3 数据质控与预处理:四道必做的工序
(1)给每张图标上"好 / 可用 / 差"的质量分
这批图到底清不清楚,不能靠感觉。要给每张图一个质量等级,一方面用来训练模型的"质量感知"能力,让模型知道哪些图不值得硬判;另一方面,也方便后面按质量分层评估——好图和差图上的性能分开报,才是真实水平。
(2)专门造一批"坏图"来考模型的拒答能力
前面说过"域外拒绝率",这里就是它的数据来源:主动构造一批非诊断样本——故意劣化的图、拍错部位的图、别种模态的图,拿来测模型能不能说"这图我看不了"。一个不会拒答的模型,在临床上是危险的。
(3)严防数据泄露,一个最常见的致命错误
这一条,十个团队里可能有八个踩过坑:特征标准化、归一化,只能在训练集上"学参数",再套用到验证集和测试集上。绝对不能用全量数据(包括测试集)一起做标准化。
为什么?因为标准化需要算均值和方差,如果你连测试集一起算了,模型的调参过程就相当于间接"偷看"了考题——测试集已经不再独立了。这样测出来的性能,必然虚高。
(4)缺失值和类别不平衡
先如实报告缺失了多少数据(不能藏着),然后处理类别不平衡:常用办法有三种——分层采样(按比例从各类里抽)、代价敏感学习(把"漏诊"的代价设得更高)、加权损失(让模型更在意少数类)。
3.4 统计处理要点:别让数字骗了你
这一节是很多论文翻车的地方。三个要点,一个比一个重要。
要点一:别只报一个点,一定要报区间
AUC、敏感度、特异度、PPV、NPV,这些全部都要报 95% 置信区间(95% CI)。
什么是置信区间?打个比方:模型测出 AUC=0.90,95% CI 是 [0.85, 0.95],意思是"我们有 95% 的把握,真实水平落在 85% 到 95% 之间"。区间越窄,说明这个估计越稳;区间很宽(比如 [0.70, 0.98]),说明数据太少、估计很飘,这个点估计不值得太当真。
特别提醒:比较两个模型时,如果两个模型的 95% CI 大面积重叠,哪怕它们点估计不一样(比如 0.90 vs 0.88),也要谨慎下结论——很可能这个差距只是运气,不是真有高下。
要点二:别连猜好几道题——多重比较校正
假设你要检验 20 个年资组 × 20 个指标 = 400 次假设检验。每次检验犯"假阳性"(把没差异说成有差异)的概率是 5%。那么 400 次下来,几乎必然会出现十几个"纯属碰巧"的显著结果。这就是多重比较问题。
解决办法:Bonferroni 校正(把显著性门槛从 0.05 除以检验次数,简单粗暴但保险)或者 FDR / BH 法(控制"假阳性占所有阳性结果的比例",更适合检验次数特别多的情况)。
一句话:检验做得越多,门槛就得越严,否则迟早被"运气显著"糊弄。
要点三:别只盯着 P 值,也别把"不显著"当"没差别"
这是最容易被误解的一条。
先看前半句:报告效应量和置信区间,比只报 P 值重要得多。比如报告"ΔAUC = 0.02,95% CI [−0.01, 0.05]"——这比光说"P=0.18,不显著"有用得多,因为它告诉读者"提升幅度大概在 −1% 到 +5% 之间"。
再看后半句,也是最要命的误区:P>0.05 ≠ 两个方法等效。
很多人看到"P 不显著",就写"两种方法无差异""模型 A 等效于 B"。这是错的。P 不显著只能说"现有数据不足以证明有差异",可能是因为真没差异,也可能只是样本太少、没统计效力。把"证据不足"说成"已经证明等效",是典型的逻辑偷换。
那要证明"等效"该怎么办?用非劣效性检验:事先定好一个"能接受的差距上限"(叫界值)。比如谷歌那项孕龄研究,预设"平均误差差 1 天以内算可接受",最后模型 4.2 天 vs 标准 4.5 天,差距在界值内,于是得出"不劣于临床标准"的结论。这才是证明等效的正规做法。
四、评估模型选取:统计工具箱与实验范式
"评估模型"指用于量化与推断效能的统计学方法、实验设计与报告规范。这一层选错,再漂亮的数据也立不住。
4.1 诊断性能比较:DeLong 检验
比较同一批受试者上两个相关 ROC 曲线(如"无 AI" vs "有 AI"、或 AI vs 医生),最常用 DeLong 非参数检验。其核心是构造结构化协方差矩阵,正确处理同一测试集上多模型预测结果的相关性——协方差项正是 DeLong 的精髓,忽略它会导致标准误膨胀、检验效能下降。
实施要点:
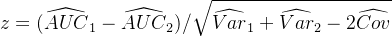 ;
实例:甲状腺结节 AI 研究中,AI 系统 AUC=0.809,高于低年资医师的 0.721(DeLong P=0.032),与高年资医师 0.865 差异无统计学意义——这组结果精准刻画了"AI 补平新手差距、逼近专家水平"的定位。
4.2 黄金标准实验范式:MRMC 多阅片者多病例研究
对于辅助诊断类 AI 产品,MRMC(Multi-Reader Multi-Case)是 FDA、NMPA、CE-MDR 三大监管共同认可的临床证据首选方案。
三层架构:
- 多阅片者(6–12 名):覆盖不同年资、不同机构类型,消除"明星医生"效应,保证外推性;
- 多病例(400–500 例):覆盖全疾病谱、不同影像表现、不同难度梯度,样本量基于功效分析确定(效能 80%–90%,α=0.025 单侧);
- 交叉对照(核心机制):每位医师在"有 AI"和"无 AI"两种模式下,独立完成同一批病例,间隔 4–6 周洗脱期(washout)消除记忆偏倚。
统计模型:采用广义线性混合模型(GLMM)/ 线性混合效应模型,把"阅片者"和"病例"作为随机效应,分解方差分量、量化异质性(I²),直接建立"AI 辅助 → 性能提升"的因果推断。对检测任务用 JAFROC(Jackknife Alternative FROC) 分析 MRMC-FROC 数据;对分类任务用 ROC / 配对 DeLong。
端点设计:可设"非劣效敏感度 + 优效特异度"的共主要终点,需做 α 多重性调整。
4.3 跨域泛化评估模型
- 域外验证分层报告:按机构、设备厂商、探头类型、人群、图像质量分层分别给出 AUC 及 CI。监管明确要求性能按亚组拆分,如 Koios DS 按超声探头频率分层分析发现 AUC 一致;
- 分布漂移量化:用最大均值差异(MMD)、KL 散度或特征空间距离量化源域与目标域的漂移程度,与性能衰减做相关分析;
- 校准迁移评估:域外数据的校准曲线、ECE、Brier Score,警惕"区分度尚可、校准崩塌";
- 微调收益曲线:横轴为"目标域标注样本量(0 / 50 / 100 / 180 例)",纵轴为域外 AUC,刻画数据高效泛化能力。
4.4 操作者依赖评估模型
- 分层混合模型:以操作者年资为固定效应、操作者为随机效应,检验"年资 × AI 辅助"交互项是否显著——若交互显著且低年资组 ΔAUC 大于高年资组,即证明 AI 补平效应;
- 配对设计:同一操作者、同一批患者、同一设备,在有/无 AI 下重复扫查与判读,把患者与硬件因素固定,孤立操作者变异;
- 学习曲线分析:跟踪新手在结构化培训 + AI 引导下的检查质量随时间/例数的提升曲线,量化"达到可接受质量所需的最少培训时长与例数"。
4.5 可解释性与公平性评估
- SHAP 值:量化影像参数(血管密度、分形维数)与临床指标对预测的贡献,验证其是否与病理生理一致;
- 公平性审计:按年龄、性别、BMI、族裔、机构层级分组,报告各组的性能极差与校准差异,呼应 TRIPOD+AI 对公平性的强调。
4.6 报告规范对齐
最终评估报告须对齐 TRIPOD+AI 声明(27 个主要条目、52 个清单条目),逐项填报:参与者流向图、各数据来源特征表、模型规格、性能估计(含关键亚组 CI)、异质性分析、模型更新、局限性、可解释性与计算环境透明度。同时参照江苏省超声 AI 质控中心提出的四大临床绩效评价角度(服务环境特征、服务过程表现、服务结果、人机协同能力)形成质控报告。
五、评估结果分析:如何读懂一份超声AI效能报告
评估跑完,真正的功夫在分析。本节给出四条分析主线与一套"红黄绿"判读框架。
5.1 主线一:诊断性能是否站得住
先看区分度:AUC 的点估计与 CI、敏感度/特异度的临床权衡。甲状腺 AI 的 meta 分析显示, pooled 敏感度 89%(95% CI 87–91%)、特异度 84%(80–88%)、AUC 0.93(0.91–0.95),且 AI 相较放射科医师的特异度绝对提升 12.2 个百分点,而敏感度基本持平——这是一个典型的"AI 提特异度、降假阳性"模式,对减少不必要穿刺价值更大。再看校准度:若校准曲线明显偏离对角线(Slope 显著<1、E_max 大),即使 AUC 高也不能直接用于临床决策,需做温度缩放(Temperature Scaling)等后处理校准。最后看 DCA:在合理的阈值概率区间内是否带来净获益。
5.2 主线二:操作者依赖——AI 到底帮了谁
这是超声 AI 最有价值的分析视角。核心判据是"补平效应":把各年资组的"无 AI"基线、"有 AI"后效能画成折线,理想的超声 AI 应让低年资组的提升斜率远大于高年资组,使两条线在"有 AI"状态下收敛。乳腺超声研究的证据正指向这一点:AI 显著提升低年资医师效能,且 AI 系统与高年资医师的 AUC 差异不显著。
要警惕两类反例:
- "零提升"陷阱:一项甲状腺 AI 临床试验让 20 名不同经验的操作者(含医学生、新手、资深医师)扫查同一批患者,结果显示 AI 辅助前后,参与者的活检推荐准确率几乎不变(69.8% vs 69.3%,P=0.75)——说明当图像采集变异未被 AI 解决时,仅给判读端一个概率分数并不能提升最终决策。这直指"采集端引导"的重要性。
- "伪稳健"陷阱:模型在专家采集的干净数据上表现完美,但在新手采集的含伪影数据上崩塌。必须用"采集端指标"(切面识别率、IQA 通过率、扫描拒绝率)与"判读端指标"联动分析,定位瓶颈究竟在上游采集还是下游算法。
5.3 主线三:基层泛化——性能衰减的可接受边界
用"四轴分层热力图"呈现:横轴为机构层级(三甲 / 县级 / 乡镇)、设备(高端 / 便携)、人群(本地 / 跨区域)、质量(好 / 可用 / 差),纵轴为各性能指标。关键观察三点:
5.4 主线四:人机协同的真实收益与风险
- 效率收益:单次检查全流程耗时、报告质量、非必要操作规避量。需把"AI 运算时间 + 医生审校时间"合并计算,避免只报 AI 自身的毫秒级推理速度;
- 采纳行为与偏倚:医生采纳率是否随使用时间下降(提示"工具疲劳"与信任漂移),是否正确否决模型错误(高正确否决率是人机协同健康的标志);
- 安全事件:全程记录不良事件,NMPA 注册试验"无不良事件发生"是安全性结论的基础。
5.5 "红黄绿"判读框架与落地决策
|
区分度 |
AUC≥0.85 且 CI 窄 |
AUC 0.75–0.85 |
AUC<0.75 或与 CI 下限低于目标值 |
|
校准度 |
Slope≈1, ECE<0.05 |
Slope 偏斜、ECE 中等 |
校准严重崩塌、预测概率不可信 |
|
操作者依赖 |
低年资提升显著、与专家收敛 |
仅部分年资受益 |
无提升或性能反而下降 |
|
基层泛化 |
域外保持率≥0.85、质量鲁棒 |
需少量微调恢复 |
跨域/跨设备严重失效 |
|
人机协同 |
正确否决率高、无自动化偏倚 |
采纳率波动 |
系统性自动化偏倚、漏诊增加 |
|
合规报告 |
对齐 TRIPOD+AI、MRMC、前瞻性 |
仅回顾性单中心 |
无外部验证、数据泄露 |
5.6 局限性与下一步
任何评估都有边界,必须诚实披露:回顾性研究的固有偏倚、前瞻样本中晚期/特殊亚组样本量不足(如盲扫孕龄研究 36 周后 MAE 升至 9.6–12.0 天)、缺乏长期间隔癌随访、未做成本效益分析。未来方向包括:更大规模多中心前瞻性验证、本地化微调与联邦学习下的隐私合规跨域训练、机器人自动探头破解"人员瓶颈"、以及把 AI 从"结论输出"推进到"参与医生思维过程"的协同范式。
【专栏目录】效能评估系列目录
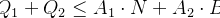
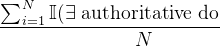

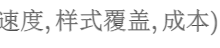


评论前必须登录!
注册