 网硕互联帮助中心
ConcurrentHashMap 的 size 与扩容机制:从分散计数到协作迁移
文章摘要
ConcurrentHashMap 新增一个键之后,需要维护元素数量,并在合适的时机判断是否扩容。多个线程同时增删元素时,它怎样避免争抢同一个计数器?baseCount、CounterCell 和 size() 又怎样参与这个过程?本文以 JDK 8 为基础,先介绍扩容的整体过程,再沿着 putVal() → addCount() → sumCount() → transfer() 解释分散计数与协作扩容,并说明为什么 size() 适合统计,却不能单独保证业务上的数量限制。
版本说明:本文讨论 JDK 8,源码核对版本为 OpenJDK jdk8u402-b06。源码片段与行号均以文末固定版本链接为准,不把 JDK 8 的内部实现推广为所有版本的规范。完整示例使用 JDK 8 语法;标注为“源码节选”或“逻辑示意”的片段用于阅读机制,不是独立程序。
运行验证:文中的 CountDemo 和 CapacityRaceDemo 均已在 Temurin OpenJDK 1.8.0_492 上编译运行,输出与正文一致。内部实现的源码分析仍以以上固定版本为准。
一、先了解 ConcurrentHashMap 的扩容机制
ConcurrentHashMap 用桶数组 table 保存键值对。每个数组位置对应一个桶,桶内可以组织为链表或树。
元素逐渐增多时,多个键落入同一个桶的机会可能增加,查询和更新的成本也可能上升。扩容就是创建更大的桶数组,把已有数据迁移过去,让数据有机会分散到更多桶中。
先区分两个概念:
| 元素数量 | 当前有多少个键值对 | map.size() 返回 10 |
| 桶数组容量 | table 数组的长度 | table.length 为 16 |
数组长度为 16,不代表最多只能放 16 个键值对:一个桶内可以有多个元素。
1. 什么时候扩容
桶数组初始化完成、且没有正在扩容时,sizeCtl 保存下一次扩容的元素数量阈值。通常按下面的关系设置:
扩容阈值 = 桶数组长度 × 0.75
桶数组长度为 16 → 阈值为 12
桶数组长度为 32 → 阈值为 24
元素计数达到或超过阈值,并进入相应的扩容检查时,就会尝试发起扩容。达到最大容量等条件会限制这一过程。
这里先介绍根据元素计数触发扩容的主线。桶内冲突严重、进入树化判断等场景,也可能走到扩容路径,后文会补充。
2. 怎么扩容
单轮桶数组扩容的主要过程是:
满足扩容条件
↓
通过 CAS 争取发起扩容
↓
创建长度为原来两倍的新桶数组
↓
参与线程领取任务,迁移不同范围的桶
↓
确认迁移完成,切换 table 并更新扩容阈值
例如,一轮扩容可以把桶数组从 16 扩到 32。迁移过程中,其他符合条件的更新线程可以协助工作,不必始终由一个线程独自完成。[1]
扩容需要参考元素数量,但多个线程同时增删元素时,ConcurrentHashMap 怎样高效地维护这个数量?先从“为什么不能只用一个 size 变量”说起。
二、为什么不能只用一个 size 变量
最直接的想法是保存一个共享变量,新增元素时执行:
// 错误的共享计数示意:普通 ++ 不能保证并发更新安全。
size++;
++ 包含读取、加一、写回。两个线程可能都读到 10,分别计算 11,再写回 11,导致一次增量被覆盖。
改用 CAS 可以避免这种丢失更新的问题。CAS 可以理解为“只有当前值仍与预期一致,才执行替换”,失败时重试。
但如果所有线程仍然修改同一个变量,就会竞争同一个内存位置。线程多、更新频繁时,CAS 失败重试以及缓存一致性开销都可能增加。
因此,JDK 8 ConcurrentHashMap 采用了分散计数的思路:
竞争较小时使用基础计数器;竞争出现后,把更新分散到多个计数单元,查询时再汇总。
这里分散的是“数量变化”,键值对本身仍然保存在桶数组中。
三、baseCount 和 CounterCell 分别是什么
1. baseCount:基础计数器
baseCount 是一个 volatile long 字段,更新主要通过 CAS 完成。没有建立计数 Cell 数组时,线程会先尝试更新它。[1]
例如,没有并发竞争时:
初始状态 baseCount = 0
新增键 A baseCount = 1
新增键 B baseCount = 2
用新值覆盖键 A baseCount = 2
成功删除键 B baseCount = 1
这里统计的是键值对数量。覆盖已有键的值没有增加键值对,因此不会把计数加一;删除不存在的键也不会把计数减一。
2. CounterCell:分散保存数量变化
当基础计数器的更新出现竞争时,线程可能进入 fullAddCount(),建立或使用 CounterCell[]。单个 Cell 的核心字段是:
// JDK 8 源码节选:省略填充注解与构造方法。
static final class CounterCell {
volatile long value;
}
Cell 不保存键值对,也不保存“这个线程一共执行过多少次”。它保存的是分散累计的数量变化,新增和删除都可以更新它。
比如先前已经累计了 10 个元素,之后的变化分散记录:
baseCount = 10
线程 A 新增一个键 → Cell0 +1
线程 B 新增一个键 → Cell1 +1
线程 C 新增一个键 → Cell0 +1
线程 A 删除一个键 → Cell0 -1
Cell0 = 1,Cell1 = 1
总计数 = 10 + 1 + 1 = 12
有了 Cell 之后,baseCount 不再必然等于总数量,但它仍然是总计数的一部分。 它也不是转成 Cell 模式后就绝对不再更新,fullAddCount() 的部分竞争路径仍会尝试回退更新它。[1]
3. 线程与 Cell 不是一对一关系
线程会根据自己的探针值选择一个 Cell,选择方式类似:
// JDK 8 逻辑示意:cells 表示当前 CounterCell 数组。
int index = ThreadLocalRandom.getProbe() & (cells.length – 1);
getProbe() 是 JDK 内部方法,不是业务代码可以直接使用的公共 API。
多个线程可能选中同一个 Cell,因此对 Cell 的值也需要使用 CAS 更新。冲突时可以调整探针,重新选择位置;持续竞争时,还可能扩大 Cell 数组。
所以要记住三个边界:
- Cell 不属于某个线程独享,也不保证线程始终更新同一个 Cell。
- Cell 与哈希桶没有对应关系,不能把它看成某一批桶的元素数量。
- Cell 的值是增减累计结果,可以为负,不能把每个 Cell 都理解为独立容器的大小。
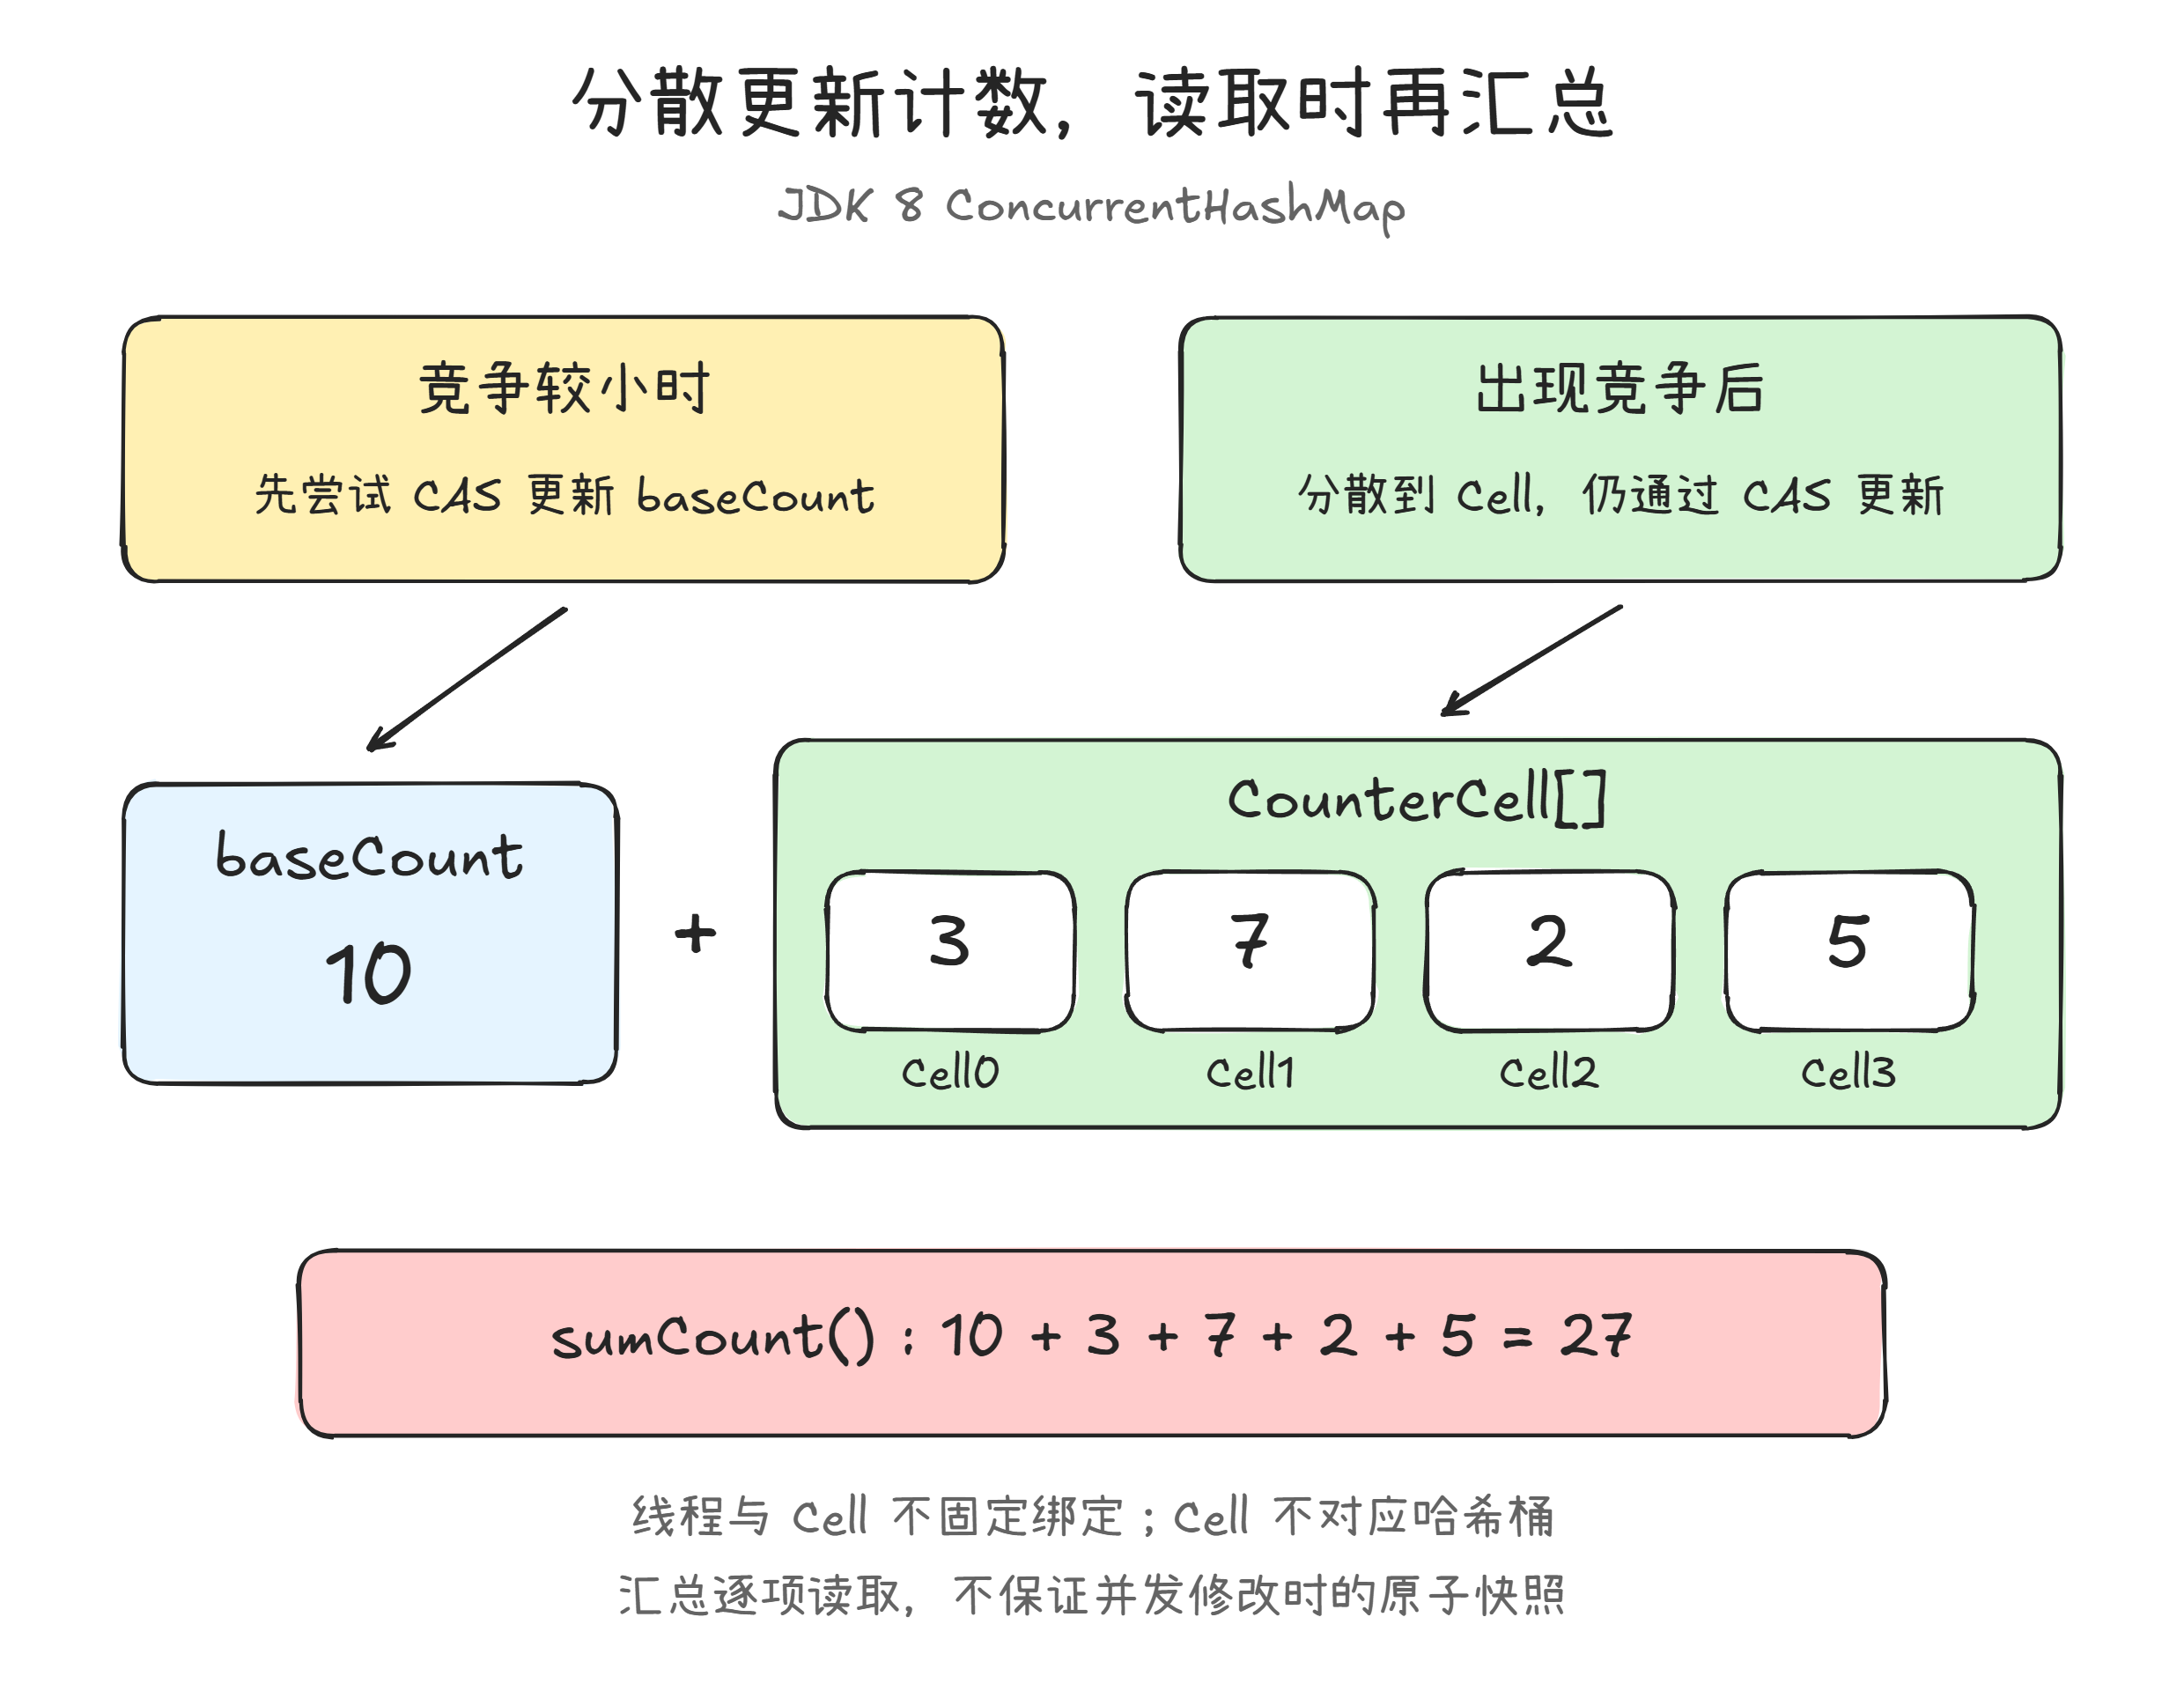
图 1:baseCount 与各个 Cell 一起构成总计数。箭头表示可能的更新路径,不表示线程与 Cell 固定绑定。
四、size() 怎样得到元素数量
1. 从 size() 跟到 sumCount()
JDK 8 的 size() 调用 sumCount(),然后将结果处理成 int:
// JDK 8 源码节选。
public int size() {
long n = sumCount();
return ((n < 0L) ? 0 :
(n > (long)Integer.MAX_VALUE) ? Integer.MAX_VALUE :
(int)n);
}
sumCount() 的核心是把基础计数和所有非空 Cell 相加:
// JDK 8 源码节选。
final long sumCount() {
CounterCell[] as = counterCells;
CounterCell a;
long sum = baseCount;
if (as != null) {
for (int i = 0; i < as.length; ++i) {
if ((a = as[i]) != null) {
sum += a.value;
}
}
}
return sum;
}
也就是:
总计数 = baseCount + Cell0.value + Cell1.value + …
它不需要遍历所有键值对,但也不能一概说成只读取一个变量:有 Cell 数组时,需要遍历该计数数组。size() 返回 int,超过 Integer.MAX_VALUE 时返回这个上限;mappingCount() 返回 long,但同样不保证并发更新期间的原子快照。[1][2]
2. 为什么汇总不是原子快照
每个字段的读取可以得到一个值,但“先读取基础计数,再依次读取多个 Cell”不是一个整体原子操作。其他线程可以在这些读取之间增删元素。
为便于观察,假设 baseCount 为 0,只有两个 Cell:
| ① | 无 | 3 | 7 | 10 | 读到 Cell0 = 3 |
| ② | 删除一个键,完成计数减一 | 2 | 7 | 9 | 尚未读取 Cell1 |
| ③ | 新增一个键,完成计数加一 | 2 | 8 | 10 | 尚未读取 Cell1 |
| ④ | 无 | 2 | 8 | 10 | 读到 Cell1 = 8 |
统计线程返回 3 + 8 = 11,而这些计数器的实际总和依次为 10 → 9 → 10,没有出现过 11。
这就是“汇总不是整体快照”:读到的值可能来自不同时间。
另外,插入节点与更新计数本身也是先后发生的步骤,并不是把整个 Map 和计数器同时原子地更新。即使没有 Cell,也不能据此把元素存储与数量读取理解成一个整体事务。
这不表示计数更新会随意丢失。 在所有相关增删操作都完成、通过 join() 等方式等待线程结束,且没有继续并发修改时,汇总能得到准确数量;size() 还需要考虑 int 的返回范围。官方文档也明确说明,并发更新期间的 size()、isEmpty() 等结果适合监控或估算,不适合直接承担程序控制条件。[2]
3. 一个可运行的计数例子
下面的程序先让四个线程插入不同的键,再等待它们结束后读取数量:
// 适用 JDK 8,文件名:CountDemo.java。
import java.util.concurrent.ConcurrentHashMap;
public class CountDemo {
public static void main(String[] args) throws InterruptedException {
ConcurrentHashMap<Integer, Integer> map = new ConcurrentHashMap<>();
Thread[] workers = new Thread[4];
for (int t = 0; t < workers.length; t++) {
final int start = t * 1000;
workers[t] = new Thread(() -> {
for (int i = 0; i < 1000; i++) {
map.put(start + i, i);
}
});
workers[t].start();
}
for (Thread worker : workers) {
worker.join();
}
System.out.println("after inserts = " + map.size());
map.put(0, –1);
System.out.println("after overwrite = " + map.size());
map.remove(0);
System.out.println("after remove = " + map.size());
}
}
输出为:
after inserts = 4000
after overwrite = 4000
after remove = 3999
这个例子验证的是“增删完成后的数量”以及“覆盖已有键不增加数量”。它不保证触发某个 Cell 分配结果,也不用于证明并发读取时一定出现某个不准确的数字。
五、插入后,计数怎样参与扩容判断
1. putVal():先插入,再更新计数
普通 put() 的主线是:
put(key, value)
↓
putVal(key, value, false)
↓
找到桶,插入新键,或更新已有键
↓
新增键时调用 addCount(1L, binCount)
putVal() 中,如果只是覆盖已有键的值,会返回旧值,不走末尾的新增计数。成功插入新键后,才调用 addCount(1L, binCount)。[1]
2. addCount():先记账,再决定是否检查
addCount(long x, int check) 的两个参数承担不同职责:
| x | 本次数量增量,新增通常为 1,成功删除为 -1 |
| check | 控制是否进入扩容检查;普通 put 传入桶遍历相关的 binCount |
前半部分源码如下,省略了后续扩容协调代码:
// JDK 8 源码节选:展示计数更新与提前返回的条件。
CounterCell[] as;
long b, s;
if ((as = counterCells) != null ||
!U.compareAndSwapLong(this, BASECOUNT,
b = baseCount, s = b + x)) {
CounterCell a;
long v;
int m;
boolean uncontended = true;
if (as == null || (m = as.length – 1) < 0 ||
(a = as[ThreadLocalRandom.getProbe() & m]) == null ||
!(uncontended =
U.compareAndSwapLong(a, CELLVALUE, v = a.value, v + x))) {
fullAddCount(x, uncontended);
return;
}
if (check <= 1) {
return;
}
s = sumCount();
}
// 后续:check >= 0 时进入扩容条件检查。
可以按下面几条路径阅读:
后续检查还有 check >= 0 的条件。删除通常传入负数,因此会更新计数,但不通过这条路径发起扩容;删除也不会自动让桶数组缩容。
因此,新增计数不等于每次都扫描 Cell,更不等于每次都必须执行扩容判断。 check 也不是“线程竞争次数”,而是调用方提供的检查控制参数。[1]
3. sizeCtl:正常状态下保存扩容阈值
当桶数组已初始化、没有正在扩容时,可以把元素数量的检查概括为:
计数 s >= sizeCtl
并且 table 存在、长度小于最大容量
↓
尝试通过 CAS 发起扩容
例如:
table.length = 16
sizeCtl = 12
汇总计数 s = 12
条件满足 → 尝试发起本轮扩容
“尝试”很关键:另一个线程可能已经先修改了控制状态,当前线程还要根据最新状态决定下一步。
sizeCtl 在不同阶段有不同含义:
| 桶数组尚未初始化 | 为 0 时采用默认初始化策略;正数可保存待初始化的容量信息 |
| 正在初始化 | 为 -1 |
| 已初始化,且没有正在扩容 | 正数,表示下一次扩容的元素数量阈值 |
| 正在扩容 | 负数,编码本轮扩容标记及参与线程的协调信息 |
不要把扩容期间的负值直接解释成一个普通阈值,也不要简单用负值的绝对值当作工作线程数。扩容状态使用了位编码,需要结合 resizeStamp() 和移位常量理解。[1]
六、达到阈值后,多个线程怎样完成扩容
1. 发起扩容:创建 nextTable
在 addCount() 的相应路径中,线程通过 CAS 把 sizeCtl 改为本轮扩容状态;成功的线程调用 transfer(tab, null)。
transfer() 发现还没有新数组时,创建长度为 n << 1 的数组,也就是原长度的两倍,并保存到 nextTable。随后设置 transferIndex,让参与线程领取迁移任务。[1]
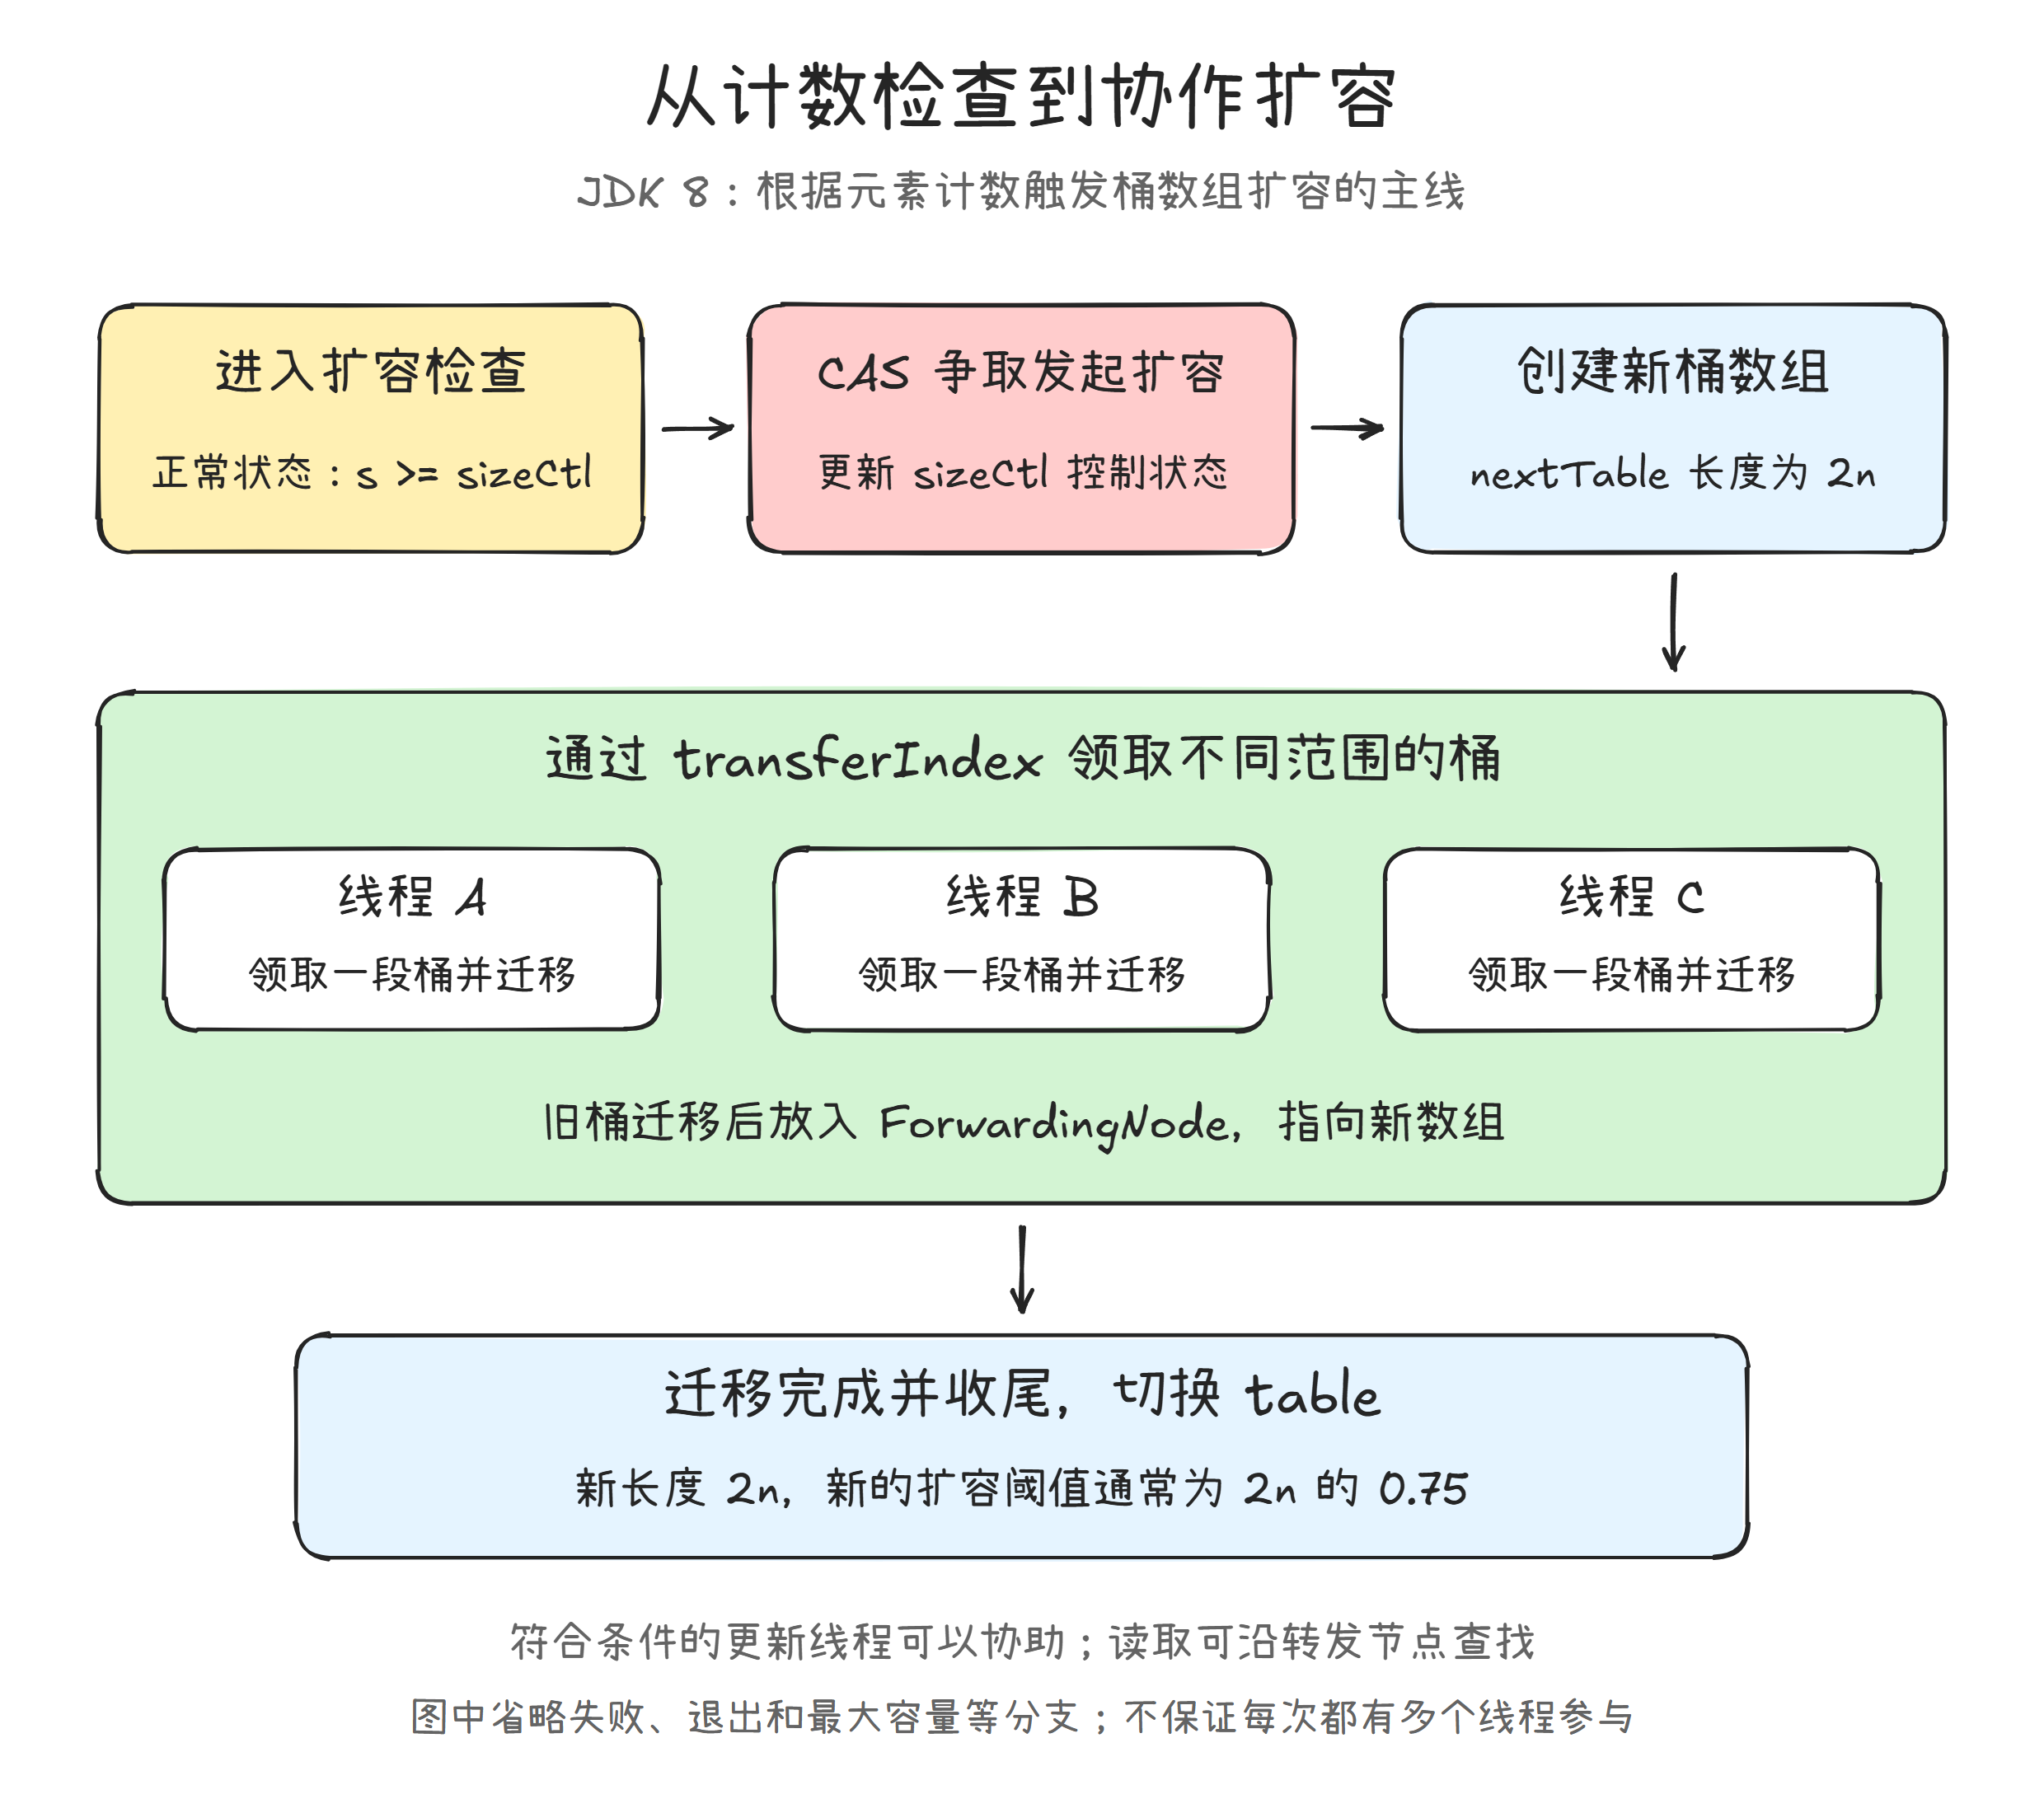
图 2:本图展示根据元素计数触发桶数组扩容的主线。不是每次更新都会走到检查,也不是每轮扩容都一定有多个线程参与。
2. 领取任务:迁移不同范围的桶
参与迁移的线程使用 CAS 更新 transferIndex,领取一段桶下标范围,再逐个处理。
这样,多个线程可以处理不同的桶,减少重复领取同一段任务的情况。对于很小的数组,可领取的任务范围较少,可能仍主要由一个线程完成。
迁移并不是把整个 Map 锁住再复制。对于非空桶,迁移会结合桶头同步与状态复查;不同桶的工作可以并行推进。
3. 原桶中的元素迁移到哪里
数组长度从 n 变成 2n 时,原来位于下标 i 的元素,根据已保存的哈希值,可以分到两个位置:
(hash & n) == 0 → 仍位于 i
(hash & n) != 0 → 位于 i + n
例如,原数组长度为 16,原桶下标为 3,迁移后可能进入新数组的桶 3 或桶 19。
这里使用节点已经保存的哈希值进行分组,不需要重新调用每个键的 hashCode()。链表桶会拆分成两组;树桶也有相应的拆分与必要时退化为链表的处理。[1]
4. ForwardingNode:旧桶已经迁移的标记
某个桶迁移完成后,旧数组对应位置会放置 ForwardingNode。它的 hash 是特殊值 MOVED,并持有新数组引用。
普通 putVal() 遇到 MOVED 时,会调用 helpTransfer():如果仍有可领取任务且符合参与条件,就尝试帮助迁移,之后再基于返回的数组继续插入。
读取线程遇到转发节点时,可以沿着新数组继续查找,并不是所有操作都必须加入迁移工作。
5. 迁移完成:切换数组与阈值
参与线程陆续完成自己的迁移工作后,通过控制状态协调退出。最后完成收尾的线程确认旧桶处理完成,再切换数组并更新阈值。关键赋值为:
// JDK 8 源码节选:n 是旧桶数组长度。
nextTable = null;
table = nextTab;
sizeCtl = (n << 1) – (n >>> 1);
旧长度为 16 时,新长度为 32,阈值为 32 – 8 = 24。
扩容只改变桶数组容量与数据组织,不会因为迁移同一个键值对就再把元素数量加一。如果并发插入持续发生,addCount() 还会重新汇总计数,检查是否需要继续扩容。[1]
七、计数不一定准确,为什么还能判断扩容
1. 扩容阈值是性能调整时机
桶数组长度为 16、阈值为 12,不代表第 13 个元素就无处可放。桶内可以存放多个节点,扩容阈值用于控制数据密度和操作成本。
因此,并发计数汇总与检查时机造成的少量提前或滞后,并不等于键值对存储出错。扩容过程本身仍需要通过 CAS、桶同步和迁移状态等机制保证正确性。
这里“允许计数判断不精确”和“允许迁移丢失数据”是两回事。
2. 严格业务限制不能只靠 size()
下面是错误的容量限制方式:
// 错误示例:不能保证并发情况下最多只有 100 个键值对。
if (map.size() < 100) {
map.put(key, value);
}
当前有 99 个元素时,两个线程都可能读到 99,都通过判断,然后插入两个不同的新键,最终达到 101。
即使 size() 的读取结果在那一刻完全准确,“检查”和“插入”仍然是两个步骤,组合起来不具备原子性。
下面用两个线程和一个门闩,固定复现这种交错:
// 适用 JDK 8,文件名:CapacityRaceDemo.java。
import java.util.concurrent.ConcurrentHashMap;
import java.util.concurrent.CountDownLatch;
public class CapacityRaceDemo {
public static void main(String[] args) throws InterruptedException {
ConcurrentHashMap<Integer, Integer> map = new ConcurrentHashMap<>();
for (int i = 0; i < 99; i++) {
map.put(i, i);
}
CountDownLatch checked = new CountDownLatch(2);
Thread[] workers = new Thread[2];
for (int i = 0; i < workers.length; i++) {
final int key = 99 + i;
workers[i] = new Thread(() -> {
boolean allowed = map.size() < 100;
checked.countDown();
try {
checked.await(); // 等两个线程都完成检查,再插入。
} catch (InterruptedException e) {
Thread.currentThread().interrupt();
return;
}
if (allowed) {
map.put(key, key);
}
});
workers[i].start();
}
for (Thread worker : workers) {
worker.join();
}
System.out.println("final size = " + map.size());
}
}
输出:
final size = 101
这说明 ConcurrentHashMap 的线程安全,并不会自动让多个方法组成的业务流程也具备原子性。
如果采用锁,需要让相关修改遵守同一把业务锁。例如,在所有相关增删操作都受同一锁约束的前提下,可以在临界区内完成检查和插入。若允许覆盖已有键,判断还需要区分“替换值”与“新增键”,不能把达到上限后的所有 put 都拒绝。
也可以用信号量管理名额,但必须把重复键、插入失败、删除释放等生命周期设计完整。只在 put() 前调用一次许可获取,不能自动完成这些业务约束。
八、容易混淆的几个问题
1. Cell 数组扩大,是否就是 Map 扩容
不是。两种数组解决不同问题:
| 数组中保存什么 | 分散的计数单元 | 桶与键值对节点 |
| 主要解决什么问题 | 多线程更新计数器的竞争 | 桶数组的数据密度与冲突 |
| 主要实现位置 | fullAddCount() | transfer(),以及相应触发入口 |
| 是否迁移键值对 | 不迁移,只保留已有 Cell 引用并增加槽位 | 将旧桶数据组织到新数组 |
Cell 数组并不随 Map 元素数量无限增加。其扩大还受 CPU 数量相关条件限制;由于长度按二次幂增长,不能简单表述为“长度一定严格不超过 CPU 数量”。[1]
2. 调用 size() 会触发扩容吗
不会。size() 只汇总计数、处理返回范围,不调用 transfer()。
是更新路径可能触发扩容检查,而不是“调用一次 size(),Map 就顺便检查一次扩容”。
3. 达到元素数量阈值,是唯一扩容入口吗
不是。putVal() 在桶内链表达到相应条件时,会调用 treeifyBin()。这个方法首先看桶数组是否足够大:
// JDK 8 源码节选:省略后续树化代码。
if ((n = tab.length) < MIN_TREEIFY_CAPACITY) {
tryPresize(n << 1);
}
JDK 8 中 MIN_TREEIFY_CAPACITY 为 64。当数组长度小于 64 时,这条路径会优先尝试扩容,而不是直接树化。因此不能把所有扩容都归结为 sumCount() >= sizeCtl。[1]
另外,tryPresize() 接收的是预分配相关的大小参数,还会进行容量换算和判断,不能把这里的 n << 1 直接当作新数组最终长度。transfer() 每一轮创建的新数组,才是旧长度的两倍。
批量插入 putAll() 也有预先调整容量的入口,不需要等到每次新增后的计数检查才开始考虑容量。
4. 与 LongAdder 有什么关系
两者采用相似的分散计数思路:
ConcurrentHashMap:baseCount + CounterCell[]
LongAdder: base + Cell[]
JDK 8 的 LongAdder 继承内部类 Striped64,由它提供基础字段与分散更新机制。ConcurrentHashMap 则在内部实现了对应的计数结构,并不是直接保存一个 LongAdder 对象来统计数量。[1][3][4]
LongAdder.sum() 同样不保证并发更新期间的原子快照,适合高并发统计。其高竞争下的性能收益以更多空间和汇总读取成本为代价,不能由此推导出“所有场景都比 AtomicLong 更好”。[5]
5. 去哪里继续读源码
下面按本文主线列出固定版本的阅读入口。源码路径均相对于 OpenJDK jdk8u402-b06 仓库:
| 计数与控制字段 | ConcurrentHashMap.java:785 | baseCount、sizeCtl、counterCells |
| size() | ConcurrentHashMap.java:909 | 汇总与返回范围处理 |
| putVal() | ConcurrentHashMap.java:1010 | 新增键后调用 addCount() |
| addCount() | ConcurrentHashMap.java:2256 | 计数更新、提前返回、扩容检查 |
| helpTransfer() | ConcurrentHashMap.java:2295 | 更新线程怎样加入迁移 |
| transfer() | ConcurrentHashMap.java:2365 | 分配任务、迁移桶、切换数组 |
| sumCount() | ConcurrentHashMap.java:2509 | 基础计数与 Cell 的求和 |
| fullAddCount() | ConcurrentHashMap.java:2522 | Cell 初始化、冲突重试与数组扩大 |
| treeifyBin() | ConcurrentHashMap.java:2609 | 数组较小时优先尝试扩容 |

评论前必须登录!
注册