 网硕互联帮助中心
近年电商大促的客服对话量持续增长,头部平台的单日咨询峰值达到较高量级。这些会话里塞满了产品参数、处置经验和用户真实意图。当对话遇上大模型,客服知识库正从一份静态文档,转向具备持续更新能力的系统。把对话沉淀成知识,再反哺前端客服和智能问答,是客服体系智能化的一条主线。
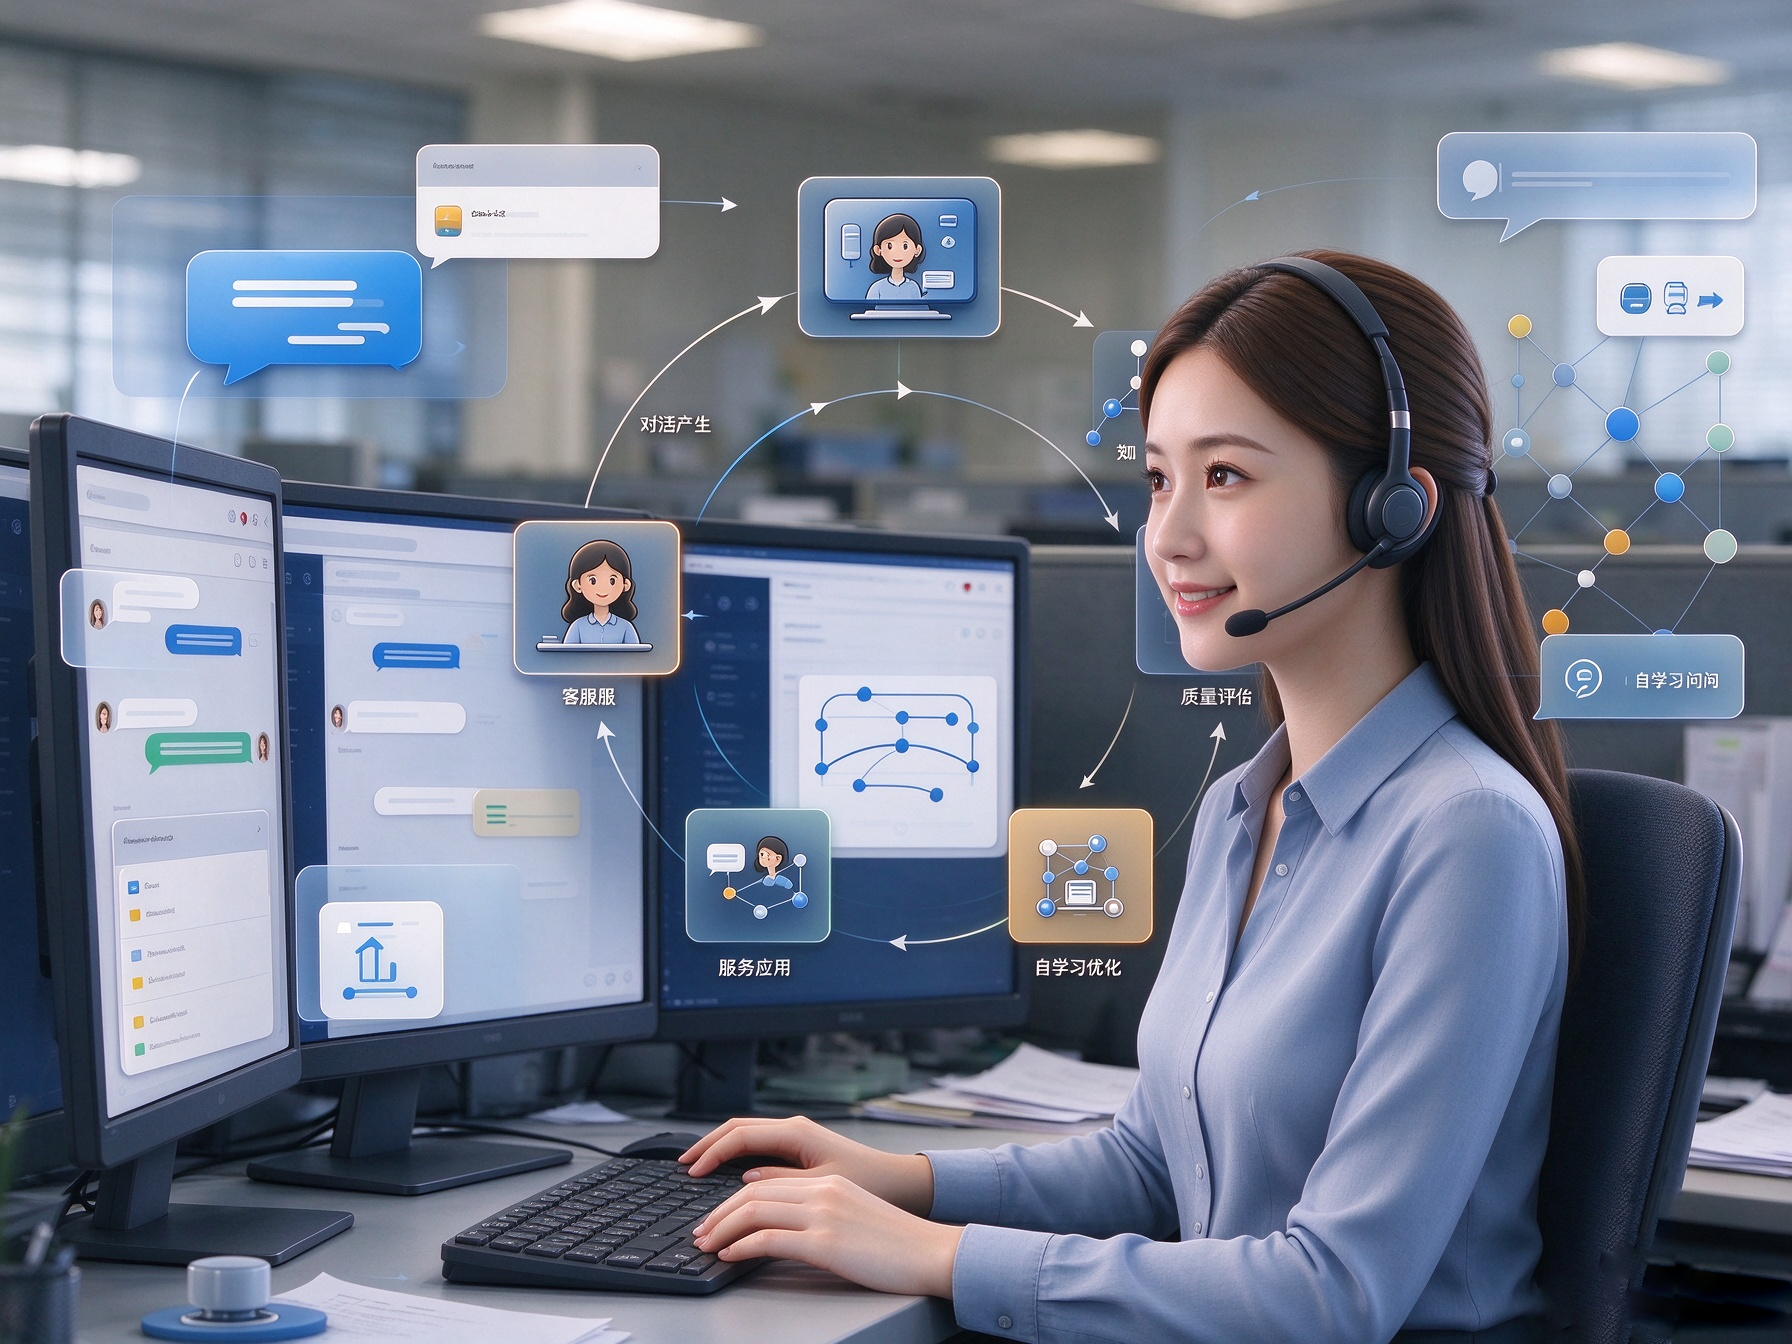
自学习回路
它的重要机制之一,是将对话和反馈转化为知识库的输入。这条回路分几步跑。
反馈信号先收上来。用户在对话结束后打满意度评分,或对某条回答点赞、点踩,这些信号可进入系统,帮助识别哪些回答较为可靠、哪些需要修正。高质回答自动转成知识。系统可将点赞、采纳等信号作为候选依据,经规则筛选或人工审核后沉淀为知识条目。
专家纠错进学习循环。AI答错了,专家在后台改一遍,修改过程和最终结论都留痕,沉淀成可复用的修正样本。下次遇到同类问题时,可获得经修正后的参考信息。
质量评分和智能标签管排序。每条知识可打质量分、贴关键词标签,检索时可优先考虑高置信条目。知识图谱同步扩张商品、问题、方案之间的关联边,让一个SKU牵出它常被问到的所有情形。
效果看两个指标。recall@k 应基于已标注的相关结果集评价前k条结果的召回覆盖情况,衡量前k条结果里命中相关内容的比例,k常取5或10;幻觉率衡量输出里出现编造内容的比例。这两个数字可定期评测,为下一轮调优提供参考。
技术底座
想法要落地,得有工程底座。下面几块是这类系统的常见配置。
向量检索管语义匹配。文本用 BGE-M3 这类 embedding 模型转成向量,存进 Milvus 这样的向量库。用户问"这款锅具能不能进洗碗机",系统可按语义相似度召回相关段落,减少对关键词精确匹配的依赖。
全文检索补严格匹配。Elasticsearch 管关键词,活动编号、型号代码这类必须一字不差的查询交给它。
混合检索把两者揉在一起,先分别召回再融合排序,混合检索可结合语义与关键词信号,在适配的数据集上有助于提升检索相关性。它给 RAG 供料,模型先查权威片段再生成答案,有助于减少幻觉。
知识图谱管关系。Neo4j 把实体和关系存成图,商品、部件、规则、方案之间都能拉出边。一条售后政策变了,图谱上挂着的关联问题可被一并定位。
技能组件做能力复用。把代码审查、纪要生成、文件处理这类能力封装成独立技能,工作流里可按需调用。
举个具体情形。用户问"iPhone 15 的充电头是否兼容旧线",向量检索先捞出产品知识条目,知识图谱关联出充电协议和退换政策,模型据此生成答案。用户点踩,系统发现答案引用的旧规格已过期,专家后台修正,经审核发布后,新条目可参与后续同类问题的召回与排序到更新后的版本。
小艾智能体的自学习模块可收集点赞点踩作为优化信号,将高质问答转化为知识库条目,专家修正可纳入学习循环,再用质量评分和智能标签辅助召回排序。
文档处理引擎可将 PDF、Word、Excel 这类格式导入向量库,BGE-M3 可用于向量化,Milvus 可用于存储,ES 可用于全文检索,Neo4j 可用于构建图谱。动态 Agent 编排可通过 JSON 或 YAML 配置工作流,条件路由和状态传递可将下载、解析、摘要、提取、发送这类流程串联起来。Skills 技能系统可支持代码审查、会议纪要、文件处理的插拔式复用。
部署可支持私有化,可根据部署与接口配置,将相关数据限制在指定环境内处理,从而降低向外部传输的可能性。微服务架构下 Java 可用于业务分发,Python Agent 可执行核心任务,各组件可独立扩展。
常见问题
Q:电商客服知识库如何实现自学习? A:靠反馈收集、问答自动转化、专家纠错和质量评测形成回路,知识有望随对话逐步补充。
Q:RAG 如何帮助降低大模型幻觉风险? A:先检索权威知识片段再生成答案,答案受出处约束,有助于降低编造内容的比例。
Q:企业知识库私有化部署有什么要求? A:对话与知识数据可设置为在本地处理,减少向第三方传输,通常配合微服务架构和独立向量集群。
Q:recall@k 和幻觉率有什么用? A:recall@k 看前k条结果的相关性覆盖,幻觉率看编造内容占比,两者定期评测指导优化。


评论前必须登录!
注册