 网硕互联帮助中心
摘要:Pandas 是 Python 数据处理的核心库,提供 Series(一维)和 DataFrame(二维)两种数据结构,支持数据读写(CSV、JSON)、索引选择(loc/iloc)、数据清洗(去重、缺失值)、数据合并(merge/concat)、分组聚合(groupby)等完整的数据处理能力。在大模型应用中,Pandas 贯穿评测集构建、模型输出解析、badcase 分析、结果统计全流程,是数据处理的首选工具。
Matplotlib 是 Python 最基础的可视化库,大模型角色只需简要了解,掌握折线图(看 loss 曲线)、直方图(看数据分布)、柱状图(看类别分布)三种最常用的图即可。通过 df.plot() 一行出图,配合 savefig() 保存实验记录,足以满足日常分析需求。
两者结合,构成大模型应用开发中「数据处理 + 可视化」的完整工具链:Pandas 负责数据清洗与分析,Matplotlib 负责快速可视化,共同支撑评测、调试、实验记录等核心工作流。
目录
二、pandas基础
2.1 Pandas 介绍
2.1.1 Pandas 是什么
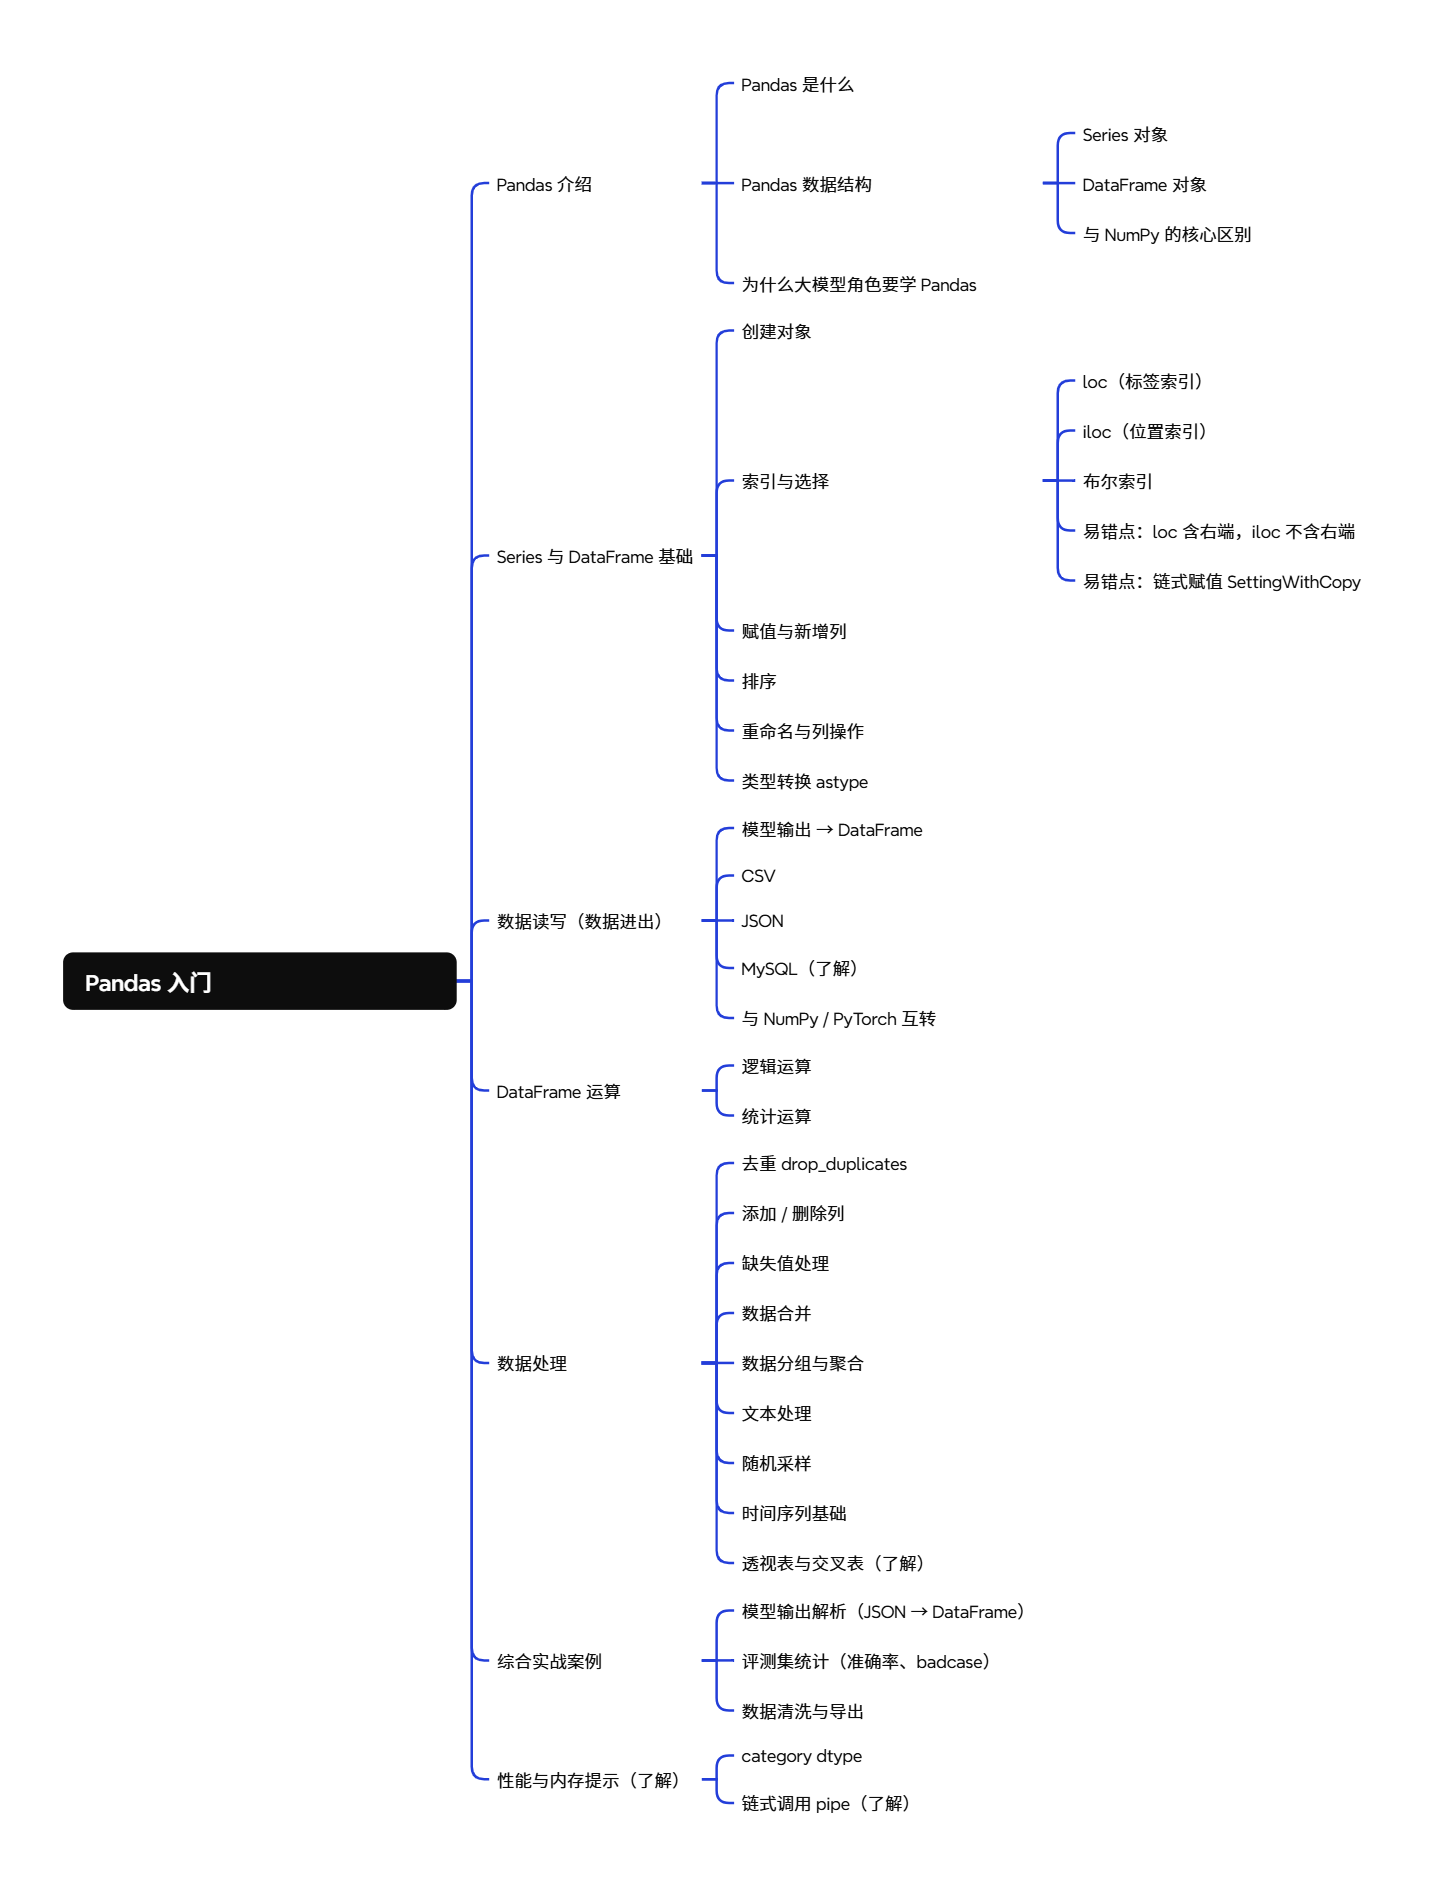
2.1.2 Pandas 数据结构
2.1.3 为什么大模型角色要学 Pandas
2.2 Series 与 DataFrame 基础
2.2.1 创建对象
2.2.2 索引与选择
2.2.3 赋值与新增列
2.2.4 排序
2.2.5 重命名与列操作
2.2.6 类型转换 astype
2.3 数据读写(数据进出)
2.3.1 模型输出 → DataFrame
2.3.2 CSV
2.3.3 JSON
2.3.4 MySQL(了解)
2.3.5 与 NumPy / PyTorch 互转
2.4 DataFrame 运算
2.4.1 逻辑运算
2.4.2 统计运算
2.4.2.1 describe / mean / std / sum
2.4.2.2 value_counts
2.5 数据处理
2.5.1 去重 drop_duplicates
2.5.2 添加 / 删除列
2.5.3 缺失值处理
2.5.4 数据合并
2.5.4.1 merge(键连接)
2.5.5 数据分组与聚合
2.5.6 文本处理
2.5.7 随机采样
2.5.8 时间序列基础
2.5.9 透视表与交叉表(了解)
2.6 综合实战案例
2.6.1 模型输出解析(JSON → DataFrame)
2.6.2 评测集统计(准确率、badcase)
2.6.3 数据清洗与导出
三、Matplotlib 入门(简要了解)
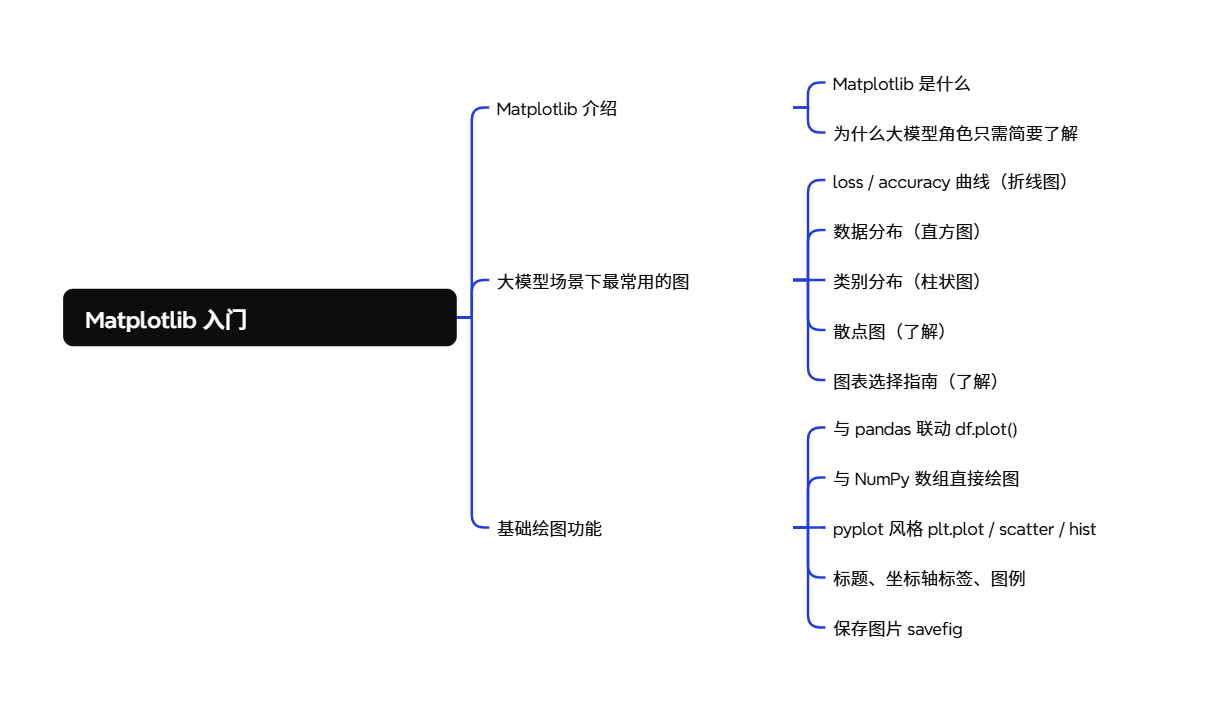
3.1 Matplotlib 介绍
3.1.1 Matplotlib 是什么
3.1.2 为什么大模型角色只需简要了解
3.2 大模型场景下最常用的图
3.2.1 loss / accuracy 曲线(折线图)
3.2.2 数据分布(直方图)
3.2.3 类别分布(柱状图)
3.2.4 散点图(了解)
3.2.5 图表选择指南(了解)
3.3 基础绘图功能
3.3.1 与 pandas 联动 df.plot()
3.3.2 与 NumPy 数组直接绘图
3.3.3 pyplot 风格 plt.plot / scatter / hist
3.3.4 标题、坐标轴标签、图例
3.3.5 保存图片 savefig
二、pandas基础
2.1 Pandas 介绍
2.1.1 Pandas 是什么
Pandas 是 Python 最流行的数据分析库,核心是两种数据结构:Series(一维)和 DataFrame(二维)。它建立在 NumPy 之上,提供了更强大的数据操作能力。
一句话理解: Pandas 让 Python 能像 Excel 一样处理表格数据,但功能更强大、更灵活。
核心能力:
| 数据读写 | CSV、JSON、Excel、MySQL 等 |
| 数据清洗 | 缺失值、去重、类型转换 |
| 数据筛选 | 条件筛选、排序、分组 |
| 数据聚合 | groupby、透视表 |
| 数据合并 | merge、concat |
2.1.2 Pandas 数据结构
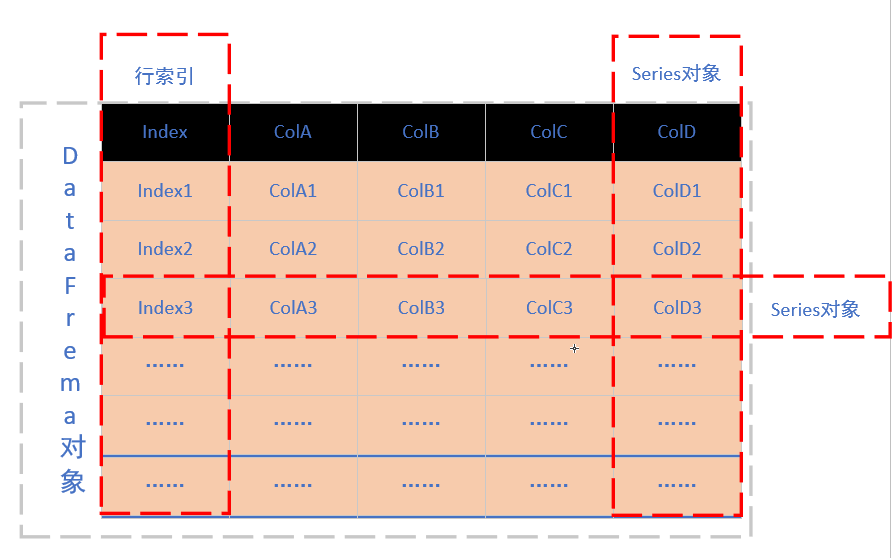
2.1.2.1 Series 对象
Series 是 Pandas 的一维数据结构,由索引(index)和值(values)组成。可以理解为"带标签的一维数组"。
2.1.2.2 DataFrame 对象
DataFrame 是 Pandas 的二维数据结构,由行索引(index)和列索引(columns)组成。可以理解为"带标签的二维表格"。
2.1.2.3 与 NumPy 的核心区别
| 维度 | 多维数组 | 一维 Series、二维 DataFrame |
| 索引 | 隐式整数索引 | 支持标签索引 |
| 类型 | 要求统一 dtype | 列间可不同 dtype |
| 缺失值 | nan(仅浮点) | None / NaN / NaT |
| 列名 | 无 | 有列名 |
| 应用 | 数值计算 | 数据处理 |
2.1.3 为什么大模型角色要学 Pandas
Pandas 是大模型应用开发中数据处理的核心工具,贯穿评测、清洗、分析全流程。
应用场景
| 数据清洗 | 清洗训练数据、评测数据 |
| 评测集 | 构建、管理评测集 |
| badcase | 分析模型错误案例 |
| 模型输出解析 | JSON → DataFrame,批量分析 |
| 结果统计 | 准确率、召回率、分布统计 |
2.2 Series 与 DataFrame 基础
2.2.1 创建对象
Pandas 支持从多种数据源创建 Series 和 DataFrame。
# 创建 Series 和 DataFrame
import pandas as pd
import numpy as np
# ===== Series =====
# 从列表
s1 = pd.Series([1, 2, 3, 4, 5])
# 从字典
s2 = pd.Series({"a": 1, "b": 2, "c": 3})
# 从 ndarray
s3 = pd.Series(np.array([10, 20, 30]))
# 指定索引
s4 = pd.Series([1, 2, 3], index=["x", "y", "z"])
print(f"从列表:\\n{s1}")
print(f"\\n从字典:\\n{s2}")
print(f"\\n指定索引:\\n{s4}")
# ===== DataFrame =====
# 从字典(最常见)
df1 = pd.DataFrame({
"name": ["张三", "李四", "王五"],
"age": [25, 30, 28],
"city": ["杭州", "上海", "北京"]
})
# 从列表的字典
df2 = pd.DataFrame([
{"name": "张三", "age": 25},
{"name": "李四", "age": 30},
])
# 从 ndarray
df3 = pd.DataFrame(np.array([[1, 2], [3, 4]]), columns=["A", "B"])
print(f"\\nDataFrame 从字典:\\n{df1}")
print(f"\\nDataFrame 从列表的字典:\\n{df2}")
print(f"\\nDataFrame 从 ndarray:\\n{df3}")
方法说明:
| pd.Series() | 创建 Series。参数为数据,index 指定索引 |
| pd.DataFrame() | 创建 DataFrame。参数为字典、列表、ndarray,columns 指定列名 |
说明:
-
Series 从列表、字典、ndarray 创建
-
DataFrame 从字典(最常见)、列表的字典、ndarray 创建
-
columns 指定列名
2.2.2 索引与选择
2.2.2.1 loc(标签索引)
loc 基于标签索引,使用行索引名和列名。
# loc:标签索引
import pandas as pd
df = pd.DataFrame({
"name": ["张三", "李四", "王五"],
"age": [25, 30, 28],
"city": ["杭州", "上海", "北京"]
}, index=["a", "b", "c"])
# 取单行
print(f"df.loc['a']:\\n{df.loc['a']}")
# 取单列
print(f"\\ndf.loc[:, 'name']:\\n{df.loc[:, 'name']}")
# 取单值
print(f"\\ndf.loc['a', 'name']:{df.loc['a', 'name']}")
# 取多行多列
print(f"\\ndf.loc['a':'b', ['name', 'age']]:\\n{df.loc['a':'b', ['name', 'age']]}")
方法说明:
| df.loc[行标签] | 取行 |
| df.loc[:, 列标签] | 取列 |
| df.loc[行标签, 列标签] | 取单值 |
| df.loc[行标签列表, 列标签列表] | 取多行多列 |
说明:
-
loc 基于标签
-
切片 'a':'b' 包含右端
2.2.2.2 iloc(位置索引)
iloc 基于位置索引,使用整数位置。
# iloc:位置索引
import pandas as pd
df = pd.DataFrame({
"name": ["张三", "李四", "王五"],
"age": [25, 30, 28],
"city": ["杭州", "上海", "北京"]
})
# 取单行
print(f"df.iloc[0]:\\n{df.iloc[0]}")
# 取单列
print(f"\\ndf.iloc[:, 0]:\\n{df.iloc[:, 0]}")
# 取单值
print(f"\\ndf.iloc[0, 0]:{df.iloc[0, 0]}")
# 取多行多列
print(f"\\ndf.iloc[0:2, 0:2]:\\n{df.iloc[0:2, 0:2]}")
方法说明:
| df.iloc[行位置] | 取行 |
| df.iloc[:, 列位置] | 取列 |
| df.iloc[行位置, 列位置] | 取单值 |
| df.iloc[行位置切片, 列位置切片] | 取多行多列 |
说明:
-
iloc 基于位置
-
切片 0:2 不含右端
2.2.2.3 布尔索引
布尔索引用条件表达式筛选数据,返回满足条件的行。
# 布尔索引
import pandas as pd
df = pd.DataFrame({
"name": ["张三", "李四", "王五"],
"age": [25, 30, 28],
"city": ["杭州", "上海", "北京"]
})
# 单条件
result = df[df["age"] > 26]
print(f"age > 26:\\n{result}")
# 多条件
result = df[(df["age"] > 26) & (df["city"] == "上海")]
print(f"\\nage > 26 且 city == 上海:\\n{result}")
# isin
result = df[df["city"].isin(["杭州", "北京"])]
print(f"\\ncity in [杭州, 北京]:\\n{result}")
方法说明:
| df[条件] | 布尔索引筛选 |
| df[条件1 & 条件2] | 多条件,用 & 且加括号 |
| df[列].isin(列表) | 判断是否在列表中 |
说明:
-
布尔索引返回满足条件的行
-
多条件用 &、|,不能用 and、or
2.2.2.4 易错点:loc 含右端,iloc 不含右端
# 错误:以为 loc 和 iloc 切片行为一致
import pandas as pd
df = pd.DataFrame({
"name": ["张三", "李四", "王五"],
"age": [25, 30, 28]
}, index=["a", "b", "c"])
# loc:含右端
print(f"loc['a':'b']:\\n{df.loc['a':'b']}") # 包含 a 和 b
# iloc:不含右端
print(f"\\niloc[0:2]:\\n{df.iloc[0:2]}") # 包含 0 和 1,不含 2
说明:
| loc | 含右端 |
| iloc | 不含右端 |
2.2.2.5 易错点:链式赋值 SettingWithCopy
# 错误:链式赋值
import pandas as pd
df = pd.DataFrame({
"name": ["张三", "李四", "王五"],
"age": [25, 30, 28]
})
# 链式赋值:先筛选,再赋值
# df[df["age"] > 26]["age"] = 100 # SettingWithCopyWarning
# 正确:用 .loc 一步到位
df.loc[df["age"] > 26, "age"] = 100
print(df)
说明:
-
链式赋值可能修改的是副本,而非原 DataFrame
-
用 .loc[条件, 列] = 值 一步到位
-
避免链式赋值
2.2.3 赋值与新增列
Pandas 支持直接赋值新增列、修改列值、条件赋值。
# 赋值与新增列
import pandas as pd
df = pd.DataFrame({
"name": ["张三", "李四", "王五"],
"age": [25, 30, 28]
})
# ===== 新增列:常量 =====
df["city"] = "杭州"
print(f"新增常量列:\\n{df}")
# ===== 新增列:计算 =====
df["age_plus_10"] = df["age"] + 10
print(f"\\n新增计算列:\\n{df}")
# ===== 新增列:条件赋值 =====
df["is_adult"] = df["age"] >= 18
print(f"\\n新增条件列:\\n{df}")
# ===== 修改列值 =====
df["age"] = df["age"] + 1
print(f"\\n修改列值:\\n{df}")
# ===== 删除列 =====
df = df.drop(columns=["age_plus_10"])
print(f"\\n删除列:\\n{df}")
方法说明:
| df["新列"] = 值 | 新增列或修改列 |
| df.drop(columns=[…]) | 删除列。columns 指定列名 |
说明:
-
新增列直接赋值
-
条件赋值用布尔表达式
-
drop 返回新 DataFrame,不修改原数据
2.2.4 排序
2.2.4.1 sort_values / sort_index [L3]
# 排序
import pandas as pd
df = pd.DataFrame({
"name": ["张三", "李四", "王五"],
"age": [25, 30, 28]
}, index=["c", "a", "b"])
# 按值排序:默认升序
print(f"按 age 升序:\\n{df.sort_values('age')}")
# 降序
print(f"\\n按 age 降序:\\n{df.sort_values('age', ascending=False)}")
# 按索引排序
print(f"\\n按索引排序:\\n{df.sort_index()}")
方法说明:
| df.sort_values() | 按值排序。by 指定列,ascending 控制升降序 |
| df.sort_index() | 按索引排序 |
说明:
-
默认升序
-
返回新 DataFrame,不修改原数据
2.2.4.2 易错点:默认不原地,需 inplace 或重新赋值 [L2]
# 错误:以为排序会修改原 DataFrame
import pandas as pd
df = pd.DataFrame({"age": [30, 25, 28]})
df.sort_values("age") # 返回新 DataFrame,原 df 未变
print(f"原 df:\\n{df}") # 顺序未变
# 正确:重新赋值
df = df.sort_values("age")
print(f"\\n重新赋值后:\\n{df}")
# 或使用 inplace
df.sort_values("age", inplace=True)
说明:
-
sort_values 默认返回新 DataFrame
-
需重新赋值或 inplace=True
-
推荐重新赋值
2.2.5 重命名与列操作
# 重命名与列操作
import pandas as pd
df = pd.DataFrame({
"name": ["张三", "李四"],
"age": [25, 30]
})
# 方式一:rename
df1 = df.rename(columns={"name": "姓名", "age": "年龄"})
print(f"rename:\\n{df1}")
# 方式二:直接赋值 columns
df2 = df.copy()
df2.columns = ["姓名", "年龄"]
print(f"\\n直接赋值 columns:\\n{df2}")
# 查看列名
print(f"\\n列名:{df.columns.tolist()}")
方法说明:
| df.rename() | 重命名。columns 指定列映射,index 指定索引映射 |
| df.columns | 列名,可赋值修改 |
说明:
-
rename 返回新 DataFrame
-
columns 直接赋值修改
2.2.6 类型转换 astype
astype() 用于转换数据类型,返回新 DataFrame。
# 类型转换 astype
import pandas as pd
df = pd.DataFrame({
"age": ["25", "30", "28"],
"score": [85.5, 92.3, 78.8]
})
print(f"原始类型:\\n{df.dtypes}")
# 字符串转整数
df["age"] = df["age"].astype(int)
print(f"\\n转换后类型:\\n{df.dtypes}")
# 浮点转整数
df["score_int"] = df["score"].astype(int)
print(f"\\n转换后:\\n{df}")
# 转为 category(节省内存)
df["age_cat"] = df["age"].astype("category")
print(f"\\ncategory 类型:{df['age_cat'].dtype}")
方法说明:
| df[列].astype() | 转换列类型。参数为目标类型,如 int、float、str、category |
说明:
-
astype 返回新 Series,需重新赋值
-
浮点转整数会截断小数
-
category 类型节省内存
2.3 数据读写(数据进出)
2.3.1 模型输出 → DataFrame
大模型输出通常为 JSON 格式(列表的字典、嵌套字典),需转为 DataFrame 进行分析。这是大模型评测、badcase 分析的第一步。
2.3.2 CSV
CSV 是最常用的数据存储格式,Pandas 提供 read_csv 和 to_csv 读写。
# CSV 读写
import pandas as pd
# ===== 写入 CSV =====
df = pd.DataFrame({
"name": ["张三", "李四", "王五"],
"age": [25, 30, 28],
"city": ["杭州", "上海", "北京"]
})
df.to_csv("data.csv", index=False, encoding="utf-8")
# ===== 读取 CSV =====
df2 = pd.read_csv("data.csv", encoding="utf-8")
print(f"\\n读取结果:\\n{df2}")
方法说明:
| df.to_csv() | 写入 CSV。index=False 不写索引,encoding 指定编码 |
| pd.read_csv() | 读取 CSV。encoding 指定编码,sep 指定分隔符 |
常用参数:
| index | 是否写入索引,默认 True |
| encoding | 编码,常用 utf-8、gbk |
| sep | 分隔符,默认 , |
| header | 是否有表头,默认 0 |
2.3.3 JSON
JSON 是 API 和模型输出的常见格式,Pandas 支持读写。
# JSON 读写
import pandas as pd
df = pd.DataFrame({
"name": ["张三", "李四"],
"age": [25, 30]
})
# 写入 JSON
df.to_json("data.json", orient="records", force_ascii=False)
# 读取 JSON
df2 = pd.read_json("data.json")
print(f"\\n读取结果:\\n{df2}")
方法说明:
| df.to_json() | 写入 JSON。orient 指定方向,force_ascii=False 保留中文 |
| pd.read_json() | 读取 JSON |
orient 参数:
| "records" | 列表的字典(推荐) |
| "index" | 字典的字典 |
| "columns" | 列导向 |
| "values" | 仅值 |
2.3.4 MySQL(了解)
Pandas 可以读写 MySQL 数据库,需配合 sqlalchemy 或 pymysql。
实际项目中使用较少,了解即可。
方法说明:
| pd.read_sql() | 读取 SQL 查询结果 |
| df.to_sql() | 写入数据库表 |
2.3.5 与 NumPy / PyTorch 互转
2.3.5.1 .values / .to_numpy()
DataFrame 和 Series 可以转为 NumPy 数组,用于数值计算。
# 与 NumPy 互转
import pandas as pd
import numpy as np
df = pd.DataFrame({
"age": [25, 30, 28],
"score": [85.5, 92.3, 78.8]
})
# 方式一:.values
arr1 = df.values
print(f".values:\\n{arr1}")
print(f"类型:{type(arr1)},dtype:{arr1.dtype}")
# 方式二:.to_numpy()(推荐)
arr2 = df.to_numpy()
print(f"\\n.to_numpy():\\n{arr2}")
# Series 转 NumPy
s = df["age"]
arr3 = s.to_numpy()
print(f"\\nSeries.to_numpy():{arr3}")
方法说明:
| df.values | 返回 NumPy 数组(旧版,不推荐) |
| df.to_numpy() | 返回 NumPy 数组(推荐)。dtype 指定类型 |
说明:
-
.to_numpy() 是推荐方法,.values 是旧版
-
混合 dtype 的 DataFrame 转为 NumPy 会统一为 object 或 float
2.3.5.2 与 PyTorch 对接前的 dtype 注意
Pandas → NumPy → PyTorch 是大模型数据处理的常见链路。关键注意:NumPy 默认 float64,PyTorch 默认 float32。
# 与 PyTorch 对接
import pandas as pd
import numpy as np
import torch
df = pd.DataFrame({
"age": [25, 30, 28],
"score": [85.5, 92.3, 78.8]
})
# 问题:默认 float64
arr = df.to_numpy()
tensor = torch.from_numpy(arr)
print(f"默认 dtype:{tensor.dtype}") # torch.float64
# 正确:显式转 float32
arr = df.to_numpy(dtype=np.float32)
tensor = torch.from_numpy(arr)
print(f"转换后 dtype:{tensor.dtype}") # torch.float32
方法说明:
| df.to_numpy(dtype=…) | 转为指定 dtype 的 NumPy 数组 |
| torch.from_numpy() | NumPy 数组转 PyTorch 张量(共享内存) |
说明:
-
NumPy 默认 float64,PyTorch 默认 float32
-
对接前需显式转换
-
大模型中统一使用 float32
2.4 DataFrame 运算
2.4.1 逻辑运算
Pandas 的逻辑运算用于组合多个条件,返回布尔 Series。
| & | 与(and) |
| | | 或(or) |
| ~ | 非(not) |
注意: 必须用 &、|、~,不能用 and、or、not;且每个条件必须加括号。
# 逻辑运算
import pandas as pd
df = pd.DataFrame({
"name": ["张三", "李四", "王五", "赵六"],
"age": [25, 30, 28, 35],
"city": ["杭州", "上海", "北京", "上海"]
})
# 与:&
result = df[(df["age"] > 26) & (df["city"] == "上海")]
# result = df[(df["age"] > 26) and (df["city"] == "上海")] # ValueError
print(f"age > 26 且 city == 上海:\\n{result}")
# 或:|
result = df[(df["age"] > 30) | (df["city"] == "杭州")]
print(f"\\nage > 30 或 city == 杭州:\\n{result}")
# 非:~
result = df[~(df["city"] == "上海")]
print(f"\\ncity != 上海:\\n{result}")
说明:
-
& 与、| 或、~ 非
-
每个条件必须加括号
-
不能用 and、or、not
2.4.2 统计运算
2.4.2.1 describe / mean / std / sum
Pandas 提供常用统计函数,可对整表或指定列计算。
# 统计运算
import pandas as pd
df = pd.DataFrame({
"age": [25, 30, 28, 35, 22],
"score": [85.5, 92.3, 78.8, 88.0, 95.5]
})
# describe:综合统计
print(f"describe:\\n{df.describe()}")
# 单列统计
print(f"\\nage 均值:{df['age'].mean():.2f}")
print(f"age 标准差:{df['age'].std():.2f}")
print(f"age 求和:{df['age'].sum()}")
# 按列统计
print(f"\\n各列均值:\\n{df.mean()}")
方法说明:
| df.describe() | 综合统计,返回计数、均值、标准差、分位数 |
| df.mean() | 均值 |
| df.std() | 标准差 |
| df.sum() | 求和 |
说明:
-
describe 一次性输出多个统计量
-
单列统计用 df["列"].方法()
-
按列统计用 df.方法()
2.4.2.2 value_counts
value_counts() 用于统计每个值出现的次数,常用于分类数据分布分析。
# value_counts
import pandas as pd
df = pd.DataFrame({
"city": ["杭州", "上海", "北京", "上海", "杭州", "上海"]
})
# 统计频次
print(f"value_counts:\\n{df['city'].value_counts()}")
# 转为比例
print(f"\\n比例:\\n{df['city'].value_counts(normalize=True)}")
方法说明:
| Series.value_counts() | 统计每个值的出现次数。normalize=True 返回比例 |
说明:
-
默认按频次降序
-
normalize=True 返回比例
-
常用于分类数据分布分析
2.5 数据处理
2.5.1 去重 drop_duplicates
drop_duplicates() 用于去除重复行,可指定列或全部列。
# 去重
import pandas as pd
df = pd.DataFrame({
"name": ["张三", "李四", "张三", "王五", "李四"],
"city": ["杭州", "北京", "杭州", "北京", "上海"]
})
# 全部列去重
print(f"原始数据:\\n{df}")
print(f"\\n全部列去重:\\n{df.drop_duplicates()}") # 行Series对象完全相同才会去除
# 按指定列去重(保留第一条)
print(f"\\n按 name 去重:\\n{df.drop_duplicates(subset=['name'])}") # 指定列对应元素相同就去除
# 按指定列去重(保留最后一条)
print(f"\\n按 name 去重(保留最后):\\n{df.drop_duplicates(subset=['name'], keep='last')}")
方法说明:
| subset | 指定列,默认全部列 |
| keep | 'first'(默认)保留第一条,'last' 保留最后一条,False 全部删除 |
说明:
-
默认全部列去重
-
subset 指定去重列
-
keep 控制保留哪条
2.5.2 添加 / 删除列
# 添加 / 删除列
import pandas as pd
df = pd.DataFrame({
"name": ["张三", "李四", "王五"],
"age": [25, 30, 28]
})
# assign:新增列
df1 = df.assign(age_plus_10=df["age"] + 10)
print(f"assign 新增列:\\n{df1}")
# 链式 assign
df2 = df.assign(
age_plus_10=df["age"] + 10,
is_adult=df["age"] >= 18
)
print(f"\\n链式 assign:\\n{df2}")
# drop:删除列
df3 = df.drop(columns=["age"])
print(f"\\ndrop 删除列:\\n{df3}")
# drop:删除行
df4 = df.drop(index=[0, 2])
print(f"\\ndrop 删除行:\\n{df4}")
方法说明:
| df.assign() | 新增列。参数为 列名=值,返回新 DataFrame |
| df.drop() | 删除列或行。columns 指定列,index 指定行 |
说明:
-
assign 返回新 DataFrame,可链式调用
-
drop 返回新 DataFrame
2.5.3 缺失值处理
# 缺失值处理
import pandas as pd
import numpy as np
df = pd.DataFrame({
"name": ["张三", "李四", "王五", "赵六"],
"age": [25, np.nan, 28, 35],
"score": [85, 92, np.nan, 88]
})
print(f"原始数据:\\n{df}")
# isnull:判断缺失
print(f"\\n是否缺失:\\n{df.isnull()}")
# 统计缺失数
print(f"\\n缺失数:\\n{df.isnull().sum()}")
# dropna:删除缺失行
print(f"\\n删除缺失行:\\n{df.dropna()}")
# fillna:填充缺失值
print(f"\\n填充 0:\\n{df.fillna(0)}")
# 用均值填充
print(f"\\n用均值填充:\\n{df.fillna(df.mean(numeric_only=True))}")
print(f"原始数据:\\n{df}") # 不会修改原数据
方法说明:
| df.isnull() | 判断是否缺失,返回布尔 DataFrame |
| df.dropna() | 删除缺失值。axis 指定轴,how 指定条件 |
| df.fillna() | 填充缺失值。参数为填充值 |
说明:
-
isnull() 返回布尔 DataFrame
-
dropna() 删除含缺失值的行
-
fillna() 填充缺失值
-
不会修改原数据,返回新的DataFrame对象
2.5.4 数据合并
2.5.4.1 merge(键连接)
merge 用于按键连接两个 DataFrame,类似 SQL 的 JOIN。
# merge:键连接
import pandas as pd
df1 = pd.DataFrame({
"id": [1, 2, 3],
"name": ["张三", "李四", "王五"]
})
df2 = pd.DataFrame({
"id": [2, 3, 4],
"score": [85, 92, 78]
})
# 内连接:只保留两表都有的键
inner = pd.merge(df1, df2, on="id", how="inner")
print(f"内连接:\\n{inner}")
# 左连接:保留左表所有键
left = pd.merge(df1, df2, on="id", how="left")
print(f"\\n左连接:\\n{left}")
# 外连接:保留所有键
outer = pd.merge(df1, df2, on="id", how="outer")
print(f"\\n外连接:\\n{outer}")
方法说明:
| on | 连接键,列名 |
| how | 连接方式:inner、left、right、outer |
说明:
-
inner:只保留两表都有的键
-
left:保留左表所有键
-
outer:保留所有键
2.5.4.2 concat(堆叠)
concat 用于堆叠多个 DataFrame,沿行或列方向。
# concat:堆叠
import pandas as pd
df1 = pd.DataFrame({
"name": ["张三", "李四"],
"age": [25, 30]
})
df2 = pd.DataFrame({
"name": ["王五", "赵六"],
"age": [28, 35]
})
# 沿行堆叠(上下)
row_concat = pd.concat([df1, df2], axis=0, ignore_index=True)
print(f"沿行堆叠:\\n{row_concat}")
# 沿列堆叠(左右)
col_concat = pd.concat([df1, df2], axis=1)
print(f"\\n沿列堆叠:\\n{col_concat}")
方法说明:
| axis | 0 沿行堆叠,1 沿列堆叠 |
| ignore_index | 是否重置索引 |
说明:
-
axis=0 上下堆叠
-
axis=1 左右堆叠
-
ignore_index=True 重置索引
2.5.5 数据分组与聚合
2.5.5.1 groupby 基础
groupby 是 Pandas 最强大的功能之一,用于按某个键分组,然后对每组做聚合运算。
核心流程: 拆分(split)→ 应用(apply)→ 合并(combine)
# groupby 基础
import pandas as pd
df = pd.DataFrame({
"city": ["杭州", "上海", "杭州", "上海", "北京", "杭州"],
"name": ["张三", "李四", "王五", "赵六", "钱七", "孙八"],
"score": [85, 92, 78, 88, 95, 90]
})
# 按 city 分组,求 score 均值
grouped = df.groupby("city")["score"].mean()
print(f"按 city 分组求均值:\\n{grouped}")
# 按 city 分组,求多个统计量
print(f"\\n按 city 分组,多个统计量:\\n{df.groupby('city')['score'].agg(['mean', 'max', 'min'])}")
# 按 city 分组,统计人数
print(f"\\n按 city 分组,统计人数:\\n{df.groupby('city').size()}")
方法说明:
| df.groupby("列") | 按列分组,返回 GroupBy 对象 |
| .agg([…]) | 多个聚合函数 |
| .size() | 统计每组数量 |
说明:
-
groupby 返回 GroupBy 对象,需接聚合函数
-
agg 可一次计算多个统计量
-
size 统计每组行数
2.5.5.2 agg 多聚合
agg 用于对分组数据同时应用多个聚合函数。
# agg 多聚合
import pandas as pd
df = pd.DataFrame({
"city": ["杭州", "上海", "杭州", "上海", "北京"],
"score": [85, 92, 78, 88, 95],
"age": [25, 30, 28, 35, 22]
})
# 多个聚合函数
result = df.groupby("city").agg({
"score": ["mean", "max", "min"],
"age": "mean"
})
print(f"多聚合:\\n{result}")
# 命名聚合(推荐)
result2 = df.groupby("city").agg(
score_mean=("score", "mean"),
score_max=("score", "max"),
age_mean=("age", "mean")
)
print(f"\\n命名聚合:\\n{result2}")
方法说明:
| agg(字典) | 对不同列应用不同聚合函数 |
| agg(命名元组) | 命名聚合,推荐 |
说明:
-
字典形式:{"列": ["函数1", "函数2"]}
-
命名聚合:新列名=("列", "函数")
-
命名聚合更清晰
2.5.5.3 reset_index
groupby 的结果索引是分组键,用 reset_index() 可将分组键转为列。
# reset_index
import pandas as pd
df = pd.DataFrame({
"city": ["杭州", "上海", "杭州", "上海", "北京"],
"score": [85, 92, 78, 88, 95]
})
# groupby 结果:索引是 city
grouped = df.groupby("city")["score"].mean()
print(f"未 reset_index:\\n{grouped}")
print(f"索引:{grouped.index.tolist()}")
# reset_index:索引转为列
grouped_reset = grouped.reset_index()
print(f"\\nreset_index 后:\\n{grouped_reset}")
print(f"列名:{grouped_reset.columns.tolist()}")
方法说明:
| .reset_index() | 将索引转为列,返回新 DataFrame |
说明:
-
groupby 结果索引是分组键
-
reset_index() 将索引转为列
-
方便后续处理
2.5.6 文本处理
2.5.6.1 str 访问器
str 访问器用于对字符串列进行向量化操作,如大小写、替换、切分。
# str 访问器
import pandas as pd
df = pd.DataFrame({
"name": ["张三", "李四", "王五"],
"email": ["ZhangSan@example.com", "LiSi@test.com", "WangWu@demo.com"]
})
# 大写
print(f"大写:\\n{df['email'].str.upper()}")
# 小写
print(f"\\n小写:\\n{df['email'].str.lower()}")
# 包含判断
print(f"\\n包含 example:\\n{df['email'].str.contains('example')}")
# 替换
print(f"\\n替换:\\n{df['email'].str.replace('.com', '.cn')}")
# 切分
print(f"\\n切分:\\n{df['email'].str.split('@')}")
方法说明:
| .str.upper() | 转大写 |
| .str.lower() | 转小写 |
| .str.contains() | 包含判断 |
| .str.replace() | 替换 |
| .str.split() | 切分 |
说明:
-
str 访问器用于字符串列
-
向量化操作,比 apply 快
2.5.6.2 apply / map / applymap 区分
| apply | 行/列 | 对每行或每列应用函数 |
| map | Series | 对每个元素应用函数 |
| applymap | DataFrame | 对每个元素应用函数 |
# apply / map / applymap
import pandas as pd
df = pd.DataFrame({
"name": ["张三", "李四"],
"score": [85, 92]
})
# apply:对列应用
print(f"apply 对列:\\n{df[['score']].apply(lambda x: x.max())}")
# map:对 Series 每个元素
print(f"\\nmap:\\n{df['name'].map(lambda x: f'学生-{x}')}")
# applymap:对 DataFrame 每个元素
print(f"\\napplymap:\\n{df.applymap(lambda x: str(x)+"test")}")
说明:
-
apply 作用于行/列
-
map 作用于 Series 元素
-
applymap 作用于 DataFrame 元素
2.5.6.3 拆分列 split / str.split
str.split() 用于拆分字符串列,可配合 expand=True 拆为多列。
# 拆分列
import pandas as pd
df = pd.DataFrame({
"info": ["张三-25-杭州", "李四-30-上海", "王五-28-北京"]
})
# 拆分为多列
split_df = df["info"].str.split("-", expand=True)
split_df.columns = ["name", "age", "city"]
print(f"拆分后:\\n{split_df}")
# 合并到原 DataFrame
df = pd.concat([df, split_df], axis=1)
print(f"\\n合并后:\\n{df}")
方法说明:
| str.split(sep) | 按分隔符拆分 |
| expand=True | 拆为多列 |
说明: expand=True 拆为多列,否则返回列表。
2.5.7 随机采样
sample() 用于随机采样,常用于数据集划分、抽样分析。
# 随机采样
import pandas as pd
df = pd.DataFrame({
"id": range(1, 11),
"score": [85, 92, 78, 88, 95, 90, 82, 87, 91, 86]
})
# 随机取 3 条
print(f"随机取 3 条:\\n{df.sample(n=3, random_state=42)}")
# 随机取 30%
print(f"\\n随机取 30%:\\n{df.sample(frac=0.3, random_state=42)}")
方法说明:
| n | 采样数量 |
| frac | 采样比例 |
| random_state | 随机种子,保证可复现 |
说明: random_state 保证结果可复现。
2.5.8 时间序列基础
to_datetime() 用于将字符串转为时间类型,dt 访问器用于提取时间属性。
# 时间序列基础
import pandas as pd
df = pd.DataFrame({
"date": ["2024-01-15", "2024-02-20", "2024-03-25"],
"score": [85, 92, 78]
})
# 转为时间类型
df["date"] = pd.to_datetime(df["date"])
print(f"转换后类型:{df['date'].dtype}")
# dt 访问器
df["year"] = df["date"].dt.year
df["month"] = df["date"].dt.month
df["day"] = df["date"].dt.day
print(f"\\n提取年月日:\\n{df}")
方法说明:
| pd.to_datetime() | 转为时间类型 |
| .dt.year | 提取年份 |
| .dt.month | 提取月份 |
| .dt.day | 提取日 |
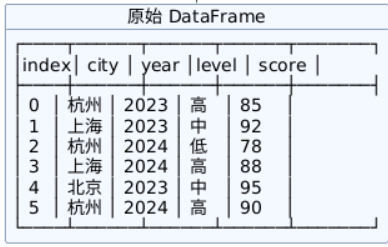
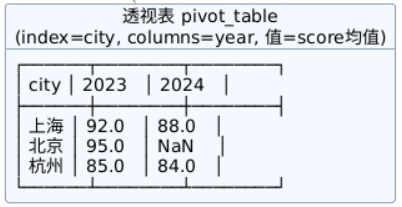
2.5.9 透视表与交叉表(了解)
| 透视表(pivot_table) | 对数据进行多维汇总,可指定值列、行、列和聚合函数 | 类似 Excel 数据透视表 |
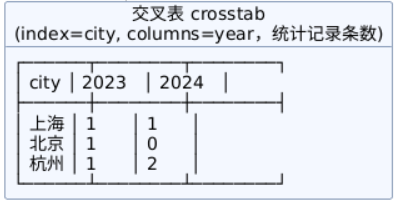
| 交叉表(crosstab) | 统计两个分类变量的频次,是透视表的特例 | 类似列联表 |
2.6 综合实战案例
2.6.1 模型输出解析(JSON → DataFrame)
调用本地 Ollama 模型,获取 JSON 输出,解析为 DataFrame。这是大模型应用开发的第一步。
# 模型输出解析:JSON → DataFrame
import httpx
import json
import pandas as pd
# 调用 Ollama
def call_ollama(prompt):
"""调用本地 Ollama 模型"""
response = httpx.post(
"http://localhost:11434/v1/chat/completions",
headers={"Authorization": "Bearer ollama"},
json={
"model": "qwen2.5:1.5b",
"messages": [{"role": "user", "content": prompt}],
"stream": False
},
timeout=60
)
return response.json()["choices"][0]["message"]["content"]
# 批量调用
prompts = [
"用一句话介绍 Python",
"用一句话介绍 Java",
"用一句话介绍 Go",
]
results = []
for i, prompt in enumerate(prompts):
output = call_ollama(prompt)
results.append({
"id": i + 1,
"prompt": prompt,
"output": output,
"length": len(output)
})
# 转为 DataFrame
df = pd.DataFrame(results)
print(f"模型输出:\\n{df}")
# 保存
df.to_csv("model_outputs.csv", index=False, encoding="utf-8")
print("\\n已保存 model_outputs.csv")
方法说明:
| httpx.post() | 发送 POST 请求。json 参数传递请求体 |
| response.json() | 解析 JSON 响应 |
| pd.DataFrame() | 从列表的字典创建 DataFrame |
| df.to_csv() | 保存为 CSV。index=False 不写索引 |
说明:
-
调用 Ollama 获取模型输出
-
批量调用,收集结果
-
转为 DataFrame,保存
2.6.2 评测集统计(准确率、badcase)
构建评测集,调用模型,统计准确率,筛选 badcase。这是大模型评测的核心流程。
# 评测集统计
import httpx
import json
import pandas as pd
def call_ollama(prompt):
"""调用本地 Ollama 模型"""
response = httpx.post(
"http://localhost:11434/v1/chat/completions",
headers={"Authorization": "Bearer ollama"},
json={
"model": "qwen2.5:1.5b",
"messages": [
{"role": "system", "content": "你是一个分类助手,只回答类别名称。"},
{"role": "user", "content": prompt}
],
"stream": False
},
timeout=60
)
return response.json()["choices"][0]["message"]["content"].strip()
# 评测集
test_cases = [
{"id": 1, "text": "今天天气真好", "label": "积极"},
{"id": 2, "text": "这个产品太差了", "label": "消极"},
{"id": 3, "text": "我喜欢这个电影", "label": "积极"},
{"id": 4, "text": "服务态度很差", "label": "消极"},
{"id": 5, "text": "一般般吧", "label": "中性"},
]
# 批量评测
for case in test_cases:
prompt = f"判断以下文本的情感(积极/消极/中性):{case['text']}"
case["pred"] = call_ollama(prompt)
# 转为 DataFrame
df = pd.DataFrame(test_cases)
print(f"评测结果:\\n{df}")
# 统计准确率
df["correct"] = df["pred"] == df["label"]
accuracy = df["correct"].mean()
print(f"\\n准确率:{accuracy:.2%}")
# 筛选 badcase
badcases = df[~df["correct"]]
print(f"\\nbadcase:\\n{badcases}")
方法说明:
| df["correct"] = df["pred"] == df["label"] | 新增布尔列 |
| df["correct"].mean() | 计算准确率 |
| df[~df["correct"]] | 筛选 badcase |
说明:
-
批量调用模型,收集预测
-
统计准确率
-
筛选 badcase 分析
2.6.3 数据清洗与导出
对模型输出进行数据清洗(去重、缺失值、文本处理),然后导出。
# 数据清洗与导出
import pandas as pd
import numpy as np
# 模拟模型输出(含脏数据)
df = pd.DataFrame({
"id": [1, 2, 3, 4, 5, 5],
"prompt": ["介绍Python", "介绍Java", "介绍Go", None, "介绍C++", "介绍C++"],
"output": ["Python是一种…", "Java是一种…", None, "Go是一种…", "C++是一种…", "C++是一种…"],
"score": [0.95, 0.87, 0.92, 0.88, np.nan, 0.88]
})
print(f"原始数据:\\n{df}")
print(f"\\n缺失值:\\n{df.isnull().sum()}")
# 去重
df = df.drop_duplicates(subset=["prompt"])
print(f"\\n去重后:\\n{df}")
# 删除缺失值
df = df.dropna(subset=["prompt", "output"])
print(f"\\n删除缺失后:\\n{df}")
# 填充缺失值
df["score"] = df["score"].fillna(df["score"].mean())
print(f"\\n填充后:\\n{df}")
# 文本处理:截断输出
df["output_short"] = df["output"].str[:20]
print(f"\\n截断后:\\n{df}")
# 导出
df.to_csv("cleaned_data.csv", index=False, encoding="utf-8")
df.to_json("cleaned_data.json", orient="records", force_ascii=False)
print("\\n已导出 cleaned_data.csv 和 cleaned_data.json")
方法说明:
| df.drop_duplicates() | 去重 |
| df.dropna() | 删除缺失值 |
| df.fillna() | 填充缺失值 |
| df["列"].str[:20] | 文本截断 |
| df.to_csv() | 导出 CSV |
| df.to_json() | 导出 JSON |
说明:
-
去重、删除缺失、填充缺失
-
文本处理
-
导出为 CSV / JSON
三、Matplotlib 入门(简要了解)
3.1 Matplotlib 介绍
3.1.1 Matplotlib 是什么
Matplotlib 是 Python 最基础、最常用的数据可视化库,用于绘制各种图表(折线图、直方图、柱状图等)。
一句话理解: Matplotlib 让 Python 能像 Excel 一样画图,但更灵活、更可定制。
3.1.2 为什么大模型角色只需简要了解
大模型应用开发中,可视化不是核心工作,但需要快速出图辅助分析。
大模型场景下的典型需求
| 看 loss 曲线 | 折线图 | 观察训练是否收敛 |
| 看数据分布 | 直方图 | 观察数据分布是否均匀 |
| 看类别分布 | 柱状图 | 观察类别是否平衡 |
| 记录实验 | 保存图片 | 保存到实验目录,便于对比 |
3.2 大模型场景下最常用的图
3.2.1 loss / accuracy 曲线(折线图)
折线图用于展示随时间变化的趋势,是大模型训练中最常用的图。通过 loss 曲线判断训练是否收敛、是否过拟合。
| 看 loss 曲线 | 判断训练是否收敛 |
| 看 accuracy 曲线 | 判断模型是否提升 |
| 对比多次实验 | 对比不同超参数的训练效果 |
-
X 轴:epoch(训练轮次)
-
Y 轴:loss(损失值)
-
判断:loss 持续下降并趋于平稳 → 收敛
-
判断:loss 先降后升 → 过拟合
3.2.2 数据分布(直方图)
直方图用于展示数据的分布情况,观察数据是否均匀、是否偏斜。
| 看数据分布 | 观察数据是否均匀 |
| 看长尾分布 | 观察是否存在长尾 |
| 数据清洗前 | 判断是否需要归一化 |
-
X 轴:数据值(分箱)
-
Y 轴:频次
-
判断:中间高两边低 → 正态分布
-
判断:偏左或偏右 → 偏斜分布
3.2.3 类别分布(柱状图)
柱状图用于展示不同类别的数量对比,观察类别是否平衡。
| 看类别分布 | 观察类别是否平衡 |
| badcase 统计 | 统计各类 badcase 数量 |
| 评测结果 | 统计各标签的准确率 |
-
X 轴:类别
-
Y 轴:数量
-
判断:柱子高度差异大 → 类别不平衡
-
应用:badcase 统计、评测结果分析
3.2.4 散点图(了解)
散点图用于展示两个变量之间的关系,观察是否存在相关性。
| 看相关性 | 观察两个变量是否相关 |
| 看聚类 | 观察数据是否分群 |
| 异常值检测 | 观察是否有离群点 |
-
X 轴:变量 1
-
Y 轴:变量 2
-
判断:点呈上升趋势 → 正相关
-
判断:点分散 → 无相关
说明: 散点图在大模型场景中较少用,了解即可。
3.2.5 图表选择指南(了解)
根据分析目的选择合适的图表类型。
| 看趋势 | 折线图 | loss 曲线 |
| 看分布 | 直方图 | 数据分布 |
| 看对比 | 柱状图 | 类别分布 |
| 看关系 | 散点图 | 相关性 |
大模型场景速查
| 训练是否收敛 | 折线图 |
| 数据是否均匀 | 直方图 |
| 类别是否平衡 | 柱状图 |
| 变量是否相关 | 散点图 |
说明: 大模型角色主要用折线图、直方图、柱状图,散点图了解即可。
3.3 基础绘图功能
3.3.1 与 pandas 联动 df.plot()
Pandas 内置 plot() 方法,基于 Matplotlib,可一行代码出图,是最便捷的方式。
# 与 pandas 联动 df.plot()
import pandas as pd
import matplotlib.pyplot as plt
# 模拟训练日志
df = pd.DataFrame({
"epoch": [1, 2, 3, 4, 5, 6, 7, 8],
"loss": [1.0, 0.8, 0.6, 0.5, 0.4, 0.35, 0.33, 0.32],
"accuracy": [0.5, 0.6, 0.7, 0.75, 0.8, 0.83, 0.85, 0.86]
})
# 折线图:loss 曲线
df.plot(x="epoch", y="loss", title="Loss Curve")
plt.savefig("loss_curve.png")
plt.show()
# 多条曲线
df.plot(x="epoch", y=["loss", "accuracy"], title="Training Metrics")
plt.show()
方法说明:
| x | X 轴列名 |
| y | Y 轴列名(可为列表) |
| kind | 图表类型:line、bar、hist、scatter |
| title | 图表标题 |
说明:
-
df.plot() 一行出图
-
kind 指定图表类型
-
返回 Axes 对象,可继续定制
3.3.2 与 NumPy 数组直接绘图
Matplotlib 可直接接收 NumPy 数组,无需转 DataFrame。
# 与 NumPy 数组直接绘图
import numpy as np
import matplotlib.pyplot as plt
# 生成数据
x = np.linspace(0, 10, 100)
y = np.sin(x)
# 直接绘图
plt.plot(x, y)
plt.title("Sin Wave")
plt.show()
# 多条曲线
y2 = np.cos(x)
plt.plot(x, y, label="sin")
plt.plot(x, y2, label="cos")
plt.legend()
plt.show()
方法说明:
| x, y | 数据数组 |
| label | 曲线标签,用于图例 |
说明: Matplotlib 可直接接收 NumPy 数组。
3.3.3 pyplot 风格 plt.plot / scatter / hist
pyplot 是 Matplotlib 的函数式接口,提供 plt.plot、plt.scatter、plt.hist 等快捷方法。
# pyplot 风格
import numpy as np
import matplotlib.pyplot as plt
# ===== 折线图 =====
x = np.linspace(0, 10, 100)
plt.plot(x, np.sin(x))
plt.title("Line Plot")
plt.show()
# ===== 散点图 =====
x = np.random.rand(50)
y = np.random.rand(50)
plt.scatter(x, y)
plt.title("Scatter Plot")
plt.show()
# ===== 直方图 =====
data = np.random.randn(1000)
plt.hist(data, bins=30)
plt.title("Histogram")
plt.show()
方法说明:
| plt.plot() | 折线图 |
| plt.scatter() | 散点图 |
| plt.hist() | 直方图。bins 指定分箱数 |
说明:
-
plt.plot 折线图
-
plt.scatter 散点图
-
plt.hist 直方图
3.3.4 标题、坐标轴标签、图例
为图表添加标题、坐标轴标签、图例,使图表更清晰。
# 标题、坐标轴标签、图例
import numpy as np
import matplotlib.pyplot as plt
x = np.linspace(0, 10, 100)
plt.plot(x, np.sin(x), label="sin")
plt.plot(x, np.cos(x), label="cos")
# 标题
plt.title("test")
# 坐标轴标签
plt.xlabel("x")
plt.ylabel("y")
# 图例
plt.legend()
plt.show()
方法说明:
| plt.title() | 设置标题 |
| plt.xlabel() | 设置 X 轴标签 |
| plt.ylabel() | 设置 Y 轴标签 |
| plt.legend() | 显示图例 |
说明:
-
title 标题
-
xlabel / ylabel 坐标轴标签
-
legend 图例,需在 plot 时指定 label
3.3.5 保存图片 savefig
savefig() 用于保存图片到文件,常用于记录实验。
# 保存图片
import numpy as np
import matplotlib.pyplot as plt
x = np.linspace(0, 10, 100)
plt.plot(x, np.sin(x))
plt.title("Sin Wave")
# 保存图片
plt.savefig("sin_wave.png", dpi=150, bbox_inches="tight")
print("已保存 sin_wave.png")
方法说明:
| fname | 文件名,支持 PNG、JPG、PDF |
| dpi | 分辨率,默认 100 |
| bbox_inches | "tight" 去除多余空白 |
说明:
-
支持多种格式:PNG、JPG、PDF、SVG
-
dpi 控制清晰度
-
bbox_inches="tight" 去除空白


评论前必须登录!
注册