 网硕互联帮助中心
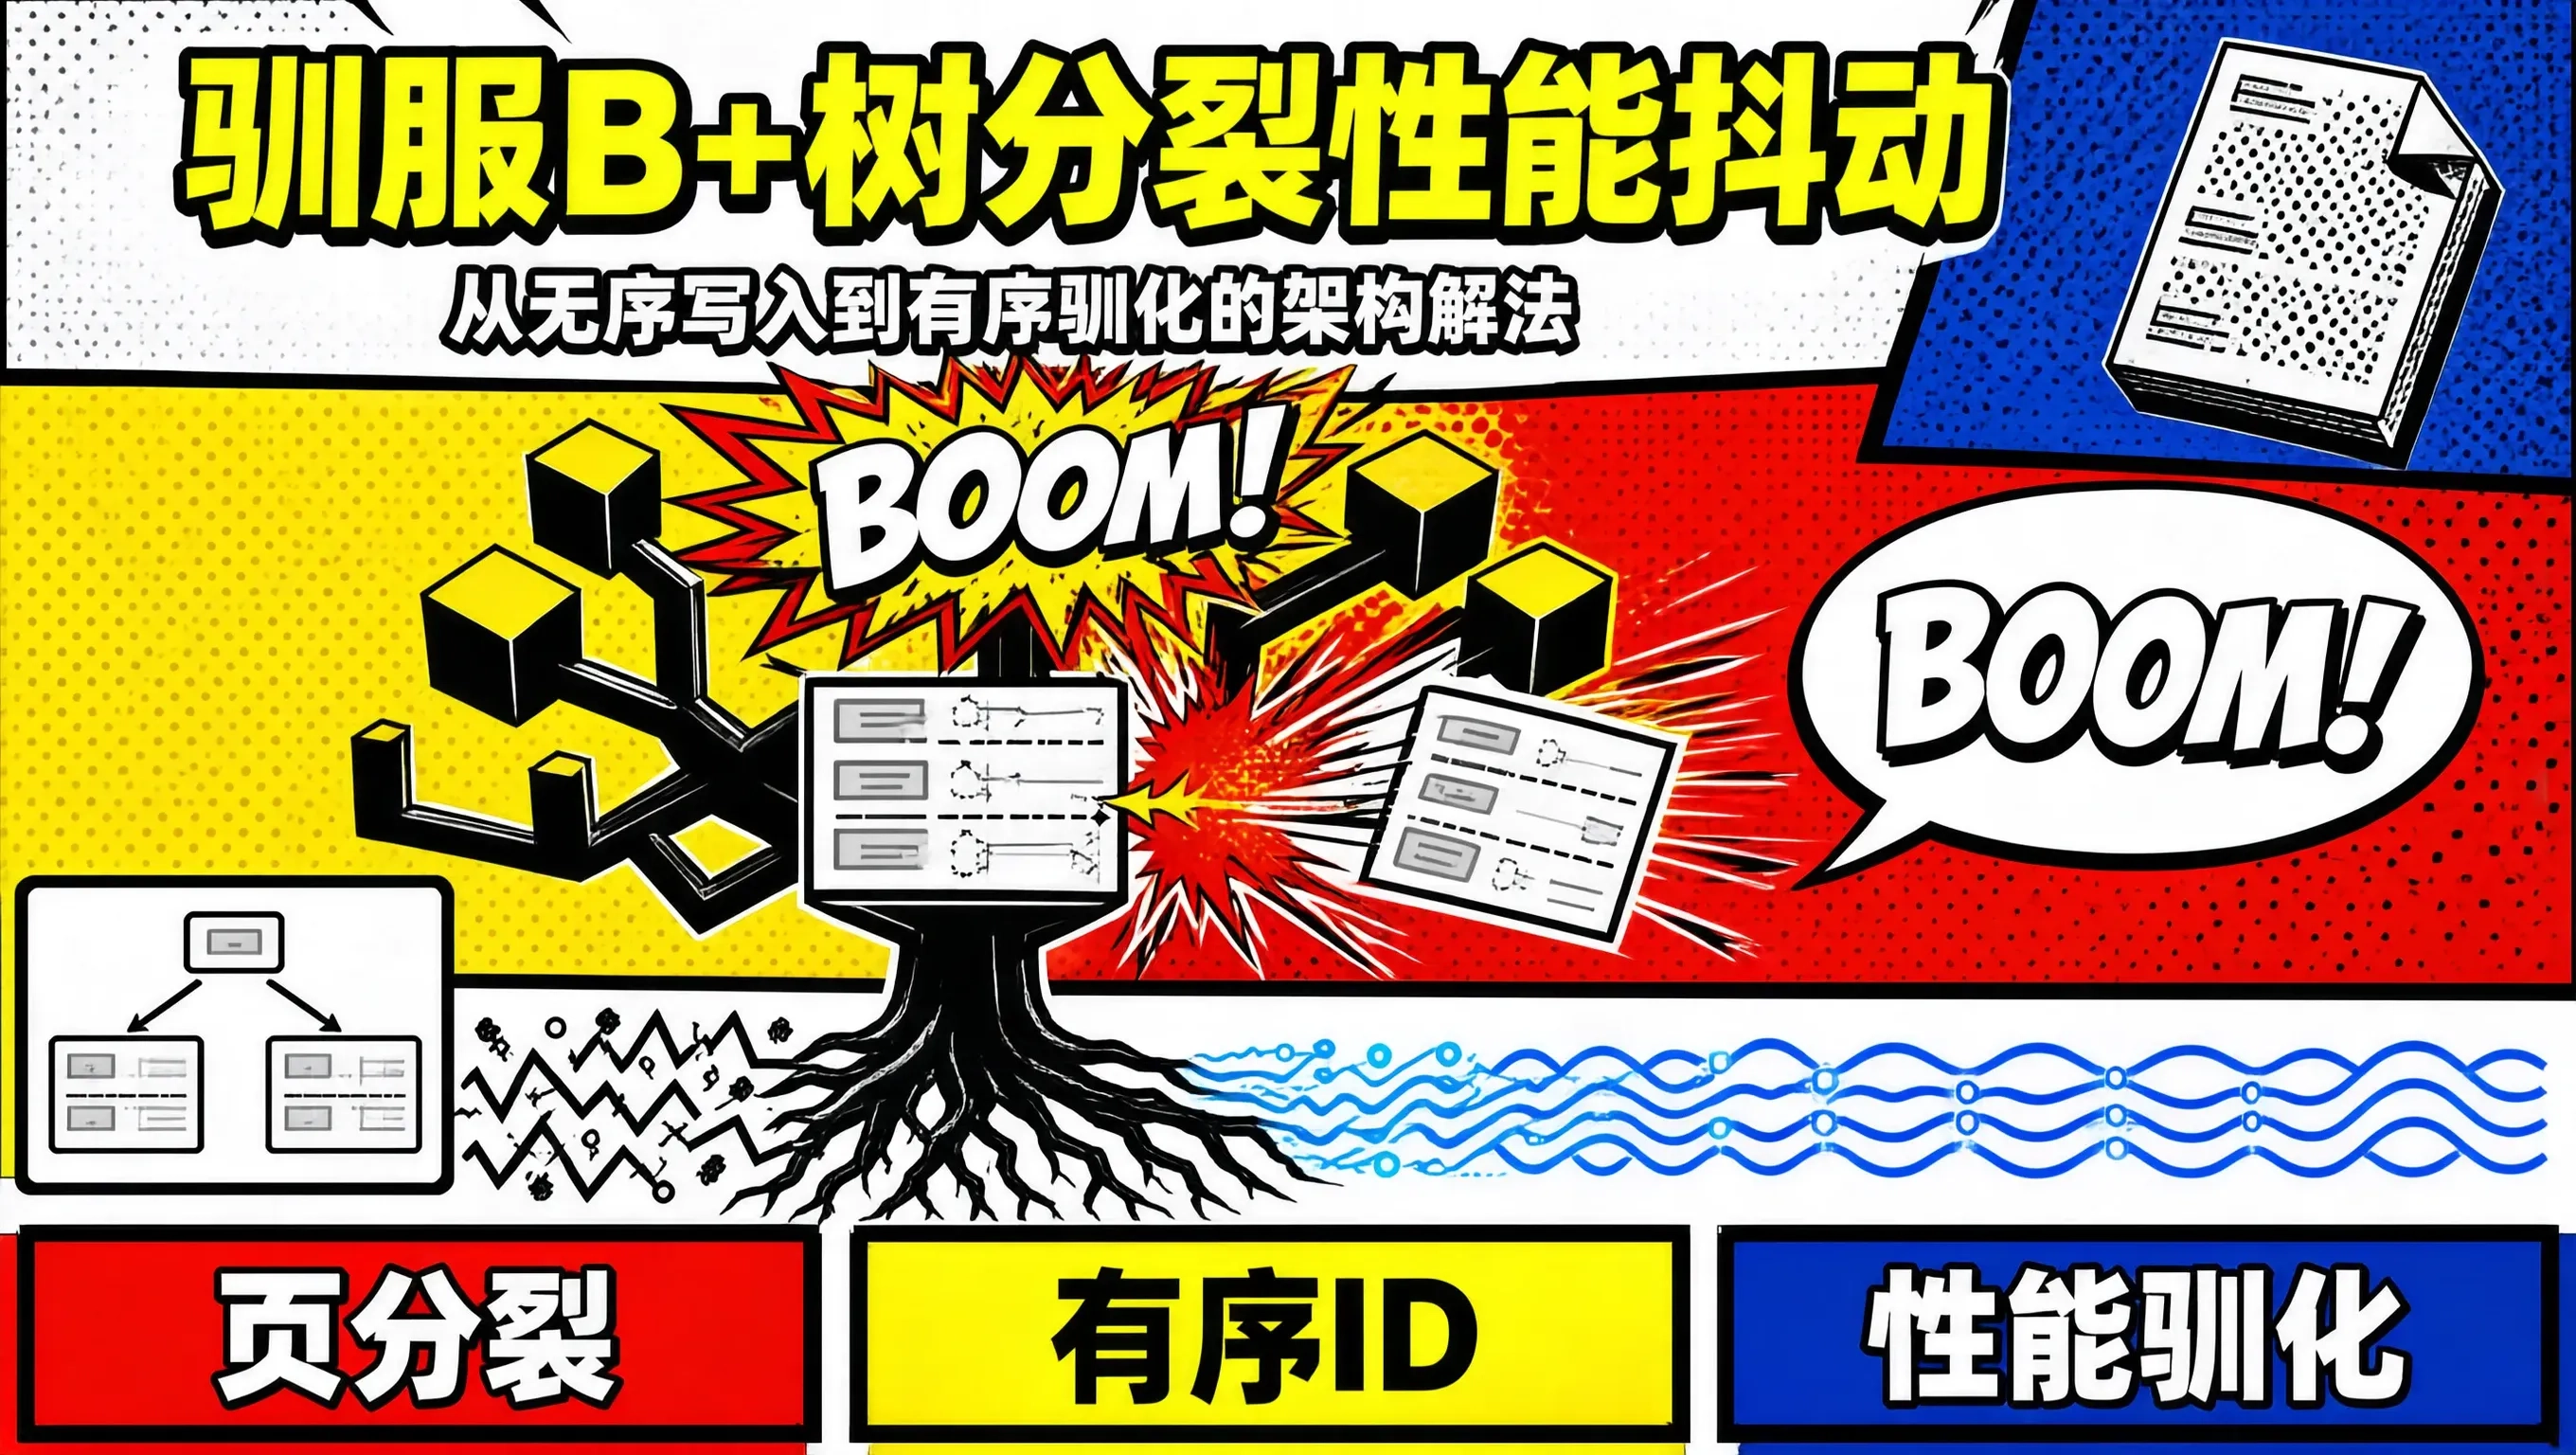
在构建高吞吐在线事务处理(OLTP)或数据回写系统时,工程师常常会遭遇一种令人困惑的现象:系统在平稳运行若干小时后,数据库的写入吞吐量突然毫无征兆地发生周期性断崖暴跌,P99 写入延迟从原本的 5ms 瞬间飙升至数秒,伴随着磁盘 I/O 利用率顶格(100%)以及大量的数据库线程处于阻塞状态。
这种周期性的性能抖动,在大批量使用非自增主键(如 UUID、无序字符串 Hash)或含有频繁离散二级索引的随机写入场景中尤为剧烈。
其背后的深层物理根源,正是 MySQL InnoDB 存储引擎底层 B+ 树索引节点的页分裂(Page Split)与页合并(Page Merge)。本文将深入 InnoDB 物理页面与 B+ 树组织结构,拆解页分裂引发 I/O 放大与缓冲池震荡的完整链路,并给出系统性的优化与抗抖动方案。
一、 物理结构:InnoDB 数据页与 B+ 树节点的动态演化
InnoDB 的核心逻辑存储单位是数据页(Page),默认物理大小为 16KB。一个 B+ 树索引无论是由主键聚簇还是由普通列构成的二级索引,其树状拓扑中的每一个节点,在磁盘与 Buffer Pool 内存中都对应着一个 16KB 的数据页。
flowchart TD
subgraph 顺序递增插入 (理想填满 15/16)
P1[Page 1: 1, 2, 3 … 满] –>|追加新页| P2[Page 2: 紧凑顺序写入]
end
subgraph 随机离散插入 (引发页分裂)
P3["Page A: 已满 (10, 20, 30, 40, 50)"]
Insert["尝试插入 25 (目标落入 Page A 中间)"]
Insert –> P3
P3 –>|触发页分裂| Split["申请新页 Page B<br/>将后半部分 (30,40,50) 物理拷贝至 Page B"]
Split –> Result["Page A 空间利用率跌至 50%<br/>父节点指针变更,产生离散双向链表调整"]
end
1. 顺序插入 vs 随机插入的底层差异
- 顺序递增插入(Sequential Insert):当采用 AUTO_INCREMENT 整数作为主键时,新插入的行总是挂载在当前最新叶子页的物理末尾。InnoDB 针对这种模式做了极致的局部性优化:当一个页写满到大约 $\\frac{15}{16}$ 的阈值后,引擎会自动申请一个全新的空白页,继续在末尾追加。旧页面被紧凑填充,几乎没有存储空间碎片,且全程属于纯粹的连续顺序 I/O。
- 随机离散插入(Random Insert):如果主键是 32 位的 UUID(例如 8f3b2a…),由于其数值在全空间内高度均匀离散,每一条新写入的数据可能随机落入整个 B+ 树上百万个叶子页中的任意一个。当目标叶子页的空间已经被填满时,为了给新插入的行腾出排序位置,InnoDB 别无选择,必须强行将该数据页切分为两个页面。
二、 页分裂(Page Split)的五重破坏性连锁反应
一次看似微小的页分裂,在底层会触发一系列沉重的物理连锁代价:
1. 内存数据的物理搬迁与双向链表重组
InnoDB 会在 Buffer Pool 中申请一个空闲数据页(如果缓存不够,还要触发 LRU 刷盘淘汰其他干净页),将原页面中后半段约 50% 的记录**物理内存拷贝(Memory Copy)**到新页面中,并将新数据行插入对应位置。随后,必须更新原页、新页以及前后邻居页之间的双向物理指针(FIL_PAGE_PREV 与 FIL_PAGE_NEXT)。
2. 父节点向上扩散演化(Tree Upward Propagation)
叶子节点分裂产生了一个全新的数据页,这意味着该页的最小键值必须作为索引项,插入到其上层的非叶子中间节点(Internal Node)中。如果其父节点此时也已经填满,分裂就会向上传导,诱发父节点分裂。在极端情况下,这种分裂甚至会一级级向上扩散,直到整棵 B+ 树的根节点(Root Node)发生分裂,引发整棵 B+ 树的层高(Tree Height)加 1。
3. 页面空间利用率腰斩与存储膨胀(Space Fragmentation)
分裂后的两个页面,各自的空间充盈率瞬间由原本的近 100% 暴跌至大约 50%。在持续的高并发随机写入下,整张表的叶子节点充斥着大量半满甚至稀疏的碎片页。测试数据显示:使用随机 UUID 主键存储相同数量级的数据,其最终占用的物理磁盘体积往往是自增主键的 1.6 到 2.2 倍。
4. Buffer Pool 缓存局部性(Locality)彻底崩溃
由于写入点完全随机分散,原本在 Buffer Pool 中被热点缓存的页面无法再复用。系统需要频繁地从磁盘将冷页面换入内存,导致 Buffer Pool 的命中率大幅跳水,整个数据库由“内存计算”迅速退化为“磁盘 I/O 阻塞”。
5. 重做日志(Redo Log)与脏页刷盘洪峰
页分裂涉及大量的指针更新、页面初始化和物理位移,这些修改全部需要同步记录到 InnoDB 的 Redo Log 中,导致 Redo Log 的写入体积瞬间暴增数十倍。一旦 Redo Log 推进过快逼近检查点(Checkpoint),InnoDB 会强制启动同步脏页刷盘(Furious Flushing),阻断所有的前台业务写入,造成吞吐量断崖。
三、 压测验证与监控指标识别
在生产系统中,如何确诊系统当前的性能抖动就是由页分裂所导致的?
可以通过以下系统状态变量进行采样对比:
— 抓取当前实例的页面分裂与分配统计量
SHOW GLOBAL STATUS LIKE 'Innodb_pages_%';
核心关注两个指标:
- Innodb_pages_created:新创建的数据页数量。如果在平稳写入期该指标呈现爆发式飙升,说明正在密集申请新页分裂。
- Innodb_buffer_pool_pages_dirty:Buffer Pool 中脏页数量。如果伴随大批量写入出现毛刺,说明分裂正在加速产生脏页。
也可以直接通过性能模式(Performance Schema)监控互斥锁(Mutex)争用:
SELECT
event_name,
count_star,
sum_timer_wait / 1000000000 AS wait_ms
FROM performance_schema.events_waits_summary_global_by_event_name
WHERE event_name LIKE '%wait/synch/mutex/innodb/index%'
ORDER BY sum_timer_wait DESC
LIMIT 5;
如果 wait/synch/mutex/innodb/index_tree 的等待时间排在第一位,毫无疑问,B+ 树的全局索引结构调整(SX-Lock / X-Lock)正在严重阻塞并发线程。
四、 大批量随机写入场景的架构调优实战
1. 架构主治方案:改用时间有序的分布式唯一 ID(有序性改造)
从源头上消灭无序,是解决页分裂的最强解法。严禁使用标准的 UUID v4(纯随机)。如果业务必须使用具有分布式唯一性且不暴露自增规律的 ID,应当切换为时间单调递增的有序 ID:
- Twitter Snowflake(雪花算法):高位为毫秒级时间戳,中位为机器节点 ID,低位为自增序列。在 B+ 树叶子节点中天然呈现近似严格的追加写入特性。
- ULID(Universally Unique Lexicographically Sortable Identifier):具备与 UUID 完全兼容的 128 位长度,但前 48 位为精准的时间戳,文本呈现上字典序严格递增。
- MySQL 8.0 UUID_TO_BIN(UUID(), 1):将传统 UUID 的低位时间与高位时间调换,使生成的 16 字节二进制数据具备前缀单调性。
— MySQL 8.0 原生有序 UUID 方案
CREATE TABLE user_orders (
— 将 swap_flag 设为 1,将 UUID 的时间高位挪到最前,实现 B+ 树单调追加
order_id BINARY(16) DEFAULT (UUID_TO_BIN(UUID(), 1)),
user_id BIGINT,
amount DECIMAL(10,2),
PRIMARY KEY (order_id)
);
2. 批量回写前的内存预排序(Pre-sorting Buffer)
如果上游确实只能提供完全无序的散列数据(例如接收离线计算结果的大批量导入),切勿直接乱序并发写入 MySQL。应当在上游应用内存或中间层(如 Flink/Spark)先按 MySQL 表的主键进行局部归并排序(Local Sorting),再以单调递增的批次有序提交给数据库:
# 写入端防页分裂缓冲排序示例
def flush_batch_to_mysql(records):
# 按照表的主键 ID 进行物理升序排序
records.sort(key=lambda x: x["primary_key_id"])
# 顺序构造多行批量 INSERT,最大化利用当前叶子页的局部性
execute_bulk_insert(records)
3. InnoDB 引擎级参数调优
对于大批量写入密集型的特定实例,通过调整参数减缓冲盘压力与并发争抢:
[mysqld]
# 1. 扩大 Buffer Pool 脏页刷盘的 I/O 容量 (结合 SSD 真实性能配置)
innodb_io_capacity = 4000
innodb_io_capacity_max = 8000
# 2. 放宽自适应脏页刷盘的激进度,平滑刷盘曲线,防止瞬时猛冲
innodb_max_dirty_pages_pct = 75
innodb_max_dirty_pages_pct_lwm = 50
# 3. 增大 Redo Log 单文件体积与总容量 (MySQL 8.0.30+ 配置 innodb_redo_log_capacity)
# 充足的 Redo 空间能有效延缓 Checkpoint 追赶导致的阻塞
innodb_redo_log_capacity = 16G
# 4. 调整 Change Buffer 大小,吸收二级索引的离散写入 (对非唯一二级索引有效)
innodb_change_buffer_max_size = 30
五、 总结
数据库性能优化的深水区,始终建立在对底层硬件特性与数据结构演化规律的深刻洞见之上。B+ 树的平衡性保证了极速的二分查找,但其代价就是对无序写入的高度敏感。通过推动主键单调有序化改造、引入批量写入前置预排序、以及匹配合理的 InnoDB 刷盘参数,我们能够彻底驯服由 B+ 树页分裂带来的性能抖动猛兽,让核心数据库在高并发大批量写入下依然稳如磐石。


评论前必须登录!
注册