 网硕互联帮助中心
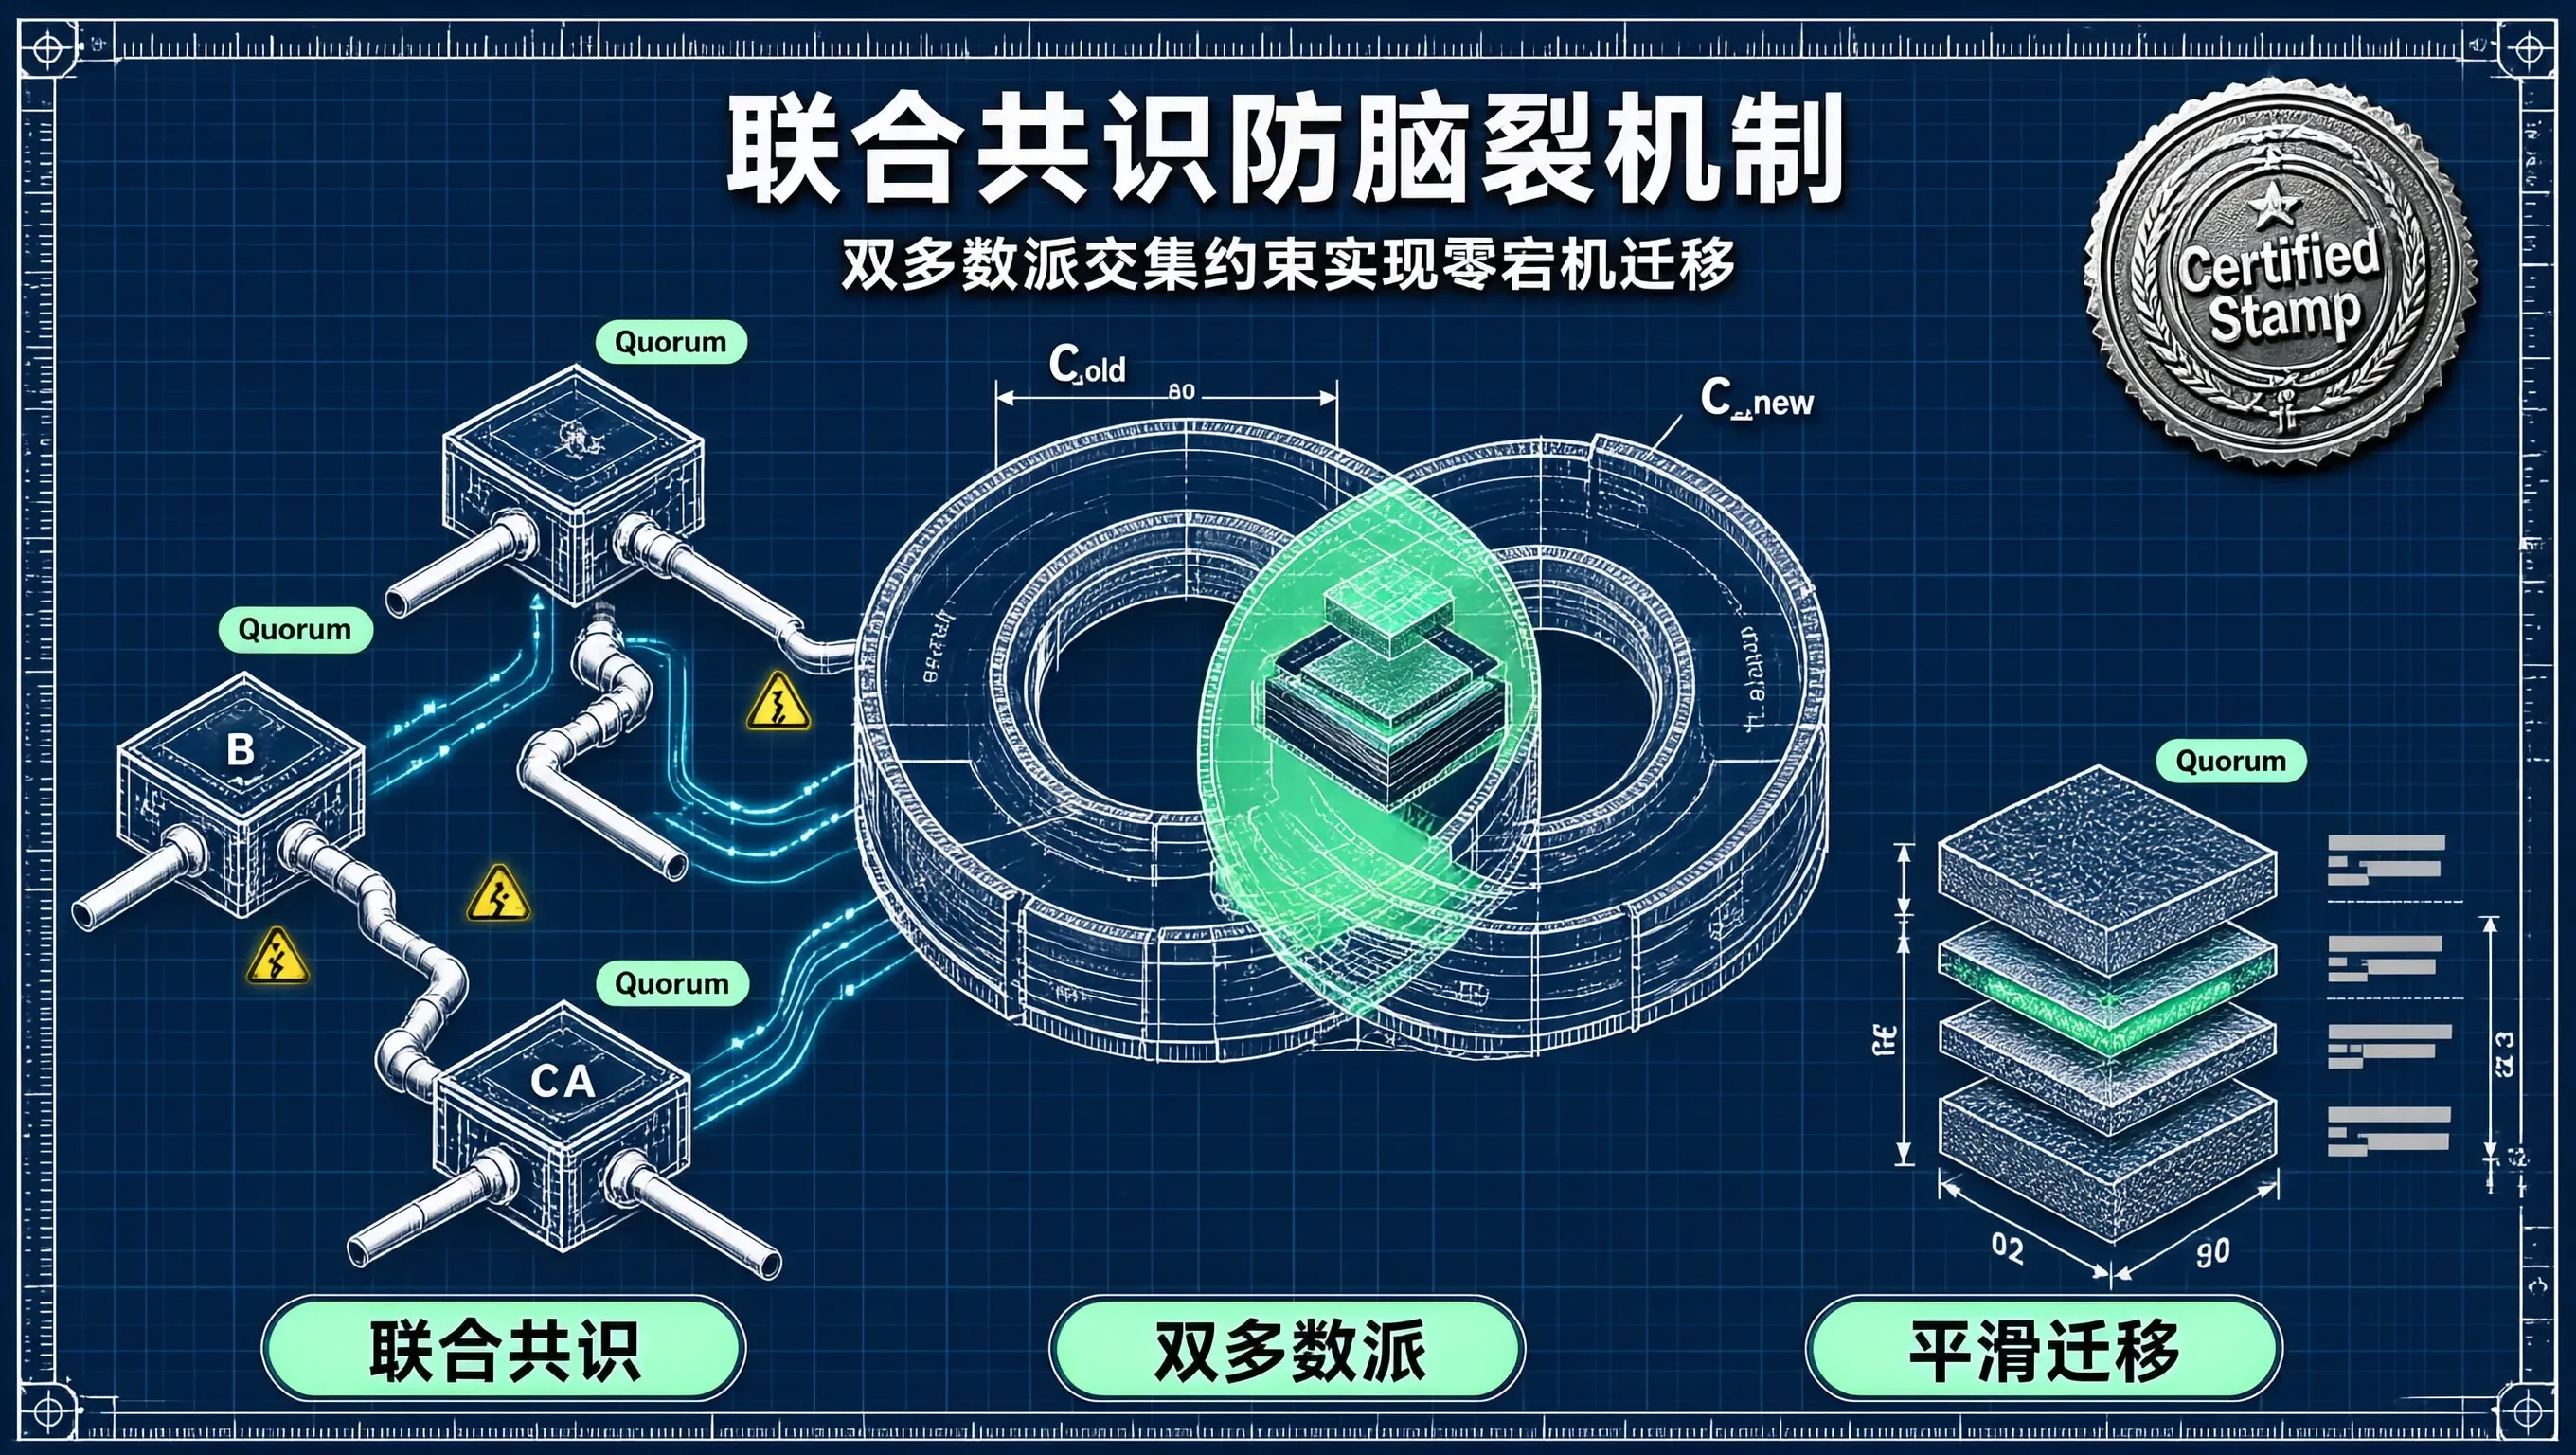
在分布式键值存储与分布式事务数据库(如 TiKV、etcd 等)的实际生产运维中,物理硬件老化更替、机房搬迁或机器故障下线是常态化操作。然而,集群成员变更(Membership Change)向来是分布式系统运行期间最脆弱的物理切片。如果在动态增加或剔除节点的过程中缺乏严谨的一致性机制保护,极易在集群内部形成两个互不相交的多数派(Disjoint Majorities),进而导致在同一任期(Term)内诞生两个合法 Leader,引发不可逆转的脑裂(Split-brain)与数据分叉覆灭。
许多工程团队在早期实现 Raft 算法时,倾向于采用简单的单步节点变更(每次只增删一个节点)。但在面临机房整体搬迁或多个坏盘节点同时下线时,单步变更不仅耗时极其冗长,而且在连续故障并发时状态机推演极易失控。工业级分布式存储系统在处理大规模平滑迁移时,核心依靠的是 Raft 论文中定义的终极保障——联合共识(Joint Consensus)。
脑裂风险剖析:多数派的重叠断裂
为什么配置变更不能直接一次性从旧配置 $C_{old}$ 切换到新配置 $C_{new}$?
假设一个由 3 个节点构成的集群 ${A, B, C}$,现在计划将其平滑迁移替换至另外两台更高性能的新机架节点,构建新的 3 节点集群 ${C, D, E}$。若 Leader 直接向所有节点广播“当前生效配置变更为 ${C, D, E}$”,由于分布式网络中消息存在不可控的延迟和丢包,不同节点收到并应用该日志的时机必然存在物理时差:
- 节点 $A$ 和 $B$ 尚未收到该消息,依然遵循 $C_{old}={A, B, C}$ 的多数派仲裁原则(只需 2 票赞成即可形成决议),它们完全可以自主选出 $A$ 作为合法 Leader。
- 与此同时,节点 $D$ 和 $E$ 已经收到了新配置并进入 $C_{new}={C, D, E}$,在新配置的多数派规则下(只需 2 票赞成),节点 $D$ 和 $E$ 同样可以合法选举出 $D$ 作为 Leader。
此时,集群在同一时刻分裂出了两个并行的法定多数派。两个 Leader 同时对外接受客户端写请求,底层存储状态机彻底分道扬镳,系统宣告崩溃。
联合共识(Joint Consensus)的物理执行法则
联合共识通过引入一个显式的两阶段过渡配置状态 $C_{old,new}$,在数学上强制切断了脑裂的可能。
在 $C_{old,new}$ 状态下,任何日志的提交(包括配置变更日志本身)以及 Leader 选举,必须同时满足一个极端苛刻的前提条件:必须在 $C_{old}$ 中获得多数派赞成,且必须在 $C_{new}$ 中同时获得多数派赞成。两个独立的多数派重合校验,使得任何一方都无法单独越权形成决议。
阶段一:Leader 写入并提交联合配置日志 C_{old,new}
此时集群规则:Quorum = (Majority of C_{old}) AND (Majority of C_{new})
阶段二:一旦 C_{old,new} 成功 Commit,Leader 立即写入目标配置 C_{new}
一旦 C_{new} 在新集群中达成多数派提交,老节点正式安全退役
工业级 Joint Consensus 投票裁决核心实现
在状态机与选举投票逻辑中,必须实现支持双集合的法定人数裁决器(Joint Quorum Matcher)。以下为 Go 语言工程核心实现:
// quorum.go
// 联合共识法定人数仲裁器
package raft
type Config struct {
OldNodes map[uint64]bool
NewNodes map[uint64]bool
}
type JointQuorum struct {
Cfg Config
}
func (jq *JointQuorum) IsCommitted(votes map[uint64]bool) bool {
// 校验在 C_old 集合中是否达到多数派
oldAgreed := 0
for id := range jq.Cfg.OldNodes {
if votes[id] {
oldAgreed++
}
}
oldMajority := (len(jq.Cfg.OldNodes) / 2) + 1
if oldAgreed < oldMajority {
return false
}
// 若当前处于联合状态,还必须校验在 C_new 集合中是否达到多数派
if len(jq.Cfg.NewNodes) > 0 {
newAgreed := 0
for id := range jq.Cfg.NewNodes {
if votes[id] {
newAgreed++
}
}
newMajority := (len(jq.Cfg.NewNodes) / 2) + 1
if newAgreed < newMajority {
return false
}
}
return true
}
在 Leader 执行配置迁移时,其标准状态流转调度如下:
// membership.go
// 发起平滑下线与联合共识迁移的主流程
func (r *RaftNode) ProposeMembershipChange(newMembers []uint64) error {
if r.State != StateLeader {
return ErrNotLeader
}
// 确保当前没有处于未决的配置变更中
if r.isJointStateActive() {
return ErrPendingConfigChange
}
// 步骤 1:构建并广播联合配置 C_{old,new}
jointConfig := r.buildJointConfig(r.CurrentCluster, newMembers)
r.appendAndReplicateEntry(EntryTypeConfChangeJoint, jointConfig)
// 状态机在 commit 联合配置后,由内部回调自动触发下一步:
// 步骤 2:写入最终配置 C_{new} 并剔除孤立节点
return nil
}
生产暗坑防范:破坏性节点(Disruptive Servers)规避
除了多数派计算,在节点下线的物理实操中,最容易引发集群不可用的是“下线节点引发的幽灵选举风暴”。
当一个节点被移出配置(例如节点 $A$),它的物理网线可能尚未拔除,或者服务进程还在后台运行。由于它不再收到 Leader 的心跳 AppendEntries RPC,其内部的选举定时器(Election Timeout)会周期性到期。该节点会单方面自增本地 Term 并向全网狂发 RequestVote。根据 Raft 原始规范,任何节点收到一个更高的 Term 消息,都必须立即放弃当前身份并强制降级为 Follower(Step Down),这会导致合法 Leader 频繁被下线节点“打落马下”,导致生产服务长时间震荡。
必须在系统中严格固化两道防线:
迁移实战 SOP 与收益评估
遵循联合共识与预检查机制,在某百 TB 级时序存储底座中执行跨机房整体平滑迁移:
- 新节点先以 Learner(只读不参与投票)身份预同步 WAL 日志与数据切片,追平延迟至 10ms 内;
- 下发 Joint Consensus 变更指令,整个集群在零停机、读写零中断的前提下平稳穿透 $C_{old,new}$ 状态并收敛至 $C_{new}$;
- 老机房 16 台物理存储节点从容断电关机,期间整个生产集群的 P99 写入时延始终平稳保持在 4.5ms,未发生一次意外降级切主。
分布式系统的本质是对不确定性状态的物理收敛。联合共识用严苛的多数派交集约束,消除了节点流动过程中的所有灰色地带,是构建零宕机生产存储底座不可逾越的底层法则。


评论前必须登录!
注册