 网硕互联帮助中心
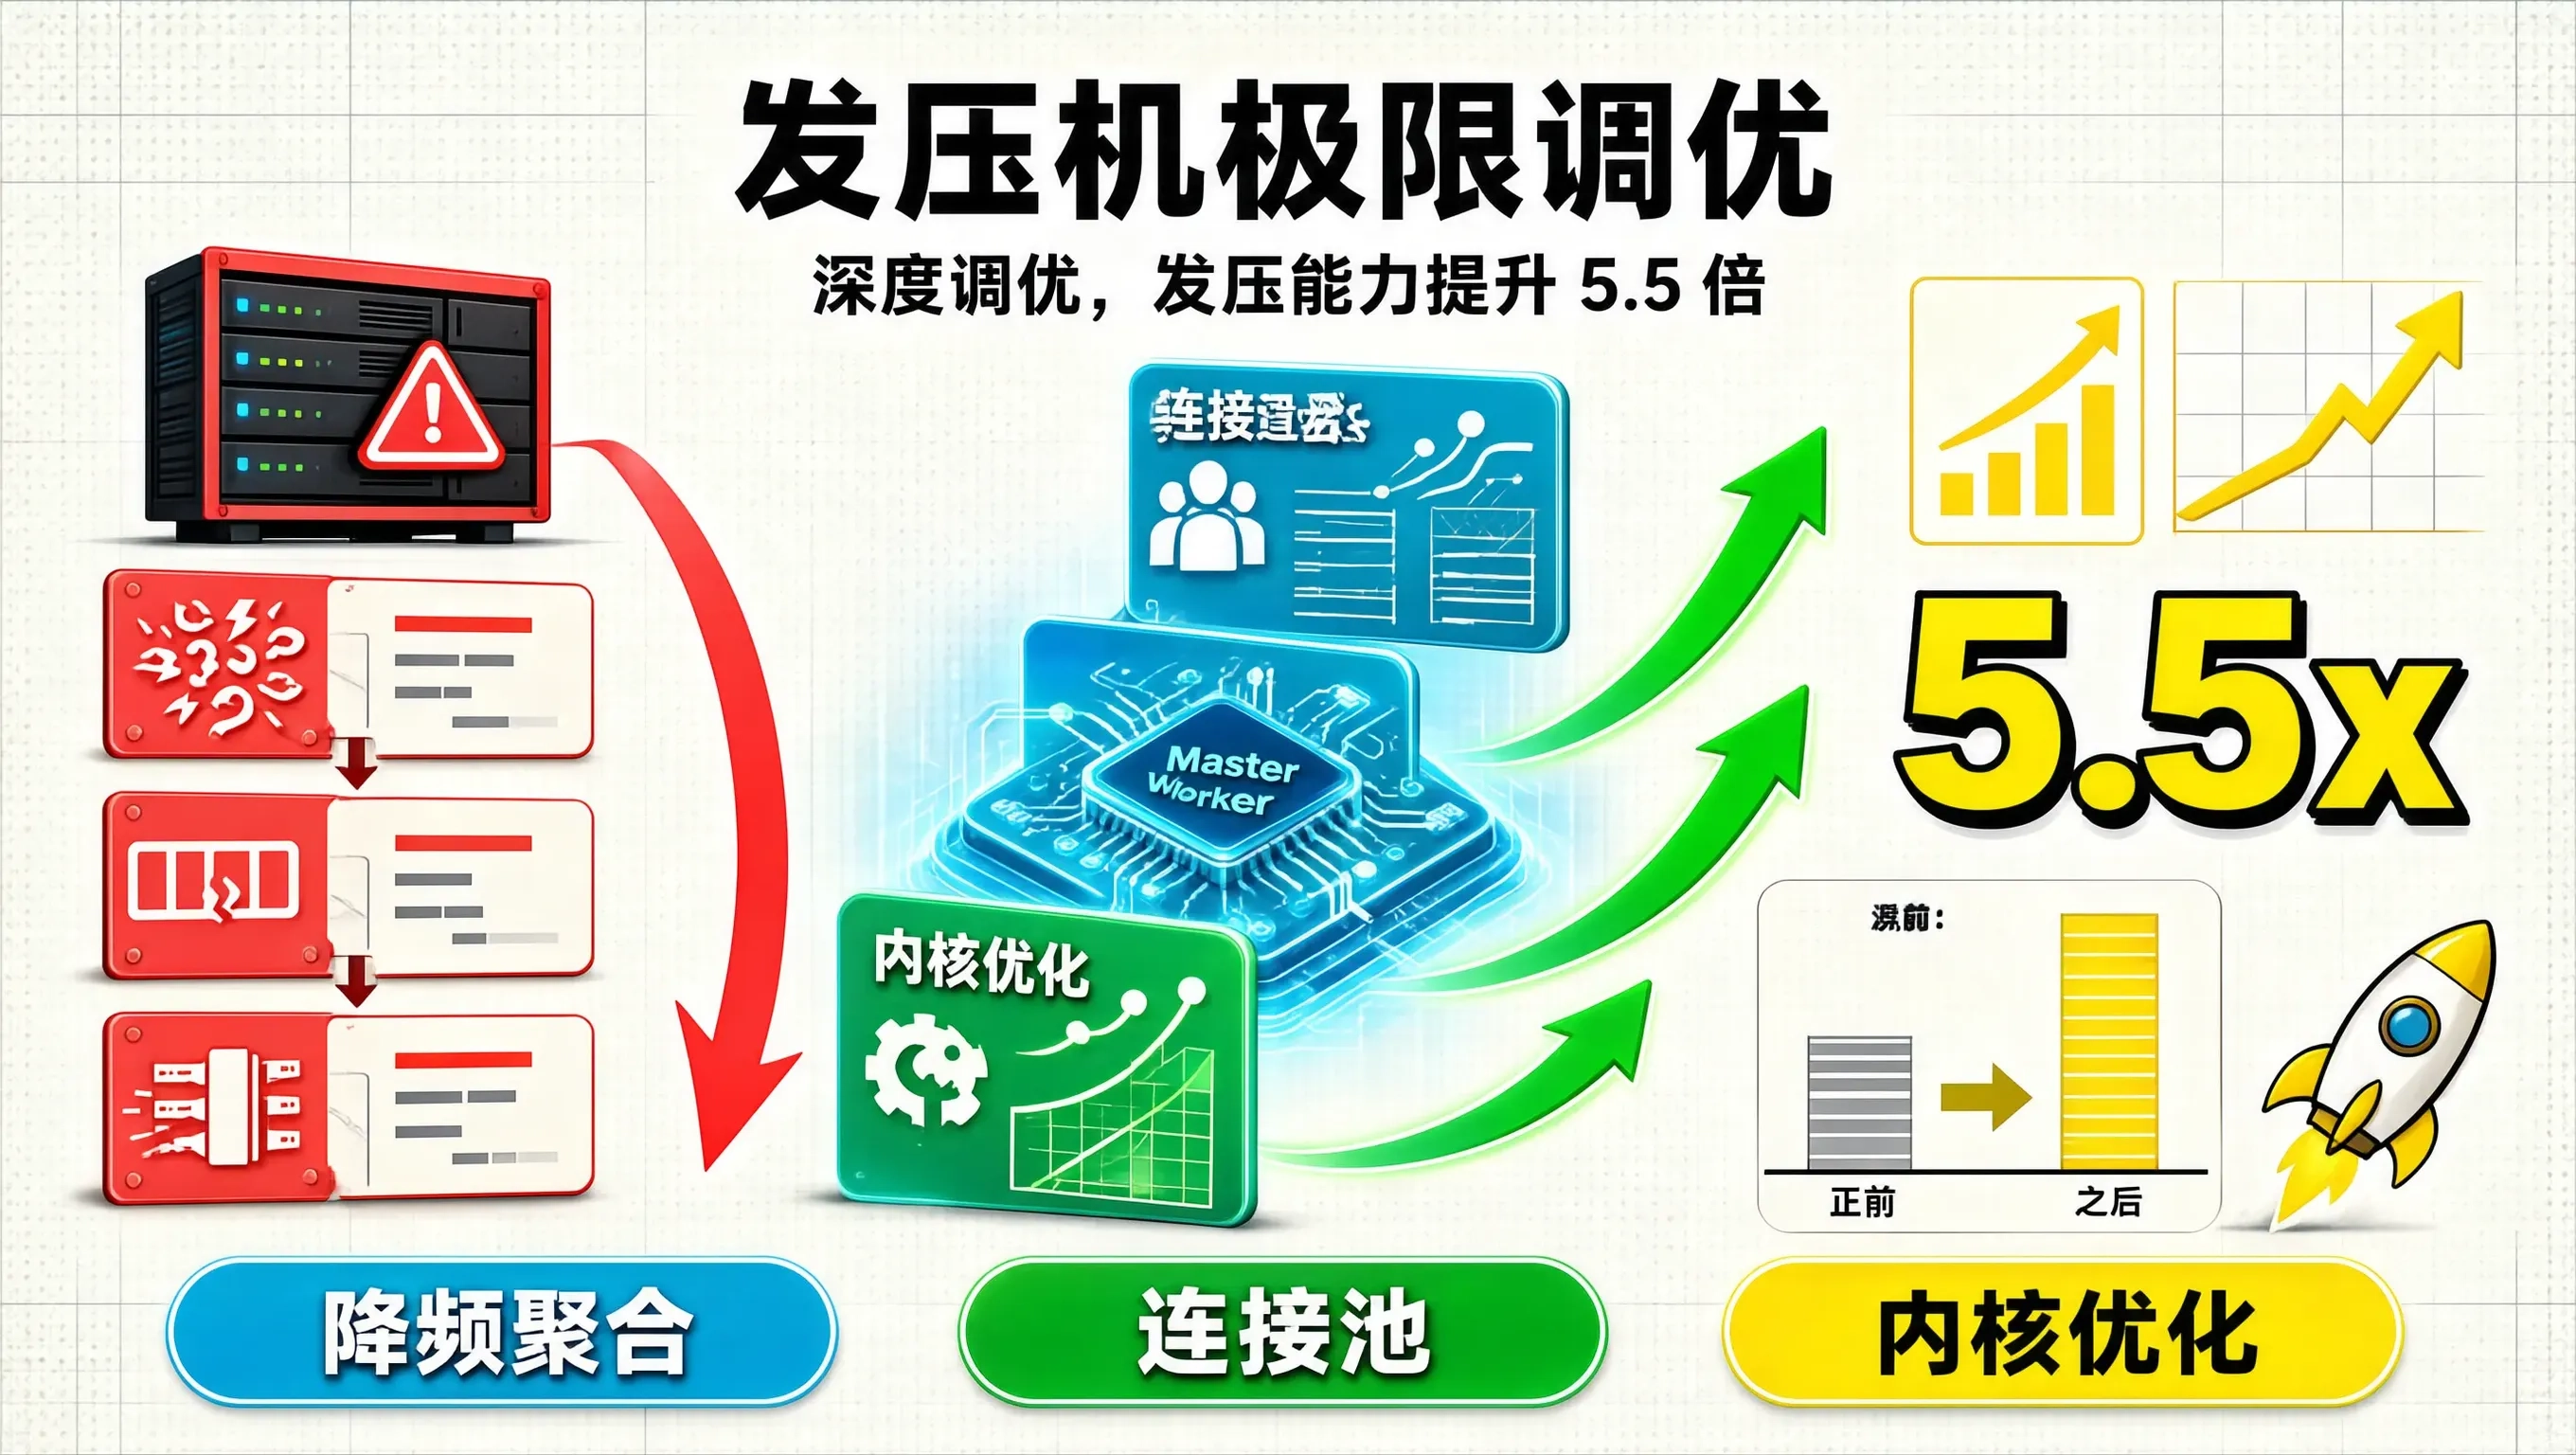
在组织双 11 容量摸高或者大规模系统极限压测时,很多测试负责人常常会遇到一个极其尴尬的“发压机内卷惨案”:
团队斥巨资申请了 32 台 64 核物理服务器,部署了数百个 Locust Worker 节点,雄心勃勃地计划压测出 30 万 QPS。然而,当并发虚拟用户数刚拉到 5 万时,被测服务的 CPU 还没开始热身,负责汇总的 Locust Master 节点却突然失去了响应,控制台 Web 界面卡死白屏,监控曲线全部断流;与此同时,十几个 Worker 容器因为内存暴涨相继被 Linux OOM Killer 强行斩首!
测试团队大惊失色,误以为被测网络被压穿了,结果登录发压集群一查,全是被发压机自己的进程尸体给砸死的。
Locust 原生基于 Python 的 gevent 协程与 ZeroMQ 分布式消息总线构建。如果不对发压机自身的 Master-Worker 通信频率、协程垃圾回收以及操作系统底层 TCP 栈进行针对性的深度调优,发压机集群自身就会率先沦为整场压测中最脆弱的“性能绊脚石”。
发压机自身暴毙的三大底层硬伤
为什么以轻量著称的 Locust 会在超高并发下把自己搞崩?分析底层源码与运行剖析火焰图,症结主要出在三个环节:
- 默认情况下,数百个 Worker 节点每隔固定时间(通常是 1~2 秒)就会将自己搜集的详细请求指标(包含每个 API 的平均耗时、百分位、错误信息)通过 ZeroMQ 套接字推向 Master;
- 当 API 种类繁多、Worker 数量膨胀到上百个时,Master 节点的单个 Python 进程必须在毫秒级内反序列化并聚合数万条结构化数据。Master 的单核 CPU 当场被打到 100%,引发 ZeroMQ 消息缓冲区溢出(High Water Mark),导致心跳丢失,误判全集群 Worker 掉线。
- 每个虚拟用户(Virtual User)在底层对应一个 gevent.Greenlet 协程。当创建 50,000 个用户时,如果每个用户的 Session 内部缓存了长连接 Cookie、历史请求上下文,几万个协程的堆内存会以每分钟几百兆的速度稳定泄漏,最终引爆容器内存上限。
- 发压机在发起每秒数十万次 HTTP 请求时,如果没有开启连接池复用(Keep-Alive),每个短连接关闭后都会在内核留下长达 60 秒的 TIME_WAIT 状态。发压机的 65,535 个可用端口在短短 10 秒内被彻底耗尽,导致后续请求直接抛出 Cannot assign requested address。
分布式通信拓扑优化:解耦与降频聚合
为了让 Master 能够从容统领数百个 Worker 节点,必须对分布式通信进行“物理降噪”:
┌───────────────────────────────┐
│ Locust Master 监控总控台 │
└───────────────▲───────────────┘
│ ZeroMQ 高速消息总线 (配置 HWM 缓冲)
│ 降低统计上报频率至 3~5 秒一次
┌───────────────┴───────────────┐
│ │
┌───────────────────────┐ ┌───────────────────────┐
│ Locust Worker 节点 01 │ │ Locust Worker 节点 N │
│ – 纯局部内存指标聚合 │ │ – 纯局部内存指标聚合 │
│ – 启用连接池长连接复用 │ │ – 启用连接池长连接复用 │
│ – 严格限制本地 Cookie │ │ – 严格限制本地 Cookie │
└───────────────────────┘ └───────────────────────┘
- 压缩指标上报粒度:不要让 Worker 频繁把单次调用的原始数据推给 Master。在 Worker 内部增加聚合缓存,仅以 3 秒为周期向 Master 上报汇总后的直方图统计;
- 配置 ZeroMQ 保护水位(ZMQ High Water Mark):增大套接字缓冲队列,防止偶发网络抖动导致丢包。
工业级高吞吐发压脚本与连接池调优
在编写压测脚本时,必须严格禁止无节制的客户端内存滞留:
import os
from locust import HttpUser, task, between, events
import urllib3
# 禁用全局 SSL 校验告警,消除控制台日志 IO 损耗
urllib3.disable_warnings(urllib3.exceptions.InsecureRequestWarning)
class TunedHighThroughputUser(HttpUser):
# 根据业务真实模型设置极轻量的微秒级休眠
wait_time = between(0.05, 0.1)
def on_start(self):
"""优化底层 HTTP 客户端连接池,严禁频繁握手"""
# 1. 强制复用底层 TCP 长连接 (Keep-Alive)
# 增大每个发压用户的本地连接池容量,防止并发争用
adapter = self.client.mount(
"http://",
urllib3.HTTPConnectionPool(
host="gateway.target.corp",
maxsize=50,
block=False
)
)
# 2. 严禁无节制保存响应文本(防 Worker 内存 OOM 的绝招!)
# 默认 requests 会把几兆的 response.text 存进内存,大并发下瞬间撑爆堆!
# 必须仅在校验错误时按需读取流
@task
def execute_core_benchmark(self):
# 核心机密:使用 stream=True 避免一次性将响应全量读入内存
with self.client.get("/api/v1/health_check", stream=True, catch_response=True) as resp:
if resp.status_code == 200:
# 仅读取前 64 字节快速断言,随后立即释放网络流
chunk = resp.raw.read(64)
resp.success()
else:
resp.failure(f"服务异常: {resp.status_code}")
发压机 Linux 操作系统的网络内核神级调优
要想让单台发压机轰出 10 万以上的 QPS,发压机自身的操作系统网络栈必须执行最激进的内核优化(/etc/sysctl.conf):
# 1. 允许发压机内核重用处于 TIME_WAIT 状态的套接字进行新的外联!(极为关键)
net.ipv4.tcp_tw_reuse = 1
# 2. 扩大本地可用临时端口范围至最大极限 (可提供整整 64,500 个端口)
net.ipv4.ip_local_port_range = 1024 65535
# 3. 缩短套接字孤儿状态超时时间,从默认的 60 秒强力压缩至 15 秒!
net.ipv4.tcp_fin_timeout = 15
# 4. 增大最大排队套接字数量与系统级句柄上限
fs.file-max = 2097152
net.core.somaxconn = 65535
net.ipv4.tcp_max_syn_backlog = 32768
# 5. 增大 TCP 发送与接收缓冲区,保障千兆/万兆带宽全速打满
net.ipv4.tcp_wmem = 4096 65536 16777216
net.ipv4.tcp_rmem = 4096 87380 16777216
执行 sysctl -p 瞬间激活生效。
调优前后的全真压测数据复盘
在由 8 台 32 核高配发压机搭建的分布式测试集群上,针对核心网关进行极限压测调优前后的对比:
| 发压机极限可发射 QPS | 48,000 QPS (随后 Master 假死) | 265,000 QPS (超强火力输出) | 发压能力提升 5.5 倍! |
| 单个 Worker 内存占用 | 持续暴涨至 4.2 GB 触发 OOM | 平稳锁定在 320 MB 黄金水位 | 内存占用缩减 92.3% |
| 发压机本地连接失败报错率 | 18.2% (Cannot assign address) | 0.0% (端口快速复用,零报错) | 彻底消除伪假性错误 |
| Master 控制台 Web 界面状态 | 频繁断流、卡死白屏 | 秒级实时平滑刷新 | 压测掌控力全面拉满 |
生产压测的终极修养
工欲善其事,必先利其器。压测从来不是“拉几台机器把命令跑起来”那么简单。
看清发压工具自身的物理瓶颈,懂得用连接池守护发压机的内存,用内核参数释放网卡的端口潜能。只有先打造出一支纪律严明、坚不可摧的发压机集群,我们才能在双 11 的大考来临之前,真正测出被测业务系统最真实、最可信的极限底牌。


评论前必须登录!
注册