 网硕互联帮助中心
一句话概括: 值类型就像"复印件"——每次传递都是独立的一份拷贝,改了互不影响;引用类型则像"门牌号"——传递的只是一个地址,大家按地址找到的都是同一间屋子,谁动了屋里的东西,所有持有这个地址的人都看得见。这个看似基础的概念,恰恰是无数诡异 bug 的根源,也是真正理解 C# 内存模型的第一道门槛。
目录
一、一个让人摸不着头脑的 bug,引出今天的主题
先看两段看起来极其相似、但行为完全不同的代码:
// 场景一:int(值类型)
int a = 10;
int b = a; // 把 a 的值复制给 b
b = 20;
Console.WriteLine(a); // 10 —— a 完全没受影响
Console.WriteLine(b); // 20
// 场景二:数组(引用类型)
int[] arr1 = { 1, 2, 3 };
int[] arr2 = arr1; // 把 arr1 "复制"给 arr2
arr2[0] = 999;
Console.WriteLine(arr1[0]); // 999 —— arr1 竟然也被改了!?
Console.WriteLine(arr2[0]); // 999
同样是一行"赋值"代码(b = a 和 arr2 = arr1),为什么第一个改了 b 对 a 毫无影响,第二个改了 arr2 却连带改了 arr1?
这不是什么诡异的 bug,而是 C# 类型系统中最根本的一条分界线——值类型(Value Type)与引用类型(Reference Type)。不理解这条分界线,你写的代码迟早会在某个"看起来毫无道理"的地方栽跟头。这篇文章就是要把这条分界线,从原理到实战,彻底讲清楚。
二、栈与堆:两种数据的"居住地"
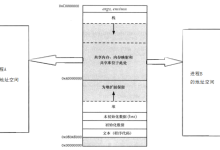
要理解值类型和引用类型的区别,必须先搞懂程序运行时内存的两个重要区域——栈(Stack)和堆(Heap)。
2.1 栈:整齐高效,但空间有限的"临时工位"
栈的特点:
┌─────────────┐
│ 后进先出 │ ← 像一摞盘子,只能从最上面存取
│ (LIFO) │
├─────────────┤
│ 自动管理 │ ← 方法执行完,它用过的栈空间自动释放,不需要GC介入
├─────────────┤
│ 访问速度极快 │ ← 内存地址连续,CPU缓存命中率高
├─────────────┤
│ 空间较小 │ ← 通常几MB,用完就是StackOverflowException
└─────────────┘
栈主要用来存放:方法调用时的局部变量、方法参数,以及值类型的数据本身。它的管理方式极其简单高效——方法一调用,就在栈顶"压入"一块空间;方法一结束,这块空间立刻"弹出"释放,完全不需要垃圾回收器介入,这也是值类型访问速度快的根本原因。
2.2 堆:灵活但需要"物业管理"的"长租公寓"
堆的特点:
┌─────────────┐
│ no固定顺序 │ ← 对象可以在任意空闲位置被分配
├─────────────┤
│ 需要GC管理 │ ← 对象何时被回收,由垃圾回收器决定,不是"用完立刻释放"
├─────────────┤
│ 访问相对较慢 │ ← 需要先找到堆上的内存地址,多了一层"寻址"的过程
├─────────────┤
│ 空间较大 │ ← 受限于系统可用内存,远大于栈
└─────────────┘
堆主要用来存放:引用类型的实际数据内容。由于对象的生命周期可能远超创建它的那个方法(比如一个对象被返回、被存入一个长期存在的集合中),堆上的内存不能像栈那样"方法结束就自动释放",必须依靠垃圾回收器(GC)定期扫描、判断哪些对象已经不再被任何地方引用,才能安全回收。
三、值类型:独立的复印件
3.1 C# 中常见的值类型
int, long, short, byte // 整数家族
float, double, decimal // 浮点数家族
bool // 布尔值
char // 字符
struct(包括 DateTime、自定义结构体)
enum // 枚举
一个简单的记忆法则: 除了 struct、enum 这两个关键字定义的类型之外,C# 内置的所有"基础数据类型"几乎都是值类型(它们本质上都是披着不同名字外衣的 struct,比如 int 实际上是 System.Int32 这个结构体的别名)。
3.2 值类型的核心特征:数据直接存储,赋值即复制
int a = 10;
int b = a; // 这一行发生的事:把 a 当前存储的"值 10",完整复制一份给 b
// 此刻内存中实际上存在两份独立的数据:
// a → [10]
// b → [10](这是一份全新的拷贝,和a的10毫无关联)
b = 20; // 只修改了 b 这份拷贝
// a → [10] (完全不受影响)
// b → [20]
这正是第一节"场景一"的答案:值类型变量直接存储数据本身(通常在栈上),赋值操作会把这份数据完整地复制一份给新变量——两者从此各自独立,互不干扰。
3.3 自定义值类型:struct
public struct Point
{
public int X;
public int Y;
}
Point p1 = new Point { X = 1, Y = 2 };
Point p2 = p1; // 整个结构体的数据被完整复制一份
p2.X = 999;
Console.WriteLine(p1.X); // 1 —— p1 完全没受影响
Console.WriteLine(p2.X); // 999
自己定义的 struct 同样遵循"赋值即复制"的规则——哪怕结构体内部有多个字段,赋值时也会把所有字段的值完整地拷贝一份,而不是只拷贝一个"引用地址"。
四、引用类型:共享的门牌号
4.1 C# 中常见的引用类型
class(所有自定义类)
interface
delegate
array(包括 int[] 这类看起来像值类型的数组)
string(特殊,第七节详细讲)
object
所有的集合类型:List<T>、Dictionary<TKey,TValue> 等
4.2 引用类型的核心特征:变量存储的是"地址",赋值即共享
public class Person
{
public string Name = "";
}
Person p1 = new Person { Name = "张三" };
Person p2 = p1; // 这一行发生的事:把 p1 存储的"地址"复制给 p2
// 此刻内存中实际上只有一份对象数据,但有两个变量都指向它:
// 堆内存
// p1 ──┐ ┌─────────────┐
// ├─── 都指向 ───► │ Name: "张三" │
// p2 ──┘ └─────────────┘
p2.Name = "李四"; // 通过 p2 这个"地址",找到了那间"屋子",修改了里面的内容
Console.WriteLine(p1.Name); // 李四 —— p1指向的是同一个对象,当然也看到了变化!
Console.WriteLine(p2.Name); // 李四
这正是第一节"场景二"的答案:引用类型变量本身存储的不是数据,而是一个指向堆内存的"地址"(引用)。赋值操作只是复制了这个地址,并没有复制地址指向的真实数据——两个变量最终指向的是同一块内存,谁通过自己手里的"地址"去修改内容,另一方都会看到变化。
4.3 一个更形象的类比:钥匙与房子
值类型:
你有一把实体钥匙(数据本身)。
复制一份给朋友,就是重新打造了一把一模一样的钥匙。
你改造自己的钥匙(比如涂个颜色),完全不影响朋友那把。
引用类型:
你有一张写着"幸福小区3栋501"的纸条(这就是"引用")。
复制一份纸条给朋友,纸条上写的地址是一样的,但房子只有一套。
你跑去那套房子里重新装修,朋友拿着同一张纸条过去,看到的也是装修后的样子——
因为你们的纸条,指向的是同一间房子。
五、装箱与拆箱:值类型"伪装"成引用类型的代价
5.1 什么是装箱(Boxing)
int number = 100; // number 是值类型,存储在栈上
object boxed = number; // 装箱:在堆上新建一个对象,把 number 的值复制进去,boxed 指向这个新对象
装箱的本质:当值类型需要被当作 object(或者某个值类型实现的接口类型)来使用时,运行时会在堆上临时创建一个"盒子",把值类型的数据复制进这个盒子里,然后返回这个盒子在堆上的地址。
5.2 什么是拆箱(Unboxing)
object boxed = 100;
int number = (int)boxed; // 拆箱:从堆上的"盒子"里把数据复制回一个新的值类型变量
拆箱是装箱的逆过程——把堆上盒子里的数据,重新复制回一个值类型变量。
5.3 为什么装箱拆箱值得特别关注——性能代价
// 看似无害的代码,背后暗藏大量装箱操作
ArrayList list = new ArrayList(); // 非泛型集合,内部用 object[] 存储
for (int i = 0; i < 1000000; i++)
{
list.Add(i); // ⚠️ 每一次 Add,int 都要被装箱成 object,在堆上新建一个"盒子"
}
每一次装箱,都意味着一次额外的堆内存分配——这不仅本身有性能开销,还会显著增加垃圾回收器的工作负担(堆上多了一百万个临时对象等着被回收)。这正是我们在讲泛型的文章中强调"List<int> 比 ArrayList 性能好得多"的根本原因——List<int> 作为泛型集合,内部直接用 int[] 存储,全程不需要任何装箱操作。
5.4 哪些场景容易"悄悄"触发装箱
int number = 100;
Console.WriteLine(number); // ✅ 不装箱,WriteLine有针对int的专门重载
Console.WriteLine("数字是:" + number); // ⚠️ 可能触发装箱(取决于具体重载解析)
object obj = number; // ⚠️ 显式装箱,一目了然
bool result = number.Equals(100); // ⚠️ Equals(object) 这个重载会导致100也被装箱
一个经验法则:当一个值类型被赋值给 object 类型的变量,或者被当作参数传给一个"期望 object 类型"的方法时,几乎必然会发生装箱——这也是为什么泛型集合(List<T>)相比非泛型集合(ArrayList)、以及"针对具体类型设计的重载方法"相比"接受 object 参数的通用方法",在性能敏感场景下几乎总是更优选择的底层原因。
六、参数传递中的值类型与引用类型
这是一个极其容易混淆、但面试和实战中都非常关键的知识点——我们在之前讲 C# 方法的文章中提到过"值传递",这里结合值类型/引用类型再讲透一层。
6.1 值类型作为参数:方法内部拿到的是一份独立拷贝
static void ModifyValue(int number)
{
number = 999; // 只修改了这份"拷贝"
}
int original = 10;
ModifyValue(original);
Console.WriteLine(original); // 10 —— 完全没变
6.2 引用类型作为参数:方法内部拿到的是"同一个地址的拷贝"
static void ModifyObject(Person person)
{
person.Name = "被修改了"; // 通过这个"地址",找到并修改了真正的那个对象
}
Person p = new Person { Name = "原始名字" };
ModifyObject(p);
Console.WriteLine(p.Name); // 被修改了 —— 原对象确实被改了!
这里有一个经常让人困惑的细节:明明 C# 默认是"值传递"(无论值类型还是引用类型,参数传递的都是一份"拷贝"),为什么修改引用类型参数的属性,却能影响到外部的原始对象?
答案是:对于引用类型,被"复制"的是"引用(地址)"本身,而不是地址指向的对象数据。方法内部的 person 变量和外部的 p 变量,虽然是两个独立的变量(各自存储了一份地址的拷贝),但这两份拷贝的地址值完全相同,指向的是堆上同一个对象——所以通过任意一个变量去修改对象的属性,另一边自然都能看到变化。
6.3 一个更精细的场景:重新赋值 vs 修改属性
static void TryReassign(Person person)
{
person = new Person { Name = "全新的对象" }; // ⚠️ 这里发生的事,和上面完全不同!
}
Person p = new Person { Name = "原始名字" };
TryReassign(p);
Console.WriteLine(p.Name); // 原始名字 —— p 完全没有受影响!
这是区分"值传递"和"引用传递"最关键的一个对比案例: person = new Person {…} 这行代码,只是让方法内部那份"地址拷贝"重新指向了一个全新创建的对象,完全没有改变外部变量 p 手里拿着的那份地址拷贝——p 依然老老实实地指向最初那个对象。
结论:C# 中"传递引用类型参数",传递的是"引用的值传递"——方法可以通过这份引用,修改原对象的内容(因为指向同一块内存),但无法让外部变量"改指"向一个新对象(因为那只是方法内部这份拷贝的事情)。
6.4 ref 关键字:真正做到"连地址本身也能被修改"
static void TryReassignWithRef(ref Person person)
{
person = new Person { Name = "全新的对象" }; // 现在真的能让外部变量"改指"了!
}
Person p = new Person { Name = "原始名字" };
TryReassignWithRef(ref p);
Console.WriteLine(p.Name); // 全新的对象 —— p 真的被重新指向了!
只有使用 ref 关键字,才能让方法内部对参数的"重新赋值"操作,真正影响到外部变量本身——这正好呼应了我们之前讲 C# 方法那篇文章中对 ref 的讲解:ref 传递的是"变量本身的引用",而不仅仅是"变量当前存储的值(无论这个值是数据本身,还是一个地址)的拷贝"。
七、特殊情况:string 为什么表现得"不太像"引用类型
7.1 string 确实是引用类型,但行为却很"值类型化"
string s1 = "Hello";
string s2 = s1;
s2 = "World"; // 看起来像是"修改"了 s2
Console.WriteLine(s1); // Hello —— s1 完全没变!
Console.WriteLine(s2); // World
这个表现乍看之下和"值类型"一模一样——明明 string 是引用类型(它确实存储在堆上,s1、s2 这两个变量存储的也确实是"地址"),为什么修改 s2 不会影响 s1?
7.2 真相:string 是不可变的(Immutable)
关键在于:string 一旦被创建,它的内容就永远不能被就地修改。 上面代码中 s2 = "World" 这一行,并不是"修改了 s2 指向的那个字符串对象的内容",而是"创建了一个全新的字符串对象’World’,然后让 s2 重新指向这个新对象"——这和前面 6.3 节 person = new Person {…} 的"重新赋值"是完全一样的逻辑,只是因为 string 太常用、语法又太像"值类型",很容易让人产生误解。
string s = "Hello";
s += " World";
// 这行代码背后发生的事:
// 1. 创建一个全新的字符串对象 "Hello World"
// 2. 让 s 重新指向这个新对象
// 3. 原来的 "Hello" 对象,如果没有其他变量引用它了,会在后续被垃圾回收
这也是为什么"在循环中频繁用 += 拼接字符串"被认为是一种性能反模式——每一次拼接,都在堆上创建了一个全新的字符串对象,旧对象变成了"垃圾"等待回收,循环次数一多,会产生大量不必要的临时对象和内存分配压力。这正是 StringBuilder 存在的意义——它提供了一个可变(Mutable)的字符缓冲区,能够在原地持续追加内容,而不是每次都重新创建一个新字符串:
// ❌ 性能较差:每次拼接都创建一个新字符串对象
string result = "";
for (int i = 0; i < 10000; i++)
result += i.ToString();
// ✅ 更优:StringBuilder 内部维护一个可动态扩容的字符缓冲区,原地追加
StringBuilder sb = new StringBuilder();
for (int i = 0; i < 10000; i++)
sb.Append(i);
string result2 = sb.ToString();
八、struct vs class:如何选择自定义类型该用哪一个
这是很多人在定义自己的数据类型时会犹豫的问题——我该把它定义成 struct(值类型)还是 class(引用类型)?
8.1 核心判断标准
| 数据大小 | 较小(经验值:不超过16字节,约等于两个 long 大小) | 较大,或者字段较多 |
| 语义 | 表示一个"值"(如坐标点、颜色、金额),而非一个"实体" | 表示一个有独立身份的"对象"(如用户、订单、员工) |
| 是否需要继承 | 不需要(struct 不支持继承其他struct或class) | 需要通过继承复用代码或实现多态 |
| 是否频繁创建销毁 | 是(值类型在栈上分配/释放,开销远小于GC回收堆对象) | 否,或生命周期较长 |
| 是否需要"引用相等"语义 | 否(值类型默认按"内容"比较相等) | 是(需要判断"是不是同一个对象") |
8.2 一个实战判断案例
// ✅ 适合用 struct:Point 代表一个"坐标值",概念上更接近"数据"而非"实体"
public struct Point
{
public double X, Y;
}
// ✅ 适合用 class:Employee 代表一个有独立身份的"员工"实体,
// 即便两个员工姓名年龄完全相同,他们依然是两个不同的人
public class Employee
{
public string Name = "";
public int Age;
}
一个很实用的思考角度: 如果你创建的类型天生应该是"可以被拷贝很多份,每份都是独立、平等的数据"(比如一个坐标、一个颜色、一个货币金额),倾向于 struct;如果你创建的类型天生代表"一个具体的、有唯一身份的东西"(一个用户、一个订单、一份合同),哪怕两个实例的所有字段值都一模一样,它们依然应该被当作"两个不同的东西",这时候 class 的"引用相等"语义才是正确的选择。
8.3 struct 滥用的典型反面案例
// ❌ 反面教材:一个包含大量字段的"业务实体"被定义成 struct
public struct Order // 应该用 class!
{
public int Id;
public string CustomerName;
public DateTime OrderDate;
public List<OrderItem> Items;
public decimal TotalAmount;
public string ShippingAddress;
// ……还有十几个字段
}
Order order1 = GetOrderFromDatabase();
Order order2 = order1; // ⚠️ 每次赋值,都会把这一大堆字段全部复制一遍,性能很差!
字段较多的"大型结构体",每一次赋值、每一次作为参数传递,都会触发"整体数据的完整拷贝",这不仅带来不必要的性能开销,更重要的是,这种"业务实体"在语义上天生就该具备"唯一身份",用 class 才符合直觉——两个不同的订单,哪怕金额、商品都碰巧完全一样,它们依然是两笔不同的交易记录。
九、实战演练:一个真实的"坑"与修复方案
9.1 问题代码:以为在"复制"配置,实际上在"共享"配置
public class GameConfig
{
public int MaxHealth { get; set; }
public int MaxMana { get; set; }
}
public class Player
{
public string Name { get; set; } = "";
public GameConfig Config { get; set; } = new GameConfig();
}
// 需求:批量创建10个玩家,都使用相同的"默认配置"模板
GameConfig defaultConfig = new GameConfig { MaxHealth = 100, MaxMana = 50 };
List<Player> players = new();
for (int i = 0; i < 10; i++)
{
players.Add(new Player
{
Name = $"玩家{i + 1}",
Config = defaultConfig // ⚠️ 危险!所有玩家的 Config 其实都指向同一个对象!
});
}
// 事故发生:给第一个玩家"单独"加成了一点血量上限
players[0].Config.MaxHealth = 150;
// 检查其他玩家的血量上限……
Console.WriteLine(players[1].Config.MaxHealth); // 150!?其他玩家也被"连带"改了!
问题根源: Config = defaultConfig 这行代码,只是把 10 个 Player 对象的 Config 属性,全部指向了同一个 GameConfig 对象——这正是本文反复强调的"引用类型赋值 = 共享地址"的真实陷阱,看起来像是"给每个玩家分配了一份配置",实际上十个玩家在共用同一份配置,改一个就等于改了所有人。
9.2 修复方案:确保每个玩家拿到的是独立的拷贝
List<Player> players = new();
for (int i = 0; i < 10; i++)
{
players.Add(new Player
{
Name = $"玩家{i + 1}",
Config = new GameConfig // ✅ 为每个玩家单独创建一个新的配置对象
{
MaxHealth = defaultConfig.MaxHealth,
MaxMana = defaultConfig.MaxMana
}
});
}
players[0].Config.MaxHealth = 150;
Console.WriteLine(players[1].Config.MaxHealth); // 50 —— 现在互不影响了!
或者,如果 GameConfig 本身字段不多、语义上更接近"纯数据值",一个更彻底的方案是直接把它改成 struct:
public struct GameConfig // 改成值类型
{
public int MaxHealth { get; set; }
public int MaxMana { get; set; }
}
// 现在 Config = defaultConfig 这行代码,会自动触发"值的完整拷贝",
// 每个玩家天然拥有独立的配置,不需要手动一个个字段去复制
这个案例也呼应了第八节的选型建议:像 GameConfig 这种"纯粹的数据集合,没有唯一身份概念"的类型,往往正是 struct大显身手的典型场景——用对了类型,很多这类"共享陷阱"从设计层面就被彻底规避了。
十、高手都会踩的 6 个坑
坑 1:以为"所有数组内置的都是值类型"
int[] numbers = { 1, 2, 3 }; // ⚠️ 数组本身是引用类型,哪怕里面存的是 int 这种值类型!
int[] arr2 = numbers;
arr2[0] = 999;
Console.WriteLine(numbers[0]); // 999 —— 原数组也被改了
这是一个极易混淆的点:数组(Array),无论它存储的元素是值类型还是引用类型,数组这个"容器"本身永远是引用类型——numbers 这个变量存储的是"指向这个数组对象的地址",赋值自然就是"共享同一个数组"。
坑 2:struct 的"默认无参构造函数"陷阱
public struct Point
{
public int X, Y;
// 没有显式写构造函数
}
Point p = new Point(); // 所有字段自动初始化为对应类型的默认值(X=0, Y=0)
// 这和 class 的行为一致,但 struct 还有一个 class 没有的特殊之处:
Point p2 = default; // ✅ struct 支持直接用 default 关键字,同样得到"所有字段为默认值"的实例
值类型的一个独特之处是:它永远不可能是 null(除非声明为可空类型 Point?),也永远拥有一个隐式的、无法被自定义覆盖参数列表的"所有字段归零"初始状态——这和引用类型"默认值是 null,必须显式 new 出来才能使用"的逻辑完全不同。
坑 3:在集合中存储 struct,修改元素属性却"不生效"
public struct Point { public int X, Y; }
List<Point> points = new() { new Point { X = 1, Y = 1 } };
points[0].X = 999; // ⚠️ 这行代码能编译通过,行为看起来"正常"
// 但如果换成下面这种方式,就会暴露问题:
foreach (Point p in points)
{
p.X = 999; // ❌ 编译错误!不能修改 foreach 中的 struct 迭代变量
}
这是因为 struct 作为值类型,foreach 遍历时拿到的 p 是数组/列表中对应元素的一份"拷贝"——如果允许修改这份拷贝,会给人一种"好像改了原集合"的错觉,但实际上完全不会影响集合本身,C# 编译器直接从语法层面禁止了这种容易误导人的写法,强制你意识到"值类型拷贝"这个事实。
坑 4:对值类型调用可能触发装箱的接口方法
int number = 100;
IComparable comparable = number; // ⚠️ 装箱:int 被包装成 object 以满足接口类型要求
// 对比:使用泛型接口 IComparable<int> 则完全不会触发装箱
IComparable<int> genericComparable = number; // ✅ 不装箱,因为编译器为int生成了专门的实现
这也是"尽量使用泛型版本的接口/集合(IComparable<T> 而非 IComparable,List<T> 而非 ArrayList)"这条最佳实践背后的底层原因之一——泛型版本能让值类型全程避免装箱,带来实打实的性能收益。
坑 5:把大型 struct 按值传递给方法,造成不必要的性能开销
public struct LargeStruct // 假设内部有20个字段
{
public double A, B, C, D, /* ……还有16个字段 */ T;
}
static void Process(LargeStruct data) // ⚠️ 每次调用,整个结构体的20个字段都要被完整复制一遍!
{
// ……
}
对于字段较多、体积较大的 struct,按值传递会带来不小的复制开销——这种场景下,要么重新考虑是否应该把它设计成 class(参见第八节的判断标准),要么使用 in 关键字按只读引用传递,避免整体拷贝:
static void Process(in LargeStruct data) // ✅ 按引用传递,避免复制整个结构体,同时保证方法内部不能修改它
{
// ……
}
坑 6:误以为给引用类型变量赋值 null,会"清空"原对象的数据
Person p1 = new Person { Name = "张三" };
Person p2 = p1;
p1 = null; // ⚠️ 这只是让 p1 不再指向那个对象了
Console.WriteLine(p2.Name); // 张三 —— p2 依然指向原对象,完全没受影响!
p1 = null 仅仅是把 p1 这个变量"手里的地址纸条"扔掉了,并没有"摧毁"纸条曾经指向的那间房子——只要还有其他变量(这里是 p2)继续持有指向这个对象的地址,这个对象在堆上就会继续存在,直到真正没有任何变量引用它了,垃圾回收器才会在未来某个时刻将其回收。
十一、写在最后
值类型与引用类型的区别,表面上是一个"内存存储位置"的技术细节,但它背后牵动的,是你对 C# 整个类型系统、方法传参行为、乃至性能优化思路的理解深度。
- 值类型:数据即本体,赋值是拷贝,独立而安全,但大体积时拷贝有代价
- 引用类型:变量只是地址,赋值是共享,高效但容易"牵一发而动全身"
- 装箱拆箱:值类型与引用类型世界之间的"桥梁",每一次跨越都有性能代价
- struct vs class:不是"哪个更好",而是"你的类型,语义上到底是一个值,还是一个有身份的实体"
下次当你遇到一个"明明没改这个变量,它却莫名其妙变了"的诡异 bug 时,第一反应应该是:检查一下,这是不是一个引用类型在"共享"同一份数据——这几乎是 C# 初中级开发者最常遇到、也最该优先排查的一类问题根源。
📝 课后练习
觉得有收获?欢迎点赞收藏,下次再遇到"改了一个变量,另一个变量却莫名其妙也变了"的诡异现象,你已经知道该往哪个方向排查了 😉


评论前必须登录!
注册