 网硕互联帮助中心
MariaDB 进阶(数据表 / 用户 / 备份 / 主从)与 Nginx 服务器入门
本文使用通俗化、体系化的语言讲解MariaDB 进阶与 Nginx 服务器入门的相关知识,每个概念讲清「是什么、为什么、怎么用」,每条命令解释「意图和原因」,并通过对比表格、架构图解、场景标注帮助理解。
📌 标注约定:
- 【使用频率】真实运维工作中的出现频率:极高 / 高 / 中 / 低
- ⭐ 重点 🔺 难点(易踩坑) 💡 理解技巧 / 生产经验
🔧 本文统一使用的实验环境:
| 通用服务端 | server | 10.1.8.11 | Nginx 等 |
| 通用客户端 | client | 10.1.8.12 | 访问测试 |
| 数据库主库 | db1(db1.hero.cloud) | 10.1.8.13 | MySQL 主 |
| 数据库从库 | db2(db2.hero.cloud) | 10.1.8.14 | MySQL 从 |
- 域名统一为 hero.cloud;
- 数据库相关密码统一为 123。
今日内容地图:
| 第一篇 MariaDB 进阶 | 数据表 CRUD、用户与权限、备份恢复、主从同步、应急 |
| 第二篇 Nginx | 介绍、部署、配置结构、nginx.conf、虚拟主机 |
文章目录
- MariaDB 进阶(数据表 / 用户 / 备份 / 主从)与 Nginx 服务器入门
- 第一篇 MariaDB 进阶
-
- 第 1 章 数据表操作(CRUD)
-
- 1.1 环境准备:导入示例库
- 1.2 查询表
- 1.3 条件查询(⭐ WHERE)
- 1.4 聚合函数与分组
- 1.5 多表查询(🔺 连接)
- 1.6 建表、插入、更新、删除
- 第 2 章 管理数据库用户
-
- 2.1 账号格式 user@host
- 2.2 创建用户
- 2.3 授权 GRANT(⭐ 四级粒度)
- 2.4 查看 / 回收 / 删除 / 改密码
- 2.5 常见访问故障
- 第 3 章 备份和恢复
-
- 3.1 ⭐ 逻辑备份 vs 物理备份
- 3.2 物理备份 / 恢复
- 3.3 逻辑备份 mysqldump(⭐ 最常用)
- 第 4 章 主从同步
-
- 4.1 ⭐ 同步原理(🔺 核心,务必理解)
- 4.2 常见架构
- 4.3 三种复制方式
- 4.4 主从延迟
- 4.5 ⭐ 主从同步实践(db1 = 10.1.8.13 主,db2 = 10.1.8.14 从)
- 4.6 防止数据丢失的关键参数
- 第 5 章 应急场景(🔺 救命)
-
- 5.1 忘记 root 密码
- 5.2 root 权限被误回收
- 5.3 root 账号被误删除
- 第二篇 Nginx 服务器
-
- 第 6 章 Nginx 介绍
- 第 7 章 Nginx 部署
- 第 8 章 Nginx 配置结构(⭐ 层级化)
- 第 9 章 nginx.conf 详解要点
- 第 10 章 配置加载与 location 匹配(🔺)
- 第 11 章 虚拟主机
-
- 11.1 基于域名(⭐ 最常用)
- 11.2 基于端口
- 总结篇
-
- 一、核心知识链路
- 二、重点 / 难点 / 频率
- 三、易错清单
- 四、面试速记
第一篇 MariaDB 进阶
第 1 章 数据表操作(CRUD)
【使用频率:极高】CRUD = Create 增、Read 查、Update 改、Delete 删,是数据库最核心的日常操作。
1.1 环境准备:导入示例库
# 下载示例 SQL
curl -o inventory.sql -s http://192.168.49.200/class/course-materials/softwares/stage01/inventory.middle.sql
# 建库并导入
mysql -uroot -p123 -e 'create database inventory;'
mysql -uroot -p123 inventory < inventory.sql
原理:mysql 库名 < 文件 表示把 SQL 文件里的语句批量灌进指定库。
1.2 查询表
① 表列表:
USE inventory;
SHOW TABLES;
— category / manufacturer / product
② 表结构(⭐ DESCRIBE):
DESCRIBE product; — 可简写 DESC product;
| Field | 字段(列)名 |
| Type | 数据类型(int 整数、varchar 变长字符串、double 浮点) |
| Null | 是否允许为空(NO = 必填) |
| Key | PRI 表示主键 |
| Default | 默认值 |
| Extra | auto_increment 自增 |
💡 主键(PRIMARY KEY):一行的唯一身份证,任何两行主键不能相同。自增(auto_increment):插入时不指定,数据库自动 +1,保证主键唯一。
③ 查询数据:
SELECT * FROM product; — * 表示所有列,查全部记录
SELECT name,price,stock FROM product; — 只查指定列(推荐,数据量小、更清晰)
1.3 条件查询(⭐ WHERE)
SELECT * FROM product WHERE price > 100; — 只返回满足条件的行
比较运算符:
| = | 等于 |
| <>(或 !=) | 不等于 |
| > < >= <= | 大小比较 |
| BETWEEN a AND b | 在 a~b 之间(含边界) |
| IN (…) | 在给定列表中 |
| LIKE | 模糊匹配:% 任意多个字符,_ 恰好一个字符 |
SELECT * FROM product WHERE id BETWEEN 1 AND 3;
SELECT * FROM category WHERE name IN ('Servers','Ssd');
SELECT * FROM product WHERE name LIKE '%Server%'; — 名字中含 Server
逻辑组合与排序:
— AND 且、OR 或
SELECT * FROM product WHERE name LIKE '%RD%' AND price>1000;
SELECT * FROM product WHERE name LIKE '%RD%' OR price>500;
— ORDER BY 排序,ASC 升序(默认),DESC 降序
SELECT * FROM product ORDER BY price;
SELECT * FROM product ORDER BY price DESC;
1.4 聚合函数与分组
| avg() | 平均值 |
| max() / min() | 最大 / 最小 |
| sum() | 求和 |
| count() | 计数(行数) |
SELECT avg(price) FROM product;
SELECT sum(stock) FROM product;
— 查最贵产品:子查询
SELECT * FROM product WHERE price=(SELECT max(price) FROM product);
— GROUP BY:按某列分组后聚合(如每个类别库存合计)
SELECT id_category, sum(stock) FROM product GROUP BY id_category;
1.5 多表查询(🔺 连接)
当数据分散在多张表,需要靠"关联字段"拼接:
— 查类型为 Servers 的产品名和价格
SELECT product.name, product.price
FROM product, category
WHERE product.id_category = category.id — 关联条件
AND category.name='Servers';
💡 product.id_category = category.id 是连接的关键,漏掉会产生"笛卡尔积"(行数爆炸)。
1.6 建表、插入、更新、删除
① 建表 CREATE TABLE:
CREATE TABLE staff(
id INT(11) NOT NULL,
name VARCHAR(100) NOT NULL,
age INT(11) DEFAULT 10,
id_department INT(11)
);
② 插入 INSERT:
INSERT INTO staff (id,name,age,id_department) VALUES (1,'hero1',28,10);
INSERT INTO staff (id,name) VALUES (2,'hero2'); — 未给的列用默认值/NULL
③ 更新 UPDATE(🔺):
UPDATE staff SET age=30 WHERE id=3; — 只改 id=3 这行
UPDATE staff SET age=30; — ⚠️ 没有 WHERE,全表所有行都被改!
④ 删除 DELETE(🔺):
DELETE FROM staff WHERE id=3; — 只删 id=3
DELETE FROM staff; — ⚠️ 没有 WHERE,清空全表(表结构还在)
⑤ 删除表 DROP TABLE:
DROP TABLE staff; — 连表结构带数据一起删除(最彻底)
🔺 DELETE vs DROP 区别(高频面试):DELETE 删「数据行」,表还在;DROP 删「整张表」(结构+数据)。TRUNCATE 则是快速清空全表数据。
第 2 章 管理数据库用户
【使用频率:高】数据库账号与 Linux 系统账号是两套独立体系,即使同名也无关。
2.1 账号格式 user@host
账号由「用户名 + 来源主机」组成,同名用户可因来源不同而权限不同:
| hero 或 hero@'%' | 可从任意主机连接 |
| hero@'localhost' | 只能本机连接 |
| hero@'10.1.8.12' | 只能从指定 IP |
| hero@'10.1.8.%' | 可从 10.1.8.0/24 网段 |
2.2 创建用户
CREATE USER hero@'%' IDENTIFIED BY '123';
新用户默认只有最小权限,什么库表都操作不了,必须再授权。 密码经加密后存在 mysql.user 表(不是明文)。
2.3 授权 GRANT(⭐ 四级粒度)
GRANT 权限1,权限2 ON 范围 TO '用户'@'主机';
| 全局 | *.* | DBA、超级管理员 |
| 数据库级 | 库名.* | 业务库开发 |
| 表级 | 库名.表名 | 单表操作 |
| 列级 | 库名.表名(列1,列2) | 敏感列(手机号/密码)管控 |
常用权限:SELECT/INSERT/UPDATE/DELETE(增删改查)、CREATE/ALTER/DROP(结构)、ALL PRIVILEGES(全部)。
— 业务库全权限
GRANT SELECT,INSERT,UPDATE,DELETE,CREATE ON inventory.* TO hero@'%';
— 只读账号(报表/监控)
GRANT SELECT ON inventory.* TO 'report'@'%';
— 全局管理员
GRANT ALL PRIVILEGES ON *.* TO 'dba'@'localhost';
授权后执行 FLUSH PRIVILEGES; 让权限生效。
💡 最小权限原则:只给"刚好够用"的权限;生产环境避免 @'%',应限定具体 IP/网段。
2.4 查看 / 回收 / 删除 / 改密码
SHOW GRANTS FOR hero@'%'; — 查看权限
SHOW GRANTS; — 查看当前登录用户权限
REVOKE DELETE ON inventory.* FROM hero@'%'; — 回收某权限
DROP USER hero@'%'; — 删除用户
— 改密码
SET PASSWORD FOR 'hero'@'%' = PASSWORD('新密码');
SET PASSWORD = PASSWORD('新密码'); — 改自己的密码
FLUSH PRIVILEGES;
2.5 常见访问故障
| 只能本机连,远程连不上 | server.cnf 设了 skip-networking;或 bind-address 不对;user 表无对应主机记录 |
| 能连但只看得到 information_schema | 没给该用户授权(新用户最小权限) |
| 能连但不能建库 | 需授予全局 CREATE 权限 |
| 能连但不能读写数据 | 需授予对应库的 CRUD 权限 |
第 3 章 备份和恢复
【使用频率:高】备份是运维保命手段。
3.1 ⭐ 逻辑备份 vs 物理备份
| 内容 | 导出为可重建数据库的 SQL 文本 | 直接复制数据库目录/文件 |
| 速度 | 慢(要转换格式) | 快(直接拷文件) |
| 可移植性 | 高,甚至可导入其他数据库 | 差,需相同软硬件环境 |
| 执行时机 | 服务在线即可 | 通常需停服或锁表 |
| 是否含日志/配置 | 不含 | 可包含 |
3.2 物理备份 / 恢复
systemctl stop mariadb
cp -a /var/lib/mysql /backup/mysql # 备份(-a 保留属性)
# 恢复
systemctl stop mariadb
rm -fr /var/lib/mysql
cp -a /backup/mysql /var/lib/mysql
chown -R mysql:mysql /var/lib/mysql # 关键:恢复属主
systemctl start mariadb
3.3 逻辑备份 mysqldump(⭐ 最常用)
# 方式1:只备份数据/表(不含建库语句)
mysqldump -u root -p inventory > /backup/inventory-1.sql
# 方式2:含 CREATE DATABASE / USE(推荐,恢复最省事)
mysqldump -u root -p –databases inventory > /backup/inventory-2.sql
# 方式3:备份所有数据库
mysqldump -u root -p –all-databases > /backup/all.sql
恢复:
# 方式2 的文件(自带建库),直接导入
mysql -u root -p < /backup/inventory-2.sql
# 方式1 的文件,需先建库再指定库导入
mysql -u root -p -e 'create database inventory;'
mysql -u root -p inventory < /backup/inventory-1.sql
在 mysql 命令行内也可用 source /backup/xxx.sql; 执行恢复。 🔺 还原会用备份内容覆盖现有数据,比备份新的数据会丢失。
第 4 章 主从同步
【使用频率:高】主从复制用于读写分离、备份、高可用,是数据库扩展的基础。
4.1 ⭐ 同步原理(🔺 核心,务必理解)
本质:主库把数据变更写进 binlog,从库拉取并重放。涉及两个日志、两个线程:
主库 Master:写操作 → 记录到 二进制日志 binlog
│
│ 从库 IO 线程主动连接主库、拉取 binlog
▼
从库 Slave:IO 线程把内容写入 中继日志 relay log
│
│ SQL 线程读取 relay log,逐条重放
▼
从库数据与主库最终一致
| 主库 | binlog | 记录所有数据变更 |
| 从库 IO 线程 | Slave_IO_Running | 拉主库 binlog,写入 relay log |
| 从库 SQL 线程 | Slave_SQL_Running | 读 relay log 并重放 SQL |
💡 主库写完 binlog 就立即回复客户端(不等从库),这是"异步"特征。
4.2 常见架构
- 一主一从 / 一主多从:主写从读,多从可分担读压力(读写分离);
- 级联复制:主→从1→从2,减轻主库复制压力;
- 双主复制:互为主从,多用于高可用切换,一般不双写(易冲突)。
4.3 三种复制方式
| 异步(默认) | 主库写完即回复,不等从库 | 性能最好,宕机可能丢数据 |
| 半同步 | 主库等至少一个从库确认收到 binlog 再回复;超时降级异步 | 一致性更好,性能略损 |
| 全同步 | 等所有从库执行完才回复 | 一致性最高、性能最差(需 MGR 等实现) |
4.4 主从延迟
- 延迟没有固定值,取决于从库"拉取+执行"速度;
- 影响因素:网络(跨机房慢)、主库大事务/高写入、从库硬件差、SQL 线程单线程;
- 监控:从库 SHOW SLAVE STATUS\\G; 中 Seconds_Behind_Master 即落后秒数;
- 优化:提升从库配置、开启并行复制(slave_parallel_workers)、拆分大事务、级联复制。
4.5 ⭐ 主从同步实践(db1 = 10.1.8.13 主,db2 = 10.1.8.14 从)
① 配置主库 db1:
cat > /etc/my.cnf.d/master.cnf <<'EOF'
[mysqld]
server_id = 1
log_bin = mysql-bin
binlog_format = ROW
relay_log = mysql-relay-bin
binlog-ignore-db = information_schema
binlog-ignore-db = performance_schema
EOF
systemctl restart mariadb
② 配置从库 db2:
cat > /etc/my.cnf.d/master.cnf <<'EOF'
[mysqld]
server_id = 2
log_bin = mysql-bin
binlog_format = ROW
relay_log = mysql-relay-bin
binlog-ignore-db = information_schema
binlog-ignore-db = performance_schema
EOF
systemctl restart mariadb
③ 主库建立复制账号、查看位点:
— 在 db1(10.1.8.13)执行
mysql –uroot –p123
GRANT REPLICATION SLAVE, REPLICATION CLIENT ON *.*
TO 'repl'@'10.1.8.14' IDENTIFIED BY '123';
FLUSH PRIVILEGES;
SHOW MASTER STATUS;
— 记下 File(如 mysql-bin.000003)和 Position(如 327)
④ 从库指向主库并启动:
— 在 db2(10.1.8.14)执行
mysql –uroot –p123
CHANGE MASTER TO
master_host='10.1.8.13',
master_user='repl',
master_password='123',
master_port=3306,
— 与主节点 SHOW MASTER STATUS 查到的对应
master_log_file='mysql-bin.000003',
master_log_pos=327,
master_connect_retry=30;
START SLAVE;
SHOW SLAVE STATUS\\G;
— 确认两项都为 Yes:
— Slave_IO_Running: Yes
— Slave_SQL_Running: Yes
⑤ 验证同步:
— 主库 db1 建库建表插数据
CREATE DATABASE test; USE test;
CREATE TABLE linux(username varchar(15), password varchar(15));
INSERT INTO linux VALUES ('hero1','123'),('hero2','123'),('hero3','123');
— 从库 db2 查询,能看到即同步成功
SELECT * FROM test.linux;
🔺 配置要点:两库 server_id 不能重复;从库 CHANGE MASTER 里的文件名和位点必须来自主库 SHOW MASTER STATUS 的真实值。
4.6 防止数据丢失的关键参数
- 半同步复制;
- sync_binlog=1:每次事务把 binlog 刷盘;
- innodb_flush_log_at_trx_commit=1:事务提交立即刷 redo log。
第 5 章 应急场景(🔺 救命)
共同思路:绕过权限验证启动 → 改权限表 → 恢复正常启动。
5.1 忘记 root 密码
FLUSH PRIVILEGES;
5.2 root 权限被误回收
- 同样 skip-grant-tables 启动后:
- 老版本:UPDATE mysql.user SET 各权限列='Y' WHERE User='root'; FLUSH PRIVILEGES;
- 新版本:FLUSH PRIVILEGES; GRANT ALL PRIVILEGES ON *.* TO 'root'@'localhost' WITH GRANT OPTION;
- 重启恢复。
5.3 root 账号被误删除
- skip-grant-tables 启动后:
- 老版本:向 mysql.user 插入 root 行(各权限列设 Y);
- 新版本:CREATE USER 'root'@'localhost' IDENTIFIED BY '123'; GRANT ALL PRIVILEGES ON *.* TO 'root'@'localhost' WITH GRANT OPTION;
- FLUSH PRIVILEGES; 后重启。
第二篇 Nginx 服务器
第 6 章 Nginx 介绍
【使用频率:极高】当今最主流的 Web 服务器 / 反向代理 / 负载均衡器。
Nginx(engine x)是一款高性能的 HTTP 服务器和反向代理服务器:高并发下可支撑约 5 万并发连接,而内存、CPU 消耗很低、运行稳定。
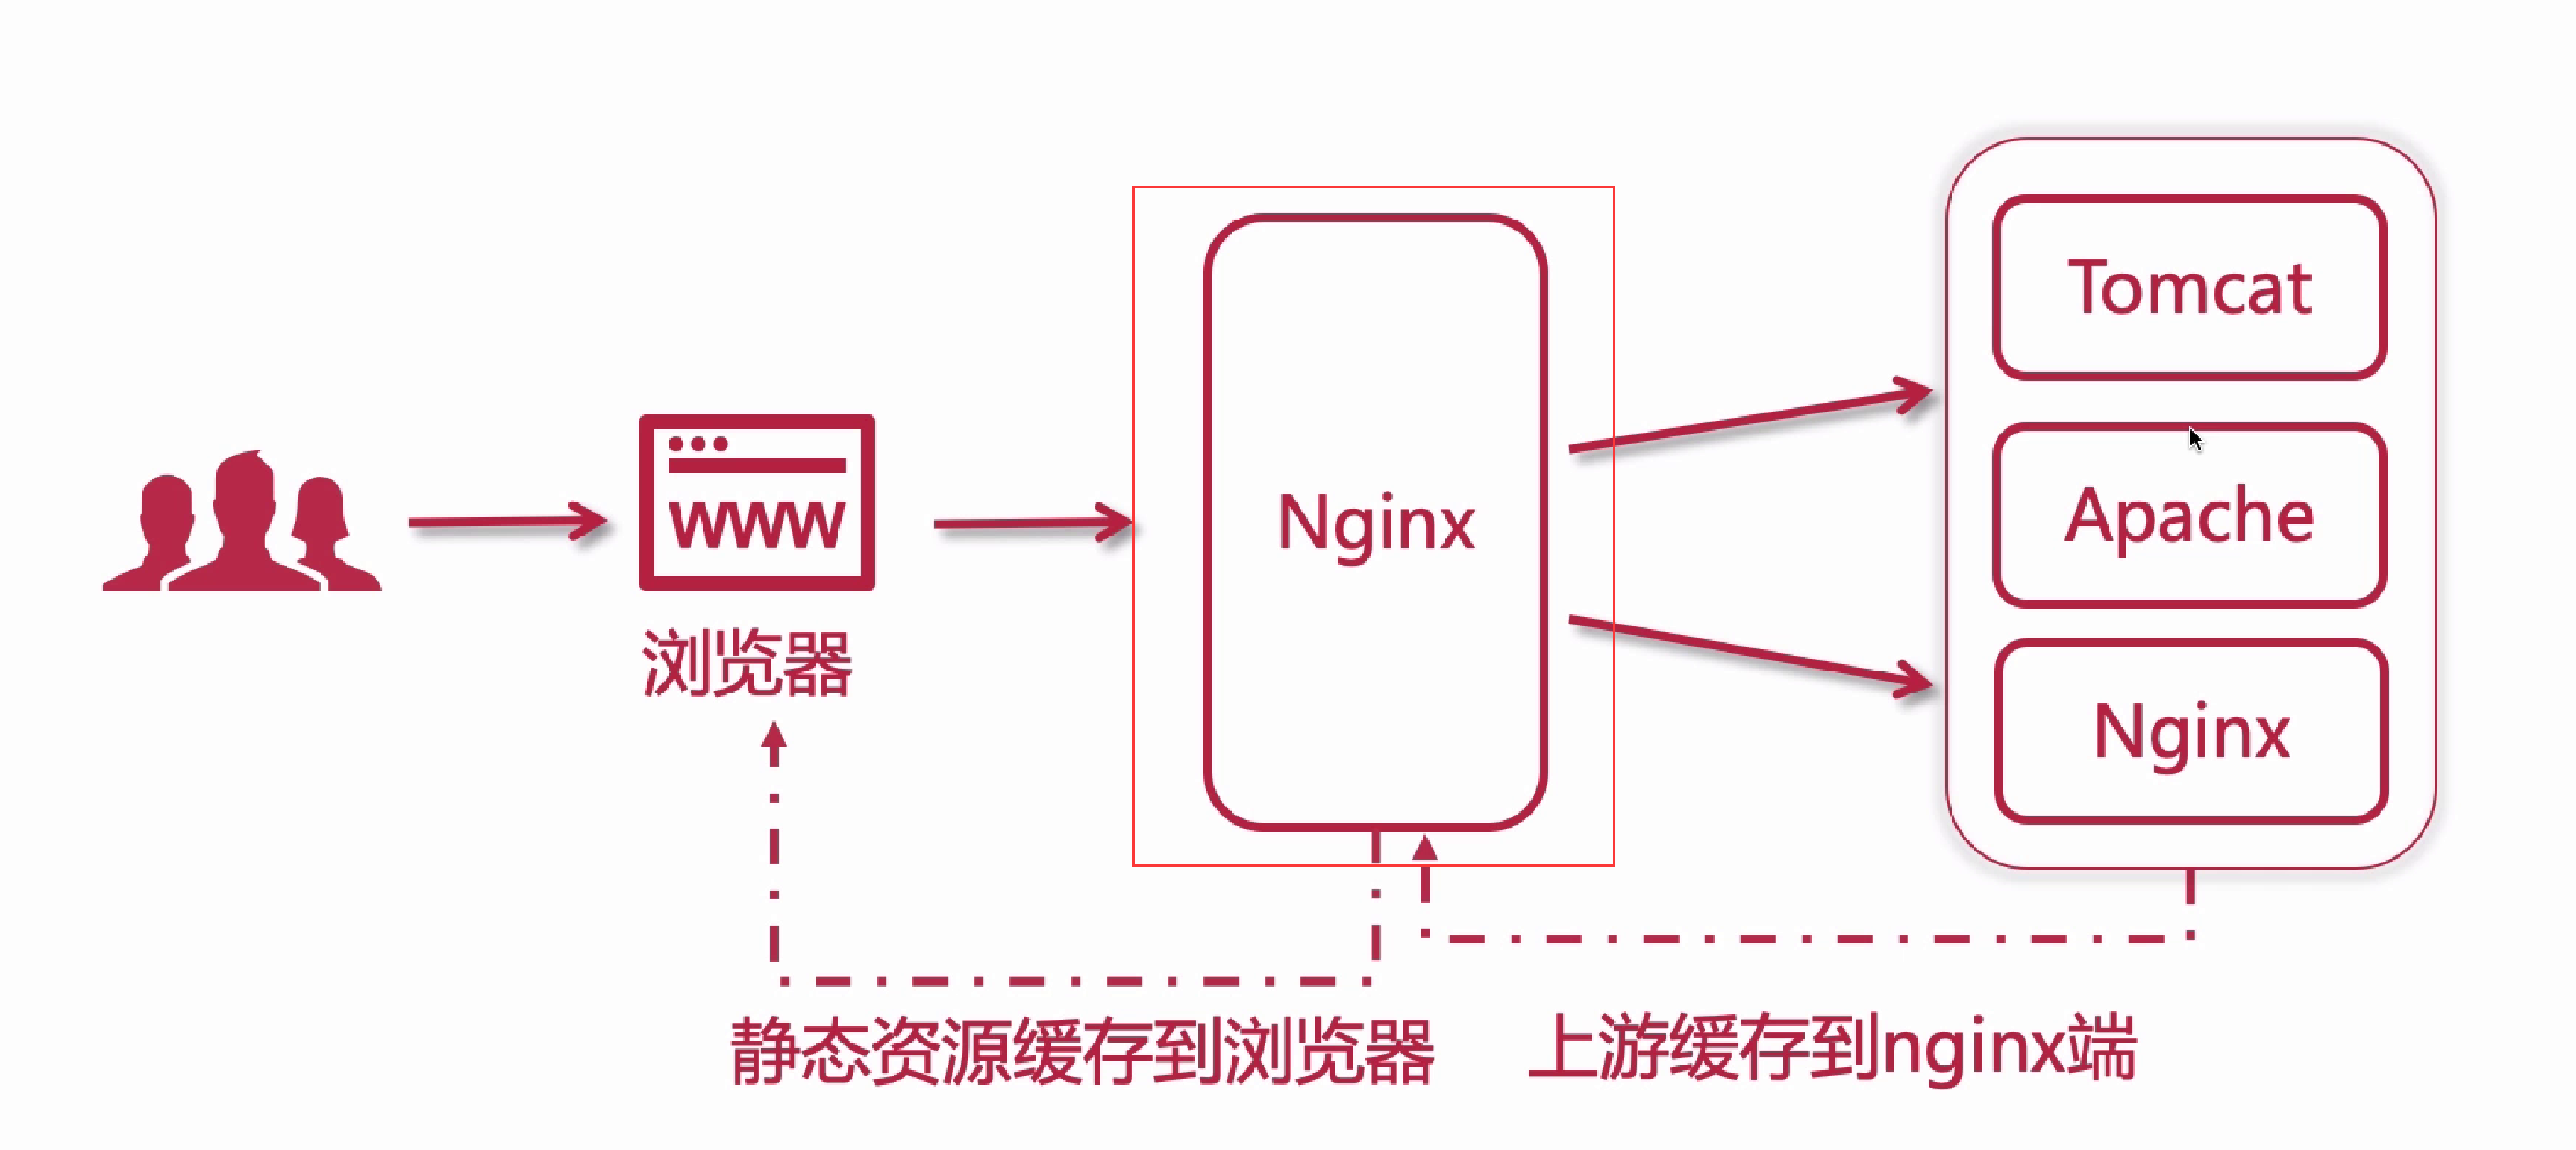
- 典型位置:用户浏览器 → Nginx(统一入口) → 后端 Tomcat / Apache / 应用服务器;
- 静态资源可缓存到浏览器,上游响应可缓存到 Nginx,进一步提速、减压。
💡 Nginx 常见四大角色:① Web 服务器(提供静态网页);② 反向代理;③ 负载均衡;④ 缓存。
第 7 章 Nginx 部署
# 安装、启动
yum -y install nginx
systemctl enable nginx –now
# 准备主页(备份原首页,写入新内容)
mv /usr/share/nginx/html/index.html{,.ori}
echo Hello World From Nginx > /usr/share/nginx/html/index.html
# 防火墙放行 HTTP
firewall-cmd –add-service=http –permanent
firewall-cmd –reload
用域名访问(配置 hosts 解析):
# Linux / Unix 改 /etc/hosts;Windows 改 C:\\Windows\\System32\\drivers\\etc\\hosts
10.1.8.11 www.hero.cloud
之后 curl http://www.hero.cloud 即可访问。
第 8 章 Nginx 配置结构(⭐ 层级化)
整体是嵌套结构:全局块 → events 块 → http 块 → server 块 → location 块。
| 全局块 | 整个进程的基础设置 | user、worker_processes、error_log、pid |
| events 块 | 网络连接模型 | worker_connections、use epoll |
| http 块 | 所有 HTTP 服务公共配置 | include mime.types、log_format、sendfile、keepalive |
| server 块 | 一个虚拟主机 | listen、server_name、root |
| location 块 | URL 路径匹配规则 | index、try_files、proxy_pass |
# 全局
user nginx;
worker_processes auto; # 工作进程数,auto=按 CPU 核数
# events
events {
worker_connections 1024; # 每个工作进程最大连接数
use epoll; # Linux 高性能事件模型
}
# http
http {
include /etc/nginx/mime.types;
default_type application/octet-stream;
sendfile on;
keepalive_timeout 65;
server {
listen 80;
server_name localhost;
root /usr/share/nginx/html;
location / {
index index.html index.htm;
}
error_page 500 502 503 504 /50x.html;
}
}
💡 并发能力怎么算:最大连接数 ≈ worker_processes × worker_connections。 HTTPS 在 server 块加 listen 443 ssl; 并配置 ssl_certificate(公钥)、ssl_certificate_key(私钥)。
第 9 章 nginx.conf 详解要点
主配置文件 /etc/nginx/nginx.conf,重点指令:
| user nginx | 工作进程运行用户 |
| worker_processes auto | 工作进程数(建议=CPU 核数) |
| log_format / access_log | 日志格式 / 访问日志 |
| sendfile on | 高效文件传输(零拷贝) |
| tcp_nopush / tcp_nodelay | 优化数据包发送、降低延迟 |
| keepalive_timeout 65 | 长连接保持时间 |
| include /etc/nginx/conf.d/*.conf | 加载子配置(虚拟主机通常写这里) |
💡 生产中习惯把每个站点写成 /etc/nginx/conf.d/xxx.conf,主配置只保留全局设置,便于管理。
第 10 章 配置加载与 location 匹配(🔺)
- include 可引入外部配置,实现模块化;
- 优先级:子级覆盖父级;同层后定义覆盖先定义;
- location 匹配优先级(高→低):
- 精确匹配 =
- 前缀匹配 ^~
- 正则匹配 ~(区分大小写)/ ~*(不区分)
- 普通前缀匹配
- 修改配置后先测试再重载:nginx -t # 检查语法(⭐必做)
systemctl reload nginx # 平滑重载,不断连接
第 11 章 虚拟主机
【使用频率:高】同一台 Web 服务器对外提供多个站点。 三种区分方式:域名(最常用)、端口、IP(基本不用)。
11.1 基于域名(⭐ 最常用)
/etc/nginx/conf.d/vhost-name.conf:
server {
server_name web1.hero.cloud;
root /usr/share/nginx/web1;
}
server {
server_name web2.hero.cloud;
root /usr/share/nginx/web2;
}
准备目录和首页:
mkdir /usr/share/nginx/web{1,2}
echo web1.hero.cloud > /usr/share/nginx/web1/index.html
echo web2.hero.cloud > /usr/share/nginx/web2/index.html
nginx -t && systemctl restart nginx
客户端 hosts:
10.1.8.11 web1.hero.cloud
10.1.8.11 web2.hero.cloud
测试:
curl http://web1.hero.cloud/ # web1.hero.cloud
curl http://web2.hero.cloud/ # web2.hero.cloud
11.2 基于端口
server { listen 8081; server_name www.hero.cloud; root /usr/share/nginx/8081; }
server { listen 8082; server_name www.hero.cloud; root /usr/share/nginx/8082; }
mkdir /usr/share/nginx/808{1,2}
echo 8081 > /usr/share/nginx/8081/index.html
echo 8082 > /usr/share/nginx/8082/index.html
nginx -t && systemctl restart nginx
curl http://www.hero.cloud:8081 # 8081
curl http://www.hero.cloud:8082 # 8082
💡 实验后及时清理(移走/删除 conf.d 中的实验配置),避免影响后续实验。
总结篇
一、核心知识链路
MariaDB:
表 CRUD:SELECT(+WHERE/ORDER BY/聚合) / INSERT / UPDATE / DELETE;DROP 删表
用户:CREATE USER user@host → GRANT(*.* / 库.* / 表 / 列)→ FLUSH PRIVILEGES
备份:逻辑 mysqldump(SQL文本、可移植、慢) vs 物理(拷目录、快)
主从:主库 binlog → 从库 IO线程写 relay log → SQL线程重放
db1(.13) 建 repl 账号/查位点 → db2(.14) CHANGE MASTER + START SLAVE
应急:skip-grant-tables 绕过验证后修复
Nginx:
部署 → 配置层级 全局/events(http→server→location)
nginx -t 校验 → reload
虚拟主机:域名(常用)/ 端口
二、重点 / 难点 / 频率
| SELECT 条件/排序/聚合/多表 | ⭐ | 极高 |
| INSERT/UPDATE/DELETE、无 WHERE 风险 | ⭐ | 极高 |
| 用户与 GRANT 四级权限、最小权限 | ⭐ | 高 |
| mysqldump 逻辑备份恢复 | ⭐ | 高 |
| 主从原理(binlog/IO/SQL 线程) | 🔺 | 高 |
| 主从实践配置 | 🔺 | 高 |
| skip-grant-tables 应急 | 🔺 | 中 |
| Nginx 部署与配置层级 | ⭐ | 极高 |
| nginx -t / reload、location 优先级 | 🔺 | 高 |
| 虚拟主机(域名/端口) | ⭐ | 高 |


评论前必须登录!
注册