 网硕互联帮助中心
💖💖作者:计算机毕业设计江挽 💙💙个人简介:曾长期从事计算机专业培训教学,本人也热爱上课教学,语言擅长Java、微信小程序、Python、Golang、安卓Android等,开发项目包括大数据、深度学习、网站、小程序、安卓、算法。平常会做一些项目定制化开发、代码讲解、答辩教学、文档编写、也懂一些降重方面的技巧。平常喜欢分享一些自己开发中遇到的问题的解决办法,也喜欢交流技术,大家有技术代码这一块的问题可以问我! 💛💛想说的话:感谢大家的关注与支持! 💜💜 网站实战项目 安卓/小程序实战项目 大数据实战项目 深度学习实战项目
目录
- 基于大数据的宫颈癌变进程光谱特征数据分析与可视化介绍
- 基于大数据的宫颈癌变进程光谱特征数据分析与可视化演示视频
- 基于大数据的宫颈癌变进程光谱特征数据分析与可视化演示图片
- 基于大数据的宫颈癌变进程光谱特征数据分析与可视化代码展示
- 基于大数据的宫颈癌变进程光谱特征数据分析与可视化文档展示
基于大数据的宫颈癌变进程光谱特征数据分析与可视化介绍
本系统《基于大数据的宫颈癌变进程光谱特征数据分析与可视化》以Hadoop分布式文件系统(HDFS)作为底层存储底座,承担光谱原始数据文件与清洗后结构化结果集的持久化存储任务,利用Spark计算引擎完成大规模光谱特征数据的并行清洗、转换与聚合统计,数据分析层融合Pandas与NumPy实现数值型特征的快速计算。系统后端采用Django构建RESTful API服务,前端基于Vue框架配合ElementUI与ECharts搭建交互式可视化界面,MySQL数据库存储用户信息、光谱样本基础标签及分析任务记录。系统围绕宫颈癌变进程的光谱数据特性,重点实现光谱基础画像、光谱数据管理与个人信息维护三个核心功能模块,覆盖从原始数据入库、特征计算到画像展示的完整链条,为宫颈癌变进程研究提供数据支撑与可视化分析手段。
基于大数据的宫颈癌变进程光谱特征数据分析与可视化演示视频
演示视频
基于大数据的宫颈癌变进程光谱特征数据分析与可视化演示图片
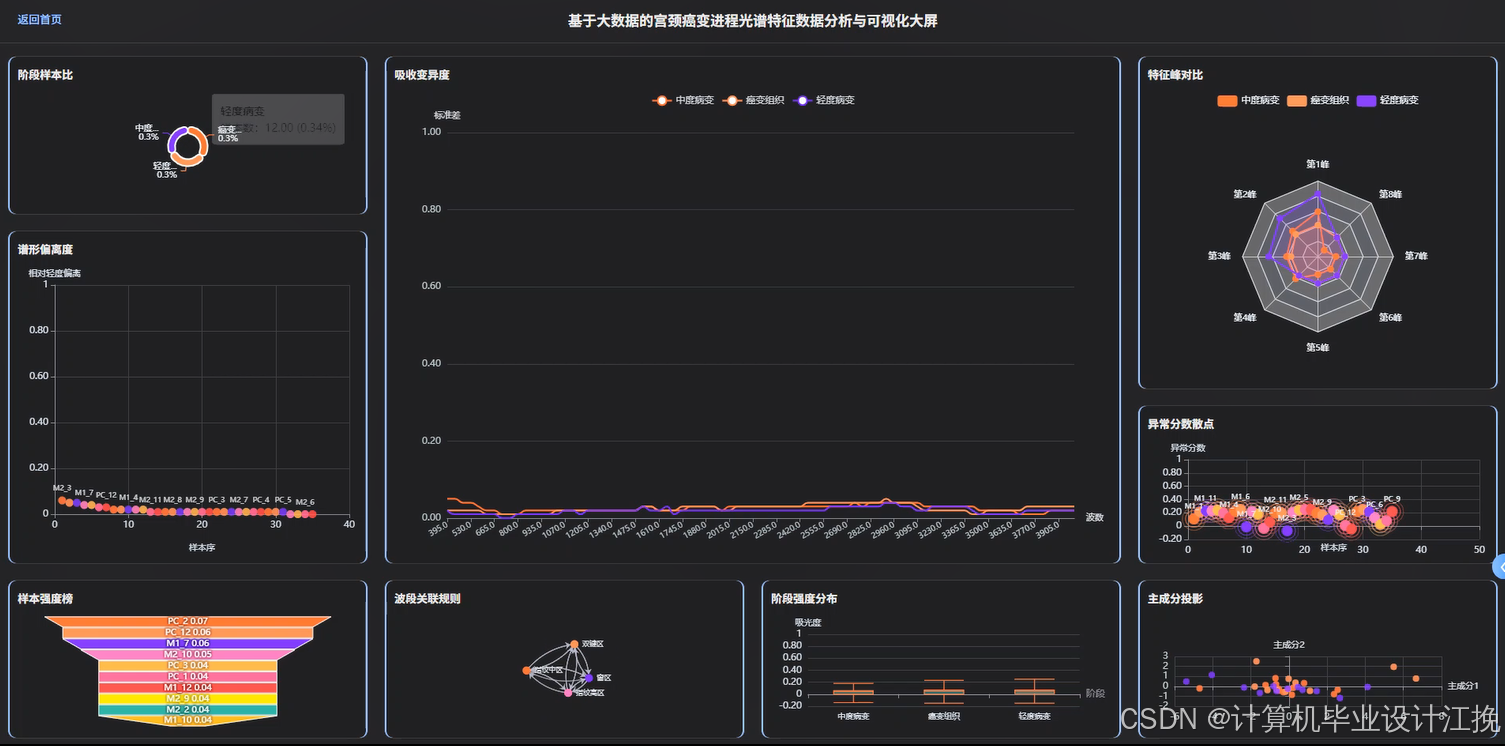
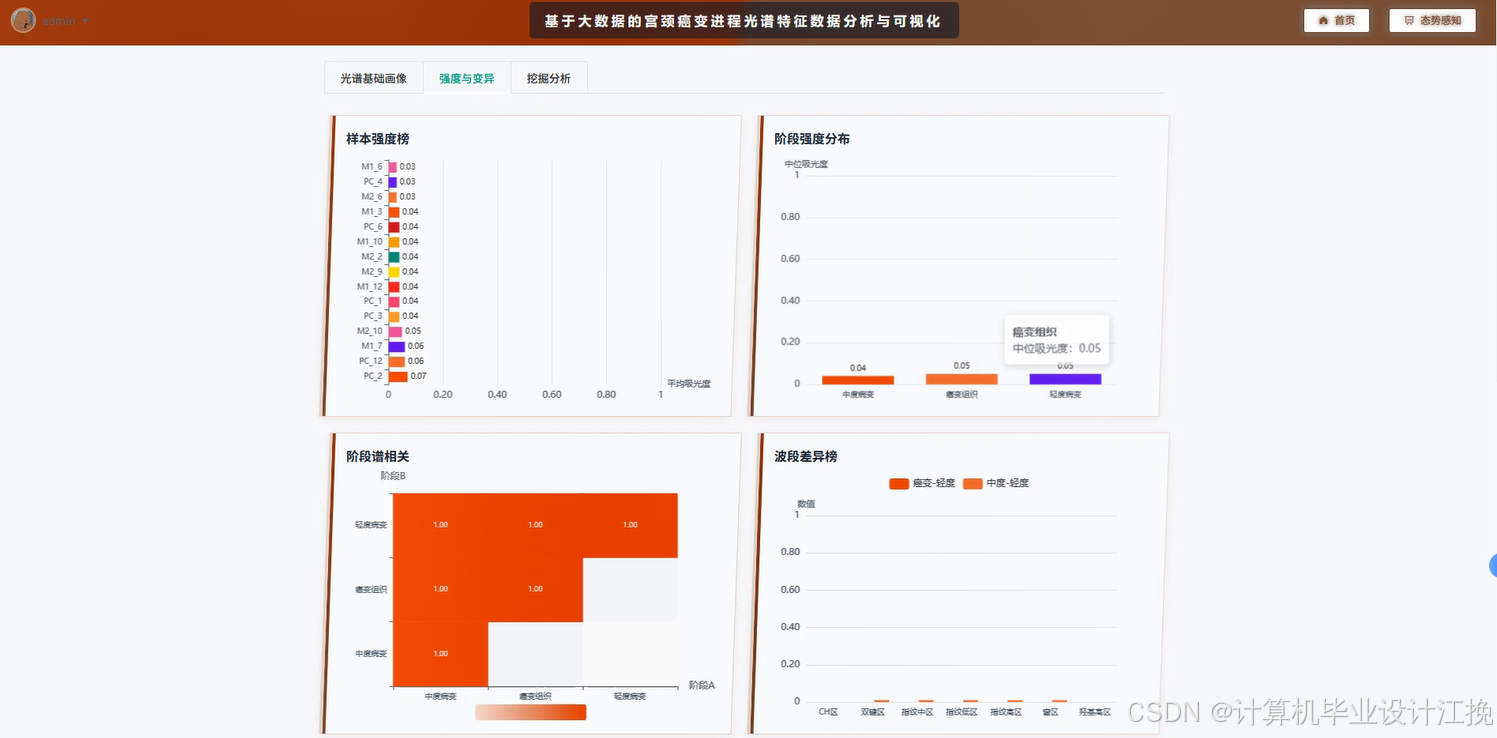
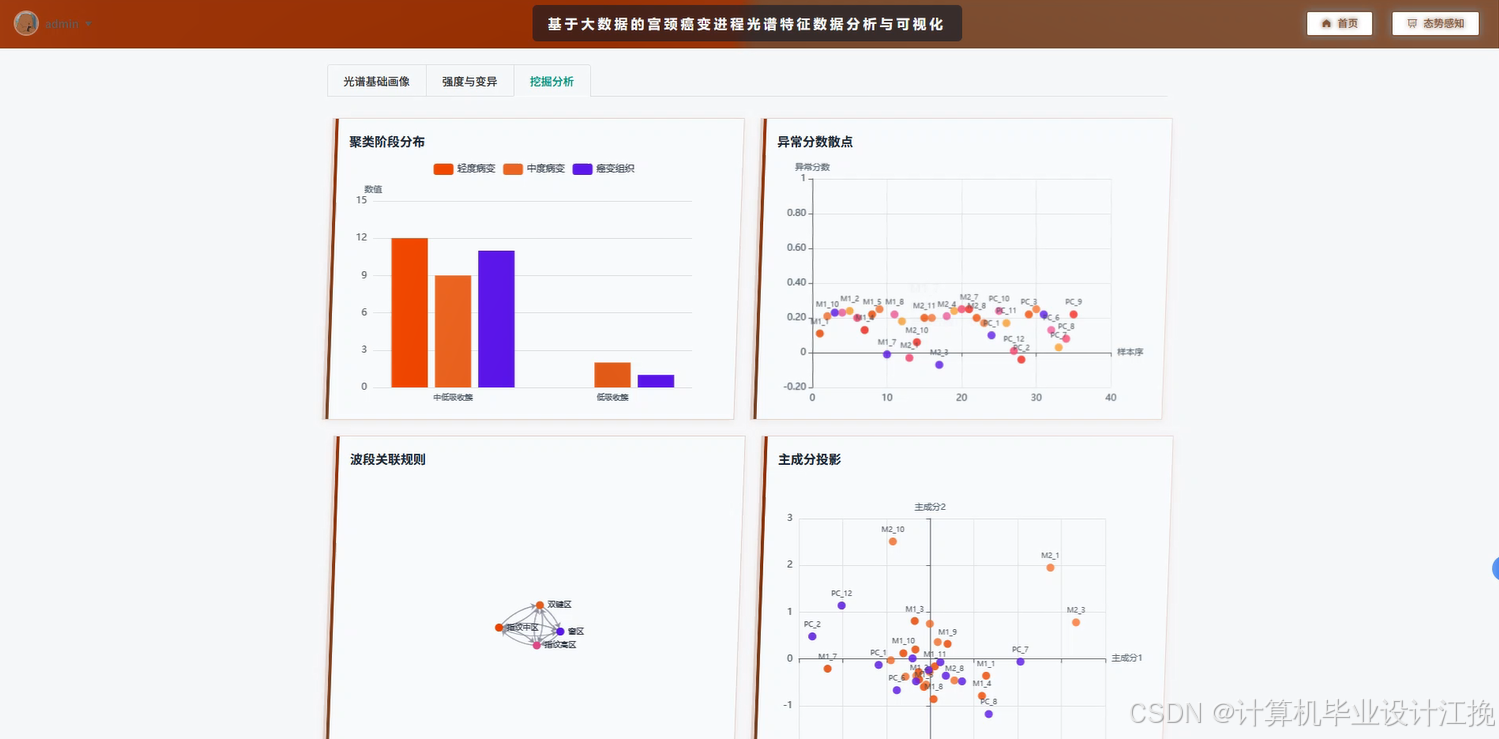
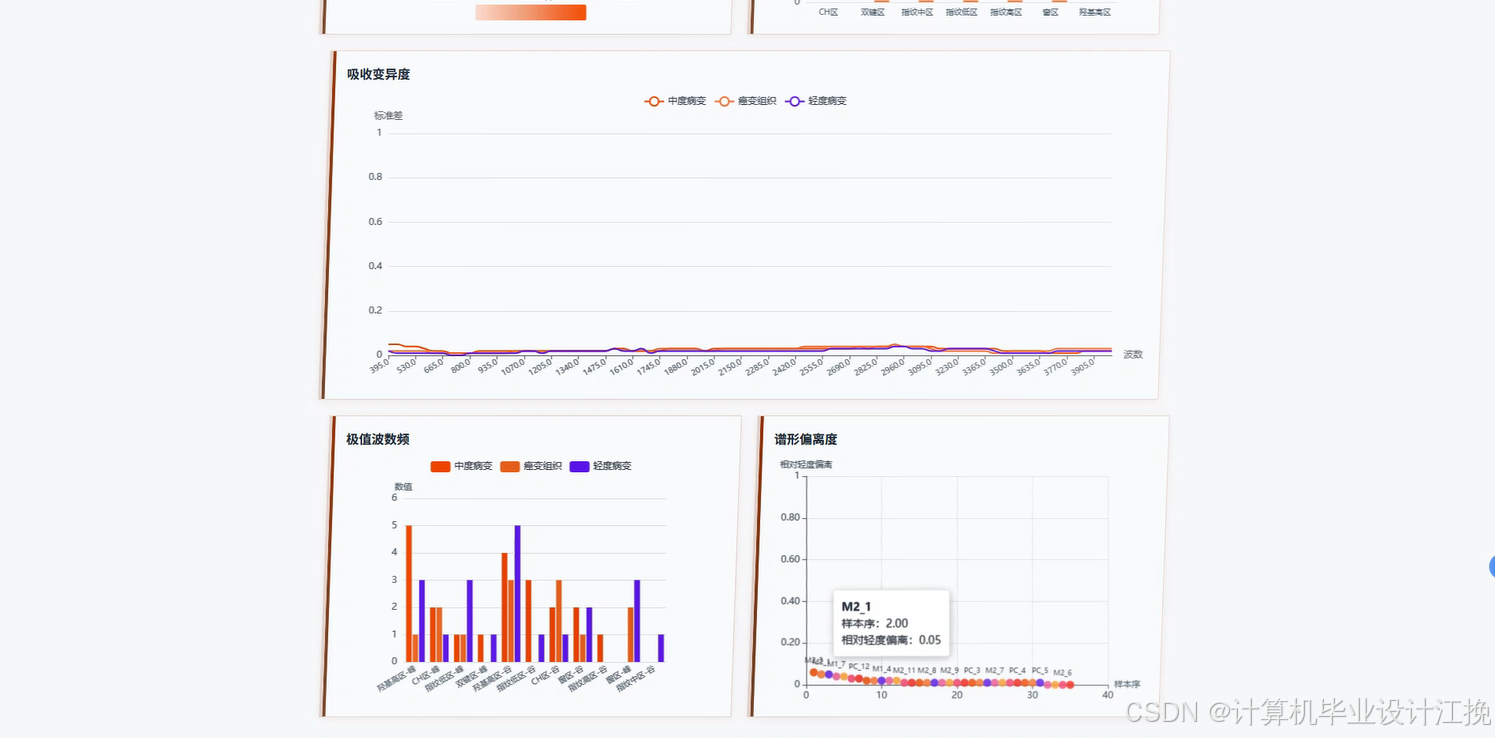
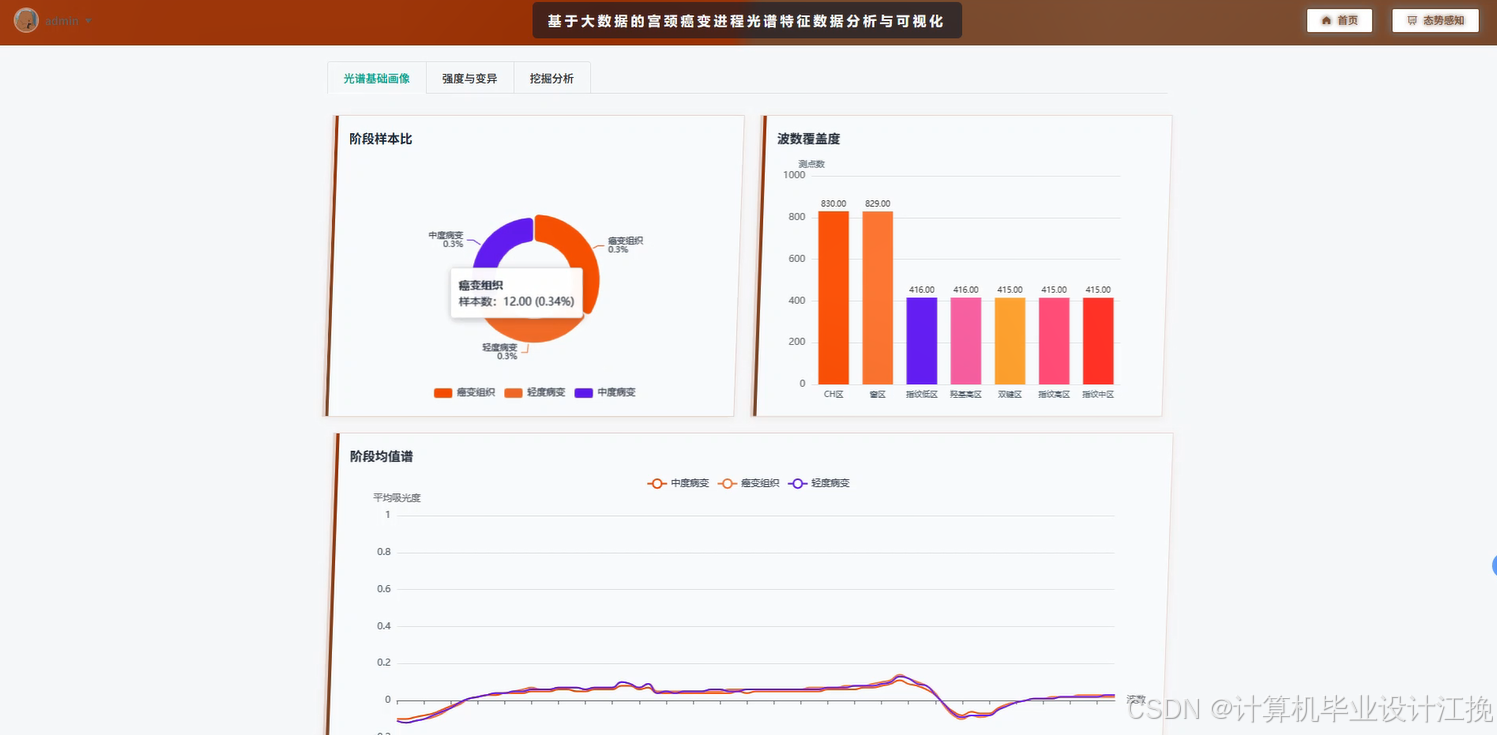
基于大数据的宫颈癌变进程光谱特征数据分析与可视化代码展示
from pyspark.sql import SparkSession
from pyspark.sql.functions import col, avg, stddev, count, sum as spark_sum, max as spark_max, min as spark_min
spark = SparkSession.builder.appName("CervicalCancerSpectrumAnalysis").config("spark.sql.adaptive.enabled", "true").config("spark.sql.adaptive.coalescePartitions.enabled", "true").getOrCreate()
# 功能一:光谱基础画像 – 计算不同病变阶段的光谱统计特征并生成画像数据
def generate_spectrum_profile(sample_ids, stage_list):
hdfs_path = "hdfs://namenode:9000/data/spectrum_clean"
df = spark.read.parquet(hdfs_path).filter(col("sample_id").isin(sample_ids)).filter(col("stage").isin(stage_list))
profile_df = df.groupBy("stage").agg(avg("intensity").alias("avg_intensity"), stddev("intensity").alias("std_intensity"), count("sample_id").alias("sample_count"), spark_sum("intensity").alias("sum_intensity"))
profile_pd = profile_df.toPandas()
profile_pd["cv"] = profile_pd["std_intensity"] / profile_pd["avg_intensity"]
result_dict = profile_pd.to_dict(orient="records")
for item in result_dict:
stage = item.get("stage")
df_stage = df.filter(col("stage") == stage)
max_val = df_stage.select(spark_max("intensity")).collect()[0][0]
min_val = df_stage.select(spark_min("intensity")).collect()[0][0]
item["max_intensity"] = max_val
item["min_intensity"] = min_val
quantiles = df_stage.approxQuantile("intensity", [0.25, 0.5, 0.75], 0.01)
item["q1"] = quantiles[0]
item["median"] = quantiles[1]
item["q3"] = quantiles[2]
spark.catalog.clearCache()
return result_dict
# 功能二:光谱数据管理 – 根据条件分页查询光谱数据记录并返回前端表格展示
def query_spectrum_data(page, limit, sample_id=None, stage=None, min_intensity=None, max_intensity=None):
hdfs_path = "hdfs://namenode:9000/data/spectrum_clean"
df = spark.read.parquet(hdfs_path)
if sample_id:
df = df.filter(col("sample_id") == sample_id)
if stage:
df = df.filter(col("stage") == stage)
if min_intensity is not None:
df = df.filter(col("intensity") >= min_intensity)
if max_intensity is not None:
df = df.filter(col("intensity") <= max_intensity)
total_count = df.count()
df_sorted = df.orderBy(col("sample_id"), col("wavelength"))
offset = (page – 1) * limit
df_page = df_sorted.limit(limit).offset(offset)
result_pd = df_page.toPandas()
result_pd["wavelength"] = result_pd["wavelength"].round(2)
result_pd["intensity"] = result_pd["intensity"].round(4)
result_list = result_pd.to_dict(orient="records")
spark.catalog.clearCache()
return {"total": total_count, "data": result_list, "page": page, "limit": limit}
# 功能三:个人信息与密码管理 – 更新用户个人资料信息
def update_user_profile(user_id, update_fields):
df = spark.read.jdbc(url="jdbc:mysql://localhost:3306/spectrum_db", table="users", properties={"user": "root", "password": "123456"})
df_filtered = df.filter(col("id") == user_id)
if df_filtered.count() == 0:
spark.catalog.clearCache()
return {"code": 404, "msg": "用户不存在"}
existing_dict = df_filtered.select("email", "phone", "real_name", "department", "role").collect()[0].asDict()
merged_dict = existing_dict.copy()
for key, value in update_fields.items():
if key in merged_dict and value is not None and value != "":
merged_dict[key] = value
update_pdf = pd.DataFrame([{"id": user_id, **merged_dict}])
update_sdf = spark.createDataFrame(update_pdf)
update_sdf.write.mode("overwrite").jdbc(url="jdbc:mysql://localhost:3306/spectrum_db", table="users_temp", properties={"user": "root", "password": "123456"})
spark.sql("CREATE OR REPLACE TEMP VIEW users_view AS SELECT id, email, phone, real_name, department, role FROM users_temp")
spark.sql("INSERT OVERWRITE TABLE users SELECT t1.id, t1.username, t1.password, t2.email, t2.phone, t2.real_name, t2.department, t2.role FROM users t1 JOIN users_view t2 ON t1.id = t2.id")
spark.sql("DROP VIEW IF EXISTS users_temp")
spark.sql("DROP VIEW IF EXISTS users_view")
spark.catalog.clearCache()
return {"code": 200, "msg": "更新成功", "data": merged_dict}
基于大数据的宫颈癌变进程光谱特征数据分析与可视化文档展示
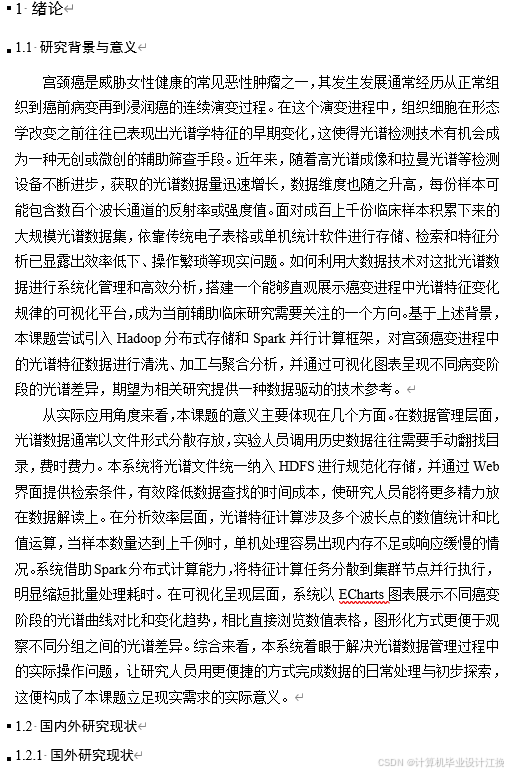
💖💖作者:计算机毕业设计江挽 💙💙个人简介:曾长期从事计算机专业培训教学,本人也热爱上课教学,语言擅长Java、微信小程序、Python、Golang、安卓Android等,开发项目包括大数据、深度学习、网站、小程序、安卓、算法。平常会做一些项目定制化开发、代码讲解、答辩教学、文档编写、也懂一些降重方面的技巧。平常喜欢分享一些自己开发中遇到的问题的解决办法,也喜欢交流技术,大家有技术代码这一块的问题可以问我! 💛💛想说的话:感谢大家的关注与支持! 💜💜 网站实战项目 安卓/小程序实战项目 大数据实战项目 深度学习实战项目


评论前必须登录!
注册