 网硕互联帮助中心
DeepSeek V4.1-Flash · 架构与成本深度解析
架构 → 缓存 → 定价 → 账单:一条因果链走到底
数据截止 2026 年 9 月 30 日 | 全文约 2.0 万字符、3 张文本示意与 2 张图表 | 官方一手数据 + 本机实跑脚本,价格口径全部注明
目录
1. 引子:一个名不副实的「Flash」
2. 先看价格表:降得最狠的是最不起眼的那一行
3. 账单的两半:98.6% 的 token,45% 的钱
4. 890 bytes/token:一条四代曲线
5. 架构一:CED 不对称——读用 8B,写用 16B
6. 架构二:CSA2 的三种注意力模式
7. 架构三:FP4 量化与缓存的生命周期
8. 三个手段合起来省了多少
9. 能力账:它赢了哪里,又输在哪里
10. 口径警告:同一个模型,换个外壳差 8.7 分
11. reasoning effort:从 25 拉到 100,买到什么
12. 三条诚实边界
13. 六条使用规则
14. 常见问题
15. 数据时效与参考资料
16. 附录:本机实验台
|
摘要 |
|
摘要: 9 月 10 日,DeepSeek 发布 V4.1-Flash。官方给的最醒目的两个数字是「552B 参数」和「输出价降 11%」——几乎所有报道都会引用它们。但如果你把一个真实 Agent 的账单按新价格表重算一遍,会发现这份账单实际降了 46%。差额不在输出那一行,在标价表最下面那一行:缓存命中。本文沿着「架构 → 缓存 → 定价 → 账单」这条因果链走一遍:CED 不对称架构怎么把 100 万 token 上下文的 KV cache 压到 890 字节/token,CSA2 的三种注意力模式怎么在层与层之间复用记忆,以及为什么这三件看起来极其底层的事,最后会变成你账单上的一行数字。一句话结论:这轮降价的真身,是「让 Agent 的重读变便宜」,而不是「让生成变便宜」。 |
关于本文数字的三种口径(沿用本系列惯例):
时效声明:V4.1-Flash 于 2026 年 9 月 10 日发布,本文写作时距发布 20 天。官方已明确 deepseek-v4-pro 自 9 月 14 日起路由至 Flash,直到 V4.1-Pro 发布——这意味着这个模型所处的版本窗口仍在变动中。引用价格前请核对官方定价页。
1. 引子:一个名不副实的「Flash」
先看三组数字。
|
项目 |
它要取代的 V4-Flash |
V4.1-Flash |
变化 |
|
主干参数 |
284B |
552B |
大 94% |
|
每 token 激活参数 |
13B |
8B (读) / 16B (写) |
读更少 |
|
名字 |
Flash (快) |
Flash (快) |
一样 |
一个叫「Flash」的模型,主干比它取代的那个大了一倍——这件事本身就值得停下来想一想。
再看它的成绩:官方对比表里,V4.1-Flash 在两边都有分的 14 行基准里赢了 12 行,对手是自家的 V4-Pro——一个 1.6T 主干、49B 激活的旗舰。而它用的是三分之一的主干参数、六分之一的激活参数。
最后看价格:它比上一代更便宜。
大了一倍、强了一个档、还更便宜。 这三件事同时成立,就意味着旧的那个「参数量 = 成本」的直觉,在这个模型上失效了。失效的原因,是这轮发布里真正重要的东西——不是参数量,是架构把「读」和「写」拆开了。
先说一条时间线,因为它决定了你此刻看到的价格是临时的还是长期的:
|
时间 |
事件 |
|
2026-08-13 |
V4-Pro 正式版( 1.6T 主干 / 49B 激活) |
|
2026-09-10 |
V4.1-Flash 发布;新价于 04:00 UTC 生效 |
|
2026-09-14 |
deepseek-v4-pro 的请求开始路由至 Flash |
|
待定 |
V4.1-Pro 发布, Pro 的路由随之终止 |
本文要回答三个问题:
2. 先看价格表:降得最狠的是最不起眼的那一行
官方定价页给出的完整价目表如下(单位:美元 / 每百万 token):
|
计费项 |
Flash 闲时 |
Flash 高峰 |
V4-Pro 闲时 |
V4-Pro 高峰 |
|
输入 · 缓存命中 |
0.003 |
0.006 |
0.022 |
0.044 |
|
输入 · 缓存未命中 |
0.15 |
0.30 |
0.66 |
1.32 |
|
输出 |
0.60 |
1.20 |
1.98 |
3.96 |
两条规则要记住:
- 闲时价 = 高峰价的一半。 高峰时段是周一至周五 01:00–04:00 与 06:00–10:00 UTC(北京时间 09:00–12:00 与 14:00–18:00),中国法定节假日不算高峰。一周 168 小时里,高峰只占 35 小时。
- 缓存命中的单价,是未命中的 1/50。 闲时 0.003 对 0.15,正好 50 倍。
现在看降幅。把 V4-Flash 的旧价和 V4.1-Flash 的新价并排(人民币口径,闲时):
|
计费项 |
V4-Flash |
V4.1-Flash |
降幅 |
|
缓存命中 |
0.05 元 |
0.02 元 |
−60.0% |
|
缓存未命中 |
1.50 元 |
1.00 元 |
−33.3% |
|
输出 |
4.50 元 |
4.00 元 |
−11.1% |
看出问题了吗?
三条线里,降幅最大的是缓存命中(−60%),最小的是输出(−11.1%)。 而绝大多数报道会引用的,恰恰是那个最小的数字。
这不是媒体偷懒,是「看得见的东西」和「重要的东西」经常不是同一个。 输出价是最好理解的——你生成多少字,就付多少钱。缓存命中价则需要你先理解「缓存」是什么,才能知道它为什么重要。
那它到底有多重要?看下一节。
3. 账单的两半:98.6% 的 token,45% 的钱
这一节是全文的核心,也是最容易被说错的一节。
有一份第三方对真实 Agent 流量的 30 天观测数据,结构是这样的:
|
示意图 · 文本绘制 |
|
新输入 26.7M token 输出 5.0M token 缓存重读 1,920.0M token <- 19.2 亿 ———————————— 合计 1,951.7M token |
这里面有个非常反直觉的事实:输出只有 500 万 token,缓存重读有 19.2 亿。
为什么?因为 Agent 的工作方式就是反复重读自己:
- 每一轮都要带上 System Prompt
- 每一轮都要带上项目说明
- 每一轮都要带上工具定义
- 每一轮都要带上前面几十轮的历史
- 每一轮都要带上上一步的执行结果
同一个前缀,它读了 100 遍。
把它想成一本菜谱。 你每做一道菜都不重印整本书,只是把书摊在桌上,翻到同一页再看一遍。Agent 也是这样——它不重新"想"这些内容,它重新"看"这些内容。而"重新看"是要付费的。
现在关键的部分来了。这 19.2 亿缓存重读,占 token 总量的 98.4%(如果只算输入侧,是 98.6%——媒体引用的就是这个口径)。
但在钱上,它是多少?
|
成本项 |
金额 |
占比 |
|
缓存重读 |
$5.76 |
45.1% |
|
新输入 |
$4.00 |
31.4% |
|
输出 |
$3.00 |
23.5% |
|
合计 |
$12.77 |
100% |
|
token 上占 98.6% 的那一块,成本上只占 45.1%。因为它的单价只有未命中的 1/50。 |
这不是矛盾,这是同一个事实的两个面。而且两个面都很有用:
- 看 token 占比 → 你知道优化方向在哪(重读)
- 看成本占比 → 你知道优化空间有多大(45%)
「占比」这件事,看 token 和看钱是两个答案。 如果你看到一篇文章说「缓存占 Agent 账单的 98.6%」,那不是算错了,就是混淆了口径——它说的是 token,不是钱。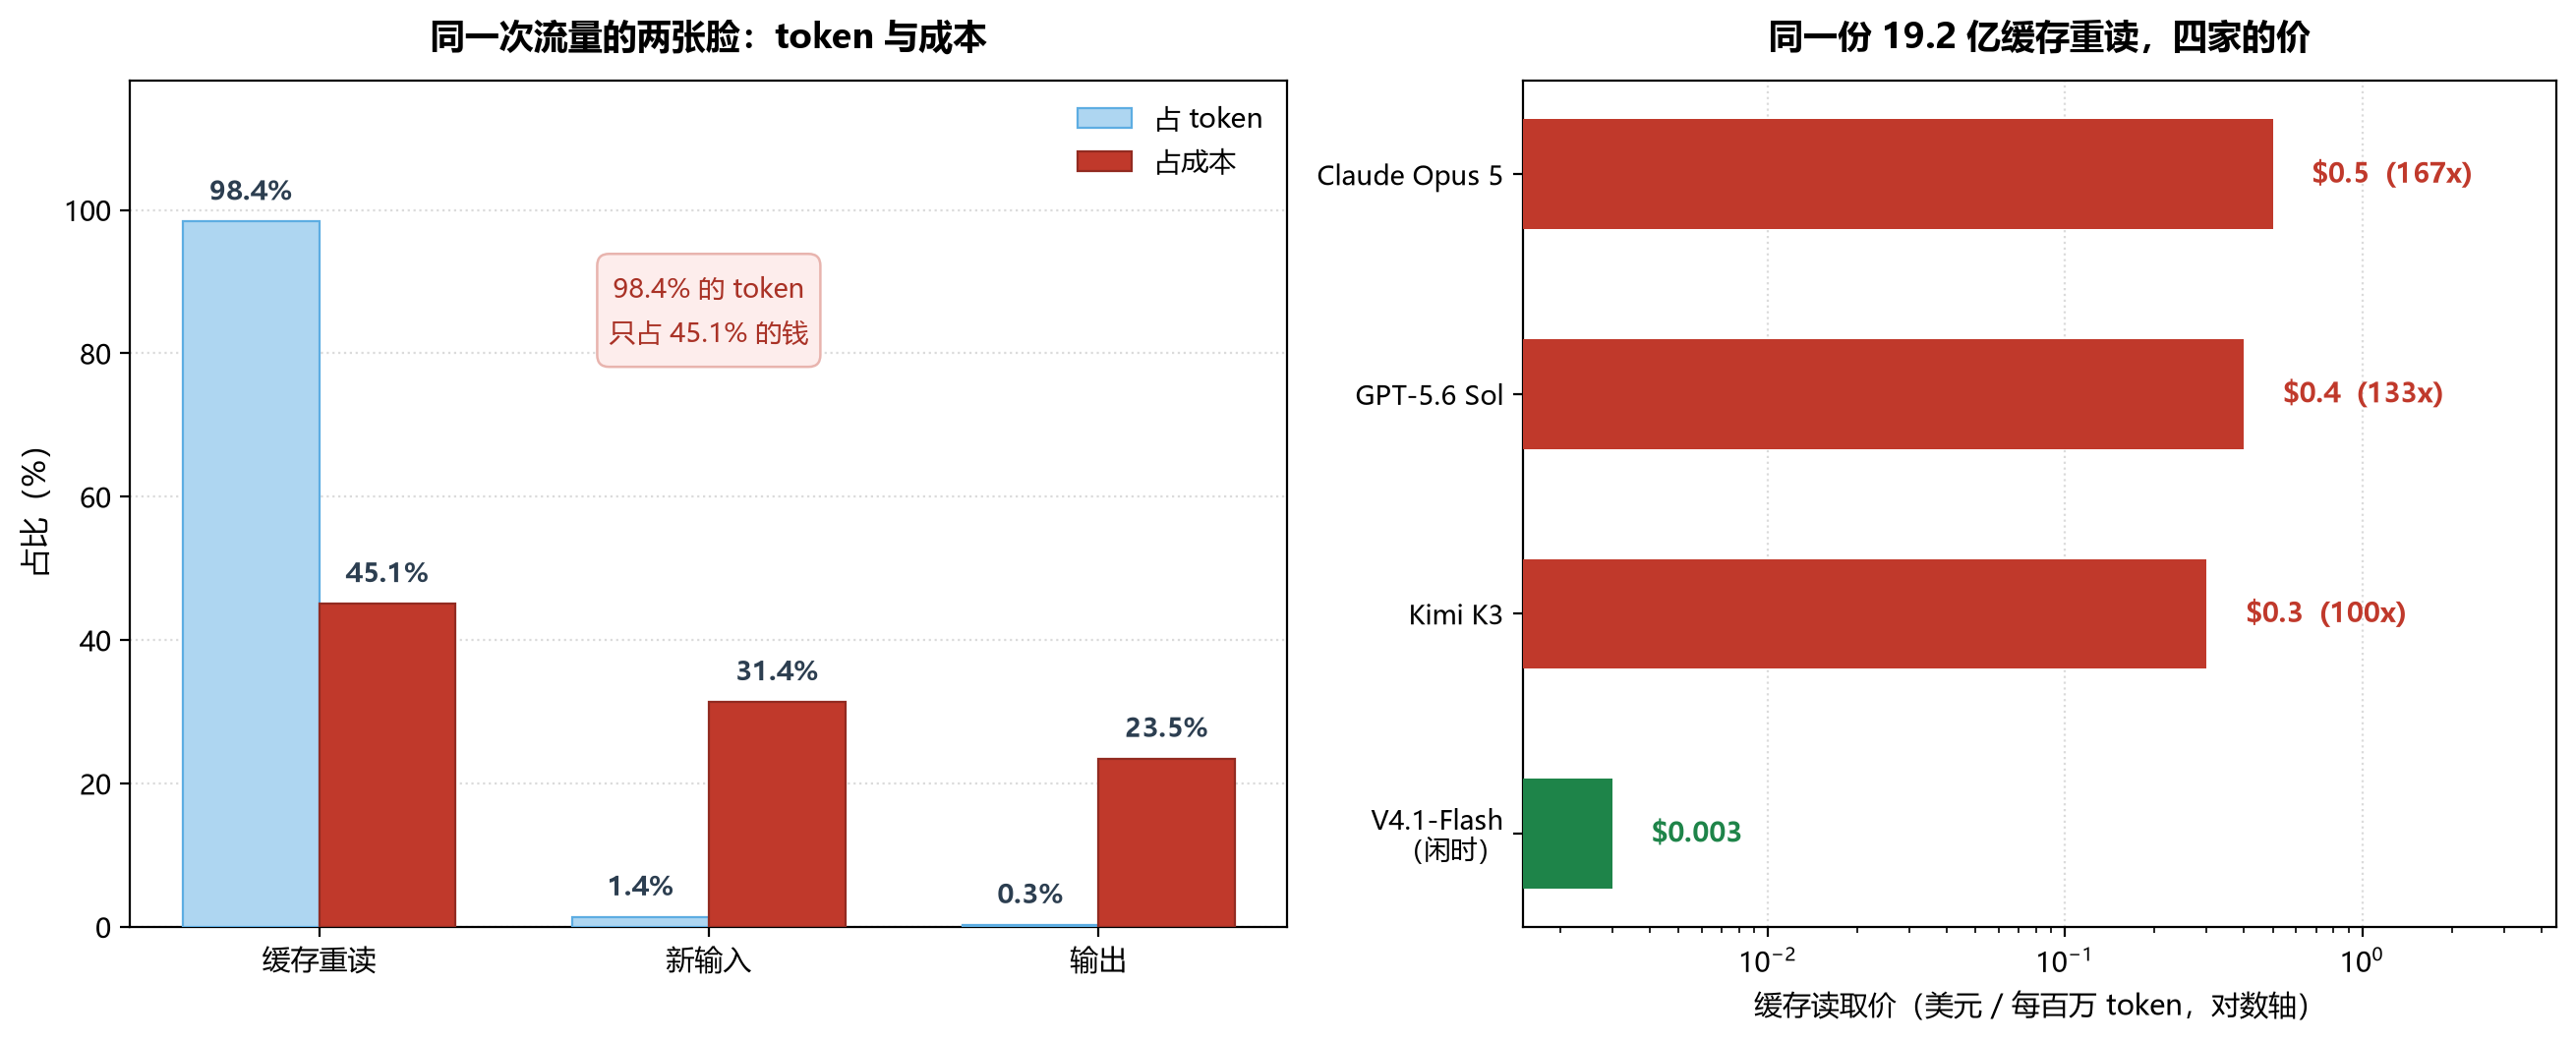 账单的两张脸:token 占比 98.4% 对成本占比 45.1%,以及四家的缓存读取价
本机推算的 $12.77,与第三方公布的 $12.78 吻合到分(口径一致),可作为交叉校验。
那「降 60%」到底值多少?
把同一份流量,分别按两代价格算(人民币,闲时,本机推算):
|
|
金额 |
|
按 V4-Flash 旧价 |
¥158.55 |
|
按 V4.1-Flash 新价 |
¥85.10 |
|
这份账单的实际降幅 |
−46.3% |
对照一下:输出单价只降了 11.1%。
只盯输出单价的人,会把这次降价低估近四倍。 因为在 Agent 场景里,输出本来就不是账单的主体——重读才是。
还有更极端的一组数:如果这 19.2 亿 token 全都按「未命中」计费(相当于根本没有缓存机制),账单是 $295.00,是现价的 23.1 倍。
|
缓存机制本身省下的钱,比这次降价省下的钱多得多。 降价是在一个已经很省钱的地基上再降一点。 |
这也解释了为什么这一节要花这么多篇幅:如果你想省钱,第一个该盯的数不是单价,是缓存命中率。
缓存命中率:最该盯的一个数
本机推算:每月 1 亿输入 + 2000 万输出,全部闲时运行(人民币):
|
缓存命中率 |
输入成本 |
输出成本 |
月合计 |
|
0% |
100.0 |
80.0 |
180.0 |
|
40% |
60.8 |
80.0 |
140.8 |
|
80% |
21.6 |
80.0 |
101.6 |
|
95% |
6.9 |
80.0 |
86.9 |
|
100% |
2.0 |
80.0 |
82.0 |
命中率从 0% 拉到 100%,月成本从 180 元降到 82 元。但注意:输出那块 80 元一动不动。
**在 prompt 里抠字,省的是"未命中"那一块;把前缀稳住、让缓存能命中,省的是整块。前者是省钱,后者是改命。
那具体怎么做?核心只有一句话:把"会重复的部分"变成"稳定的前缀"。 几条能直接落地的:
这五条的共同点:都不需要改模型,只需要改你拼 prompt 的方式。 而它们对账单的影响,比换模型更大。**
4. 890 bytes/token:一条四代曲线
缓存为什么能便宜?因为 DeepSeek 花了四代时间,把模型"记事"的占用压了下去。
KV cache 是什么?一句话:模型每多读一个 token,就要在显存里多记一份"这个 token 是什么意思"的笔记。 上下文越长,笔记越厚。这是长上下文推理的第一大成本。
|
模型 |
全局 KV cache (字节 /token ) |
相对 V4.1-Flash |
比上一代缩小 |
|
DeepSeek-V1 |
389,120 |
437.2x |
— |
|
DeepSeek-V3.2 |
48,068 |
54.0x |
8.10x |
|
DeepSeek-V4-Flash |
3,514 |
3.9x |
13.68x |
|
DeepSeek-V4.1-Flash |
890 |
1.0x |
3.95x |
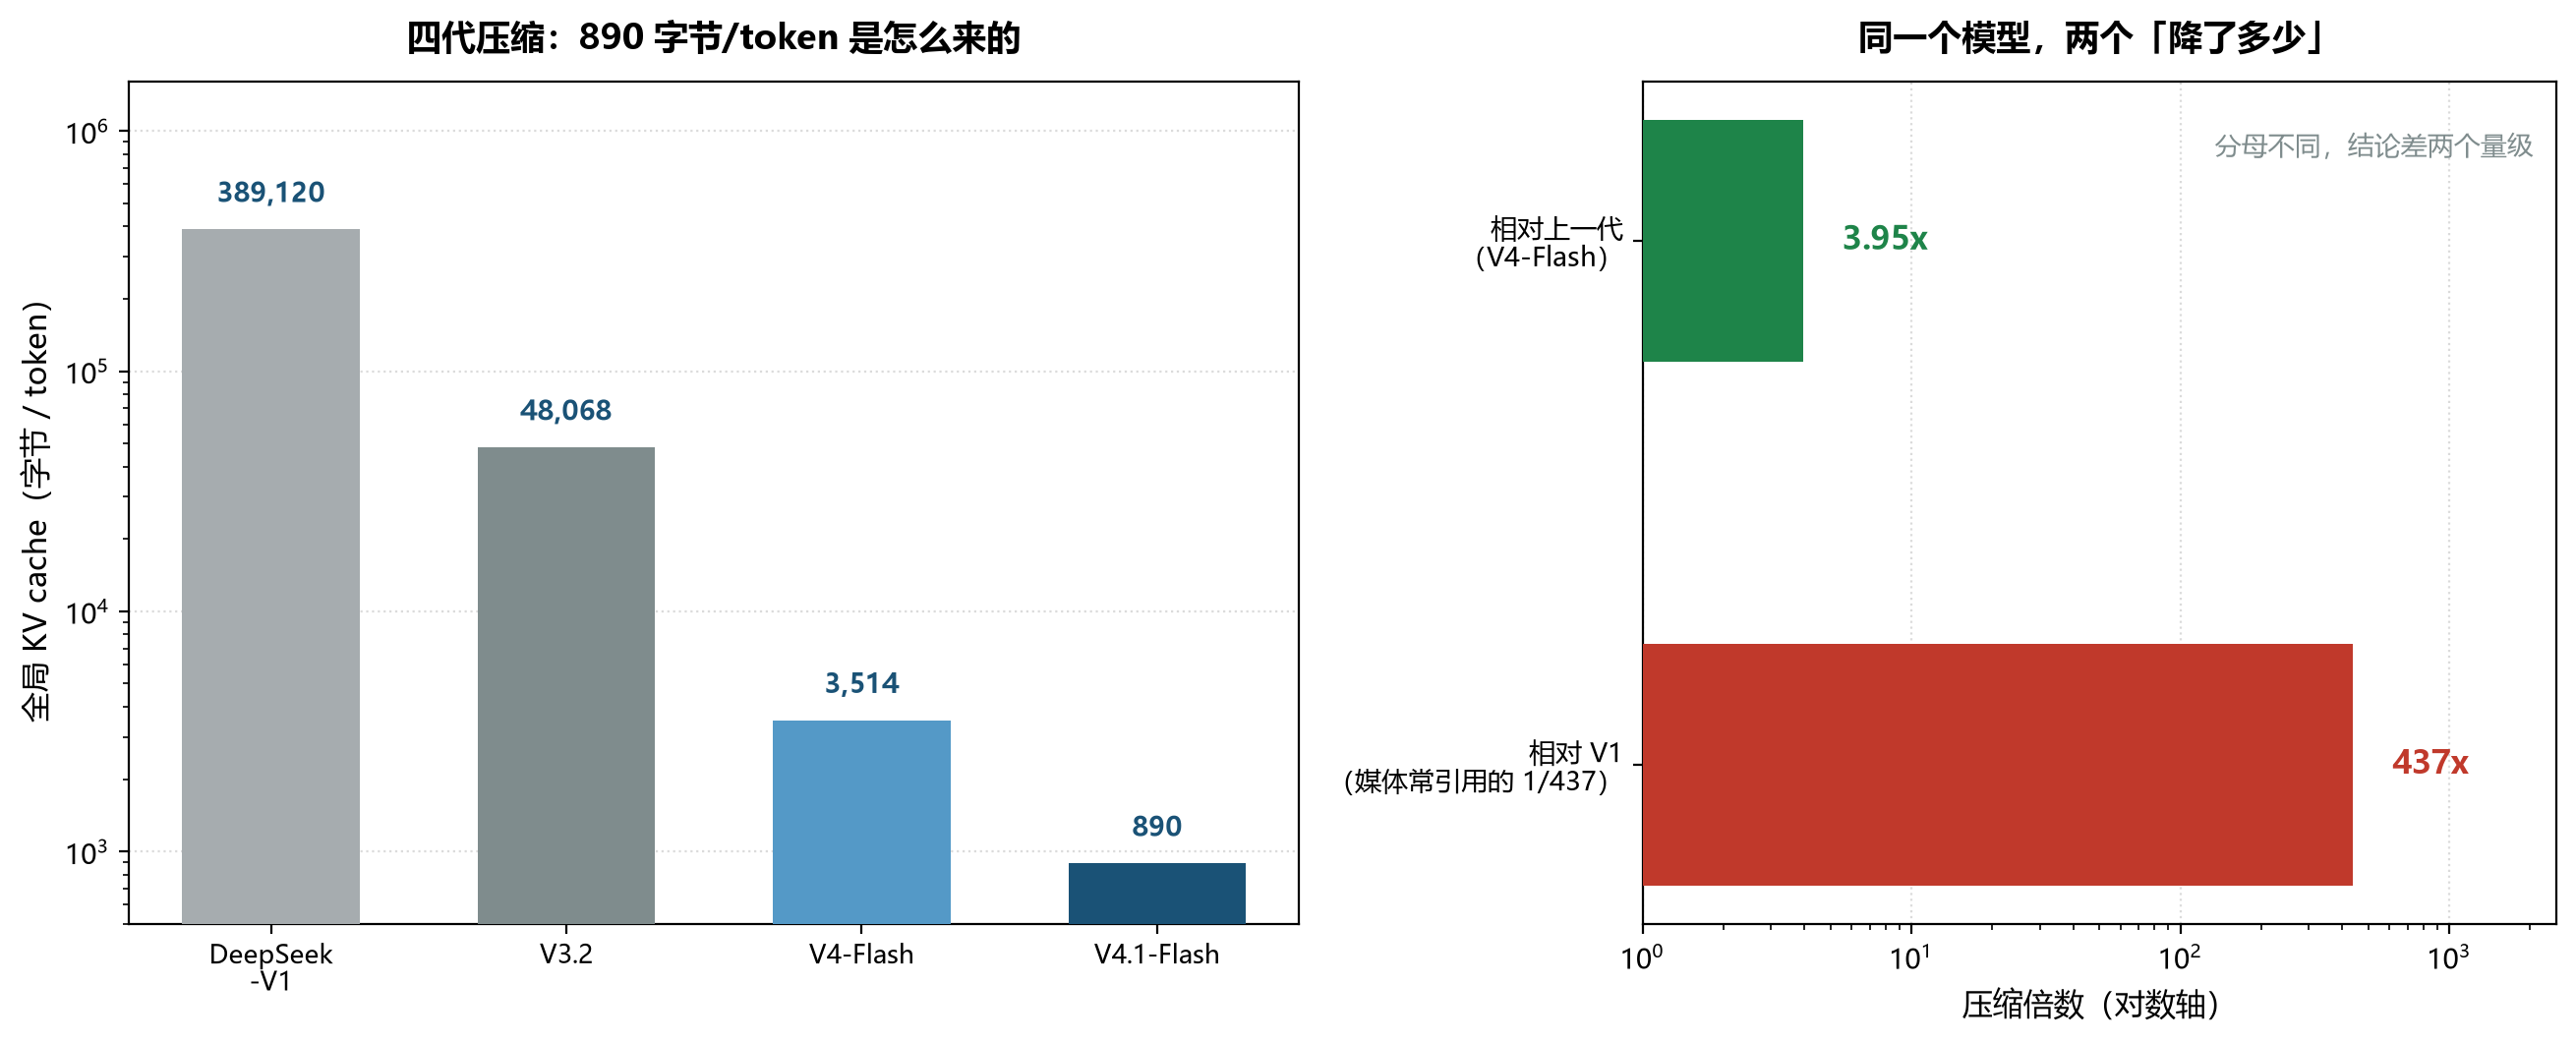 KV cache 四代曲线:890 字节/token,以及两个「降了多少」
注意这里有个口径坑,中文报道里非常普遍。
很多中文资讯写「V4.1-Flash 的 KV Cache 压缩至原来的 1/437」。这个数字是对的,但对照的是四代之前的 DeepSeek-V1——括号里那句"原来的"很容易让人以为说的是上一代。
实际情况是:
- 相对 V1:437 倍 ✅(真实数字)
- 相对 上一代 V4-Flash:只有 3.95 倍
|
1/437 和 1/4,差整整两个量级的语义。前者听起来像"跨时代的革命",后者听起来像"一次正常的迭代"——而两者说的是同一个模型。看到这种数字,第一件事是问一句:分母是谁? |
顺带算个具体的:按 100 万 token 上下文估算全局缓存占用(本机推算):
|
|
1M 上下文的 KV 占用 |
|
V4.1-Flash |
0.87 GB |
|
V4-Flash |
3.43 GB |
0.87 GB 是什么概念? 一张 40GB 级别的卡,扣掉权重和激活之后,还装得下百万 token 的缓存——这在上一代是很难想象的。而这正是「890 bytes/token」这个数字的工程意义:它决定了长上下文能不能跑在便宜硬件上。
5. 架构一:CED 不对称——读用 8B,写用 16B
现在进入架构。第一个,也是最核心的一个。
V4.1-Flash 用的是 Causal Encoder-Decoder(CED,因果编码器-解码器)。40 层 Transformer 被切成两半:
- 20 层编码器(encoder):负责"读"
- 20 层解码器(decoder):负责"写"
关键在于两边激活的参数不一样:
|
示意图 · 文本绘制 |
|
CED 不对称架构: "读" 和 "写" 拆开走不同的层 输入 prompt 输出 generation (输入量是输出的 389 倍) (真正要生成的) | ^ v | +———————+ +———————+ | 20 encoder layers | —> | 20 decoder layers | | active = 8B | | active = 16B | +———————+ +———————+ "读" 只走这一半 "写" 才用这一半 prompt 不经过 decoder 骨架 552B, 但每个 token 只激活其中一小部分 |
那么,这件事省在哪里?
prompt 阶段的 token,根本不经过 decoder。 decoder 的全局 KV 不是一层层算出来的,而是从 encoder 的最终状态投影出来的(每层有自己的投影权重)。这带来两个直接结果:
|
重点提示 |
|
这个设计对应一个很具体的现实:Agent 的输入和输出,量级完全不对等。 前面那组数据里,输入(含重读)1,946M,输出 5M——输入是输出的 389 倍。 一个为聊天设计的模型,输入输出大致相当,对称架构是合理的。但一个为 Agent 设计的模型,如果还让 16B 的参数去处理那 389 倍的重读,就是把钱花在最不需要的地方。 CED 的"不对称",说白了就是:读文件用轻便的阅读器,写报告才叫上主笔。 |
效果:当上下文从 4K 涨到 1M,单 token 的 decode FLOPs 只增加约 1.25 倍(官方技术报告口径)。
换成人话:从读一页纸到读一本书,每写一个字的代价只多 25%。 而上下文长度涨了 250 倍。
6. 架构二:CSA2 的三种注意力模式
第二个手段,解决的是"那 890 字节还能不能再压"。
先说背景:传统注意力里,每一层都自己算一份 KV cache。40 层就是 40 份,层与层之间明明在看同一段文本,却各记各的笔记。
CSA2(Compressed Sparse Attention 2,第二代压缩稀疏注意力) 干的事就是:让层之间可以抄笔记。
它给每一层静态指派三种身份之一:
|
示意图 · 文本绘制 |
|
40 层不再各记一份笔记, 而是层与层之间"抄作业" Full 自己算 KV, 自己选 Top-512 索引 组内的"源头层", 每组只有一个 Reindex 复用上一个 Full 层的 KV, 用自己的 Q 重新打分 不重算主 KV, 只重排索引 Reuse 直接复用最近的 Top-K 索引, 连索引器都跳过 最省, 组内占大多数 ———————————————————- encoder 侧 18 层 ratio 2-in-3 3 组 x 6 层 每组 = 1 Full + 5 Reuse decoder 侧 20 层 ratio 1-in-4 5 组 x 4 层 第 1 组 = 1 Full + 3 Reuse 其余 = 1 Reindex + 3 Reuse 层级稀疏索引器: 候选池最多 16,384 个位置 -> 找索引的代价不再随上下文长度增长 |
读法:40 层里真正"从头算记忆"的只有少数几层,其余都靠复用。这就是 890 bytes/token 里"4 倍压缩"的来源——不是把笔记写得更短,是让更多层共用同一份笔记。
另外还有一个层级稀疏索引器:第一个 Full 层会建一个最多 16,384 个位置(2,048 块 × 8)的候选池,后续 Reindex 层在这个有界集合里打分,而不是在全部上下文里打分。
这让"找相关片段"的代价不再随上下文长度增长。 读 1 万 token 和读 100 万 token,找索引的开销是一样的——这是它能扛住 1M 的另一个前提。
用一个比喻收一下这两节: CED 解决的是"谁来读",CSA2 解决的是"记多少"。前者让便宜的参数去干重读的活,后者让 40 层共享一份笔记而不是各记 40 份。
7. 架构三:FP4 量化与缓存的生命周期
第三个手段,是把每一份笔记本身写得更小,并且管好它的"保质期"。
① FP4 量化。 主 KV cache 用 E2M1 格式存储,每 16 个通道配一个 E4M3 缩放因子(即 NVFP4 方案去掉全局 scale 的做法)。这套量化是在后训练阶段通过量化感知训练引入的,相比 V4 的 FP8 大约再省一半空间。
② SWA Bounded Replay(滑动窗口注意力的有界重放)。 decoder 的滑动窗口状态不重跑全部层,只重放最后 128 个 prompt token 就能重建。
③ 缓存的生命周期管理。 这是最容易被忽略、但对生产部署最关键的一条:
|
缓存类型 |
存放位置 |
生命周期 |
|
全局 KV |
持久缓存 |
保证 ≥ 72 小时 |
|
SWA KV |
从 10% 主机 DRAM 划出的分布式池, 不落 SSD |
分钟级 |
|
这带来一个反常识的结论:真正的瓶颈,已经不是显存,而是"缓存基础设施策略"。 |
想想这意味着什么:一个多租户的长上下文服务,能不能扛住,取决于你怎么设计 72 小时和分钟级这两档的淘汰策略——这更接近一个存储系统问题,不是模型问题。
换个说法: 前两节在压缩"记忆的厚度",这一节在管理"记忆的寿命"。记忆越便宜,就越有资格被留下来;能留下来,才谈得上复用。
8. 三个手段合起来省了多少
把三个架构手段和它们的效果摊在一张表上:
|
手段 |
作用对象 |
官方口径效果 |
|
CED 不对称( 8B 读 / 16B 写) |
计算量 |
prefill 约减半; 4K→1M 单 token decode FLOPs 只涨 1.25x |
|
CSA2 ( Full / Reindex / Reuse ) |
缓存体积 |
层间复用,压缩比 2-in-3 ( encoder ) / 1-in-4 ( decoder ) |
|
FP4 KV 量化 |
缓存体积 |
相比 FP8 约再省一半 |
|
SWA Bounded Replay |
持久化占用 |
SSD / 主机内存占用降至约 1/8 |
|
合计 |
全局 KV cache |
890 bytes/token ≈ 上一代的 1/4 |
注意最后一行和第 4 节那条曲线的关系:
- 「1/4」是这一代架构的贡献(上面这五个手段)
- 「1/437」是四代累积的贡献(回看第 4 节的表)
这两个数字不冲突,它们回答的是不同的问题。 前者回答"这次改了什么",后者回答"这条路走了多远"。写文章时如果只引一个,读者就会得到一张失真的图。
而这一切的终点,就是你看到的那张价格表——缓存命中降到 0.003 美元。 架构上的 890,和账单上的 0.003,是同一件事的两端。
9. 能力账:它赢了哪里,又输在哪里
现在说能力。官方对比表(最大推理努力设置,即 reasoning_effort=100)的几个关键行:
|
基准 |
V4.1-Flash |
V4-Pro 0813 |
GLM-5.3 |
Kimi-K3 |
GPT-5.6 Sol |
Claude Opus 5 |
|
Terminal-Bench 2.1 |
90.6 |
87.9 |
88.2 |
88.3 |
88.8 |
89.1 |
|
DeepSWE v1.1 |
74.2 |
62.7 |
66.9 |
67.5 |
73.0 |
74.0 |
|
CyberGym |
88.1 |
83.3 |
84.5 |
80.0 |
84.5 |
— |
|
Automation-Bench |
54.8 |
43.2 |
48.8 |
46.7 |
45.8 |
50.3 |
|
Codeforces 评分 |
3471 |
3348 |
— |
— |
— |
— |
|
Agents' Last Exam |
31.8 |
25.7 |
28.5 |
27.6 |
26.7 |
28.6 |
|
HLE (带工具) |
63.9 |
60.0 |
62.5 |
59.8 |
— |
63.6 |
赢的地方很集中:Agent 与工程类任务。 Terminal-Bench、DeepSWE、CyberGym、Automation-Bench、Codeforces——它基本都拿了这张表的第一。
但输的地方,官方一点没藏:
|
基准 |
V4.1-Flash |
V4-Pro 0813 |
Claude Opus 5 |
|
GPQA Diamond |
90.9 |
92.4 |
93.4 |
|
HLE (不用工具) |
36.8 |
42.7 |
56.3 |
|
Terminal-Bench 3.0 |
30.0 |
11.8 |
43.3 |
|
Terminal-Bench 4.0 |
31.2 |
12.4 |
51.8 |
|
这张表说清了一件很重要的事:它赢的是"开卷",不是"闭卷"。 |
怎么理解?带工具的 HLE 是 63.9,不带工具只有 36.8。 同一个模型,同一个基准,差别只在于"能不能查资料"。
它是一个非常会"用工具办事"的模型,不是一个新的"推理之王"。 如果你要拿它做闭卷知识推理、硬核理论推导,它的表现会低于你的预期——尤其在 Terminal-Bench 3.0 / 4.0 这两个更新、更难的版本上,和 Opus 5 的差距是 13 到 20 分,这不是小差距,是断层。
关于「赢 12/14 行」这个说法也要说清楚:两边都有分数的 14 行里它赢 12 行,不是"19 项测评里赢 14 项"。分母不同,结论就不同——这又是一次口径检查。
10. 口径警告:同一个模型,换个外壳差 8.7 分
这一节是本系列的老朋友,但在 V4.1-Flash 上又出现了一次,而且更明显。
官方公布了同一个模型在八种不同 Agent 外壳(scaffold)下的评分:
|
基准 |
最好 |
最差 |
差距 |
|
DeepSWE v1.1 |
74.2 ( mini-SWE ) |
65.5 ( OpenCode ) |
8.7 分 |
|
Terminal-Bench 2.1 |
90.6 ( Minimal ) |
84.1 ( Codex ) |
6.5 分 |
同一个模型、同一份权重、同一个基准,只因为外面套的壳不一样,分数差了 8.7 分——比它和 Opus 5 在 DeepSWE 上的差距(0.2 分)大 40 多倍。
|
重点提示 |
|
这意味着:你看到的每一个 Agent 基准分数,都是"模型 × 外壳"的联合成绩,不是模型的成绩。 当你看到"A 模型 74.2 分,超过 B 模型的 74.0 分",请立刻问:它俩用的是同一个外壳吗? 如果 A 用的是 mini-SWE、B 用的是 Codex,那这个 0.2 分的"领先"完全可能是外壳带来的,跟模型无关。 |
而且要注意官方评测的默认设置:代码类 Agent 基准跑在 DeepSeek Harness 的 Minimal 模式 + 1M 上下文窗口下。**换掉这个前提,表里的数字就不成立。
所以看任何一篇 Agent 评测,先问三个问题:
|
该问的 |
为什么问 |
|
用的哪个外壳? |
同一个模型换外壳能差 8.7 分 |
|
上下文窗口设了多大? |
官方用 1M ;你的场景可能只有 128K |
|
effort 设了多少? |
25 和 100 差 8.2 分,成本还差 2.5 倍 |
三个里有一个没写清,这个分数就不能跨文章比较。**
11. reasoning effort:从 25 拉到 100,买到什么
V4.1-Flash 支持连续可控的推理努力:一个 1 到 100 的整数(官方给了 low / high / max 三档映射,对应 50 / 75 / 100)。这是这次发布里对成本影响最直接的一个旋钮。
官方给了一组很干净的对照:
|
基准 |
effort=25 |
effort=100 |
涨分 |
涨幅 |
|
DeepSWE v1.1 |
66.0 |
74.2 |
+8.2 |
12.4% |
|
Terminal-Bench 2.1 |
82.4 |
90.6 |
+8.2 |
10.0% |
代价是:输出 token 约 2.5 倍。(官方口径)
本机推算:按闲时输出价 4.0 元/百万 token,单位任务的输出成本从 4.0 元涨到 10.0 元。
花 2.5 倍的钱,买 8.2 个点。
这个交换划不划算,取决于任务:
- 值得:错的代价高、需要多步推理、答案有明确对错(写代码、跑终端命令、做题)
- 不值得:任务本身很简单,只是量大(分类、抽取、格式化、简单问答)
正确用法是"分档",不是"全局拉满"。 把 effort 当成一个按任务分级的旋钮——简单任务用低档跑量,难任务才拉满。这一句话能省下的钱,通常比换模型更多。
12. 三条诚实边界
前面讲了它的好。这一节讲三个必须知道的坏。
边界一:开源 ≠ 能跑
V4.1-Flash 权重以 MIT 许可开源,Hugging Face 上有完整 MoE 权重和技术报告。但「开源」和「你能跑」是两件事。
社区在发布后 30 小时内在 Hugging Face 上出现了 44 个仓库,它们的模型卡写清了本地现实:
|
量化版本 |
体积 |
目标机器 |
速度 |
|
4-bit ( Apple silicon ) |
427.6 GB |
512 GB 机器 |
~14 tok/s |
|
4-bit (另一版) |
463 GB |
512 GB 机器 |
~14 tok/s |
|
2-bit |
238.8 GB |
256 GB Mac Studio |
~9.5 tok/s |
而且那个能塞进 256GB 机器的 2-bit 版本,作者自己写了警告:「重复、不连贯和任务失败仍可能出现。」 还有一个 4-bit 版本的模型卡直接说明:这个架构「在任何运行时里都不存在」——transformers、mlx-lm、mlx-vlm 都不支持,它自带了一份移植。
没有任何公开构建能装进 128GB 或消费级 GPU。
所以关于"开源自部署",务实的态度是:
- 想用它 → 走 API。 这是绝大多数人的正确答案。
- 想自部署 → 先算机器。 510 GB 级别是起点,不是终点。
- 看到"MIT 开源"就以为免费 → 会被硬件成本教育。
边界二:官方自己承认的退化风险
这一条很少被报道,但它写在官方材料里,值得单独拿出来。
DeepSeek 明确说明,新架构引入了尚未充分测试的鲁棒性边界:
- 稀疏选择误差:挑相关片段时可能挑错
- 近似状态重建:缓存复用是"抄笔记",抄的过程有近似
这两件事在两个具体场景下可能导致能力退化:
官方表示计划做额外压力测试。
这条要这么用: 如果你的场景正好卡在这两处——比如"百万 token 上下文里做精确检索",或者"跨会话反复复用长缓存"——上线前必须自己压测,不能假设它和短上下文一样稳。 官方没测的地方,就是风险最集中的地方。
边界三:它的定位是"做事",不是"想事"
第 9 节已经用数据说过了,这里只做个收口:
|
它擅长 |
它不擅长 |
|
开卷(带工具)任务 |
闭卷推理 |
|
多步工程流程 |
硬核理论推导 |
|
长上下文 + 大量重读 |
单次超长生成 |
|
成本敏感的大批量调用 |
需要 " 最强单点智力 " 的场景 |
选模型不是选"谁最强",是选"谁最不浪费"。 一个开卷考试冠军去考闭卷,是资源错配;反过来也一样。
13. 六条使用规则
把前面所有内容压成六条能直接照着做的规则:
|
示意图 · 文本绘制 |
|
六条规则, 按"杠杆从大到小"排 #1 先算缓存命中率, 再谈单价 命中率 0% -> 100%, 月账差 2.2 倍 #2 能等的任务排到闲时时段 一周只有 35 / 168 小时是高峰 #3 effort 按任务分档, 不要全局拉满 拉满 = 2.5 倍输出 token #4 长上下文要看"缓存寿命" 全局 KV 保证 72h, SWA 只有分钟级 #5 看 Agent 分数, 先问用的哪个外壳 同一个模型换壳能差 8.7 分 #6 引数字先问分母 "1/437" 是对 V1, "1/4" 才是对上一代 |
展开说:
① 先算缓存命中率,再谈单价。 命中率从 0% 到 100%,月账单能差 2.2 倍(第 3 节)。把 System Prompt、项目说明、工具定义、长期上下文固定成稳定前缀,是最高杠杆的动作。
② 能等就排到闲时。 闲时价是高峰的一半。一周只有 35 小时是高峰。离线批处理、日志分析、批量生成这类任务全部排到闲时,直接五折。
③ effort 按任务分档,不要全局拉满。 拉满 = 2.5 倍输出 token。简单任务用低档,难任务才拉满。
④ 长上下文要看清"记忆的寿命"。 全局 KV 保证 72 小时,SWA 只有分钟级。跨会话复用长缓存的设计必须考虑这个边界,否则会出现"上午很快、下午变慢"的诡异现象。
⑤ 看 Agent 基准分数,先问外壳。 同一个模型换外壳差 8.7 分(第 10 节)。只比自己用同一外壳跑出来的数,别跨文章比。
⑥ 别用「1/437」下判断,用「1/4」。 引数字先问分母(第 4 节)。这个习惯不只能用在缓存上。
14. 常见问题
Q1:它和 V4-Pro 到底什么关系?V4-Pro 还能用吗?
官方口径:自 2026 年 9 月 14 日 04:00 UTC 起,所有 deepseek-v4-pro 请求路由到 V4.1-Flash,并按 Flash 的价格计费,直到 V4.1-Pro 发布。所以如果你的代码里硬编码了 deepseek-v4-pro,它不会报错,但模型和行为都变了——这类"静默替换"是上线前最容易漏掉的风险。
建议:现在就用同一套流程分别跑 deepseek-flash 和 deepseek-v4-pro,固定上下文、工具、审批与成功标准,只换模型,然后对比完成率、重试率、命中率、输出 token 和墙上时间。
Q2:旧模型名还能用吗?
能。deepseek-v4-flash 和 deepseek-v4-flash-vision-exp 仍然接受,但实际由 V4.1-Flash 服务,按 Flash 价计费。名字还在,模型不是那个了。
Q3:多模态要不要单独调用另一个模型?
不用。视觉理解已经做进模型内部,deepseek-v4-flash-vision-exp 已经退役。一个端点同时处理文本和图片。视觉基准(基础模型口径):DocVQA 95.6、RefCOCO-avg 86.0。
Q4:输出长度上限是多少?
官方定价页写最大输出 384K,上下文 1M(精确值 1,048,576,可在模型 config.json 里核对)。但注意:第三方推理平台通常有更小的上限(例如 16,384),这是平台限制不是模型限制。要长输出,先确认你走的是哪条路。
Q5:并发够用吗?
官方并发上限 2,500(V4-Pro 是 500)。从 Pro 迁过来的人会拿到更高的限额。
Q6:现在入手合适吗,还是等 V4.1-Pro?
两个考虑:
- 价格:现在处于"Pro 路由到 Flash"的窗口期,用 Flash 的价拿 Flash 的能力。
- 变动:V4.1-Pro 发布后,Pro 的路由会变回去,届时价格体系可能再调。
务实做法:如果现在就有成本敏感的大批量任务,现在就可以上;但要把模型版本记进日志,并在 V4.1-Pro 发布后重跑一次回归。
15. 数据时效与参考资料
时效声明:本文写于 2026 年 9 月 30 日,距 V4.1-Flash 发布(9 月 10 日)20 天。以下内容变动风险较高,引用前请核对官方来源:
|
易变项 |
当前值 |
说明 |
|
API 价格 |
见表 |
官方价格页明确保留调价权 |
|
V4-Pro 路由 |
9/14 起路由至 Flash |
直到 V4.1-Pro 发布,届时会变 |
|
并发上限 |
2,500 |
可能随容量调整 |
|
第三方平台价格 |
各家不同 |
见下,仅作参考 |
官方一手来源
- DeepSeek 官方新闻页:https://www.deepseek.com/en/news/deepseek-v4-1-flash(发布日 2026-09-10)
- DeepSeek 官方定价页:https://api-docs.deepseek.com/quick_start/pricing
- 模型权重与技术报告:Hugging Face deepseek-ai/DeepSeek-V4.1-Flash
三方口径来源(仅供参考,会变)
- 独立评测:Neowin 完整基准表、Artificial Analysis(190 tok/s、Index 40)
- 推理平台定价:DeepInfra(Standard $0.20 输入 / $0.60 输出 / $0.006 缓存读取,另有 Priority 1.5x 与 Flex 0.8x 两档)
- 真实 Agent 流量观测:第三方 30 天流量样本(26.7M 新输入 / 5.0M 输出 / 19.2 亿缓存重读)
- 竞品缓存读取价:GPT-5.6 Sol $0.40、Claude Opus 5 $0.50、Kimi K3 $0.30(各自公开定价)
口径对照速查
|
说法 |
正确理解 |
|
「缓存占账单 98.6% 」 |
是 token 占比 ;成本占比是 45.1% |
|
「 KV cache 降到 1/437 」 |
是相对 V1 ;相对上一代是 1/4 |
|
「 19 项测评赢 14 项」 |
官方完整表 19 行; 两边都有分的 14 行里赢 12 行 |
|
「开源可自部署」 |
权重 MIT 开源; 最小可用构建约 239 GB ,且 2-bit 版有质量警告 |
16. 附录:本机实验台
本文所有标注「本机推算」的数字,都由下面这个脚本产出。它只用 Python 标准库,不需要任何第三方包,把价格常量改掉就能复算你自己的场景:
|
Python |
|
# -*- coding: utf-8 -*- """DeepSeek V4.1-Flash 账单实验台 —— 纯标准库, 零依赖""" M = 1_000_000.0 # 注:输出里的 Y 代表人民币符号(避开部分终端的编码问题) # 官方价格(美元 / 每百万 token):(缓存命中, 缓存未命中, 输出) USD_OFF = (0.003, 0.15, 0.60) # V4.1-Flash 闲时 USD_PEAK = (0.006, 0.30, 1.20) # V4.1-Flash 高峰 # 人民币 / 每百万 token(闲时) CNY_OFF = (0.02, 1.0, 4.0) CNY_V4F = (0.05, 1.5, 4.5) # 上一代 V4-Flash 旧价 # —- 一次真实 agent 流量的 30 天结构(第三方口径)—- FRESH_IN = 26.7 * M # 新输入 token OUT_TOK = 5.0 * M # 输出 token CACHE_IN = 1_920.0 * M # 缓存重读 token print("=== 一、token 结构 ===") total = FRESH_IN + OUT_TOK + CACHE_IN print(f"缓存重读 / 全部 token = {CACHE_IN/total*100:.1f}%") print(f"缓存重读 / 输入 token = {CACHE_IN/(FRESH_IN+CACHE_IN)*100:.1f}% <- 98.6% 口径") print() print("=== 二、成本结构(V4.1-Flash 闲时)===") c_cache = CACHE_IN / M * USD_OFF[0] c_fresh = FRESH_IN / M * USD_OFF[1] c_out = OUT_TOK / M * USD_OFF[2] c_tot = c_cache + c_fresh + c_out for name, v in (("缓存重读", c_cache), ("新输入", c_fresh), ("输出", c_out)): print(f" {name} | ${v:6.2f} | {v/c_tot*100:5.1f}%") print(f" 合计 | ${c_tot:6.2f} | 100.0%") print() print("=== 三、若完全没有缓存机制(全按未命中)===") nocache = CACHE_IN / M * USD_OFF[1] + c_fresh + c_out print(f"${nocache:.2f} = 现价的 {nocache/c_tot:.1f} 倍") print() print("=== 四、同一份流量, 两代价格(人民币)===") old = sum(x/M*y for x, y in zip((CACHE_IN, FRESH_IN, OUT_TOK), CNY_V4F)) new = sum(x/M*y for x, y in zip((CACHE_IN, FRESH_IN, OUT_TOK), CNY_OFF)) print(f" V4-Flash 旧价 | Y{old:8.2f}") print(f" V4.1-Flash 新价 | Y{new:8.2f}") print(f"账单降幅 {(new/old-1)*100:6.1f}% (对照: 输出单价降 " f"{(CNY_OFF[2]/CNY_V4F[2]-1)*100:.1f}%)") print() print("=== 五、缓存命中率扫描(月 100M 输入 + 20M 输出, 闲时)===") IN_M, OUT_M = 100.0, 20.0 for hit in (0, 40, 80, 95, 100): r = hit / 100 cin = IN_M*r*CNY_OFF[0] + IN_M*(1-r)*CNY_OFF[1] cout = OUT_M*CNY_OFF[2] print(f" 命中率 {hit:3d}% | 输入 Y{cin:7.1f} | 输出 Y{cout:5.1f} | 合计 Y{cin+cout:7.1f}") print() print("=== 六、KV cache 历史曲线(字节/token)===") for name, b in (("V1", 389_120), ("V3.2", 48_068), ("V4-Flash", 3_514), ("V4.1-Flash", 890)): print(f" {name:<11} {b:>9,} | 相对 V4.1 = {b/890:6.1f}x") print(f"V1 -> V4.1 : {389_120/890:.0f}x (媒体常引用的 1/437)") print(f"上一代 -> 新: {3_514/890:.2f}x (相对上一代其实只有这一档)") print(f"1M 上下文全局缓存: {890*1_048_576/1024**3:.2f} GB") |
本机实跑输出(完整):
|
运行结果 |
|
=== 一、token 结构 === 缓存重读 / 全部 token = 98.4% 缓存重读 / 输入 token = 98.6% <- 98.6% 口径 === 二、成本结构(V4.1-Flash 闲时)=== 缓存重读 | $ 5.76 | 45.1% 新输入 | $ 4.00 | 31.4% 输出 | $ 3.00 | 23.5% 合计 | $ 12.77 | 100.0% === 三、若完全没有缓存机制(全按未命中)=== $295.00 = 现价的 23.1 倍 === 四、同一份流量, 两代价格(人民币)=== V4-Flash 旧价 | Y 158.55 V4.1-Flash 新价 | Y 85.10 账单降幅 -46.3% (对照: 输出单价降 -11.1%) === 五、缓存命中率扫描(月 100M 输入 + 20M 输出, 闲时)=== 命中率 0% | 输入 Y 100.0 | 输出 Y 80.0 | 合计 Y 180.0 命中率 40% | 输入 Y 60.8 | 输出 Y 80.0 | 合计 Y 140.8 命中率 80% | 输入 Y 21.6 | 输出 Y 80.0 | 合计 Y 101.6 命中率 95% | 输入 Y 6.9 | 输出 Y 80.0 | 合计 Y 86.9 命中率 100% | 输入 Y 2.0 | 输出 Y 80.0 | 合计 Y 82.0 === 六、KV cache 历史曲线(字节/token)=== V1 389,120 | 相对 V4.1 = 437.2x V3.2 48,068 | 相对 V4.1 = 54.0x V4-Flash 3,514 | 相对 V4.1 = 3.9x V4.1-Flash 890 | 相对 V4.1 = 1.0x V1 -> V4.1 : 437x (媒体常引用的 1/437) 上一代 -> 新: 3.95x (相对上一代其实只有这一档) 1M 上下文全局缓存: 0.87 GB |
最后说一句为什么要把脚本贴出来。 本文所有关键结论——「降 46% 不是 11%」「98.6% 是 token 不是钱」「缓存省下 23 倍」——都可以被上面这段代码推翻或证实。 价格表是公开的,算式是简单的,你不需要相信作者的判断,只需要把常量换成你的用量跑一遍。
一个模型值不值得用,最终不是看它的参数,是看它在你的账单结构里,落在哪一行。


评论前必须登录!
注册