 网硕互联帮助中心
第一卷:大模型 基础篇
第3章 模型能力认知
第8节:Agent为什么需要Memory?——没有记忆的AI,为什么很难真正完成长期任务?
《Agent开发工程师成长指南》系列教程
引言
前面我们已经学习了:
LLM
↓
Reasoning
↓
Planning
↓
Tool Calling
↓
Observation
↓
Agent Loop
现在,一个新的问题出现了。
假设你正在使用一个企业AI助手。
第一天,你告诉它:
我们公司的核心产品是 Apollo MES。
第二天,你继续问:
Apollo最近的客户投诉主要集中在哪些问题?
如果Agent回答:
请问Apollo是什么?
你会发现一个非常明显的问题:
这个AI虽然能够推理、规划、调用工具,但它似乎没有“记忆”。
实际上,这正是很多Agent系统从Demo走向真实应用时必须解决的问题。
因为:
LLM
≠
天然拥有长期记忆
Context
≠
真正的Memory
本节我们就来深入理解:
Agent为什么需要Memory?
Memory和Context有什么区别?
Short-Term Memory和Long-Term Memory是什么?
Agent如何记住用户?
企业级Agent又该如何构建Memory系统?
一、核心概念:Memory到底是什么?
很多初学者会认为:
把之前的聊天记录全部放回Prompt,不就是Memory吗?
这个理解并不完全正确。
先看一个简单流程:
用户第一次提问
“我们公司的项目名称叫Apollo”
↓
LLM生成回答
如果下一次用户继续说:
“帮我分析Apollo最近的订单”
系统想让模型理解Apollo,就必须把之前的信息重新提供给模型:
历史信息
+
当前问题
↓
Context
↓
LLM
因此,LLM本身并不会自动永久保存:
Apollo
=
某个企业项目
真正的情况是:
系统在下一次调用模型时,又把相关信息重新放进了Context。
所以更准确地说:
Memory
=
信息存储
+
信息管理
+
Memory Retrieval
+
Context Construction

Memory不是简单的:
保存所有历史聊天记录
而应该是:
Information
↓
Store
↓
Organize
↓
Retrieve
↓
Select Relevant Memory
↓
Context
↓
LLM / Agent
二、Context不是Memory
这是Agent开发中非常重要的一个认知。
我们可以简单理解:
| 当前模型可见的信息 | Agent长期管理的信息 |
| 生命周期较短 | 可以长期保存 |
| 直接进入LLM | 需要检索后决定是否进入LLM |
| 受到Context Window限制 | 可以远大于Context Window |
| 主要用于当前推理 | 用于跨任务、跨时间的信息复用 |
例如:
Context:
当前用户问题
+
System Prompt
+
最近聊天记录
+
RAG检索结果
+
Tool Result
而Memory可能是:
用户信息
+
历史任务
+
过去经验
+
业务规则
+
长期偏好
+
重要事件
因此可以理解为:
Memory
↓
Memory Retrieval
↓
Relevant Memory
↓
Context
↓
LLM
也就是说:
Memory通常不是直接等于Context,而是Context的重要来源之一。
三、为什么Agent不能把所有历史记录都塞进Context?
最简单的方案似乎是:
所有聊天记录
+
所有任务历史
+
所有Tool Result
↓
全部放进Prompt
但是很快就会出现问题。
问题一:Context越来越长
例如:
Day 1
1000 Tokens
Day 10
10000 Tokens
Day 100
100000 Tokens
最终可能导致:
Context Too Large
或者:
Cost ↑
Latency ↑
Information Noise ↑
问题二:大量信息根本不相关
例如用户现在问:
帮我查询上海地区的销售额。
Agent并不需要知道:
三个月前:
用户让AI写过一封邮件
两个月前:
用户修改过一个PPT
一个月前:
用户查询过员工考勤
如果全部放进去:
大量历史信息
↓
Context Noise
↓
Attention Competition
↓
Decision Quality ↓
因此Memory系统必须具备一个核心能力:
Remember Everything
≠
Put Everything Into Context
真正应该做的是:
Store More
↓
Retrieve Less
↓
Inject Relevant Information
四、Agent Memory的主要类型
一个完整的Agent Memory系统,通常可以分成多个层次。
Context
↓
Short-Term Memory
↓
Long-Term Memory
↓
User Memory
↓
Semantic Memory
↓
Episodic Memory
↓
Memory Retrieval
↓
Agent Memory Architecture
【正文配图P01|Agent Memory能力层级】
下面分别来看。
1. Short-Term Memory
短期记忆主要负责:
当前任务过程中暂时需要的信息。
例如:
用户:
查询上海地区销售额
↓
Agent:
调用Sales API
↓
获得结果:
2026-08销售额 1200万
↓
继续下一步分析
这里的:
上海
2026-08
1200万
都可能属于当前任务的短期状态。
可以理解为:
Current Task State
例如:
{
"region": "SH",
"month": "2026-08",
"sales": 12000000
}
任务完成之后,这些信息不一定需要永久保存。
2. Long-Term Memory
长期记忆保存跨任务、跨时间仍然有价值的信息。
例如:
公司名称:ABC Technology
核心产品:
Apollo MES
主要市场:
中国
韩国
越南
默认货币:
USD
这些信息可能在未来很多任务中重复使用。
因此:
Long-Term Memory
=
长期有效的信息
3. User Memory
用户记忆主要记录:
用户偏好
+
用户习惯
+
用户角色
+
长期需求
例如:
用户:
技术负责人
偏好:
希望回答更加详细
常用技术:
Java
Spring Boot
Vue
工作领域:
企业数字化
以后用户再问:
帮我设计一个Agent架构。
Agent就可以结合这些信息。
例如:
User Query
+
User Memory
↓
Context
↓
LLM
最终可能自动生成:
Java
+
Spring Boot
+
Vue
+
Python Agent Service
而不是每次重新询问:
你使用什么技术栈?
4. Semantic Memory
Semantic Memory可以理解为:
Agent积累的事实和知识。
例如:
Apollo MES
=
企业制造执行系统
或者:
客户A
=
韩国地区客户
它更接近:
Facts
Knowledge
Business Rules
例如:
Company Policy:
订单金额 > 100万
必须进行人工审批
这种信息可能被长期保存,并在后续任务中持续使用。
5. Episodic Memory
Episodic Memory可以理解为:
Agent对过去发生事件的记忆。
例如:
2026-08-01
用户要求:
检查上海工厂生产异常
Agent执行:
Query MES
↓
发现设备A异常
↓
创建Maintenance Ticket
↓
任务完成
这就是一次完整的:
Episode
以后用户问:
上次上海工厂那个异常最后处理了吗?
Agent可以检索:
Historical Episode
↓
Find Relevant Task
↓
Recover Previous Action
这比单纯保存聊天记录更有价值。
五、Memory Retrieval:真正的关键不是“记住”,而是“找回来”
一个Agent可能存储了:
1000条Memory
但用户当前只问:
Apollo项目现在进展怎么样?
Agent真正需要的是:
1000 Memories
↓
Memory Retrieval
↓
Apollo Related
↓
Top Relevant Memories
↓
Context
↓
LLM
因此,Memory系统的核心问题不是:
能不能存更多?
而是:
能不能在正确的时间,找到正确的信息?
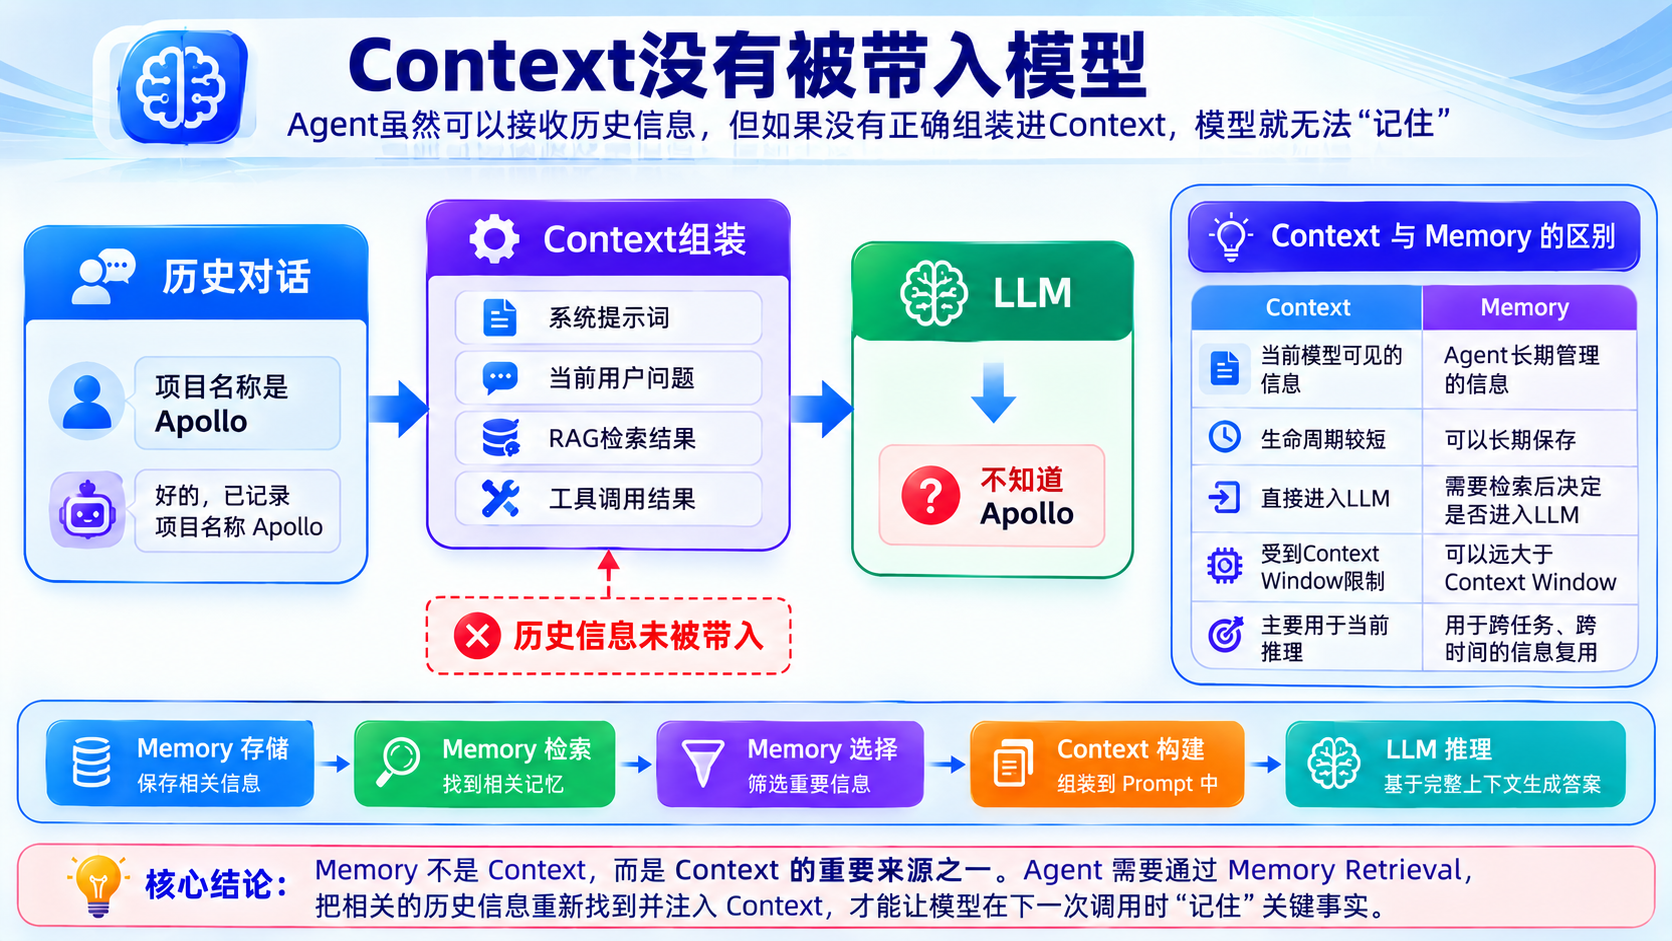
一个典型流程可能是:
User Query
↓
Query Understanding
↓
Memory Retrieval
↓
Relevant Memory
↓
Ranking
↓
Memory Selection
↓
Context Construction
↓
LLM
这里其实和RAG非常相似。
例如:
RAG
Query
↓
Vector Search
↓
Document
↓
Context
而Memory:
Query
↓
Memory Retrieval
↓
Relevant Memory
↓
Context
两者的区别在于:
RAG
主要解决:
外部知识
Memory
主要解决:
历史经验
用户信息
任务状态
长期上下文
六、Memory、State、RAG到底有什么区别?
这是Agent开发中非常容易混淆的三个概念。
我们可以这样理解。
State
负责:
当前任务进行到哪里
例如:
Task ID:123
Current Step:
3
Region:
Shanghai
Sales:
1200万
State通常强调:
Current
Memory
负责:
过去发生过什么
未来可能继续使用什么
例如:
User Preference
Historical Task
Past Experience
Business Fact
Memory通常强调:
Remember
RAG
负责:
企业外部知识
例如:
PDF
Word
Wiki
Manual
Knowledge Base
RAG通常强调:
Retrieve Knowledge
因此:
State
=
现在
Memory
=
过去
RAG
=
外部知识
当然,实际系统中三者可能存在交叉。
完整Agent可能是:
User Request
↓
Agent
↓
┌───────┼────────┐
↓ ↓ ↓
State Memory RAG
↓ ↓ ↓
Current History Knowledge
↓
Context Builder
↓
LLM
【正文配图P03|State、Memory与RAG协同模型】
七、Memory如何影响Agent的行为?
假设一个没有Memory的Agent:
User:
帮我分析客户A
Agent:
请问客户A是谁?
用户回答:
客户A是韩国市场最大的客户。
下一次:
User:
客户A最近有什么风险?
如果Agent又问:
客户A是谁?
那么用户体验会非常差。
但是加入Memory之后:
User
↓
客户A最近有什么风险?
↓
Memory Retrieval
↓
客户A
=
韩国最大客户
↓
RAG
↓
客户风险数据
↓
Context
↓
Agent
最终Agent可以直接进入任务:
Query Customer
↓
Query Orders
↓
Query Complaints
↓
Risk Analysis
↓
Final Answer
这意味着:
Memory可以减少重复信息收集,让Agent具备连续工作的能力。
八、Memory不是越多越好
很多开发者会犯一个错误:
用户说什么
↓
全部保存
久而久之:
Memory Explosion
例如:
“今天心情不错”
“帮我写封邮件”
“下午开会”
“这个答案不错”
“刚才那句话写错了”
并不是所有信息都值得长期保存。
因此需要:
Memory Extraction
↓
Importance Evaluation
↓
Store or Discard
例如:
重要:
用户长期使用Java
→ 保存
短期:
用户今天下午开会
→ 可能进入Short-Term Memory
无价值:
“好的,谢谢”
→ 不保存
所以企业级Memory系统通常需要:
Memory Importance
+
TTL
+
Update
+
Delete
+
Compression
九、Agent Memory的典型生命周期
一个Memory系统可以设计成:
Interaction
↓
Memory Extraction
↓
Importance Evaluation
↓
Memory Classification
↓
Store
↓
Index
↓
Memory Retrieval
↓
Context Injection
↓
Task Execution
↓
Memory Update
【正文配图P04|Agent Memory生命周期】
例如用户说:
我以后所有技术方案都优先使用Java。
Agent首先需要判断:
这是不是长期偏好?
如果是:
User Preference
↓
Long-Term Memory
以后:
User:
帮我设计Agent系统。
Agent:
Memory Retrieval
↓
Preferred Stack = Java
↓
Context
↓
Architecture Generation
这才是真正的:
Personalized Agent
十、Memory与Agent Loop如何结合?
我们上一节学习过:
Reasoning
↓
Action
↓
Observation
↓
Context Update
↓
Next Action
加入Memory之后:
User Task
↓
Memory Retrieval
↓
Reasoning
↓
Planning
↓
Action
↓
Tool Calling
↓
Observation
↓
State Update
↓
Memory Update
↓
Next Loop
【正文配图P05|Memory增强的Agent Loop】
Memory在这里可能发生两次作用。
第一次:
Task Start
↓
Retrieve Memory
帮助Agent理解任务背景。
第二次:
Task Complete
↓
Extract Important Experience
↓
Write Memory
帮助未来任务。
因此:
Past Experience
↓
Current Task
↓
New Experience
↓
Future Task
形成持续循环。
十一、企业级Agent Memory架构
企业Agent不能简单使用:
Chat History
作为唯一Memory。
更合理的架构可能是:
Agent
│
┌───────────────┼───────────────┐
↓ ↓ ↓
Short-Term Long-Term User Memory
Memory Memory
│ │ │
└───────────────┼───────────────┘
↓
Memory Retrieval
↓
Memory Ranking
↓
Context Builder
↓
LLM
底层可能继续连接:
Redis
Database
Vector Database
Graph Database
不同类型的信息适合不同的存储方式。
例如:
Session State
→ Redis
Structured User Profile
→ MySQL / PostgreSQL
Semantic Memory
→ Vector Database
Complex Entity Relationship
→ Graph Database
【正文配图P06|企业级Agent Memory Architecture】
因此企业级Memory不是:
一个数据库。
而更像:
多种存储系统 + Memory管理机制。
十二、企业Agent还需要考虑Memory Governance
当Agent开始记住用户信息之后,就会出现新的问题:
能不能保存?
保存多久?
谁可以访问?
用户能不能删除?
Memory是否过期?
Memory是否正确?
例如:
User Memory
用户部门:
销售部
一年之后用户已经调岗。
如果Memory仍然存在:
Outdated Memory
↓
Wrong Context
↓
Wrong Decision
因此企业级Memory必须考虑:
Memory Update
Memory Expiration
Memory Deletion
Permission
Privacy
Audit
完整流程可能是:
Memory Write
↓
Validation
↓
Permission Check
↓
Storage
↓
TTL / Expiration
↓
Retrieval
↓
Access Control
↓
Audit
这意味着:
Agent Memory不仅是AI能力问题,也是数据治理问题。
十三、工程师应该如何开始实现Agent Memory?
建议不要一开始就设计非常复杂的“超级Memory系统”。
可以分阶段。
第一阶段:Conversation History
Recent Messages
↓
Context
适合:
Chatbot
Simple Agent
第二阶段:Session State
Task State
↓
Redis / Database
适合:
Workflow Agent
Multi-Step Agent
第三阶段:Long-Term Memory
User Profile
+
Important Facts
+
Historical Events
↓
Database / Vector DB
适合:
Personal AI Assistant
Enterprise Copilot
第四阶段:Advanced Agent Memory
Semantic Memory
+
Episodic Memory
+
User Memory
+
Experience Memory
+
Memory Retrieval
+
Memory Governance
适合:
Enterprise Agent Platform
Long-Running Agent
Autonomous Agent
工程能力是逐步演进的:
Chat
↓
Stateful Agent
↓
Memory Agent
↓
Learning Agent
十四、Agent为什么最终一定会走向Memory?
因为没有Memory的Agent,每次任务都像:
重新开始
它可能拥有:
Reasoning
Planning
Tool Calling
但缺少:
Experience
Continuity
Personalization
而加入Memory之后:
Past
↓
Memory
↓
Present Decision
↓
New Experience
↓
Future Memory
【正文配图P07|从无记忆Agent到持续进化Agent】
Agent逐渐从:
Single Interaction
发展到:
Continuous Interaction
最终:
Task Execution
+
Experience Accumulation
+
Memory Reuse
十五、知识体系总结
本节的核心知识链路如下:
LLM
↓
Context
↓
State
↓
Short-Term Memory
↓
Long-Term Memory
↓
User Memory
↓
Semantic Memory
↓
Episodic Memory
↓
Memory Retrieval
↓
Context Construction
↓
Agent Memory
【正文配图P08|Agent Memory完整知识体系】
最重要的认知是:
LLM
负责推理
Memory
负责保存和检索经验
State
负责管理当前任务
RAG
负责提供外部知识
它们共同组成Agent的:
Thinking
+
Knowledge
+
Experience
+
Current State
面试题
问题1:Context和Memory有什么区别?
参考答案:
Context是当前一次模型调用能够看到的信息,直接参与模型推理,并受到Context Window限制。
Memory则是Agent系统长期管理的信息集合,通常需要通过Memory Retrieval筛选相关内容,再注入Context。
简单来说:
Memory
负责存储
Context
负责让LLM当前可见
问题2:Agent为什么不能简单保存所有聊天记录?
参考答案:
因为历史记录不断增长会导致:
Context过长
Cost增加
Latency增加
信息噪声增加
模型注意力分散
因此更合理的方式是:
Store Everything Important
↓
Retrieve Relevant Information
↓
Inject Selected Memory
核心不是把所有历史都放进模型,而是在正确的时间提供正确的信息。
问题3:State、Memory和RAG分别解决什么问题?
参考答案:
State
→ 当前任务状态
Memory
→ 历史经验和长期信息
RAG
→ 外部知识和企业文档
三者共同参与Context构建。
问题4:企业级Agent Memory需要考虑哪些问题?
参考答案:
除了Memory Retrieval,还需要考虑:
Memory Update
Memory Expiration
Permission
Privacy
Audit
Deletion
Data Governance
因为长期保存的信息可能过期,也可能涉及企业数据权限和隐私问题。
问题5:为什么说Memory是Agent实现长期任务能力的重要基础?
参考答案:
因为长期任务通常跨越多个步骤、多个时间点。
Agent需要记住:
过去做了什么
当前进行到哪里
已经获得了什么结果
哪些经验未来可以继续使用
否则每次任务都需要重新理解上下文,无法形成连续性。
本节小结
本节我们重点理解了:
✅ 核心概念
Memory ≠ Chat History
Context ≠ Memory
Memory是一个完整的信息:
存储
+
分类
+
检索
+
筛选
+
注入
+
更新
体系。
✅ 底层原理
LLM本身不会永久记住每次交互。
Agent需要通过:
External Memory
↓
Memory Retrieval
↓
Context Construction
让过去的信息重新进入模型。
✅ 常见问题
保存所有信息
≠
好的Memory
Memory过期
≠
仍然正确
Memory很多
≠
Agent一定更聪明
✅ 工程解决方案
Short-Term Memory
+
Long-Term Memory
+
User Memory
+
Semantic Memory
+
Episodic Memory
+
Memory Retrieval
+
Memory Governance
✅ Agent应用
Memory让Agent拥有:
连续性
+
个性化
+
经验复用
+
长期任务能力
最终形成:
LLM
+
Reasoning
+
Planning
+
Tool Calling
+
Observation
+
Memory
+
State
+
Agent Loop
一句话总结:
真正的Agent不仅要能够理解当前任务,还要能够记住过去、利用经验,并把历史信息转化为未来决策的一部分。
下一篇
《第3章 第9节:Agent为什么需要State?——任务执行到一半,AI如何知道自己进行到了哪里?》
下一节我们将继续深入Agent系统中的另一个核心能力:
State
↓
Task Progress
↓
Context Update
↓
Checkpoint
↓
Resume
↓
Long-Running Agent
我们将理解:
Memory负责“记住过去”,State负责“管理现在”。
这也是Agent从简单对话系统走向复杂任务执行系统的重要一步。



评论前必须登录!
注册