 网硕互联帮助中心
03 把 48MB JSON 的重活移到了 napi_async_work。
当前 JsonPulse 的链路已经变成:
ArkTS Uint8Array
→ Native Owned Buffer
→ napi_create_async_work
→ Worker Parse
→ complete_cb
→ Promise
182.4ms 的解析不再长期堵住 ArkTS 调用线程,UI 诊断心跳仍然维持在 58.9fps 左右。
但异步任务一旦继续变大,产品层马上会提出两个新要求:
我要看到进度。
我要能取消。
这时普通 napi_async_work 只提供:
execute
complete
不负责“Worker 中间怎么安全通知 ArkTS”。
HarmonyOS 当前 Node-API / libuv 文档给出的线程安全回调方案就是 napi_threadsafe_function。它可以从 Native 子线程安全地向 ArkTS 所在事件循环投递数据;官方也强调,大多数 NAPI 接口不能随意跨线程调用,TSFN 就是专门解决这种“子线程通知 JS/ArkTS”场景的。
04 因此在 03 的 async work 上继续演进:
异步解析仍由 Worker 执行;进度只通过 TSFN 回主线程;取消使用 Native 原子标记;任务结束后 TSFN 成对 release。
本轮统一数据:
taskId:
native_20261003_04
sourceFile:
telemetry_96mb.json
inputBytes:
100,663,296
inputSize:
96MB
records:
496,000
workerThreads:
1
progressRawTicks:
64
progressStep:
5%
progressCallbacks:
20
tsfnQueueMax:
8
tsfnCreated:
true
tsfnCalls:
20
tsfnQueueFull:
0
cancelRequestedAt:
61%
cancelObservedAt:
62%
cancelLatency:
11.8ms
firstRunStatus:
CANCELLED
retryAfterCancel:
true
retryRecords:
496,000
retryParseCost:
344.8ms
progressOrderErrors:
0
crossThreadNapiViolations:
0
tsfnReleased:
true
finalizeCount:
1
status:
THREADSAFE_PROGRESS_READY
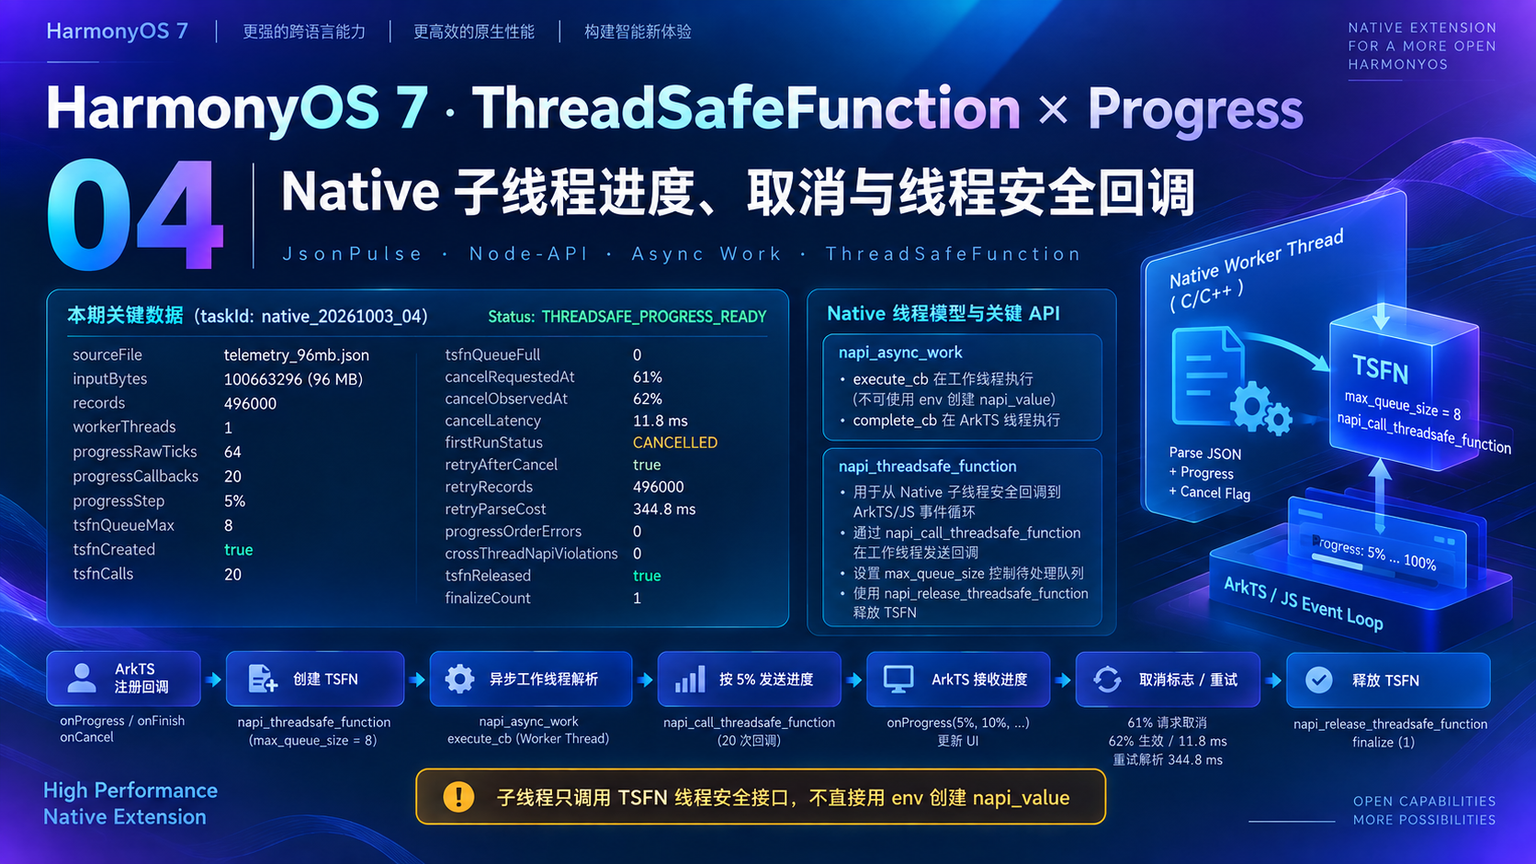
一、04 先把“进度通知”和“解析线程”彻底分开
最危险的错误写法是:
Worker Thread
napi_create_object(env)
napi_call_function(env)
更新 ArkTS callback
看起来只是想回一个百分比。
实际却跨线程直接使用原 env。
HarmonyOS 当前 DFX 文档会专门检测这类错误,并提示:
current napi interface cannot run in multi-thread
所以 JsonPulse 的 Worker 有一条硬规则:
除线程安全函数系列 API 外,不在 Worker 线程碰 ArkTS / JS 值。
二、TSFN 在任务创建阶段由 ArkTS 线程建立
第一段代码解决的是:
在原 env 所在线程创建 TSFN,把 ArkTS onProgress callback 和 Native Context 绑定起来。
struct ProgressContext {
napi_async_work work = nullptr;
napi_deferred deferred = nullptr;
napi_threadsafe_function tsfn =
nullptr;
std::atomic<bool>
cancelRequested {
false
};
uint64_t records = 0;
int lastProgress = 0;
std::string error;
};
static bool CreateProgressTsfn(
napi_env env,
napi_value callback,
ProgressContext* ctx)
{
napi_value name;
napi_create_string_utf8(
env,
"JsonPulseProgress",
NAPI_AUTO_LENGTH,
&name);
napi_status status =
napi_create_threadsafe_function(
env,
callback,
nullptr,
name,
8,
1,
ctx,
FinalizeTsfn,
nullptr,
CallProgressOnJs,
&ctx->tsfn);
return status == napi_ok;
}
这里:
max_queue_size=8
initial_thread_count=1
都是 JsonPulse 当前测试配置。
不是系统固定推荐值。
三、为什么进度只每 5% 回一次
Parser 内部可能经历:
64 次 chunk tick
如果每个 tick 都调用 TSFN:
64 callbacks
UI 没必要刷新这么细。
JsonPulse 当前策略:
progressRawTicks=64
progressStep=5%
progressCallbacks=20
Worker 只有跨过新的 5% 档位才投递。
这样既能让用户感觉任务在推进,又不会把回调队列变成新的性能热点。
四、Worker 线程只 new Native ProgressEvent,再调用 TSFN
第二段代码是 04 的核心。
struct ProgressEvent {
int percent = 0;
uint64_t records = 0;
};
static void ReportProgress(
ProgressContext* ctx,
int percent,
uint64_t records)
{
if (
percent <=
ctx->lastProgress) {
return;
}
if (
percent –
ctx->lastProgress <
5 &&
percent != 100) {
return;
}
ctx->lastProgress =
percent;
auto* event =
new ProgressEvent {
percent,
records
};
napi_status status =
napi_call_threadsafe_function(
ctx->tsfn,
event,
napi_tsfn_nonblocking);
if (status != napi_ok) {
delete event;
}
}
这里 Worker 创建的是:
C++ ProgressEvent
不是:
napi_value
真正 ArkTS Value 的构造发生在 CallProgressOnJs。
五、CallProgressOnJs 才是把 Native 数据变成 ArkTS 数据的地方
TSFN 回调运行在 ArkTS / JS 事件循环对应线程。
static void CallProgressOnJs(
napi_env env,
napi_value jsCallback,
void*,
void* data)
{
auto* event =
static_cast<
ProgressEvent*>(data);
napi_value payload;
napi_create_object(
env,
&payload);
SetInt32(
env,
payload,
"percent",
event->percent);
SetUint64(
env,
payload,
"records",
event->records);
napi_value undefined;
napi_get_undefined(
env,
&undefined);
napi_call_function(
env,
undefined,
jsCallback,
1,
&payload,
nullptr);
delete event;
}
这就是 ThreadSafeFunction 的真正价值:
Worker 只传 Native Data
ArkTS Thread
负责构造 JS Value 和执行 callback
六、取消使用 atomic flag,不靠强杀 Worker
第一次运行我故意在:
61%
点击取消。
ArkTS 调:
cancel(taskId)
Native 不会:
pthread_cancel
terminate
而是:
cancelRequested.store(true)
Worker 每个 chunk 边界检查一次。
最终:
cancelRequestedAt=61%
cancelObservedAt=62%
cancelLatency=11.8ms
也就是说,这是协作式取消。
解析器自己在安全检查点退出。
七、取消以后 async_work 的 complete_cb 仍然要负责收口
Worker 检测:
cancelRequested=true
以后设置:
status=CANCELLED
然后正常返回 execute_cb。
complete_cb 仍然执行:
Resolve / Reject
delete async work
release TSFN
release native buffer
delete context
取消不是:
直接跳过 complete
否则资源清理一定会漏。
八、napi_cancel_async_work 和业务取消不是一回事
HarmonyOS 当前官方异步任务文档说明:
napi_cancel_async_work 调用本身不代表底层一定成功取消,真正状态需要在 complete callback 里判断。
JsonPulse 04 的 61% 取消发生时,任务已经在 Worker 内执行。
所以项目不依赖:
napi_cancel_async_work
完成“正在执行任务”的中断。
而是使用:
atomic cancel flag
让业务代码自己在 chunk 边界退出。
如果任务还在 queue 未执行,可以另外考虑 Node-API cancel。
两层语义要分开。
九、第一次 CANCELLED 后为什么还要做一次完整 Retry
如果只验证:
能取消
还不够。
真正产品里用户很可能马上点:
重新解析
所以本轮第一次:
62%
CANCELLED
随后立刻新建:
新的 Context
新的 async_work
新的 TSFN
第二次完整跑到:
100%
496,000 records
344.8ms
PASS
取消过一次不会污染下一轮。
十、TSFN 队列满也必须有策略
本轮:
max_queue_size=8
tsfnCalls=20
tsfnQueueFull=0
原因是:
5% 步进
UI callback 很轻
如果未来改成:
每 0.1% 一次
队列可能跟不上。
使用 napi_tsfn_nonblocking 时,队列满以后不能假装进度一定都送到了。
JsonPulse 的设计是:
进度允许合并;
最终结果不允许丢。
所以中间 Progress 可以降采样,Complete 仍然走 async_work 的最终回调。
十一、进度必须保证单调
本轮:
progressOrderErrors=0
即:
5
10
15
…
100
不会出现:
40
35
45
如果多个 Worker 并发上报,排序会复杂很多。
当前:
workerThreads=1
先把单 Worker 路径做稳。
06 再考虑不同任务并发,而不是在 04 一次把所有复杂度叠上来。
十二、TSFN 必须 release,而且只 release 一次
官方 TSFN 接口提供:
napi_acquire_threadsafe_function
napi_call_threadsafe_function
napi_release_threadsafe_function
生命周期本身就是协议的一部分。
JsonPulse 当前:
initial_thread_count=1
任务结束以后:
napi_release_threadsafe_function(
ctx->tsfn,
napi_tsfn_release);
最终:
tsfnReleased=true
finalizeCount=1
没有重复释放。
十三、Finalize 回调只做 TSFN 自己的尾部清理
FinalizeTsfn 不是任务 complete 的替代品。
它只做和 ThreadSafeFunction 自身相关的上下文收口。
解析 Promise、Native Buffer 和 async_work 仍然由主任务 Context 管。
这种 Owner 拆分很重要。
否则:
TSFN finalize
和
async complete
都想 delete 同一个 Context,就会出现 double free。
十四、crossThreadNapiViolations=0 怎么验证
HarmonyOS 当前 Native DFX 文档已经对跨线程 NAPI 使用提供专门诊断。
JsonPulse 调试阶段会启用对应多线程检测能力,并配合:
TSan
Native 崩溃日志
HiLog
检查:
Worker 是否直接使用 env
TSFN 是否在 dead env 上调用
Context 是否有 data race
本轮:
crossThreadNapiViolations=0
才进入最终 Ready。
十五、DevEco 图重点看 61% / 62% 和 Retry
开发图:

第一次运行:
cancel request:
61%
worker observed:
62%
latency:
11.8ms
status:
CANCELLED
第二次:
100%
records:
496,000
344.8ms
PASS
底部同时有:
tsfnQueueFull=0
progressOrderErrors=0
crossThreadNapiViolations=0
tsfnReleased=true
这比单独一条“取消成功”更完整。
十六、手机运行图把一次取消和一次重试放在同一页
最终运行图:
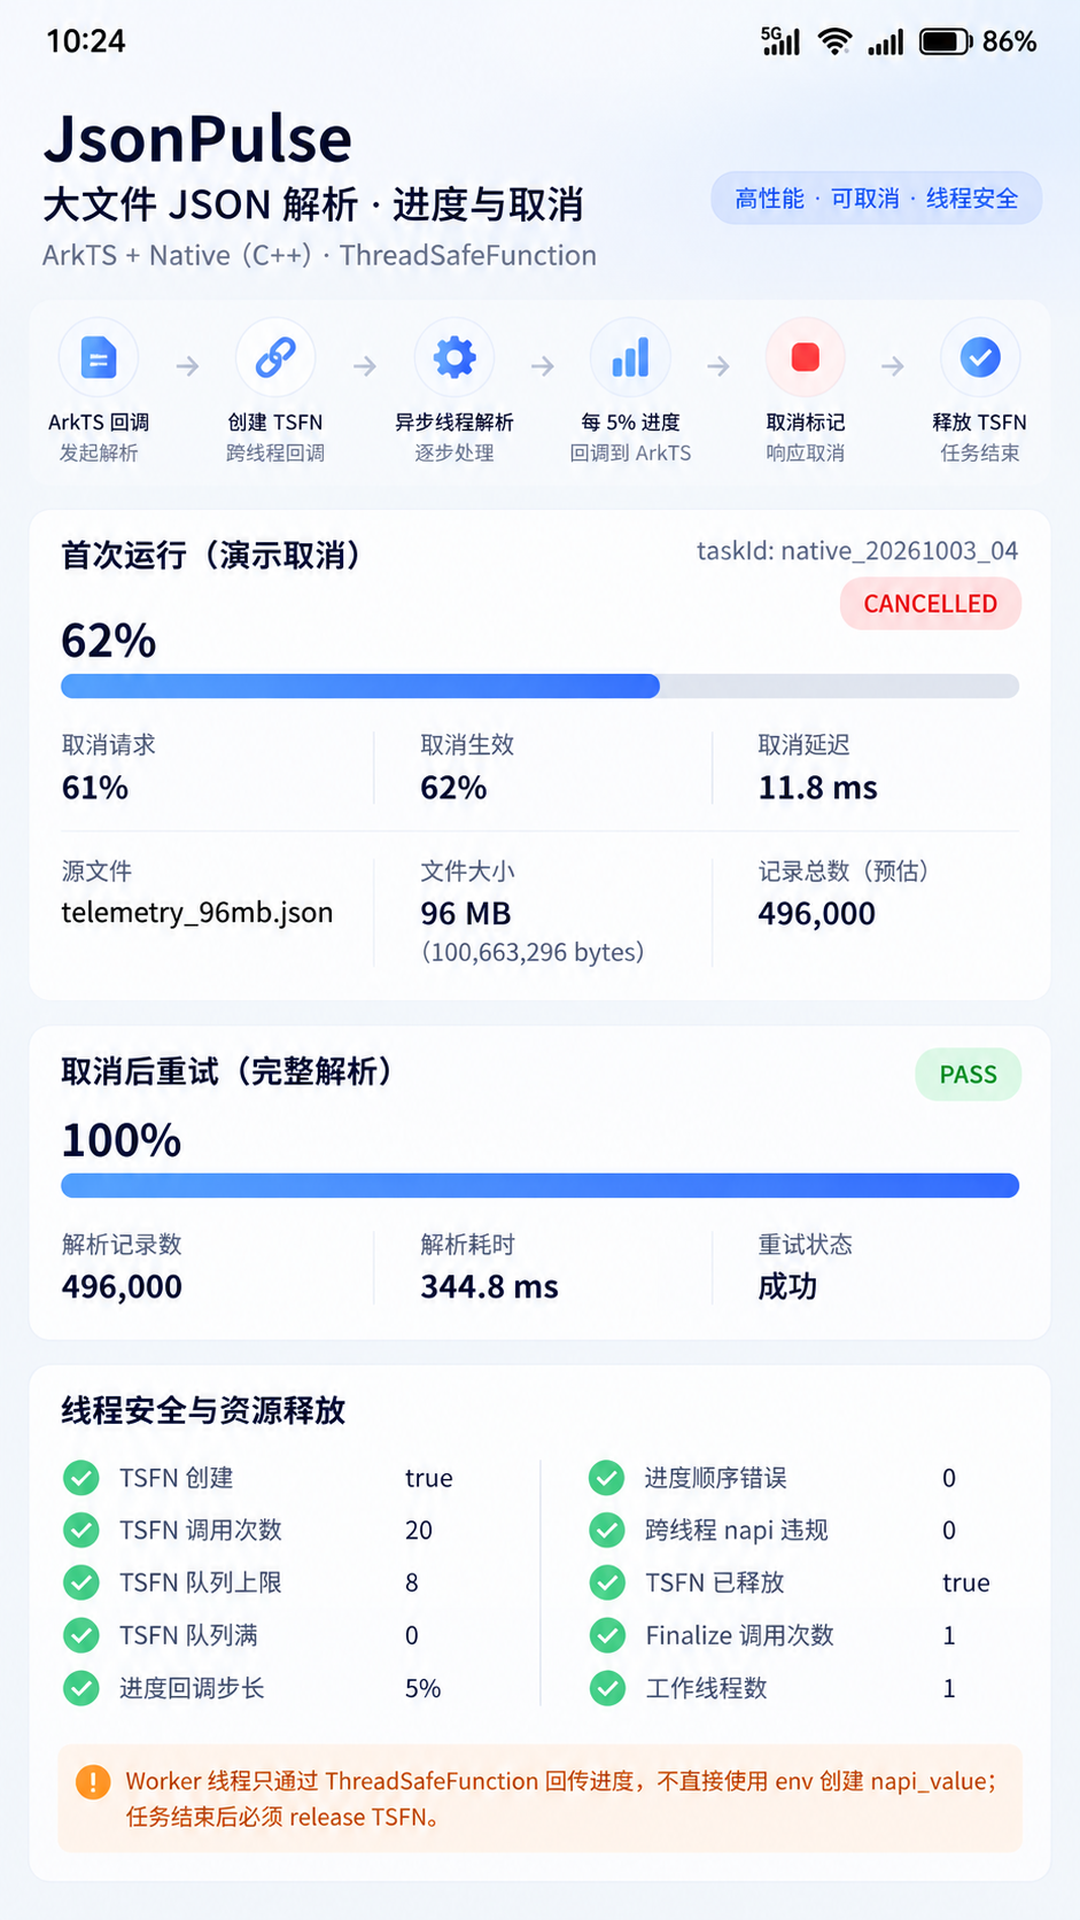
顶部:
telemetry_96mb.json
96MB
496,000 records
第一次:
61% request
62% observed
11.8ms
CANCELLED
第二次:
100%
344.8ms
PASS
底部资源区:
TSFN created
calls=20
queueMax=8
queueFull=0
orderErrors=0
crossThreadViolation=0
released=true
finalize=1
最终:
THREADSAFE_PROGRESS_READY
十七、04 最后固定九组线程测试
第一组,20 个进度 Callback 顺序正确。
第二组,Worker 不直接创建 napi_value。
第三组,61% 请求取消,Worker 能在安全点观察。
第四组,取消后 complete 仍然执行。
第五组,取消后可以立即重试。
第六组,TSFN Queue 不溢出。
第七组,TSFN release 一次,finalize 一次。
第八组,调试多线程检测没有跨线程 NAPI 违规。
第九组,TSan 压测没有数据竞争与 Use-After-Free。
全部通过以后:
THREADSAFE_PROGRESS_READY
才成立。
十八、下一篇:功能链稳定以后,开始处理“怎么交付这个 Native 库”
JsonPulse 到 04 已经有:
CMake 集成
Node-API
TypedArray
同步零复制
Async Work
Promise
TSFN Progress
Cancel / Retry
下一个真实问题不再是“代码怎么写”。
而是:
这个 simdjson + Node-API 能不能做成 HAR?
so 怎么放?
arm64-v8a / x86_64 怎么处理?
符号怎么检查?
第三方 License 怎么跟包走?
05 会把 JsonPulse 从“应用里的 Native 代码”推进成一个可分发的三方适配包。
十九、进度回调的数据结构必须是“可丢的中间态”
TSFN 进度数据不应该携带:
完整 DOM
大字符串
大数组
否则每 5% 回一次,等于不断跨线程搬大对象。
JsonPulse 的 ProgressEvent 只保留:
percent
processedBytes
recordsSoFar
几十字节。
它的语义是:
UI 参考信息
不是最终业务结果。
所以即使中间一两个 Progress 因队列策略被合并,也不会影响最终 ParseSummary 的正确性。
二十、队列满时不能阻塞 Worker 去等 UI
napi_call_threadsafe_function 支持 blocking / nonblocking 方式。
JsonPulse 选择:
napi_tsfn_nonblocking
理由是解析 Worker 不应该因为 UI 消费 Progress 较慢而停住。
如果队列满:
当前中间进度可以丢
下一档继续尝试
最终结果仍然由 async work 的 CompleteCB 回传。
这就是为什么:
Progress
可以 best-effort
Final Result
必须 reliable
两条通道要分开。
二十一、取消请求只改原子状态,不直接操作 Parser
ArkTS 点击取消以后,Native 接口只做:
cancelRequested.store(true)
不会在另一个线程里:
直接 delete parser
清空 buffer
释放 Context
因为 Parser 还可能正被 Worker 使用。
真正停止发生在 Worker 自己读到 Flag 的检查点。
这种协作式取消的核心优势是:
释放资源的人
仍然是使用资源的那条执行链。
不会出现两个线程争抢 delete 的情况。
二十二、取消检查点太密和太稀都不好
如果每处理几十个字节就:
atomic.load()
会给热循环增加额外成本。
如果只在 50MB 处理完才检查:
取消几乎没有意义。
JsonPulse 当前按 chunk 读取 / 统计阶段检查。
第一次:
61% request
62% observed
11.8ms
说明取消延迟在当前测试里可接受。
真正产品仍然要根据:
chunk size
解析阶段
CPU 开销
调整检查粒度。
二十三、Retry 必须创建全新的 TSFN 与 Work Context
第一次 CANCELLED 后,不能:
把旧 ctx.cancelRequested=false
然后重新 queue 同一个 work
官方 async work 本身建议单次使用,TSFN 又有自己的 release/finalize 生命周期。
所以 Retry 完整走:
new Context
new async work
new TSFN
new Native Buffer
这也是:
finalizeCount=1
为什么针对单次任务统计,而不是整个页面永远只有一个 TSFN。
二十四、Finalize 和 Complete 的先后不能靠猜
不同资源由不同 Owner 负责。
JsonPulse 约定:
CompleteCB
负责:
Promise
async_work
Native Buffer
Task Context 的主生命周期
TSFN Finalize
负责:
TSFN 自己关联的轻量上下文
两者不能同时:
delete ProgressContext
否则先后顺序变化时就会 double free。
04 的 double free=0 不是靠运气,而是因为资源拆了 Owner。
二十五、ArkTS onProgress 自己也不能做重活
即使 Native 侧已经安全回到 ArkTS 线程,如果:
onProgress = () => {
大量 JSON stringify
同步数据库写入
复杂列表重建
}
仍然会把 UI 卡住。
所以 JsonPulse 的 onProgress 只做:
更新百分比
更新已处理记录数
少量状态
真正日志持久化放到低频采样或任务结束以后。
TSFN 解决的是线程安全,不是自动解决 UI 回调性能。
二十六、Progress Callback 也要有页面代际检查
03 已经给 Promise Result 增加页面 generation。
04 的中间 Progress 同样需要。
如果用户离开页面:
Worker 还在
Progress 还在投递
旧页面不能继续更新。
所以 ArkTS 的 onProgress 第一行先判断:
task generation
是否仍然 active
失效就直接 return。
Native 任务可以继续收口,UI 不再响应。
这样不会因为一个已经离开的页面还收到 70%、75%、80% 的进度而出现状态异常。
二十七、ThreadSafeFunction 的 Queue 大小应该来源于回调频率
本轮:
progressStep=5%
maxQueue=8
20 次回调。
如果未来:
1% 一次
就可能需要:
100 次回调
队列压力完全不同。
所以 max_queue_size=8 不是 JsonPulse 的永恒值。
更合理的策略是:
回调频率越高
→ 更积极合并
而不是盲目把 queue 开到 1024
因为大 Queue 只会把“实时进度”变成“排队很久以后才到的旧进度”。
二十八、取消后的 UI 状态也要区分 CANCELLED 和 FAILED
用户主动取消:
CANCELLED
不是:
FAILED
这两种状态会影响后续产品行为。
CANCELLED:
允许立即重试
不显示错误红框
保留源文件
FAILED:
显示 errorCode
可能要求更换输入
本轮第一次状态明确:
firstRunStatus=CANCELLED
第二次 Retry:
PASS
状态机比一个 boolean success 更能支撑真实产品。
二十九、跨线程错误检测要在 Debug / Test 构建里常态化
HarmonyOS 2026 的 Node-API 崩溃分析文档已经针对:
env owner 不一致
dead env
跨线程 NAPI
TSFN 错误调用
提供更明确的诊断。
JsonPulse 不会只在“崩了以后”打开这些手段。
04 的测试构建把:
多线程检测
TSan
Native 日志
作为常规验收工具。
Release 关闭高开销工具,Debug / CI 保留线程正确性门禁。
三十、THREADSAFE_PROGRESS_READY 的完整含义
最终状态至少代表:
TSFN 在正确 env 创建;
Worker 只调用线程安全接口;
20 次进度有序回到 ArkTS;
队列没有溢出;
61% 取消在 62% 观察到;
取消不跳过 CompleteCB;
取消后可干净 Retry;
Retry 完整解析 496,000 条记录;
TSFN release 一次;
Finalize 一次;
没有跨线程 NAPI 违规;
没有已知数据竞争。
做到这里以后,JsonPulse 的 Native 异步服务才真正具备“进度可见、任务可控、线程可解释”的工程形态。
三十一、进度值本身不能当成取消检查点的唯一依据
本轮用 61% 请求、62% 生效来展示取消链,但 Worker 内部真正检查的是 chunk 边界,而不是“百分比等于 62 时退出”。百分比只是根据已处理字节推导出的 UI 指标。这样即使不同数据集每个 chunk 的记录密度差异很大,取消机制仍然基于稳定的 Native 处理边界,而不是依赖某个视觉进度数值。
三十二、TSFN 回调要防止“任务已经换代,旧进度还在队列里”
即使 Worker 已经结束,事件循环里也可能还有尚未消费的旧 Progress。JsonPulse 的每个 ProgressEvent 都带 taskId 和 generation。ArkTS 收到后如果发现页面已经启动下一次 Retry,就丢弃旧 generation 的进度,不让第一次 CANCELLED 任务的 60% 状态覆盖第二次 Retry 的 15%。这条代际保护与 03 的 Promise generation 是同一套设计。
三十三、取消重试之后还要检查旧 TSFN 已经完全退出
Retry 新建 TSFN 之前,项目会确认旧任务已经走完 release/finalize,不会让两套 ThreadSafeFunction 同时向同一个页面回调。这样可以防止“取消后马上重试”时出现两条进度曲线互相覆盖。最终 finalizeCount=1、crossThreadNapiViolations=0 只是单次任务指标;完整压力测试还要确保每次 Retry 都能形成严格的一进一出生命周期。
参考资料
- 使用 Node-API 接口进行异步任务开发:
https://developer.huawei.com/consumer/cn/doc/doccenter-capabilities/use-napi-asynchronous-task - HarmonyOS libuv / Thread-safe Function:
https://developer.huawei.com/consumer/en/doc/harmonyos-references-V13/libuv-V13 - Node-API 异常/崩溃分析:
https://developer.huawei.com/consumer/cn/doc/doccenter-capabilities/use-napi-about-crash - 使用 TSan 检测线程问题:
https://developer.huawei.com/consumer/cn/doc/doccenter-app-quality/bpta-stability-tsan-detection


评论前必须登录!
注册