 网硕互联帮助中心
第 2 章 AI 怎样从数据中学习
一封新邮件刚到,垃圾邮件过滤器几乎立刻给出了判断。它没有见过这封邮件,也没有人提前为这封邮件写好答案。这个结果很容易让人觉得模型在凭经验判断,可“经验”放进计算机以后,究竟是什么东西。 
监督学习的流程可以压到一张很朴素的表格里。每一行放一个过去发生过的例子,几列记录可供判断的线索,最后一列写下当时确认的答案。模型反复处理这些例子,调整内部参数,随后再面对没有答案的新数据。 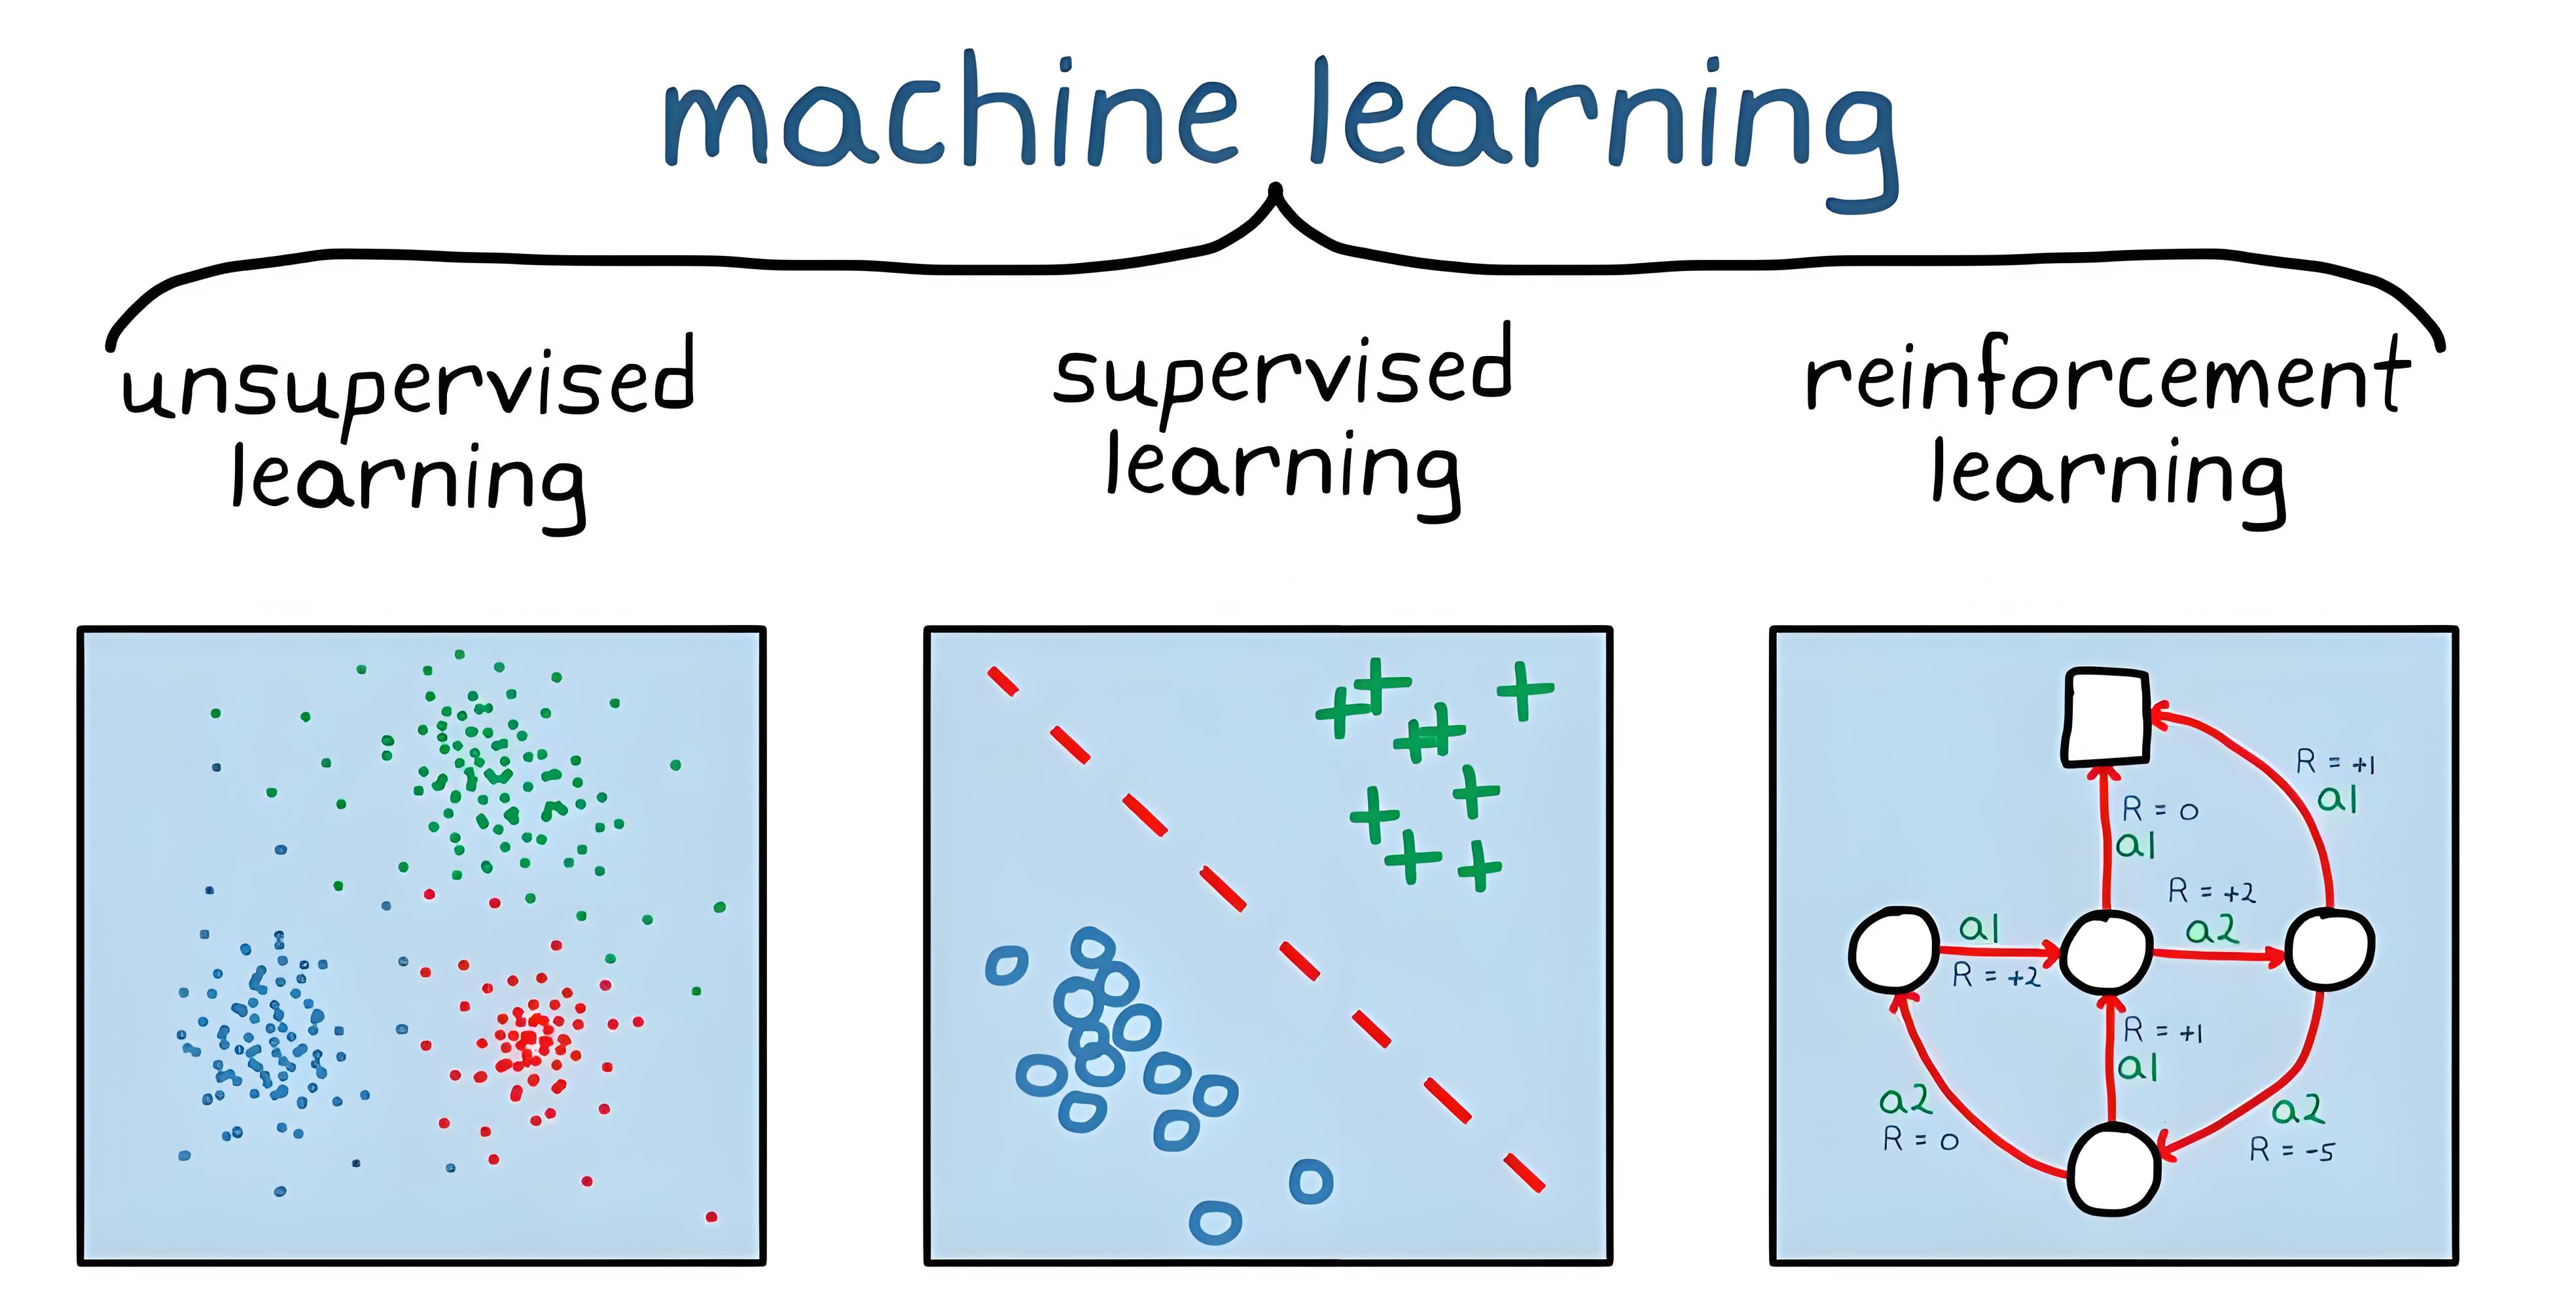
本章沿着垃圾邮件分类走完这个过程。读完以后,你应该能解释数据、样本、特征、标签、模型、训练、评估和推理分别做什么,也能看出数据质量为什么会改变结果。这里不需要数学和编程基础。第 1 章的五个概念能分清,就可以继续。
🌈 关于《AI 零基础 36 讲》
🧠 零基础也能开始学 AI
《AI 零基础 36 讲》是一套面向初学者的 AI 入门教程。课程从认识和使用 AI 开始,逐步学习 Python、数据处理、机器学习与深度学习,再进入大模型应用开发,最后完成个人知识库助手的综合实践。
📖 本篇是正式讲解文章
通过具体例子、原创图示和操作结果讲清概念。涉及编程的章节提供可运行代码,方便你边读边试。
🎯 读完以后,动手检验
建议按专栏顺序学习,并完成对应的课后训练,检查自己能否独立运用本章知识。
博客专栏:《AI 零基础 36 讲》
先把一封邮件放进表格
假设我们要训练一个很小的邮件分类模型。开发者收集了一批历史邮件,由人工确认每封邮件属于“垃圾邮件”还是“正常邮件”,再整理出下面这样的表格。
| 1 | 是 | 0 | 否 | 正常邮件 |
| 2 | 否 | 4 | 否 | 垃圾邮件 |
| 3 | 否 | 1 | 是 | 垃圾邮件 |
| 4 | 是 | 1 | 否 | 正常邮件 |
| 5 | 否 | 0 | 否 | 正常邮件 |
这是一份为讲解流程而构造的模拟数据,不能直接用于邮件过滤。它的好处是小,所有东西都看得见。
表格里的一行叫一个样本,也常写成一个示例。前面三列提供判断线索,它们叫特征。最后一列给出希望模型学会预测的答案,它叫标签。
同一列数据换一个任务,身份也可能变化。如果任务是预测一封邮件包含多少条链接,链接数量就会成为标签。现在的任务是判断邮件类别,链接数量才是特征。特征和标签由问题决定,不能只看数据长什么样。
现实中的特征也不会总是这样整齐。文字、图片和声音都要转换成模型能够计算的数字。Google 的机器学习课程把一个样本输入模型的数字数组称为特征向量。原始数据经常还要清洗、编码或缩放,后面的数据章节会逐步处理这些工作。
训练在反复调整一组数字
训练开始时,模型内部的参数可能还很差。它接收第一个样本的特征,给出一个预测,例如认为这封邮件有百分之六十的可能属于垃圾邮件。训练数据里已经保存了真实标签,程序可以把预测和标签放在一起比较。
两者差得多,损失就大。训练程序根据损失调整模型参数,让下一次预测朝正确方向移动一点。随后模型继续处理更多样本,多轮重复同一过程。
监督学习的训练流程可以写成五个动作。
模型最后学到的是特征与标签之间的数学关系。垃圾邮件分类模型可能发现,没有出现在联系人中的发件人、较多链接和索要验证码等特征,会改变垃圾邮件的预测概率。具体影响有多大,由训练数据和算法共同决定。
这里很容易冒出一个误会。训练不等于把每一封历史邮件原样背下来。一个只记住训练样本的模型,遇到新邮件时没有多少用处。我们需要它从过去的样本里找到能够迁移到新样本的规律,这种能力通常叫泛化。
模型也可能真的记得太多。它在训练数据上答得很好,面对新数据却频繁出错,这叫过拟合。第 20 章会专门处理过拟合、数据泄漏和评估指标,本章先记住一件事,训练成绩不能单独证明模型已经学会了任务。
留一部分数据给模型做陌生题
开发者通常会把一部分带标签数据留出来,不让模型在训练时使用。训练结束后,只把这些样本的特征交给模型,再把模型预测和真实标签比较。
这一步叫评估。它像一次闭卷练习,题目来自同一类任务,模型此前没有拿这些样本调整参数。评估结果能帮助开发者判断模型面对新数据时大概会怎样表现。
训练数据和评估数据混在一起,会产生误导。假如模型已经看过评估样本,它在这些样本上的高分可能来自记忆。真实使用时出现的是新邮件,这个分数便没有提供我们需要的信息。
scikit-learn 提供的 train_test_split 会把数组或表格随机分成训练部分和测试部分。第 17 章开始写机器学习代码时,我们会用到它。现在只要分清两份数据的用途。训练数据帮助模型调整参数,留出的数据检查它能否处理没见过的样本。
推理时没有标签可以偷看
模型通过评估以后,才会进入实际使用。此时来了一封新邮件,系统能够提取发件人、链接和文字等特征,却没有现成标签。模型根据训练得到的参数算出预测,这次计算叫推理。
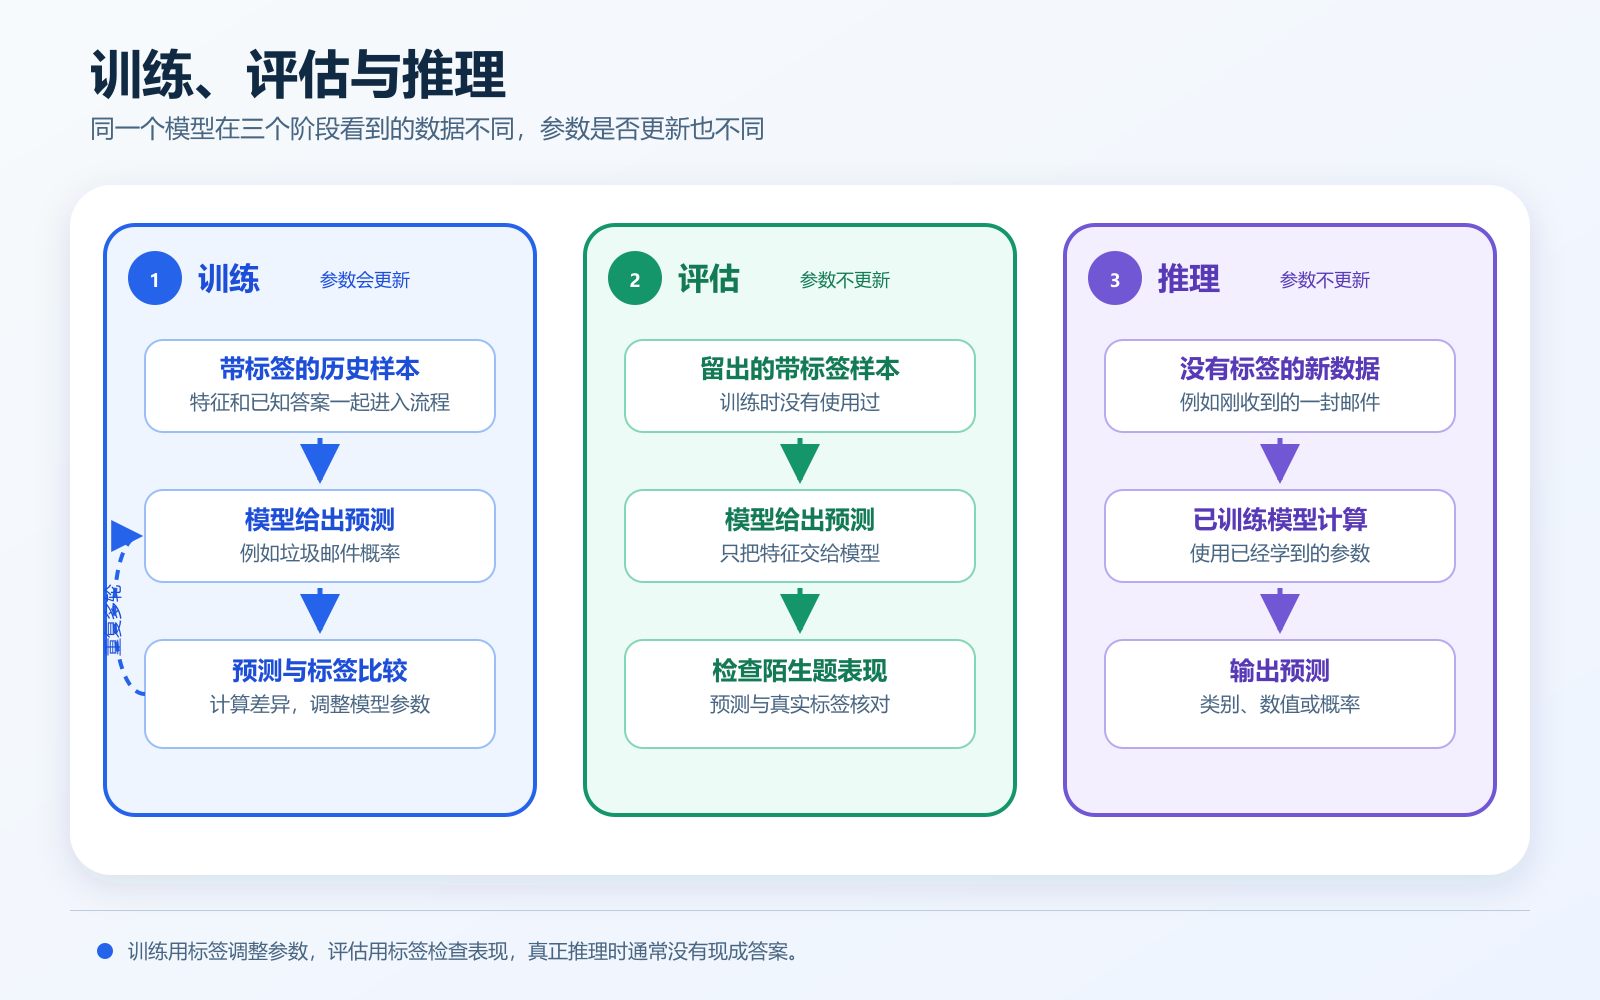
图里最要紧的区别在标签。训练阶段有标签,程序用它计算差异并调整参数。评估阶段也保留标签,用于核对结果,模型参数不应借这些样本继续学习。推理阶段面对未标注的新数据,系统只能输出预测。
过滤器把邮件移进垃圾箱以后,用户可能把它恢复出来。这个动作可以成为新的反馈数据,但它不会自动让所有模型立刻学会。产品需要记录反馈、检查质量,并在合适的时候重新训练或更新模型。线上产品怎样收集反馈和重新训练,远比一张流程图复杂。
特征没有记录,模型就看不见
回到那张五行表格。假如一封钓鱼邮件没有链接,也没有直接索要验证码,只让收件人拨打一个电话号码,我们的小模型可能把它判成正常邮件。电话号码、正文语义和发件域名都没有进入特征,模型拿不到这些线索。
增加特征也不保证结果变好。Google 的监督学习课程提醒,更多特征可能提供额外规律,也可能加入与标签无关的信息。无用特征会增加训练和维护负担。某个特征在训练时期很有效,后来采集方式发生变化,模型表现还可能突然下降。
特征会把现实压缩成程序能够处理的表示。压缩总会遗漏一些东西。设计特征时要问,这条信息在实际使用时能否稳定取得,它与目标有没有真实关系,采集它会不会带来隐私或成本问题。
标签错了,模型会认真学错
监督学习依赖标签。如果历史邮件被人工错标,模型收到的学习信号也会出错。少量随机错误可能只是增加噪声,大量系统性错误会让模型稳定地学向错误方向。
数据覆盖范围同样重要。假如训练数据几乎全是中文邮件,系统上线后开始处理多种语言,原来的表现不能直接代表新场景。假如历史样本只来自某一类用户或设备,模型也可能在其他人群和设备上失灵。
Google 的数据质量说明列出了标签错误、噪声特征、缺失值和过滤问题。NIST 对 AI 偏差的研究又往外扩了一步。偏差可能来自数据和算法,也可能来自人的判断、组织流程及更大的社会环境。检查训练表格很重要,还要检查谁定义了标签、谁没有进入数据,以及错误最终落在谁身上。
邮件过滤的代价也不对称。一封广告留在收件箱里,多数时候只是打扰。一封重要通知被误移进垃圾箱,可能让人错过缴费、考试或工作安排。模型优化目标必须考虑错误后果,单看总体答对了多少还不够。第 20 章会用精确率、召回率等指标继续处理这件事。
模型学到的是数据里的关联
训练数据里经常一起出现的特征和标签,会影响模型参数。模型可以利用这种关联做出准确预测,却不会自动知道关联为什么存在。
假设某段时间收集到的垃圾邮件大多来自一个特定邮箱服务商,模型可能把服务商域名当成强信号。这个规律在旧数据上很好用,换一批用户或等发送者更换域名,效果就会下降。域名本身没有让邮件变坏,数据收集过程碰巧把它和垃圾邮件绑在了一起。
开发者需要检查模型依赖了哪些信息,也要观察上线后的输入是否发生变化。发现一个特征与标签相关,只能说明它有预测价值的可能。要解释原因,还需要业务知识、实验或其他证据。
用八封虚构邮件走一遍流程
本章的课后练习准备了八封训练邮件和四封新邮件。所有内容都是教学用虚构数据,任务也很简单。
先从训练表中找线索,写出自己的分类办法。再给四封新邮件预测标签,最后打开答案,看看哪一封最容易判断错。你还会往训练数据里补一封正常的安全提醒邮件,观察原先的规则为什么需要修改。
这个小游戏不会训练出可部署的机器学习模型。它让你亲手经历同一条过程,从历史样本找规律,用陌生样本检查,再根据失败补数据。等到第 17 章调用代码训练模型时,屏幕上的函数名字会变,背后的问题还是这些。
总结
垃圾邮件案例属于监督学习,因为训练样本带着人工或业务系统确认的标签。机器学习还有无监督学习、强化学习等路线。大语言模型的预训练也会从文本本身构造学习目标,完整过程比这张小表复杂得多。
本章选监督学习,是因为它把输入、答案和学习过程摆得最清楚。先抓住数据怎样进入模型、参数怎样根据差异调整、预测怎样在新样本上接受检查,后面再换算法和模型,读者仍然知道自己在看哪一步。
做完练习后,拿身边一个预测功能试着拆解。它接收什么数据,想输出什么,历史答案从哪里来,实际使用时哪种错误更麻烦。四个问题能说清,就可以进入第 3 章。下一章会把语言模型接收文字、利用上下文和逐步生成内容的过程展开。
参考资料
- Google 监督学习入门
- Google 机器学习基础术语
- Google 数据质量说明
- Google 特征向量说明
- scikit-learn 数据划分文档
- NIST 人工智能偏差研究


评论前必须登录!
注册