 网硕互联帮助中心
面试官翻着简历:"你做过 AI 客服?"
候选人点头:"对,知识库问答 + 多轮对话。"
"用户跟 AI 聊了 20 轮之后,AI 还记不记得第一轮说了什么?"
"……应该记得吧?"
"你确定?你了解上下文窗口吗?如果 Token 超了会发生什么?"
候选人沉默了。他做多轮对话时确实没考虑过这个问题——反正框架自动处理历史消息,用户聊到一半 AI 突然"失忆",他还以为是模型的问题。
这不是模型的问题,是记忆管理的问题。 大模型的记忆是有限的、有成本的、还是一次性的。这篇聊透。
大模型的记忆到底有多小
很多人以为大模型像人一样"记性好"。错了。
大模型每次回答,只能"看到"你这次请求里塞给它的所有文字。上一次对话它根本记不住——除非你把历史对话重新发给它。
所以所谓"多轮对话",本质是:每轮都把之前所有的对话,重新拼进 Prompt 里,再发给模型。
而模型一次能"看到"的文字总量,就是上下文窗口(Context Window)。
GPT-4o 一般是 128K Token,但很多国产模型只有 8K、32K。8K Token 是什么概念?大概 6000 个汉字,或者 20 轮左右的简单对话。一杯水,就这么点。
更麻烦的是,窗口不是只有历史对话在占用:
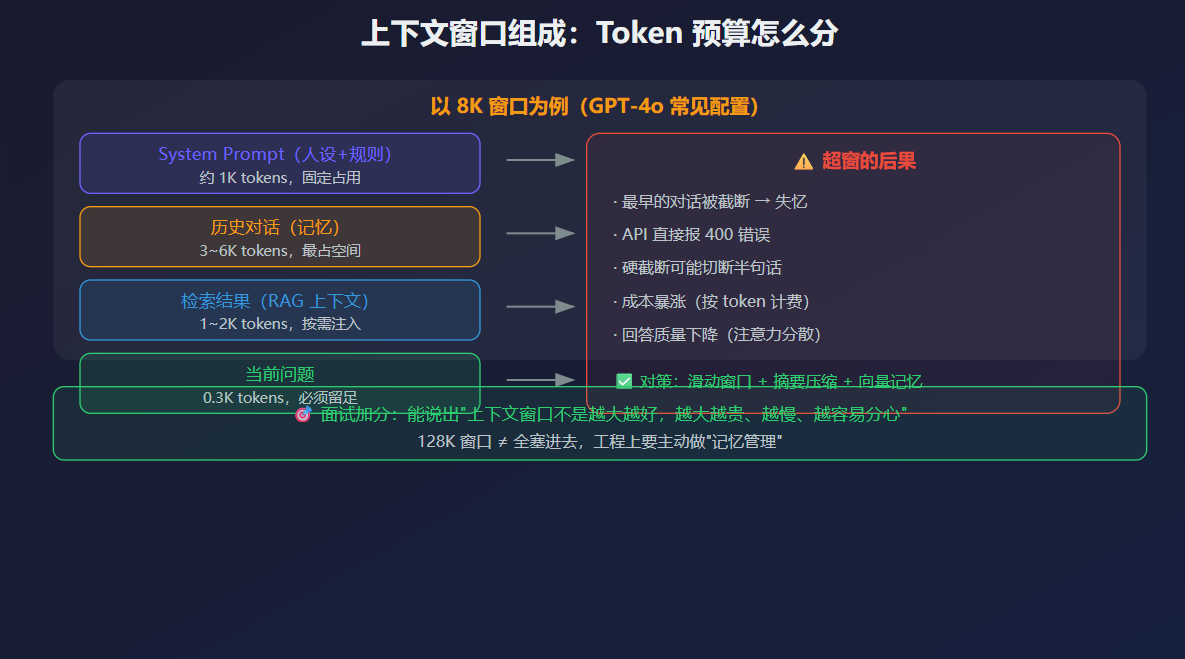
系统提示词占一块、历史对话占一块、RAG 检索结果占一块、用户当前问题占一块。四块加起来不能超过窗口上限。
超了怎么办? 两个后果:
1. API 直接报错(maximum context length exceeded)
2. 框架自动截断——最早的历史被丢掉,AI 就"失忆"了
失忆的代价:一个很典型的场景
举个典型场景:AI 保险顾问,用户咨询理赔。
用户第一轮说:"我父亲去年买的 XX 重疾险,今年确诊了肺癌。"
AI 答得挺好,给了一堆理赔指引。
聊了 30 轮,用户问:"那像我父亲这种情况,之前说的那个免赔额条款还适用吗?"
AI 答:"您父亲是哪款产品?之前没有提到过,请补充说明。"
用户当场炸了:"我刚说了一万遍!"
技术排查发现:历史对话超过了窗口,最早的几轮被截断丢弃,模型压根不知道用户父亲买的是什么保险。
这不是模型蠢,是记忆管理没做好。 用户不会理解"上下文窗口"这种技术概念,他只知道"这 AI 记性真差"。
记忆管理方案一:滑动窗口
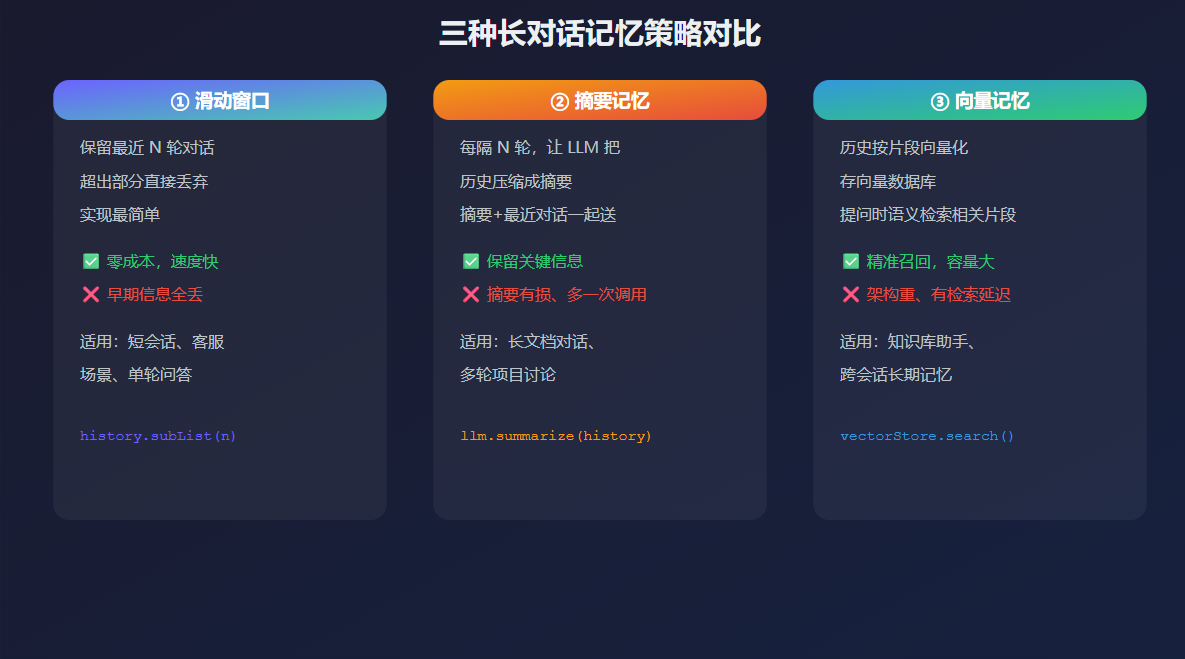
最朴素的做法:只保留最近 N 轮对话,更早的直接丢弃。
public List<Message> slidingWindow(List<Message> history, int maxTurns) {
if (history.size() <= maxTurns) {
return history;
}
// 保留系统消息 + 最近 maxTurns 轮
Message system = history.get(0);
List<Message> recent = history.subList(history.size() – maxTurns, history.size());
List<Message> result = new ArrayList<>();
result.add(system);
result.addAll(recent);
return result;
}
优点:实现简单,几乎零成本,速度最快。
缺点:早期信息全丢。 用户第一轮说的关键信息(父亲买的保险),第 21 轮就被丢了。
滑动窗口适合:客服问答、单轮为主、对历史依赖不强的场景。
记忆管理方案二:摘要记忆
既然原始对话太占空间,那就压缩。每隔几轮,让模型把之前的对话总结成一段摘要,以后只带摘要 + 最近几轮。
public class SummaryMemory {
private final ChatModel chatModel;
private String summary = ""; // 累积摘要
public List<Message> buildMessages(List<Message> recentTurns) {
List<Message> messages = new ArrayList<>();
// 先放压缩后的历史摘要
if (!summary.isEmpty()) {
messages.add(new SystemMessage("历史对话摘要:" + summary));
}
// 再放最近几轮原始对话
messages.addAll(recentTurns);
return messages;
}
// 每 5 轮触发一次摘要更新
public void maybeSummarize(List<Message> allHistory) {
if (allHistory.size() % 10 == 0) {
this.summary = chatModel.call(
"把以下对话压缩成 200 字以内的摘要,保留关键事实:\\n" + allHistory
);
}
}
}
摘要的本质是"丢细节换容量"。 用户父亲买的是哪款保险、确诊什么病、问过哪些条款——这些关键事实会被摘要保留,但对话的细枝末节就没了。
优点:能记住早期关键信息,容量可控。
缺点:摘要本身有信息损失;每 5 轮多一次模型调用,有成本和延迟;摘要更新时机要设计好。
记忆管理方案三:向量记忆
最"重"的方案,也是大厂 Agent 产品的主流做法。
思路:把每一轮对话(或每个知识点)向量化,存进向量数据库。用户提问时,先从向量库里语义检索出最相关的几条历史,拼进 Prompt。
@Service
public class VectorMemory {
private final VectorStore vectorStore;
// 每轮对话结束后,把内容存入向量库
public void remember(String sessionId, String userMsg, String aiMsg) {
Document doc = new Document(
"用户说:" + userMsg + "\\nAI 答:" + aiMsg,
Map.of("sessionId", sessionId, "timestamp", System.currentTimeMillis())
);
vectorStore.add(List.of(doc));
}
// 用户提问时,检索相关历史
public List<Document> recall(String sessionId, String question, int topK) {
return vectorStore.similaritySearch(
SearchRequest.builder()
.query(question)
.topK(topK)
.filterExpression("sessionId == '" + sessionId + "'")
.build()
);
}
}
优点:容量大(存多少都行)、检索精准(只带相关历史)、天然支持跨会话长期记忆。
缺点:架构重(要引入向量库)、多一次检索延迟(几十毫秒)、历史片段怎么切分有讲究。
实战:Token 预算怎么算
面试官问"你怎么控制 Token",光说"压缩历史"不够,得有具体方法。
第一步:估算。 中文场景有个粗略公式:1 个汉字 ≈ 1.5~2 个 Token,1 个英文字符 ≈ 0.3 个 Token。不够精确,但做预算够用。要精确就调 API 的 tokenizer 接口,或者用 tiktoken 库:
// OpenAI 官方 tiktoken 的 Java 移植版
int tokens = EncoderFactory.get().encoder()
.encode(prompt)
.size();
第二步:分级预算。 我习惯按比例分配,以 8K 窗口为例:
public class TokenBudget {
private static final int WINDOW = 8000;
// 各部分预算(给当前问题留足空间)
private static final int SYSTEM_BUDGET = (int) (WINDOW * 0.15); // 1200
private static final int HISTORY_BUDGET = (int) (WINDOW * 0.50); // 4000
private static final int RAG_BUDGET = (int) (WINDOW * 0.20); // 1600
private static final int QUESTION_BUDGET = (int) (WINDOW * 0.15); // 1200
public List<Message> assemble(String question,
List<Message> history,
List<Document> ragDocs) {
// 历史超预算 → 从旧到新截断,或触发摘要
List<Message> trimmedHistory = fitHistory(history, HISTORY_BUDGET);
// RAG 文档超预算 → 只保留最相关的
List<Document> trimmedDocs = fitDocs(ragDocs, RAG_BUDGET);
return buildMessages(trimmedDocs, trimmedHistory, question);
}
}
第三步:超预算的降级策略。 按优先级丢弃:先丢最老的对话 → 再触发摘要压缩 → 再丢低相关度 RAG 文档 → 如果还不够,明确告诉用户"对话太长,请开启新会话"。宁可降级,不要硬塞导致 API 报错。
这里有个反直觉的点:RAG 文档的优先级要高于早期对话。 因为早期对话的信息大概率已经进了摘要,而 RAG 文档是当前问题的答案依据,丢了就直接答错。
三种方案怎么选?面试这样答
| 滑动窗口 | 零 | 只记最近 N 轮 | 客服、单轮问答 |
| 摘要记忆 | 低 | 记关键事实,丢细节 | 多轮业务对话 |
| 向量记忆 | 高 | 精准召回,容量大 | Agent、长期记忆 |
生产环境的正确姿势是组合拳:滑动窗口保底(防止超窗报错)+ 摘要记忆兜底(保留关键事实)+ 向量记忆增强(需要时精准召回)。
另外两个必答的细节:
第一,Token 预算要主动控制。 不要等窗口满了再截断。每次组装请求前,估算一下总 Token(系统提示 + 历史 + 检索 + 问题),给当前问题留足空间。常见做法:历史压缩到窗口的 50% 以内,检索结果 20%,系统提示 15%,问题 15%。
第二,128K 窗口不是让你全塞进去的。 这是面试官最爱挖的坑。窗口越大越贵(按 Token 计费)、越慢(处理时间长)、越容易分心(注意力被无关内容稀释)。上下文管理的目标不是"塞满",是"只带该带的"。
🎯 面试官视角的标准回答
如果面试官问:"长对话中 AI 失忆了怎么办?"
先解释根因:大模型本身没有记忆,所谓多轮对话是把历史重新拼进 Prompt 再发送。上下文窗口有限,历史太长就会超窗,框架自动截断最早的部分,导致 AI"失忆"。我的解决方案是三层记忆:第一层,滑动窗口保底。保留最近 N 轮,防止超窗报错。这是兜底方案,保证系统不崩。第二层,摘要记忆。每隔几轮让模型把历史压缩成摘要,保留关键事实。这样即使早期对话被丢弃,用户说过的关键信息(比如买了什么保险、什么病情)还在摘要里。第三层,向量记忆。把历史对话向量化存库,提问时语义检索最相关的片段。适合 Agent 和需要长期记忆的场景。另外我会主动做 Token 预算管理:每次请求前估算各部分的 Token 占比,给当前问题留足空间。还要强调一点:上下文窗口不是越大越好,越大越贵越慢,记忆管理的核心是"只带该带的"。
下一篇聊 AIGC 面试必考的另一座大山——幻觉。AI 一本正经地胡说八道,根因到底是什么?RAG、提示约束、解码参数、事后校验,四层防线怎么搭?


评论前必须登录!
注册