 网硕互联帮助中心
🔥 本文专栏:CUDA 🌸作者主页:努力努力再努力wz
💪 今日博客励志语录:理论真正开始变成自己的东西,往往不是在“听懂”的时候,而是在亲手把第一段代码编译出来的时候。
思维导图
CUDA 理论基础
↓
不能只停留在 Grid / Block / Thread / 显存这些概念
↓
开始真正编写 CUDA C++ 代码
↓
首先解决一个问题:CUDA 程序到底怎么被编译出来?
↓
普通 C++
.cpp → g++ → 可执行文件
↓
CUDA C++
.cu → nvcc
↓
一个 .cu 中可以同时存在
Host Code(CPU) + Device Code(GPU)
↓
nvcc 作为整个 CUDA 编译流程的入口
↓
Host Code → Host C++ Compiler
Device Code → NVIDIA Device 编译链
↓
最终组合并链接成可执行文件
↓
进一步认识 CUDA 源码本身
↓
CUDA 语言扩展
__global__ / __device__ / <<< >>> 等
↓
这些不是普通库函数,而是编译器能够识别的 CUDA C++ 语言扩展
↓
CUDA Runtime API
cudaMalloc / cudaMemcpy / cudaFree 等
↓
属于运行库 API,与语言扩展是两个层次
↓
继续明确 Host / Device 的执行边界
↓
普通 Host 函数不能直接在 Device 中调用
Device 代码只能调用具有 Device 侧实现的函数
↓
printf 是 CUDA 特殊支持的 Device-side 函数之一
std::cout / 普通 std::vector 则不能直接放进 Kernel 中使用
↓
编写第一个 hello.cu
↓
nvcc hello.cu -o hello
↓
成功生成可执行文件
引入
在此前学习 CUDA 的过程中,我们已经认识了很多理论上的概念,例如:
CPU / GPU
Host / Device
Grid
Block
Thread
Warp
Global Memory
Shared Memory
Kernel
这些概念能够帮助我们理解 GPU 到底是怎样组织计算的,但是如果一直停留在理论层面,很容易出现一个问题:
每个概念似乎都认识,但是一旦真正看到一个 .cu 文件,却不知道这些概念究竟对应代码中的哪一部分。
因此接下来需要开始把理论映射到真正的 CUDA C++ 代码中。
不过在真正研究 cudaMalloc、cudaMemcpy、线程索引以及矩阵计算之前,我觉得更应该先把最底层的一条链路理顺:
CUDA 源代码
↓
究竟由谁编译?
↓
CPU 代码和 GPU 代码如何共存在一个程序中?
↓
最后又怎样生成一个可执行文件?
这也是本文首先要解决的问题。
一、普通 C++ 程序是怎样被编译出来的
在理解 CUDA 之前,可以先回到我们最熟悉的普通 C++。
假设存在一个:
main.cpp
其中只包含普通 CPU 代码,那么在 Linux 下最常见的流程就是:
g++ main.cpp -o main
整体可以简单理解为:
main.cpp
↓
g++
↓
预处理 / 编译 / 汇编 / 链接
↓
main
↓
./main
↓
CPU 执行
也就是说,对于普通 C++ 程序,我们面对的基本就是:
C++ Source Code
↓
Host Compiler
↓
CPU 可执行程序
但是 CUDA 程序会多出一个非常明显的问题:
同一个程序中,不仅存在 CPU 要执行的代码,同时还存在 GPU 要执行的代码。
因此,它不能再简单地全部交给普通 g++ 处理。
二、CUDA 程序本质上是 Host Code + Device Code
一个 CUDA C++ 程序通常不是“只有 GPU 代码”。
相反,一个非常典型的 CUDA 程序实际上由两部分共同组成:
CUDA Program
│
├── Host Code
│ └── CPU 执行
│
└── Device Code
└── GPU 执行
例如后面会使用的第一段代码:
#include <cstdio>
__global__ void helloFromGPU()
{
printf("Hello from GPU\\n");
}
int main()
{
printf("Hello from CPU\\n");
helloFromGPU<<<1, 1>>>();
return 0;
}
其中:
int main()
属于正常的 Host 代码,也就是 CPU 侧程序入口。
而:
__global__ void helloFromGPU()
则声明了一个 CUDA Kernel,它的函数体最终在 GPU 上执行。
因此同一个源码文件中实际上同时存在:
CPU 世界
+
GPU 世界
这也是 CUDA 编译与普通 C++ 编译相比最核心的区别之一。
三、nvcc:CUDA 编译流程的总入口
既然同一个 CUDA 源文件中可能同时存在 Host Code 和 Device Code,那么就需要一个能够协调两套编译流程的入口。
这个入口就是:
nvcc
nvcc 全称可以理解为 NVIDIA CUDA Compiler Driver。
这里“Driver”这个词很重要,因为我们不应该简单地把它理解成:
nvcc 自己一个程序把 CPU 代码和 GPU 代码全部直接编译完。
更准确的心智模型应该是:
hello.cu
↓
nvcc
│
├── Host Code
│ ↓
│ Host C++ Compiler
│ Linux 下通常是 gcc / g++
│ ↓
│ Host Object Code
│
└── Device Code
↓
NVIDIA CUDA Device 编译链
↓
PTX / GPU Binary 等 Device Code
随后 Device 代码会被嵌入 Host 侧目标文件,并与 CUDA Runtime 等所需内容完成后续链接,最终得到一个普通的可执行文件。
因此可以先把 nvcc 理解成:
CUDA 整个编译流程的“总调度入口”。
NVIDIA 官方文档对这一点的描述也很明确:CUDA 源文件可以同时包含传统 C++ Host 代码和 GPU Device 函数,nvcc 会协调 Host 编译器以及 NVIDIA 自己的 Device 编译工具链完成处理。
四、先准备 CUDA 编译环境
既然现在的目标首先是:
.cu
↓
nvcc
↓
可执行文件
那么第一件事就是检查当前机器有没有 nvcc。
执行:
nvcc –version
一开始当前 Ubuntu 云服务器中并没有安装 nvcc:
Command 'nvcc' not found
因此安装 CUDA Toolkit 后,再次检查:
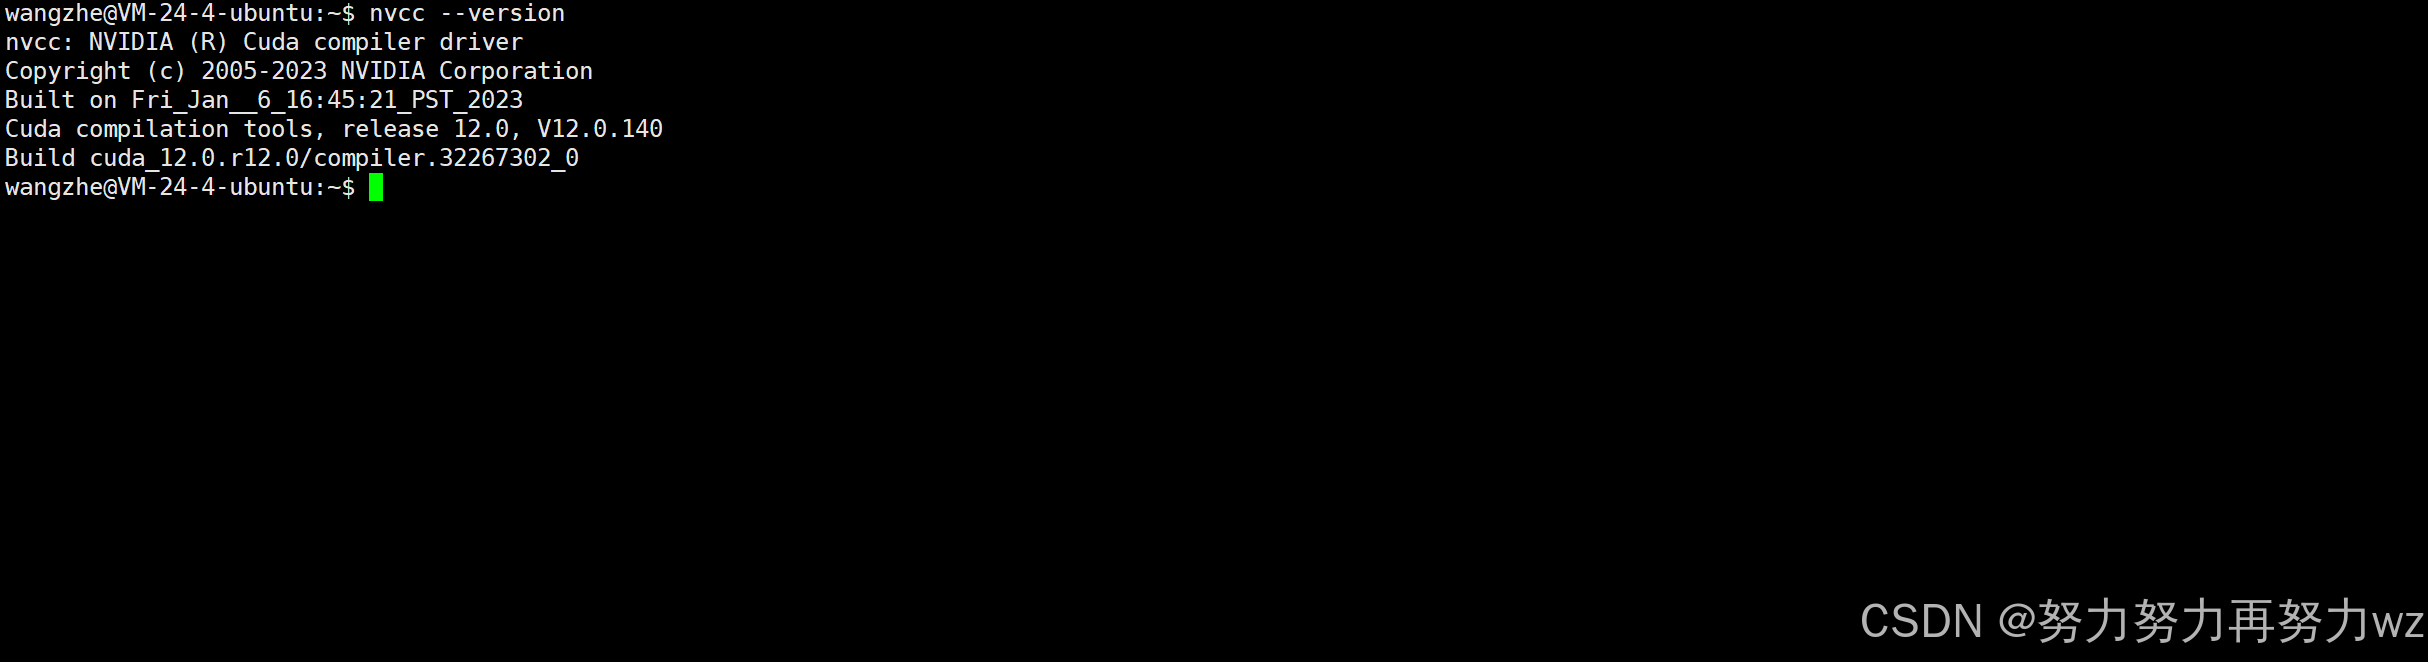
nvcc –version
当前环境输出为:
nvcc: NVIDIA (R) Cuda compiler driver
Cuda compilation tools, release 12.0, V12.0.140
也就是说,当前使用的是 CUDA 12.0 的编译工具链。
至此,至少已经具备了:
CUDA Toolkit ✅
nvcc ✅
CUDA 12.0 ✅
五、没有 GPU,还能不能学习 CUDA 编译?
这里又遇到了另一个问题。
当前使用的是一台云服务器,所以继续检查:
nvidia-smi
结果发现命令本身不存在。
随后进一步执行:
lspci | grep -i nvidia
同样没有任何 NVIDIA 设备输出。
因此对于这台虚拟机,更准确的说法是:
当前虚拟机并没有向系统暴露可用的 NVIDIA GPU 设备。
这意味着目前不能真正完成:
CPU 发起 Kernel
↓
CUDA Runtime / Driver
↓
NVIDIA GPU
↓
真正执行 GPU 指令
但是这里需要把编译和运行明确区分开。
1. 编译阶段
hello.cu
↓
nvcc
↓
Host + Device Code 编译
↓
链接
↓
hello
这一阶段的重点是把 CUDA 源码转换成最终可执行文件。
2. 运行阶段
./hello
↓
CPU 启动进程
↓
程序发起 CUDA Kernel
↓
CUDA Driver 找到 NVIDIA GPU
↓
GPU 执行 Kernel
当前机器缺少的是第二部分真正能够执行 Kernel 的 GPU 环境。
因此本文先将目标收窄:
先跑通 CUDA 源码的编译链路,暂时不讨论真正的 GPU 运行过程。
这并不妨碍我们认识 .cu、nvcc、Host/Device Code 以及 CUDA C++ 的基本代码结构。
六、为什么 CUDA 源文件通常使用 .cu
普通 C++ 文件通常使用:
.cpp
.cc
.cxx
而当一个文件中包含 CUDA Device 代码或者 Host + Device 混合代码时,通常使用:
.cu
例如:
hello.cu
vector_add.cu
matrix_mul.cu
可以先建立这样一个最直观的区分:
纯 Host C++ 代码
↓
.cpp
↓
g++ / clang++
包含 CUDA Device Code
↓
.cu
↓
nvcc
需要注意的是:
.cu 并不意味着这个文件里面全部都是 GPU 代码。
一个 .cu 完全可以同时包含:
普通 C++ Host Code
+
CUDA Device Code
这也是实际 CUDA 工程中非常常见的写法。
除此之外,还经常会看到:
.cuh
它通常被作为 CUDA 相关头文件的命名约定,例如:
kernel.cuh
operator.cuh
不过 .cuh 更多属于工程上的常见约定,并不是说所有 CUDA 头文件都必须使用这个后缀。
七、为什么没有 #include <cuda_runtime.h> 也能写 __global__
第一次看到下面这段代码时,很容易产生一个疑问:
#include <cstdio>
__global__ void helloFromGPU()
{
printf("Hello from GPU\\n");
}
这里只有:
#include <cstdio>
却没有显式引入:
#include <cuda_runtime.h>
那么为什么:
__global__
仍然能够正常识别?
核心原因在于:
CUDA C++ 的“语言扩展”和 CUDA Runtime 提供的“库 API”不是同一个层次。
1. CUDA 语言扩展
例如:
__global__
__device__
__host__
<<<grid, block>>>
这些内容不是某个普通函数库中提供的函数。
它们属于 CUDA C++ 的语言扩展,由 CUDA 编译器直接识别。
这个感觉和普通 C++ 中的:
sizeof
new
auto
有些类似。
例如我们使用:
sizeof(int)
并不是因为某个头文件里面声明了一个叫 sizeof() 的函数,而是因为编译器本身就认识这种语法。
同理:
__global__ void kernel()
以及:
kernel<<<1, 1>>>();
是 nvcc 能够识别的 CUDA C++ 语言结构。
所以这里可以建立:
CUDA 语言扩展
│
├── __global__
├── __device__
├── __host__
└── <<< >>> Kernel Launch Syntax
↓
由 CUDA 编译器理解
而不是普通库函数调用
2. CUDA Runtime API
另一类则是:
cudaMalloc()
cudaMemcpy()
cudaFree()
cudaDeviceSynchronize()
cudaGetLastError()
这些就不是语言语法了,而是真正的 CUDA Runtime API。
概念上可以理解为:
CUDA Runtime API
↓
对应函数声明
↓
cuda_runtime.h
↓
最终还需要链接 CUDA Runtime
因此从代码阅读的角度来看,我们需要明确:
__global__
↓
语言扩展
cudaMalloc()
↓
Runtime API
这是两个完全不同的层次。
一个容易忽略的细节
严格来说,使用 nvcc 编译 .cu 文件时,nvcc 默认会在翻译单元顶部隐式包含 cuda_runtime.h。
因此某些 CUDA Runtime API 即使源码中没有手写:
#include <cuda_runtime.h>
也可能仍然能够成功编译。
但是这并不会改变上面的核心区别:
__global__、Kernel Launch 语法属于 CUDA C++ 语言层;cudaMalloc、cudaMemcpy 等属于 CUDA Runtime API 层。
实际写代码时,如果直接使用 CUDA Runtime API,显式写出:
#include <cuda_runtime.h>
通常也更有利于表达当前源码的依赖关系。
八、Host 和 Device 之间存在明确的函数调用边界
认识了语言扩展以后,还需要继续解决一个更重要的问题:
CPU 代码和 GPU 代码虽然可以写在同一个 .cu 文件中,但是它们并不是处于同一个执行世界。
可以先把函数分成三类。
1. 普通函数:默认属于 Host
例如:
void func()
{
}
如果没有添加任何 CUDA 执行空间修饰符,那么它默认就是 Host 函数。
也可以粗略看成:
__host__ void func()
{
}
它由 CPU 执行。
2. __device__:GPU 内部函数
例如:
__device__ int add(int a, int b)
{
return a + b;
}
这个函数:
在 GPU 上执行
并由 Device Code 调用
例如 Kernel 内部可以调用:
__global__ void kernel()
{
int x = add(1, 2);
}
3. __global__:Kernel
例如:
__global__ void kernel()
{
}
最基础的心智模型就是:
Host 侧发起 Kernel Launch
↓
kernel<<<grid, block>>>()
↓
Device / GPU 执行 Kernel 函数体
因此 __global__ 函数就是连接 Host 与 Device 的一个非常重要的入口。
九、为什么 Kernel 里面能够调用 printf
这里又出现了一个很有意思的问题。
我们的 Kernel 是:
__global__ void helloFromGPU()
{
printf("Hello from GPU\\n");
}
但是我们知道,普通程序中的 printf 本来属于 C/C++ 运行库中的函数。
那么 GPU 代码为什么能够调用它?
如果简单理解成:
GPU Kernel
↓
直接调用 CPU 上 glibc 的 printf
那肯定是不对的。
因为 Host Code 与 Device Code 之间存在明确边界。
真正的原因是:
CUDA 专门为 Device Code 提供了 Device-side printf 支持。
所以 Kernel 中:
printf("Hello from GPU\\n");
调用的是 CUDA 支持的 Device 侧输出机制,而不是让 GPU 跑去直接执行 CPU 上的普通 libc 实现。
可以简单理解为:
GPU Thread
↓
Device-side printf
↓
记录输出参数 / 信息
↓
由 CUDA 运行机制最终把格式化输出呈现在 Host 输出流中
因此这里真正应该建立的规则是:
Device Code 只能调用具有 Device 侧实现或者被 CUDA 明确支持的函数。
十、为什么不能在 Kernel 中随便使用 std::cout 和 std::vector
有了上面的边界以后,下面这种代码就很好理解了:
#include <iostream>
__global__ void kernel()
{
std::cout << "hello";
}
普通情况下这不能直接成立。
原因不是:
<iostream> 没有 include 成功
而是:
当前正在编译 Device Code
↓
std::cout 属于普通 Host C++ 标准库实现
↓
没有可供这个 Kernel 直接执行的 Device 版本
↓
无法这样使用
类似地:
#include <vector>
__global__ void kernel()
{
std::vector<int> values;
}
普通的 std::vector 同样不能直接被当成 GPU Device 容器在 Kernel 中使用。
所以可以形成一个非常重要的判断过程:
当前代码是否位于 __global__ / __device__ 函数?
↓
是
↓
准备调用某个函数 / 使用某个库能力
↓
它是否存在 Device 侧可执行实现?
↓
┌───────┴───────┐
↓ ↓
有 没有
↓ ↓
可以 不可以
printf 之所以能够使用,不是因为 GPU 可以随意使用 CPU 标准库,而是因为 CUDA 对它进行了 Device 侧支持。
后面的 CUDA 生态中还会存在 Thrust、libcu++ 等专门面向 CUDA / Device 的 C++ 能力,这属于进一步学习的内容。当前阶段先把最基本的 Host/Device 边界建立起来即可。
十一、编写第一个 CUDA C++ 程序
在认识完前面的代码结构以后,就可以真正创建第一份 CUDA 源文件:
vim hello.cu
内容如下:
// hello.cu
#include <cstdio>
__global__ void helloFromGPU()
{
printf("Hello from GPU\\n");
}
int main()
{
printf("Hello from CPU\\n");
helloFromGPU<<<1, 1>>>();
return 0;
}
实际源码如下图所示:
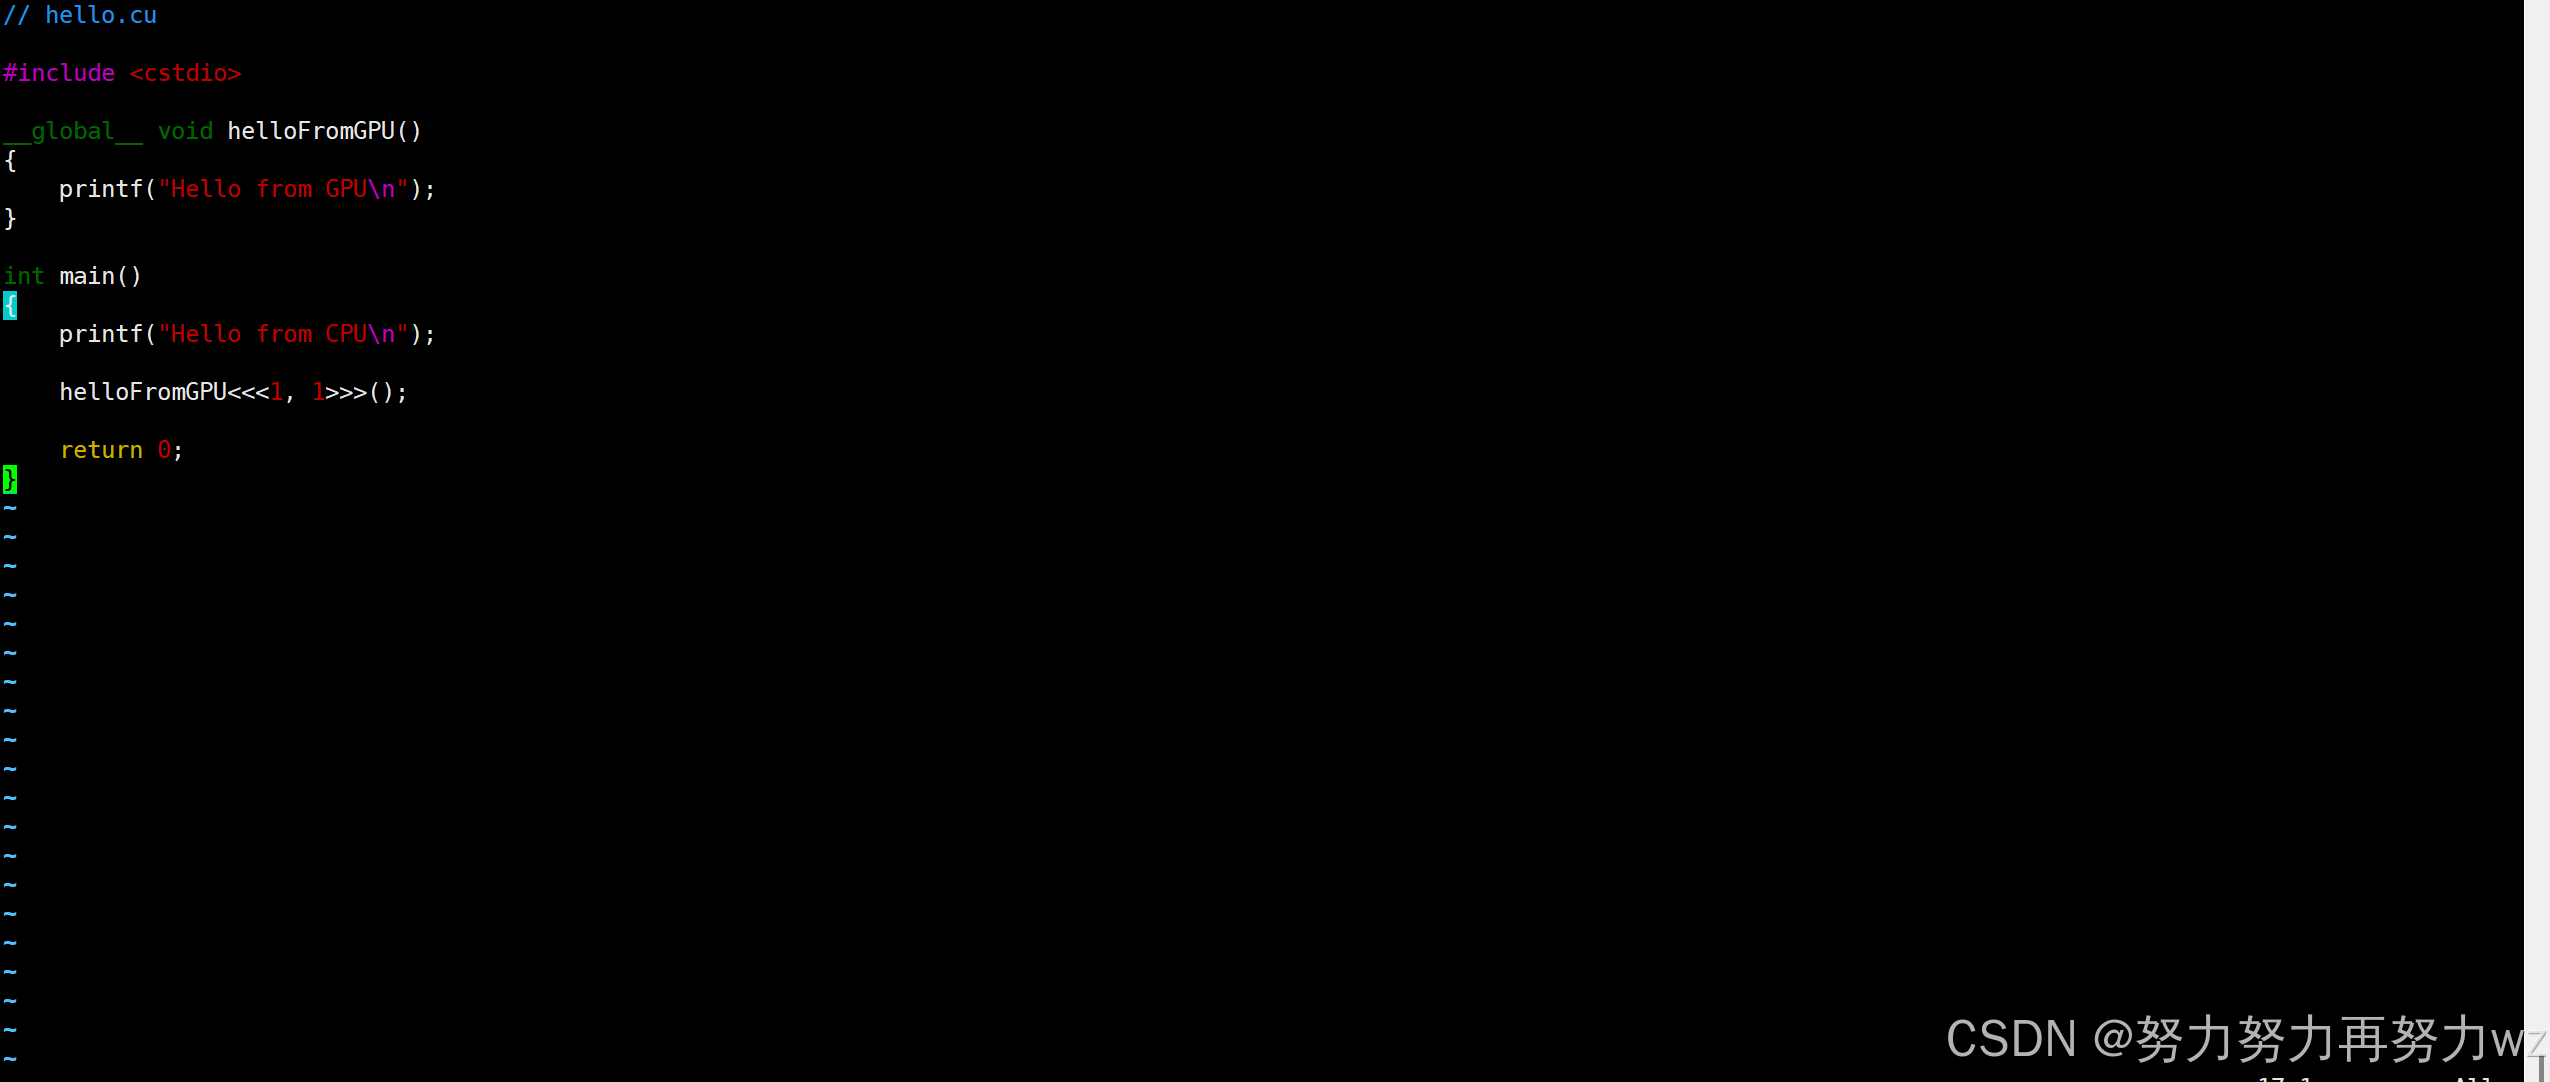
这段代码虽然很短,但是已经包含了 CUDA 程序最核心的两个执行世界。
Host 侧
int main()
{
printf("Hello from CPU\\n");
helloFromGPU<<<1, 1>>>();
return 0;
}
这里由 CPU 执行。
其中:
helloFromGPU<<<1, 1>>>();
不是普通 C++ 函数调用,而是 CUDA Kernel Launch。
目前暂时只需要知道:
<<<1, 1>>>
描述了 Kernel 的执行配置。
后面再继续把它和:
Grid
Block
Thread
映射起来。
Device 侧
__global__ void helloFromGPU()
{
printf("Hello from GPU\\n");
}
这个函数体最终由 GPU 执行。
因此整个源码可以简单画成:
hello.cu
│
├── Host Code
│ └── main()
│ └── CPU 执行
│
└── Device Code
└── helloFromGPU()
└── GPU 执行
十二、使用 nvcc 完成第一次 CUDA 编译
源码写完以后,执行:
nvcc hello.cu -o hello
这条命令和我们以前使用的:
g++ main.cpp -o main
在使用体验上非常相似。
其中:
hello.cu
是输入 CUDA 源文件。
而:
-o hello
表示最终生成名为:
hello
的可执行文件。
执行以后终端没有打印任何错误信息,然后继续:
ls -l
可以看到:
hello
hello.cu
其中 hello 已经带有可执行权限。
实际结果如下:
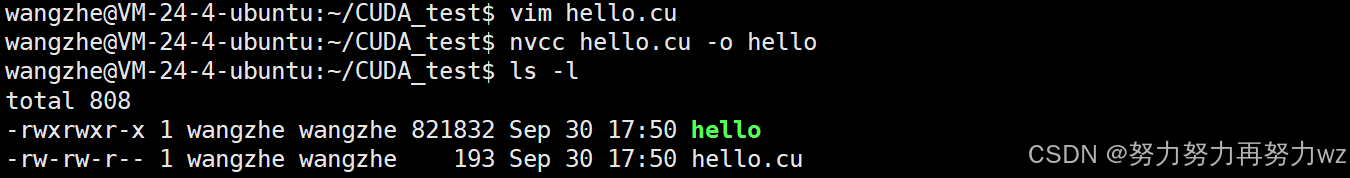
这意味着第一条 CUDA 编译链已经真正跑通:
hello.cu
↓
nvcc hello.cu -o hello
↓
解析 CUDA C++
↓
Host Code + Device Code 分别进入对应编译流程
↓
Device Code 被组合进 Host 侧目标文件
↓
完成链接
↓
hello
这里还有一个和 g++ 很相似的现象:
编译成功时,编译器通常不会专门输出一段“编译成功”。没有报错,本身往往就是成功。
最终再通过 ls -l 或者直接检查目标文件,就能够确认可执行文件已经生成。
十三、现在为什么暂时不执行 ./hello
正常情况下,编译完成以后下一步自然会执行:
./hello
但是当前云服务器没有向虚拟机暴露 NVIDIA GPU。
因此如果真正进入运行阶段:
./hello
↓
CPU 执行 main()
↓
遇到 helloFromGPU<<<1, 1>>>()
↓
CUDA Runtime 尝试启动 Kernel
↓
需要可用 NVIDIA Device
当前环境就在最后这里缺少真实 GPU。
所以本文暂时只完成:
CUDA Source Code
↓
CUDA Compilation
↓
Executable
至于真正:
Host Launch Kernel
↓
GPU Execute Kernel
后面可以换到带 NVIDIA GPU 的环境,例如公司的 Jetson Orin 或者 GPU 云主机以后继续验证。
这也再次说明:
CUDA Toolkit / nvcc
解决的是:CUDA 程序能不能被编译
NVIDIA GPU + Driver
解决的是:Device Code 能不能真正被执行
这两个问题需要明确区分。
十四、重新整理整个 CUDA C++ 编译心智模型
到这里,可以把本文所有内容重新串成一条完整链路。
首先,普通 C++ 程序是:
.cpp
↓
g++
↓
CPU 可执行文件
但是 CUDA 程序中同时存在:
Host Code
+
Device Code
因此通常使用:
.cu
并交给:
nvcc
作为整个 CUDA 编译流程的入口。
然后:
hello.cu
│
↓
nvcc
│
┌───────┴────────┐
↓ ↓
Host Code Device Code
↓ ↓
Host C++ Compiler CUDA Device Toolchain
↓ ↓
CPU Object GPU Code / Fatbinary
└───────┬────────┘
↓
最终链接
↓
hello
与此同时,在源码层面还需要区分:
CUDA C++
│
├── 语言扩展
│ ├── __global__
│ ├── __device__
│ ├── __host__
│ └── <<< >>>
│
└── CUDA Runtime API
├── cudaMalloc
├── cudaMemcpy
├── cudaFree
└── cudaDeviceSynchronize
最后还必须保持 Host/Device 边界意识:
Host Code
↓
CPU 世界
Device Code
↓
GPU 世界
GPU Kernel 不是把 CPU 的整个 C++ 运行环境直接搬过去。
Kernel 内部只能使用能够被编译为 Device Code 的函数和能力。
因此:
Device-side printf
✅ CUDA 提供支持
普通 std::cout
❌ 不能直接在 Kernel 中这样使用
普通 std::vector
❌ 不能直接作为 Device 容器这样使用
理解了这一层以后,后面再继续学习:
cudaMalloc
cudaMemcpy
cudaFree
threadIdx
blockIdx
blockDim
Grid / Block / Thread
就不再只是单独记几个 API 或几个关键字,而是能够把它们放回完整的 CUDA 程序执行链路中理解。
总结
本文并没有急着进入 CUDA 的矩阵乘法、显存优化或者复杂 Kernel,而是先解决了最基础的代码与编译问题。
首先,CUDA C++ 程序通常同时包含 CPU 侧的 Host Code 和 GPU 侧的 Device Code,因此它与普通只面向 CPU 的 C++ 程序存在明显区别。
其次,.cu 是包含 CUDA Device Code 或 Host/Device 混合代码时最常见的源文件后缀,而 nvcc 则负责协调整个 CUDA 编译过程。Host Code 会交给 Host C++ 编译器处理,Device Code 则进入 NVIDIA 的 Device 编译链,最后再组合成最终的可执行文件。
再次,需要明确 CUDA 的语言扩展和 CUDA Runtime API 并不是同一个东西。__global__、__device__ 以及 Kernel Launch 语法属于 CUDA C++ 语言层,而 cudaMalloc、cudaMemcpy 等则属于 Runtime API。
此外,Host 与 Device 之间存在明确的执行边界。普通 CPU 函数和 Host 标准库能力不能想当然地放到 Kernel 内部使用;Kernel 中能够调用的函数必须具有 Device 侧可执行实现。printf 是 CUDA 专门支持的 Device-side 函数,因此才可以出现在 Kernel 中。
最后,我们已经真正完成:
hello.cu
↓
nvcc hello.cu -o hello
↓
hello
第一次 CUDA C++ 编译链路已经跑通。
当前云服务器虽然没有 NVIDIA GPU,因此还不能真正执行 Kernel,但是这并不影响我们先把 CUDA 的源码结构、Host/Device 边界以及 nvcc 编译模型建立起来。
下一步就可以在这个基础上继续向真正的 CUDA Runtime 编程推进,把:
Host Memory
↓
cudaMalloc
↓
Device Memory
↓
cudaMemcpy
↓
Kernel
这一条数据与执行链真正映射到代码中。


评论前必须登录!
注册