 网硕互联帮助中心
前面4篇学会了发请求、提数据、抓表格、存CSV。能跑通一个小爬虫了,但跑多了就会发现:
- 跑了半小时,最后一页网络超时崩了,前面数据全白干
- 请求太快被网站封了 IP
- 页面结构偶尔变一下,程序直接报错退出
- 网络不稳定,程序卡在那里一动不动
今天这篇是数据采集部分的收尾——把前面的知识串起来,加上几个关键的"防护盾",让你的爬虫遇到问题不崩溃、失败之后能重试、被封之前懂克制。
今天教五招,全是干货。
第一招:超时设置 timeout
爬虫跑着跑着突然不动了,也不报错,大概率是网络问题——请求发出去了,但服务器一直不响应。requests 默认没有超时限制,会一直等。
给它设一个"耐心上限":
import requests
# 最多等10秒,超过就报错
response = requests.get('https://example.com', timeout=10)
超时还能分开设置:连接超时和读取超时。
# 连接超时5秒,读取超时10秒
response = requests.get('https://example.com', timeout=(5, 10))
新手不用纠结太细,统一 10 秒基本够用。
第二招:异常捕获 try-except
光设超时还不够——超时了程序会报错退出。我们希望的是:这一页失败了没关系,记下来,继续爬下一页,别整个程序崩了。
最常见的几种异常:
| requests.exceptions.Timeout | 请求超时 |
| requests.exceptions.ConnectionError | 连不上服务器 |
| requests.exceptions.RequestException | 所有请求异常的老祖宗(兜底用) |
import requests
try:
response = requests.get(url, timeout=10)
response.raise_for_status() # 状态码不是200也会报错
print("请求成功")
except requests.exceptions.Timeout:
print(f"请求超时:{url}")
except requests.exceptions.ConnectionError:
print(f"连接失败:{url}")
except requests.exceptions.RequestException as e:
print(f"请求出错:{url},错误信息:{e}")
注意:response.raise_for_status() 很重要。它检查 HTTP 状态码,404、500 这种错误也会抛出异常。不然你拿到一个 404 页面还以为成功了。
第三招:请求休眠 time.sleep
爬虫爬太快,服务器压力大;而且请求太快容易被识别成爬虫、封 IP。加个休眠,既是礼貌,也是自保。
import requests
import time
for url in urls:
try:
response = requests.get(url, timeout=10)
except Exception as e:
print(f"爬取失败:{url},{e}")
# 每次请求后休眠1秒
time.sleep(1)
进阶:随机休眠更像真人。 固定时间也容易被识别——哪有真人每次都精确等 1 秒?
import random
import time
# 随机休眠1到3秒
time.sleep(random.uniform(1, 3))
第四招:User-Agent 伪装 + 请求头完善
很多网站检查请求头,发现你是 python-requests 直接就拒了。
headers = {
'User-Agent': 'Mozilla/5.0 (Windows NT 10.0; Win64; x64) AppleWebKit/537.36 (KHTML, like Gecko) Chrome/120.0.0.0 Safari/537.36',
'Referer': 'https://example.com/', # 从哪个页面点过来的
'Accept': 'text/html,application/xhtml+xml,application/xml;q=0.9,*/*;q=0.8',
'Accept-Language': 'zh-CN,zh;q=0.9',
}
response = requests.get(url, headers=headers, timeout=10)
记住一个原则:伪装得越像浏览器,越不容易被封。
第五招:重试机制
有时候失败只是暂时的——网络抖一下、服务器刚好忙不过来,重试一下说不定就成了。
import requests
import time
def fetch_url(url, headers, max_retries=3):
"""
带重试的请求函数
max_retries: 最多重试次数
"""
for attempt in range(1, max_retries + 1):
try:
response = requests.get(url, headers=headers, timeout=10)
response.raise_for_status()
return response # 成功就返回
except requests.exceptions.RequestException as e:
print(f"第 {attempt} 次请求失败:{e}")
if attempt < max_retries:
# 重试间隔递增:第1次等2秒,第2次等4秒
wait_time = attempt * 2
print(f"等待 {wait_time} 秒后重试…")
time.sleep(wait_time)
else:
print(f"已重试 {max_retries} 次,最终失败")
return None
三个设计细节:
五招合体:完整健壮爬虫模板
五招都教完了,把它们全部整合成一个可以直接拿去改的完整模板:
import requests
import time
import random
import csv
from bs4 import BeautifulSoup
# ========== 配置区 ==========
BASE_URL = 'https://example.com/list?page=' # 目标网站基础URL
TOTAL_PAGES = 10 # 总页数
OUTPUT_FILE = 'data.csv' # 输出文件名
HEADERS = {
'User-Agent': 'Mozilla/5.0 (Windows NT 10.0; Win64; x64) AppleWebKit/537.36 (KHTML, like Gecko) Chrome/120.0.0.0 Safari/537.36',
'Referer': 'https://example.com/',
}
MAX_RETRIES = 3 # 最大重试次数
SLEEP_MIN = 1 # 最短休眠时间(秒)
SLEEP_MAX = 3 # 最长休眠时间(秒)
TIMEOUT = 10 # 请求超时时间(秒)
# ========== 核心函数 ==========
def fetch_page(url):
"""带重试的页面请求函数"""
for attempt in range(1, MAX_RETRIES + 1):
try:
response = requests.get(url, headers=HEADERS, timeout=TIMEOUT)
response.raise_for_status()
response.encoding = 'utf-8'
return response
except requests.exceptions.Timeout:
print(f"第{attempt}次请求超时:{url}")
except requests.exceptions.ConnectionError:
print(f"第{attempt}次连接失败:{url}")
except requests.exceptions.RequestException as e:
print(f"第{attempt}次请求异常:{e}")
if attempt < MAX_RETRIES:
time.sleep(attempt * 2) # 重试间隔递增
else:
print(f"{url} 重试{MAX_RETRIES}次后仍失败,跳过")
return None
def parse_data(html_text):
"""解析页面提取数据(根据实际网站结构修改)"""
soup = BeautifulSoup(html_text, 'html.parser')
items = []
for item in soup.select('.item'):
items.append({
'标题': item.select_one('.title').get_text(strip=True),
'日期': item.select_one('.date').get_text(strip=True),
})
return items
def save_to_csv(data_list, file_name, mode='a'):
"""保存数据到CSV"""
if not data_list:
return
fieldnames = data_list[0].keys()
with open(file_name, mode, newline='', encoding='utf-8-sig') as f:
writer = csv.DictWriter(f, fieldnames=fieldnames)
if mode == 'w':
writer.writeheader()
writer.writerows(data_list)
# ========== 主程序 ==========
def main():
print("爬虫开始运行")
all_data = []
failed_pages = [] # 记录失败的页面
for page in range(1, TOTAL_PAGES + 1):
url = BASE_URL + str(page)
print(f"\\n正在爬取第 {page} 页:{url}")
response = fetch_page(url)
if response is None:
failed_pages.append(page)
time.sleep(random.uniform(SLEEP_MIN, SLEEP_MAX))
continue
try:
items = parse_data(response.text)
all_data.extend(items)
print(f" 提取到 {len(items)} 条数据")
except Exception as e:
print(f" 解析失败:{e}")
failed_pages.append(page)
if page < TOTAL_PAGES:
time.sleep(random.uniform(SLEEP_MIN, SLEEP_MAX))
# 收尾
print(f"\\n爬取完成!成功 {TOTAL_PAGES – len(failed_pages)} 页,失败 {len(failed_pages)} 页")
print(f"共获取 {len(all_data)} 条数据")
if all_data:
save_to_csv(all_data, OUTPUT_FILE, mode='w')
print(f"数据已保存到 {OUTPUT_FILE}")
else:
print("没有获取到任何数据")
if __name__ == '__main__':
main()
模板的特点:
- ✅ 配置区和代码区分开,改参数不用翻代码
- ✅ 每个函数只干一件事,清晰好维护
- ✅ 失败的页面会记录,方便补爬
- ✅ 有进度提示,运行过程不黑盒
- ✅ 最后有统计汇总
以后要爬别的网站,改改配置区和 parse_data 函数就行。
新手常见错误(避坑)
| try-except 写太宽 | except: pass | 只捕获预期异常,异常信息打印出来 |
| 休眠太短/太长 | 0.1秒=没加;10秒=太慢 | 小网站2-3秒,大网站1秒左右 |
| 重试没有次数限制 | while True | 设最大重试次数,3次够了 |
| 所有页面同一个UA | 太明显 | 量大时准备UA列表随机选 |
# UA列表随机选
USER_AGENTS = [
'Mozilla/5.0 (Windows NT 10.0; Win64; x64) AppleWebKit/537.36 Chrome/120.0.0.0',
'Mozilla/5.0 (Macintosh; Intel Mac OS X 10_15_7) AppleWebKit/605.1.15 Version/17.0',
'Mozilla/5.0 (Windows NT 10.0; Win64; x64; rv:121.0) Gecko/20100101 Firefox/121.0',
]
headers = {'User-Agent': random.choice(USER_AGENTS)}
真实运行效果
五招合体的完整模板,用本地模拟数据跑一遍(模拟第 2 页第一次请求超时、重试后成功):
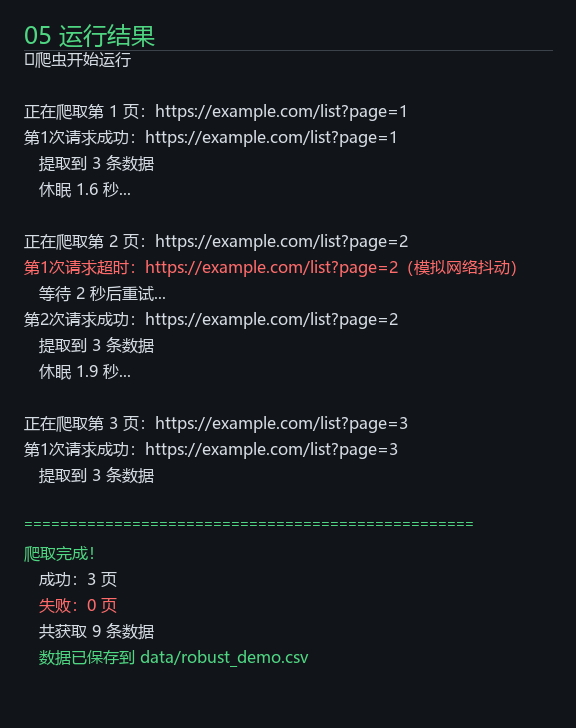
可以看到:第 2 页模拟了一次"超时→自动重试→成功"的完整过程,失败的页面被记录,最终成功页数、失败页数、总数据量一目了然,数据正常写入 CSV。这就是工程化爬虫该有的样子——出问题不崩、失败能重试、收尾有统计。
总结
到这里,数据采集部分的5篇就全部学完了:
- 第1篇:requests 发请求
- 第2篇:BeautifulSoup 提取数据
- 第3篇:表格数据抓取
- 第4篇:数据存 CSV + 翻页
- 第5篇(本篇):工程化完善,让爬虫"扛造"
5篇下来,你已经能独立写出一个健壮、不容易崩、懂礼貌的小爬虫了。这比网上那种"三行代码爬XX"的玩具爬虫实用多了。
完整可跑工程版(健壮爬虫模板 robust_spider.py)在配套资源包里。
接下来进入 Pandas 的世界:数据怎么清洗、怎么分析、怎么发现价值。
梅雅达编程工作室 · Python数据实战系列第5篇
五招下来,爬虫从"能跑"变成"耐造"了。数据采集收尾,下一篇进 Pandas 的世界。


评论前必须登录!
注册