 网硕互联帮助中心
复杂任务一直有个现实问题:能力越强的模型,调用成本通常也越高。代码仓库分析、跨文件修改、连续工具调用和专业工作流都需要更强的推理能力,但如果每个请求都交给旗舰模型,预算很快就会成为新的限制。
OpenAI 这次发布 GPT-6.1 Sol,给出的方向很直接:它面向复杂编码和专业工作,能力接近 GPT-6 Astra,但标准输入和输出价格只有 Astra 的五分之一。对开发者来说,这不只是多了一个模型名称,而是多了一种把高难度任务放进日常预算的可能。
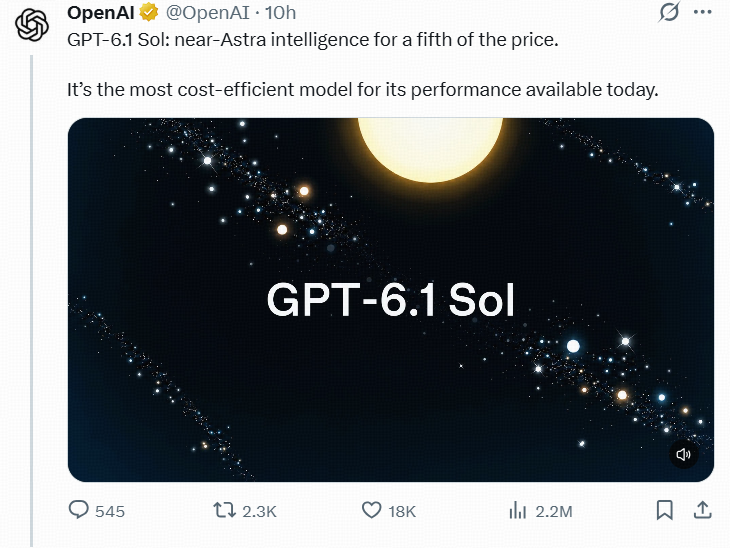 图 1|OpenAI 官方发布 GPT-6.1 Sol。来源:OpenAI 官方 X 发布帖。
编程任务:比较能力,也比较完成任务的成本
GPT-6.1 Sol 的第一个强信号来自 DeepSWE v1.1。这个评测把模型放进真实代码库,要求它完成复杂的软件工程任务。横轴是单任务成本,纵轴是评测得分,因此可以同时看到模型做得怎么样,以及完成一次任务需要付出多少成本。
在这项官方评测中,GPT-6.1 Sol 以大约五分之一的成本,达到与 GPT-6 Astra 相当的水平;相比 GPT-6 Sol 的最高得分,GPT-6.1 Sol 高出 6.4 个百分点。
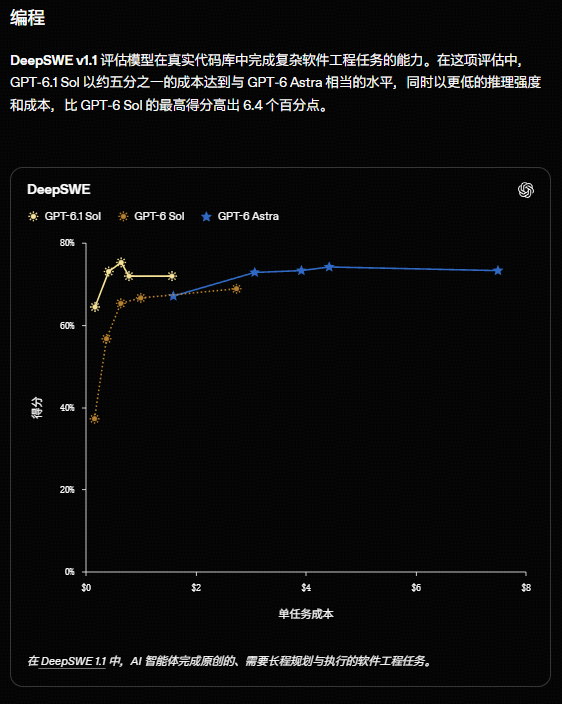 图 2|DeepSWE v1.1 的得分与单任务成本对比。来源:OpenAI GPT-6.1 Sol 官方介绍页。
这张图的关键,不只是 Sol 的点落在 Astra 附近,而是它把“能力”和“成本”放在了一张图里。做复杂编码任务时,开发者可以反过来问:在达到目标质量的前提下,是否有必要每次都调用最贵的模型?
“五分之一”是这项评测中的单任务成本关系,不是所有代码任务都会自动便宜五倍。代码库、上下文长度、工具调用次数和重试次数,都会改变真实费用。但在官方展示的范围内,Sol 已经进入了复杂编码任务的候选名单。
专业工作:模型选择不再只围绕代码
如果只看 DeepSWE,GPT-6.1 Sol 很容易被理解成一个更便宜的代码模型。AutomationBench 展示的是另一面:它衡量模型完成多步骤业务工作流的能力,覆盖销售、营销、运营、支持、财务和人力资源等场景。
这类任务不是生成一段文字就结束了。模型要理解目标、调用工具、推进多个步骤,再把结果整理出来。对企业应用来说,这种连续完成工作的能力,往往比单轮回答更接近真实使用。
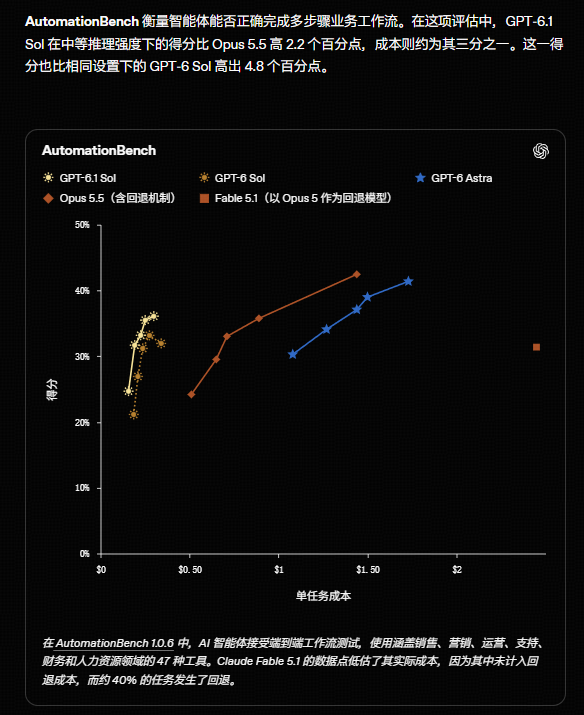 图 3|AutomationBench 多步骤业务工作流评测。来源:OpenAI GPT-6.1 Sol 官方介绍页。
在图中标明的中等推理强度设置下,GPT-6.1 Sol 的得分比 Opus 5.5 高 2.2 个百分点,成本约为其三分之一;相比相同设置下的 GPT-6 Sol,高出 4.8 个百分点。
这个比较必须带上条件。它说明 Sol 在这组业务工作流评测中表现出了更好的成本和得分组合,但不能改写成“Sol 全面超过 Opus 5.5”。不同模型、推理设置和回退机制都会影响结果。
更值得期待的是,模型的应用场景正在从“帮我写一段代码”扩展到“把一项需要多个工具和多个步骤的工作做完”。如果这类任务能以更低的单次成本完成,开发者就有更多空间把复杂能力放进日常业务。
Sol 在模型家族里的位置
OpenAI 给 GPT-6.1 Sol 的定位并不是取代 Astra。官方介绍页把三款模型区分得很清楚:Astra 追求最高综合能力,Sol 试图用更低价格接近 Astra 的智能水平,Luna 面向快速、高效的日常工作。
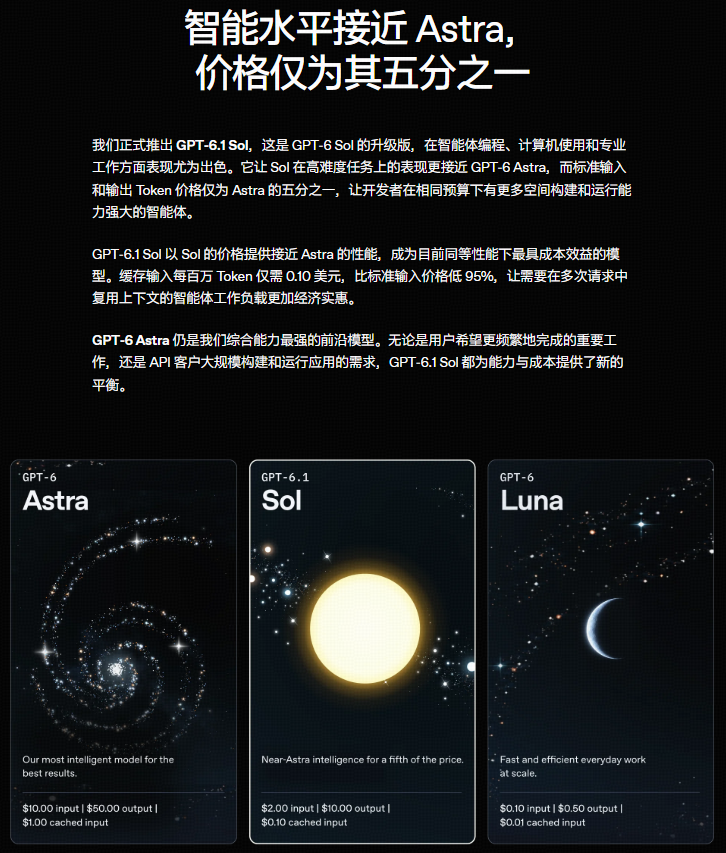 图 4|GPT-6 Astra、GPT-6.1 Sol 与 GPT-6 Luna 的定位和价格。来源:OpenAI GPT-6.1 Sol 官方介绍页。
API Changelog 给出的 GPT-6.1 Sol 标准价格为:每百万 token 输入 2 美元,缓存输入 0.10 美元,缓存写入 2.50 美元,输出 10 美元,支持最高 272K 输入 token。
这些数字要分开看。缓存输入和缓存写入不是同一项费用,输入上限也不等于输出上限。真正的任务成本还取决于上下文长度、输出规模、缓存命中和重试次数。
Sol 给模型选择增加了一档清晰的中间位置:简单请求可以交给更轻量的模型,极端复杂任务继续使用 Astra,而大量需要较强推理能力、又不能无限提高预算的任务,可以优先评估 Sol。
Responses API 又多了一层任务分工
API Changelog 明确写出,GPT-6.1 Sol 在 beta 阶段支持 Multi-agent,模型可以在一次 Responses API 请求中把工作委派给子 Agent。
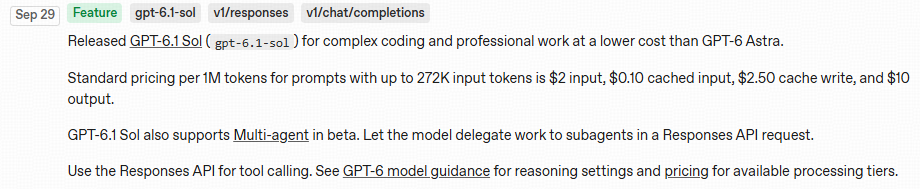 图 5|API Changelog 中关于 GPT-6.1 Sol、Responses API 和 Multi-agent beta 的说明。来源:OpenAI API Changelog。
这意味着复杂任务的拆分和结果汇总开始进入 API 能力范围。开发者不必把所有工作都设计成一次模型调用,而可以围绕一个更大的目标,让模型处理其中的子任务。
但 Changelog 只确认了 Responses API 中的 beta Multi-agent 能力,以及模型向子 Agent 委派工作的描述。它没有在这条公告里说明并发数量、上下文共享方式、权限继承、工具配置或子任务如何计费。因此,Multi-agent 更适合被理解为新的编排入口,而不是自动完成整个项目的开关。
开发者仍然需要定义任务目标、工具权限和结果验收方式。模型负责拆分和推进之后,哪些结果可以直接采用,哪些结果必须复核,依然是应用设计的一部分。
从新模型到真实调用
GPT-6.1 Sol 适不适合一个项目,最终不会只由官方跑分决定。复杂编码任务要看代码库、上下文和工具调用;专业工作流要看任务是否能连续完成;API 接入还要看价格、响应表现、稳定性和实际 token 消耗。
GPT-6.1 Sol 上线后,我在 OkenAI 的模型页面里看到,它已经被单独收录。页面把 OpenAI 官方价格和其他 API 服务线路的输入、输出及缓存读取价格放在同一张表里,旁边还有服务详情入口。
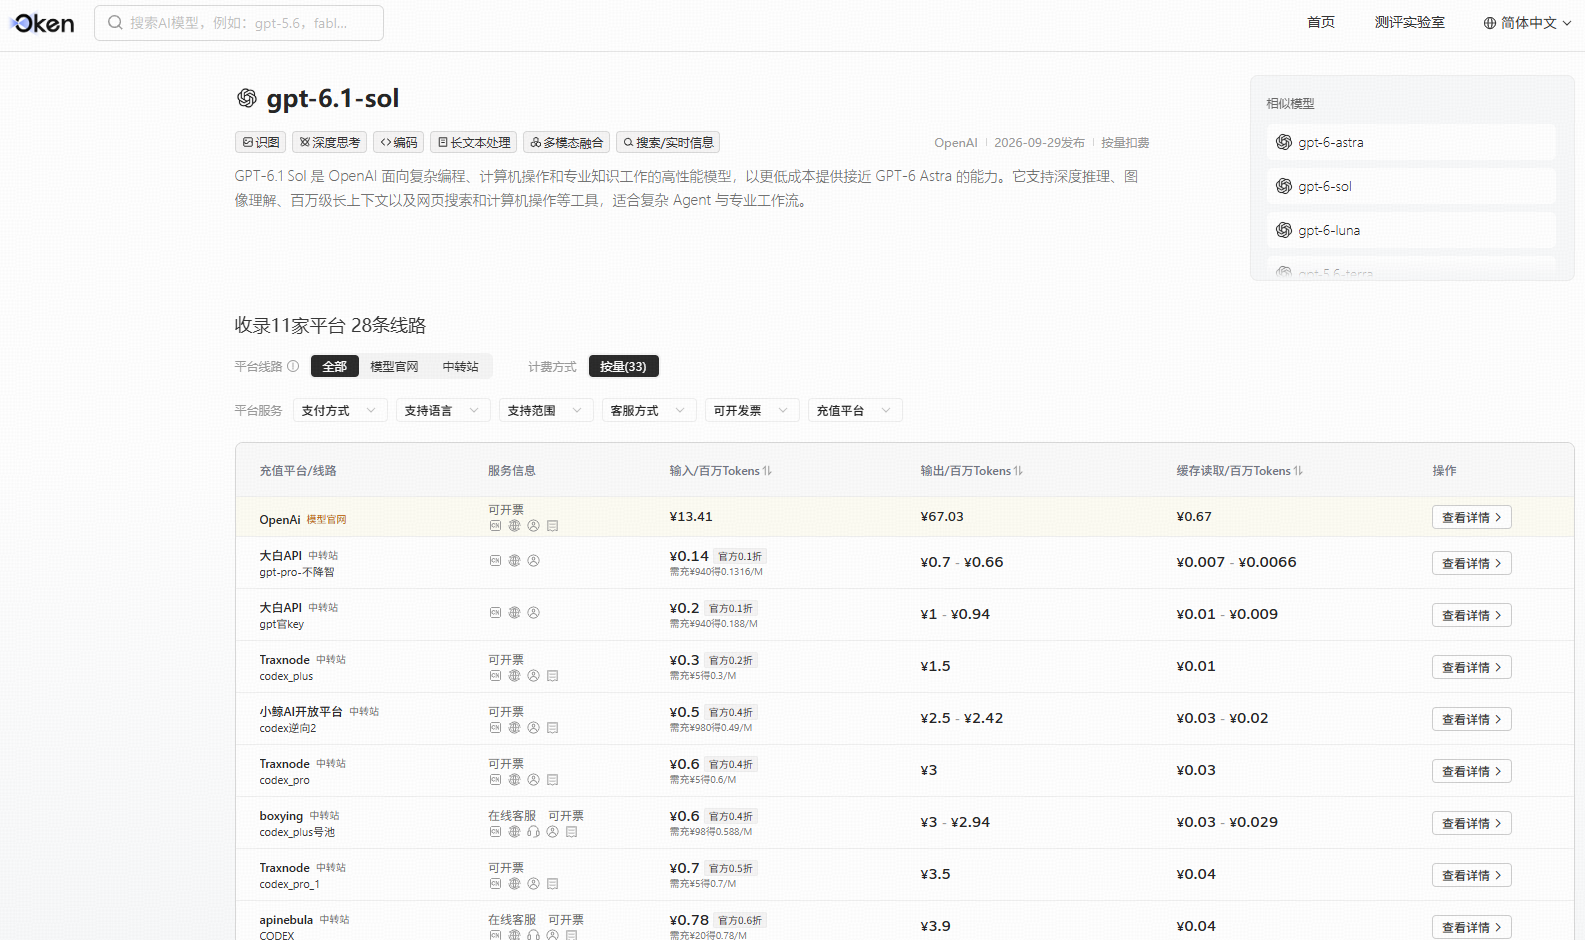 图 6|OkenAI 中的 GPT-6.1 Sol 模型与 API 服务线路。来源:OkenAI 模型详情页截图。
这类页面的价值不在于替开发者直接宣布“哪条线路最好”,而在于把模型名称、服务线路、价格和缓存字段放到同一个比较口径里。官方模型价格可以作为基准,其他线路的折扣、输入输出价格和缓存读取价格则可以先做筛选,再结合稳定性和实际任务表现决定是否接入。
需要区分的是,GPT-6.1 Sol 支持 Responses API 的 Multi-agent beta,是模型和接口能力;某条 API 服务是否完成适配、表现是否稳定,则要看具体线路的数据。Router 负责统一管理和切换线路,不能被理解成模型子 Agent 委派本身。
结语
GPT-6.1 Sol 最值得关注的地方,不是又增加了一个模型 SKU,而是它把复杂任务的能力和成本关系重新摆到了开发者面前。官方评测显示,它在编程和多步骤专业工作中接近更高价模型,同时把标准输入输出价格压到了更容易进入日常预算的区间。
如果你的任务已经超出简单问答,下一步不妨把正在运行的任务拆开看:模型实际消耗了多少 token,完成一次任务花了多少成本,工具调用和响应时间是否稳定。Sol 是否适合你,不应该只看宣传语,而要看它能不能在自己的任务里持续交付相同的结果。


评论前必须登录!
注册