 网硕互联帮助中心
做信息检索类小工具时最常见的痛是:同一个关键词要在三四个网站之间反复切换、复制粘贴,结果页样式不一,还得手动合并重复条目,效率被来回跳转吃掉大半。
常规做法是给每个站点写一段一次性脚本,或者干脆用一个大 Prompt 让模型直接吐结果——前者换个数据源就要重写,后者字段不稳、链接会编、超时无兜底,离可上线的产品还差很远。
本文分享一套用 Codex 驱动开发的聚合搜索方案:适配器统一数据源 + asyncio 并发抓取 + 字段归一去重,配合前端加载态与部署清单,可直接落地。
一、项目定位:一个搜索框吃下多个信息源
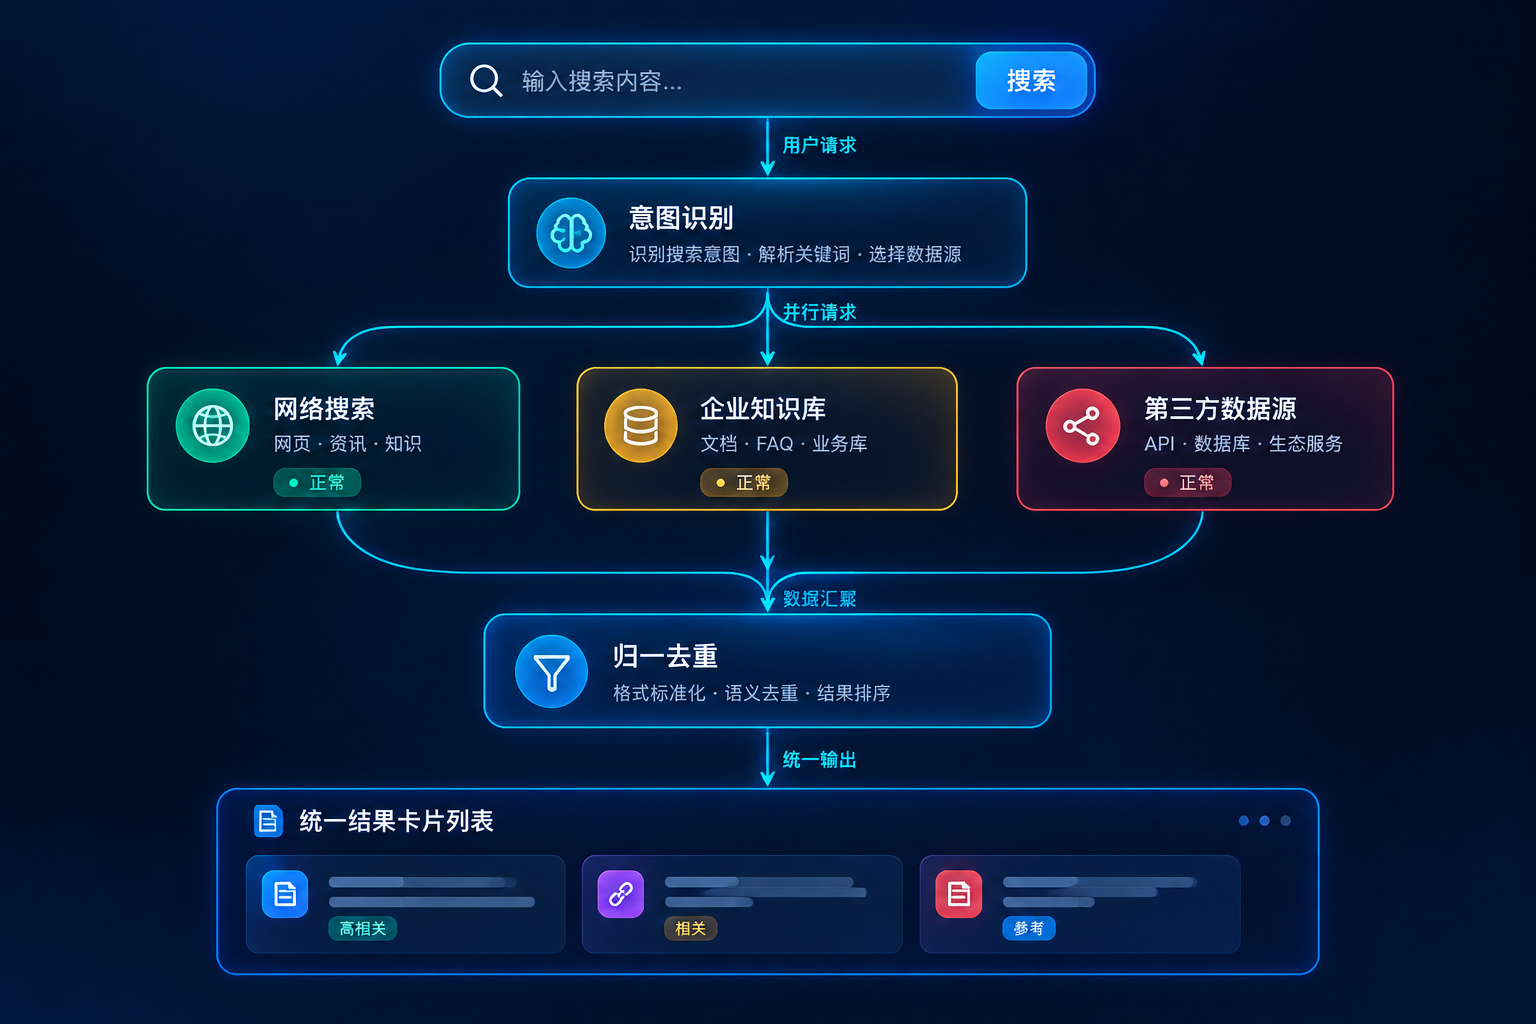
先明确要交付什么:一次输入、多源并行、结果统一,后面所有环节都围绕这个目标展开。
- 单一入口:用户只面对一个输入框与一条结果流,不再关心数据来自哪个站点。
- 统一卡片:所有条目收敛为「标题 / 链接 / 摘要 / 热度」四要素,视觉与信息密度一致。
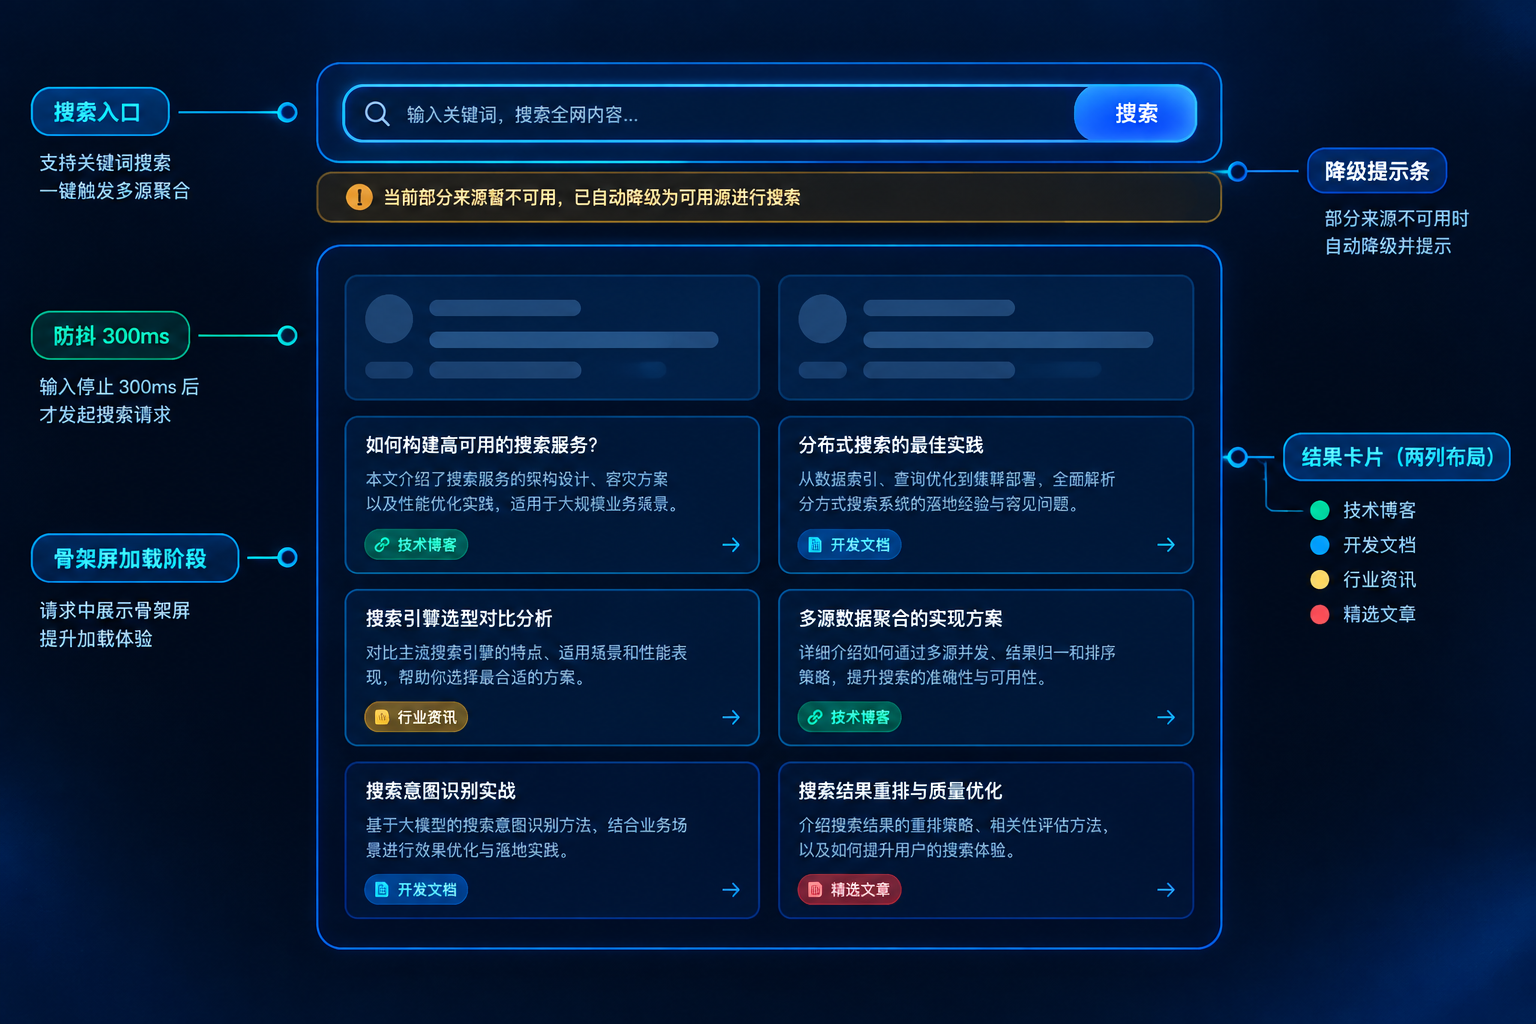
- 失败可容忍:任一数据源超时或报错,其余源照常返回,页面顶部只留一行降级提示。
**核心结论:**聚合搜索的价值不在「搜到更多」,而在「少切换、可比较」。
二、环境与骨架:先让 Codex 跑通最小工程
开工前先把地基打好:后端用 FastAPI,抓取用 httpx,进程与依赖交给 Codex 一次性生成。
# 建项目并装依赖(Python 3.11+,macOS/Linux 均可)
mkdir agg-search && cd agg-search
python -m venv .venv && source .venv/bin/activate
pip install fastapi "uvicorn[standard]" httpx
mkdir -p app/sources templates static
依赖越少,Codex 生成的代码越少出错,调试回路也越短。
接着让 Codex 补一个最小可跑接口,确认链路通了再往上加功能,避免问题堆积到后期。
# app/main.py:最小骨架,只返回固定结果用于联调
from fastapi import FastAPI
from fastapi.responses import HTMLResponse
app = FastAPI(title="agg-search")
@app.get("/api/search")
async def search(q: str = ""):
return {"q": q, "items": [], "took_ms": 0}
@app.get("/", response_class=HTMLResponse)
async def index():
return "<h1>agg-search</h1>"
先跑通空链路 → 再填数据源 → 最后调体验,这是用 Codex 做项目最稳的节奏。
三、需求拆解:把一句话需求变成任务清单
给 Codex 下指令前,先把需求切成可独立验收的小块:颗粒度越细,返工越少。
- 任务切片:数据源接入、并发调度、字段归一、去重排序、前端渲染,各自独立成一个可验证单元。
- 验收前置:每一片都先写清「怎样算通过」,比如「两个源同时超时仍能返回第三个源的 5 条结果」。
- 顺序安排:先做不依赖 UI 的后端链路,UI 只消费 /api/search 的 JSON,两边可并行推进。
推荐的推进顺序如下,Codex 按此分批生成、你逐批跑通:
| 1 | 适配器基类 + 一个真实源 | 单源能返回结构化条目 |
| 2 | 并发调度与超时 | 多源并发耗时不超过最慢源上限 |
| 3 | 归一与去重 | 同一链接只出现一次 |
| 4 | 前端卡片与加载态 | 慢源时仍有骨架屏与降级提示 |
| 5 | 部署脚本 | 一条命令起服务并健康检查通过 |
**核心结论:**需求不切片,Codex 给的就是一坨跑不动的大代码。
四、数据源接入:用适配器抹平接口差异
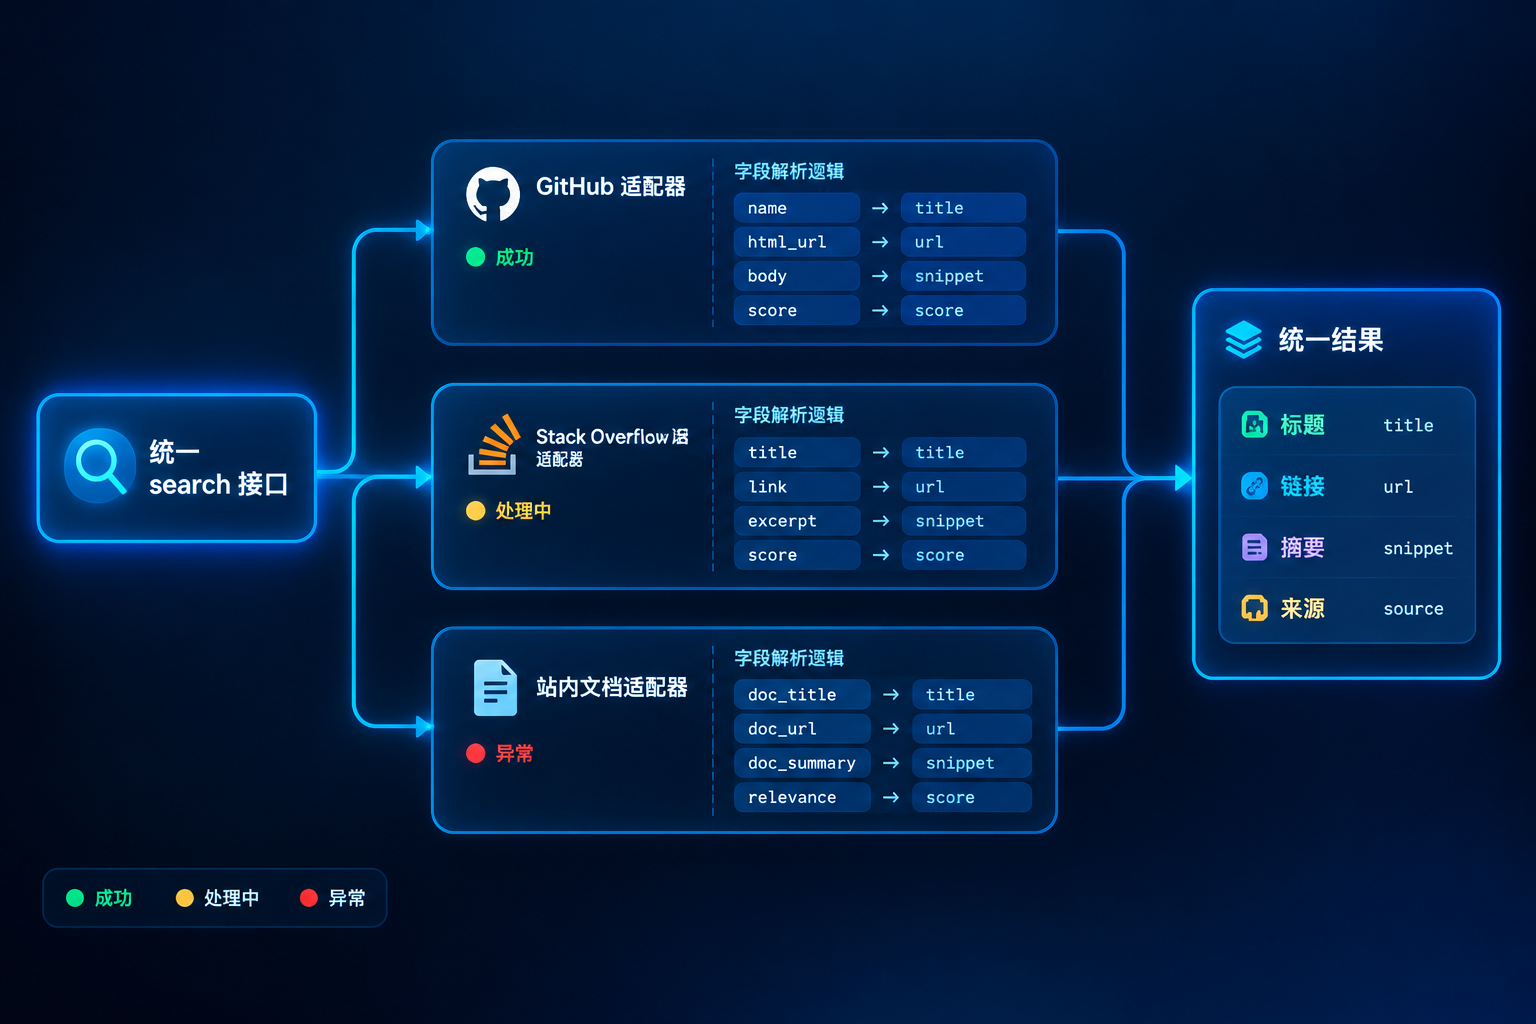
各站字段千差万别,用一个适配器基类把差异封在源内部,主流程永远只见统一结构。
# app/sources/github.py:适配器模式,新源只需实现 search
import httpx
class BaseSource:
name = "base"
async def search(self, q: str, limit: int = 5) –> list[dict]:
raise NotImplementedError
class GithubSource(BaseSource):
name = "github"
async def search(self, q: str, limit: int = 5) –> list[dict]:
async with httpx.AsyncClient(timeout=6) as c:
r = await c.get(
"https://api.github.com/search/repositories",
params={"q": q, "per_page": limit},
headers={"Accept": "application/vnd.github+json"},
)
return [dict(title=i["full_name"], url=i["html_url"],
summary=i["description"] or "",
heat=i["stargazers_count"], source=self.name)
for i in r.json().get("items", [])]
每个源只暴露统一的 search 出口,新增来源时主流程一行都不用改。
各源的接入参数建议这样定,超时统一交给上一层调度:
| GitHub | REST API + Token | 5 条 | 6s |
| Stack Overflow | 官方 API | 5 条 | 6s |
| 站内文档 | 本地向量索引 | 5 条 | 2s |
| 网页搜索 | 第三方聚合接口 | 5 条 | 6s |
**核心结论:**差异留在适配器里,主流程只认一种条目结构。
五、并发抓取:线程池不如 asyncio 加熔断
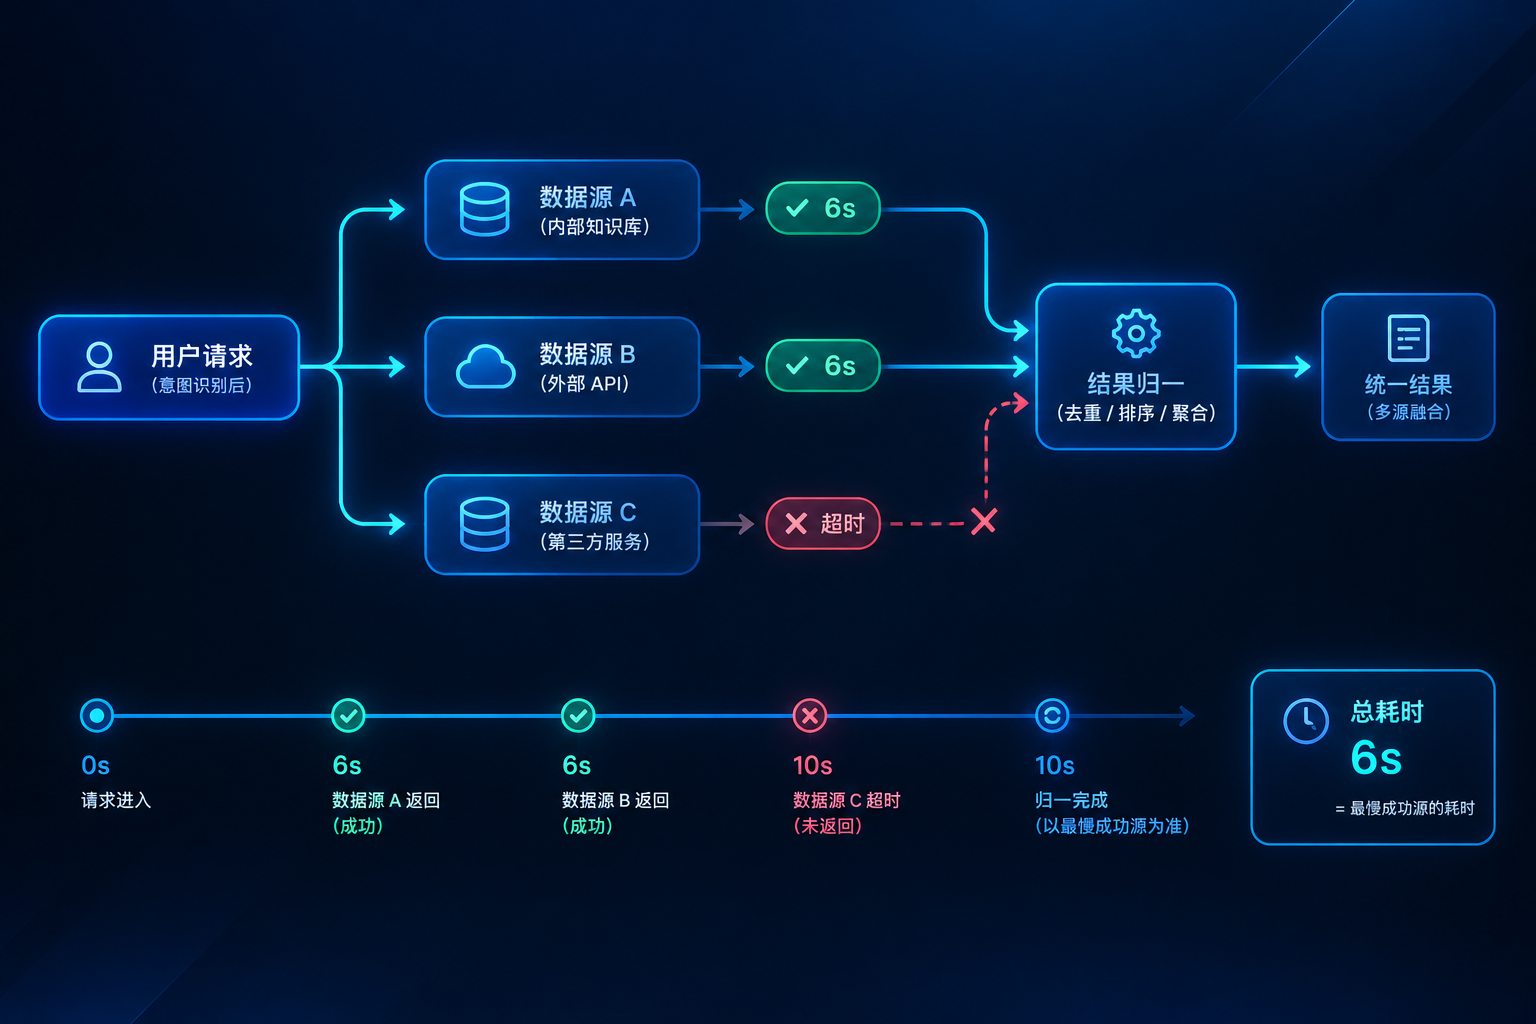
串行请求会让总耗时等于各源之和,这里用 asyncio 并发 + 单源超时 把耗时压到最慢源附近。
# app/fanout.py:并发扇出,单源失败只记日志不中断整体
import asyncio, logging
from app.sources.github import BaseSource
logger = logging.getLogger("agg")
async def fan_out(q: str, sources: list[BaseSource], limit: int = 5) –> list[dict]:
tasks = [asyncio.wait_for(s.search(q, limit), timeout=6) for s in sources]
results = await asyncio.gather(*tasks, return_exceptions=True)
items = []
for src, res in zip(sources, results):
if isinstance(res, Exception):
logger.warning("source_fail %s: %s", src.name, res)
continue
items.extend(res)
return items
并发扇出 → 单源超时 → 异常降级,三步保证页面永远有结果可展示。
调优时盯住这几个经验值:
- 超时上限:单源 6 秒封顶,用户可感知的等待阈值在 2 秒左右,超出就该降级。
- 并发数量:4~6 个源同时打,超过容易被对方限流,反而整体更慢。
- 失败计数:连续失败 3 次的源本轮直接跳过,避免每次都白等一个超时窗口。
六、结果归一:字段映射加去重才有可比性
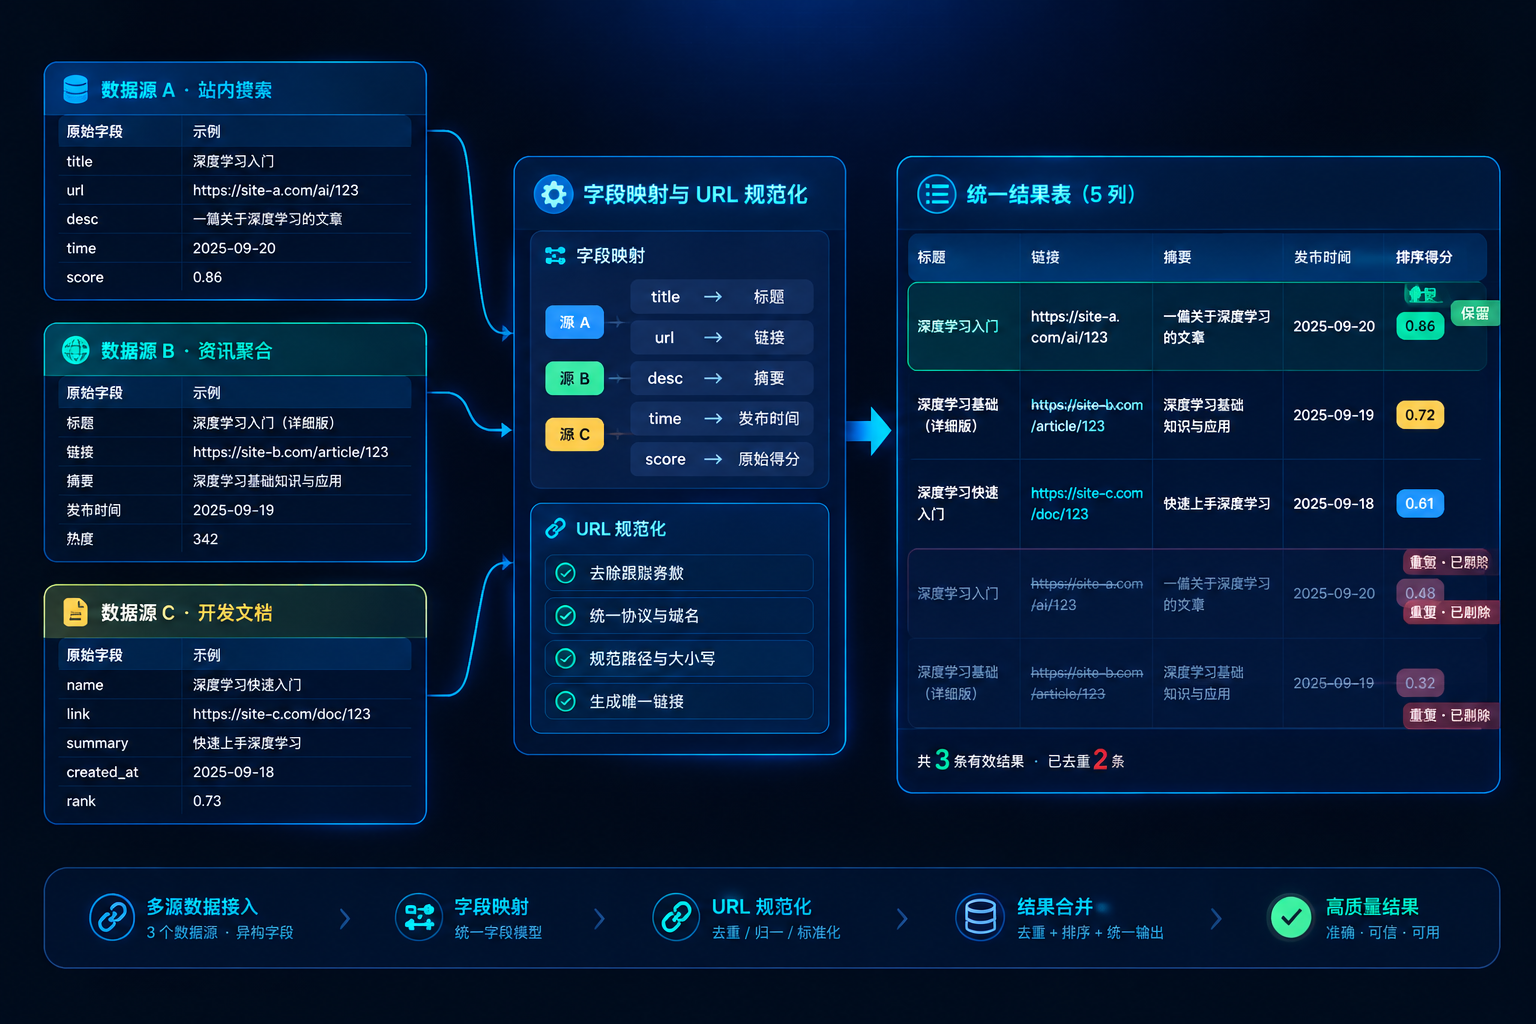
条目抓回来了还得「对得上」,否则同一问题的两个链接会并排重复出现。
- 字段映射:把各源字段统一为 title / url / summary / heat / source 五列,缺失值给空串而非 None。
- 去重键:以规范化后的 URL 去掉 utm_* 参数作为 key,用字典覆盖,先到先得。
- 排序权重:score = 归一化热度 * 0.6 + 源权重 * 0.4,热度跨量级时先取对数再归一。
| 同一链接带不同追踪参数 | URL 规范化后按 key 去重 |
| 某源没有热度字段 | 用源权重补位,不填 0 以免被误判 |
| 摘要过长撑破卡片 | 截断到 120 字并补省略号 |
| 源顺序影响首屏 | 按 score 降序,同分按源权重 |
**核心结论:**去重发生在渲染之前,前端只负责「照单显示」。
七、搜索意图:先判类型再决定打哪些源
不是每次请求都要打全部源,先做一层轻量路由,省流量也省等待时间。
- 关键词规则:命中 repo/代码/github 走开发者源,命中 论文/文档 走站内索引,其余走全量扇出。
- 缓存兜底:同一 query 在 60 秒内直接命中内存缓存,回车连点不会重复打接口。
- 空结果回退:首轮命中源 0 条时自动触发全量扇出一次,避免过窄的路由把结果掐死。
# 意图路由 + 60 秒缓存:先分流,再决定打哪些源
import time, hashlib, json
CACHE: dict[str, tuple[float, list[dict]]] = {}
ROUTES = {"repo": ["github"], "doc": ["local_index"], "all": ["*"]}
def pick_sources(q: str) –> list[str]:
key = hashlib.md5(q.strip().lower().encode()).hexdigest()
hit = CACHE.get(key)
if hit and time.time() – hit[0] < 60:
return hit[1]
low = q.lower()
route = "repo" if any(w in low for w in ("repo", "github", "代码")) else "all"
return ROUTES[route]
路由省下的是一半请求量,缓存省下的是重复等待。
八、前端交互:加载态比动画更重要
结果要等 1~2 秒,这段空白期的处理直接决定体验好坏。
- 骨架屏先行:点击搜索立刻渲染 6 个占位卡片,数据回来再替换,杜绝白屏。
- 降级提示:failed.length > 0 时顶部显示「部分来源暂不可用」,不弹窗、不阻断。
- 防抖节流:输入框 300ms 防抖后才发请求,边打字边请求会把后端打满。
<!– templates/index.html:最小搜索页,纯原生 JS 无框架依赖 –>
<input id="q" placeholder="搜索关键词" />
<button id="go">搜索</button>
<div id="tip"></div>
<div id="list"></div>
<script>
let timer;
document.querySelector('#q').addEventListener('input', e => {
clearTimeout(timer);
timer = setTimeout(() => run(e.target.value), 300);
});
async function run(q) {
document.querySelector('#list').innerHTML = '<div class="sk"></div>'.repeat(6);
const r = await fetch('/api/search?q=' + encodeURIComponent(q)).then(x => x.json());
document.querySelector('#tip').textContent = r.failed?.length ? '部分来源暂不可用' : '';
document.querySelector('#list').innerHTML = r.items.map(i =>
`<a class="card" href="${i.url}"><b>${i.title}</b><p>${i.summary}</p></a>`).join('');
}
</script>
先给占位、再给数据、最后给降级文案,三步把等待期填满。
九、质量守门:日志、限流与排错三件套
上线前必须能回答「为什么这次只有 2 条结果」,靠的是可查的日志与可复现的排错路径。
| 结果恒为 0 | query 没进 URL 或被编码破坏 | 打印原始 q 与编码后字符串 |
| 某源总是缺失 | 超时或被限流 429 | 查日志中 source_fail 的原因字段 |
| 列表顺序混乱 | 去重后未重排 | 归一完成后强制再 sort 一次 |
| 首次很慢、再次很快 | 缓存未生效 | 确认 key 用了规范化后的 query |
- 结构化日志:每条请求记录 q / 源名 / 耗时 / 条数 / 失败原因,一行一事件便于 grep。
- 基础限流:按 IP 每分钟 30 次,超限返回 429,防止脚本把上游配额刷光。
- 健康检查:/healthz 返回各源最近一次成功时间,超过 10 分钟标红。
**核心结论:**没有日志的聚合搜索,出问题时只能靠猜。
十、部署上线:一条命令起服务并验证
最后把成果打包,用最短路径交付到能被访问的环境。
# 构建镜像并起容器,随后做两步冒烟验证
cd agg-search
docker build -t agg-search .
docker run -d -p 8000:8000 –name agg agg-search
curl -s localhost:8000/healthz # 应返回各源状态 JSON
curl -s "localhost:8000/api/search?q=fastapi" | head -c 300
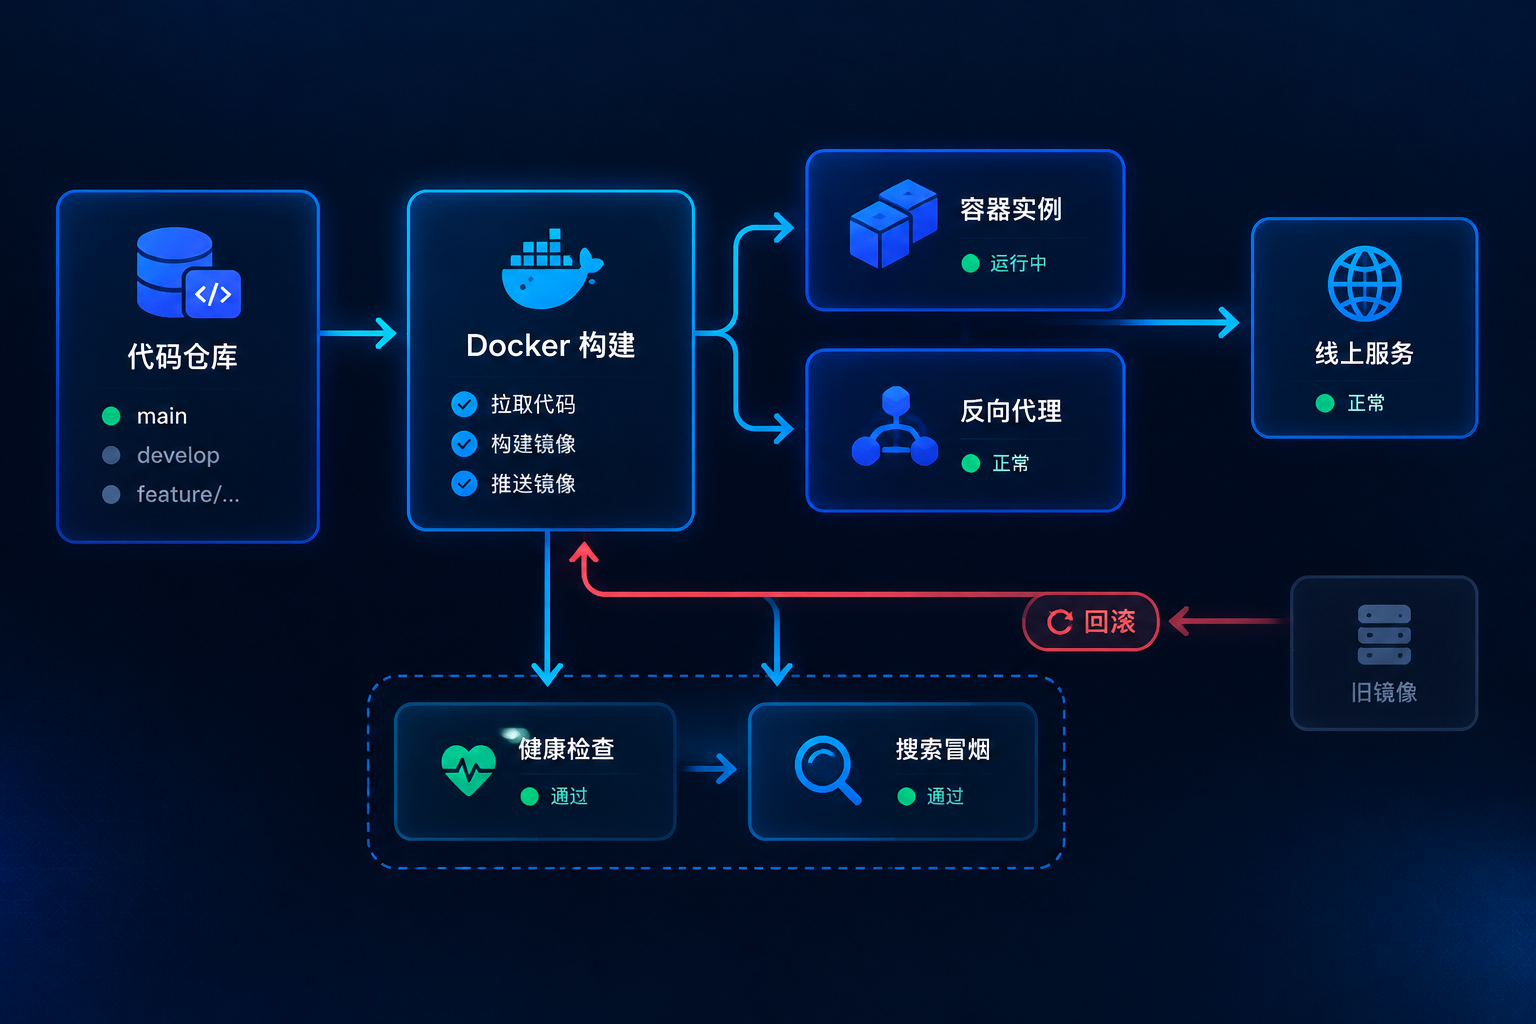
构建 → 起容器 → 健康检查 → 搜索冒烟,四步跑完才算交付完成。
上线前的核对清单:
- 环境变量:API Key 全部走环境变量注入,禁止写进代码或镜像层。
- 并发上限:–limit-concurrency 或反向代理层设好连接数,避免被打挂。
- 回滚预案:保留上一个镜像 tag,docker run 换 tag 十秒内可回退。
结语
这套链路的价值在于把「聚合搜索」拆成了可逐段验收的工程:适配器隔离差异、并发与超时保证可用、归一去重保证可比,三者合起来才让一个 demo 变成能长期跑的产品。用 Codex 驱动开发时,真正省时间的不是生成速度,而是你把任务切得足够细、验收标准写得足够明确。
按上面的顺序推进,你会在很短周期内拿到一个能搜、能降级、能部署的完整应用,后续加源、加排序策略都只是局部改动。
把等待变成可见的加载、把失败变成可解释的提示,聚合搜索才算真正可用。


评论前必须登录!
注册