 网硕互联帮助中心
摘要:本文基于四家模型在同一道自相矛盾的编程陷阱题上的 12 跑思考全文存档,从思考语言、思考量、思考用时三个维度做全景对照。实测发现:中文思考的模型思考量平均约 3.0 万字符,英文思考平均约 14.5 万,差近 5 倍;长考模型的思考用时方差极大,同一道题成本可差出数倍。结论是,选购推理模型不能只看单价,思考语言和思考时长的方差才是隐藏菜单——便宜但爱长考的模型,做对同一道题,真可能比单价贵一点点的更贵。
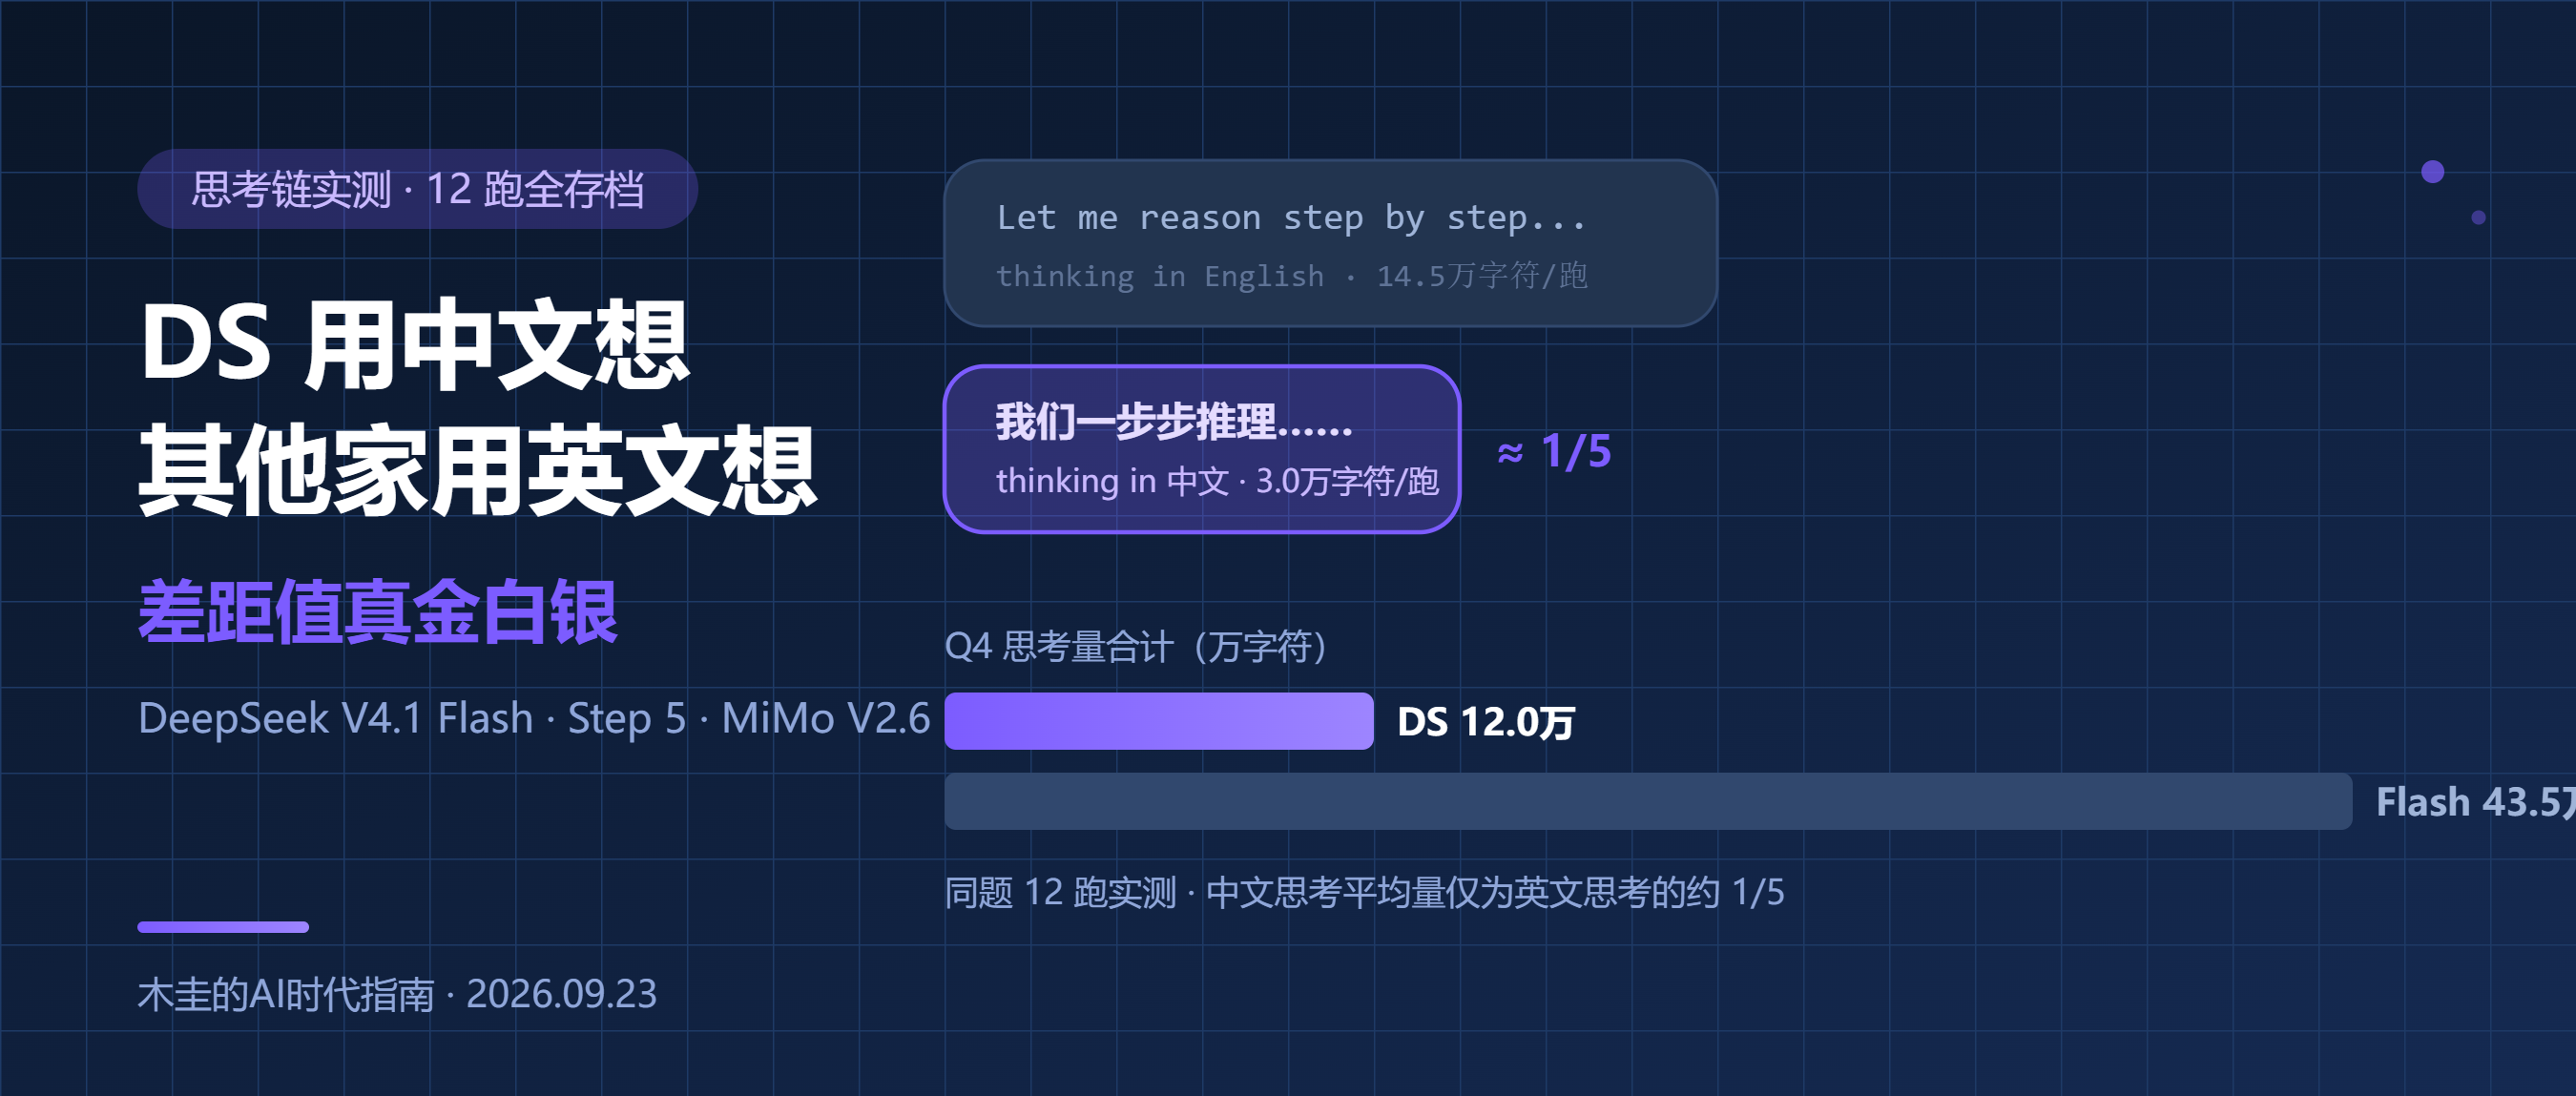
同一道陷阱题,12 跑思考过程全存档,思考语言、思考量、思考用时全景对照
mimo 2.6发布后到处都在比模型答题的对错,没人看模型是怎么想的。跑分表给你一个分数,评测文给你一个结论,中间那段"模型脑子里发生了什么",全被一笔带过。
这两天打开时间线,全是同一句话:MiMo 2.6 是新的斩杀线。官方跑分确实漂亮,定价确实很低,转发的人确实多,可没几个拆开仔细算算账。我的看法是,斩杀线立没立起来,答案藏在思考过程里,跑分表和定价都只是其中最后一环。
上一篇我把 DeepSeek V4.1 Flash、Step 5、MiMo V2.6 Pro、MiMo V2.6 Flash 四家拉到同一张考卷上判完了答案,结论是"深度、速度、稳定,免费档顶多给两样"。
先交代我做这次测试的初衷,它是一笔成本账。Agent 场景里,输入端的成本可以靠缓存命中率使劲卷:同样的系统提示词、同样的知识库,命中率上去了,输入价格能压到零头。输出端就没得卷了,吐多少字全看模型自己,其中思考链占大头,它脑子里滚的每一个字都在烧我的钱。于是一个问题冒了出来:在同样都能解决问题、都能把题做对的前提下,一个爱长考的模型,就算单价更低,到头来会不会反而比单价高的更贵?
回答这个问题,光看答案没用,四家的答案几乎都是对的。得看它的思考烧了多少、烧得多随机。所以上一篇实测文章发完之后我一直有个疙瘩:判卷判的是答案,答案只是思考的最后一步。四家翻车集中在一道陷阱题上,但翻车那道题拆开看看到底是什么样子的,那个题是典型的长考题,从这个题入手来看成本账又会怎么样呢?
所以有了这篇。我把四家在那道陷阱题上的 12 跑思考全文存了档,统计语言、字数、用时,又反复回到原始记录里核对。有几个发现跟我的直觉反着来,其中一个还把我自己给绕进去了。
一、考题先交代:那道全场翻车的陷阱题
考题编号 Q4,是一道自相矛盾的编程题:要求写一个 Python 函数,"返回列表中所有出现次数为奇数的元素",后面又补一句"如果有多个,返回任意一个",同时卡住 O(n) 时间、O(1) 空间、不许新建任何容器。
"返回所有"和"返回任意一个"互相打架,正确答案应该是识破矛盾、给出证明。上一篇的结果:DS 三跑全过,Step 一跑崩掉,MiMo Pro 两跑思考到最后一个字没输出,MiMo Flash 一跑思考了 17 分钟才吐答案。这是纯结论性的结果反馈。
这一篇看的是除了结果的对错之外的东西:结果出来之前,各个模型长考部分到底是什么样的呢?现在各家官网都把思考流摆在页面上,能复制、能存档。我把 12 跑思考全部存了下来,做了一遍笨统计。
二、第一个发现:思考语言是硬差距
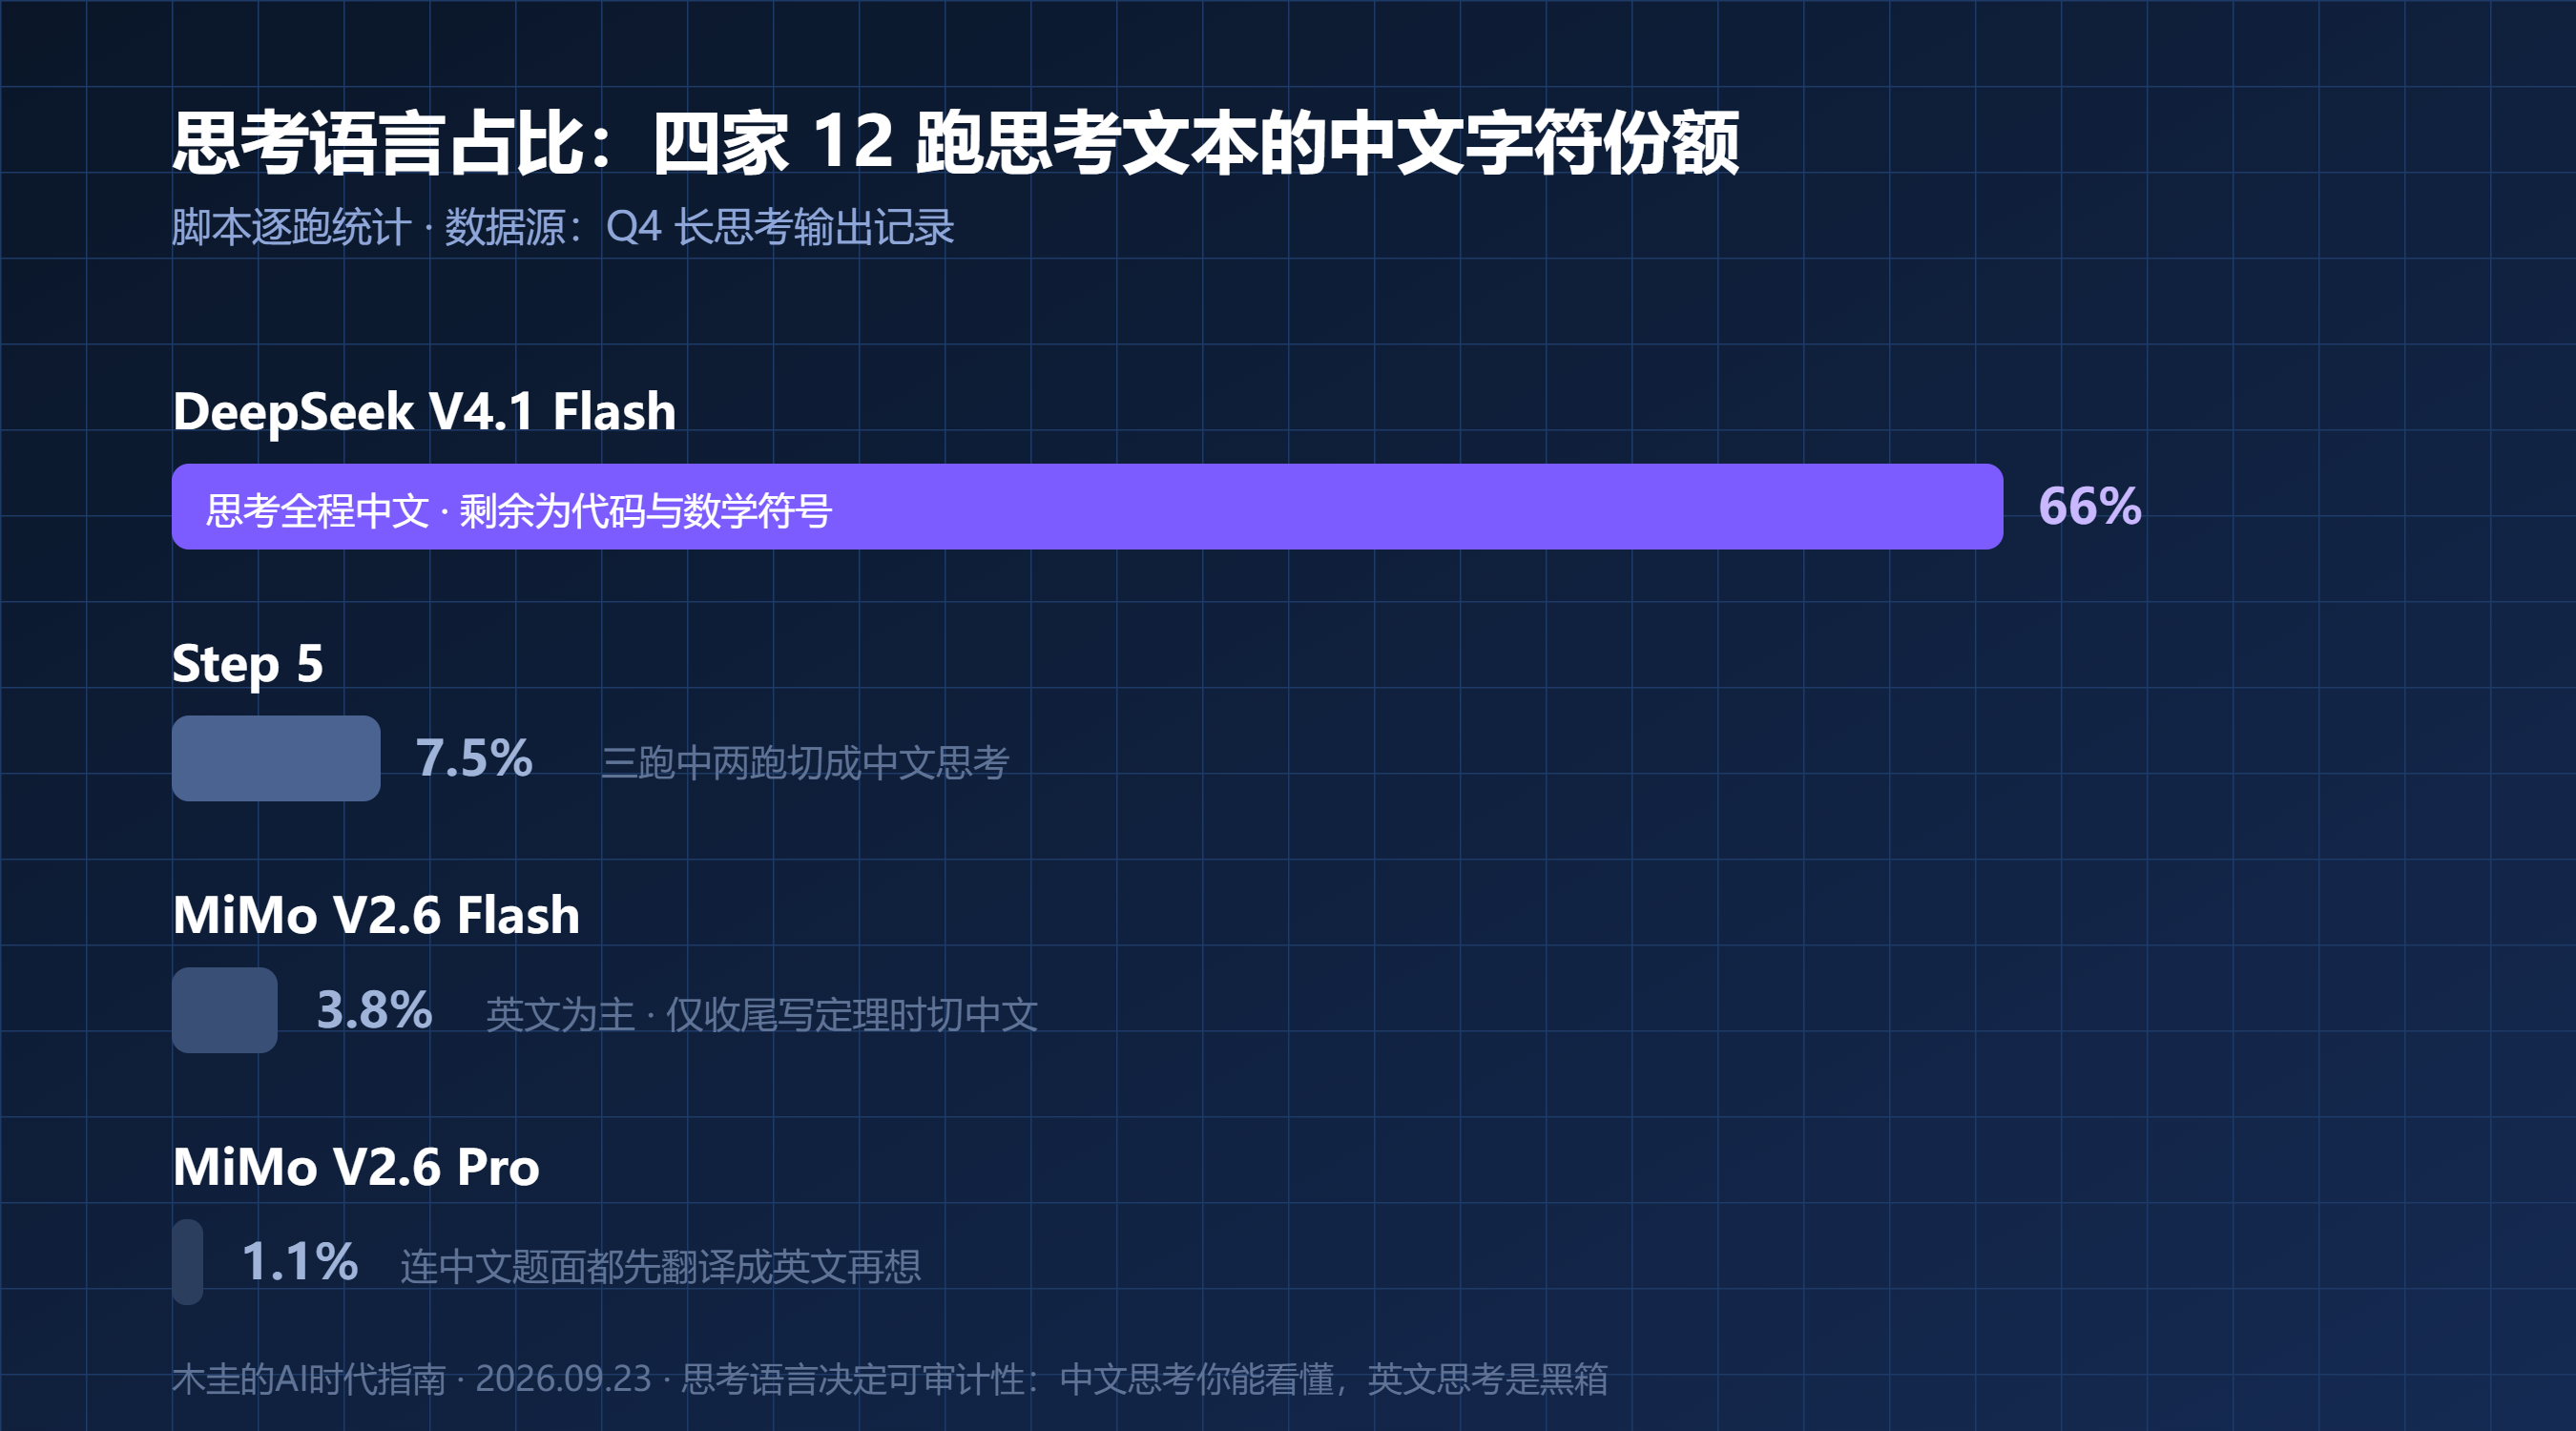
先上统计结果。四家 12 跑思考文本里,中文字符的占比:
|
DS V4.1 Flash |
66% |
12.0 万字符 |
1分18 / 1分58 / 3分35 |
|
Step 5 |
7.5% |
24.1 万字符 |
官网不计时,但是从输出总数能看出大概 |
|
MiMo Flash |
3.8% |
43.5 万字符 |
16分52 / 32分38 / 5分23 |
|
MiMo Pro |
1.1% |
37.1 万字符 |
22分12 / 31分40 / 6分38 |
DS 的思考全程用中文,剩下的占比是代码和数学符号。你不光能看到它在想什么,还能看懂它想到哪一步。
MiMo Pro 在另一个头,中文占比 1.1%。它拿到我的中文题面,做的第一件事是在脑子里把题翻译成英文。思考的第一句原文是:"We need to reason step by step. The question: write a Python function taking a list of integers…"。我的题面是中文的,他的思考过程全部都是英文。
这件事的分量有两处。
1)可审计。英文思考链对中文用户是个黑箱,等待的时候你连它推到哪一步了都不知道,只能干瞪着屏幕滚。DS 的思考你能边等边检查,它枚举失败集合枚举到第几条、有没有漏掉西瓜糖,你扫一眼就知道。发现它跑偏了,你甚至能提前打断重来。
2)成本。往下看。
三、第二个发现:语言比模型更能预测思考量
统计完 12 跑的数据, Step5有条规律特别扎眼。
Step 三跑思考:第一跑英文,21.0 万字符;第二跑中文,1.7 万字符;第三跑中文,1.4 万字符。同一个模型、同一道题、一模一样的提示词,思考切到中文之后,思考量掉到英文跑的十二分之一。
这不是 Step 一家的孤例。把 12 跑摊开:中文思考的 5 跑(DS 全部三跑加 Step 两跑),思考量全部落在 1.4 万到 6.4 万字符之间,平均约 3.0 万;英文思考的 7 跑(MiMo 全部六跑加 Step 一跑),平均约 14.5 万。差接近 5 倍。全卷最长的几次思考,全部出自英文思考。
mimo 2.6 Flash 是思考量最大的,43.5 万字符,是 DS 的 3.6 倍。它也不是全程一根筋用英文,第二跑到收尾写定理证明时,自己切成了中文,像是发现中文写起来省字。
这条规律的背景是业内老共识:同样一段推理,中文比英文省 token。但共识归共识,我第一次拿到同题对照的实测数字。对按输出 token 计费的推理模型来说,用英文思考约等于默认给自己加了 5 倍的思考税,而且没有任何一家会在报价单里告诉你这件事。
四、第三个发现:长考的方差,比长考本身更要命
MiMo Pro 的三跑用时值得单独拎出来看:22分12秒、31分40秒、6分38秒。
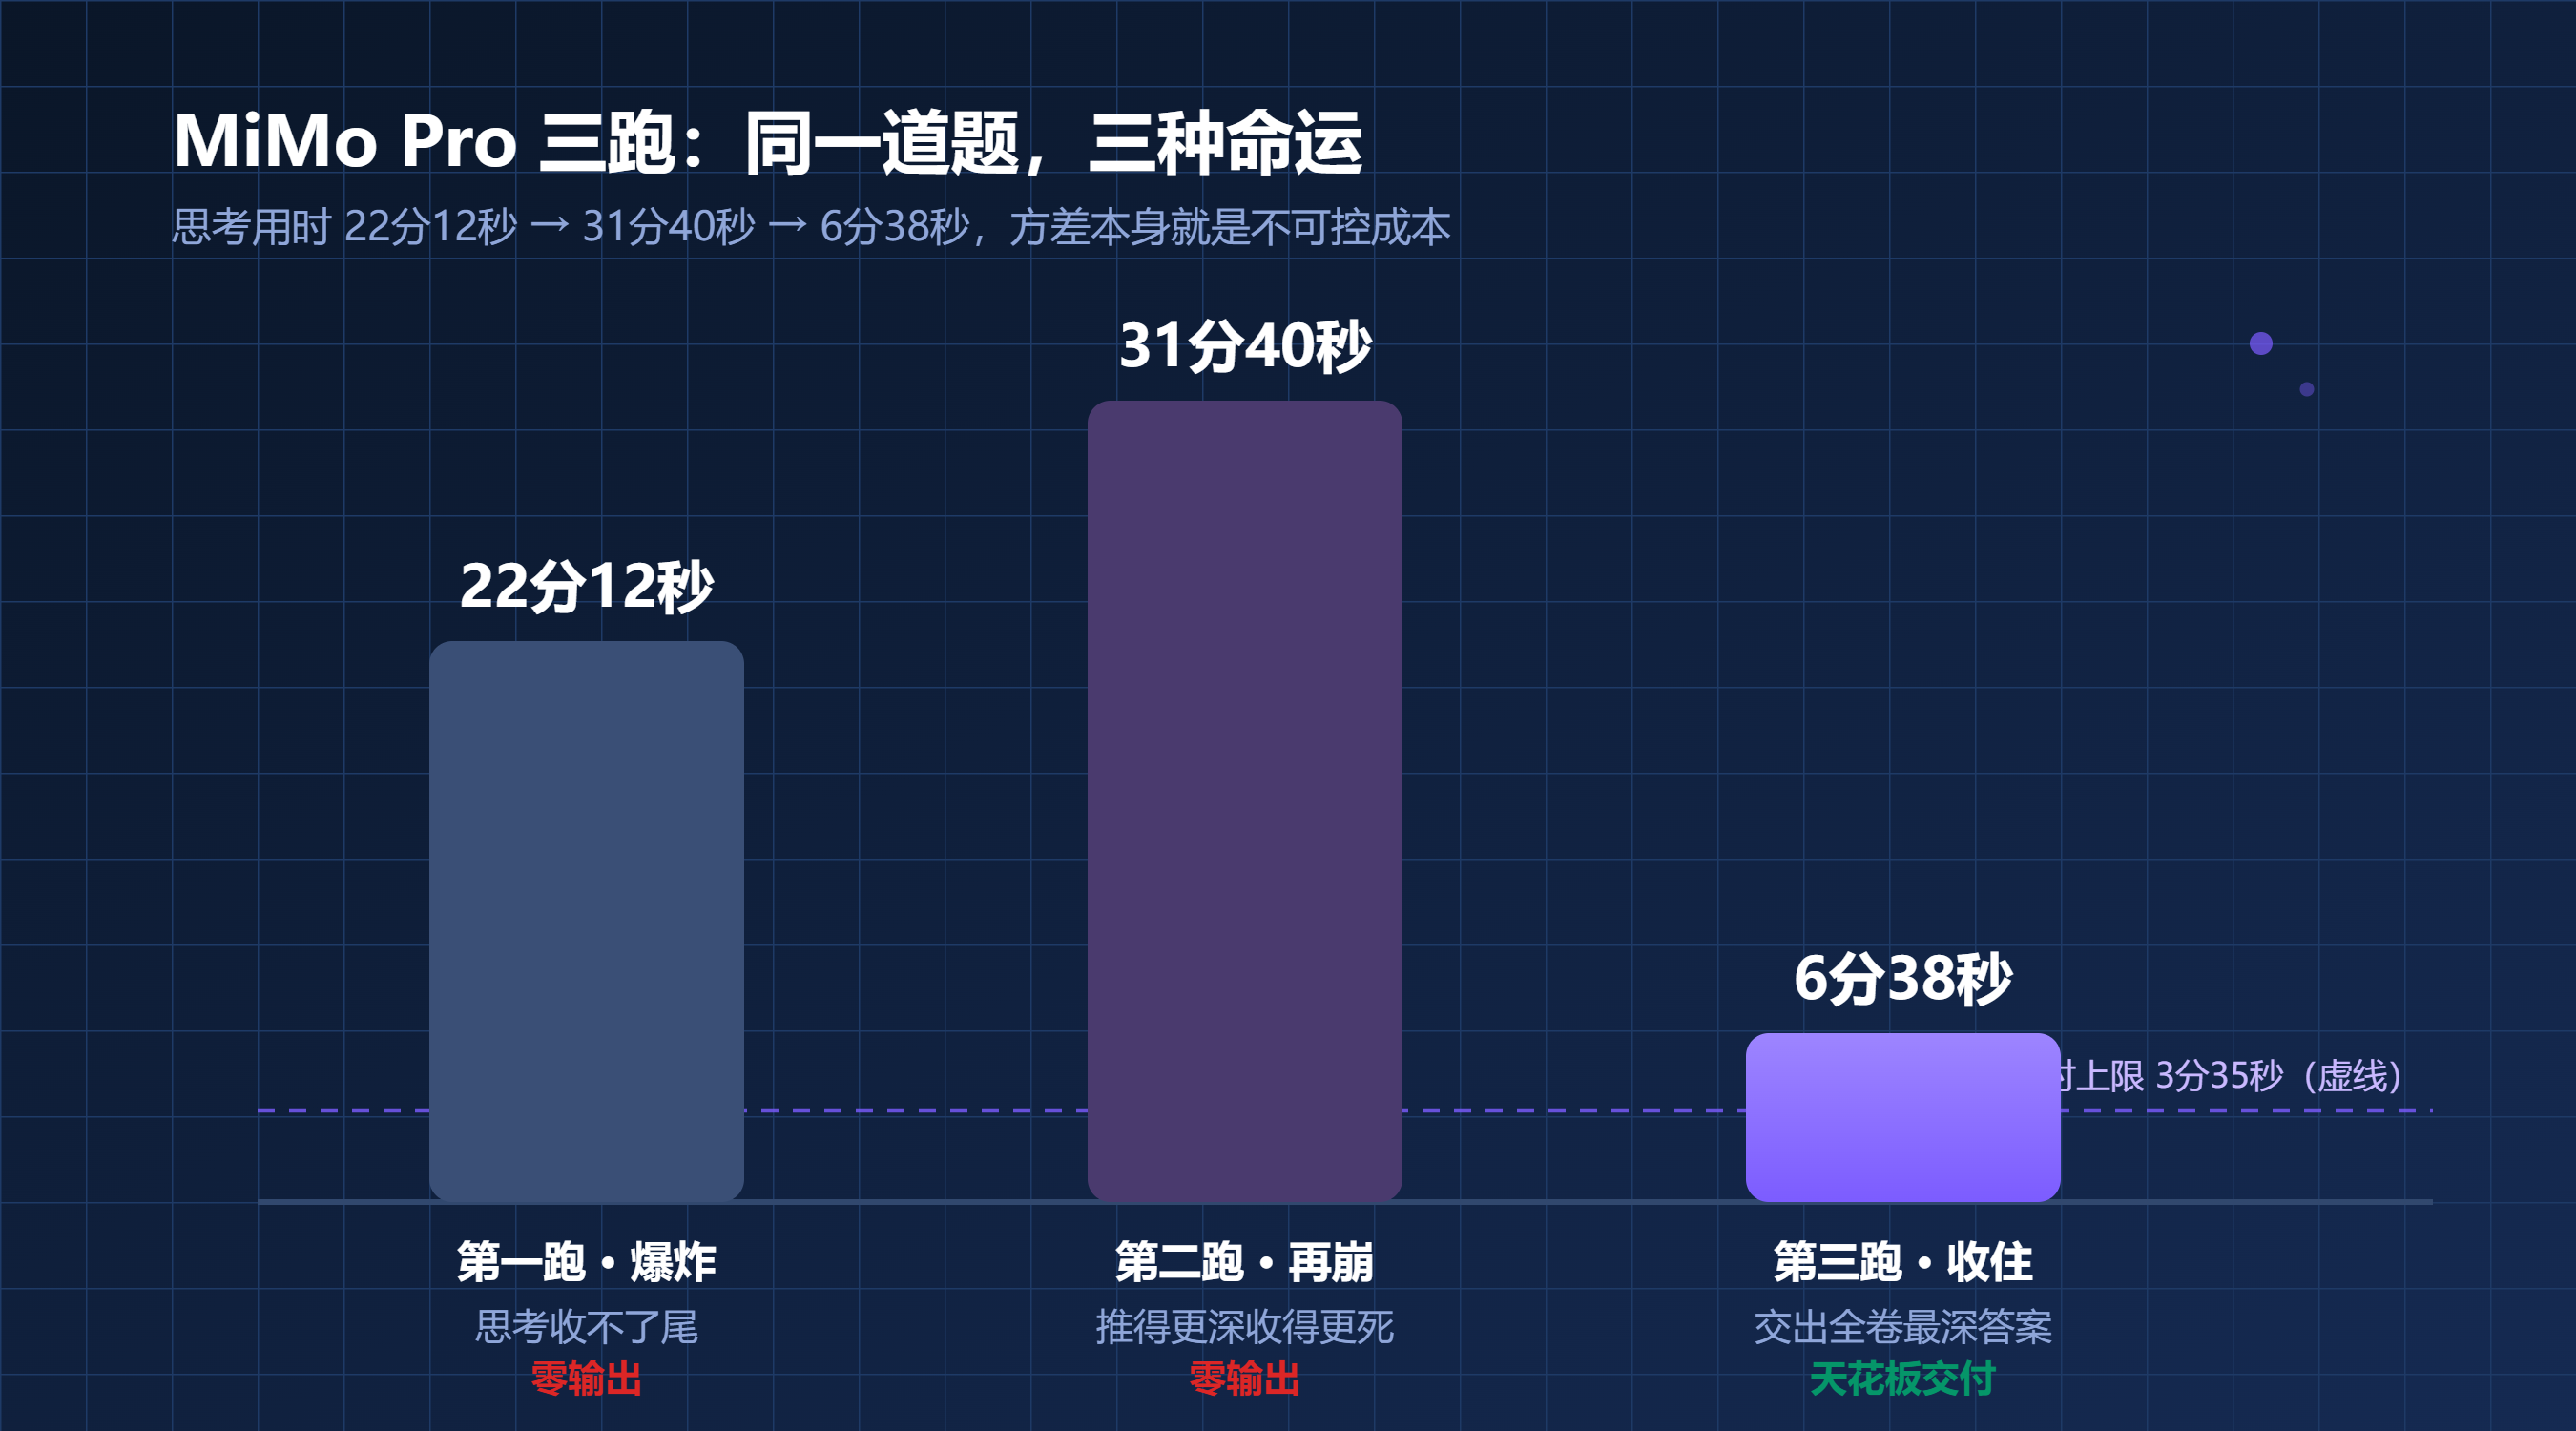
前两次不是想不出来。我把那两跑的思考记录从头读到尾,下界证明、按位分组、原地消除法,它全推了一遍,推理做的最深,但就是收不了尾。第三次收着想了,6 分半交卷,交出来的是全卷最有深度的一份答案:把题面的五条要求逐条形式化,指出两组矛盾,还给了模型的适用边界说明。
所以它崩,崩在想得太贪。而这三跑摆在一起,真正的警告是那道题的思考用时是 22 分、32 分、6 分半,三档随机。你发出请求之前,没有任何办法知道这一次会落在哪一档。
这就是我上一篇没说透、这篇必须说透的账:高价不可怕,单价摆在那儿,用多少你心里有数,可以有意识地控制。长考不一样,思考 token 按输出价计费,用量事前不可预估,同一个题目成本能差出几倍,你连"要不要换便宜档"的决策机会都没有,它先烧完思考,你才看到账单。免费网页版里你付的是时间,到了 API 场景你付的是钱,还付得没数,这也不是我点名评测的这几款模型的问题,反而是现在主流模型都在干的事。
五、回到初衷那笔账:长考模型单价低,可能反而更贵吗
初衷的那个问题,现在可以用实测倍数来算了。
第一笔,思考量账。DS 三跑思考平均 4.0 万字符,MiMo 两家六跑平均 13.4 万字符,单跑思考量 3.4 倍。答案文本两家差不多,题目一样,思考占输出的大头,所以这个倍数基本就是输出成本的倍数。它直接给出一个临界条件:MiMo 的输出单价得比 DS 低到三分之一以下,光思考量这一项才能把折扣吃平。单价折扣只要没低过这条线,同样做对一道题,长考模型的实际花费就反超了。
第二笔,方差账。MiMo 单跑思考用时从 5分23 到 32分38,同一道题差 6 倍;DS 从 1分18 到 3分35,差不到 3 倍。单价你可以预算,方差你预算不了。
第三笔,废跑账。Pro 有两跑分别思考了 22 分钟和 32 分钟,最后一个字没输出。这两跑放在计费场景里照样要付钱,纯烧掉。
所以初衷问题的答案是:会。长考模型单价低,真有可能反而更贵,条件就是单价折扣小于思考量倍数。各家单价随调价波动,这篇文章不报具体价格,只报倍数,倍数是从 12 跑原始记录里数出来的。
六、乌龙:出题人自己被英文思考链骗到
整理这份记录的时候,我一直以为 MiMo 的最终输出也是英文的,印象里满屏英文滚了十几分钟,最后交的卷也"应该"是英文。直到这次逐跑核对才发现:Pro 和 Flash 的 Q4 正式输出全是中文,Pro 那份还是全卷最深的证明。
为什么会看漏?英文思考流滚了十七分钟,我早已失去耐心,根本没翻到正文,脑子里把"思考是英文的"记成了"答案是英文的"。
我讲这个乌龙,是因为它比任何论证都有说服力:思考链的语言看着像界面包装,实际是产品能力。连出题的人都会被英文思考链绕进去,把一次成功的交付记成一场崩溃,普通用户只会更懵。
七、外部视角:我找了 DS pro当第二考官
写这篇之前,我把全套思考记录发给了 DS pro,让它给一个更狠的判法。用竞品当考官,这事儿本身就挺赛博,它的意见我不照单全收,但有一段值得原样放出来。
它说,这道题的理想回答应该非常短:直接给"不能同时满足",然后四条理由,语义矛盾、输出空间下界、XOR 只在恰好一个奇数频次元素时成立、一般情形需要额外空间或超线性时间。完。从记录看,四个模型都做不到这种"快速识破加简洁证明":都能识别一部分矛盾,但容易陷入"到底能不能构造出来"的长考,输出冗长,收敛慢。
它还给了一个关于成本账的风险排序,从坑到不坑:无上限长考叠加按输出 token 计费、再叠加自动重试或高并发,最坑;其次高价但稳定可预算;再次有硬上限的长考;最稳的是低价稳定。这套排序我认大部分,特别是它把"自动重试"叠了进来:高并发场景一次长考超时自动重跑,等于双倍烧钱还加倍排队。不过这是钱袋子视角的排法,我的落点更简单,往下看。
八、结论:中文用户选购的新坐标
跑分表不会列,评测文不会写,但实测摆在这儿,我给中文用户补两个选购坐标。
第一,思考语言。中文思考对中文用户意味着两件事:看得懂,等得起。看得懂是可审计,你能检查它的推理、发现它的跑偏;等得起是成本,中文思考量天然低一个量级,API 场景少烧钱,网页场景少受罪。
第二,思考时长的方差。平均快慢是小事,方差大小才决定你敢不敢把它接进正经流程。一道题三跑能给你 6 分半、22 分、32 分三个答案的模型,你在它身上做的所有排期都是赌。
回到四家:DS 全程中文思考、思考量最少、用时最短、三跑全成,深度确实偏浅;MiMo 家思考最深,英文思考,方差最大。上一篇我有一句很主观的判断,我一直觉得可能争议很大,这一次论证完,我觉得不用改,“结果没问题的情况下,我无脑选 DS”。这一篇补上了为什么:它不光把题答了,它连思考都说人话。
开头那个问题也一并收掉:mimo 2.6作为斩杀线在答案层面立住了,MiMo 真能把题做对,还做得深。可斩杀线是要算钱的:思考量 3.4 倍,方差 6 倍,拿到中文题还在脑子里翻成英文再想。线立起来了,接线的钱包先瘪了。
最后收回开头那笔成本账。输入端靠缓存命中率去卷,那是你自己的本事;输出端你只能挑模型。挑的时候别只盯着单价,思考量倍数和思考时长的方差才是隐藏菜单。便宜但爱长考的模型,做对同一道题,真可能比单价贵一点点的更贵。
测试口径:2026-09-23,四家官网 chat 网页端实测(非 API),同一道 Q4 陷阱题,关闭联网与工具,同题多跑。思考文本为各官网展示的思考流原文,语言占比与字符量由脚本统计,计时取自官网展示(Step 官网无计时)。DS 的外部判据由 DeepSeek 官方网页版给出,仅供参考,文章结论与取舍归本号。上一篇:《DeepSeek V4.1 Flash · Step 5 · MiMo V2.6 Pro/Flash,一套自编考卷,四家官网 chat 各跑三遍》。考卷全文公开,大家可以自测:https://free-llm-exam.app.workbuddy.host/


评论前必须登录!
注册