 网硕互联帮助中心
Ray 的 remote 调用之后:任务怎样衔接,状态留在哪里
把一批文本的预处理函数加上 @ray.remote,再逐条调用,程序看起来已经“分布式化”。但下面这个循环仍然是一份工作结束,才提交下一份:
for text in texts:
value = ray.get(prepare.remote(text))
consume(value)
即使另一个 Worker 空闲,它也无法提前处理下一条:Driver——提交这些调用的应用进程——还停在上一条的 ray.get。这个问题不需要先研究集群部署,读懂一段调用代码就能发现。
Ray Core 提供远程任务、结果引用和有状态执行进程。理解它的起点,是分清提交工作、等待依赖、取得结果、修改状态发生在哪里。本文围绕文本预处理与评分的短流程展开;示例不加载模型,没有 GPU、吞吐或故障实测。接口语义依据 2026 年 9 月 9 日核对的 Ray 2.58.0 官方文档。
下一份任务什么时候才被提交
prepare.remote(text) 提交一次 Task,通常返回代表未来结果的 ObjectRef;这时结果未必已经产生。ray.get(ref) 才在调用方等待并取得值。任务也不一定每次新建进程,Ray 可以复用 Worker 执行多次普通 Task。
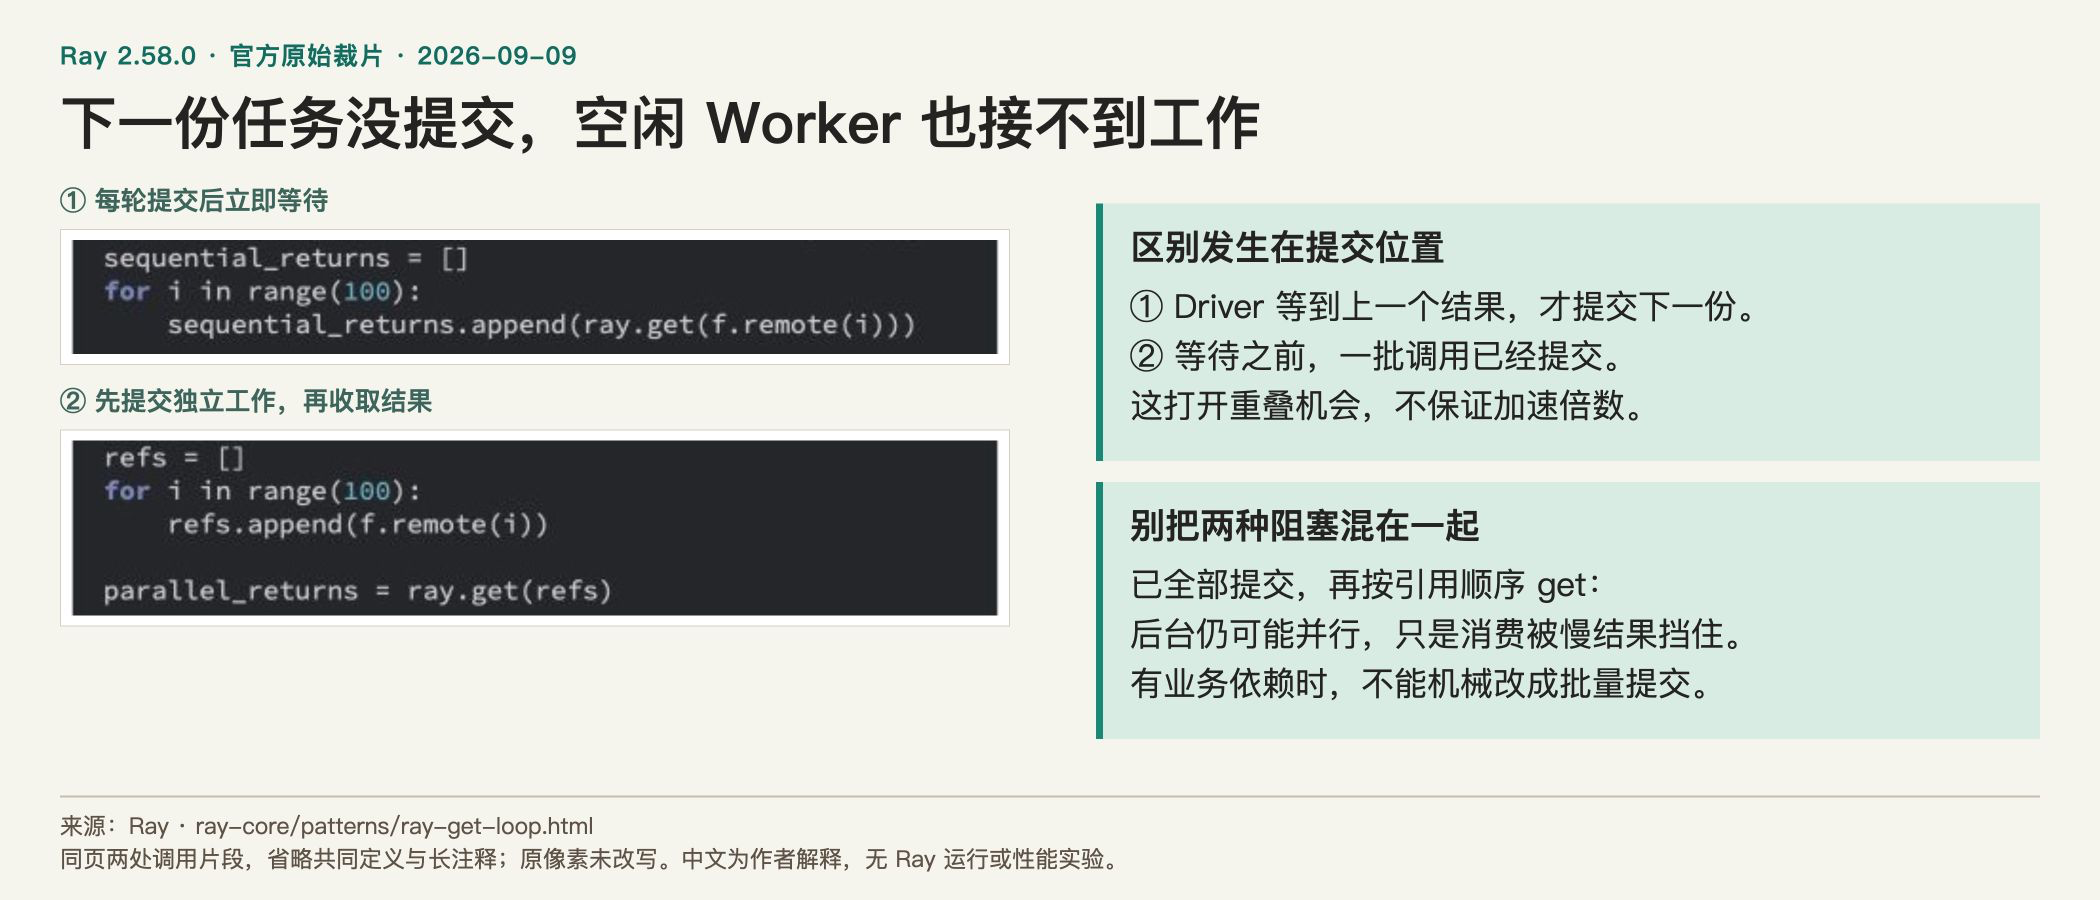
原循环把提交与等待绑在同一轮。若文本互相独立,可以先保留引用,最后收取结果:
refs = [prepare.remote(text) for text in texts]
values = ray.get(refs)
这只是打开了任务重叠执行的机会。能同时运行多少份,仍取决于资源与调度;函数太细、传输太重时,也可能得不偿失。它没有给出任何加速倍数。
Ray 的循环内 get 反例直接对比了这两种写法。关键证据在提交位置:第一种写法等待前一个结果,第二种在等待之前已提交一批工作。对于本来就有先后依赖的业务,不能照搬并发改写;独立性必须来自业务本身。
还有一种容易混淆的写法:已经提交完全部任务,再按照引用列表逐个 get。此时后台工作仍有机会并行,只是调用方可能等着排在前面的慢任务,迟迟不处理后面已完成的结果。它与“下一份任务根本没有提交”是两种阻塞。结果可独立消费时,可以用 ray.wait 取回已就绪的引用;如果必须按输入顺序输出,就要保存序号并承担重排缓冲,不能假装顺序要求已经消失。官方结果处理反例讨论的正是这一差别。

ObjectRef 把依赖交给下游,数据仍要到达
预处理后还有评分阶段。最直接的写法是在 Driver 取回预处理结果,再提交评分:
prepared = ray.get(prepare.remote(text))
score_ref = score.remote(prepared)
如果 Driver 不需要查看中间值,可以把引用作为评分调用的顶层参数:
prepared_ref = prepare.remote(text)
score_ref = score.remote(prepared_ref)
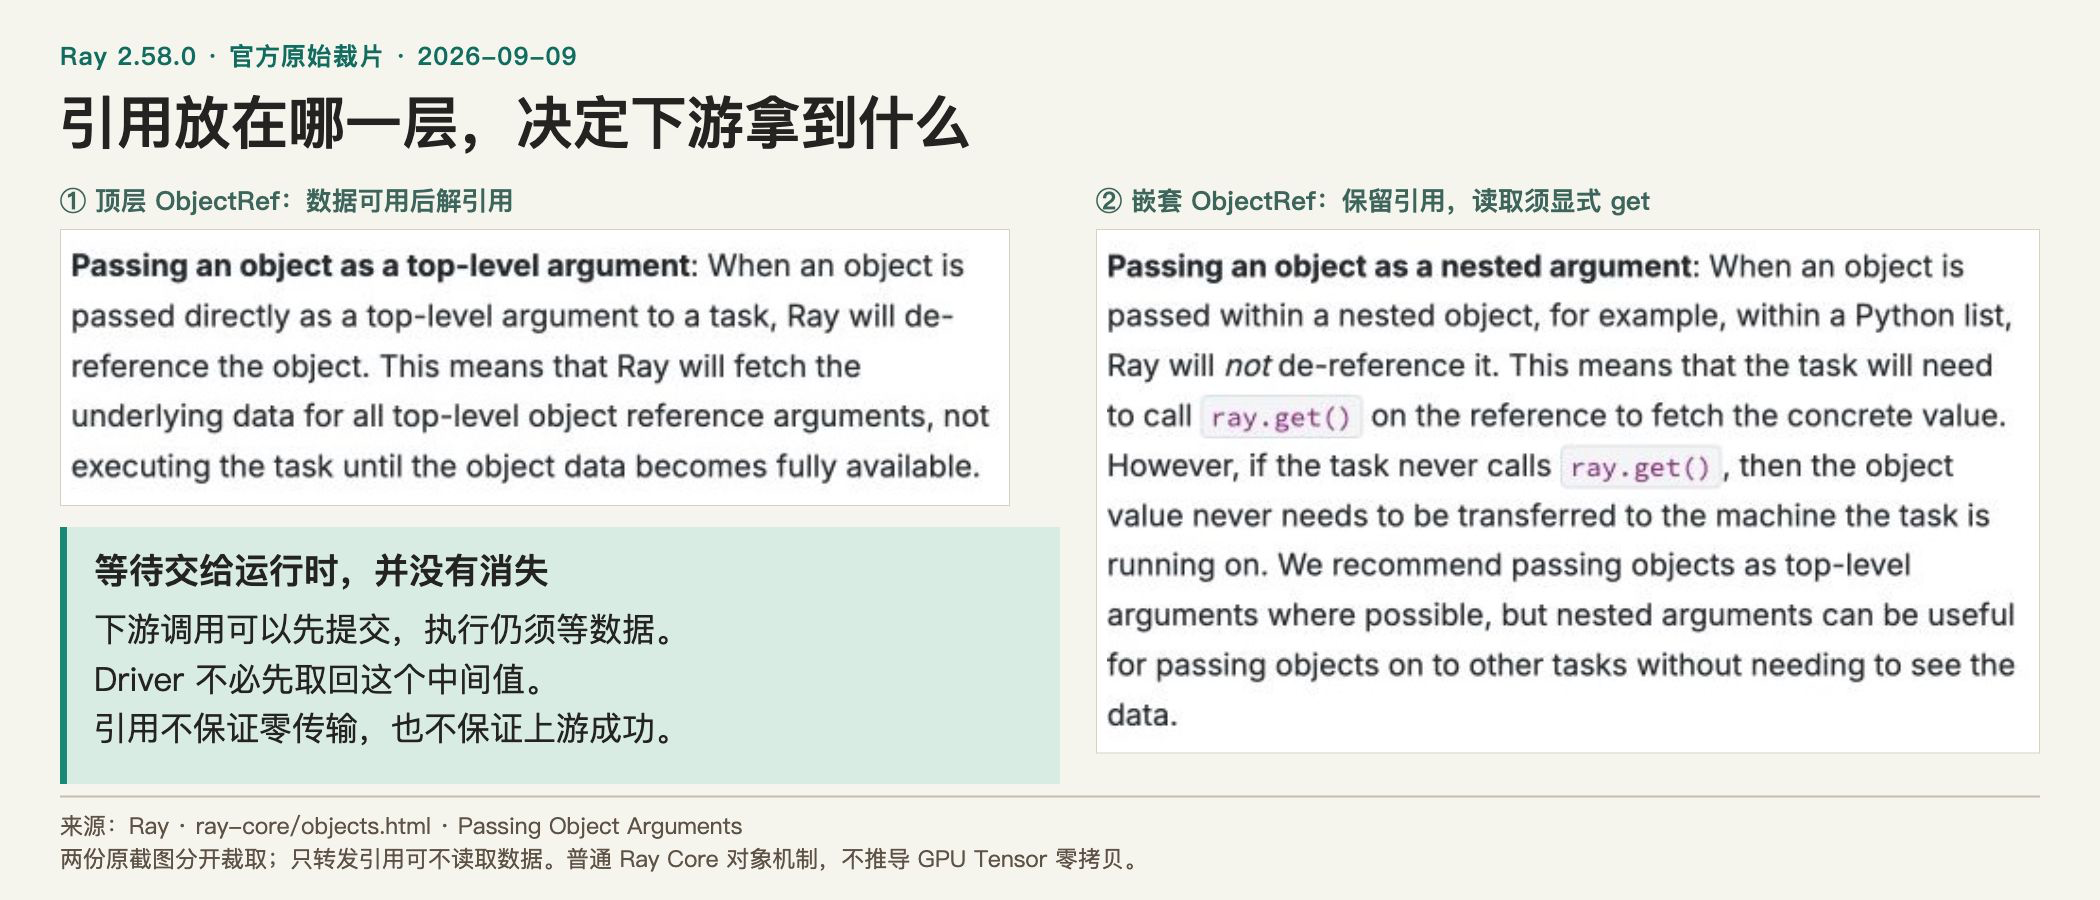
第二个调用可以先提交。Ray 等顶层引用对应的数据可用,再执行 score,函数接收的是已经解开的值。等待并没有消失,而是从 Driver 手动阻塞,变成了运行时知道的任务依赖。这让 Driver 能继续提交其他独立文本的处理链。
传参的层级会改变含义。score.remote([prepared_ref]) 把引用藏进列表,Ray 不会自动把它解成值列表;被调用函数拿到的是包含引用的列表。如果它要读值,需要显式取回。若只负责把引用转交给其他任务,也可以始终不读数据。Ray Objects明确区分这两种行为,Actor 构造函数和方法调用也采用这个约定。
因此,给下游传一个字典或列表之前,要确认接口约定的是实际值,还是供继续转交的引用。两者都合理,但不能只改容器形状而保留原先的函数理解。上游失败时,也不能把“手里有 ObjectRef”当成结果存在;最终等待或读取结果仍可能得到异常。
引用也不等于没有数据成本。对象可能位于其他节点,使用它仍可能需要传输;对象存储中的远程对象是不可变的,不能作为各进程随意修改的共享 Python 变量。这里讨论的是普通 Ray Core 对象机制,不从引用传递推导 GPU Tensor 零拷贝,也不把未启用的专用传输机制算进收益。
Actor 留住状态,也限定了调用落在哪个进程
如果评分需要反复使用同一份已加载模型,把加载动作写在每次 Task 内部,可能重复做昂贵初始化。Actor 为另一种组织方式提供了基础:创建一个有状态 Worker,把后续方法调用交给它,在其生命周期内复用成员变量。
为了只观察这一点,下面用字符数代替模型评分,用计数器代表进程内状态:
@ray.remote(num_cpus=1)
class Scorer:
def __init__(self):
self.processed = 0
def score(self, item):
request_id, text = item
self.processed += 1
return request_id, len(text), self.processed
Scorer.remote() 返回 Actor 句柄,scorer.score.remote(item) 返回这次方法调用的结果引用。句柄用来找到有状态执行对象;结果引用用来找到某次调用的返回值。把两者都理解成“远程结果”,就容易误把创建实例当成已经获得评分。
Actors 文档说明,每个 Python Actor 在自己的进程中运行,方法可以访问和修改该 Worker 的状态。创建两个 Actor,意味着两份各自持有的成员状态,不会自动变成一个共享计数器。真实模型放进成员变量,也只是让它在该实例生命周期内复用;不会因此自动切分权重或跨实例共享显存。
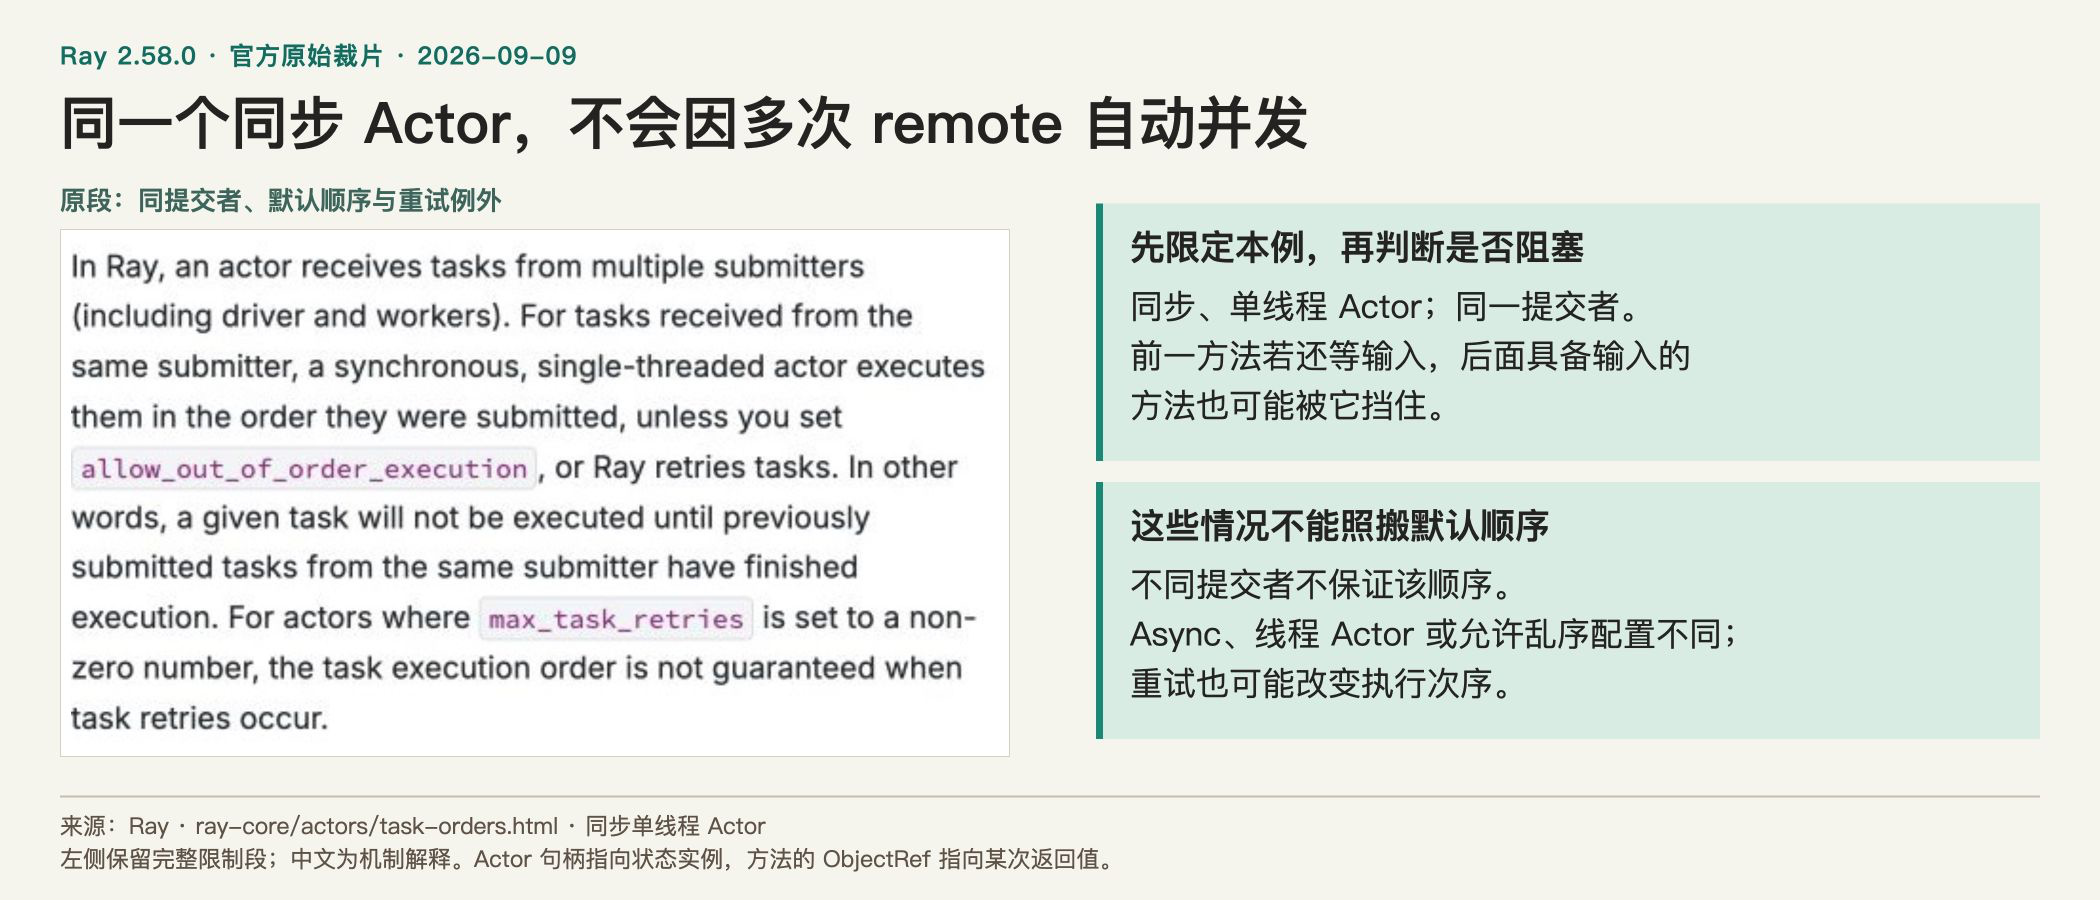
这一例采用同步、单线程 Actor。同一提交者发来的方法,默认按提交顺序执行;即使 Driver 很快提交十次 .score.remote(),这个 Actor 也不会自动同时跑十次评分。若前一个调用仍等预处理结果,后面已经具备输入的调用也可能被它挡住。不同 Actor 可以分别执行,Async 或线程 Actor 则有不同的并发约束。执行顺序文档还特别限定:不同提交者之间不保证上述顺序,允许乱序配置或发生重试时也不能沿用默认顺序推断。
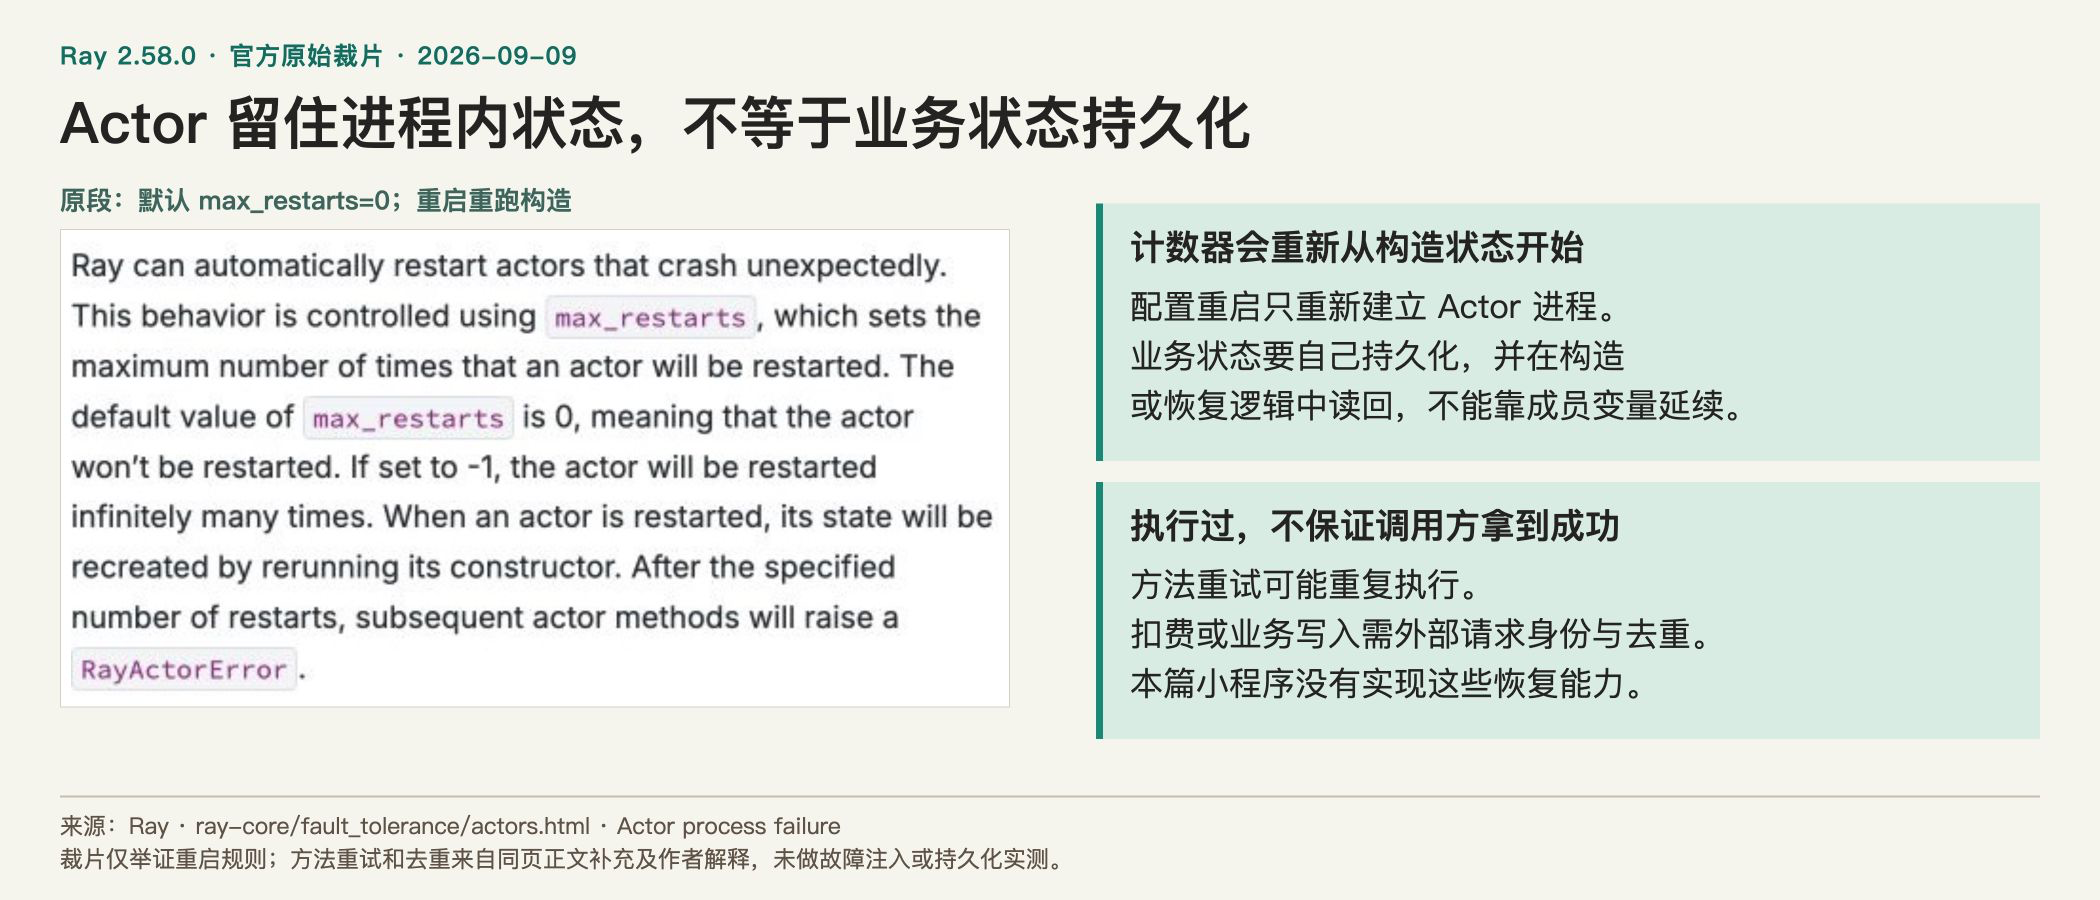
进程驻留同样不等于业务状态持久化。Actor 意外退出后,默认不会自动重启;配置 max_restarts 后,重启会重新执行构造函数。这个计数器因此从零开始,而不是继续上一次的值。业务需要恢复时,必须自行持久化并在构造或恢复逻辑中读取。
Actor 容错文档还指出,调用已经执行但 Actor 在返回后立即死亡,调用方仍可能收到错误;开启方法重试又可能带来重复执行。若评分之外还要扣费或写业务结果,不能靠计数器判断“恰好执行一次”。应围绕请求身份,在外部持久化系统中设计去重与写入语义。这是应用要补的能力,下面的小程序没有实现它。
把一条依赖链写成有界流程
把所有 get 都移到最后,也不能无限提交。输入持续到来而下游消费较慢时,在途工作会积累。Ray 的限制 pending tasks 模式使用 ray.wait 让提交方适时停下来,先处理已就绪结果,再释放提交窗口。
下面是完整的单机教学代码,需自行准备 Ray 环境。两份逻辑 CPU 的安排给一个 Actor 和预处理 Task 留出资源;窗口设为二只为观察有界行为,不是性能推荐值。不同输入的预处理与评分可以重叠,评分始终交给同一个同步 Actor,以便看清状态的连续变化。
import ray
@ray.remote(num_cpus=1)
def prepare(request_id, text):
return request_id, text.strip().lower()
@ray.remote(num_cpus=1)
class Scorer:
def __init__(self):
self.processed = 0
def score(self, item):
request_id, text = item
self.processed += 1
return request_id, len(text), self.processed
def main():
ray.init(num_cpus=2)
try:
scorer = Scorer.remote()
inputs = [("a", " Hello "), ("b", "RAY"), ("c", " Actor ")]
pending, results = [], {}
window = 2
def collect_one():
nonlocal pending
ready, pending = ray.wait(pending, num_returns=1)
request_id, score, processed = ray.get(ready[0])
results[request_id] = (score, processed)
for request_id, text in inputs:
if len(pending) >= window:
collect_one()
prepared_ref = prepare.remote(request_id, text)
pending.append(scorer.score.remote(prepared_ref))
while pending:
collect_one()
assert results == {"a": (5, 1), "b": (3, 2), "c": (5, 3)}
print(results)
finally:
ray.shutdown()
if __name__ == "__main__":
main()
这里保留了一个明确的等待点:窗口满时,Driver 收取一个终端评分结果,再继续提交。每个终端引用对应一条“预处理→评分”链,因此该循环最多保留两条尚未收取结果的链。链中同时存在 Task 和 Actor 方法,不能把窗口二解释成全系统只有两个 Task,更不能把它当成显存字节上限。
ray.wait 返回就绪引用,不会把同一个同步 Actor 的方法改成并行,也不会替前一个方法解除输入依赖。本例保留同一提交者和默认执行顺序,因此计数断言有明确适用条件;若改成多个 Actor 或并发方法,就需要重新定义状态与顺序。
窗口控制的是在途工作数量。真正能同时运行多少任务还由资源决定,结果本身太大也可能撑满内存。本例把少量结果存在字典中只是为了断言;持续流式生产需要边收边交给消费者,并限制结果缓冲,而不能永久积累这个字典。
遇到执行效率问题时,可以沿这段代码还原一次流程:下一份调用是否已提交,中间值是否必须回到 Driver,下游得到的是值还是引用,方法是否落到同一个 Actor,提交是否快于消费。每个问题都对应一处可查看的代码或运行记录。先找到实际阻塞,再决定该改等待点、依赖表达还是实例组织,才不会把 .remote() 当成自动并行的开关。 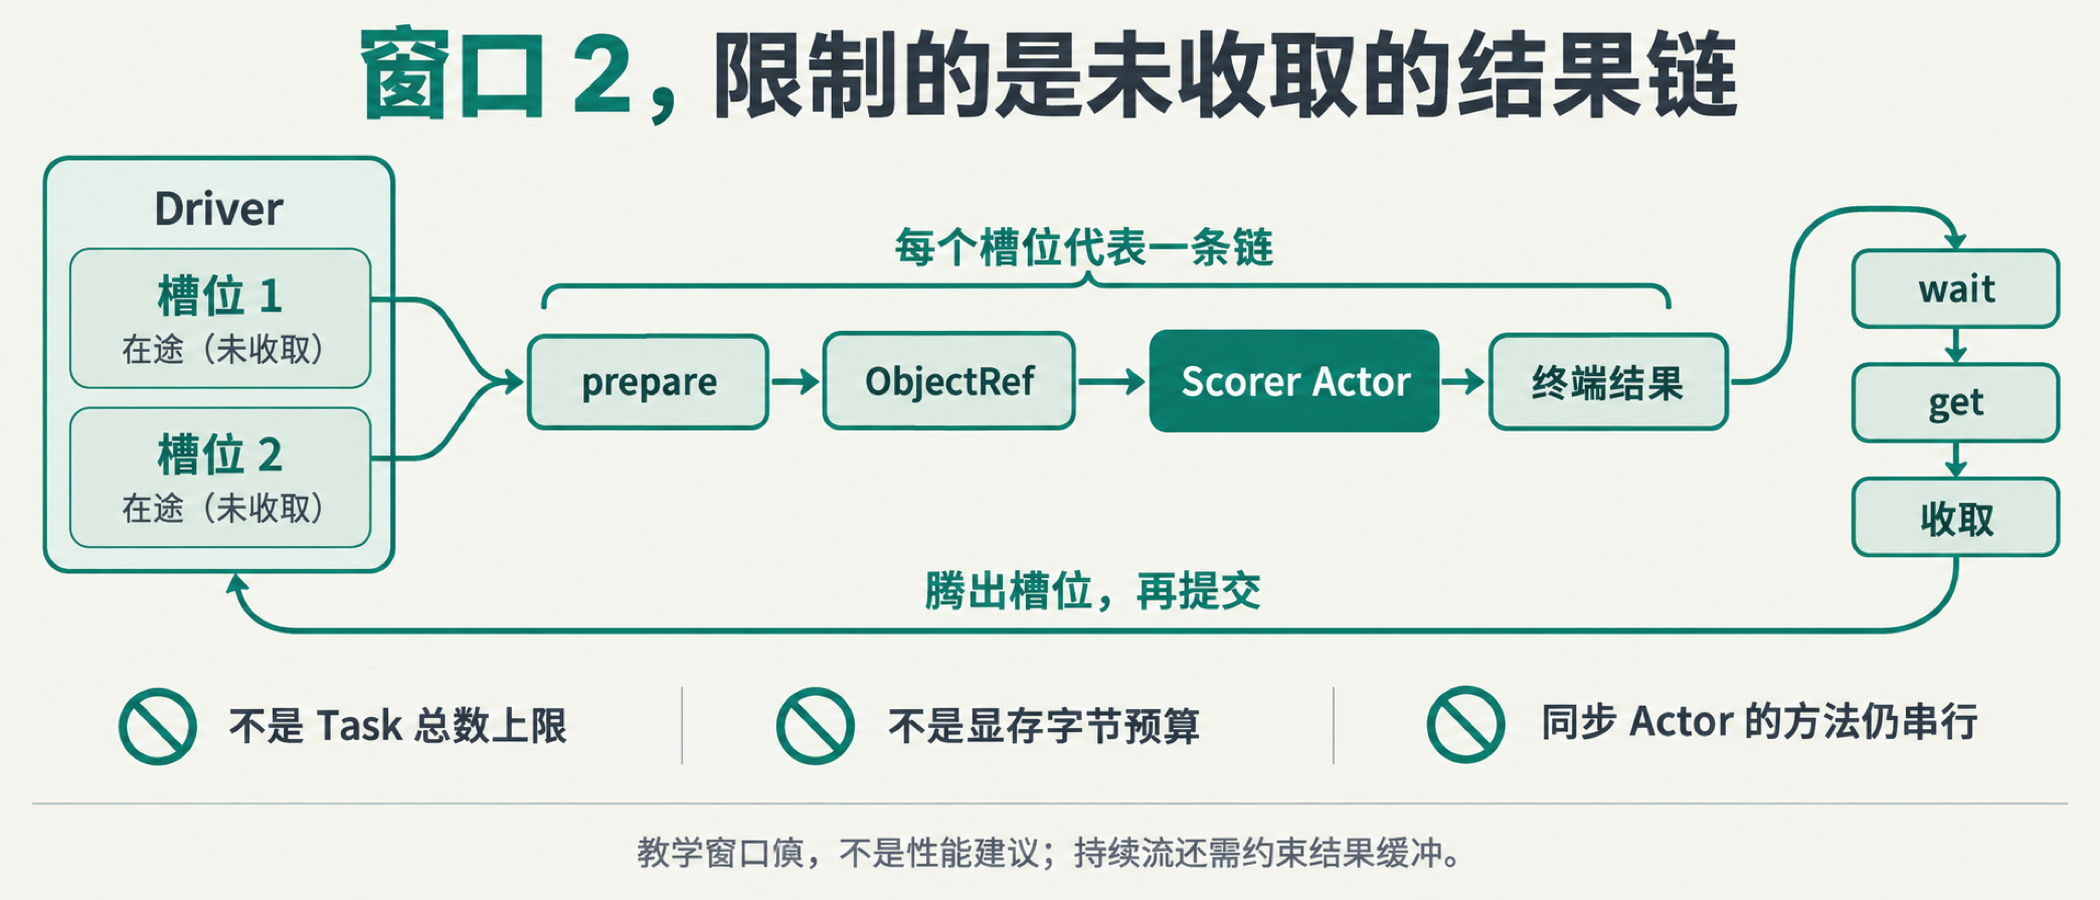



评论前必须登录!
注册