 网硕互联帮助中心
🫧 励志不掉头发的内向程序员:个人主页
✨️ 个人专栏: 《C++语言》《Linux学习》
🌅偶尔悲伤,偶尔被幸福所完善
👓️博主简介:
文章目录
- 前言
- 一、问题的产生
- 二、问题的思考
-
- 2.1、先给"短"定一个标准
- 2.2、只把短线段记下来,够吗?
- 2.3、建模:给点编号,用邻接表存
- 2.4、最关键的一步:短边连成的整块,要一起塌缩
- 2.5、合并一个连通分量:三件事
- 2.6、为什么外面还要套一个 while?
- 三、完整代码
- 四、几个容易踩的坑
- 总结
前言
在日常的工作中,我们总会碰到各种各样的问题。在痛苦的同时,也间接的提高了对问题的解析能力,但是有一些小伙伴们还没有开始实习,却也想锻炼锻炼我们用代码解决问题的能力,或者疑惑学的一些算法、STL 库等,是怎么来解决实际问题的,所以在这里博主打算来一个专辑,来聊聊我在写代码时碰到的一些问题,以及最后是怎么解决的,用到了什么算法等,让大家以后碰到一样的问题时能很快的想到方法。
这一篇,我想聊聊我在实现一个 CAM 的"找中轴线"功能时,碰到的一个合并短线段的问题。它看起来很小,但最后是用一张图解决的。
一、问题的产生
有一天,老板对博主说,你接下来的任务是解决一个函数的 bug,博主得知任务后欣喜若狂,这简直就是摸鱼的美差,一个函数能有多难,看我速速整完后摸几天鱼先╰(°▽°)╯。  然后就看到了这个函数的真面目ಥ_ಥ。什么叫做一个函数有一万行啊。博主虽然欲哭无泪,但是还是想细细品品这坨屎山,结果越品越心惊,为什么一个循环体里面有 9000 行代码啊,这个三重 for 循环加嵌套lambda 是什么东西啊,而且全是浮点数运算是什么鬼啊。就这样,博主倔强了 1 周后实在是没招了,只能重写了,因为是边缘的功能,没有太复杂的调用,所以重写不需要改太多别的地方,只要保持这个函数名不变就行了。
闲话少说,接下来博主在实现功能的时候就遇到了一个问题,生成了一个骨架,这个骨架是用一个数组保存的,这个数组里面保存了很多线段,线段是用两个点记录下来的。
struct Point
{
double x;
double y;
};
vector<pair<Point, Point>> segments;
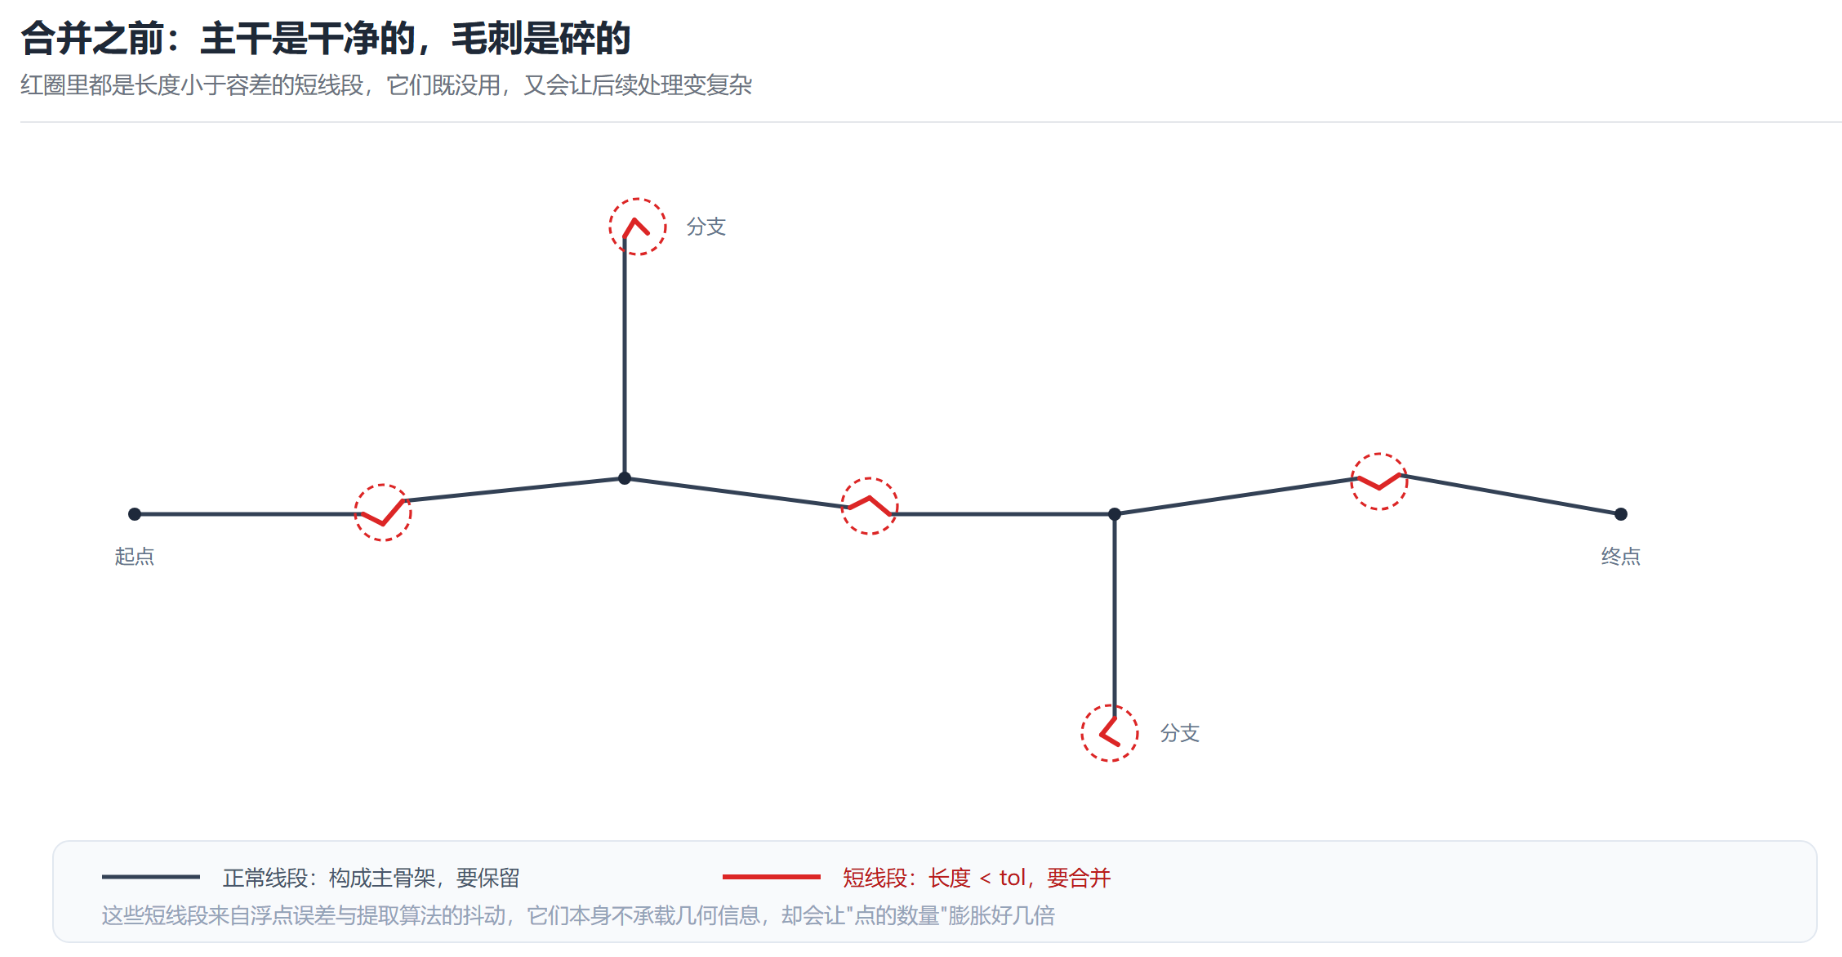 保存的是骨架的线段,但是此时的问题就是,这里面有很多错误的非常短的线段,得去掉,最好是合并起来,但是改怎么做呢?
二、问题的思考
我们的目标是:让这些非常短的线段合并在一起,只留下一个关键的、干净的骨架。
2.1、先给"短"定一个标准
想要合并"非常短的线段",第一步就得回答:多短才算短?
所以要引入一个阈值,来判断一条线段是不是短线段:
double tol;
有了标准,接下来就得算出每条线段的长度,才能拿去和阈值比较。为此需要一个求两点距离的函数:
double distance(const Point& a, const Point& b) {
double dx = a.x – b.x;
double dy = a.y – b.y;
return std::sqrt(dx * dx + dy * dy);
}
很简单,就是初中就学过的两点间距离公式。有了它,我们就能遍历 segments,把短线段全部挑出来。
2.2、只把短线段记下来,够吗?
挑出短线段之后,怎么记录呢?有的小伙伴可能想当然地觉得:这不是很简单,跟 segments 一样不就行了:
std::vector<std::pair<Point, Point>> shortSegments;
从"记录下来"这个层面看,倒也没错。但我们得回到最初的问题:我们要做的是合并。 所谓合并,就是把原来短线段所在的位置,收缩成一个点。假如现在有一条短线段 ab:
c —- a — b ——- d
如果合并时保留 a 点、丢掉 b 点,那么问题来了:原来连在 b 上的那些线段怎么办?
它们现在是连在 b 上的,而 b 马上就要被丢掉了,所以必须把它们全部改接到 a 上——也就是 c—a 和 a—d。那如果我们只用一个 vector 记录短线段,会发生什么?为了找到"谁原本连在 b 上",我们只能回头去遍历整个 segments。而每处理一条短线段都要遍历一次,短线段一多,时间复杂度直接拉满。
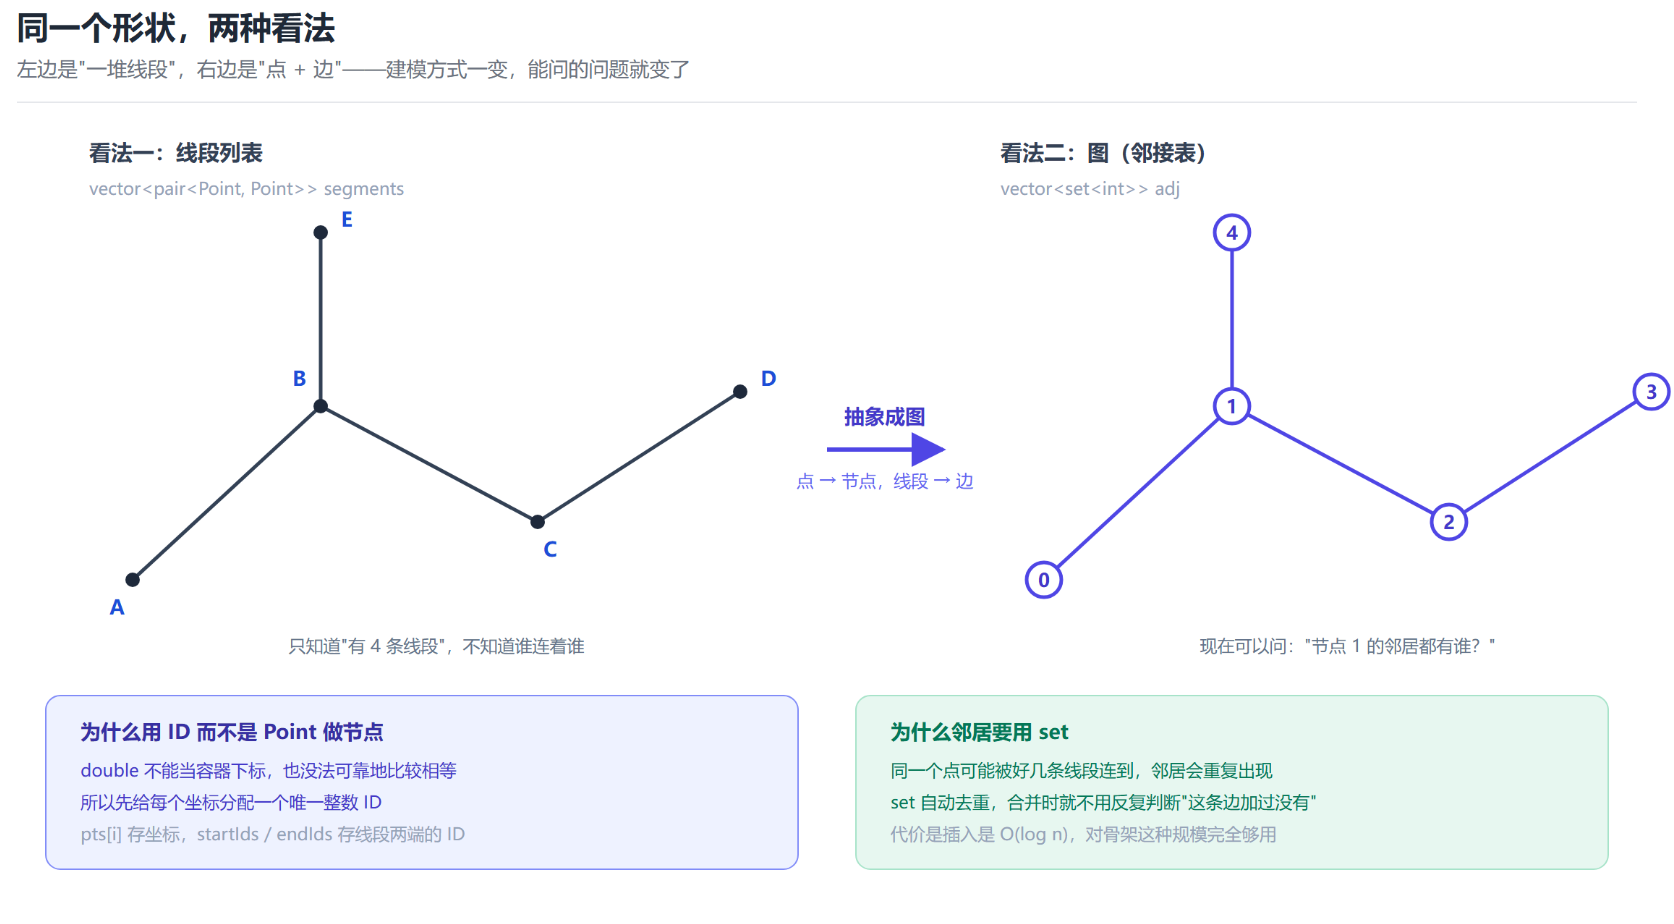
所以真正的难点不是"记下短线段",而是"记下每个点和谁相连"。 我左思右想,最后想到了图。
是啊——图简直是为这个问题量身定做的结构:它既能记录短线段(哪两个点之间有一条短边),又能记录每个点接了哪些邻居。这样在合并时,我们就可以很快地把 b 的邻居全部改接到 a 上,同时把 b 从图里摘掉。
2.3、建模:给点编号,用邻接表存
不过在真正画图之前,还有一个尴尬的问题:Point 里装的是浮点数,浮点数是不能直接拿来当下标的。 所以我们要给每个点分配一个唯一的整数 ID,用 ID 表示图中的节点:
// 当前工作数据:所有端点,以及每条线段两端点的 ID
std::vector<Point> pts;
std::vector<int> startIds, endIds;
auto getOrCreate = [&](const Point& p) -> int {
for (size_t i = 0; i < pts.size(); ++i) {
if (distance(pts[i], p) < eps) { // 浮点数比较,用 eps 而不是 ==
return static_cast<int>(i);
}
}
pts.push_back(p);
return static_cast<int>(pts.size()) – 1;
};
// 初始化:给所有端点分配唯一 ID
for (const auto& seg : segments) {
int sid = getOrCreate(seg.first);
int eid = getOrCreate(seg.second);
if (sid == eid) continue; // 退化线段,直接丢掉
startIds.push_back(sid);
endIds.push_back(eid);
}
这里有两个细节值得说一下。
第一,为什么把起点和终点分成两个数组? 因为后面操作线段时基本都是"成对"操作的,如果把它们混在一个容器里,删除和替换时就得处理下标奇偶性,非常容易出错。分开存之后,一条线段就是"startIds[i] 连到 endIds[i]“,增删都干净。 第二,为什么不用 pts[i] == p 判断两个点是否相同? 因为 Point 里是 double。两个理论上相同的点,经过一连串运算后可能差出 1e-16,用 == 一定会有漏网的。所以这里用 distance(…) < eps 来判定"是同一个点”。
有了 ID 之后,图就可以直接建出来了:
int n = static_cast<int>(pts.size());
std::vector<std::set<int>> adj(n); // 记录所有边
std::vector<std::set<int>> shortAdj(n); // 记录所有短边
用 std::set 而不是 vector 存邻居,是为了自动去重——同一个点可能被多条线段连到,重复的邻居会让后面的合并逻辑出错。
2.4、最关键的一步:短边连成的整块,要一起塌缩
写到这里,我一开始的思路是"逐条合并短边":找到一条短边 ab,就把 b 并到 a 上。但很快就发现这样不对。看这种情况:
a — b — c — d
四条短边首尾相接,如果只按"两两合并"来做,处理 A-B 时把 B 并到 A,再处理 B-C 时 B 已经不存在了……一轮下来要么漏掉,要么陷入反复修改。正确的看法是:短边在图上连成的整块区域,应该整体塌缩成一个点。 这在图论里有现成的名字——连通分量。把短边构成的子图单独拿出来,每个连通分量里的所有点,最终都要合并成同一个点。
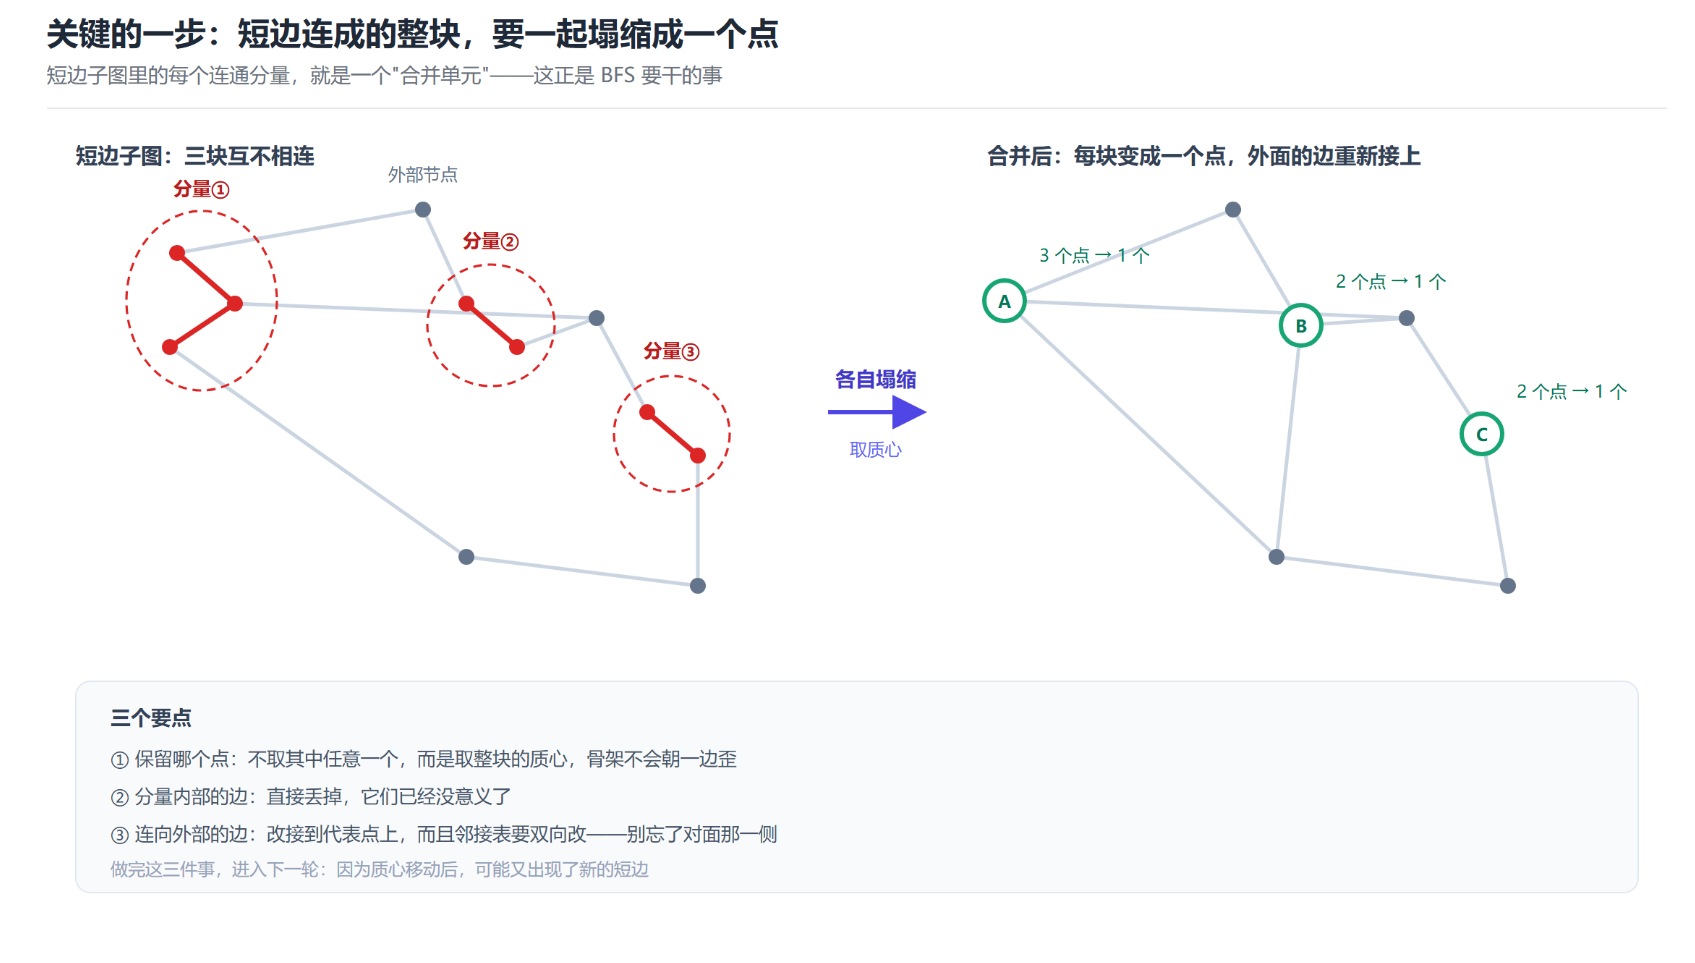
这就是整套算法的核心。想清楚这一点之后,剩下的都是工程活儿。
2.5、合并一个连通分量:三件事
对每个包含两个以上点的连通分量,要做三件事。
第一件,算出这个分量合并后的位置。
保留哪一个点呢?如果直接取其中一个点,整个骨架会朝那个点"歪过去";取平均位置(质心)更稳:
Point center{0.0, 0.0};
for (int idx : comp) {
center.x += pts[idx].x;
center.y += pts[idx].y;
}
center.x /= static_cast<double>(comp.size());
center.y /= static_cast<double>(comp.size());
第二件,把分量外的邻居改接到代表点上。
分量里我们只留一个代表点 rep,其余全部标记为"已移除"。然后遍历它们原来的邻居,凡是不在本分量内的(也就是连向外面的长边),一律改接到 rep 上:
const int rep = comp.front();
pts[rep] = center;
for (size_t k = 1; k < comp.size(); ++k) removed[comp[k]] = true;
for (int idx : comp) {
if (idx == rep) continue;
for (int nb : adj[idx]) {
if (removed[nb] || nb == rep) continue; // 分量内部的边,直接丢掉
adj[rep].insert(nb);
adj[nb].erase(idx); // 对面也别忘了改
adj[nb].insert(rep);
}
adj[idx].clear();
}
注意这里最关键的一点:改邻接表是双向的。 你不仅要把 nb 挂到 rep 上,还得把 nb 原来记录的 idx 删掉、换成 rep,否则下一次遍历的时候,它会去找一个已经不存在的点。
第三件,按邻接表重建点表和边表。
因为点已经被移除了,下标全乱了,所以干脆整个重建一遍:先给剩下的点重新编号,再用一个 set<pair<int,int>> 收集去重后的边。这里用 edgeSet 而不是直接塞进 vector,是为了防止同一条边被存两次——毕竟邻接表里 u 有 v、v 也有 u,遍历两遍就会重复。至于 BFS 找连通分量的部分,就是最基础的广搜,这里就不展开讲了。
2.6、为什么外面还要套一个 while?
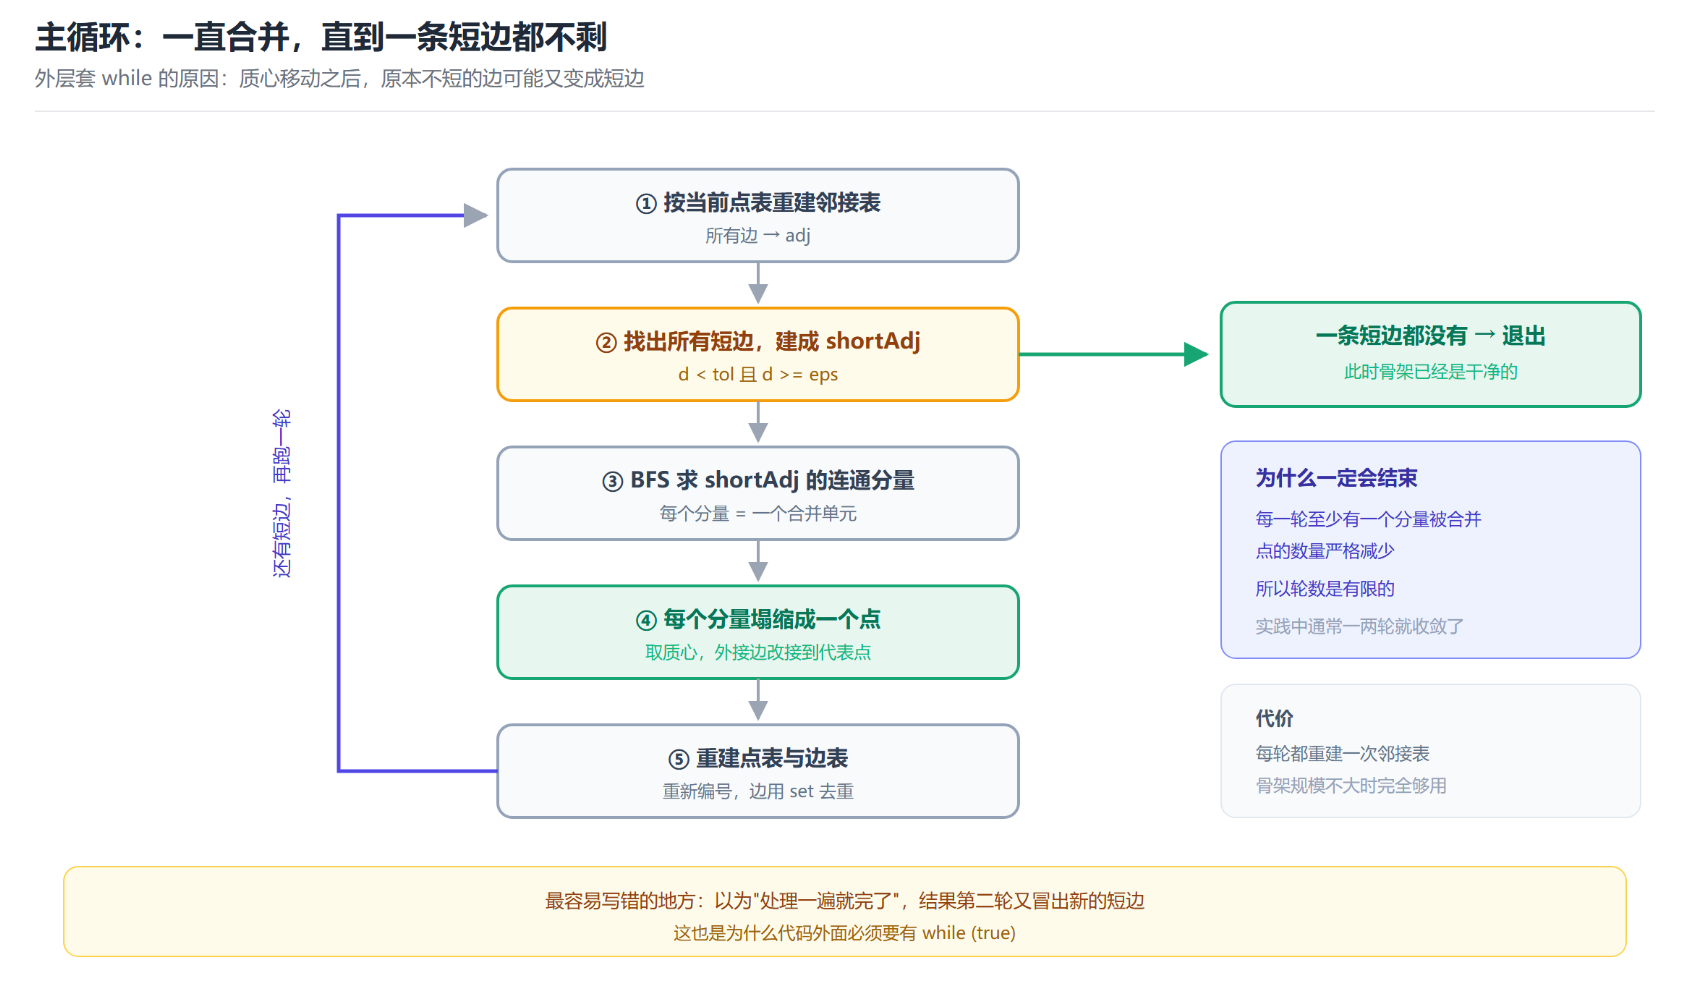
还有一个很容易被忽略的点:合并会让代表点移动位置,而移动之后,可能又出现了新的短边。 比如 A 和 B 合并后,新的点更靠近 C 了,原本不算短的 A-C 变成了短路。所以整个过程必须循环执行,直到某一轮里一条短边都找不到为止:
while (true) {
// 1. 重建邻接表
// 2. 找出所有短边,一条都没有就 break
// 3. BFS 找连通分量
// 4. 逐个分量塌缩
// 5. 重建点表与边表
}
每一轮至少会消掉一个点,所以这个循环一定会在有限轮内结束。
三、完整代码
把上面的思路拼起来,就是最终的实现(为了方便阅读,我做了一点点整理和加固):
#include <cmath>
#include <queue>
#include <set>
#include <utility>
#include <vector>
struct Point
{
double x = 0.0;
double y = 0.0;
};
using Segment = std::pair<Point, Point>;
// 两点间距离
inline double distance(const Point& a, const Point& b) {
const double dx = a.x – b.x;
const double dy = a.y – b.y;
return std::sqrt(dx * dx + dy * dy);
}
std::vector<Segment> mergeShortSegments(const std::vector<Segment>& segments,
double tol, double eps = 1e-9)
{
std::vector<Segment> result;
if (segments.empty()) return result;
// ———- 1. 给每个端点分配唯一 ID ———-
std::vector<Point> pts;
std::vector<int> startIds, endIds;
auto getOrCreate = [&](const Point& p) -> int {
for (size_t i = 0; i < pts.size(); ++i) {
if (distance(pts[i], p) < eps) {
return static_cast<int>(i);
}
}
pts.push_back(p);
return static_cast<int>(pts.size()) – 1;
};
for (const auto& seg : segments) {
int sid = getOrCreate(seg.first);
int eid = getOrCreate(seg.second);
if (sid == eid) continue; // 退化线段,丢弃
startIds.push_back(sid);
endIds.push_back(eid);
}
// ———- 2. 反复合并,直到没有短边 ———-
while (true) {
const int n = static_cast<int>(pts.size());
// 2.1 所有边构成的邻接表
std::vector<std::set<int>> adj(n);
for (size_t i = 0; i < startIds.size(); ++i) {
int u = startIds[i], v = endIds[i];
if (u == v || distance(pts[u], pts[v]) < eps) continue;
adj[u].insert(v);
adj[v].insert(u);
}
// 2.2 短边构成的邻接表
bool hasShort = false;
std::vector<std::set<int>> shortAdj(n);
for (size_t i = 0; i < startIds.size(); ++i) {
int u = startIds[i], v = endIds[i];
if (u == v) continue;
const double d = distance(pts[u], pts[v]);
if (d < tol && d >= eps) {
shortAdj[u].insert(v);
shortAdj[v].insert(u);
hasShort = true;
}
}
if (!hasShort) break; // 没有短边了,收工
// 2.3 BFS 找出短边图的连通分量
std::vector<char> visited(n, 0);
std::vector<std::vector<int>> comps;
for (int i = 0; i < n; ++i) {
if (visited[i] || shortAdj[i].empty()) continue;
std::vector<int> comp;
std::queue<int> q;
q.push(i);
visited[i] = 1;
while (!q.empty()) {
const int u = q.front();
q.pop();
comp.push_back(u);
for (int nb : shortAdj[u]) {
if (!visited[nb]) {
visited[nb] = 1;
q.push(nb);
}
}
}
comps.push_back(std::move(comp));
}
// 2.4 每个连通分量塌缩成一个点
std::vector<char> removed(n, 0);
for (const auto& comp : comps) {
if (comp.size() <= 1) continue;
// 用质心作为合并后的位置
Point center{0.0, 0.0};
for (int idx : comp) {
center.x += pts[idx].x;
center.y += pts[idx].y;
}
center.x /= static_cast<double>(comp.size());
center.y /= static_cast<double>(comp.size());
const int rep = comp.front();
pts[rep] = center;
for (size_t k = 1; k < comp.size(); ++k) {
removed[comp[k]] = 1;
}
// 把连向外部的边改接到 rep 上
for (int idx : comp) {
if (idx == rep) continue;
for (int nb : adj[idx]) {
if (removed[nb] || nb == rep) continue;
adj[rep].insert(nb);
adj[nb].erase(idx);
adj[nb].insert(rep);
}
adj[idx].clear();
}
}
// 2.5 按邻接表重建点表和边表
std::vector<Point> newPts;
std::vector<int> oldToNew(n, –1);
for (int i = 0; i < n; ++i) {
if (!removed[i]) {
oldToNew[i] = static_cast<int>(newPts.size());
newPts.push_back(pts[i]);
}
}
std::set<std::pair<int, int>> edgeSet;
for (int i = 0; i < n; ++i) {
if (removed[i]) continue;
for (int nb : adj[i]) {
if (removed[nb] || nb == i) continue;
int a = oldToNew[i], b = oldToNew[nb];
if (a > b) std::swap(a, b);
edgeSet.insert({a, b});
}
}
pts = std::move(newPts);
startIds.clear();
endIds.clear();
for (const auto& e : edgeSet) {
startIds.push_back(e.first);
endIds.push_back(e.second);
}
}
// ———- 3. 还原成线段列表 ———-
result.reserve(startIds.size());
for (size_t i = 0; i < startIds.size(); ++i) {
result.push_back({pts[startIds[i]], pts[endIds[i]]});
}
return result;
}
四、几个容易踩的坑
代码本身不长,但里面有几个地方是我改了好几遍才写对的,单独列出来。 第一个,浮点数永远不要用 == 比较。 判断两个点是不是同一个点、判断一条线段是不是零长度,统统要用 eps。我一开始就是在这里栽了跟头:理论上同一个点,运算之后差了 1e-16,结果被判成两个不同的点,图上凭空多出一堆孤立节点。 第二个,退化线段要提前丢掉。 如果一条线段的两端被判定成同一个点(sid == eid),它是一条零长度线段,必须提前跳过。否则在"第一轮就没有短边、直接退出"的情况下,这些零长线段会被原样带出去——因为它建邻接表时就被 u == v 跳过了,根本没机会被清理。这个小 bug 很隐蔽,我是拿几组边界数据挨个试才发现的。 第三个,改图的时候邻接表要双向改。 把 nb 接到 rep 上时,别忘了把 nb 那边记录的旧点删掉。漏掉这一步,下一次遍历就会访问到一个已经被移除的点。 第四个,重建边表要用 set 去重。 邻接表是双向的,直接遍历会得到两条相同的边。 第五个,getOrCreate 用的是线性查找,点多了会慢。 上面为了好读,我用的是"逐个比较",复杂度是 O(P²)。如果骨架里有几十万个点,这里就会成为瓶颈。实际项目里可以换成一个哈希表(把点坐标量化到网格再建索引),能降到接近 O§。这一点我当时是压测之后才发现要优化的。
总结
回头看这个问题,我觉得最有价值的不是最后那几十行代码,而是中间的三个判断: 第一个判断:先想清楚"合并"到底意味着什么。 如果一上来就写"把 b 删掉、把 a 留下",很快就会卡在"b 的邻居怎么办"。把这个问题想明白,才意识到我们需要的是一个能表达"谁和谁相连"的结构。 第二个判断:认出这是图,并且认出这是连通分量。 把线段集合看成图之后,“一堆短边连在一起"就变成了"短边子图里的一个连通分量”,而"整块塌缩成一个点"就成了顺理成章的操作。算法书上那个平平无奇的 BFS,在这里就是解决实际问题的关键一步。 第三个判断:合并会改变几何,所以要循环到收敛。 这一点最容易被忽略。很多"一次性处理"的写法都是在这里出错的——处理完第一轮就以为结束了,其实新的短边又冒出来了。 最后分享一句体会:工程里遇到的大多数问题,都不是"用某个高级算法"解决的,而是"把问题抽象成正确的结构"解决的。 这个问题的算法部分其实就是 BFS;真正花时间的,是把它建模成一张图。如果这篇对你有帮助,后面我还会继续更新这个专辑,聊聊实习中碰到的其他问题。有什么说得不对的地方也欢迎指出,谢谢大家。
🎇坚持到这里已经很厉害啦,辛苦啦🎇
ʕ • ᴥ • ʔ
づ♡ど


评论前必须登录!
注册