 网硕互联帮助中心
数据还在路上,业务已经需要答案了
前阵子跟一家出行平台的数据负责人聊天,他说了一件事让我印象很深。平台每天产生数千万条订单和轨迹数据,风控系统需要在用户下单后的毫秒内判断这笔订单是否异常。但传统批处理模式下,数据要先落到数仓、再跑ETL、再算指标——等结果出来,订单早就完成了。
他说:等我们算完,钱已经付了、单已经跑了。风控变成了'事后追认'。
这不是他一家的问题。流式数据处理要解决的核心难题,恰恰是这两个——怎么让数据边来边算、算完即用,以及怎么处理实时数据中不可避免的乱序问题。今天就把这两个问题一次讲清楚。
感兴趣的朋友可以立马体验Finedatalink:https://s.fanruan.com/ysq87。
一、流式数据如何实现业务毫秒级实时计算?
毫秒级实时计算的核心逻辑,是把先存后算变成边来边算——数据产生的那一刻就开始处理,不等落库、不等调度。
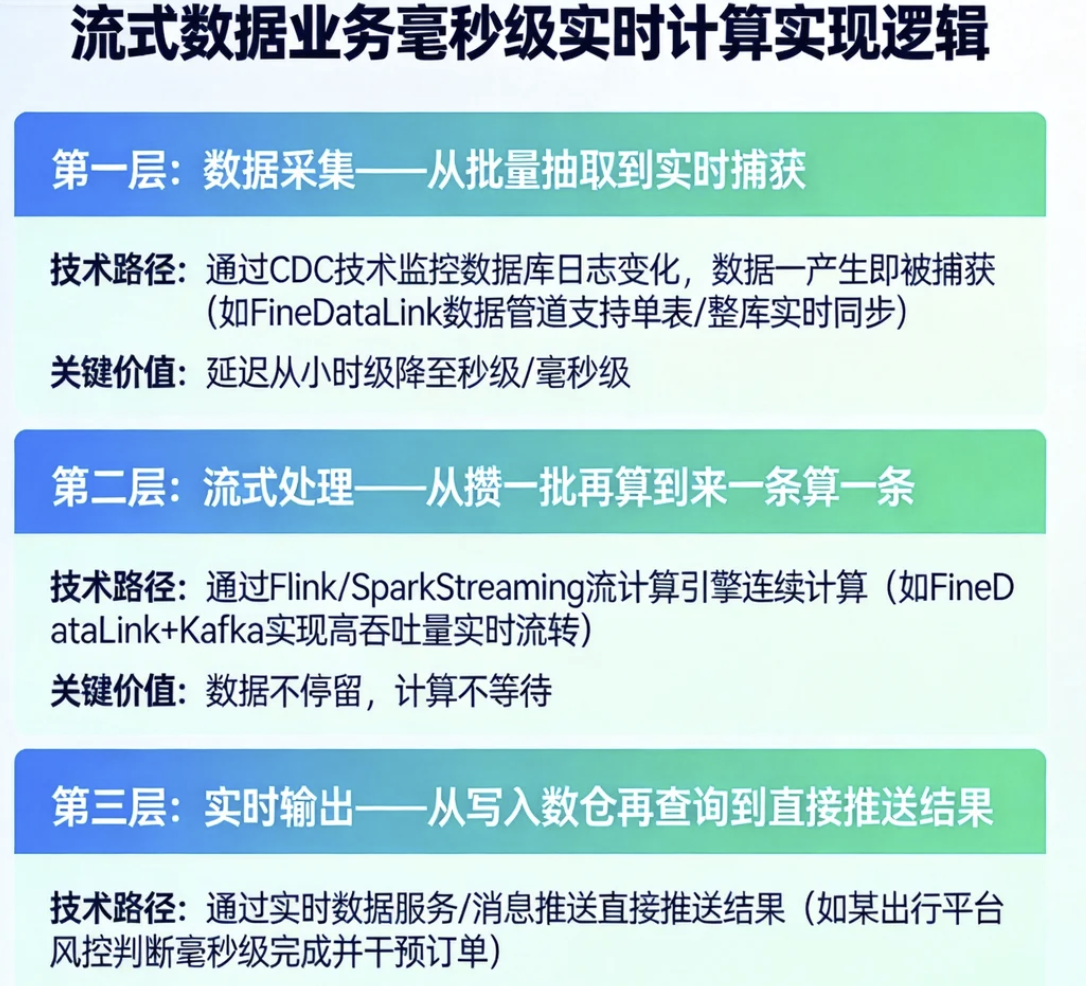
第一层:数据采集——从批量抽取到实时捕获
传统模式下,数据从业务系统到分析平台要经过定时抽取环节——每小时或每天抽一次。流式处理的第一步,是把定时抽取变成实时捕获。
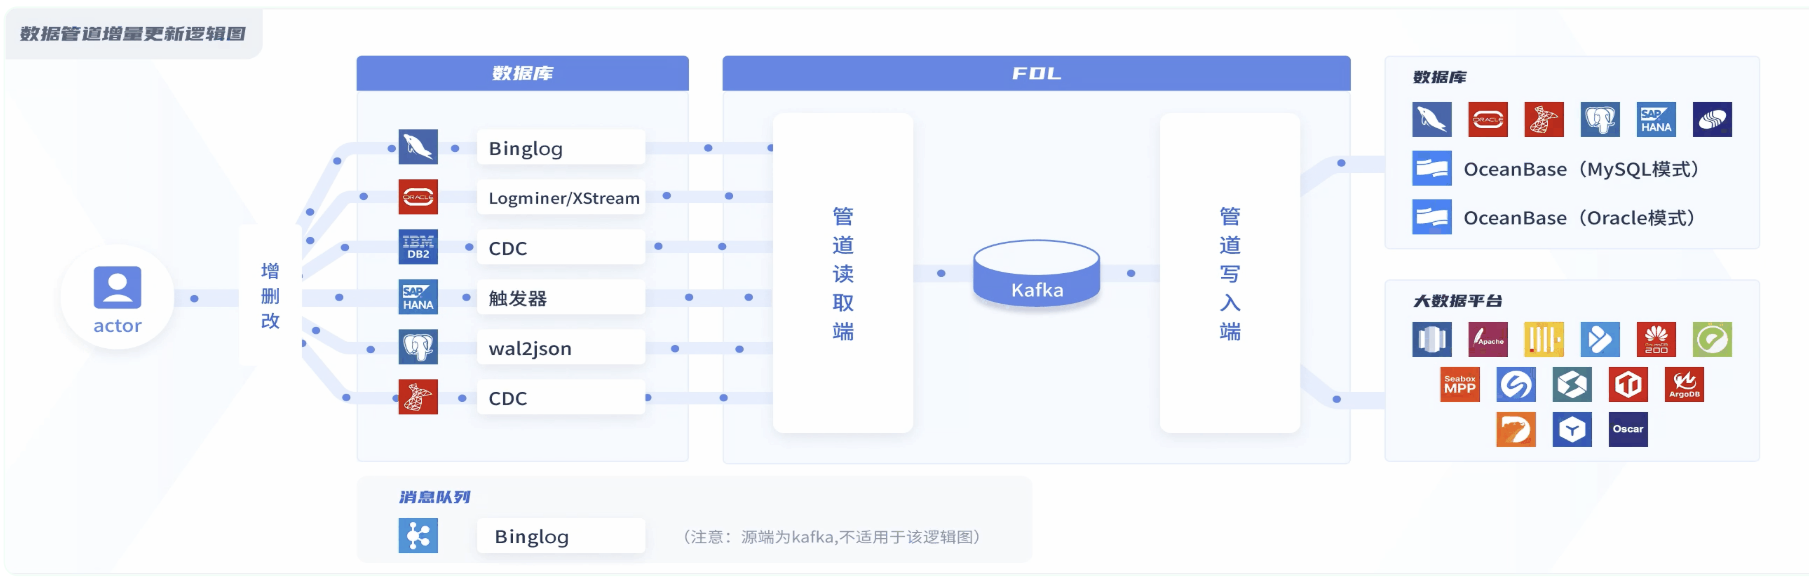
技术路径:通过CDC(变更数据捕获)技术监控数据库日志变化,数据一产生就被捕获,而不是等定时任务来抽。FineDataLink的数据管道支持实时数据同步,通过监控数据库日志变化,实现单表或整库数据的实时同步。
关键价值:从小时级延迟变成秒级甚至毫秒级延迟。
第二层:流式处理——从攒一批再算到来一条算一条
数据捕获之后,需要立即处理。传统批处理是攒一批再算,流式处理是来一条算一条。
技术路径:通过流计算引擎(如Flink、SparkStreaming)对实时数据进行连续计算。FineDataLink通过Kafka中间件作为数据缓冲与分发通道,支持高吞吐量的实时数据流转与处理,数据延迟可缩短到秒级甚至毫秒级。
关键价值:数据不停留,计算不等待。
第三层:实时输出——从写入数仓再查询到直接推送结果
计算结果需要立即送到业务端。传统模式下,结果先写入数仓,业务再查数仓——多了一道写入+查询的环节。
技术路径:通过实时数据服务或消息推送,把计算结果直接推送到业务系统。某出行平台通过实时流处理,风控判断在毫秒内完成,直接干预订单流程。
二、流式数据怎样解决实时数据乱序异常?
实时数据乱序是流式处理中最常见也最难解决的问题。数据从不同源系统产生,经过不同网络路径到达处理引擎——先产生的数据可能后到,后产生的数据可能先到。如果不处理乱序,计算结果就会出错。
方法一:事件时间+水位线——区分什么时候发生的和什么时候到的
流式处理中,有两个时间概念容易混淆:事件时间(数据实际发生的时间)和处理时间(数据到达处理引擎的时间)。乱序的本质是处理时间和事件时间不一致。
解决路径:采用事件时间语义,配合水位线机制。水位线是一个时间戳,表示在这个时间之前的数据都已经到了。当水位线推进到某个时间点,系统就认为该时间点之前的数据已经全部到达,可以触发计算。
实操逻辑:设置一个允许延迟时间(如5秒),水位线在最大事件时间减去允许延迟时间的位置推进。这样,即使有数据乱序到达,只要延迟不超过允许范围,计算结果仍然正确。
方法二:窗口聚合+延迟触发——让迟到的数据也能被算进去
窗口聚合是流式处理中最常用的计算模式——按时间窗口(如每分钟、每5分钟)聚合数据。但乱序数据可能导致窗口已经关闭了,数据才到。
解决路径:设置延迟触发机制——窗口关闭后,不立即销毁,而是保留一段时间(如允许延迟时间),等待迟到的数据到达后重新触发计算。
实操逻辑:某实时报表场景中,系统按5分钟窗口聚合订单量。如果设置了30秒的允许延迟,窗口关闭后30秒内到达的订单仍然会被计入该窗口,确保计算结果准确。
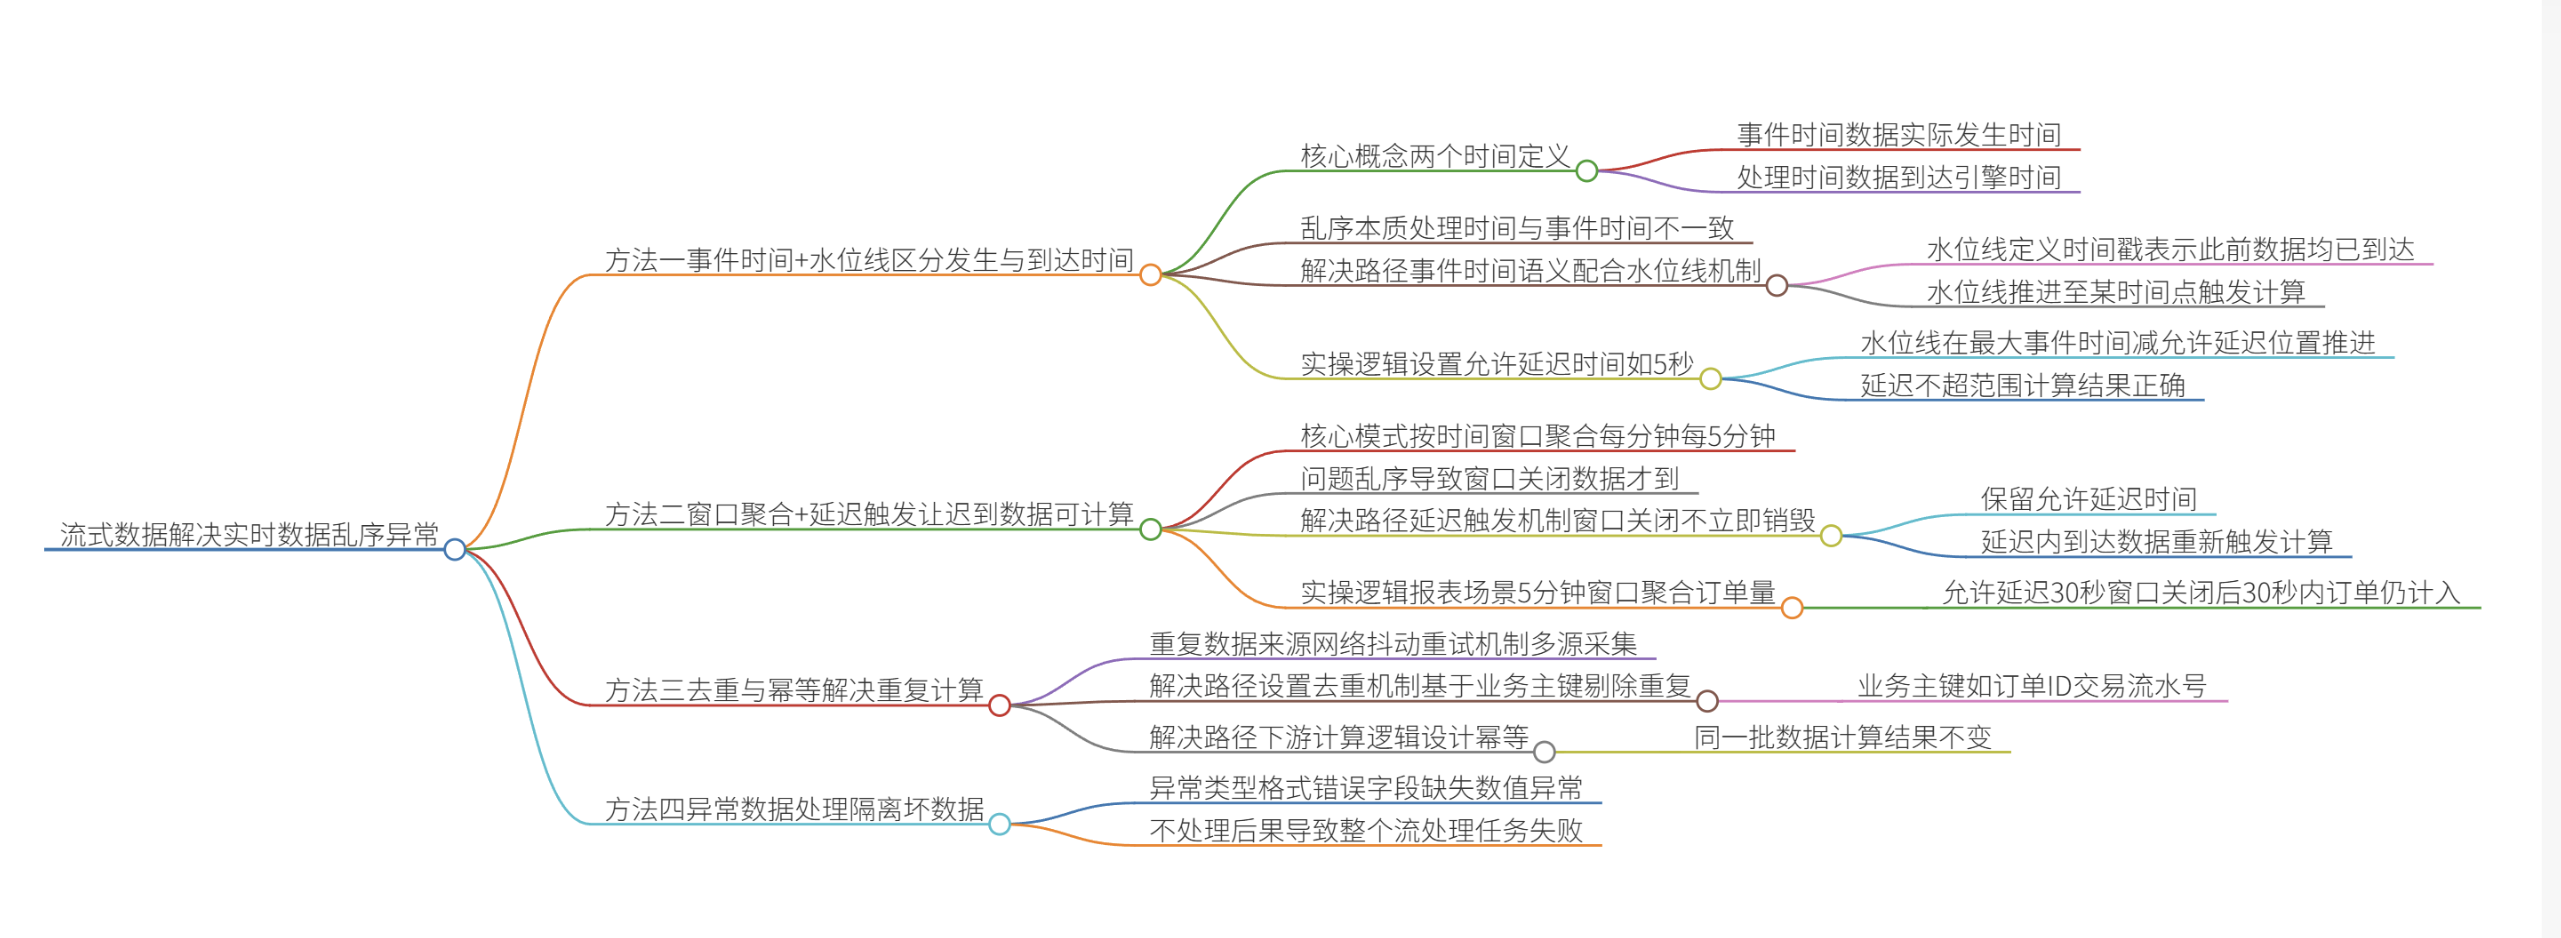
方法三:去重与幂等——解决重复数据导致的重复计算
流式数据中,重复数据是另一个常见异常。网络抖动、重试机制、多源采集——都可能导致同一条数据被处理多次。
解决路径:在流处理环节设置去重机制,基于业务主键(如订单ID、交易流水号)识别并剔除重复数据。同时,下游计算逻辑设计为幂等——同一批数据计算多次,结果不变。
方法四:异常数据处理——把坏数据隔离出来
流式数据中,格式错误、字段缺失、数值异常的数据不可避免。如果不处理,这些坏数据可能导致整个流处理任务失败。
解决路径:在流处理管道中设置异常数据旁路——正常数据走主流程,异常数据被分流到死信队列或异常数据表,不阻塞主流程。同时,对异常数据进行标记和告警,供后续人工排查。
在流式数据处理和乱序异常解决的落地中,FineDataLink承担的是实时数据管道的角色:通过Kafka中间件实现高吞吐量的实时数据流转,支持实时流处理与离线批处理;其数据管道功能支持断点续传,确保网络异常后数据不丢失;通过脏数据阈值配置和异常数据旁路机制,确保乱序和异常数据不会阻塞主流程。
流式数据实现毫秒级实时计算的核心,是把先存后算变成边来边算——用CDC实时捕获数据、用流计算引擎实时处理、用实时推送直接送到业务端。从小时级到毫秒级,每一个环节都在压缩延迟。
流式数据解决乱序异常的核心,是用事件时间代替处理时间、用水位线判断数据到齐、用延迟触发等待迟到数据、用去重和幂等处理重复数据、用异常旁路隔离坏数据。
用过来人的经验告诉你,判断流式处理做得好不好,标准很简单:业务做决策的时候,用的是此刻的数据还是几小时前的数据。如果是几小时前的,说明实时处理没做到位;如果是此刻的,那才是真正的毫秒级实时计算。
常见问题解答
Q:毫秒级实时计算,最难的是什么?
A:最难的是端到端的延迟控制。数据从产生到业务可用,中间要经过采集、传输、处理、输出多个环节。任何一个环节的延迟都会累积。实现毫秒级延迟,需要每个环节都不拖后腿——采集用CDC实时捕获,传输用Kafka高吞吐通道,处理用流计算引擎,输出用实时推送。
Q:实时数据乱序,不处理会怎样?
A:计算结果会出错。比如按时间窗口统计每分钟订单量,如果先到的数据是10:00:05产生的,后到的数据是10:00:03产生的,不处理乱序的话,10:00:03的订单可能被计入错误的窗口。处理乱序的核心是用事件时间代替处理时间,配合水位线和延迟触发机制。
Q:中小企业需要做实时流处理吗?
A:取决于业务场景。如果业务对时效性要求不高(T+1报表即可),不需要实时流处理。如果业务需要实时风控、实时推荐、实时监控,实时流处理就有价值。


评论前必须登录!
注册