 网硕互联帮助中心
(1)《三年面试五年模拟》AIGC / LLM / AI Agent 算法工程师与开发工程师求职面试秘籍,独家资源见 WeThinkIn/AIGC-Interview-Book,欢迎 Star! (2)AIGC / LLM / AI Agent 算法岗与开发岗求职面试内推学习社群,涵盖 AIGC、LLM 大模型、AI Agent、传统深度学习、自动驾驶、机器学习、计算机视觉、自然语言处理、强化学习、大数据挖掘、具身智能、元宇宙、AGI 等方向的最新面试干货与核心知识,欢迎加入(https://t.zsxq.com/33pJ0)!
论文标题:PaddleOCR-VL-1.6: Expanding the Frontier of Document Parsing with Under-Optimized Region Refinement and Progressive Post-Training 论文作者:百度飞桨 发表时间:2026年6月2日
目录
-
- 一、两阶段流水线沿用1.5的0.9B架构
- 二、边界脆弱、覆盖稀疏、监督不可靠三路挖掘
- 三、多专家共识与渲染引导标注
- 四、CPT到SFT再到GRPO的递进后训练
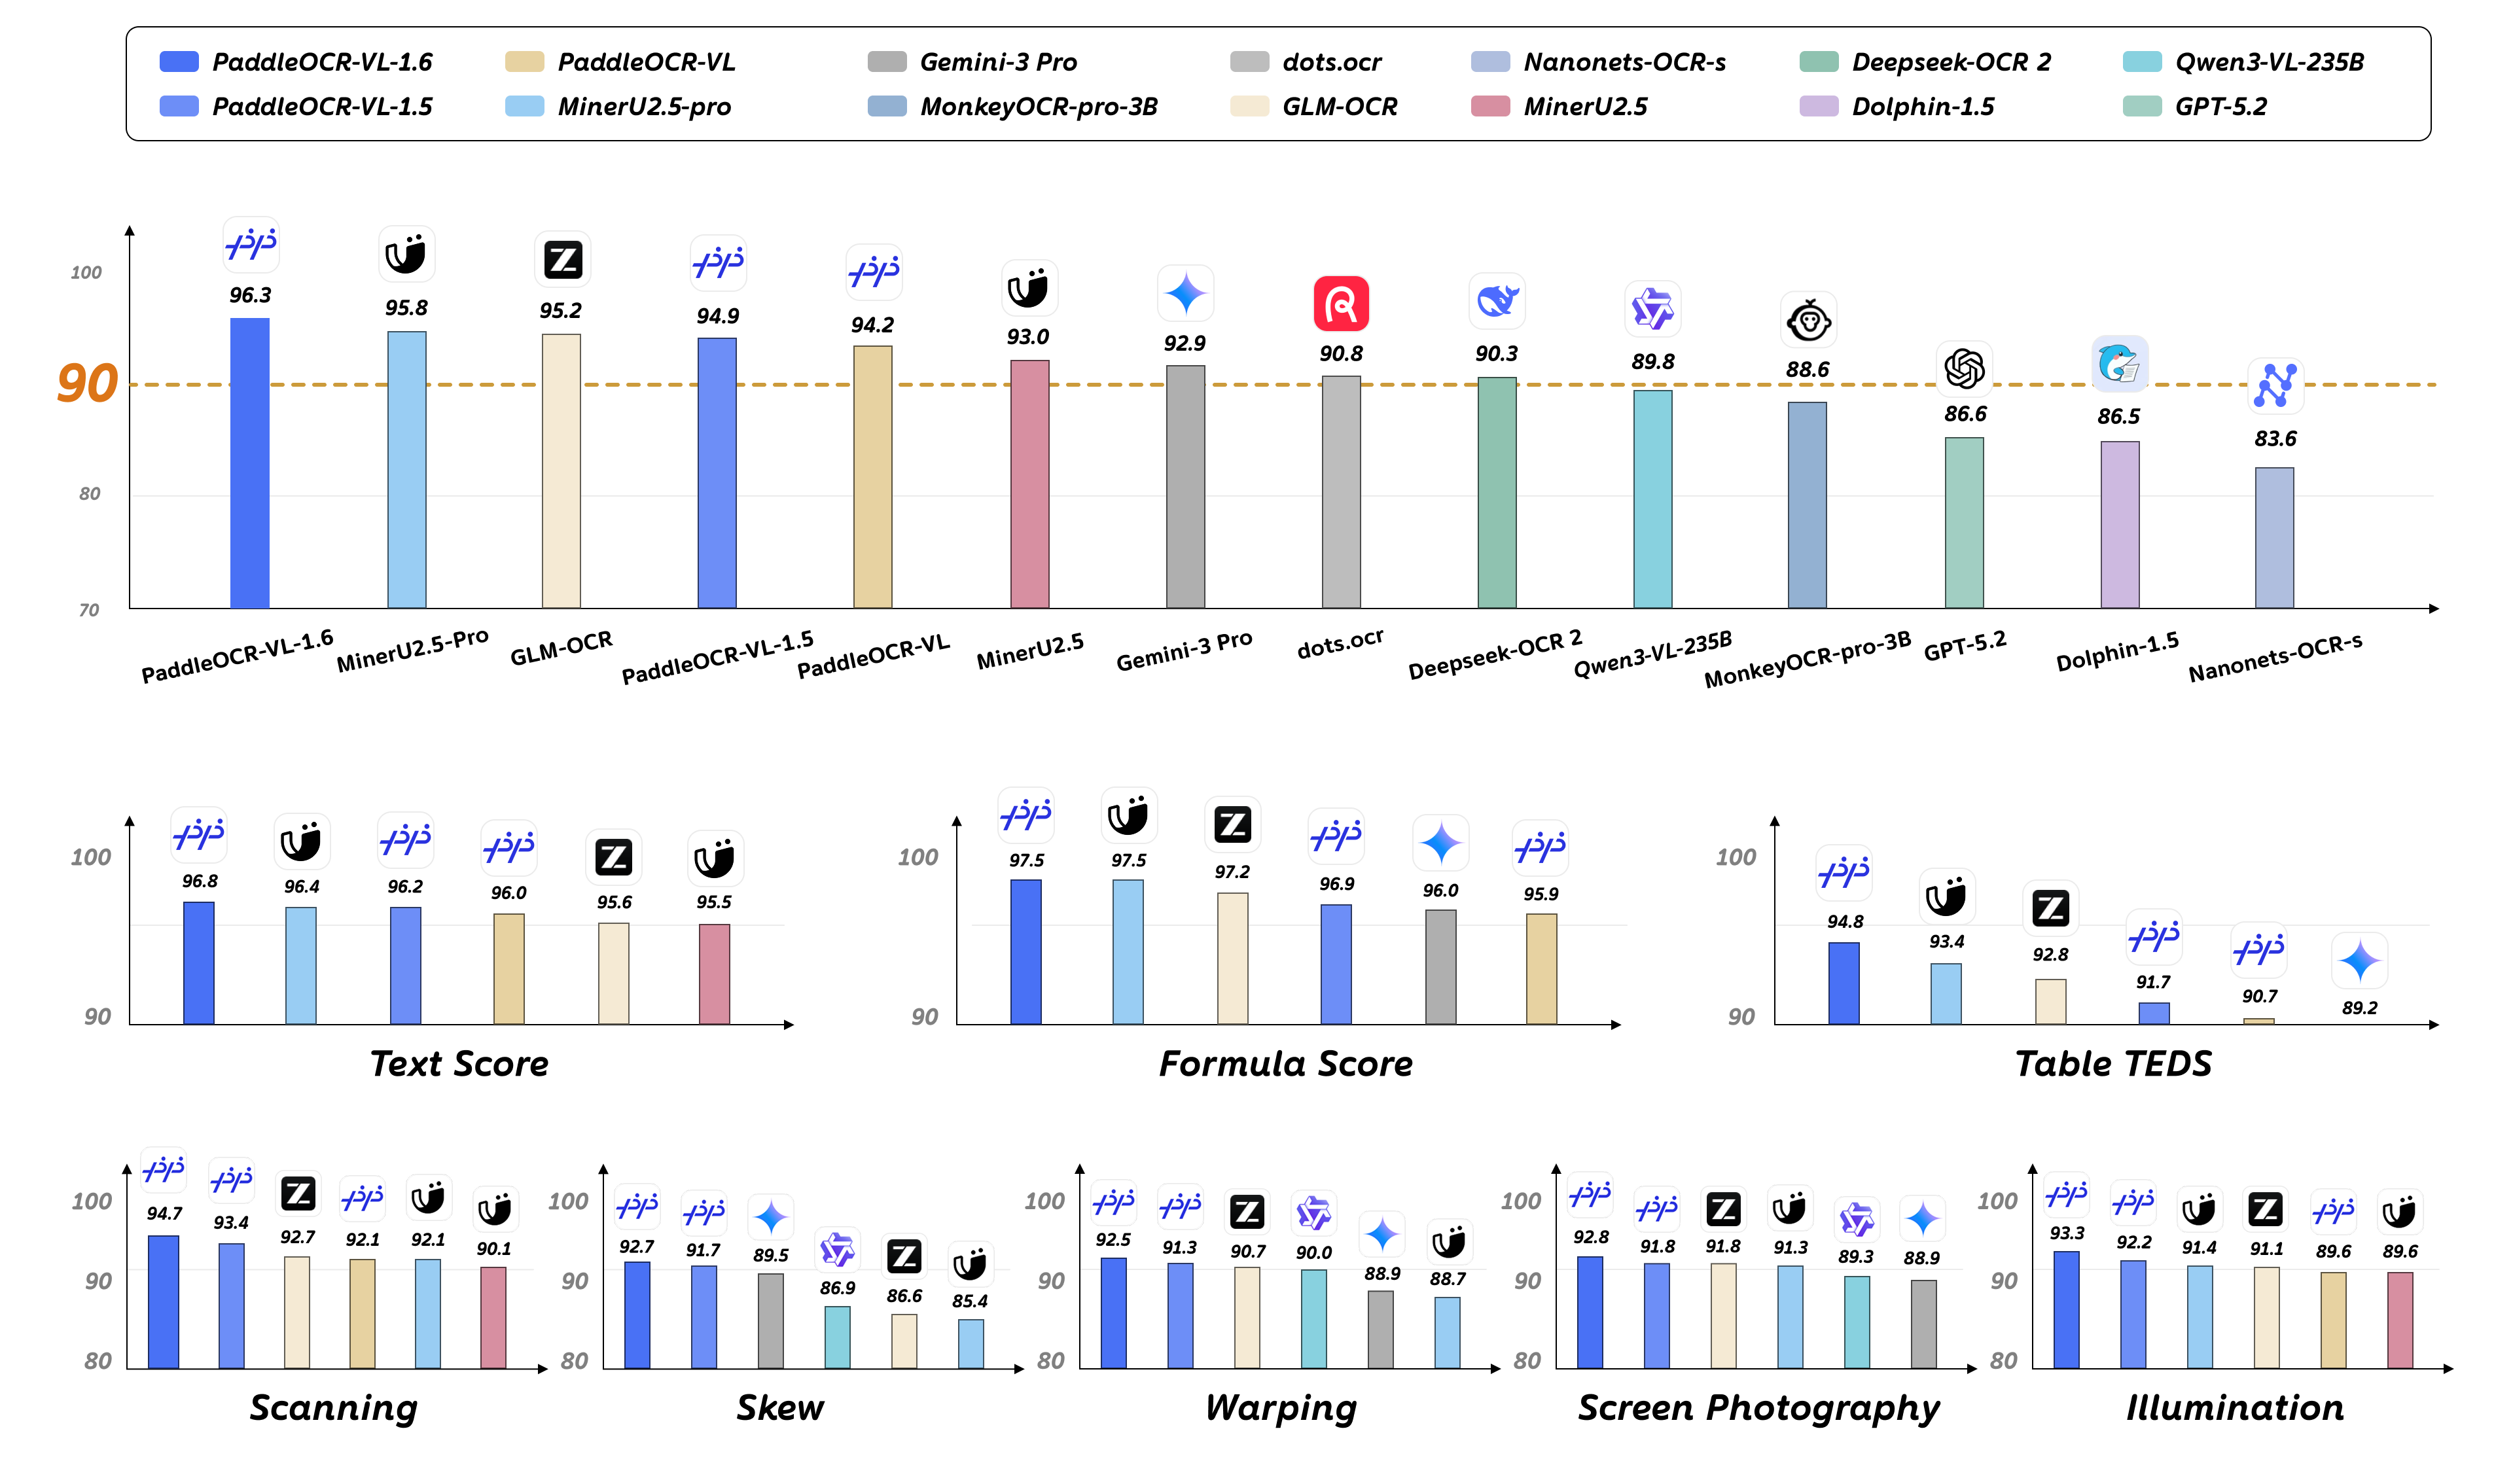
- 五、OmniDocBench v1.6总分96.33与分项短板
- 六、本地部署与推理实践
- 七、总结与思考
本文要点 (1)PaddleOCR-VL-1.6是百度飞桨2026年6月发布的文档解析模型,0.9B架构与1.5相同。 (2)OmniDocBench v1.6总分96.33,比1.5的94.93高1.40分,表格TEDS从91.67升到94.76。 (3)做法上最值得看的是按边界脆弱、覆盖稀疏、监督不可靠三路挖样本,再走CPT、SFT、GRPO。 (4)短板是阅读顺序没拿第一,中文手写定位识别从89.52掉到85.90。 (5)文末附模型卡的官方推理示例。
百度飞桨在2026年6月2日把PaddleOCR-VL-1.6的技术报告挂上arXiv,编号2606.03264。模型卡把权重发布写成5月28日。我把报告、模型卡和HTML版对了一遍。
0.9B架构与1.5相同,版面模型PP-DocLayoutV3没动,后训练只动识别那一支。OmniDocBench v1.6总分96.33。
一、两阶段流水线沿用1.5的0.9B架构
文档解析分两段。PP-DocLayoutV3先出多边形框、类别和阅读顺序,裁块再按指令识别正文、表格、公式、图表和印章,后处理拼成Markdown或JSON。
识别模型0.9B,原生分辨率视觉编码器、自适应MLP连接器,再加上ERNIE-4.5-0.3B。文字定位不走版面模型,0.9B自己做端到端检测和识别。
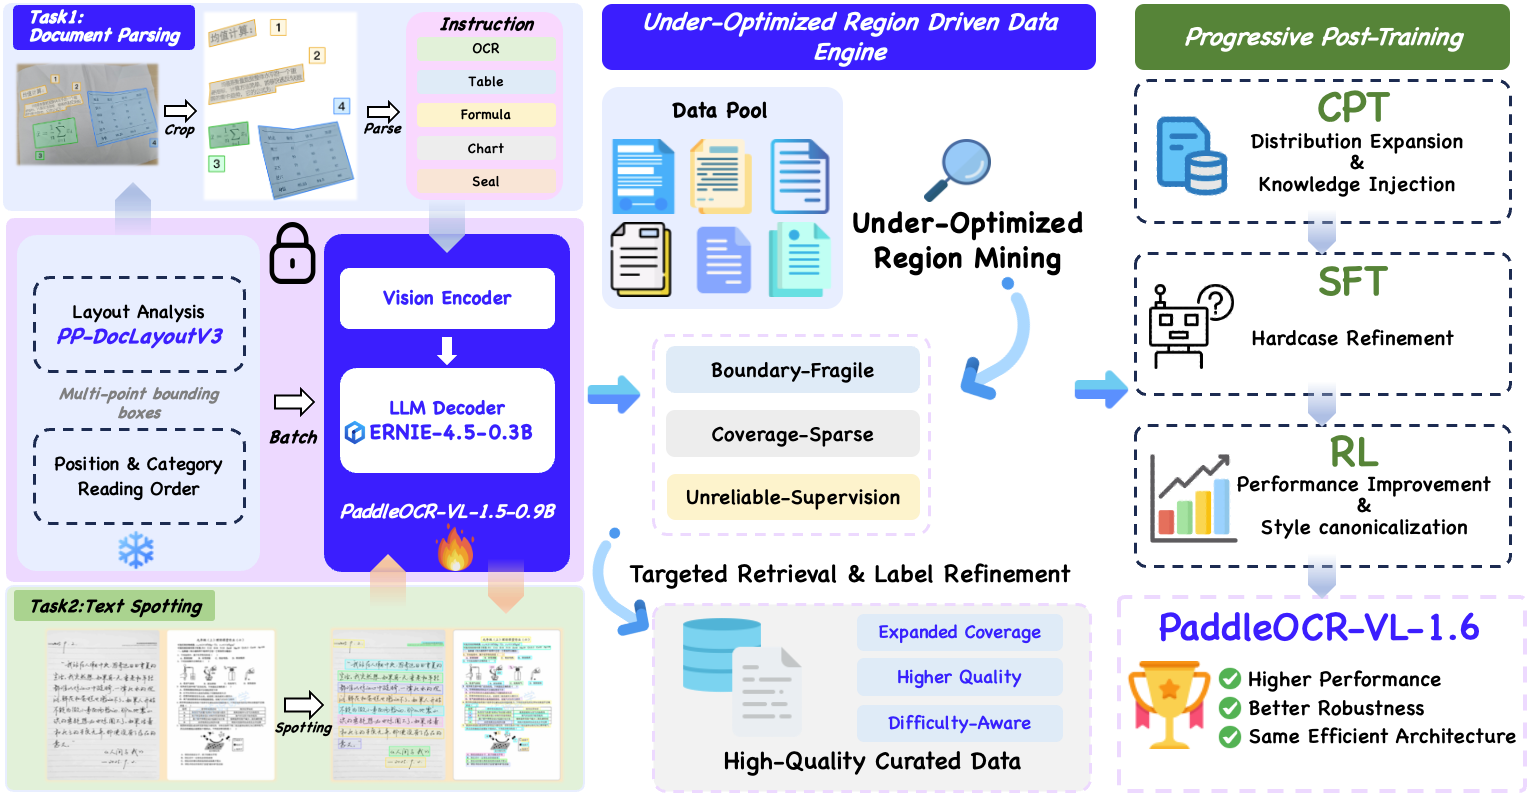
1.5已经够强。剩下的错不再像均匀噪声。有的样本轻轻一扰动输出就跳,长尾版式几乎没邻居,标签也有从一开始就站不住的。0.9B对数据效率更敏感,后面都围着怎么把样本选到还没学稳的地方。
二、边界脆弱、覆盖稀疏、监督不可靠三路挖掘
报告把这些地方叫欠优化区域。挖法对着1.5本身,不靠把语料整体再铺一层。有的路问输出稳不稳,有的路问这类版式见没见够。标签脏不脏被单独开出来,查的是真值。
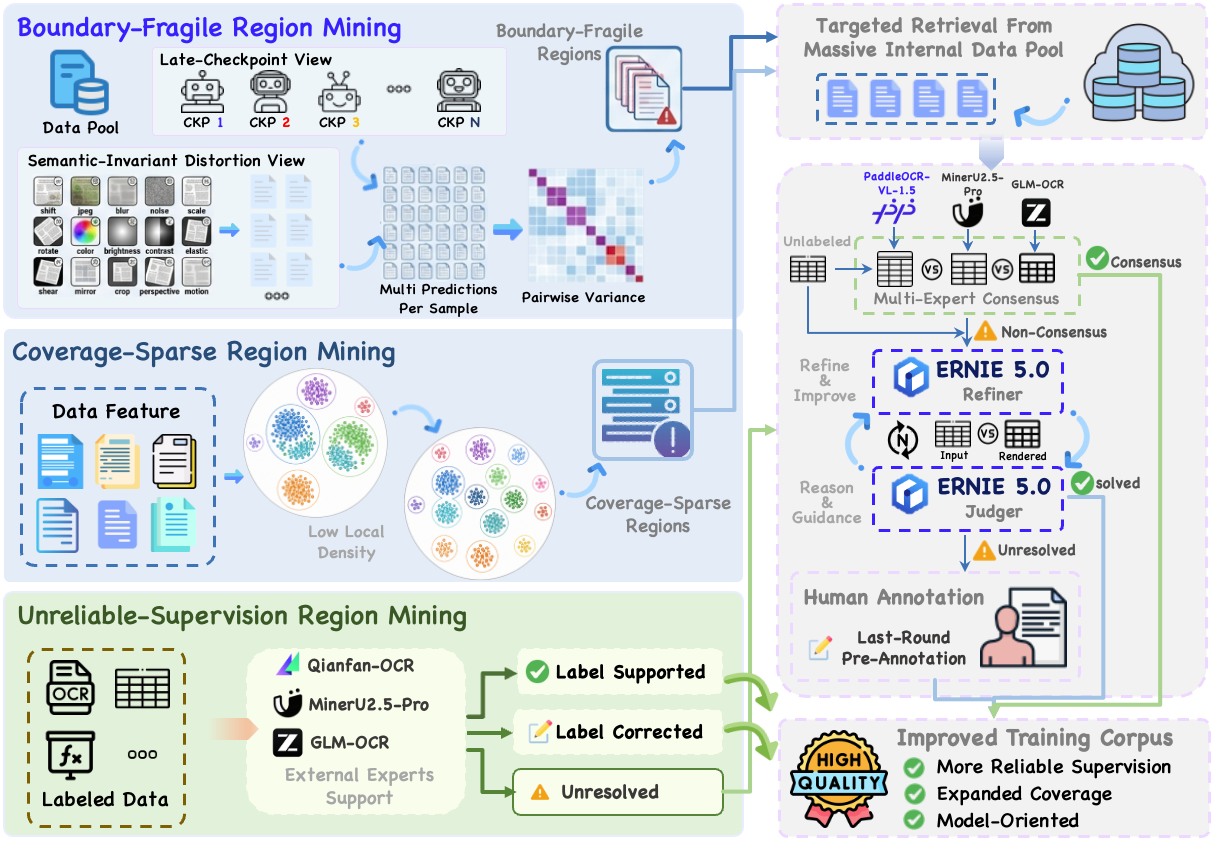
边界脆弱针对决策面发飘的样本。他们留了训练日程最后8%里的八个checkpoint,再给同一张图加十六种不改语义的扰动,像素平移、JPEG压缩、噪声、模糊、非均匀缩放都在里面。每个样本得到128次预测,两两算归一化编辑距离,一共8128对。
为了少被标点格式这类小差异带着走,只取最大的128对做平均当作脆弱分数,按分数取前1%,再加进出现过模型退化的样本。十多种常规增强叠在一起,仍压不住其中一部分。
覆盖稀疏是另一类错。相似模式训练里出现过,模型还是会写错,周围分布撑得太薄。他们用文档专用编码器建相似度图,把阈值一步步抬高,让连通块裂开,留下局部密度低、容易被大簇吞掉的小块。K-Means预先定K、每个点都必须进簇,稀有版式容易被吸进邻近的密集团。种子拿去内部大池子定向检索,报告点名补了古籍、生僻字和工业表格。
监督不可靠管已经有标签、但标签可能带偏的样本。模型有时会非常自信地重复同一种错,报告把这类失败记在标签上。外部专家是Qianfan-OCR、GLM-OCR和MinerU2.5-Pro。原标签被任意一家支持就保留。三家都不认、但至少两家专家彼此一致,就用共识覆盖。仍说不到一块,标成未解决,交给精修标注。
三、多专家共识与渲染引导标注
检索回来的图没有标签,未解决样本缺外部支持,两条都要重新写成能训的监督。自动标注换另一组专家,PaddleOCR-VL-1.5、GLM-OCR和MinerU2.5-Pro。至少两家一致,共识直接当标签。达不成共识的,进入ERNIE 5.0的Judge-and-Refine循环。
表格和公式很难拿LaTeX、HTML直接跟原图对,他们先把候选输出渲染成图,让判定做图和图的比对,去找错行、错列、跨单元格和内容放错位。专家输出只在第一轮注入,后面几轮只用当前预测和上一轮差异,避免三家说法反复把轨迹拽回去。仍对不上的送到人工,最后一轮输出当作预标注。通过率和人工量报告没写。
四、CPT到SFT再到GRPO的递进后训练
训练从1.5的checkpoint接着做。新数据按可靠程度拆进三截。
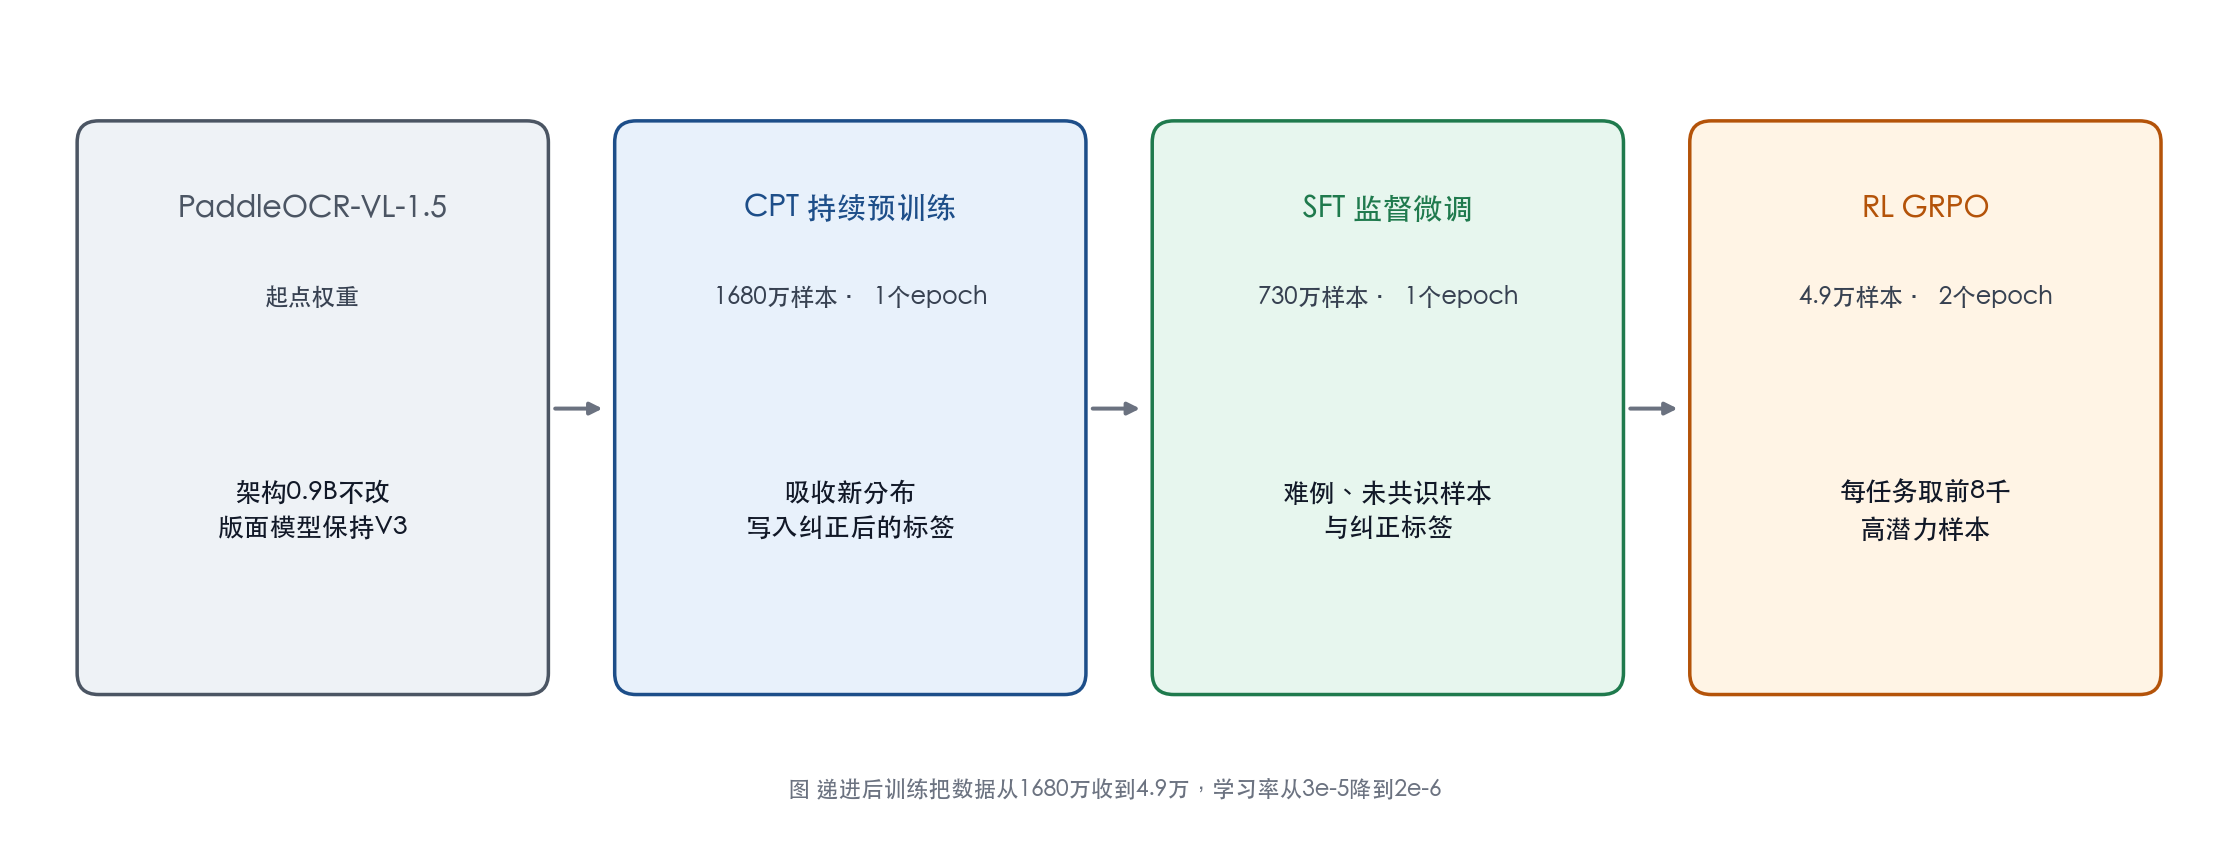
CPT先灌新分布。语料是1.5的全部SFT、一部分预训练,再加上新检索到的全部样本,一共1680万条,标签换成最新版。全参数、1个epoch、batch 1024、学习率3e-5。古籍、生僻字这类偏移,靠短短一段SFT吃不稳,所以放在最前面。
SFT改收窄。沿用1.5的不确定感知聚类采样挖难例,留下专家未共识后精修的样本,再收进纠正过的旧标签,合计730万条,学习率1e-5,仍是1个epoch、全参数。
强化学习更挑食。语言模型只有0.3B,样本选飘了,可能一小撮难例涨了、整体掉下去。他们用SFT模型当初始策略,每条采16次,温度0.85,top-p 0.9,top-k 32。最好一次仍很低、平均已经很高、最好和平均差太小、奖励方差接近零,这四类先扔掉。
留下的打高潜力分数。主项是最好一次减去平均,再按生成不确定度和奖励方差加权,α取1、β取2。不确定度用长度归一化的序列置信度来算,避免长输出天然把似然打低。OCR、图表、表格、公式、印章、文字定位各取前8千条,一共4.9万条,再训2个epoch,学习率2e-6。组大小16,跟了DAPO的clip-higher,ε_high取0.28,组内奖励方差为零的更新直接丢掉。
奖励先过有效性门,格式坏、截断、退化记零,再乘结构项和相似度。表格用TEDS,公式用CDM,正文和印章用1减归一化编辑距离,图表用RMS-F1,定位用编辑相似度加权F1。
| 表格 | 退化、截断、OTSL解析失败 | 单元格LaTeX合法性、矩形化编辑代价 | TEDS |
| OCR | 退化、截断、行内LaTeX非法 | 取1 | 1-NED |
| 公式 | 退化、截断、LaTeX非法 | 取1 | CDM |
| 印章 | 退化、截断 | 取1 | 1-NED |
| 图表 | 退化、截断、Markdown表非法 | 矩形化编辑代价 | RMS-F1 |
| 定位 | 退化、截断、输出格式非法 | 取1 | 编辑相似度加权F1 |
五、OmniDocBench v1.6总分96.33与分项短板
v1.6加了多粒度自适应匹配,并新增296页Hard子集。文本和阅读顺序用编辑距离,表格用TEDS,公式用CDM。
| PaddleOCR-VL-1.6 | 0.9B | 96.33 | 0.033 | 97.49 | 94.76 | 0.127 |
| MinerU2.5-Pro | 1.2B | 95.75 | 0.036 | 97.45 | 93.42 | 0.120 |
| GLM-OCR | 0.9B | 95.22 | 0.044 | 97.18 | 92.83 | 0.133 |
| PaddleOCR-VL-1.5 | 0.9B | 94.93 | 0.038 | 96.89 | 91.67 | 0.130 |
| Youtu-Parsing | 2.5B | 93.74 | 0.044 | 93.63 | 92.02 | 0.116 |
| Gemini 3 Pro | 未公开 | 92.91 | 0.064 | 95.99 | 89.15 | 0.165 |
分项里跳得最大的是表格,结构TEDS从94.37升到97.11。阅读顺序0.127,落后Youtu-Parsing的0.116和MinerU2.5-Pro的0.120。6月交稿时96.33是榜首,7月OvisOCR2报告给出96.58,两份报告的评测都指向官方榜。
Real5按扫描、弯曲、屏摄、光照、倾斜五组真实拍摄条件考。1.6总分93.19,1.5是92.05,Gemini 3 Pro是89.24,Qwen3-VL-235B-A22B-Instruct是88.90。
内部1258张难表Overall TEDS 91.71,1801张图表RMS-F1 91.74,300张印章NED 0.119,都是自家考卷。文字定位九维平均从86.21升到87.47,模糊从84.22升到90.59。中文手写却从89.52掉到85.90,英文印刷从86.89微降到86.51,古籍只从85.23挪到85.98。
边界脆弱那路用了大量模糊扰动,覆盖稀疏点名补了古籍,中文手写落在主攻对象之外。
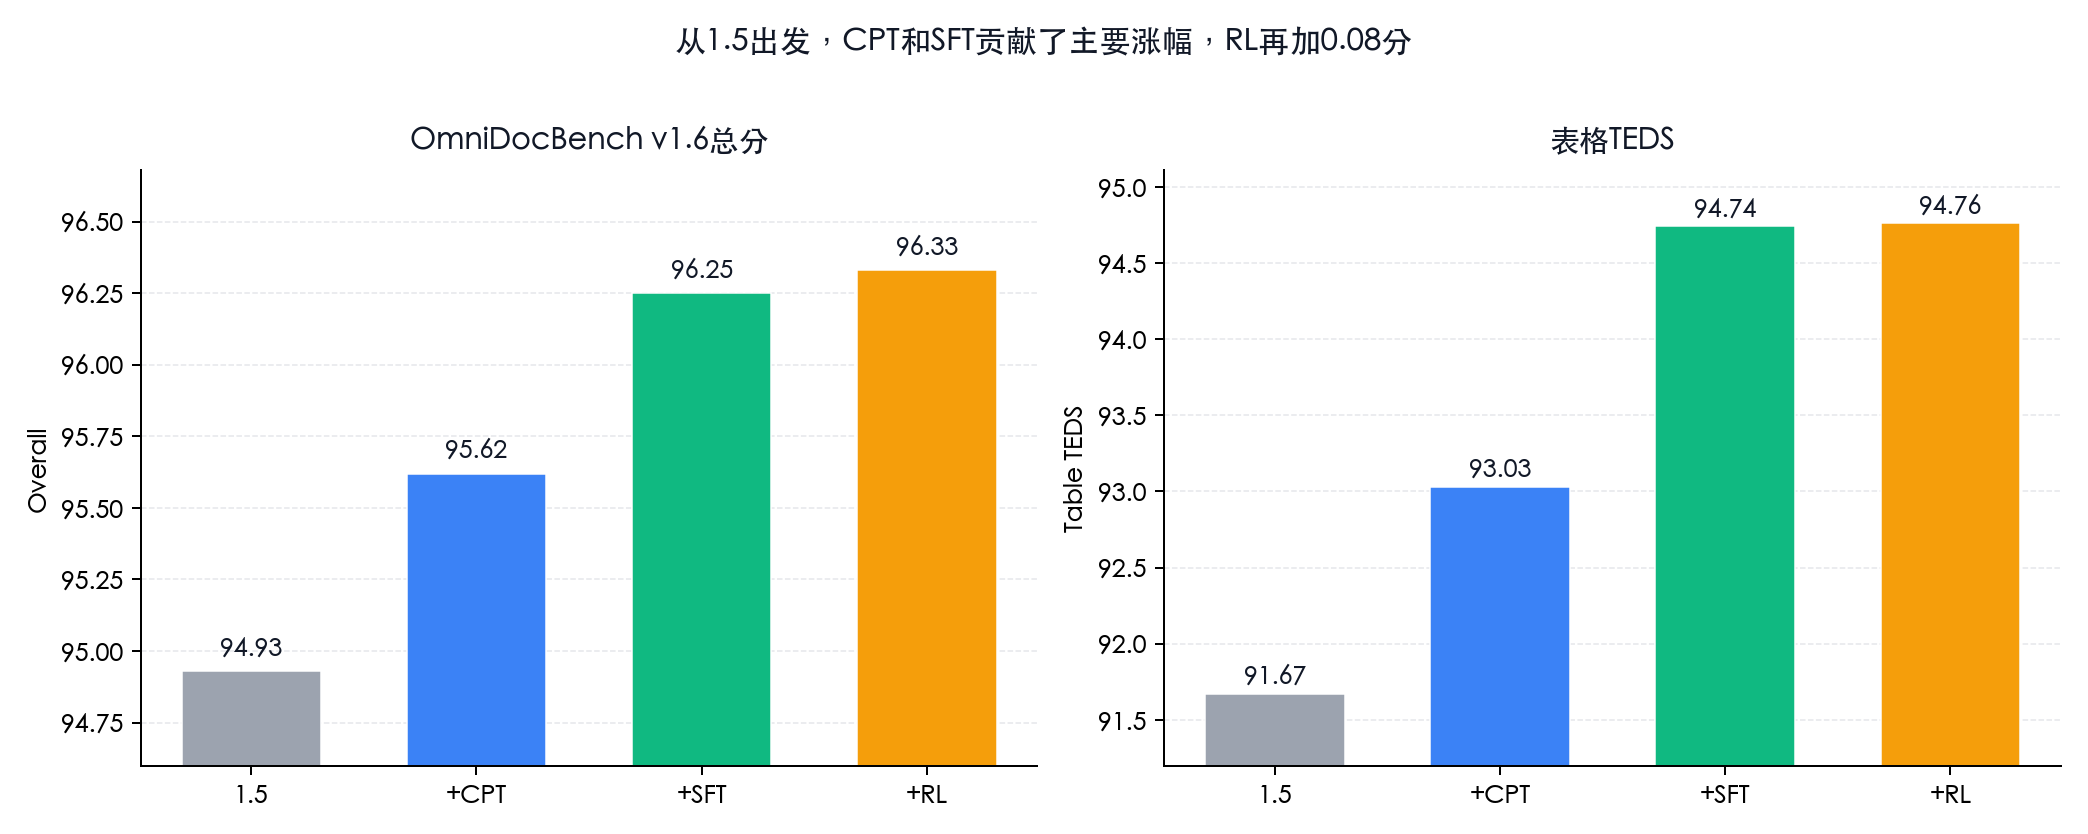
消融从1.5出发,CPT到95.62,SFT到96.25,RL到96.33。表格TEDS在SFT已经到94.74,RL只再加0.02。大头在前面两段监督。
六、本地部署与推理实践
模型卡强调架构和1.5兼容。官方推荐走PaddleOCR流水线做整页解析,transformers示例只覆盖元素级识别和文字定位。安装命令来自模型卡。
python -m pip install paddlepaddle-gpu==3.2.1 -i https://www.paddlepaddle.org.cn/packages/stable/cu126/
python -m pip install -U "paddleocr[doc-parser]>=3.6.0"
paddleocr doc_parser -i https://paddle-model-ecology.bj.bcebos.com/paddlex/imgs/demo_image/paddleocr_vl_demo.png –pipeline_version v1.6
pipeline_version写成v1.6才会走到新权重。Python接口是PaddleOCRVL(pipeline_version="v1.6"),结果可以save_to_json或save_to_markdown。模型卡要求PaddlePaddle 3.2.1及以上,macOS用户按说明用Docker。加速可用官方vLLM镜像,模型名PaddleOCR-VL-1.6-0.9B。元素级调用走transformers>=5.0.0,任务靠短指令切换。
from PIL import Image
import torch
from transformers import AutoProcessor, AutoModelForImageTextToText
model_path = "PaddlePaddle/PaddleOCR-VL-1.6"
image_path = "test.png"
task = "ocr" # ocr / table / chart / formula / spotting / seal
image = Image.open(image_path).convert("RGB")
orig_w, orig_h = image.size
if task == "spotting" and orig_w < 1500 and orig_h < 1500:
image = image.resize((orig_w * 2, orig_h * 2), Image.Resampling.LANCZOS)
max_pixels = 2048 * 28 * 28 if task == "spotting" else 1280 * 28 * 28
PROMPTS = {
"ocr": "OCR:",
"table": "Table Recognition:",
"formula": "Formula Recognition:",
"chart": "Chart Recognition:",
"spotting": "Spotting:",
"seal": "Seal Recognition:",
}
DEVICE = "cuda" if torch.cuda.is_available() else "cpu"
model = AutoModelForImageTextToText.from_pretrained(
model_path, torch_dtype=torch.bfloat16
).to(DEVICE).eval()
processor = AutoProcessor.from_pretrained(model_path)
messages = [{
"role": "user",
"content": [
{"type": "image", "image": image},
{"type": "text", "text": PROMPTS[task]},
],
}]
inputs = processor.apply_chat_template(
messages,
add_generation_prompt=True,
tokenize=True,
return_dict=True,
return_tensors="pt",
images_kwargs={"size": {
"shortest_edge": processor.image_processor.min_pixels,
"longest_edge": max_pixels,
}},
).to(model.device)
outputs = model.generate(**inputs, max_new_tokens=512)
print(processor.decode(outputs[0][inputs["input_ids"].shape[–1]:–1]))
max_new_tokens=512是元素级长度,整页Markdown不要指望这段代码。文字定位短边低于1500会先放大一倍,max_pixels提到2048×28×28。
七、总结与思考
最值得抄的是小模型后训练怎么把样本选薄。三路挖掘把还不稳、见得少、标签脏拆开,CPT、SFT、RL再按可靠程度往下收。RL要组内比出差异,策略还得偶尔够得着更好的输出。4.9万条只把总分从96.25推到96.33,大头在前面两段监督。
阅读顺序没拿到第一。中文手写掉了3.62个百分点。版面模型整代没动,切错的区域后面看不见。内部表、图、章是自家考卷。自动标注的通过率报告没写。这些缺口不影响把挖弱点、再按阶段灌数据这一套拿走用。
参考链接
- 技术报告原文 arXiv 2606.03264 v1,2026年6月,HTML版
- 模型权重与推理示例 PaddlePaddle/PaddleOCR-VL-1.6
- 源码 PaddlePaddle/PaddleOCR
- OmniDocBench榜单
- 前置版本 PaddleOCR-VL-1.5,arXiv 2601.21957
- 对比方案 MinerU2.5-Pro、GLM-OCR、OvisOCR2
- 真实拍摄基准 Real5-OmniDocBench


评论前必须登录!
注册