 网硕互联帮助中心
一堂课摸懂机器学习:从“反馈信号”到“学习任务”的完整坐标系
上完这堂机器学习的体系梳理课,最大的感受是:面对纷繁复杂的 AI 术语,其实只要抓准**“数据从哪来”和“模型干什么”**这两个问题,就能把所有技术对号入座。
老师课上反复强调,机器学习的分类有两大维度:
整堂课的重心放在了第一维度——监督、无监督、半监督、自监督、强化学习五大反馈机制上;第二部分则快速而精要地串起了五大常见任务:分类、回归、聚类、关联规则、序列预测。
一、按反馈信号分类:模型是怎么“学”的?
如果把机器学习比作学生,反馈信号就是它手边有没有“参考答案”、参考答案从哪来。
1. 监督学习(Supervised Learning)——做有标准答案的习题
核心定义:模型通过带有标记的训练数据进行学习,目标是建立输入 X 到输出 Y 的映射关系。它极度依赖外部标准答案,也就是人工标注的标签。
课上最经典的例子,莫过于机器学习的“Hello World”——鸢尾花分类。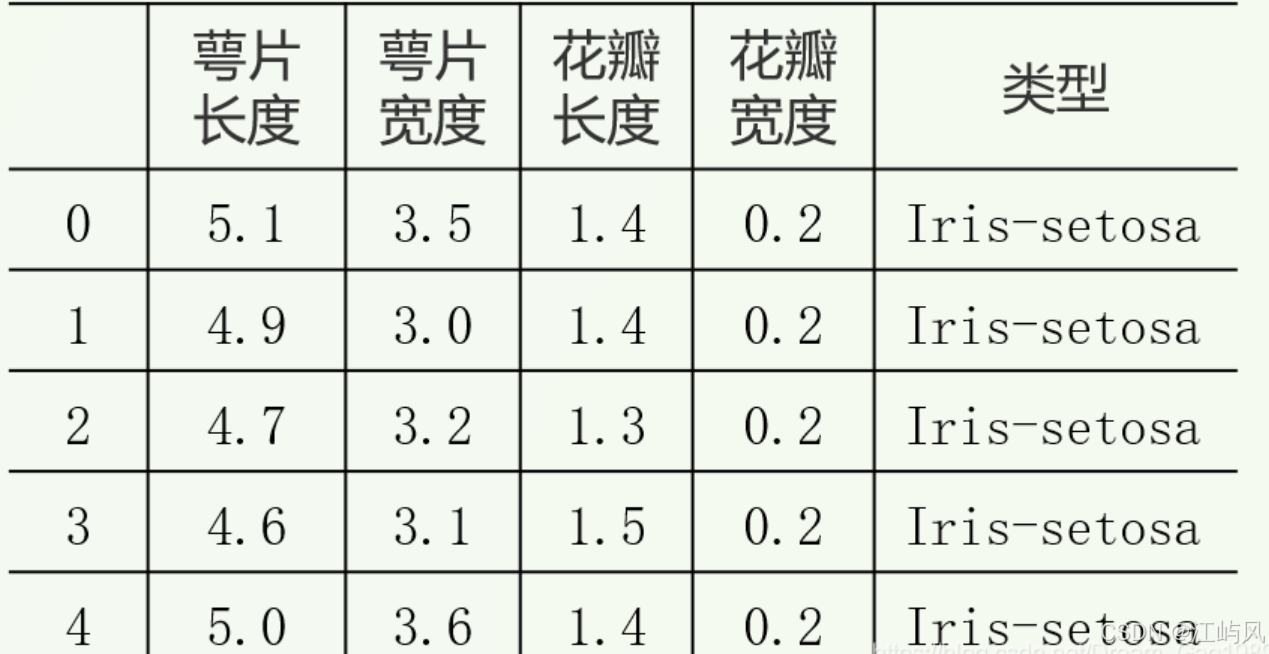
老师打开数据让我们看:一共 150 行数据,前 4 列分别是花萼长度、花萼宽度、花瓣长度、花瓣宽度,最后一列是人工标记好的品种标签(山鸢尾、变色鸢尾、维吉尼亚鸢尾)。模型的任务很简单:你给我一朵新花的花萼和花瓣尺寸,我帮你判断它属于哪个品种。
另一个更直白的例子是猫狗图像识别。老师打了个比方:这就像教科书上的习题,每道题后面都印好了正确答案(Yes/No)。为了让模型分清猫和狗,人们需要先拿出几百上千张图片,一幅一幅地人工标注“这是猫”“这是狗”。这里课上补了一个很实在的知识点:不要小看打标签的成本。老师提到,业界标一张图可能就要一毛钱,如果标 10 万张、100 万张,成本是极高的;很多知名数据集最初都是靠几百万美金硬砸出来,一幅一幅标,再由人工审核。
所以监督学习虽然简单直观,但它的命门在于高质量人工标注。
2. 无监督学习(Unsupervised Learning)——没有参考答案,自己找规律
核心定义:算法自行从数据中发现隐藏的结构、规律或模式,完全不需要人工标注标签。它没有对错之分,只依靠数据内在的结构进行反馈。
课上举了非常接地气的电商用户分群案例。
平台拿到了用户的年龄、收入、购买频次、客单价等信息,想回答一个问题:哪些用户在我这儿消费较高?我需要针对性投广告。
模型启动后,自己把用户划成了 8 个类别(例如主力军、新势力等)。这里老师特意停下来澄清了一个常见误解:模型并不会在训练前就给你一个叫“精致妈妈”的标签。模型只负责把人群聚成几堆(比如类别 1、类别 2……类别 8)。标签是业务部门后续分析才赋予的——他们发现某一类用户大概率是女性、最近买了母婴用品、客单价动辄 299、599 甚至 1599 元、复购率很高,这才人为贴上了“精致妈妈”的标签。
这个补充很重要:无监督学习只负责发现隐含规律,不负责解释业务标签。
3. 半监督学习(Semi-supervised Learning)——少量参考书 + 大量练习卷
核心定义:结合少量有标签数据和大量无标签数据共同训练,以提升模型精度。
为什么要搞这么“ hybrid(混血)”?课上老师把痛点讲得很透:人工标注不仅贵,而且耗时。有些领域还必须靠资深专家才能标注准确,比如医疗影像。
典型案例是三甲医院的肺炎影像诊断。医院有 1 万张肺部片子,如果全标,专家得排半年队,人力成本极高。于是采用半监督思路:
- 先请专家标500 张高质量片子(两周就能完成);
- 用这 500 张训练一个初步模型;
- 让初步模型去给剩余未标注的片子生成伪标签;
- 把带伪标签的数据和原本的 500 张真标签混合,重新训练。
效果非常显著:如果只用 500 张真标签,准确率可能只有 75%;全标 1 张万张虽然能上 90%,但成本不可接受;半监督混合后,准确率能提升到 88%。这是一个兼顾成本与精度的现实解法。
4. 自监督学习(Self-supervised Learning)——自己出题,自己答
核心定义:利用数据本身的结构自动生成监督信号(伪标签),完全无需人工标注。
课上老师专门对比了半监督与自监督的核心区别:半监督学习里仍有真实标签,而自监督学习彻底不依赖真实标签,它自己从数据内部构造任务。
第一个例子是 NLP(Natural Language Processing(自然语言处理)) 完形填空。
面对海量高质量文本(比如教材、书籍),模型会随机把某些词“挖空”,例如把 “I am a boy” 变成 “I _m a boy”,然后让模型去猜被遮盖的是什么。因为原文本里本来就有完整答案,所以模型天然知道该填 “a” 还是 “am”。监督信号完全来自数据自身。
第二个例子是图像领域的扩散模型(Diffusion Model),课上老师用了一个非常形象的比喻:
给你一幅狗的图片,往上“撒沙子”(加噪声)。撒一遍不够,继续撒,直到狗完全看不见,变成一幅纯噪声图。然后反过来,训练模型学习如何从噪声中把原图“还原”回来。这个“去噪/还原”的能力,就是数据本身的结构生成的自监督信号。
老师还补了一个关键知识点:当前主流的大模型,主要都属于自监督学习范畴。 这也是为什么大模型能利用海量无标注数据进行训练的根本原因。
5. 强化学习(Reinforcement Learning)——在试错中追求长期收益
核心定义:智能体在试错中积累经验,通过外部环境的奖励或惩罚信号,追求长期效益最大化。
为了让大家秒懂,老师先举了最生活化的例子——训狗或训海豚。狗把球捡回来,就喂狗粮(奖励);不去捡,就拍头(惩罚)。通过外部环境的明确反馈,模型自己调整策略,最终找到最优解。
但整堂课最重磅的案例,无疑是 AlphaGo 的三阶段演进。
-
阶段一:监督学习(打谱)
AlphaGo 先学习大量人类高手的棋谱,模仿人类下法。这一步有明确答案:高手下哪,机器就学哪。学完这一步,AlphaGo 已经很厉害了,绝大多数普通人已经下不过它。 -
阶段二:强化学习(左右互搏)
做一堆不同版本的 AlphaGo 互相 PK。围棋的好处是输赢信号极其明确:赢了就是奖励,输了就是惩罚。通过自我对弈,AlphaGo 开始突破人类经验的局限,走出了人类棋手从未想过的棋路。 -
阶段三:纯强化学习(从零开始)
更激进的版本直接抛掉人类棋谱,只告诉 AI 围棋规则,让它自己从头开始对弈。40 天后,这个版本达到了对人类 100:0 的战绩。老师当时的原话是“非常恐怖”。
这个案例极其生动地说明了强化学习的威力:它不依赖人类标注的“标准答案”,而是在与环境的交互和试错中,通过奖惩信号自我进化。
【课堂速记】一张表理清五种反馈信号
| 监督学习 | 明确的标准答案 (Yes/No) | 有参考答案,如教科书习题 |
| 无监督学习 | 无标准答案 | 无参考答案,自行发现内部隐含规律 |
| 半监督学习 | 少量标准答案 + 大量无答案 | 混合模式,部分有参考,部分需自测 |
| 自监督学习 | 数据自身构造的伪标签 | 自我生成信号,如挖空填空 |
| 强化学习 | 外部环境的奖励/惩罚 | 依据外部反馈判断好坏,追求长期最大收益 |
二、按学习任务分类:模型到底在“干”什么?
说完了“怎么学”,再来看“学什么”。
1. 分类(Classification)——把事物装进贴好标签的框里
分类属于监督学习。核心就是把输入数据映射到预先定义好的离散类别标签。
- 二分类:判断邮件是不是垃圾邮件,输出“是”或“否”。
- 多分类:给你一幅动物图片,模型输出它是老虎、狮子还是大象——类别远超两种,但每一个都是明确的离散标签。
2. 回归(Regression)——预测一个连续的数值
回归不是预测“类别”,而是预测一个具体的、连续的数值。
老师花了点时间解释离散 vs 连续这个补充知识点:
人数是离散的,不能有 5.5 个人;但股票价格是连续的,可以是 10 元,也可以是 10.5 元。
回归的任务,就是利用历史数据拟合出一条尽可能贴近真实值的曲线,然后用这条曲线去推测新数据点。比如根据历史股价,预测明天股票的具体价格。评估标准就是预测值和真实值之间的误差越小越好,完全重合你就“暴富”了。
3. 聚类(Clustering)——物以类聚,人以群分
聚类属于无监督学习。它不需要预先给定标签,而是根据数据内在相似性自动分组。
课上例子很鲜活:关于**《王者荣耀》和《原神》**的新闻,模型自动把它们归为一类,因为它们的向量空间距离很近,都属于“游戏”类;而“天气”类的距离就很远。
老师特别补充了一句:相似性通常靠向量空间中的距离来衡量。 而且如果在这一步人工预先打上标签,它就不是聚类了,而变成前面说的分类任务。聚类的精髓在于自动发现结构。
4. 关联规则(Association Rules)——发现“买了 A 的人大概率买 B”
关联规则是从大规模数据中发现变量之间隐含的依赖关系或共生模式。
最经典的例子莫过于沃尔玛“啤酒与尿布”。故事背景:上世纪 90 年代的美国,妈妈在家照顾宝宝,爸爸去超市买尿布,顺手就会带瓶啤酒。沃尔玛把啤酒和尿布摆在一起,两者销量显著提升。这就是典型的隐含依赖。现在的商品推荐系统也在用同样的逻辑:你买了啤酒,系统就给你推尿布(或反之)。
5. 序列预测(Sequence Prediction)——利用顺序依赖,预测未来
序列预测的核心是:数据之间存在强烈的顺序依赖性。如果打乱顺序, predictions 就全乱了。
- 文本预测:学了“床前”,预测下一个是“明月光”。如果你语序打乱成“床前 地上霜 疑是 明月光”,模型就会“乱拼”。
- 时间序列:课上举了航空公司的经典案例。收集了 12 年共 144 个观测值的乘客总数,数据呈现明显的季节性(夏季高、冬季低)和周期性。基于这段有顺序的历史,模型可以预测明年 6 月份的乘客数量。
最后老师抛出了一个重要的“打通式”知识点:大语言模型(LLM)的本质,也是序列预测任务。它基于上下文序列,预测下一个 token。学完大模型再回头看,会发现所有炫技背后,遵循的都是这个基本逻辑。
三、写在最后:两个维度,一张地图
回顾整堂课,老师的逻辑非常清晰:
- 按反馈信号分类,是在回答“模型的学习资料长什么样”——是有答案的习题、没答案的观察、一半有答案的卷子,还是自己给自己出题,又或者是在实战奖惩中自我进化?
- 按学习任务分类,是在回答“模型交上来的作业是什么形态”——是离散标签、连续数值、自动分群、隐含关联,还是基于时间或文本的顺序推演?
这两个维度交叉在一起,就构成了理解机器学习乃至当下大模型的基本坐标系。比如当前火爆的大语言模型,放在这个坐标系里看,它的底层层逻辑是自监督学习(反馈信号维度),干的事情是序列预测(学习任务维度)。把这两个身份同时看清楚了,很多关于“大模型为什么能学、在学什么”的困惑,也就迎刃而解了。


评论前必须登录!
注册