 网硕互联帮助中心
从 .o 到 ELF:静态库、动态库与可执行文件的完整生命周期
系列第三篇,时间跨度 2026.07.18 – 07.20,主题正式从「文件系统」转入「库文件」。
主线是三个问题:
① 库到底是什么?怎么造、怎么用、链接期和运行期分别发生了什么?
② 二进制文件凭什么能被加载?—— 走进 ELF 格式
③ 进程的虚拟地址空间从哪来?—— Program Header Table 是那张「段蓝图」
一、库的本质:一堆 .o 的打包
编译四步走:预处理 → 编译 → 汇编 → 链接。汇编之后得到 .o(目标文件,准确叫可重定位目标文件),它是「变成标准二进制之前的最后一步」。
而库,就是把一堆 .o 打包起来:
# 静态库:ar 归档工具,把当前目录所有 .o 打包
ar -rc libmystdio.a *.o
# 动态库:gcc -shared 把多个 .o 链接成共享库
gcc -shared -o libmystdio.so *.o # 每个 .o 需先用 -fPIC 编译
几条铁律:
二、静态库:链接期就「焊死」进可执行文件
gcc -c mystdio.c -o mystdio.o # 编译成 .o
ar -rc libmystdio.a mystdio.o # 打包成静态库
gcc -o main main.c -I./include -L./lib -lmystdio
使用时的三个参数,各司其职:
| -I(大写 i) | 头文件搜索路径(编译期用) |
| -L | 库文件搜索路径(链接期用) |
| -l(小写 L) | 指定库名,不加 lib、不加后缀 |
为什么头文件不用指明路径,库却必须指明? 这是初学时最别扭的一点:
- 头文件是你在代码里 #include 的,名字你已经写死了(#include "mystdio.h"),编译器按 < > 先系统目录、" " 先本地再系统、最后 -I 的顺序去找就行;
- 而库文件代码里根本没提过它的名字!一个 .o 集合的名字是用户(你)起的,编译器无从猜测「这个文件该链谁」——所以必须显式给 -l。而且同一个路径下可能有多个库,不指明就会歧义。
静态链接的最终形态:库里的函数代码被直接复制进 main 的可执行文件。这就是为什么静态链接出来的程序体积大(几 MB),但拷到任何地方都能跑,不依赖外部库。
三、动态库:链接期只「记名字」,运行期才「找库」
gcc -fPIC -c mystdio.c -o mystdio.o # -fPIC:生成位置无关代码
gcc -shared -o libmystdio.so mystdio.o
gcc -o main main.c -I./include -L./lib -lmystdio
./main # ← 经常在这里翻车:找不到库!
-fPIC(Position Independent Code,位置无关代码) 是动态库的关键:库要被加载到进程地址空间里不确定的位置(共享区),所以里面的代码不能写死绝对地址,必须全部用相对寻址——让 .o 在编译期就采用相对地址。
3.1 为什么运行时找不到库?
因为动态库有两道关卡,静态库只有一道:
| 静态库 | ✅ 需要库文件(.a) | ❌ 不需要(已复制进可执行文件) |
| 动态库 | ✅ 需要库文件(识别名字) | ✅ 还需要库文件 |
- 链接期:链接器把「我用了哪个动态库」这个名字写进可执行文件的一个段里(这就是后面要讲的 .dynamic / DT_NEEDED);
- 运行期:系统的动态加载器 ld.so 拿这个名字,去几个默认路径查找 .so,找不到就报 error while loading shared libraries。
3.2 运行期找库的四条路(本质是四合一)
| ① 环境变量 | LD_LIBRARY_PATH=/my/lib | 最常用,等价于「库的 PATH」 |
| ② 系统默认路径 | 把库拷到 /lib64、/usr/lib 等 | 正规做法(需要权限) |
| ③ 配置文件 | /etc/ld.so.conf + ldconfig | 本质仍是方式①,只是集中登记 |
| ④ 软链接 | 在默认目录建软链接指向真实库 | 本质仍是方式①,软链接只存路径字符串 |
记住这条类比:我们执行命令靠 PATH 找可执行文件,程序在运行期则靠 LD_LIBRARY_PATH 找动态库。
四、静态库和动态库同时存在,用哪个?
答案很干脆:有动态库就用动态库,没有才退回静态库。
理由是体积账:同一份功能,静态库版本可能 8000 字节、动态库版本 800000 字节(相差上百倍)——动态库代码只有一份,被所有进程共享,当然更划算。
要强制静态链接,加 -static。
| 时机 | 链接期完成全部工作 | 链接期记名字,运行期装载 |
| 可执行文件体积 | 大(含库代码) | 小 |
| 运行期依赖 | 无 | 需要 .so 存在 |
| 内存/磁盘占用 | 每份程序各存一份 | 多进程共享一份 |
| 升级库 | 需重新链接程序 | 换 .so 即可(无需重编) |
五、走进 ELF:二进制文件的格式
可执行文件不是「随意堆在一起的 01」,它有严格的格式,这个格式叫 ELF(Executable and Linkable Format)。以下都是 ELF 文件:
- .o 可重定位目标文件;
- 可执行文件(a.out);
- 动态库 .so;
- core dump 文件。
一句话总结链接:链接的本质,就是把一堆 ELF 合并为一个 ELF。
5.1 ELF 的四大组成部分
| ELF Header | 描述整个文件结构;最重要的字段是 Entry Point Address(入口地址) | readelf -h | 磁盘的 Super Block |
| Section Header Table | 描述所有节(磁盘视角) | readelf -S | 目录索引 |
| Program Header Table | 描述所有段(内存/虚拟地址空间视角) | readelf -l | 段蓝图 |
| 节内容本体 | 真正存放代码与数据 | — | — |
为什么 ELF 也需要这么一套「管理结构」?跟磁盘一模一样:要管理磁盘就需要 Super Block 和 GDT;要管理这些节,就需要 ELF Header 和两张 Header Table。 先描述,再组织——又一次印证。
5.2 常见的节(Section)
| .text | 程序代码(只读、可执行) |
| .rodata | 只读常量 |
| .data | 已初始化的全局变量 |
| .bss | 未初始化的全局变量(不占文件空间,只占内存) |
| .symtab | 符号表(函数/变量名与地址的对应) |
| .strtab | 符号名字符串表 |
| .shstrtab | 节名字符串表 |
| .debug* | 调试信息 |
| .rela.dyn / .plt / .init | 重定位、延迟绑定、初始化等 |
5.3 节(Section)vs 段(Segment)
这是整篇笔记最核心的一组区分:
节,是描述 ELF 磁盘文件的概念;段,是描述内存(进程地址空间)的概念。
那为什么要有两套?关键在于内存比磁盘珍贵得多:
- 内存(和外存 IO)都以 4KB 为基本单位,一次换入 4KB;
- 如果按节加载,.text、.rodata、.data 这些小节各自占不满一个 4KB,会造成大量内部碎片、浪费宝贵的物理内存;
- 于是加载器把「权限相同、类型相同」的节合并成大段,凑满 4KB 的整数倍,最大化内存利用效率。
节(磁盘,细粒度) ──合并规则(权限一致 / 类型一致)──▶ 段(内存,4KB 对齐)
.text + .rodata ────────────────────────────────▶ 代码段(r-x)
.data + .bss ────────────────────────────────▶ 数据段(rw-)
这条规则同时也解释了为什么代码段是只读的:它由一批只读节合并而成,权限是合并时就定好的。
这也是为什么 readelf -S 能看到几十个节,而 readelf -l 只有寥寥几个段——多个节,合成一个段。
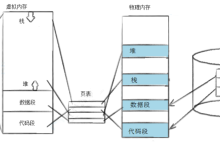
六、重谈进程地址空间:虚拟地址是从哪来的?
6.1 先回答问题:程序还没加载,有没有地址?
有!一定有虚拟地址。
- 代码反汇编时,每条 call 后面跟着的就是函数地址——这些地址是编译器编出来的;
- 32 位系统下,虚拟地址空间从全 0 到全 1(4GB)平坦编址(平坦模式 = 0 + 偏移量,逐行编址);
- 但物理地址必须等加载进内存才有:没加载 → 虚拟地址存在、物理地址为 0(空)→ 一旦访问触发缺页异常,再由内核把代码和数据从磁盘载入并建立映射。
所以:
虚拟地址空间不只是操作系统的事,它一半是编译器的活。
6.2 Program Header Table:编译器留下的「段蓝图」
创建进程的顺序是:先创建 PCB/mm_struct 等数据结构,再加载数据与代码。
那 struct mm_struct(进程的虚拟地址空间)拿什么初始化?答案:
读 ELF Header → 定位 Program Header Table
↓ Program Header Table 里记录了每个段的虚拟地址、权限、对齐等
用这份「段蓝图」初始化进程的 mm_struct
↓
虚拟地址空间就此建立(段与段的边界、权限全部就位)
Program Header Table 是怎么来的?编译器生成的:它在生成 ELF 时,已经按「权限 + 类型」的规则总结好了「哪些节合并成哪个段、这个段占哪些虚拟地址」,于是才有了 .text 段的第一个虚拟地址等一堆地址信息。
6.3 一张表说清「谁记载了什么」
| 整个文件的架构 | ELF Header |
| 程序入口(main 起始虚拟地址) | ELF Header 的 Entry Point Address |
| 代码与数据本体 | 节(Section) 里 |
| 段的虚拟地址蓝图(mm_struct 的来源) | Program Header Table |
| 用了哪些动态库 | .dynamic 段(链接器写入) |
6.4 CPU 从哪开始执行?
这就是虚拟地址空间落地为物理内存的完整闭环。
七、动态库是怎么加载的?
最后一环:动态库被加载到进程地址空间的哪里?
加载到 共享区(mmap 区)。
正因为在共享区,同一个 libc.so 的物理内存页可以被成百上千个进程共同映射——这就是动态库又叫 共享库(Shared Object,.so) 的原因,也是它节省内存的根源。
而不论是动态库还是可执行文件:
顺便回扣文件系统:缺页时内核要找到「文件的第几个块」,走的正是我们前面学的那条链——路径缓存拿 inode → inode 的 i_block[] 算块号 → 读磁盘。两套知识在这里合流了。
八、小结
.c ──编译──▶ .o(可重定位目标文件,ELF)
.o ──ar──▶ .a(静态库) ──链接期复制进可执行文件──▶ 无运行期依赖,体积大
.o ──shared+fPIC──▶ .so(共享库)──链接期只记名字、运行期由 ld.so 找──▶ 体积小、可共享
一堆 ELF ──链接──▶ 一个 ELF(可执行文件)
可执行文件 ──加载──▶ 按 Program Header Table 的段蓝图建 mm_struct
→ Entry Point 入 RIP → MMU 翻译 → 真正跑起来
四条最值得记住的结论:
本文基于 2026-07-18 ~ 07-20 的学习笔记(静态库/动态库生成、动静态库双向、目标文件 ELF、Program Header Table 来源机制、回归动态库加载)整理。后续笔记(7.21 ELF 动态库、7.28 动态库为什么是共享的)继续深入。


评论前必须登录!
注册