 网硕互联帮助中心
不会鸿蒙的人,怎么把一个 Android 项目搬到鸿蒙上
“鸿蒙版什么时候能上?”
这句话是 6 月 18 号下午飘过来的。先交代主角:这个 App 叫「子午流注」,Android 版在应用商店上架的就是这个名字,主打经络、时辰和按时取穴。我手上的资源很寒酸:一个能跑的 Android 项目、一台装了 DevEco Studio 的 Windows,还有一条硬邦邦的事实——我一行鸿蒙代码没写过。
三个多月后(基本都是下班时间在搞),鸿蒙版跑起来了。18 个页面、65 个 ArkTS 文件、1.7 万行代码,登录、经络、学习、PDF、EPUB、微信支付、支付宝支付、Unity 三维经络都在里面,代码提交了 85 次。
这篇不复述“鸿蒙很好很强大”。讲的是一个人不会鸿蒙,靠 vibecoding 把活啃下来的过程:活怎么拆、AI 记不住怎么办、坑长什么样、账烧了多少。
先把结论放这儿:不会鸿蒙不影响交付,影响的是你学习它的方式。vibecoding 的瓶颈也很少是“AI 写不出来”,多数时候是“你没把上下文说明白”。
目录
先看一眼搬完之后长什么样,鸿蒙版首页是这样:
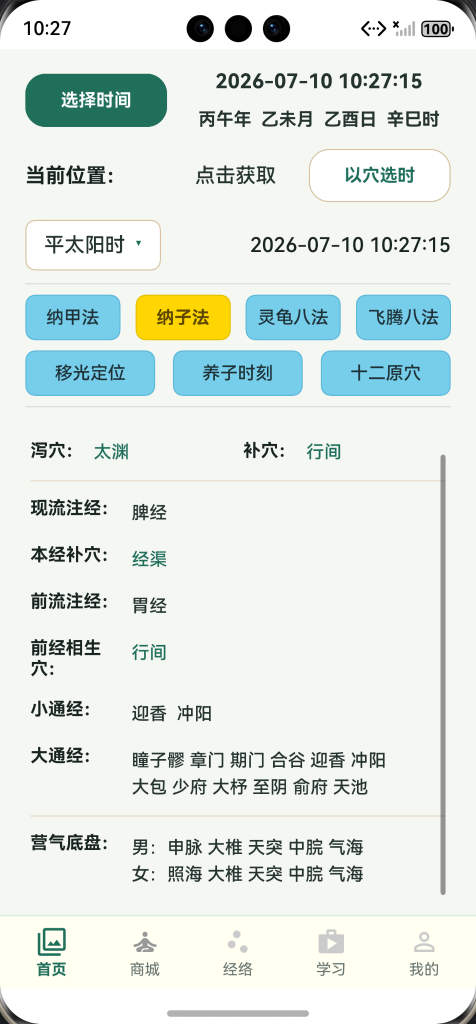
当时的真机截图:时间模式、日时干支、穴位算法入口都挂在首页上。
一、先别写代码,先算清楚这活有多大
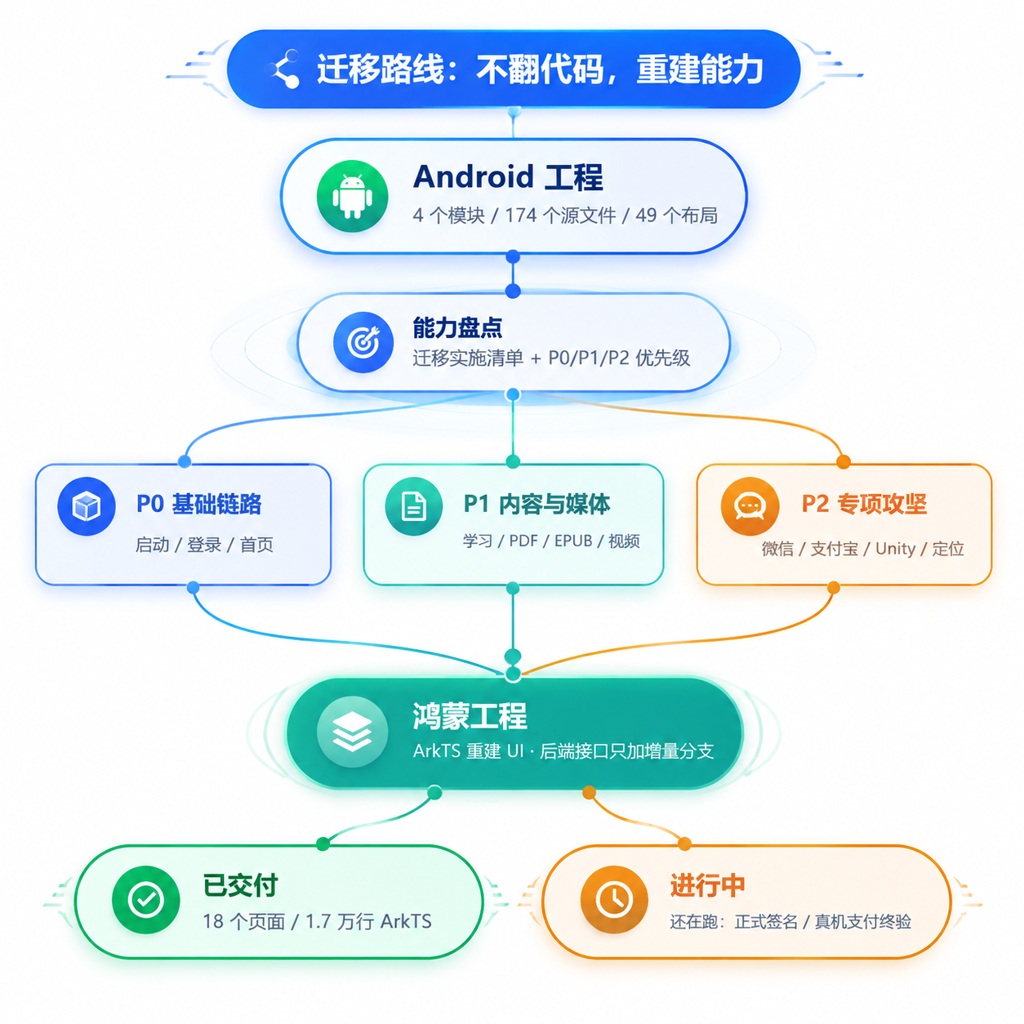
接手第一件事不是打开 IDE 写代码,是把 Android 工程扫一遍,把“这活到底多大”算出来。
扫完的结果不太好看:4 个模块,大约 174 个 Java/Kotlin 源文件,49 个 XML 布局。Activity、Fragment、DataBinding 是骨架;外面挂着一圈 Android 专属的依赖——高德定位、AgentWeb、PDF 渲染库、GSYVideoPlayer、微信 SDK、支付宝 SDK,还有一个 UnityPlayerActivity。
顺手把产品和工程的账也理了:
| P0 | 启动、路由、网络层、登录注册、首页、本地存储 | 没有这些,App 打不开,别的都是空谈 |
| P1 | 搜索、用户中心、学习资源、Web 内容、基础视频 | 能演示、能联调,业务方马上能看到东西 |
| P2 | PDF、定位、微信、支付宝、Unity | 每一项都要单独啃 SDK,风险高、周期长 |
于是有了两份文档:《鸿蒙迁移实施清单》和《产品功能清单 + 迁移优先级表》。前者写清阶段、模块映射、风险矩阵、验收标准;后者写清产品有哪些功能、先搬谁后搬谁。
清单里我写了三条原则,后来证明这是整件事的地基:
- 不做“逐文件翻译 Android 代码”;
- 后端接口尽量复用,数据字段跟着老接口走;
- UI 层、系统能力层、三方 SDK 层按鸿蒙的方式重建。
翻代码这件事看着聪明,其实最贵。Android 那套命令式 UI 和鸿蒙的声明式 UI 不是同一种语言,翻译到最后你会得到一份谁也维护不了的代码。
二、鸿蒙不是安卓换皮,ArkTS 有自己的军规
第一次编译,我就被上了一课。
ArkTS 看着像 TypeScript,用起来是 TypeScript 的“军规版”。平时写 TS 随手就来的写法,在这里会被编译器一条条拦下来:
| arkts-no-untyped-obj-literals | 直接传 { path: 'x', method: 'GET' } | 先声明类,再 new 出来传 |
| arkts-limited-throw | throw error,什么类型都往外扔 | 转成 Error 再抛 |
| arkts-no-structural-typing | 拿“长得一样”的对象当另一个类型用 | 类型必须声明式匹配 |
| Only UI component syntax can be written here | 在 build() 里写逻辑 | 逻辑挪到方法里,build() 只管拼界面 |
拿请求参数举个例子。在 TS 里我习惯这么写:
// 在 ArkTS 里,这样传参会被编译器拦下来
request({ path: 'user/login', method: 'POST', data: body })
鸿蒙这边得先把类型立起来,再传实例:
export enum ApiHttpMethod {
GET = 'GET',
POST = 'POST'
}
export class ApiRequestOptions {
path: string = '';
method?: ApiHttpMethod;
query?: Map<string, string | number | boolean>;
data?: string;
mockData?: string;
}
看着啰嗦,但换来的是接口层边界清楚:页面不能自己拼 URL,也不能随手解析响应。
网络层从 mock 换成真接口以后,长这样(节选):
const request = http.createHttp();
const response = await request.request(url, {
method: ApiClient.toRequestMethod(method),
header: requestHeaders, // token、deviceId 等公共头
extraData: ApiClient.buildBody(options.data),
connectTimeout: ApiConfig.connectTimeout,
readTimeout: ApiConfig.readTimeout
});
if (response.responseCode === 401 || response.responseCode === 403) {
await AuthGuard.expireLogin('登录已失效,请重新登录');
throw new Error('NEED_LOGIN');
}
401 统一清登录态再跳登录页,比在每个页面里各写一遍 if 靠谱得多。
还有一类差异更隐蔽:Android 里组件就是个 Java 类,权限、定位、分享、支付都靠系统 API 直给;鸿蒙这边每个能力都要看权限声明、querySchemes、Ability 回调和签名配置。SDK 能装上去不代表能跑起来,这条后面踩得最深。
三、vibecoding 的真实分工:我是产品加测试,AI 是手
很多人以为 vibecoding 是我动嘴、AI 全包。实际跑下来,分工更像装修:我定方案、盯验收、验收不过就打回重做;AI 是那个效率极高的施工队。
把几个主会话的数据拉出来,节奏就很清楚了:
| 我发出去的消息 | 1814 条 |
| 其中带截图/图片的 | 486 条 |
| 助手回复 | 11385 条 |
| 工具调用(读文件、改代码、跑编译) | 22310 次 |
| 消息里只写“继续下一步 / 好 / 同意”这类 | 204 条 |
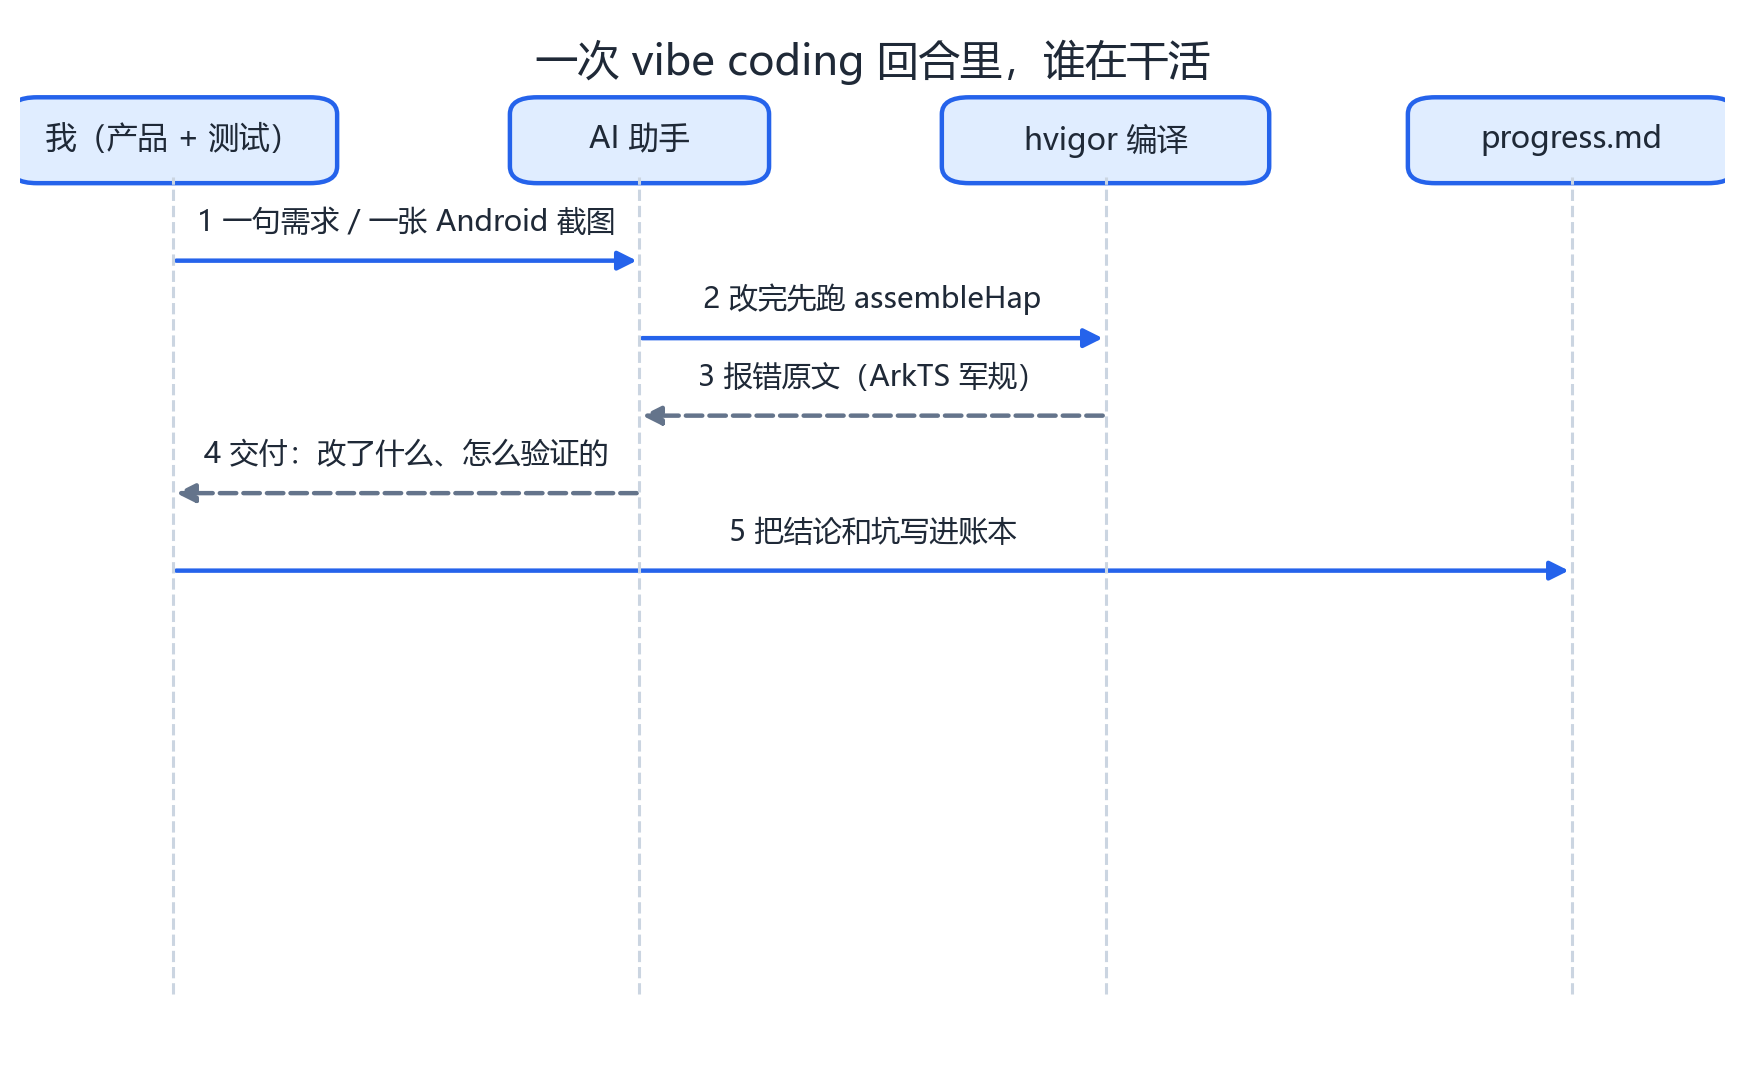
我干的事就三样:
AI 干的事是:读 Android 源码找规则、写 ArkTS、跑 hvigor 编译、按报错改、把改动和验证方式写进进度文档。
有几条经验,都是被教育出来的:
- 需求必须带参照物。“做个登录页”这种话,出来的东西一定不是你要的;说清“参照 Android 哪个页面、哪个方法、什么跳转行为”,一次成型的概率高很多。
- 报错别只贴一行结论,连上下文一起贴。ArkTS 的报错号加文件名,基本等于半个答案。
- 验收标准要能看见。截图、录屏、真机结果,比“应该没问题了吧”可靠。
- 一次只推进一个模块。想一口气让 AI 把四个模块搬完,最后你会收到四个都没搬完的半成品。
做到一半的时候,我还认真问过工期和报价——结论很朴素:这个需求,确实得加钱。
四、最难的不是技术:AI 的“长期记忆”怎么解决
这是整件事里最值得写的一节。
AI 的上下文窗口是内存,不是硬盘。会话一长,早期的结论会被压缩、被挤掉;换个会话,前面积累的约定直接归零。我这边的主线会话从 6 月 18 号一直用到 9 月 7 号,中间压缩过很多轮——如果什么都不落地,早就开始“重复犯昨天的错”了。
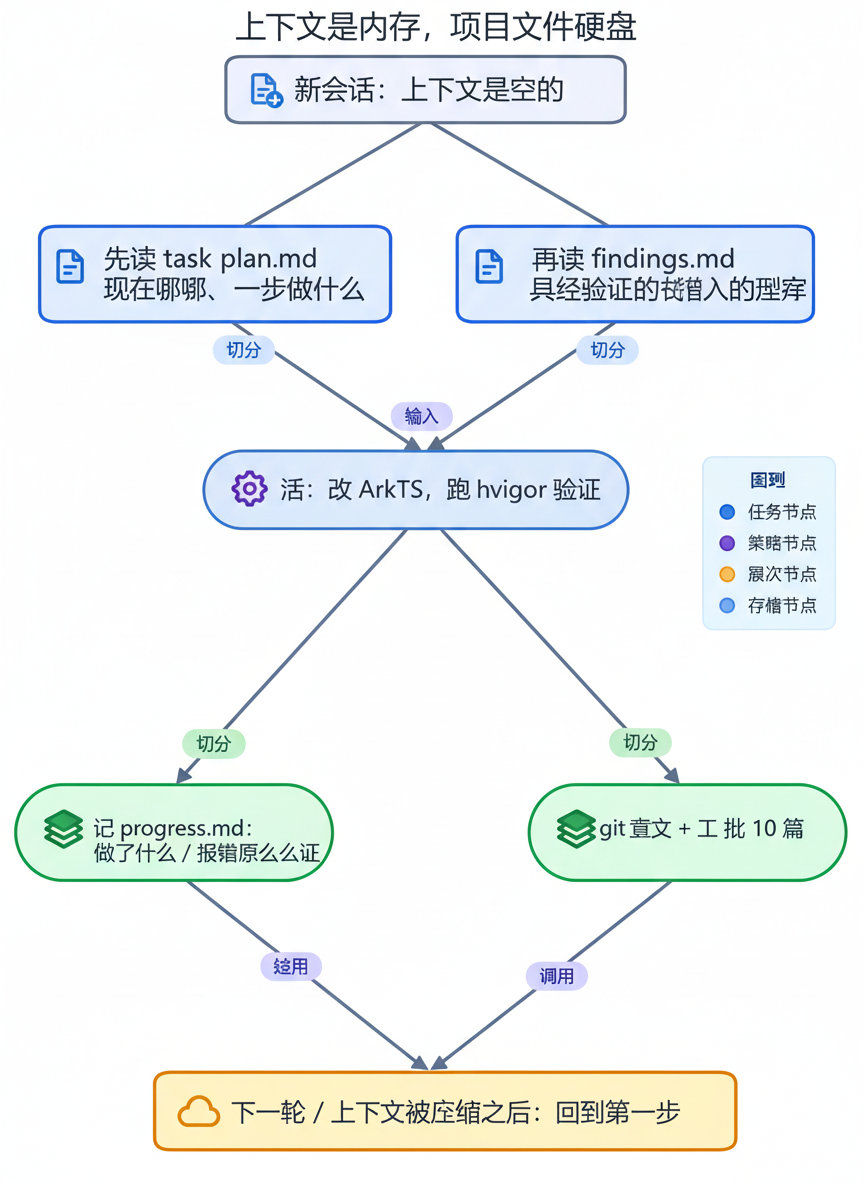
解决办法说穿了不新鲜,就是一个老程序员都会的习惯:把重要的东西写到磁盘上,而不是指望脑子记住。
4.1 三件套:计划、发现、进度
项目根目录一直躺着三个文件:
| task_plan.md | 目标、阶段清单、已定决策、错误表 | 每完成一个阶段就更新状态 |
| findings.md | 调研结论、接口行为、技术边界 | 每次有新发现立刻写 |
| progress.md | 每个阶段做了什么、改了哪些文件、怎么验证 | 干完活就补,不留到明天 |
看着像给自己记流水账,其实这是给 AI 攒“病历”。医生不会凭空记得你三个月前说过什么,你也不该指望 AI 记得。
progress.md 最后长成了近 9 万字符、1200 多行、53 个阶段的记录,每个阶段都带验证表:
| 鸿蒙构建 | assembleHap | ArkTS 编译通过、HAP 打包成功 | BUILD SUCCESSFUL | pass |
| 后端编译 | JDK 8 + mvn -DskipTests compile | 后端编译通过 | BUILD SUCCESS | pass |
| 真机支付 | 签名 HAP + 生产后端 | 支付回调后 VIP 生效 | 待真机验证 | pending |
这张表的价值在于:写清楚的东西,下一轮不用再问一遍;没验证的东西,也不会被当成已完成。
4.2 新会话开场先“复诊”
功能一换话题,我就开新会话:微信登录一个、支付宝支付一个、批量改文本转义一个。开新会话的第一句话不是“继续做项目”,而是让它先读文件、再把位置说清楚。
给自己定的检查表就五个问题,答得上来,说明状态是齐的:
| 我在哪? | task_plan.md 的当前阶段 |
| 我要去哪? | 还没做完的阶段 |
| 目标是什么? | 计划里的目标声明 |
| 我学到什么? | findings.md |
| 我做过什么? | progress.md |
顺手补齐的两条规矩也很值:一是“动手两步就落盘”,截图、日志里的结论立刻写成文字,别留在脑子里;二是“同一个错误不犯第三次”,第一次诊断、第二次换思路、第三次就停下来找人商量。
4.3 给下一个 AI 写一份“说明书”
工程稳定之后,我让它写了一份《源码结构说明》:目录怎么分、路由怎么跳、主题和公共组件在哪、改动第三方登录和 Unity 时要注意什么、推荐构建命令是什么。
这份文档的读者不是人,是下一个会话里的 AI(也包括三个月后的我自己)。有了它,新会话接手成本从“先读一整天代码”变成“看十分钟说明书”。
里面甚至写清了几条容易被忽略的约定:
- 页面只管状态和展示,请求放 common/api,算法放 common/home 或 common/ganzhitime;
- 改路由页面必须同步 main_pages.json,加 Ability 必须同步 module.json5;
- 新增文本直接用 UTF-8 中文,不要用 \\uXXXX 转义;
- 每次构建报错先记进 progress.md,修完补上验证命令和结果。
4.4 加一层时间机器:提交和快照
AI 改代码的速度很快,出错的速度也快。所以每过一个阶段就 git commit 一次,整件事 85 次提交,出问题随时能退。
大改造之前还会留一份工程快照(当时是 EPUB 阅读器改造前)。快照加还原脚本,比事后回忆“当时那个版本是好的”便宜太多。
4.5 还有一层跨会话的机器记忆
工具本身还带了一层记忆:它会记住这个工程的长期约定和踩过的坑,下次进同一个工程先看一眼。
举个真实例子。Unity 导出的三维库反复重导出,我需要每次只同步库文件、保留改过的返回桥接、把应用名恢复成中文。这套规矩被记下来之后,下一次同步不用重新解释一遍,直接按老流程走完,最后用哈希比对确认没有偏差。
这几层加起来的顺序是:会话内靠上下文,会话间靠项目文档,项目间靠工具记忆,出事故靠 git 和快照。
五、21 条任务记录,摊开来看
任务清单里一共 21 条已完成记录。第 21 条我把几件零碎活打包记在一起,省得清单太长:
| 1 | 需求盘点 + 迁移实施清单 + 优先级表 | 文档交付,后续所有排期都按它走 |
| 2 | 启动壳 + 五个底部 Tab(首页/商城/经络/学习/我的) | 应用能跑起来 |
| 3 | 登录 / 注册 / 忘记密码 + 用户协议与隐私政策 | 真实接口联调通过 |
| 4 | 网络层从 mock 换成真实 HTTP(统一封装、token 注入、401 跳登录) | 日志验证通过 |
| 5 | 登录态持久化 + “我的”页真实用户信息 | 杀掉应用重进仍在线 |
| 6 | 关于我们页 | 页面完成 |
| 7 | VIP 页壳与会员状态、到期时间展示 | 接口数据回显正确 |
| 8 | 统一主题与二级页样式规范 | 先出图确认,再落代码 |
| 9 | 学习模块真实列表 + VIP 访问校验 | 非会员被正确拦截 |
| 10 | 学习详情三入口 + 视频播放页 | 真机播放通过 |
| 11 | PDF 阅读器 | 线上大文件实测 |
| 12 | EPUB 阅读器(本地脚本、目录、字号、主题、进度、图片内联) | 真机重测 |
| 13 | 经络模块:分类 / 搜索 / 详情 | 数据与 Android 对齐 |
| 14 | 经络二级页统一样式 + 练习分类页 | 按确认稿落地 |
| 15 | 首页平太阳时 / 真太阳时 + 地点联动 | 与 Android 结果比对 |
| 16 | 选择时间页与干支计算(时间起点回到 1900 年) | 与 Android 结果比对 |
| 17 | 以穴选时:静态数据重建 + 规则对齐 Android | 结果比对通过 |
| 18 | 七个干支算法:纳甲 / 纳子 / 灵龟八法 / 飞腾八法 / 养子时刻 / 十二原穴 / 移光定位 | 切算法即按当前时间重算 |
| 19 | 商城模块 + 微信小程序拉起 | 真机拉起成功 |
| 20 | 第三方账号闭环:微信登录、支付宝登录、手机号绑定、解绑 | 真机 + 后端联调 |
| 21 | 收尾打包:微信/支付宝 VIP 支付、分享页、应用名与包名版本号对齐、Unity 三维经络、Unicode 转义清理 | 部分待真机终验 |
顺带说一件容易漏的事:应用名。Android 版在应用商店上架叫「子午流注」,鸿蒙版得沿用同一个名字,包名和版本号也对齐到开发者平台上登记的那一套。麻烦在后半段——Unity 导出三维库时会把自带资源一起塞进来,应用名会被写成它自己的名字,每次重新导出都要改回「子午流注」。这种“每做一次就得重做一遍”的小事,最该写进文档交给下一个会话。
跑起来的样子
下面几张是当时真机联调留下的截图,个别图上还带着当时圈 bug 的记号——留着才有现场感:
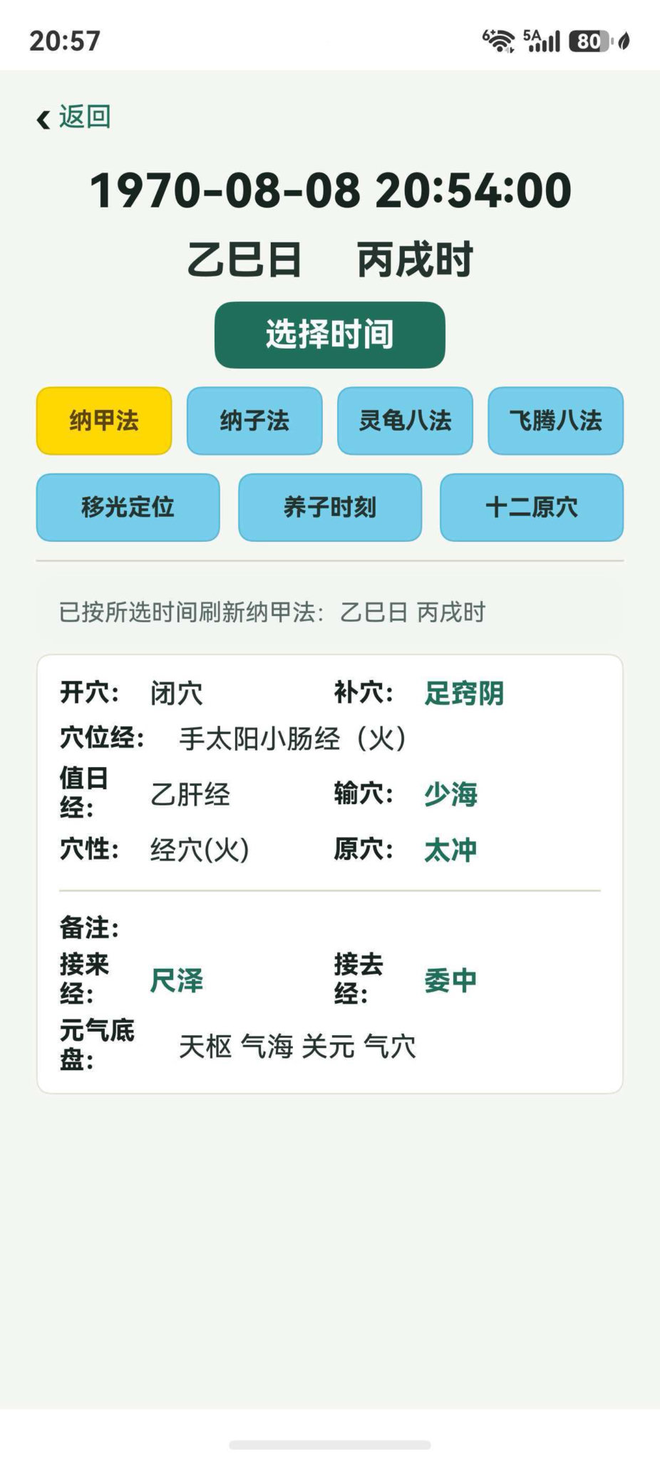
选完时间,日时干支和下方的算法结果整块刷新,切算法也按当前时间重算。
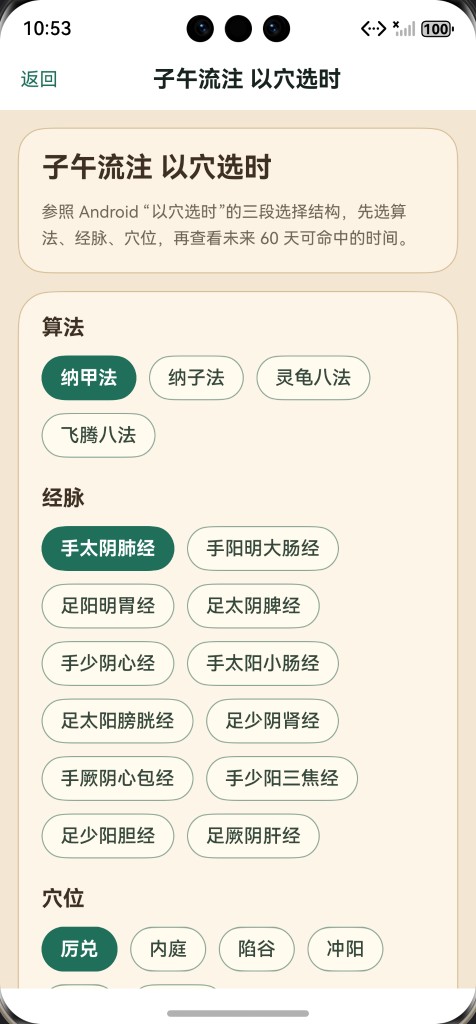
以穴选时:先选算法、经脉、穴位,再看未来 60 天能命中的时间。
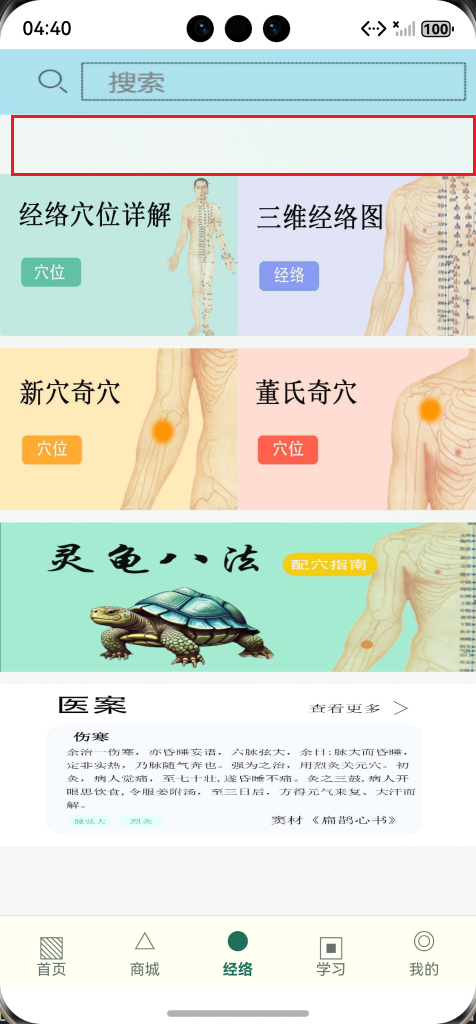
经络入口:搜索、分类、三维经络图都从这里进。
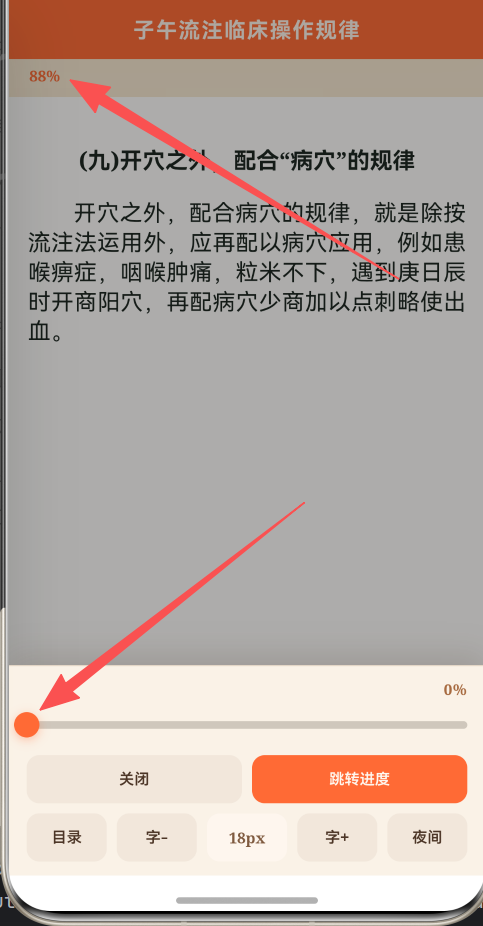
EPUB 阅读器:脚本本地打包,带目录、字号、进度和夜间模式。
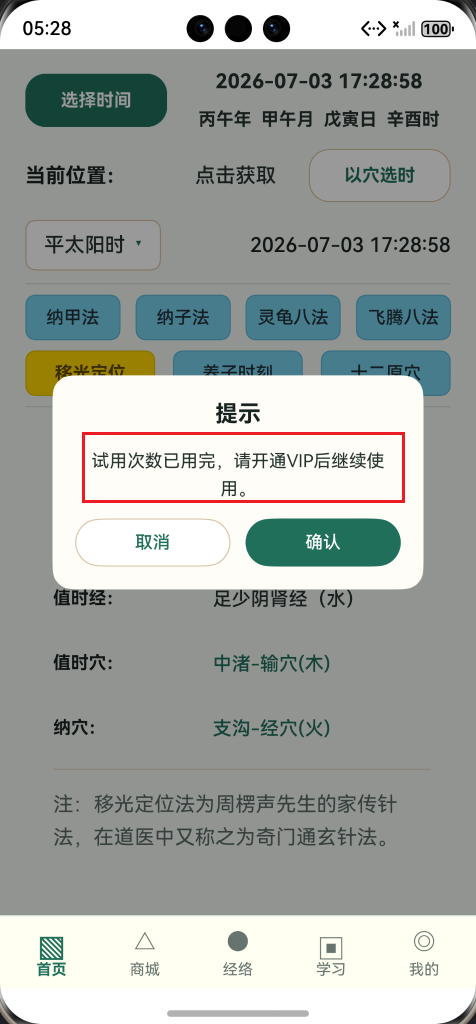
试用次数用完就拦住,提示开通会员。这类判断一律以服务端为准,客户端只负责显示。
这里面最花时间的不是页面数量,是三类“看起来简单”的活:
- 算法对齐。同一个穴位、同一个时间点,鸿蒙算出来的结果必须和 Android 一模一样,差一位都算 bug。
- 阅读器。EPUB 是 HTML 加压缩包的组合,图片、目录、字号、进度条,每个细节都能卡住半天。
- 第三方 SDK。微信和支付宝的登录、支付、回调,涉及签名、包名、回调路由、后端分支,跑通一次比写完十个页面还累。
六、踩过的坑,按报错原文归档
挑几条印象最深的,报错原文照抄,方便下一个人对照:
| DEVECO_SDK_HOME invalid / SDK component missing | 命令行找不到 SDK,或 SDK 组件确实没装 | 显式设置 SDK 环境变量,用 DevEco 自带的 hvigorw,构建任务用 assembleHap –mode module |
| Failed … stat 'signing/material' | 签名材料缺失 | 补齐签名配置再构建,别指望跳过 |
| Object literal must correspond to some explicitly declared class or interface | 拿 TS 的习惯写 ArkTS | 先声明类,传实例 |
| Only UI component syntax can be written here | 逻辑写进了 build() | 逻辑挪出 UI 构建块 |
| main_pages.json file format is invalid | 加页面忘了同步路由表 | 改页面就同步 main_pages.json |
| EPUB 图片在 WebView 里加载不出来 | iframe 拿不到 blob:,且压缩包里的中文文件名是 URL 编码过的 | 直接用 JSZip 读图片条目、解码清单文件名,把图片地址换成 data: URL |
| 微信小程序拉不起来 | openLink('weixin://') 只能当兜底 | 用官方 OpenSDK,并补齐 querySchemes 和回调 action |
| 支付宝授权回来了但登录不行 | 把一次性的 authCode 当成了长期身份 | 后端用 authCode 换稳定 id,私钥留服务端签名,客户端只拿参数 |
| Unity 三维在 Previewer 里看不到画面 | Previewer 不支持原生渲染和独立 Ability 跳转 | 用签名 HAP 在真机验证,Unity 库整包导出,不手工改 .so;导出后把应用名改回「子午流注」 |
| 后台挂起再回来要重新登录 | 登录态只存在内存里 | 本地持久化会话,恢复时校验 token 有效性 |
这些坑的共同点是:错误信息本身信息量很大。ArkTS 的编译报错会告诉你哪一行、哪条规则;SDK 的报错会告诉你缺哪个文件。怕的不是报错,是“没感觉哪里不对”的静默失败。
七、20 亿 token 的账单
聊 vibecoding 不聊账就是耍流氓。我这边几个主会话的消耗是这样:
| 主线会话 | 启动壳、登录、首页、经络、学习、Unity 同步 | 5.93 亿 |
| 首页算法分支 | 太阳时、干支、以穴选时的结果校准 | 2.97 亿 |
| 学习与阅读器分支 | 学习列表、PDF、EPUB、视频 | 1.78 亿 |
| 微信登录分支 | OpenSDK、小程序拉起、绑定解绑 | 4.20 亿 |
| 支付宝分支 | 授权、稳定 id、绑定、支付 | 5.15 亿 |
| 文本清理分支 | 批量把 Unicode 转义换成中文 | 0.13 亿 |
| 合计 | 约 20.2 亿 |
还有一批后台跑的复核任务,加起来大约 0.13 亿,量级可以忽略。
顺手说清一件容易误会的事:任务清单里会出现同名记录,其实是同一次会话被记了多条副本,统计时我做了去重,只算真正干活的会话。
20 亿这个数字刚看到会吓一跳,但它不是“写了 20 亿字的代码”。它的本质是每轮对话都要把前面的历史重新读一遍:会话越长、验得越久,同样的内容被反复计费。会话长了之后,一次的输入就是几十万 token。
所以省 token 的办法,全在“别让它重复读没用的东西”:
- 结论落盘,别堆在对话里。一份 53 阶段的进度文档,比让 AI 从聊天记录里翻三个月前的决定便宜得多。
- 换话题就新会话,只带上必须的上下文。
- 贴日志贴报错那一屏,别整文件粘。三万行日志买不来一句结论。
- 一次只干一个模块。范围一散,返工重来的成本全在 token 上。
- 让它先读文件再动手。多读一次文档,少猜一次架构。
八、现在的状态,和还欠的账
三个月下来,这个鸿蒙工程的样子是:
- 65 个 ArkTS 文件、1.7 万行代码、18 个注册页面;
- 应用身份:上架名沿用 Android 版的「子午流注」,包名与版本号对齐开发者平台登记值;
- 主壳五个 Tab:首页、商城、经络、学习、我的;
- 阅读能力:PDF、EPUB、视频三条入口都通了;
- 账号体系:手机号密码、微信、支付宝,含首次绑定和解绑;
- 会员与支付:微信、支付宝两条 VIP 支付链路,回调以服务端为准;
- 三维经络:Unity 库整包接入,独立 Ability、登录与 VIP 校验齐全。
还没收完的账也很清楚,不装:
- 正式签名配置要等第三方开放平台审核通过;
- 微信/支付宝的支付真机终验还挂着,需要生产后端部署配合;
- 少数依赖真机的能力(分享到好友/朋友圈等)要签名设备上再走一遍。
回到开头那个问题:鸿蒙版什么时候能上?
答案是——不会鸿蒙,也能上。前提是你愿意把 vibecoding 当成一套正经工程方法:先拆活、写文档、留证据、按报错推进,把 AI 当同事而不是许愿池。
它不记得三个月前的事,这很正常。你也别指望自己记得。把该记的记在文件里,把该验的贴在屏幕上。
别慌,问题不大。


评论前必须登录!
注册