 网硕互联帮助中心
干过交通行业的都知道,高速公路上最不值钱的是摄像头,最值钱的是能用的视频。一条省几千公里路,隧道、桥梁、门架、收费站、服务区,摄像机厂家能有十几个,协议五花八门,平台建了一茬又一茬,真到要调一路画面的时候,还得打电话问路段所密码。
这篇聊聊一套省级/路段级视频汇聚平台该怎么搭:设备怎么接、视频怎么转、事件怎么算、平台怎么级联,以及我们踩过的坑。
一、先看清楚要解决什么问题
视频汇聚不是"把画面上墙",核心是四件事:
按这四件事反推架构,比上来就选产品靠谱。
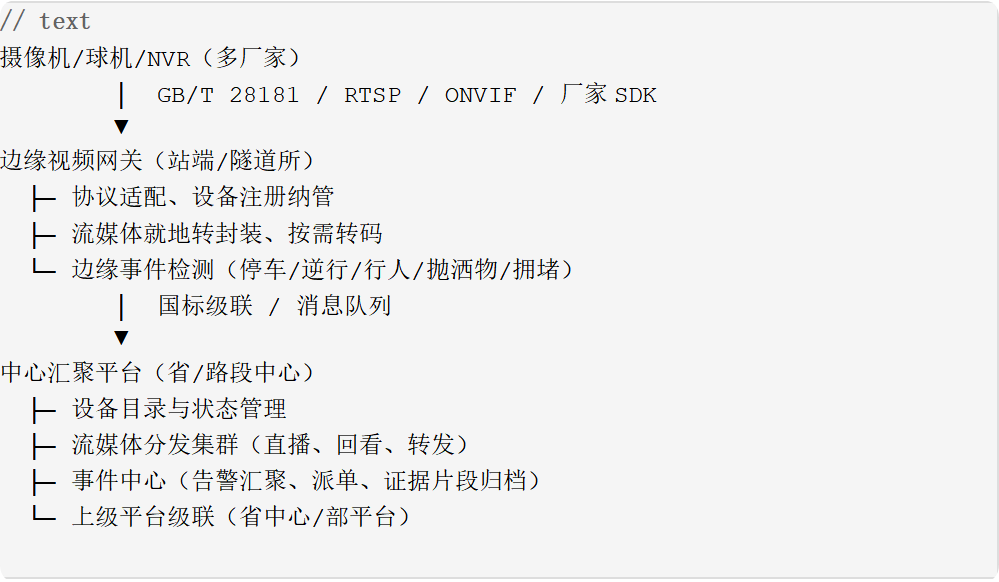
二、整体架构:端、边、云三
端:别指望设备统一
选型时千万别假设全线设备能统一替换,预算不允许,运营周期也不允许。现实做法是接入层做协议归一:
- 新建和近年设备优先走 GB/T 28181 注册,SIP 信令 + RTP 媒体,目录、点播、回放、云台控制都有标准流程;
- 老设备只支持 RTSP/ONVIF 的,由边缘网关主动拉流注册成虚拟国标通道;
- 连标准协议都没有的存量设备,用厂家 SDK 在网关侧做适配插件,对上仍然吐国标流。
这样中心平台只认一种协议,脏活全压在边缘,拓扑简单很多。
边:网关不是"协议转换器"那么简单
边缘视频网关至少要扛三件事:
一是设备纳管。几千路设备的在线状态、心跳、通道目录要在本地有缓存,链路中断后恢复能自动重注册,不能靠中心一台台去 ping。
二是流媒体处理。摄像机上来的码流五花八门(H.264/H.265、PS 封装、裸 RTP),网关做转封装而不是动不动转码——转码吃 DSP/GPU 资源,万路规模下成本完全不可接受,只有浏览器不支持的编码格式才按需转码。直播走"一次拉流、多分片分发",避免一百个客户端看同一路画面就去摄像机建一百条连接,老摄像机直接被拉死。
三是边缘智能。事件检测模型下沉到网关或就近的边缘算力盒,有两个硬理由:带宽,几千路视频全量回中心不现实,只回告警和片段;时延,隧道停车、逆行这种事件,等视频绕一圈省会再回来,晚个十几秒可能就是事故级别差别。边缘出告警、带截图和短视频片段,经消息队列上报中心,需要时再调完整录像。
云:中心拼的是分发和业务闭环
中心侧的关键组件:
- 设备中心:全网设备的"户口",编码规则要提前按交通运输行业的设备编码规范设计好,后面级联、检索、权限全都靠它,编码一旦乱了,迁移成本极高;
- 流媒体集群:无状态分发节点 + 负载均衡,按区域和线路调度,支持 GB/T 28181 上下级级联,也支持 WebRTC/HLS 一类协议给网页和移动端;
- 事件中心:算法告警报点之后,真正产生价值的是闭环——去重、分级、派单、处置回传。同一起停车事件,边缘算法可能连续推几十条,平台必须做时空去重和事件合并,否则值班员三分钟就被刷屏刷麻木;
- 存储分层:日常录像尽量留在站端/边缘 NVR,中心只存事件关联片段和关键图片,对象存储按"事件—路段—时间"归档,保存周期对齐举证和考核要求。
三、几个真金白银砸出来的坑
时钟不同步是万恶之源。事件截图、告警、录像对不上时间,事后核查就是灾难。NTP 对时必须覆盖到摄像机本体,不只是服务器。
H.265 网页播放是个坑。不少浏览器原生不支持,要么服务端转码(贵),要么前端用 WASM 软解(吃客户端性能),移动端分发提前做好协议降级策略。
内网带宽按峰值算,不按平均值算。交接班、早会、事故后领导调看,都是几百路并发的尖峰,流媒体级联链路要留冗余。
NAT 和多级路由下的 SIP/RTP 穿越。国标设备注册上来容易,媒体端口放不通是常事,网关部署位置、端口规划在方案阶段就要和网络人员对齐,别等联调时抓包抓通宵。
算法误报治理要进产品设计。雨雾、夜间车灯、路面补丁都会触发告警,阈值、场景模板、人工反馈回流要成套做,只谈识别率不谈误报率的算法,上线一个月必被值班员静音。
权限模型别后补。交警、路政、运营、养护看的是同一张路上不同的东西,点位权限、云台控制权限、录像下载权限在第一版就要设计,后补等于重做。
四、落到产品
这套架构没有什么神秘组件,难点全在工程细节:协议适配的覆盖率、流媒体在万路规模下的稳定性、事件去重和派单闭环、以及和多级平台的级联联调。山东易构软件技术股份有限公司的云监卫士就是按这个思路做的,配合视频云网关把多厂家存量设备统一纳管,前端事件检测、中心告警派单、证据片段归档一条链跑通,在隧道群和长下坡这类事件高发路段是刚需场景。
留个选择题,做视频/流媒体/交通行业的同行评论区聊:
A. 你们项目里设备接入占整体工作量的几成
B. 事件检测的误报率压到多少业务方才肯用
C. 万路级并发直播,流媒体选型有什么实战建议
D. GB/T 28181 级联联调踩过最离谱的坑是什么
评论区见。


评论前必须登录!
注册