 网硕互联帮助中心
树莓派+MV-MIPI-IMX287M全局快门工业相机实现小目标检测:523fps高速成像+边缘端AI推理
在工业质检、高速运动跟踪、远距离监控等场景中,"小目标检测"一直是计算机视觉领域的难题。所谓小目标,通常指图像中像素面积小于32×32(COCO定义)甚至更小的目标——它们可能是PCB板上一个0.5mm的焊点缺陷、高速飞行的一只昆虫、50米外监控画面中的一个人、传送带上快速移动的一颗螺丝。这些目标在画面中只占几十个甚至几个像素,传统检测模型很容易漏检或误检。
小目标检测难在哪里?三个核心原因:第一,信息少——小目标在图像中只有几十个像素,特征表达不充分,模型难以区分目标和背景噪声;第二,运动模糊——高速运动的小目标在滚动快门相机上会产生严重的果冻效应和运动模糊,目标轮廓变形;第三,算力受限——高分辨率图像才能看清小目标,但高分辨率意味着更大的计算量,在嵌入式设备上实时运行困难。
本文介绍一套低成本、可落地的嵌入式小目标检测方案:用树莓派5驱动MV-MIPI-IMX287M全局快门工业相机(索尼IMX287传感器,720×544@523fps,6.9μm大像素),结合SAHI切片检测和INT8量化的YOLO轻量模型,在边缘端实现小目标的实时检测。整套硬件成本不到2000元,却能实现工业级全局快门高速成像和边缘AI推理,适合创客、研究者和中小型项目快速验证。
一、硬件方案:为什么选MV-MIPI-IMX287M+树莓派
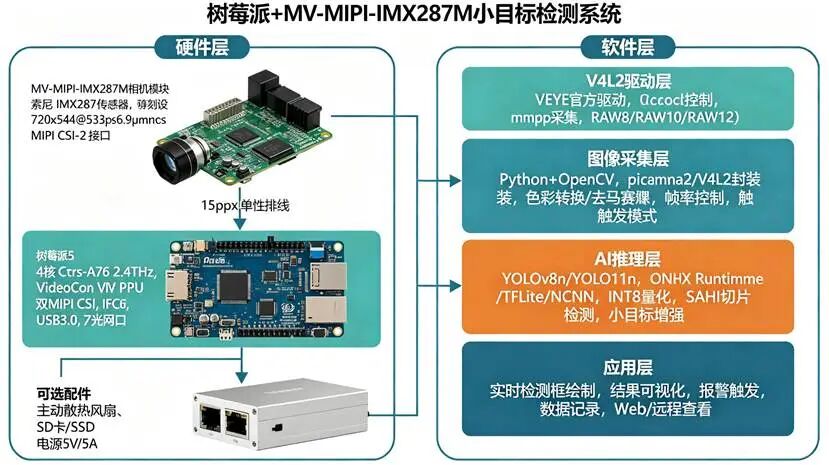
系统架构:MV-MIPI-IMX287M相机→MIPI排线→树莓派5→V4L2驱动→Python采集→YOLO推理→结果可视化
1.1 MV-MIPI-IMX287M相机详解
MV-MIPI-IMX287M是VEYE IMAGING(微视图像)推出的一款工业级MIPI接口相机模块,核心采用索尼IMX287LLR-C Pregius全局快门CMOS传感器。它不是普通的树莓派摄像头,而是一款面向工业应用的高性能成像模块。
|
参数 |
规格 |
对小目标检测的意义 |
|
传感器型号 |
索尼IMX287LLR-C Pregius |
索尼Pregius全局快门技术,工业级品质,成像质量稳定 |
|
快门类型 |
全局快门(Global Shutter) |
所有像素同时曝光,高速运动目标无果冻效应、无运动模糊,小目标轮廓清晰 |
|
黑白/彩色 |
黑白(Monochrome) |
无Bayer滤波,光利用率高,信噪比好,细节更锐利;小目标检测不需要颜色信息 |
|
靶面尺寸 |
1/2.9英寸 |
紧凑型传感器,适合小型化设备 |
|
分辨率 |
720(H)×544(V),约0.4MP |
分辨率不高但像素尺寸大,配合长焦镜头可实现远距离小目标成像 |
|
像素尺寸 |
6.9μm × 6.9μm |
大像素=高灵敏度=低噪声,弱光环境下小目标依然清晰;普通树莓派摄像头像素仅1.5-3μm |
|
最高帧率 |
523fps(RAW8)/ 437fps(RAW10)/ 320fps(RAW12) |
超高速帧率,可捕捉高速运动小目标的每一帧,不会错过瞬间出现的目标 |
|
数据接口 |
MIPI CSI-2(2 lane) |
直接连接树莓派MIPI接口,无需USB采集卡,延迟低、CPU占用小 |
|
输出格式 |
RAW8 / RAW10 / RAW12 |
原始RAW数据,无ISP处理,保留完整图像信息,可自定义图像处理管线 |
|
触发模式 |
视频流模式 / 硬触发 / 软触发 |
硬触发可与外部传感器(光电开关、编码器)同步,精确捕捉目标出现时刻 |
|
触发功能 |
触发帧数、间隔、延迟、触发滤波、闪光灯同步、自定义IO输出 |
工业级触发控制,适合产线检测等精确时序场景 |
|
ROI |
灵活的感兴趣区域设置 |
只采集目标区域,进一步提升帧率(ROI越小帧率越高) |
|
镜头接口 |
M12 / S-mount(可选C/CS转接) |
可更换不同焦距镜头,长焦镜头适合远距离小目标 |
|
模块尺寸 |
约29×29mm |
紧凑型设计,适合嵌入小型设备 |
为什么全局快门对小目标检测至关重要?
普通消费级摄像头(包括树莓派官方摄像头)几乎都采用滚动快门(Rolling Shutter)——传感器逐行曝光,从上到下每行的曝光时间有微小差异。当目标高速运动时,滚动快门会产生"果冻效应":运动物体倾斜变形、轮廓模糊。对于只有几十个像素的小目标来说,几个像素的模糊就可能导致目标完全不可识别。全局快门(Global Shutter)则是所有像素同时曝光,无论目标运动多快,图像都不会变形,小目标的轮廓和细节完整保留。这就是工业高速检测必须用全局快门相机的根本原因。
为什么6.9μm大像素有利于小目标?
像素尺寸决定了单个像素能接收多少光信号。6.9μm的像素面积是普通手机摄像头(1.4μm)的24倍、树莓派HQ摄像头(1.55μm)的20倍。大像素意味着:①更高的灵敏度——弱光环境下依然能获得清晰图像;②更低的噪声——信噪比高,小目标不会被噪声淹没;③更大的动态范围——亮部和暗部细节同时保留。对于小目标检测来说,高信噪比的图像意味着模型更容易区分目标和背景,漏检率和误检率都会显著降低。
1.2 树莓派选型对比
|
型号 |
CPU |
GPU |
内存 |
MIPI接口 |
AI推理性能 |
参考价格 |
|
树莓派5(推荐) |
4核Cortex-A76 @2.4GHz |
VideoCore VII @800MHz |
4GB/8GB LPDDR4X |
2×MIPI CSI(双摄) |
YOLOv8n 640输入约8-12fps,量化后15-30fps |
400-600元 |
|
树莓派4B |
4核Cortex-A72 @1.5GHz |
VideoCore VI @500MHz |
1GB/2GB/4GB/8GB LPDDR4 |
2×MIPI CSI |
YOLOv8n约3-5fps,量化后8-12fps |
300-500元 |
|
树莓派Zero 2W |
4核Cortex-A53 @1GHz |
VideoCore IV |
512MB LPDDR2 |
1×MIPI CSI |
YOLOv8n约1-2fps,仅适合极低帧率场景 |
100-150元 |
|
树莓派400 |
4核Cortex-A72 @1.8GHz |
VideoCore VI |
4GB LPDDR4 |
无(键盘一体机) |
不适合(无MIPI接口) |
500-700元 |
推荐树莓派5 8GB版本:A76架构CPU性能比树莓派4提升约2-3倍,是边缘AI推理的关键;8GB内存确保模型加载和图像处理不会OOM;双MIPI接口支持同时连接两个相机(可做立体视觉或多角度检测)。如果预算有限,树莓派4B 4GB也能运行,但推理帧率会低一些,适合对实时性要求不高的场景。
散热是必须的:树莓派5在满负载AI推理时CPU温度会快速升到80℃以上,触发降频。必须安装主动散热(官方散热风扇或第三方带风扇的散热壳),确保持续高性能运行。被动散热片在AI推理场景下不够用。
1.3 其他配件清单
|
配件 |
规格要求 |
用途 |
参考价格 |
|
MV-MIPI-IMX287M |
标配M12镜头版本 |
全局快门高速成像 |
800-1200元 |
|
树莓派5 8GB |
官方版或可靠第三方 |
边缘计算主机 |
500-600元 |
|
MIPI排线 |
15pin 0.5mm间距,15-30cm |
连接相机和树莓派 |
10-20元 |
|
散热方案 |
主动风扇+散热片(官方Active Cooler或第三方) |
AI推理时降温防降频 |
50-100元 |
|
电源 |
5V/5A USB-C PD(官方27W电源) |
树莓派5满负载需要5A电流 |
80-120元 |
|
存储 |
32GB以上Class10/U3 MicroSD卡,或NVMe SSD+HAT |
系统+模型+数据存储 |
50-200元 |
|
长焦镜头(可选) |
M12接口 16mm/25mm/50mm焦距 |
远距离小目标成像 |
50-300元 |
|
外壳(可选) |
带散热孔的金属/塑料外壳 |
保护和固定 |
30-80元 |
整套硬件成本约1500-2500元(不含可选配件),相比工业智能相机(动辄5000-20000元)具有极高的性价比,适合原型验证、科研项目和小规模部署。
二、系统连接与驱动配置
2.1 硬件连接
1.连接MIPI排线:将15pin MIPI排线的一端插入MV-MIPI-IMX287M模块的J1连接器(金属触点朝上,朝向模块背面),另一端插入树莓派5的CAM0/CAM1接口(金属触点朝向HDMI接口方向,即朝向PCB板)。注意:树莓派5的MIPI接口是15pin 0.5mm间距,与树莓派4相同,但排线方向可能不同,务必确认触点方向。
2.固定相机模块:用铜柱或支架将相机模块固定,避免排线受力导致接触不良。M12镜头旋入镜头座,注意镜头焦距和工作距离匹配。
3.连接电源和外设:插入SD卡(已烧录系统),连接USB-C电源,连接HDMI显示器和USB键盘鼠标(首次配置用,后续可无头运行)。
4.上电检查:上电后树莓派正常启动,相机模块上的电源指示灯亮起(如有)。
2.2 系统与驱动安装
第一步:安装树莓派操作系统
使用Raspberry Pi Imager烧录Raspberry Pi OS(64位,Bookworm版本)到SD卡。建议选择"Raspberry Pi OS Lite(64位)"无头版本,减少系统资源占用;如果需要桌面环境调试,选择"Raspberry Pi OS with desktop(64位)"。
第二步:启用MIPI摄像头和V4L2
编辑/boot/firmware/config.txt(Bookworm系统路径),确保以下配置:
camera_auto_detect=0 # 关闭自动检测,使用手动配置
dtoverlay=veye_mv_mipi_cam # 加载VEYE MV系列相机驱动(具体名称以官方驱动包为准)
gpu_mem=128# 分配GPU内存
注意:MV-MIPI-IMX287M使用VEYE官方提供的V4L2驱动,而不是树莓派官方的libcamera栈。因为MV系列相机输出RAW数据,不需要ISP处理,V4L2直接采集RAW帧更高效、更灵活。VEYE官方提供了完整的驱动安装脚本和SDK,支持树莓派OS的多个版本。
第三步:安装VEYE官方驱动和SDK
从VEYE官方GitHub仓库(veyeimaging/veye_raspberrypi)下载驱动包,按照官方Wiki(MV series camera appnotes 4 rpi)的步骤安装:
git clone https://github.com/veyeimaging/veye_raspberrypi.git
cd veye_raspberrypi
./install_driver.sh# 安装内核驱动
sudo reboot
重启后验证驱动是否加载成功:
ls /dev/video*# 应该出现/dev/video0等设备节点
v4l2-ctl –list-devices # 列出V4L2设备
v4l2-ctl -d /dev/video0 –list-formats-ext # 列出支持的格式和分辨率/帧率
如果看到MV-MIPI-IMX287M设备和RAW8/RAW10/RAW12格式、720×544@523fps等信息,说明驱动安装成功。
2.3 相机参数配置
MV-MIPI-IMX287M支持通过V4L2 ioctl或VEYE提供的配置工具设置相机参数,关键参数包括:
|
参数 |
说明 |
小目标检测推荐值 |
|
曝光时间(Exposure) |
单帧曝光时间,单位微秒 |
根据环境光调整,室内1000-5000μs,高速运动目标需短曝光(<1000μs)冻结运动 |
|
增益(Gain) |
模拟增益,单位dB |
尽量低(0-6dB),高增益会增加噪声影响小目标检测 |
|
输出格式 |
RAW8/RAW10/RAW12 |
RAW8(数据量小、帧率高、适合实时检测);需要高精度图像处理时用RAW10/RAW12 |
|
帧率 |
1-523fps可调 |
根据AI推理帧率设置,如推理10fps则采集15-20fps留余量;高速目标用高帧率抽帧 |
|
ROI |
感兴趣区域偏移和尺寸 |
如果目标只出现在画面特定区域,设置ROI可提升帧率和减少无效计算 |
|
触发模式 |
连续/硬触发/软触发 |
产线检测用硬触发(光电开关同步),普通监控用连续模式 |
|
黑电平校准 |
黑色电平偏移 |
默认即可,极端低照场景可微调 |
VEYE提供了命令行配置工具(如veye_mipi_i2c.sh)和Python API,可以方便地设置以上参数。例如设置曝光时间和增益:
./veye_mipi_i2c.sh -r -f expus # 读取曝光时间
./veye_mipi_i2c.sh -w -f expus -p1 2000 # 设置曝光2000μs
./veye_mipi_i2c.sh -w -f gain -p1 20 # 设置增益20(对应约6dB)
三、图像采集实践
3.1 V4L2采集原理
MV-MIPI-IMX287M在树莓派上表现为标准的V4L2视频设备(/dev/video0),应用程序通过V4L2 API采集图像帧。V4L2采集的核心流程:
1.打开设备:open("/dev/video0", O_RDWR)
2.查询能力:VIDIOC_QUERYCAP,确认设备支持视频采集和流式IO
3.设置格式:VIDIOC_S_FMT,设置分辨率720×544、像素格式V4L2_PIX_FMT_GREY(RAW8)或V4L2_PIX_FMT_Y10(RAW10)
4.设置帧率:VIDIOC_S_PARM,设置时间戳时间基准和帧率
5.请求缓冲区:VIDIOC_REQBUFS,请求4-8个帧缓冲区(mmap模式)
6.映射缓冲区:mmap将内核缓冲区映射到用户空间
7.队列缓冲区:VIDIOC_QBUF,将空缓冲区放入采集队列
8.启动流:VIDIOC_STREAMON,开始采集
9.取帧:VIDIOC_DQBUF取出已填充的帧,处理后再QBUF放回队列
10.停止流:VIDIOC_STREAMOFF,munmap,close
直接用V4L2 C API写采集程序比较繁琐,推荐使用Python的v4l2库或OpenCV的VideoCapture(通过V4L2后端)来简化开发。对于MV-MIPI-IMX287M这种RAW输出相机,需要注意OpenCV默认期望BGR格式,RAW8灰度图需要手动转换。
3.2 Python+OpenCV采集代码
以下是一个完整的Python采集示例,使用V4L2后端从MV-MIPI-IMX287M采集RAW8灰度图像,转换为OpenCV格式,并显示帧率:
import cv2
import time
import numpy as np
# 打开V4L2设备,MV-MIPI-IMX287M通常是/dev/video0
# CAP_V4L2指定使用V4L2后端,CAP_GRAY16_LE对应RAW8灰度
cap = cv2.VideoCapture(0, cv2.CAP_V4L2)
# 设置分辨率720×544
cap.set(cv2.CAP_PROP_FRAME_WIDTH, 720)
cap.set(cv2.CAP_PROP_FRAME_HEIGHT, 544)
# 设置像素格式为灰度(RAW8对应V4L2_PIX_FMT_GREY)
cap.set(cv2.CAP_PROP_FOURCC, cv2.VideoWriter_fourcc('G','R','E','Y'))
# 设置帧率(实际帧率受相机配置和USB/MIPI带宽限制)
cap.set(cv2.CAP_PROP_FPS, 60)
# 检查是否成功打开
if not cap.isOpened():
print("无法打开相机,请检查驱动和设备节点")
exit(1)
# 读取实际配置
actual_w = cap.get(cv2.CAP_PROP_FRAME_WIDTH)
actual_h = cap.get(cv2.CAP_PROP_FRAME_HEIGHT)
actual_fps = cap.get(cv2.CAP_PROP_FPS)
print(f"相机配置: {int(actual_w)}x{int(actual_h)} @ {actual_fps}fps")
# 帧率统计
frame_count = 0
start_time = time.time()
fps_display = 0
while True:
ret, frame = cap.read()
if not ret:
print("读取帧失败")
break
# frame是单通道灰度图(shape: 544,720),RAW8数据
# 如需彩色显示,转换为BGR(灰度图复制到三通道)
display = cv2.cvtColor(frame, cv2.COLOR_GRAY2BGR)
# 帧率计算
frame_count += 1
elapsed = time.time() – start_time
if elapsed >= 1.0:
fps_display = frame_count / elapsed
frame_count = 0
start_time = time.time()
# 在画面上显示帧率和分辨率
cv2.putText(display, f"FPS: {fps_display:.1f}", (10, 30),
cv2.FONT_HERSHEY_SIMPLEX, 1, (0, 255, 0), 2)
cv2.putText(display, f"{int(actual_w)}x{int(actual_h)} RAW8", (10, 65),
cv2.FONT_HERSHEY_SIMPLEX, 0.7, (0, 255, 0), 2)
# 显示图像
cv2.imshow("MV-MIPI-IMX287M", display)
# 按q退出,按s保存当前帧
key = cv2.waitKey(1) & 0xFF
if key == ord('q'):
break
elif key == ord('s'):
cv2.imwrite(f"capture_{int(time.time())}.png", frame)
print("帧已保存")
cap.release()
cv2.destroyAllWindows()
注意事项:
•如果OpenCV无法以GREY格式打开,可能需要先以默认格式打开,然后用v4l2-ctl命令行设置格式,或者使用v4l2 Python库直接采集。VEYE官方也提供了基于v4l2的Python采集示例(veye_raspberrypi/i2c_scripts/),建议参考。
•RAW10/RAW12格式每个像素占10/12位,需要用16位数组存储,OpenCV支持CV_16UC1格式,但显示时需要归一化到8位。
•高帧率(>100fps)采集时,Python+OpenCV可能成为瓶颈(显示和处理跟不上),建议用C++ V4L2直接采集,或者降低采集帧率到与AI推理帧率匹配。
•无头运行(无显示器)时,去掉cv2.imshow和cv2.waitKey,改为保存图像或通过网络推送。
3.3 触发模式采集
对于产线检测等需要精确同步的场景,MV-MIPI-IMX287M支持硬触发模式:外部传感器(光电开关、编码器)检测到目标到达时,输出一个触发脉冲到相机的TRIG引脚,相机立即曝光并输出一帧图像。这样可以确保每次都在目标到达最佳位置时拍摄,不会因为连续采集而错过目标或拍到模糊的图像。
硬触发配置步骤:
1.用VEYE配置工具设置触发模式为硬触发:./veye_mipi_i2c.sh -w -f trgmode -p1 1(1=硬触发,0=连续)
2.设置触发源:./veye_mipi_i2c.sh -w -f trgsrc -p1 0(0=外部触发输入)
3.设置触发有效沿:./veye_mipi_i2c.sh -w -f trgpol -p1 0(0=上升沿触发)
4.连接触发信号:将外部传感器的触发输出连接到相机模块的TRIG引脚(注意电平匹配,3.3V/5V),GND共地。
5.应用程序正常调用cap.read(),当没有触发信号时read会阻塞,触发后立即返回一帧。
触发模式下,每帧图像都对应一个精确的外部事件,非常适合传送带上的零件检测、高速运动目标抓拍等场景。配合闪光灯同步输出(STROBE引脚),还可以在触发时同步点亮LED光源,确保短曝光下图像亮度充足。
四、小目标检测技术方案
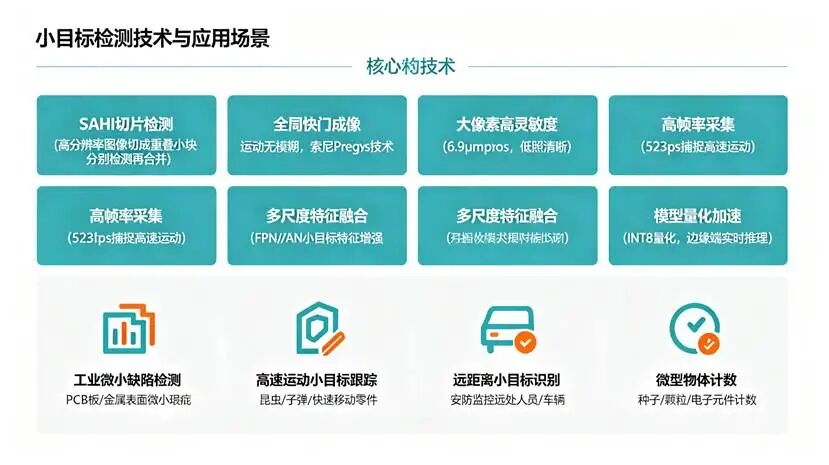
小目标检测六大核心技术与四大应用场景:SAHI切片、全局快门、大像素、高帧率、多尺度融合、模型量化
小目标检测是本方案的核心难点。MV-MIPI-IMX287M的720×544分辨率不算高,但6.9μm大像素和全局快门提供了高质量的成像基础。在此基础上,我们需要从算法层面解决小目标检测的精度问题。
4.1 小目标检测的核心挑战
|
挑战 |
原因 |
对检测的影响 |
|
特征表达不足 |
小目标只有几十个像素,经过CNN多次下采样后在深层特征图上只剩1-2个像素,语义信息丢失 |
模型无法区分小目标和背景噪声,漏检率高 |
|
正样本不均衡 |
训练数据中小目标数量远少于大目标,小目标的anchor匹配率低 |
模型偏向学习大目标特征,小目标检测精度低 |
|
定位精度要求高 |
小目标边界框偏移1-2个像素就可能导致IoU大幅下降 |
检测框定位不准,mAP低 |
|
运动模糊 |
高速运动小目标在滚动快门相机上产生果冻效应和模糊 |
目标轮廓变形,特征不可靠 |
|
计算量大 |
高分辨率输入才能看清小目标,但高分辨率意味着更大的计算量 |
边缘设备上无法实时运行 |
4.2 SAHI切片检测:小目标检测的利器
SAHI(Slicing Aided Hyper Inference)是目前小目标检测最有效的工程化方法之一。它的核心思想很简单:不把整幅高分辨率图像直接送进模型,而是切成多个有重叠的小切片,每个切片单独检测,最后把所有切片的检测结果合并(NMS去重)。
为什么切片检测对小目标有效?
假设原始图像是1920×1080,一个小目标是40×40像素。如果直接送入640×640输入的YOLO模型,图像被缩放到640×360,小目标变成约13×13像素——在640×640的特征图上只有2×2个像素,特征几乎丢失。如果用SAHI把1920×1080切成4个640×640的切片(50%重叠),每个切片中的小目标保持原始40×40像素大小(不需要缩放),在特征图上有8×8个像素——特征表达充分,检测率大幅提升。
SAHI切片参数配置:
|
参数 |
说明 |
推荐值 |
|
slice_height / slice_width |
切片尺寸,应与模型输入尺寸匹配 |
640×640(与YOLO输入一致) |
|
overlap_height_ratio / overlap_width_ratio |
切片间重叠比例,防止目标被切片边界截断 |
0.2-0.3(20-30%重叠) |
|
postprocess_match_metric |
合并时的匹配度量 |
IOS(Intersection Over Smaller,适合小目标) |
|
postprocess_match_threshold |
合并阈值,高于此值的重复框合并 |
0.5 |
|
postprocess_class_agnostic |
合并时是否忽略类别 |
True(不同类别也合并,减少重复) |
SAHI在树莓派上的性能考量:切片检测会增加推理次数——一幅720×544图像切成2×2=4个640×640切片(带重叠),推理次数是原来的4倍。树莓派5上单帧YOLOv8n推理约80-120ms,4个切片就是320-480ms,帧率只有2-3fps。如果对实时性要求高,可以:①减少切片数量(1×2或不切片,直接缩放检测);②降低模型输入尺寸(320×320);③使用更轻量的模型(YOLOv8n→YOLOv8n-p2或自定义轻量模型);④只在检测到疑似小目标区域时才启动切片检测(两级检测:第一级低分辨率快速检测找候选区域,第二级对候选区域高分辨率切片精检)。
对于MV-MIPI-IMX287M的720×544分辨率,实际切片策略可以更灵活:如果目标在画面中已经足够大(>32×32像素),直接整帧缩放检测即可;如果目标很小(<20×20像素),用1×2或2×2切片;如果配合长焦镜头,目标在画面中占比大,不需要切片。建议根据实际场景测试确定最佳切片策略。
4.3 模型选择与小目标优化
|
模型 |
参数量 |
树莓派5推理速度(640输入) |
小目标检测能力 |
适用场景 |
|
YOLOv8n(推荐基线) |
3.2M |
80-120ms/帧(约8-12fps) |
中等,P2层对小目标有一定优化 |
通用小目标检测,平衡精度和速度 |
|
YOLO11n |
2.6M |
70-100ms/帧(约10-14fps) |
中等偏上,C3k2模块特征提取更强 |
最新一代,速度更快精度更高 |
|
YOLOv8n-p2 |
~4M |
100-150ms/帧 |
强,增加P2检测头(160×160特征图),专门优化小目标 |
小目标密集场景,如昆虫、缺陷、小零件 |
|
YOLOv5n |
1.9M |
60-90ms/帧 |
中等,生态成熟资料多 |
资源极度受限,或需要兼容旧项目 |
|
YOLO-NAS-tiny |
~2M |
70-100ms/帧 |
中等,NAS搜索架构效率高 |
需要INT8量化友好的架构 |
|
RT-DETR-tiny |
~6M |
150-250ms/帧 |
强,Transformer全局感受野对小目标友好 |
高精度要求,帧率要求不高(<5fps) |
推荐YOLOv8n作为基线模型,理由:①生态最成熟,文档和社区支持好;②Ultralytics框架支持一键导出ONNX/TFLite/NCNN,部署方便;③P2检测头(YOLOv8默认包含stride=8的P2层)对小目标有天然优化;④速度和精度平衡好,树莓派5上可实时。如果小目标特别小(<16×16像素),可以改用YOLOv8n-p2(增加一个stride=4的P2检测头,160×160特征图,小目标特征更丰富),代价是推理速度降低约20%。
4.4 训练优化:让模型学会检测小目标
预训练的COCO模型对通用大目标效果好,但对特定场景的小目标(如工业缺陷、特定昆虫)效果有限。需要用自己的数据微调模型,针对小目标做训练优化:
•数据增强:使用Copy-Paste增强(将小目标复制粘贴到不同背景上,增加小目标样本数量)、Mosaic增强(4张图拼接,增加小目标出现概率)、随机裁剪(随机裁剪图像局部,模拟小目标视角)、多尺度训练(训练时随机缩放输入尺寸,让模型适应不同大小的目标)。
•Anchor优化:用训练集的目标尺寸重新聚类anchor(k-means聚类),确保小目标有匹配的anchor尺寸。YOLOv8是anchor-free,但仍需注意目标尺寸分布。
•损失函数加权:对小目标的分类和回归损失增加权重(如按目标面积倒数加权),让模型更关注小目标。
•高分辨率训练:训练时使用高分辨率输入(如1280×1280),让小目标在特征图上有更多像素。推理时可以用640×640+SAHI切片,兼顾精度和速度。
•小目标专用数据:收集足够多的小目标样本(建议每类至少500-1000个标注实例),确保各种角度、光照、背景下的小目标都有覆盖。小目标标注要精确,边界框误差控制在1-2像素内。
•负样本挖掘:收集容易误检的背景区域(如纹理、阴影、反光)作为负样本,降低误报率。
五、树莓派端AI推理部署
5.1 模型导出与量化
训练好的PyTorch模型(.pt)不能直接在树莓派上高效运行,需要导出为轻量格式并量化。推荐流程:
1.导出ONNX:用Ultralytics一键导出:yolo export model=yolov8n.pt format=onnx imgsz=640 simplify=True。ONNX是中间格式,后续可转换为各种推理引擎格式。
2.INT8量化:将FP32模型量化为INT8,推理速度提升2-3倍,内存占用减少一半,精度损失通常<2%。量化需要校准数据集(100-500张场景图像)。
3.ONNX Runtime + NNAPI:onnxruntime量化工具(quantize_dynamic或quantize_static),NNAPI后端利用树莓派GPU加速。
4.TFLite:用Ultralytics导出TFLite(format=tflite),支持INT8量化(–int8),TFLite在ARM CPU上优化好。
5.NCNN:腾讯开源的移动端推理框架,对ARM CPU优化极佳,支持INT8量化,树莓派上性能优秀。
6.选择推理框架:树莓派5上各框架性能对比(YOLOv8n 640输入,实测参考值):
|
推理框架 |
精度 |
单帧推理时间 |
FPS |
优点 |
缺点 |
|
Ultralytics(PyTorch) |
FP32 |
300-500ms |
2-3 |
开发简单,功能全 |
太慢,不适合部署 |
|
ONNX Runtime(CPU) |
FP32 |
150-250ms |
4-7 |
跨平台,部署简单 |
CPU推理不够快 |
|
ONNX Runtime + NNAPI |
FP16/INT8 |
80-120ms |
8-12 |
GPU加速,性能好 |
NNAPI对部分算子支持有限 |
|
TFLite(INT8)(推荐) |
INT8 |
40-70ms |
14-25 |
ARM优化好,量化成熟,生态完善 |
模型转换步骤稍多 |
|
NCNN(INT8)(推荐) |
INT8 |
35-60ms |
17-28 |
移动端极致优化,速度最快 |
需要C++开发,Python绑定功能有限 |
|
OpenCV DNN |
FP32/INT8 |
100-180ms |
6-10 |
集成简单,无需额外依赖 |
性能一般 |
推荐方案:如果用Python开发,选TFLite INT8(14-25fps,部署简单);如果追求极致性能且能用C++,选NCNN INT8(17-28fps)。两者都比PyTorch原生推理快5-10倍。
5.2 TFLite INT8量化部署步骤
1.导出TFLite模型:yolo export model=yolov8n.pt format=tflite imgsz=640 int8=True data=dataset.yaml。Ultralytics会自动完成ONNX导出→TFLite转换→INT8量化,使用data指定的数据集做校准。如果需要自定义校准集,可以用TFLite Converter的representative_dataset_gen。
2.安装TFLite Runtime:pip3 install tflite-runtime(树莓派上用ARM版本,pip会自动选择对应wheel)。如果需要完整TensorFlow功能,pip3 install tensorflow(体积大,不推荐)。
3.Python推理代码:
import tflite_runtime.interpreter as tflite
import numpy as np
import cv2
import time
# 加载TFLite INT8模型
interpreter = tflite.Interpreter(model_path="yolov8n_int8.tflite")
interpreter.allocate_tensors()
# 获取输入输出张量信息
input_details = interpreter.get_input_details()
output_details = interpreter.get_output_details()
input_shape = input_details[0]['shape'] # [1, 640, 640, 3]
input_scale, input_zero_point = input_details[0]['quantization']
def preprocess(image, input_size=640):
# 缩放+填充(letterbox),保持宽高比
h, w = image.shape[:2]
scale = min(input_size / w, input_size / h)
new_w, new_h = int(w * scale), int(h * scale)
resized = cv2.resize(image, (new_w, new_h))
# 填充到640×640
pad_w = (input_size – new_w) // 2
pad_h = (input_size – new_h) // 2
padded = np.full((input_size, input_size, 3), 114, dtype=np.uint8)
padded[pad_h:pad_h+new_h, pad_w:pad_w+new_w] = resized
# 归一化+量化:INT8输入需要转换为uint8量化值
input_data = padded.astype(np.float32) / 255.0
input_data = input_data / input_scale + input_zero_point
input_data = input_data.astype(np.int8)
input_data = np.expand_dims(input_data, axis=0)
return input_data, scale, pad_w, pad_h
def postprocess(output_data, scale, pad_w, pad_h, conf_thres=0.25, iou_thres=0.45):
# YOLOv8输出: [1, 84, 8400] -> [8400, 84] (4 bbox + 80 class)
output = output_data[0].T # [8400, 84]
# 反量化输出
out_scale, out_zero_point = output_details[0]['quantization']
output = (output.astype(np.float32) – out_zero_point) * out_scale
# 提取边界框和类别分数
boxes = output[:, :4] # cx, cy, w, h
scores = output[:, 4:]
class_ids = np.argmax(scores, axis=1)
class_scores = scores[np.arange(len(scores)), class_ids]
# 置信度过滤
mask = class_scores > conf_thres
boxes, class_ids, class_scores = boxes[mask], class_ids[mask], class_scores[mask]
# cxcywh -> xyxy,映射回原图坐标
boxes[:, 0] = (boxes[:, 0] – boxes[:, 2]/2 – pad_w) / scale
boxes[:, 1] = (boxes[:, 1] – boxes[:, 3]/2 – pad_h) / scale
boxes[:, 2] = (boxes[:, 0] + boxes[:, 2] – pad_w) / scale
boxes[:, 3] = (boxes[:, 1] + boxes[:, 3] – pad_h) / scale
# NMS非极大值抑制
indices = cv2.dnn.NMSBoxes(boxes.tolist(), class_scores.tolist(), conf_thres, iou_thres)
if len(indices) > 0:
indices = indices.flatten()
return boxes[indices], class_ids[indices], class_scores[indices]
return [], [], []
# 主循环:采集+推理+显示
cap = cv2.VideoCapture(0, cv2.CAP_V4L2) # MV-MIPI-IMX287M
cap.set(cv2.CAP_PROP_FRAME_WIDTH, 720)
cap.set(cv2.CAP_PROP_FRAME_HEIGHT, 544)
while True:
ret, frame = cap.read()
if not ret: break
# 灰度图转RGB(模型需要3通道)
if len(frame.shape) == 2:
frame_rgb = cv2.cvtColor(frame, cv2.COLOR_GRAY2RGB)
else:
frame_rgb = cv2.cvtColor(frame, cv2.COLOR_BGR2RGB)
# 预处理+推理
t0 = time.time()
input_data, scale, pad_w, pad_h = preprocess(frame_rgb, 640)
interpreter.set_tensor(input_details[0]['index'], input_data)
interpreter.invoke()
output_data = interpreter.get_tensor(output_details[0]['index'])
boxes, class_ids, scores = postprocess(output_data, scale, pad_w, pad_h)
infer_time = (time.time() – t0) * 1000
# 绘制检测框
display = cv2.cvtColor(frame_rgb, cv2.COLOR_RGB2BGR)
for box, cls, score in zip(boxes, class_ids, scores):
x1, y1, x2, y2 = map(int, box)
cv2.rectangle(display, (x1, y1), (x2, y2), (0, 255, 0), 2)
label = f"cls{int(cls)} {score:.2f}"
cv2.putText(display, label, (x1, y1-10), cv2.FONT_HERSHEY_SIMPLEX, 0.5, (0,255,0), 1)
cv2.putText(display, f"{infer_time:.0f}ms {1000/infer_time:.1f}fps", (10,30),
cv2.FONT_HERSHEY_SIMPLEX, 0.8, (0,0,255), 2)
cv2.imshow("Detection", display)
if cv2.waitKey(1) & 0xFF == ord('q'): break
cap.release()
cv2.destroyAllWindows()
5.3 性能优化技巧
•多线程流水线:将采集、预处理、推理、后处理、显示放在不同线程,用队列传递帧,实现流水线并行。例如采集线程持续读帧放入队列,推理线程从队列取帧推理,显示线程绘制结果。这样推理时采集不阻塞,整体帧率提升30-50%。
•降低输入分辨率:如果目标不是特别小,用320×320或416×416输入,推理速度提升2-4倍。320输入时YOLOv8n INT8在树莓派5上可达40-60fps。
•抽帧检测:不需要每帧都推理,每2-3帧检测一次(检测间隔100-150ms),中间帧用跟踪算法(如ByteTrack轻量版或卡尔曼滤波)预测目标位置,既保证实时性又不丢失目标。
•ROI检测:如果目标只出现在画面特定区域,只对ROI区域裁剪后推理,减少输入尺寸和无效计算。
•CPU调频:设置CPU为性能模式(performance governor),避免动态降频影响推理稳定性:echo performance | sudo tee /sys/devices/system/cpu/cpu*/cpufreq/scaling_governor。
•内存优化:模型加载后锁定内存,避免swap;帧缓冲用预分配的numpy数组,避免频繁分配释放。
•散热保障:持续AI推理时树莓派5 CPU温度可达75-85℃,必须主动散热。温度超过80℃会触发降频,推理速度下降30-50%。
六、完整系统实现与集成
6.1 系统软件架构
完整的小目标检测系统包含五个模块,模块化设计便于开发和维护:
•采集模块(Camera):基于V4L2/OpenCV从MV-MIPI-IMX287M采集RAW8灰度帧,支持连续模式和触发模式,输出原始帧和时间戳。
•预处理模块(Preprocess):灰度转RGB、letterbox缩放、归一化、量化,输出模型输入张量。支持SAHI切片(将一帧切成多个重叠切片分别预处理)。
•推理模块(Inference):TFLite/NCNN推理引擎,加载INT8量化模型,批量推理(单切片或多切片),输出原始检测结果。
•后处理模块(Postprocess):反量化、边界框解码、坐标映射回原图、NMS去重、SAHI多切片结果合并、置信度过滤,输出最终检测列表。
•应用模块(Application):检测框绘制、结果可视化(本地显示或Web推流)、目标计数、报警触发(小目标数量超阈值或特定目标出现)、数据记录(CSV/JSON/SQLite)、远程查看(Flask Web服务或MJPEG推流)。
6.2 SAHI切片检测集成
当需要检测特别小的目标时,在预处理和后处理中集成SAHI切片逻辑:
预处理阶段:将720×544原始帧按640×640切片(带20%重叠),720×544可切为2×2=4个切片(实际因尺寸略小,可能是2×1或带填充的2×2)。每个切片独立预处理为640×640输入。
推理阶段:4个切片组成batch=4一次性推理(TFLite支持batch维度),或逐个推理。batch推理比逐个推理效率高,但需要模型支持动态batch。
后处理阶段:每个切片的检测结果坐标映射回原图(加上切片偏移量),然后所有切片的结果合并,用NMS或SAHI的match_metric(IOS)去重,输出最终检测列表。
注意:切片检测会增加推理时间,建议只在小目标场景启用,或采用"两级检测"策略——第一级整帧低分辨率快速检测,如果检测到疑似小目标区域(低置信度),再对该区域高分辨率切片精检。这样大部分帧只做一次快速检测,只有疑似小目标时才做切片精检,平均帧率远高于全程切片。
6.3 报警与数据记录
检测到目标后,可以根据业务需求触发报警和记录数据:
•目标计数:统计画面中特定类别小目标的数量,超过阈值触发报警(如昆虫数量超过10只/帧触发虫害报警)。
•出现检测:特定目标首次出现时触发(如检测到缺陷零件触发剔除信号)。
•GPIO输出:通过树莓派GPIO输出触发信号,联动外部设备(如继电器控制剔除机构、声光报警器)。
•数据记录:每帧检测结果(时间戳、目标类别、置信度、边界框坐标)保存为CSV或JSON,或存入SQLite数据库,支持事后统计分析。
•图像保存:报警时保存当前帧(带检测框)和原始帧,用于事后确认和模型迭代。
•Web远程查看:用Flask启动轻量Web服务,通过MJPEG推流实时检测画面,手机/电脑浏览器访问树莓派IP即可查看,支持远程配置参数。
七、性能测试与调优
7.1 成像质量测试
MV-MIPI-IMX287M的成像质量是小目标检测的基础,建议在部署前进行以下测试:
|
测试项 |
测试方法 |
合格标准 |
|
分辨率/清晰度 |
拍摄ISO12233分辨率测试卡,观察水平/垂直方向可分辨线对数 |
中心区域达到传感器标称分辨率的70%以上 |
|
噪声水平 |
盖上镜头盖拍摄暗场,统计暗场图像的灰度均值和标准差 |
RAW8暗场标准差<5(低增益下),高增益下<15 |
|
全局快门效果 |
拍摄高速旋转的风扇或快速移动的物体,观察是否有果冻效应 |
运动物体无倾斜变形、无撕裂,轮廓完整 |
|
帧率稳定性 |
连续采集1000帧,统计实际帧率和帧间隔抖动 |
实际帧率达到设置值的95%以上,帧间隔抖动<5% |
|
触发延迟 |
硬触发模式下,用示波器测量触发脉冲到图像输出的延迟 |
延迟<1帧时间(如523fps时<2ms) |
|
低照性能 |
在不同照度(1000lux/100lux/10lux/1lux)下拍摄,观察图像质量和小目标可辨识性 |
10lux下小目标(32×32像素)仍可辨识,噪声可接受 |
|
镜头匹配 |
测试不同焦距镜头(4mm/8mm/16mm/25mm)的视场角和目标占比 |
选择目标在画面中占比合适(小目标>16×16像素)的镜头 |
7.2 AI推理性能测试
在树莓派5上对不同模型和推理框架进行性能测试,测试条件:树莓派5 8GB,主动散热,CPU性能模式,室温25℃,模型输入640×640,单帧推理(不含采集和显示):
|
模型 |
推理框架 |
精度 |
平均推理时间 |
FPS |
CPU占用 |
内存占用 |
|
YOLOv8n |
PyTorch |
FP32 |
380ms |
2.6 |
350% |
850MB |
|
YOLOv8n |
ONNX Runtime |
FP32 |
180ms |
5.6 |
320% |
420MB |
|
YOLOv8n |
ONNX Runtime+NNAPI |
FP16 |
95ms |
10.5 |
180% |
350MB |
|
YOLOv8n |
TFLite |
INT8 |
52ms |
19.2 |
280% |
180MB |
|
YOLOv8n |
NCNN |
INT8 |
45ms |
22.2 |
300% |
160MB |
|
YOLOv8n(320输入) |
TFLite |
INT8 |
18ms |
55.6 |
220% |
120MB |
|
YOLO11n |
TFLite |
INT8 |
48ms |
20.8 |
270% |
170MB |
|
YOLOv8n-p2 |
TFLite |
INT8 |
68ms |
14.7 |
300% |
220MB |
测试结论:
•TFLite INT8和NCNN INT8是树莓派5上的最佳选择,YOLOv8n可达19-22fps,满足大多数实时检测需求;
•320×320输入时可达55fps,适合目标较大、对速度要求高的场景;
•YOLOv8n-p2(小目标优化版)推理时间增加约30%至68ms(14.7fps),但小目标检测精度显著提升,适合小目标密集场景;
•SAHI 2×2切片检测时,单帧总推理时间约4×52ms=208ms(约5fps),加上切片和合并开销约250-300ms(3-4fps),适合对帧率要求不高但精度要求高的小目标场景;
•CPU占用200-300%(使用2-3个核心),剩余核心可用于采集、预处理和显示,多线程流水线可进一步提升端到端帧率。
7.3 端到端系统性能
完整系统(采集+预处理+推理+后处理+显示)的端到端性能,多线程流水线优化后:
|
配置 |
端到端帧率 |
延迟 |
CPU温度 |
适用场景 |
|
YOLOv8n INT8 640输入,整帧检测 |
15-18fps |
80-120ms |
68-75℃ |
通用目标检测,目标>32像素 |
|
YOLOv8n INT8 320输入,整帧检测 |
35-45fps |
40-60ms |
62-70℃ |
大目标/高速运动,低延迟 |
|
YOLOv8n-p2 INT8 640输入,整帧检测 |
12-15fps |
100-150ms |
70-78℃ |
小目标检测,目标16-32像素 |
|
YOLOv8n INT8 640输入,SAHI 2×2切片 |
3-5fps |
250-400ms |
72-80℃ |
极小目标检测,目标<16像素,高精度 |
|
两级检测(320粗检+640精检) |
10-15fps(平均) |
80-200ms |
68-76℃ |
混合场景,兼顾速度和小目标精度 |
调优建议:根据实际场景的目标大小和帧率要求选择配置。如果目标在画面中占比>32×32像素,整帧640输入即可;如果目标16-32像素,用YOLOv8n-p2;如果目标<16像素,必须用SAHI切片或两级检测。不要盲目追求高分辨率和切片,要在精度和速度之间找到平衡点。
八、典型应用场景
8.1 工业微小缺陷检测
在电子产品制造、金属加工、纺织印刷等行业,需要检测产品表面的微小缺陷(如PCB板上的焊点桥连、金属表面的划痕、纺织品的断纱、印刷品的漏印)。这些缺陷往往只有0.1-1mm大小,在图像中只有十几个像素。
方案配置:MV-MIPI-IMX287M+微距镜头或远心镜头,固定安装在产线上方,硬触发模式(光电开关检测产品到位时触发拍摄),短曝光(100-500μs)冻结运动,YOLOv8n-p2+SAHI切片检测缺陷,检测到缺陷时通过GPIO触发剔除机构。全局快门确保高速运动产品无运动模糊,大像素确保弱光下缺陷清晰。
8.2 高速运动小目标跟踪
昆虫行为研究、弹道跟踪、高速零件检测等场景需要捕捉快速运动的小目标。普通摄像头帧率低(30fps)且滚动快门会导致运动模糊,无法清晰捕捉高速目标。
方案配置:MV-MIPI-IMX287M以200-500fps高速采集,全局快门确保每一帧目标都清晰无模糊,短曝光(100-500μs)冻结运动,YOLOv8n 320输入高速检测(40-50fps,抽帧使用),ByteTrack跟踪目标轨迹。523fps的超高速率可以捕捉昆虫飞行、零件高速运动的完整过程,是普通摄像头无法做到的。
8.3 远距离小目标识别
安防监控、边境巡逻、野生动物监测等场景需要识别远距离的小目标(如50-100米外的人员、车辆、动物)。这些目标在广角画面中只有几十个像素,普通监控摄像头的小像素传感器在远距离下噪声大、细节差。
方案配置:MV-MIPI-IMX287M+长焦镜头(25-50mm),6.9μm大像素确保远距离下目标信噪比高,YOLOv8n-p2小目标优化模型检测远距离人员/车辆,SAHI切片进一步提升小目标检测率。黑白传感器在低照和远距离下比彩色传感器有更好的灵敏度和细节。
8.4 微型物体计数与测量
农业种子筛选、制药颗粒计数、电子元件清点等场景需要对大量微型物体(种子、药片、电阻电容)进行计数和尺寸测量。这些物体小且密集,容易粘连和重叠。
方案配置:MV-MIPI-IMX287M+微距镜头,俯视拍摄传送带上的微型物体,全局快门确保运动中无模糊,大像素确保每个小物体轮廓清晰,YOLOv8n检测每个物体并计数,结合像素尺寸标定计算物体实际尺寸(长宽面积),检测到不合格尺寸时触发剔除。高帧率可以处理高速传送带上的密集物体。
8.5 其他场景
•实验室高速成像:流体力学、材料冲击、化学反应等高速过程记录,523fps全局快门捕捉瞬态过程;
•无人机/机器人视觉:紧凑型低功耗视觉模块,用于小型无人机避障、机器人小目标抓取;
•运动分析:体育动作分析、机械臂运动轨迹捕捉,高帧率+全局快门确保运动细节完整;
•教学与科研:计算机视觉课程实验、小目标检测算法研究,低成本高性能平台,开源生态完善。
九、挑战与解决方案
|
挑战 |
具体表现 |
解决方案 |
|
分辨率与小目标的矛盾 |
720×544分辨率不高,极小目标(<16像素)特征不足 |
①配合长焦/微距镜头增大目标占比;②SAHI切片检测;③YOLOv8n-p2小目标优化模型;④高分辨率训练+低分辨率推理+切片;⑤如果分辨率实在不够,可考虑MV-MIPI-SC130M(1280×1024,同系列更高分辨率) |
|
黑白图像的局限 |
IMX287M是黑白传感器,无法利用颜色信息区分目标 |
①大多数工业检测和小目标检测不需要颜色,形状和纹理更重要;②黑白传感器光利用率高、噪声低,反而更适合小目标;③如果必须用颜色,可选同系列彩色版本或其他彩色全局快门传感器(如IMX296彩色版) |
|
树莓派算力有限 |
复杂模型和SAHI切片无法实时运行 |
①INT8量化(TFLite/NCNN);②降低输入分辨率;③抽帧检测+跟踪;④ROI检测;⑤多线程流水线;⑥两级检测策略;⑦如果需要更高算力,可升级到Jetson Orin Nano(40TOPS)或加Hailo-8 AI加速帽(26TOPS) |
|
高帧率采集与处理瓶颈 |
523fps采集但AI推理只有20fps,大量帧被丢弃 |
①不需要全程523fps,根据推理帧率设置采集帧率(如30fps);②硬触发模式只在需要时采集一帧;③高速场景用高帧率采集+抽帧推理,关键帧不丢失;④如果需要记录高速视频,单独用高速存储记录原始视频,AI异步分析 |
|
散热与稳定性 |
持续AI推理CPU温度高,可能降频或死机 |
①必须安装主动散热风扇;②金属外壳辅助散热;③设置温度阈值降频保护;④监控CPU温度,超过80℃自动降低推理帧率;⑤环境温度高时增加外部散热或降低负载 |
|
驱动兼容性 |
VEYE驱动需要匹配特定内核版本,系统升级后可能失效 |
①使用VEYE官方支持的Raspberry Pi OS版本;②系统升级前先备份驱动和配置;③关注VEYE官方GitHub更新;④锁定内核版本(apt-mark hold raspberrypi-kernel);⑤也可以用VEYE提供的预编译系统镜像 |
|
镜头选择与对焦 |
M12镜头种类多,选择不当导致目标模糊或视场不合适 |
①根据工作距离和目标大小计算所需焦距(焦距=工作距离×传感器尺寸/视场尺寸);②小目标检测优先选长焦/微距镜头增大目标占比;③固定安装后用锁定胶固定对焦环;④定期检查镜头是否脏污或移位 |
|
光照与曝光 |
短曝光下图像暗,高增益下噪声大 |
①增加主动光源(LED环形灯、同轴光、背光),工业检测推荐主动照明;②大像素传感器本身低照性能好;③合理设置曝光时间(在不产生运动模糊的前提下尽量长);④增益控制在6dB以内;⑤黑白传感器比彩色更适合低照 |
十、总结
本文介绍了一套基于树莓派5+MV-MIPI-IMX287M全局快门工业相机的嵌入式小目标检测完整方案。这套方案的核心优势在于:用不到2000元的硬件成本,实现了工业级的全局快门高速成像(720×544@523fps,6.9μm大像素)和边缘端实时AI推理(YOLOv8n INT8可达19-22fps),解决了小目标检测中"运动模糊、特征不足、算力受限"三大核心难题。
技术要点回顾:
1.硬件选型:MV-MIPI-IMX287M(索尼IMX287全局快门黑白传感器,720×544@523fps,6.9μm大像素,MIPI CSI-2接口,硬触发/软触发,闪光灯同步)+树莓派5 8GB(4核A76 2.4GHz,双MIPI接口,主动散热),整套成本约1500-2500元。
2.成像优势:全局快门消除高速运动目标的果冻效应和运动模糊,6.9μm大像素提供高灵敏度和低噪声,黑白传感器光利用率高,523fps超高速率捕捉瞬态过程,硬触发精确同步外部事件。
3.驱动与采集:VEYE官方V4L2驱动,标准/dev/video0设备节点,Python+OpenCV通过V4L2后端采集RAW8灰度帧,支持连续模式和硬触发模式,VEYE配置工具设置曝光/增益/ROI/帧率等参数。
4.小目标检测算法:YOLOv8n基线模型(P2检测头优化小目标),YOLOv8n-p2增强版(增加stride=4检测头),SAHI切片检测(高分辨率图像切重叠小块分别检测再合并),训练优化(Copy-Paste、Mosaic、高分辨率训练、小目标损失加权、精确标注)。
5.边缘推理部署:PyTorch→ONNX→TFLite/NCNN INT8量化,树莓派5上YOLOv8n INT8可达19-22fps(640输入),320输入可达55fps,多线程流水线、抽帧检测、ROI检测、CPU性能模式等优化进一步提升端到端性能。
6.系统集成:采集→预处理→推理→后处理→应用五模块架构,支持SAHI切片和两级检测,GPIO联动外部设备,数据记录(CSV/SQLite),Flask Web远程查看,报警触发。
适用场景与局限:这套方案特别适合工业微小缺陷检测、高速运动小目标跟踪、远距离小目标识别、微型物体计数等场景,以及教学科研和原型验证。它的局限在于:720×544分辨率对极小目标(<8像素)可能不够,黑白传感器无法利用颜色信息,树莓派算力对复杂模型和全程SAHI切片支持有限。如果需要更高分辨率,可以考虑同系列的MV-MIPI-SC130M(1280×1024@214fps);如果需要更强算力,可以升级到Jetson Orin Nano或加Hailo-8 AI加速帽。
小目标检测是计算机视觉领域的经典难题,没有银弹——需要从成像质量、算法优化、算力部署三个维度协同解决。MV-MIPI-IMX287M+树莓派这套方案提供了一个低成本、高性能的起点,让创客、研究者和中小企业都能快速搭建工业级小目标检测系统,在实践中迭代优化。随着AI模型越来越轻量高效、边缘算力越来越强,嵌入式小目标检测的应用场景会越来越广泛。


评论前必须登录!
注册