 网硕互联帮助中心
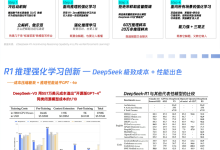
R1推理强化学习创新一DeepSeek极致成本+性能出色成本压缩极致+推理性能追平GPT-40
一DeepSeek极致成本性能出色成本压缩极致推理性能追平GPT-40
一DeepSeek极致成本性能出色成本压缩极致推理性能追平GPT-40
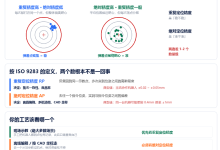
上篇拆了硬件 3.5万:减速器、控制柜、安全认证,都是参数表上能查到的东西。这篇说剩下的2.5万。这部分报价单上写得很模糊ÿ...
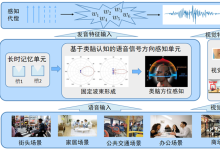
面向逻辑思维的程序设计方法——依托世界模型的类脑大模型反思创新子网设计 冯胤清 (河南 三门峡 472000)摘要:大...
195、大模型蒸馏与压缩:知识蒸馏与VLA模型轻量化 上周在调试一个7B参数的VLA模型部署到机械臂实机时,显存直接爆掉——16G的4090连前向推理都跑不动...
面向逻辑思维的程序设计方法——依托世界模型的类脑大模型感知理解子网设计 冯胤清 (河南 三门峡 472000)摘要:大...
强化学习(Reinforcement Learning, RL)是机器学习的一个分支,它让智能体在与环境交互的过程中通过试错学习最优策略。MuJoCo 凭借其高...
机器人开源代码: https://github.com/engineai-robotics/engineai_robotics_native_sd...
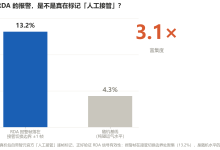
上周五还在说“数据质量检查没有趁手工具”的话,这周一智元就开源了 AGIBOT WORLD 2026 第三期——真机强化学习数据集。这是我等的机会...
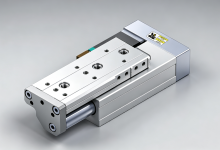
在3C电子制造、半导体封装、精密医疗器械组装等非标自动化产线中,微型滑台是实现微米级定位的核心“关节”。然而,许多工程师在产线调试初...
技术宅找活干:硬件安装、软件设计、方案、编程、画图、文档技术翻译、C1驾驶员……1️⃣若有居家办公的活,推荐给我哈(最...
