 网硕互联帮助中心
【随笔】推理准入控制:请求进来之前,先给KV缓存留出位置
KV缓存量化可以减少单个Token的存储成本,服务仍然需要决定同时接纳多少请求。十个短问答与十份长文档占用的资源完全不同;只限制HT...
KV缓存量化可以减少单个Token的存储成本,服务仍然需要决定同时接纳多少请求。十个短问答与十份长文档占用的资源完全不同;只限制HT...

从今天觉醒,技术赋予每一个人数字生命我造了个\"虚拟来访者\"陪咨询师练手,并用数据验证它演得像不像心理咨询新手的培训里有个绕不开的环节ÿ...
算桥 API 已公开上架 deepseek-v4.1-flash,模型页提供了调用接口和价格。需要注意:平台模型 ID 与 Deep...
我是AI时代的无业游民,我游荡在现实与意念之间当AI在数学中“失准”:一场关于形式化、直觉与工程取舍的深度复盘 背景与痛点 过去两年...
目录 模型监控概述性能指标异常检测日志记录告警体系监控平台实践建议与最佳实践 摘要 本文以 7B 参数大语言模型在线推理服务为例,构建一套覆盖...
目录 多模态训练概述 视觉编码器:ViT 与 CLIP 多模态对齐:对比学习与跨模态注意力 多模态融合:早期融合与晚期融合 多模态生成:文本到图像、图像到文本 ...
摘要 4.3 拆完上下文崩溃止于信息残留率 2% 的关键检测防患,但 Agent 成本层另有三类典型崩溃。本篇承接 4.3 末段预告「下一篇进入...
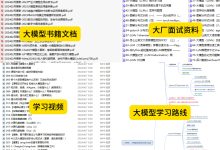
文件之文章目录, 其中第二条为给模型时间予以思考, 第三条讲述局限性, 第四条归纳五大优化策略, 还有三、基础结构, 底下第三条是总结, 四为技巧, 五是大语言...
Llama-3.2-3B部署案例:Ollama镜像在国产昇腾910B服务器上的适配与性能调优 1. 项目背景与价值 最近在国产昇腾910B服务...
Gemma-3-12B-IT开源大模型部署方案:23GB模型在32GB内存服务器实测 1. 引言:为什么选择Gemma-3-12B...