 网硕互联帮助中心
KV缓存量化可以减少单个Token的存储成本,服务仍然需要决定同时接纳多少请求。十个短问答与十份长文档占用的资源完全不同;只限制HTTP连接数,很难解释为什么相同并发有时顺畅、有时排队很久。今天把输入长度、输出预算和缓存容量放进同一本账,写一个可运行的准入模型,再区分它与推理引擎的调度参数。
一、先画出请求经过的三个位置
客户端提交请求后,网关先检查身份、长度和业务配额;通过检查的请求进入有上限的等待队列;获得资源预算后,才交给推理引擎执行。引擎内部继续安排Prefill和Decode。准入控制决定是否接纳工作,调度决定已接纳工作下一步执行什么。
等候不能无限增长。队列长度、等待期限和客户端取消都要有明确处理:排队到期则结束等待,用户取消则移除请求,服务过载则返回可识别的繁忙结果。否则队列只是把显存压力转成了不可见的延迟。
本文的资源模型面向单实例、纯文本、每请求一个生成序列。真实接入时,输入Token数应在聊天模板、系统提示和工具定义加入后计算,使用服务端实际Tokenizer。字符数不能直接当Token数。
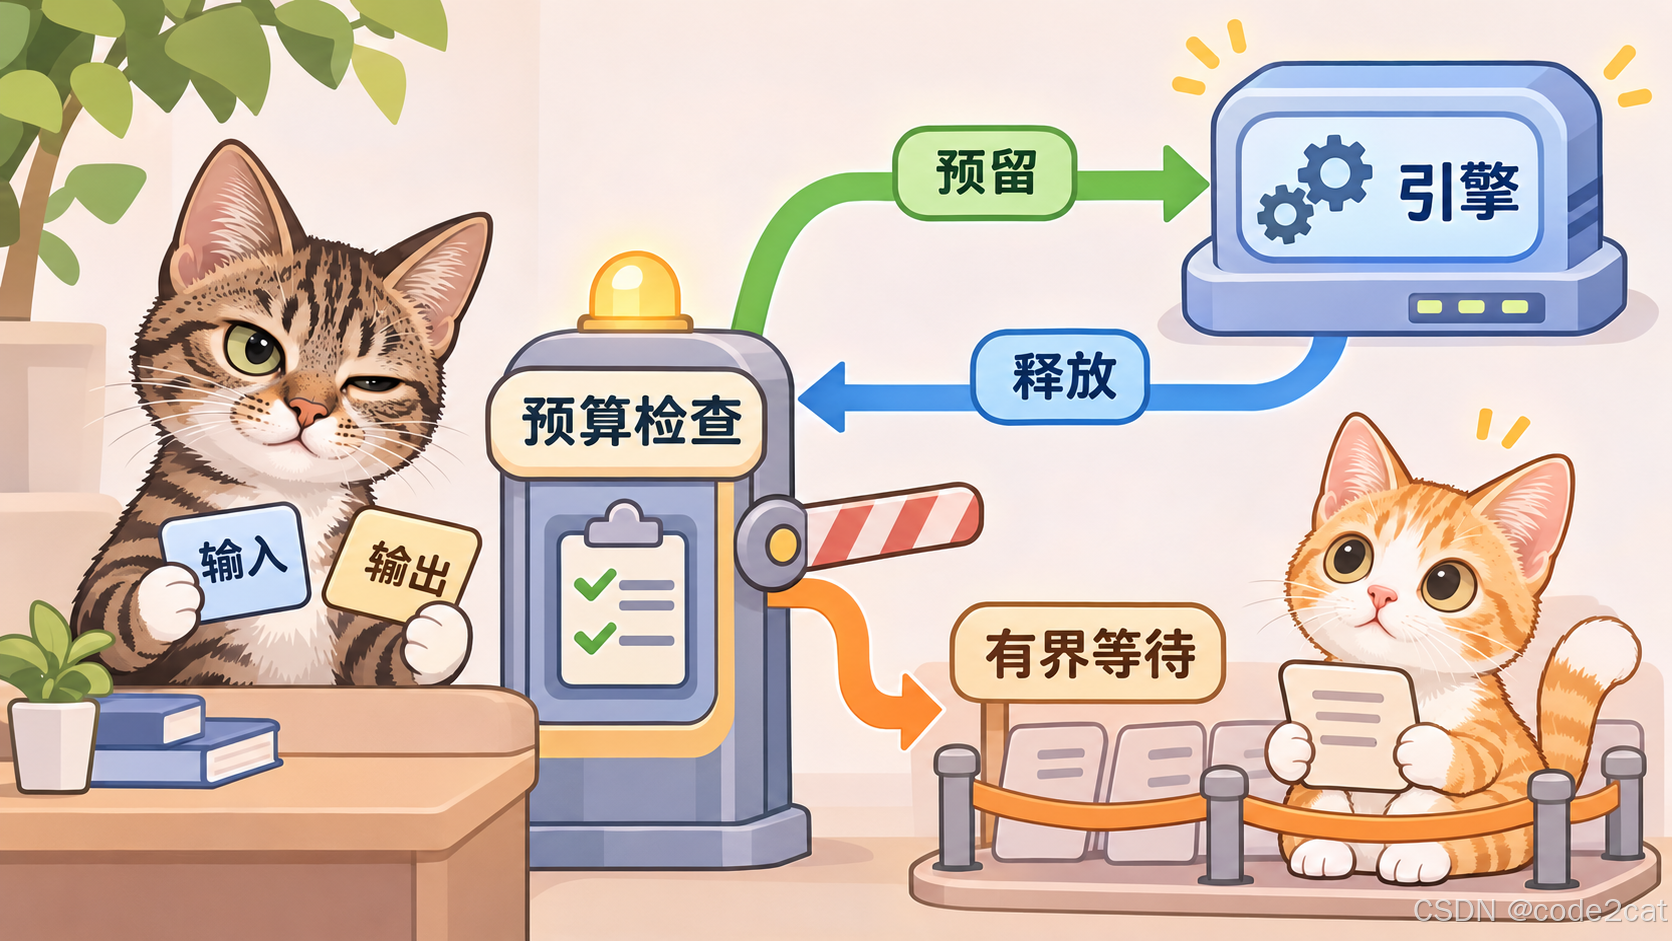
栗子检查输入与输出预算,小橘在有界队列等待。绿色路径获得预留后进入引擎,蓝色路径在执行结束后归还预算。
二、从Token数推导一个保守预算
对于每层使用相同KV头数、保存全部上下文的模型,单Token的KV载荷为:
2 × 层数 × KV头数 × 每个头的维度 × 每个元素字节数
2代表Key与Value。假设32层、8个KV头、头维度128、每元素2字节,得到131072字节,即128KiB/Token。输入1024Token,最多生成512Token,就为1536Token预留192MiB载荷。
这里的预算上限应来自可供请求使用的KV容量,先扣除权重、工作区和运行余量。不要拿显卡总显存直接代入。量化需要额外比例信息,滑动窗口与混合注意力模型也需要按实际缓存布局重新建账。
预留输入加最大输出是一种保守的网关策略。它会把尚未生成的Token也计入账面,因此利用率低于按实际增长动态分配的方案,但能减少请求运行到一半才发现预算不足的情况。下文在网关侧实现这个预算账本,引擎仍独立管理实际缓存分配。
缓存按块分配时,还要向上取整。若每块16Token,1500Token预留94块,而非93.75块。本例每块2MiB,1024MiB预算对应512块。
三、用完整代码验证接纳、等待与释放
下面代码只依赖Python 3标准库。为了把准入账本讲清,它按顺序模拟请求到达;实际服务需要让“检查与扣减”成为原子操作。
from dataclasses import dataclass
BLOCK_TOKENS = 16
CAPACITY = 512
MAX_CONTEXT = 8192
@dataclass(frozen=True)
class Request:
id: str
prompt: int
output: int
class Gate:
def __init__(self):
self.active = {}
@property
def free(self):
return CAPACITY – sum(self.active.values())
def admit(self, request):
if request.id in self.active:
return "duplicate"
if request.prompt < 1 or request.output < 1:
return "reject-invalid"
total = request.prompt + request.output
if total > MAX_CONTEXT:
return "reject-context"
blocks = (total + BLOCK_TOKENS – 1) // BLOCK_TOKENS
if blocks > CAPACITY:
return "reject-capacity"
if blocks > self.free:
return "wait"
self.active[request.id] = blocks
return "admit"
def release(self, request_id):
self.active.pop(request_id, None)
gate = Gate()
a = Request("A", 4096, 2048)
b = Request("B", 2048, 1024)
c = Request("C", 8000, 512)
for request in (a, b, c):
print(request.id, gate.admit(request), gate.free)
gate.release("A")
print("release A", gate.free)
print("B retry", gate.admit(b), gate.free)
print("B duplicate", gate.admit(b), gate.free)
gate.release("B")
gate.release("B")
print("release twice", gate.free)
实际运行输出:
A admit 128
B wait 128
C reject-context 128
release A 512
B retry admit 320
B duplicate duplicate 320
release twice 512
A预留384块,剩128块;B需要192块,所以等待。C总长8512,超过8192上下文限制,等待无法解决这个问题,因此直接拒绝。A释放后,B重试成功。重复请求不会再次扣减,重复释放也不会把空闲容量加到总容量之外。

A占用384块时,只剩128块,容纳不下需要192块的B;A释放后,B获得预算,空闲容量变为320块。
这份代码返回wait时不保存请求。接入时由外层有界队列管理等待、超时和公平性;当资源释放时,再重新检查队首请求。若要允许短请求绕过大请求,要同时设置大请求的最长等待约束,避免长期饥饿。
四、不要把三种上限当成同一个参数
以vLLM 0.11.0的参数语义为例,下面三个限制作用于不同范围:官方引擎参数。
| max-model-len | 单条序列的输入与输出总上下文长度 | 所有请求合起来能占多少缓存 |
| max-num-seqs | 一次迭代处理的序列数 | 网关等待队列的长度 |
| max-num-batched-tokens | 一次迭代处理的Token数 | 完整请求可用的总Token数 |
启用分块Prefill后,长输入可以跨多次迭代处理,因此单次迭代预算与请求总长度没有一一对应关系。把批次Token上限加大,也不会自动增加可用KV容量。
网关预算与引擎实际占用之间应建立反馈。初期使用保守预留,记录预算与实际峰值的差值;掌握业务输出分布后,再评估动态增长或分级预算。不能只降低账面预留,却不设计运行中扩容失败时的处理。
五、上线前必须补齐的资源生命周期
资源释放要对应引擎真正停止执行。客户端断开后,应先向引擎传播取消并确认终止,再释放网关账面预算。如果只在HTTP连接断开时释放,而推理还在继续,新请求会被错误接纳。
多个网关工作进程不能各自持有一份完整容量。必须由同一个资源所有者统一扣减,或把实例容量拆成互不重叠的配额。检查空闲和写入预留必须放在同一个临界区;跨进程则需要具有原子性的协调机制。
服务重启时也不能直接把账本清空并宣布全部空闲。对仍在运行的引擎请求进行对账,或者让引擎生命周期与账本统一重建。日志至少记录请求ID、输入长度、输出上限、预留块、接纳时间、结束原因及释放时间。
验收时分别观察拒绝率、等待时长、首Token延迟、逐Token延迟和实际缓存峰值。使用相同请求集合比较策略,包含短问答、长文档和长输出;额外测试取消、超时、重复回调和实例重启。
六、🧠 思维导图
#mermaid-svg-X7lmRYKiCM3fUUbb{font-family:\”trebuchet ms\”,verdana,arial,sans-serif;font-size:16px;fill:#333;}@keyframes edge-animation-frame{from{stroke-dashoffset:0;}}@keyframes dash{to{stroke-dashoffset:0;}}#mermaid-svg-X7lmRYKiCM3fUUbb .edge-animation-slow{stroke-dasharray:9,5!important;stroke-dashoffset:900;animation:dash 50s linear infinite;stroke-linecap:round;}#mermaid-svg-X7lmRYKiCM3fUUbb .edge-animation-fast{stroke-dasharray:9,5!important;stroke-dashoffset:900;animation:dash 20s linear infinite;stroke-linecap:round;}#mermaid-svg-X7lmRYKiCM3fUUbb .error-icon{fill:#552222;}#mermaid-svg-X7lmRYKiCM3fUUbb .error-text{fill:#552222;stroke:#552222;}#mermaid-svg-X7lmRYKiCM3fUUbb .edge-thickness-normal{stroke-width:1px;}#mermaid-svg-X7lmRYKiCM3fUUbb .edge-thickness-thick{stroke-width:3.5px;}#mermaid-svg-X7lmRYKiCM3fUUbb .edge-pattern-solid{stroke-dasharray:0;}#mermaid-svg-X7lmRYKiCM3fUUbb .edge-thickness-invisible{stroke-width:0;fill:none;}#mermaid-svg-X7lmRYKiCM3fUUbb .edge-pattern-dashed{stroke-dasharray:3;}#mermaid-svg-X7lmRYKiCM3fUUbb .edge-pattern-dotted{stroke-dasharray:2;}#mermaid-svg-X7lmRYKiCM3fUUbb .marker{fill:#333333;stroke:#333333;}#mermaid-svg-X7lmRYKiCM3fUUbb .marker.cross{stroke:#333333;}#mermaid-svg-X7lmRYKiCM3fUUbb svg{font-family:\”trebuchet ms\”,verdana,arial,sans-serif;font-size:16px;}#mermaid-svg-X7lmRYKiCM3fUUbb p{margin:0;}#mermaid-svg-X7lmRYKiCM3fUUbb .label{font-family:\”trebuchet ms\”,verdana,arial,sans-serif;color:#333;}#mermaid-svg-X7lmRYKiCM3fUUbb .cluster-label text{fill:#333;}#mermaid-svg-X7lmRYKiCM3fUUbb .cluster-label span{color:#333;}#mermaid-svg-X7lmRYKiCM3fUUbb .cluster-label span p{background-color:transparent;}#mermaid-svg-X7lmRYKiCM3fUUbb .label text,#mermaid-svg-X7lmRYKiCM3fUUbb span{fill:#333;color:#333;}#mermaid-svg-X7lmRYKiCM3fUUbb .node rect,#mermaid-svg-X7lmRYKiCM3fUUbb .node circle,#mermaid-svg-X7lmRYKiCM3fUUbb .node ellipse,#mermaid-svg-X7lmRYKiCM3fUUbb .node polygon,#mermaid-svg-X7lmRYKiCM3fUUbb .node path{fill:#ECECFF;stroke:#9370DB;stroke-width:1px;}#mermaid-svg-X7lmRYKiCM3fUUbb .rough-node .label text,#mermaid-svg-X7lmRYKiCM3fUUbb .node .label text,#mermaid-svg-X7lmRYKiCM3fUUbb .image-shape .label,#mermaid-svg-X7lmRYKiCM3fUUbb .icon-shape .label{text-anchor:middle;}#mermaid-svg-X7lmRYKiCM3fUUbb .node .katex path{fill:#000;stroke:#000;stroke-width:1px;}#mermaid-svg-X7lmRYKiCM3fUUbb .rough-node .label,#mermaid-svg-X7lmRYKiCM3fUUbb .node .label,#mermaid-svg-X7lmRYKiCM3fUUbb .image-shape .label,#mermaid-svg-X7lmRYKiCM3fUUbb .icon-shape .label{text-align:center;}#mermaid-svg-X7lmRYKiCM3fUUbb .node.clickable{cursor:pointer;}#mermaid-svg-X7lmRYKiCM3fUUbb .root .anchor path{fill:#333333!important;stroke-width:0;stroke:#333333;}#mermaid-svg-X7lmRYKiCM3fUUbb .arrowheadPath{fill:#333333;}#mermaid-svg-X7lmRYKiCM3fUUbb .edgePath .path{stroke:#333333;stroke-width:2.0px;}#mermaid-svg-X7lmRYKiCM3fUUbb .flowchart-link{stroke:#333333;fill:none;}#mermaid-svg-X7lmRYKiCM3fUUbb .edgeLabel{background-color:rgba(232,232,232, 0.8);text-align:center;}#mermaid-svg-X7lmRYKiCM3fUUbb .edgeLabel p{background-color:rgba(232,232,232, 0.8);}#mermaid-svg-X7lmRYKiCM3fUUbb .edgeLabel rect{opacity:0.5;background-color:rgba(232,232,232, 0.8);fill:rgba(232,232,232, 0.8);}#mermaid-svg-X7lmRYKiCM3fUUbb .labelBkg{background-color:rgba(232, 232, 232, 0.5);}#mermaid-svg-X7lmRYKiCM3fUUbb .cluster rect{fill:#ffffde;stroke:#aaaa33;stroke-width:1px;}#mermaid-svg-X7lmRYKiCM3fUUbb .cluster text{fill:#333;}#mermaid-svg-X7lmRYKiCM3fUUbb .cluster span{color:#333;}#mermaid-svg-X7lmRYKiCM3fUUbb div.mermaidTooltip{position:absolute;text-align:center;max-width:200px;padding:2px;font-family:\”trebuchet ms\”,verdana,arial,sans-serif;font-size:12px;background:hsl(80, 100%, 96.2745098039%);border:1px solid #aaaa33;border-radius:2px;pointer-events:none;z-index:100;}#mermaid-svg-X7lmRYKiCM3fUUbb .flowchartTitleText{text-anchor:middle;font-size:18px;fill:#333;}#mermaid-svg-X7lmRYKiCM3fUUbb rect.text{fill:none;stroke-width:0;}#mermaid-svg-X7lmRYKiCM3fUUbb .icon-shape,#mermaid-svg-X7lmRYKiCM3fUUbb .image-shape{background-color:rgba(232,232,232, 0.8);text-align:center;}#mermaid-svg-X7lmRYKiCM3fUUbb .icon-shape p,#mermaid-svg-X7lmRYKiCM3fUUbb .image-shape p{background-color:rgba(232,232,232, 0.8);padding:2px;}#mermaid-svg-X7lmRYKiCM3fUUbb .icon-shape .label rect,#mermaid-svg-X7lmRYKiCM3fUUbb .image-shape .label rect{opacity:0.5;background-color:rgba(232,232,232, 0.8);fill:rgba(232,232,232, 0.8);}#mermaid-svg-X7lmRYKiCM3fUUbb .label-icon{display:inline-block;height:1em;overflow:visible;vertical-align:-0.125em;}#mermaid-svg-X7lmRYKiCM3fUUbb .node .label-icon path{fill:currentColor;stroke:revert;stroke-width:revert;}#mermaid-svg-X7lmRYKiCM3fUUbb :root{–mermaid-font-family:\”trebuchet ms\”,verdana,arial,sans-serif;}
推理准入控制
长度检查
输入与输出预算
上下文上限
资源账本
分块取整
原子预留
生命周期
有界等待
取消与释放
指标与对账
七、总结
总结要点
准入预算把请求长度转成资源需求。先检查单请求能否成立,再检查当前容量能否容纳;超长请求与暂时拥塞要采取不同处理。
资源生命周期决定账本是否可信。原子扣减、幂等释放、取消确认和重启对账,缺少任何一环都可能让容量数字脱离实际执行状态。引擎调度参数需要单独理解和测量。
下一篇讨论结构化输出,看看推理服务怎样让生成结果符合JSON结构,同时检查业务含义。
👉 如果你觉得这篇文章对你有所帮助,欢迎点赞、收藏、分享!😊



评论前必须登录!
注册