 网硕互联帮助中心
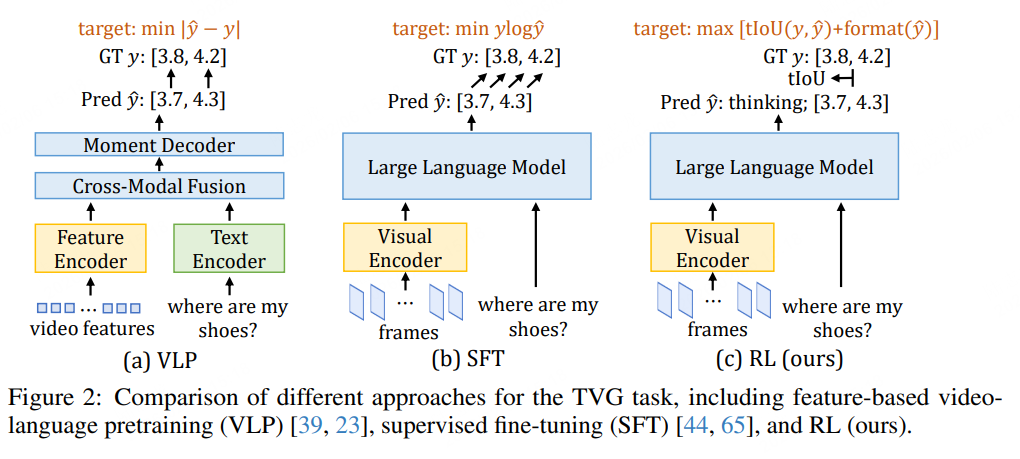
文章核心总结与创新点
主要内容
该研究聚焦长视频理解中的核心任务——时间视频定位(TVG),即根据自然语言查询定位视频中特定片段。针对现有大型视觉语言模型(LVLMs)在TVG任务中因监督微调(SFT)过惩罚合理预测导致泛化能力不足的问题,提出了基于强化学习(RL)的后训练框架Time-R1,配套设计了数据高效的微调策略TimeRFT和专用基准测试集TVGBench,最终在多个数据集上实现了最先进(SoTA)性能,同时提升了模型在长短视频问答任务中的通用理解能力。
该研究聚焦长视频理解中的核心任务——时间视频定位(TVG),即根据自然语言查询定位视频中特定片段。针对现有大型视觉语言模型(LVLMs)在TVG任务中因监督微调(SFT)过惩罚合理预测导致泛化能力不足的问题,提出了基于强化学习(RL)的后训练框架Time-R1,配套设计了数据高效的微调策略TimeRFT和专用基准测试集TVGBench,最终在多个数据集上实现了最先进(SoTA)性能,同时提升了模型在长短视频问答任务中的通用理解能力。
 AI 新闻日报 2026-09-26:微软 Copilot 拆三区、Docker 云沙箱、具身数采转向众包
 从工程落地看 GEO:一个东莞制造品牌的 AI 可见度优化复盘
 Mathematical Computation and Reasoning Errors by Large Language Models【一文看懂】从 i²=-1 到 I²=-N:程序员用 Python 看懂“螺旋生成论”,顺便打通数学、AI 与量子计算τ–η 离散场 · 第三卷Describe What You See with Multimodal Large Language Models to Enhance Video RecommendationsShader 编译耗时与运行时变体预热流水线:消除进图卡顿
 LLM 和 Jev 到底有什么区别?为什么这个“不说话的AI“突然爆火?

评论前必须登录!
注册