 网硕互联帮助中心
一、HTTP 协议概述
虽然我们说,应用层协议是程序员自己定的,但实际上,早就已经有前辈们定义好了一些现成的、非常好用的应用层协议,供我们直接参考使用,HTTP(超文本传输协议)就是其中之一。
在互联网世界中,HTTP(HyperText Transfer Protocol,超文本传输协议)是一个至关重要的协议。它定义了客户端(如浏览器)与服务器之间如何通信,从而交换或传输超文本(如 HTML 文档)。
HTTP 协议是客户端与服务器之间通信的基础。客户端通过 HTTP 协议向服务器发送请求,服务器收到请求后进行处理并返回响应。HTTP 协议是一个无连接、无状态的协议,即每次请求都需要建立新的连接,且服务器不会保存客户端的状态信息。
二、什么是 URL
我们平时俗称的"网址",其实就是 URL。
要在全网内访问某个唯一的进程,需要知道该进程所在服务器的 IP 地址和端口号(port)。URL 就是用来描述这个地址的。
URL 的一般格式如下:
协议://主机[:端口]/路径[?查询参数][#片段]
以 https://leetcode.cn/problems/two-sum/description/ 为例,各部分含义如下:
| 协议(Scheme) | https | 告诉浏览器/系统:用 HTTPS 协议来访问 |
| :// | 固定分隔符 | 协议和后面部分的分隔标记 |
| 主机(Host) | leetcode.cn | 服务器域名,通过 DNS 解析成 IP |
| 路径(Path) | /problems/two-sum/description/ | 服务器上的资源路径 |
| 端口 | 省略(默认 443) | HTTPS 默认端口,不用显式写出 |
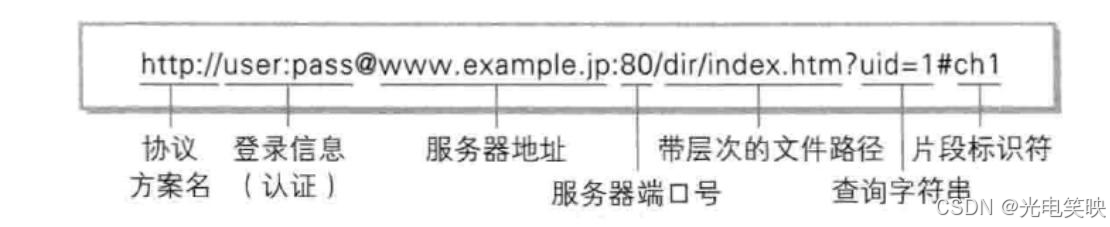
访问服务的完整流程就是:域名 → DNS 解析 → IP → TCP 连接 → 访问。 域名是给人记的,IP 是给机器用的,DNS 负责把域名翻译成 IP。拿到 IP + 端口,就能连上服务器,访问它提供的服务。 这是所有网络访问的基本流程。
具体来说,访问网络服务时,浏览器会先查本地缓存(浏览器缓存、系统缓存、hosts 文件),都没有命中才去问 DNS 服务器;DNS 逐级查询,把域名翻译成 IP 返回给浏览器;浏览器再拿这个 IP 建立 TCP 连接、访问服务器。
简单总结一句话:域名就相当于 IP 地址。
那么知道了 IP,还要知道端口号才能访问服务器,端口在哪里呢?其实成熟的协议端口是固定的——浏览器知道我们用的是 HTTPS 协议,就用 443 端口;用的是 HTTP 协议,就用 80 端口。
既然协议(Scheme)和主机(Host)已经能够定位到服务器进程了,那么后面的字段,就是资源路径了。说到底,我们进行 URL 通信,本质上就是 socket 通信。
三、什么是资源:静态资源与动态资源
在上网时,事实上只有两种行为(从通信角度看就是 I/O):
- 从远端获取资源
- 把本地资源上传到远端
这里的"资源",就是我们访问的短视频、图片、音频等。这些资源都以文件的形式存放在远端服务器里。例如 /problems/two-sum/description/ 其实就是 Linux 路径下的一个文件。
因此,HTTP(S) + 域名 + 路径,代表了全网内唯一的文件。
URL 的本质,就是用来在全网中特定主机、特定服务器的特定路径下定位一个文件,然后通过该协议把它返回给用户——这,就是 HTTP 协议的核心工作:用来传输文件。
静态资源
服务器上真实存在的文件,内容固定,不随参数变化。
https://leetcode.cn/static/logo.png
└──┬──┘
真实文件
| 对应磁盘文件 | /var/www/static/logo.png |
| 内容固定 | 谁访问都一样 |
| 不执行程序 | 直接读文件返回 |
| 典型 | 图片、CSS、JS、视频、HTML |
访问 logo.png 时,服务器直接把这个文件的内容发给你。
动态资源
服务器不返回固定文件,而是根据请求参数,执行程序,动态生成内容。
https://cn.bing.com/search?q=hello
└─┬─┘
动态参数
| 不对应固定文件 | 没有 search?q=hello 这个文件 |
| 内容动态生成 | 后端程序查数据库、计算、拼 HTML |
| 参数驱动 | 不同 q,返回不同结果 |
| 典型 | 搜索、登录、购物车、API |
搜 “hello” 和搜 “world”,服务器返回的页面完全不同——因为后端程序根据 q 参数动态生成了内容。
静态资源与动态资源的对比
| 对应文件 | 真实文件 | 由程序生成 |
| 内容 | 固定 | 随参数变化 |
| 服务器行为 | 读文件,返回 | 执行程序,生成,返回 |
| URL 特征 | 路径清晰,无参数 | 常带 ?key=value |
| 例子 | 图片、CSS、JS | 搜索、登录、API |
| 速度 | 快(直接读文件) | 慢(要执行程序) |
访问链路
静态资源的访问链路:
浏览器:GET /static/logo.png
↓
服务器:读 /var/www/static/logo.png
↓
返回文件内容
动态资源的访问链路:
浏览器:GET /search?q=hello
↓
服务器:执行搜索程序
├─ 解析 q=hello
├─ 查数据库
├─ 生成 HTML
└─ 返回结果
一句话总结:静态资源是"文件里现成的",动态资源是"程序里现算的"。 只要返回的数据包含了"根据用户输入实时计算或查询"的过程,它就是动态资源。
这种基于"浏览器 + 服务器"的模式,我们称之为浏览器/服务器模式,也就是 B/S 模式。
四、urlencode 与 urldecode
像 /、?、: 这样的字符,已经被 URL 当作有特殊意义的字符理解了,因此这些字符不能随意出现在 URL 中。比如,某个参数中需要带有这些特殊字符时,就必须先对特殊字符进行转义。
转义的规则如下:将需要转码的字符转为十六进制,然后从右到左取 4 位(不足 4 位直接处理),每 2 位组成一个字节,前面加上 %,编码成 %XY 格式。urldecode 就是 urlencode 的逆过程。
例如,当我们用 Microsoft Edge 搜索 hello://@ world 时,上面的 URL 就变成了:
https://cn.bing.com/search?q=hello%3A%2F%2F%40+world&form=ANNTH1&refig=…
└──────────┬──────────┘└────┬────┘
q=hello://@ world form=ANNTH1
(查询参数) (其他参数)
各部分含义:
| ? | 查询参数起始标记 |
| q=hello://@ world | key=value,搜索关键词 |
| & | 参数分隔符 |
| form=ANNTH1 | 来源标识 |
| refig=… | 会话/追踪 ID |
我们发现,这些参数都是 key=value 的形式,多个参数用 & 隔开。其实这就是向搜索引擎提交搜索条件时携带的参数,可以用来实现动态交互式网站(上面的 leetcode 就是静态资源)。
?key=value&key=value 就是向服务器提交参数的格式。
回到上面的例子:我们搜索的是 hello://@ world,但参数却变成了 hello%3A%2F%2F%40+world,这是因为 :、/、@ 这些字符在 URL 中都有特殊用途,如果直接出现,就会导致 URL 解析失败——就像我们建文件夹时不能以 / 开头一样。所以发起请求时,客户端(一般是浏览器)会自动对特殊字符进行编码,这就是 urlencode;交给服务器后,服务器再自行解码,这就是 urldecode。
五、HTTP 请求报文格式
HTTP 请求及请求报文头格式如下: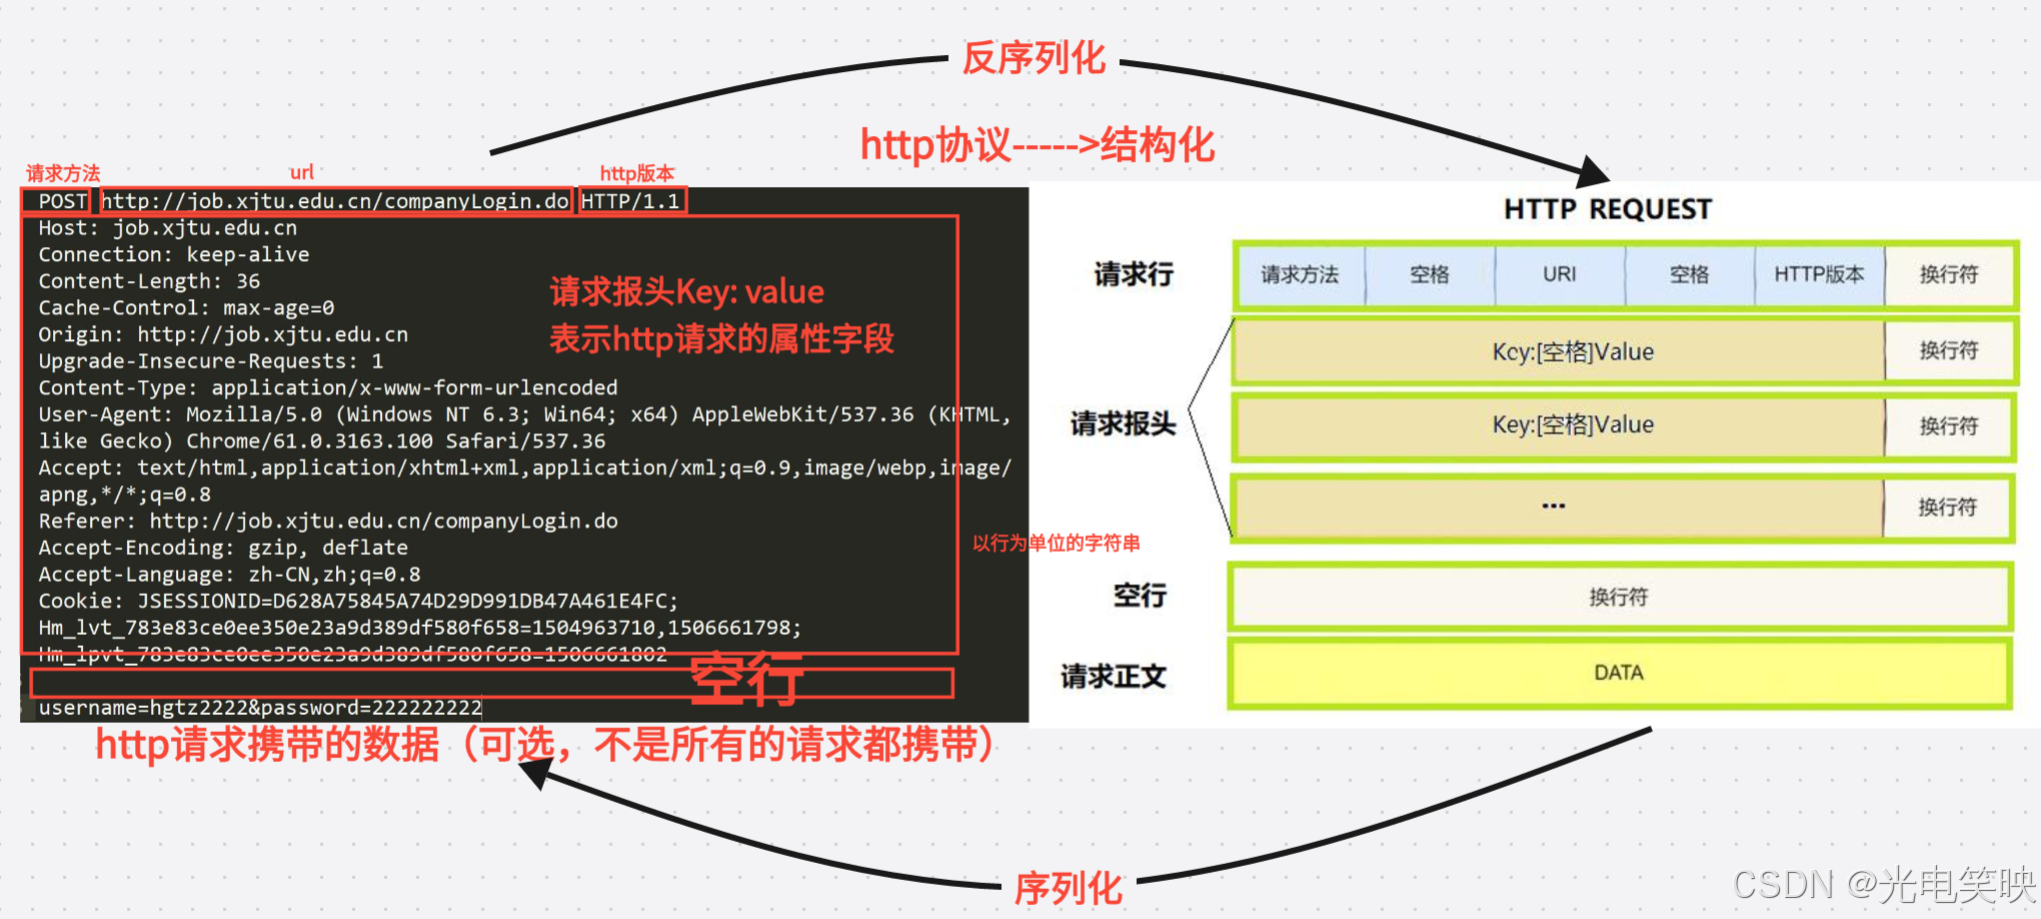 字段如下:
一、请求行
请求行是 HTTP 请求的第一行,包含三个部分,用空格分隔:
| 请求方法 | 最常用的是 GET 和 POST。GET 表示获取资源(也能上传资源),POST 表示上传资源。 |
| URI | 资源的路径。服务器会根据路径找到并读取资源,返回给客户端。 |
| HTTP 版本 | 客户端在请求中携带自身支持的 HTTP 版本,服务器据此为客户端提供对应版本的服务。 |
格式:
GET /index.html HTTP/1.1
└─┬─┘└─────┬─────┘└──┬──┘
请求方法 URI 版本
二、头部字段
以 key: value 的形式,传输各个属性信息:
Host: www.example.com
User-Agent: Chrome/120
Content-Type: application/json
Content-Length: 25
| Host | 目标主机 |
| User-Agent | 客户端信息 |
| Content-Type | 正文类型 |
| Content-Length | 正文长度 |
三、空行
空行把报头与有效载荷(正文)分开。
- 空行以上:报头(请求行 + 头部字段)
- 空行以下:有效载荷(请求正文)
四、请求正文
本质是一个长字符串(可以是 JSON 格式)。该部分可有可无:
| GET | 通常没有 |
| POST | 通常有 |
五、完整结构
请求行\\r\\n
头部字段1: value1\\r\\n
头部字段2: value2\\r\\n
\\r\\n ← 空行
请求正文 ← 可有可无
| 请求行 | 方法 + URI + 版本 |
| 头部字段 | key: value |
| 空行 | 分隔报头和正文 |
| 请求正文 | 长字符串(JSON 等) |
| 序列化/反序列化 | HTTP 通过特殊字符(如 \\r\\n、空格)进行字段拼接,不依赖任何第三方库 |
| 底层协议 | HTTP 基于 TCP 协议 |
HTTP 是纯文本协议,靠约定好的分隔符(\\r\\n、空格)来解析,不需要 JSON 库、protobuf 库。
总结一下:HTTP 请求 = 请求行(方法 + URI + 版本)+ 头部字段(key: value)+ 空行(分隔)+ 请求正文(可有可无)。它靠 \\r\\n 和空格拼接字段,不依赖第三方库,基于 TCP 传输。
几个关键问题的理解
1. HTTP 是如何做到报头和有效载荷分离的?
以空行为分隔符进行解析。
2. HTTP 协议如何理解?
采用特殊字符来区分不同的区域。
3. HTTP 协议的序列化和反序列化体现在哪里?
首先肯定会有一个类,这个类里面包含请求方法、URL、HTTP 版本、kv、请求正文这些成员;其次,我们可以把 HTTP 请求当成一个非常大的字符串——一行一行的字符串,将来可以一个一个地提取出来(反序列化),或者把对象按格式拼接成字符串(序列化)。
六、HTTP 应答报文格式
HTTP 应答格式如下: 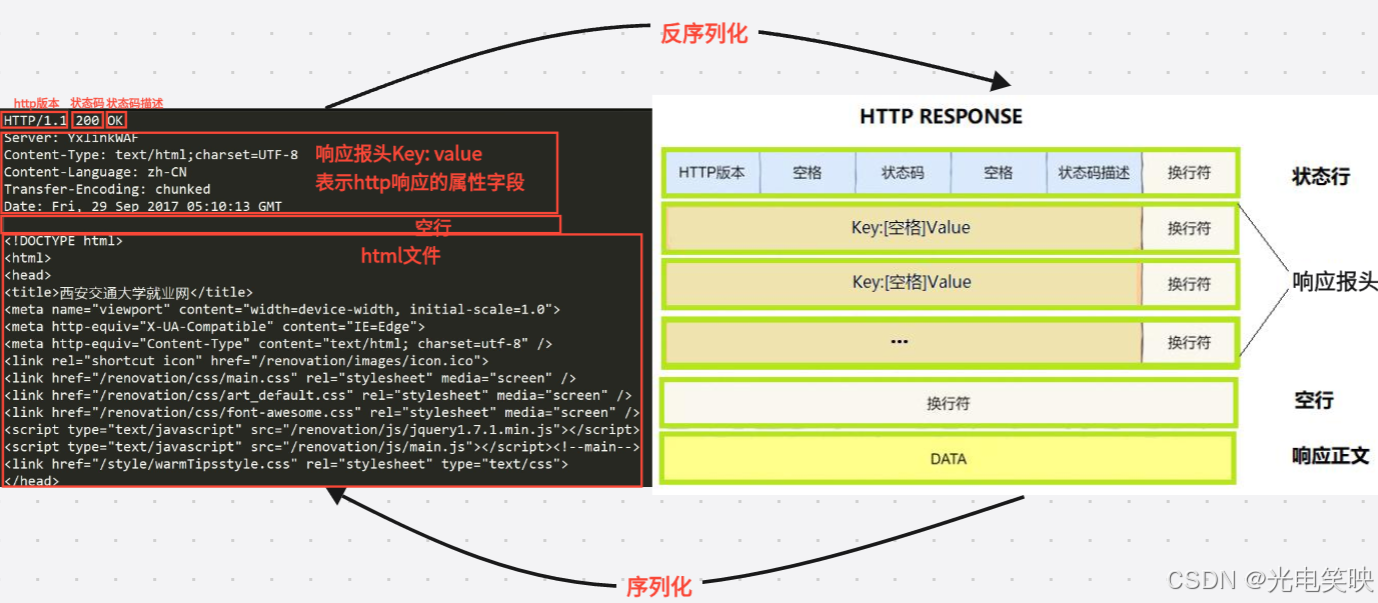
HTTP 响应报文由四部分组成:
状态行\\r\\n
响应头部字段\\r\\n
\\r\\n
响应正文
一、状态行
HTTP/1.1 200 OK
└──┬──┘ └┬┘ └┬┘
版本 状态码 状态码描述
| HTTP 版本 | 如 HTTP/1.1 |
| 状态码 | 3 位数字,如 200、404、500 |
| 状态码描述 | 如 OK、Not Found |
二、响应头部字段
以 Key: value 形式,描述响应的属性:
Content-Type: text/html
Content-Length: 1024
Server: nginx
Set-Cookie: session=abc
| Content-Type | 正文类型 |
| Content-Length | 正文长度 |
| Server | 服务器软件 |
| Set-Cookie | 设置 Cookie |
| Location | 重定向地址 |
三、空行
空行把报头与正文分开。
- 空行以上:状态行 + 响应头部
- 空行以下:响应正文
四、响应正文
服务器返回的实际内容,可以是 HTML、JSON、图片等。可有可无(如 204 无内容)。
五、完整示例
HTTP/1.1 200 OK\\r\\n
Content-Type: text/html\\r\\n
Content-Length: 25\\r\\n
Server: nginx\\r\\n
\\r\\n
hello world
| 状态行 | HTTP/1.1 200 OK |
| 响应头部 | Content-Type、Content-Length、Server |
| 空行 | 分隔 |
| 响应正文 | hello world |
六、常见状态码
状态码就是"结果是否有效"的标记。 网络计算器的 code 和 HTTP 的状态码,本质是一样的——结果可能无效(如除零),必须用独立的状态码区分"正常结果"和"异常情况"。 如果只返回结果,调用方就无法判断结果是否可信。结果 + 状态码分离,是可靠通信的基本设计。
| 200 | OK,成功 |
| 301/302 | 重定向 |
| 404 | Not Found,资源不存在 |
| 500 | Internal Server Error,服务器内部错误 |
七、短连接 vs 长连接
短连接:客户端和服务器每进行一次通信,就建立一次 TCP 连接,请求响应完成后立即断开。每次都要重新进行三次握手、四次挥手,开销大,适合低频请求。典型如 HTTP/1.0。
长连接:建立一次 TCP 连接后,多次请求响应都复用这条连接,直到一方主动关闭。省去反复握手、挥手的开销,适合高频交互。典型如 HTTP/1.1 的 keep-alive、聊天室、数据库连接。
八、编写 HTTP 请求的代码 —— 验证 HTTP 请求
之前把 HTML 硬编码进服务器程序,只是测试用的临时方案,并不是真正的做法。
resp._text =
"\\r\\n"
"…Hello World…
1. 请求如何表示要访问什么资源?
答案在请求行的 URI 里:
GET /a/b/c.html HTTP/1.1
└─────┬─────┘
URI
| GET | 请求方法 |
| /a/b/c.html | URI,表示要访问的资源路径 |
| HTTP/1.1 | 版本 |
客户端通过 URI 告诉服务器:“我要这个资源。”
2. 服务器怎么知道资源在哪?
URL 路径会映射到服务器文件系统的路径。
URL: /a/b/c.html
↓
服务器: web根目录/a/b/c.html
URL 路径的第一个 /,代表 web 根目录。
https://example.com/a/b/c.html
└────┬────┘
│
相对于 web 根目录
│
▼
/var/www/html/a/b/c.html
3. / 请求的是什么?
从日志看:
GET / HTTP/1.1
| / | 请求 web 根目录 |
| 方法 | GET |
/ 不能直接返回根目录下的所有文件,而是会自动拼接一个首页:
web根目录/index.html
| index.html | 最常见的首页 |
| index.htm | 另一种写法 |
GET / 实际请求的是 web根目录/index.html。
4. 什么是 web 根目录?
web 根目录就是项目中定义的一个文件夹,用来存放网页资源。
项目目录/
├── www/ ← web 根目录
│ ├── index.html ← 首页
│ ├── a/
│ │ └── b/
│ │ └── c.html
│ └── images/
│ └── logo.png
└── server ← 服务器程序
| GET / | wwwroot/index.html |
| GET /a/b/c.html | wwwroot/a/b/c.html |
| GET /images/logo.png | www/images/logo.png |
网页必须是服务器特定路径下的文件。 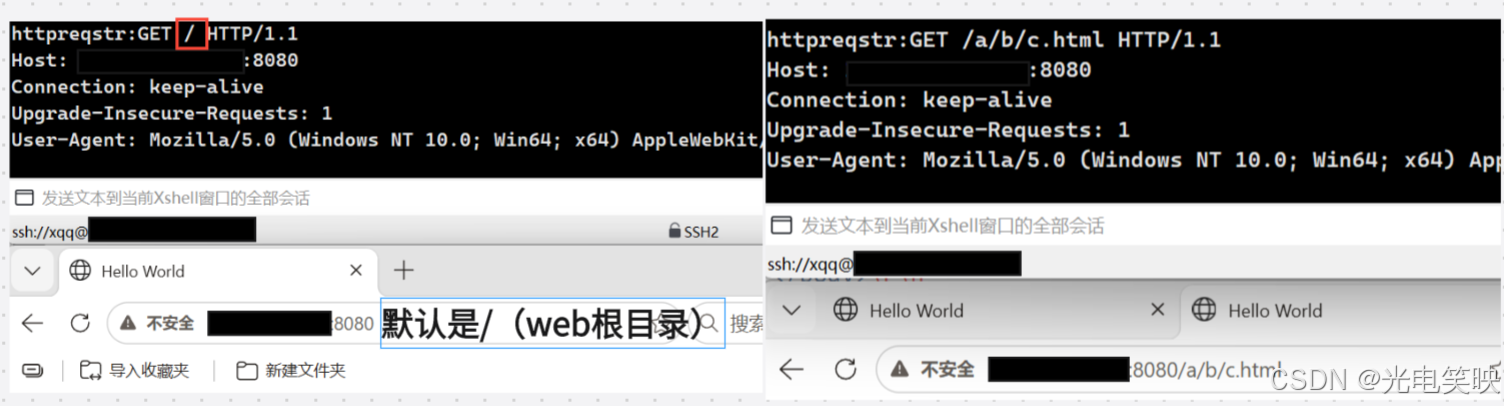
5. 完整链路
浏览器请求 GET /a/b/c.html
↓
服务器提取 URI:/a/b/c.html
↓
拼接 web 根目录:www/a/b/c.html
↓
检查文件是否存在
├─ 存在 → 200 + 文件内容
└─ 不存在 → 404
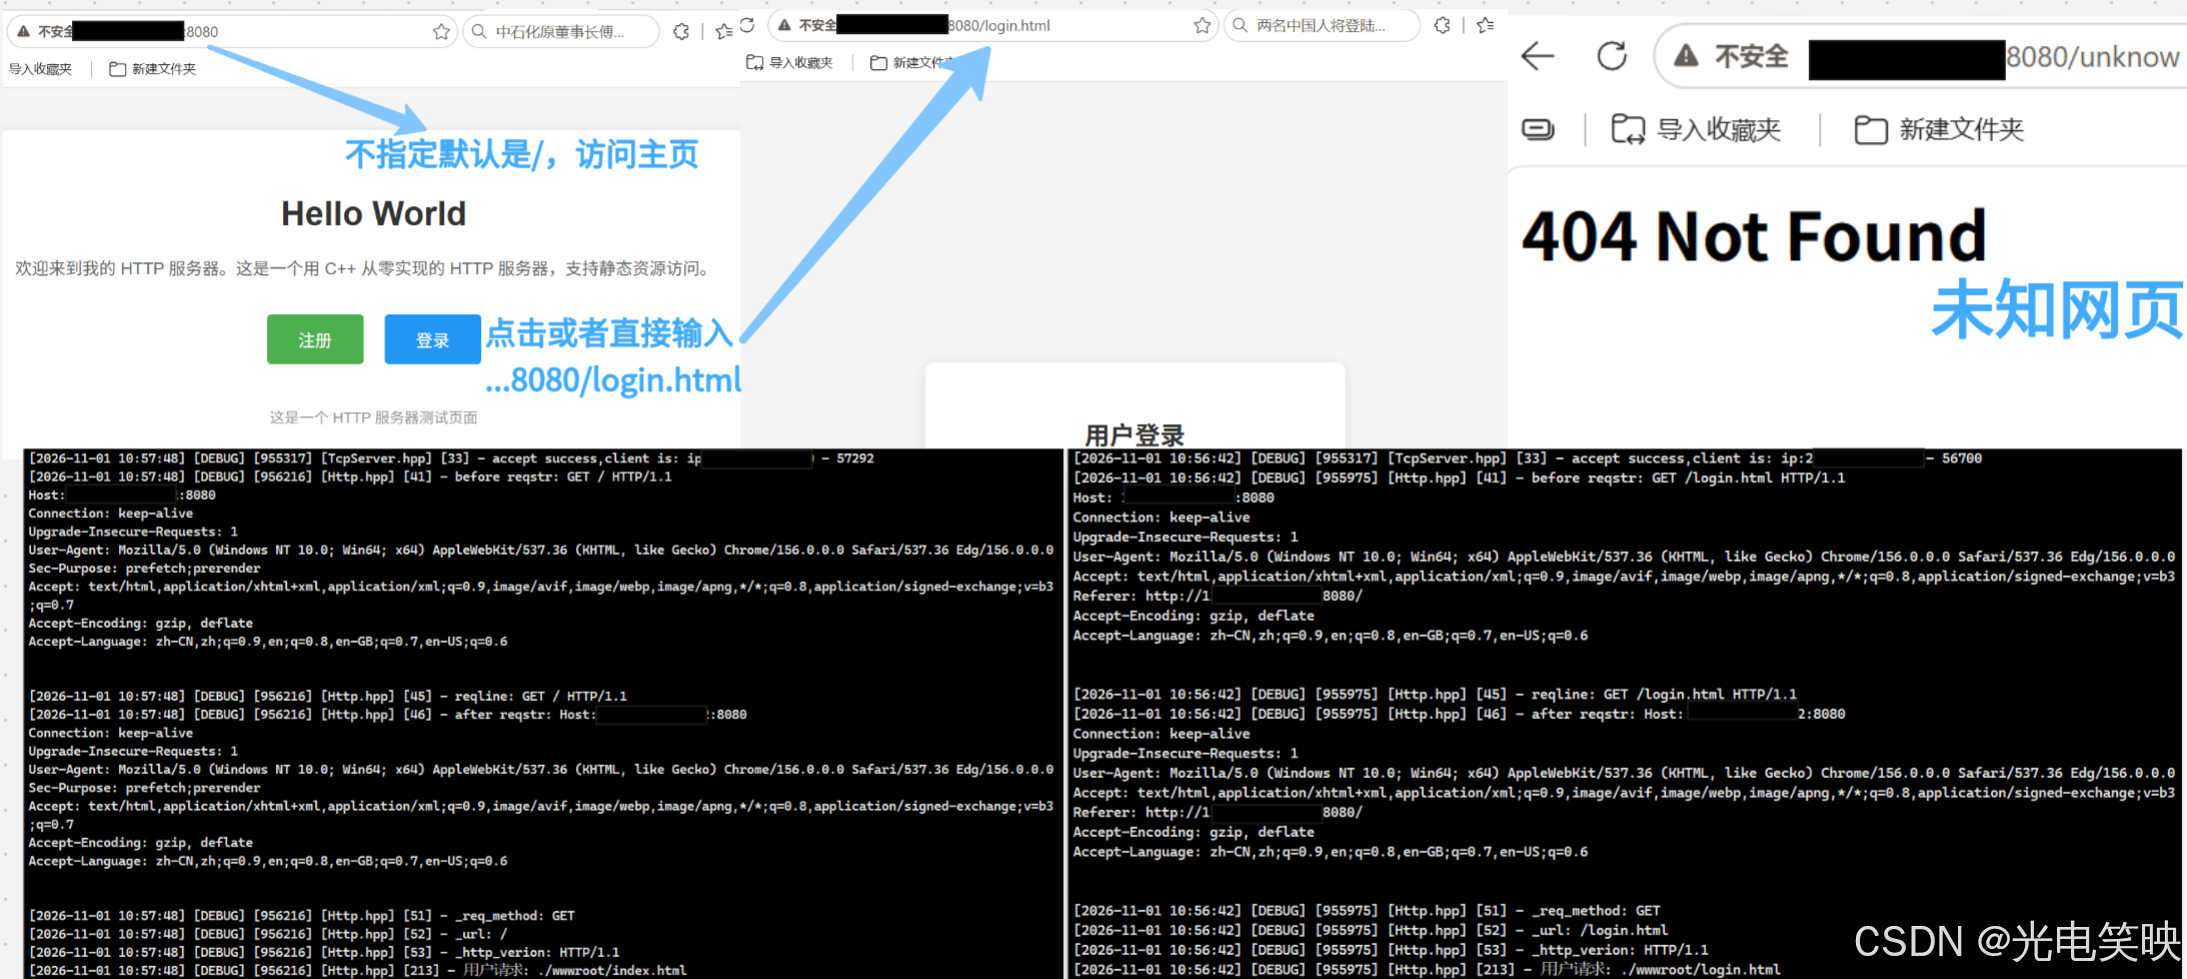
所以 HTTP 的本质,就是请求代码中 ./wwwroot(web 根目录)目录下特定路径的特定文件,而 URI 就是我们要找的文件路径。
为什么 request 和 response 报头里都有 HTTP 版本字段?
请求版本是客户端声明"我用的哪个版本",响应版本是服务器确认"我也用这个版本"。 双方都声明,才能协商版本、正确解析、处理不兼容。这是协议协商的基本机制——先确认"用什么规则",再按规则通信。(新老版本的服务器和客户端并存是很常见的。)
HandHttpRequest 是 HTTP 服务器处理单个连接的核心入口函数,负责从"收到字节流"到"返回 HTTP 响应"的完整流程。
// 浏览器给我发的是一个大的字符串,tcp面向字节流,不能保障获取的是一个完整的请求
// 但是可以读取到请求的报头=====查找空行,空行以前就是请求行+请求报头,那么请求正文怎么办呢
// 在请求报头中有一个Content-Length的key对应的value就是请求正文的大小(有效载荷的长度)
然后接着读取 Content-Length 个字符,就能拿到完整的请求正文。同理,如果我们的 response 携带了数据,就应该在 response 的相应报头里加上 Content-Length。
完整流程是:收到字节流 → 找空行分离报头 → 解析 Content-Length → 收齐正文 → 反序列化 → URI 映射文件 → 读文件 → 构造响应 → 发送。它把 TCP 字节流翻译成 HTTP 请求,再把文件内容翻译成 HTTP 响应——这是 HTTP 服务器的核心。
目录结构
xqq@VM-0-12-ubuntu:~/linux/module4/http$ tree .
.
├── Comm.hpp
├── http
├── Http.hpp
├── InetAddr.hpp
├── Log.hpp
├── Main.cc
├── Makefile
├── Mutex.hpp
├── Socket.hpp
├── TcpServer.hpp
├── Util.hpp
└── wwwroot
├── index.html
├── login.html
└── register.html
1 directory, 14 files
这里的 HTML 是使用 AI 生成的静态资源。只要服务器不需要动态生成内容,而是直接从磁盘按路径读出文件发回去,不管它是 HTML、CSS、JS 还是图片,都属于静态资源。我们之前的"网络版计算器"的运行结果就是动态资源——没有哪个磁盘文件里存着 6+9=15 这个结果,这个结果是程序根据输入实时算出来的。
我们访问网页时,肯定不会直接在网址后面手动输入对应的文件夹名称,而是点击按钮。这就要了解一些 HTML 的知识了:a 标签可以链接到某个地址,网页上点击这个按钮,就会形成一个新地址,点击的位置被浏览器识别后形成新的网页地址,进而发起二次请求。
我们在浏览器请求时,首页是站点的入口。一个网页就是一棵多叉树,点击链接时浏览器会形成新的访问地址、发起二次请求,而我们请求资源都是通过 HTTP 请求的 URI 来表示的。
九、状态码
我们发起 HTTP 请求时,一定都能访问到对应的资源吗?有没有可能会出错?又或者服务器创建子进程失败又要怎么办?这就要了解状态码了。上面谈的都是 HTTP 请求行(request),接下来了解 HTTP 响应(response)的状态。
了解状态行中的状态码,其实就是了解异常处理。
状态码一览
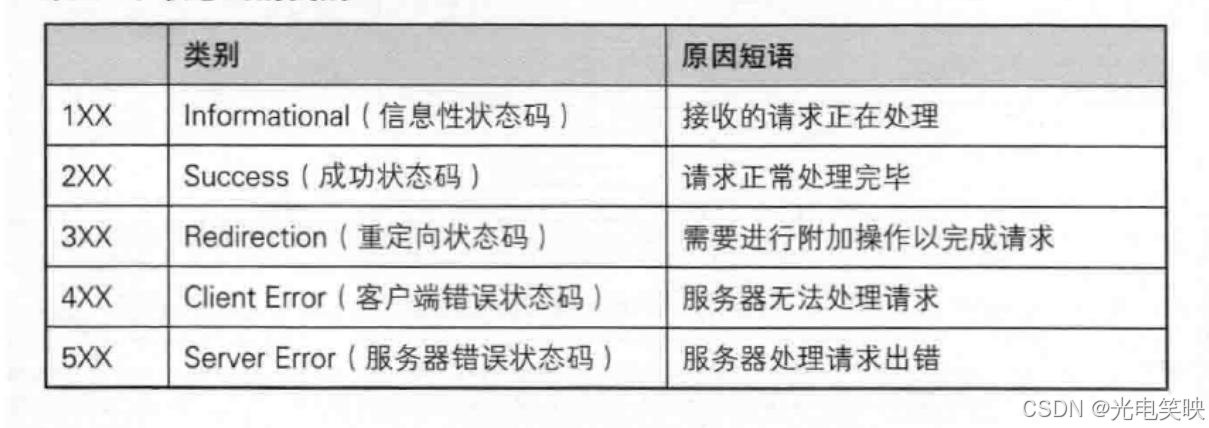
| 100 | Continue | 上传大文件时,服务器告诉客户端可以继续上传 |
| 200 | OK | 访问网站首页,服务器返回网页内容 |
| 201 | Created | 发布新文章,服务器返回文章创建成功的信息 |
| 204 | No Content | 删除文章后,服务器返回"无内容"表示操作成功 |
以下是关于重定向有关的状态码:
| 301 | Moved Permanently | 网站换域名后,自动跳转到新域名;搜索引擎更新网站链接时使用 |
| 302 | Found 或 See Other | 用户登录成功后,重定向到用户首页 |
| 304 | Not Modified | 浏览器缓存机制,对未修改的资源返回 304 状态码 |
| 400 | Bad Request | 填写表单时,格式不正确导致提交失败 |
| 401 | Unauthorized | 访问需要登录的页面时,未登录或认证失败 |
| 403 | Forbidden | 尝试访问你没有权限查看的页面 |
| 404 | Not Found | 访问不存在的网页链接 |
| 500 | Internal Server Error | 服务器崩溃或数据库错误导致页面无法加载 |
| 502 | Bad Gateway | 使用代理服务器时,代理服务器无法从上游服务器获取有效响应 |
| 503 | Service Unavailable | 服务器维护或过载,暂时无法处理请求 |
十、重定向
临时重定向与永久重定向
| 浏览器缓存 | 会缓存,下次不请求服务器 | 默认不缓存,每次都问 |
| 调试友好度 | 差(缓存难清) | 好 |
| 方法保留 | 301 不保证,308 保证 | 302 不保证,303 强制 GET,307 保证 |
| 项目里怎么用 | 上线后的域名/URL 迁移 | 开发期默认选这个 |
一句话:301 是"以后都去那",302 是"这次去那"。 开发阶段永远先用 302,等 URL 彻底定下来再换 301。
举一个生活中的例子:小明和小张知道学校东门有一家非常好吃的牛肉面馆,与学校的东大门隔了一条马路。有一天他们想去吃面,到了门口发现贴着一张纸条:“由于这条马路正在翻修,尘土飞扬,不利于就餐环境,我们将临时暂搬至学校的西门”。于是两人就去西门吃饭了。一个月后再想去吃,是去西门还是东门呢?此时他们并不确定路有没有修好、面馆有没有搬回来,于是倾向于先去东门看看。
上面例子中,牛肉面就相当于网络服务,面馆贴的字条相当于 HTTP 应答,这种方案就是临时重定向——不修改任何信息,在两人的脑子里"店还是在东门",主要用来做登录跳转、页面跳转等。
换一个场景:牛肉面老板发现西门人多、生意好,于是在东门的牛肉面馆门前贴上"本店将永久搬至西门"。看过这个标签的人就不会再去东门了;没看过的会先去东门,但下一次也不会再去了,以后都去西门。也就是说这个告示改变了他们大脑里的信息(也就是改了客户端的信息),这叫永久重定向,典型应用场景就是网站更换域名。
完整流程:从 S1 到 S2 的一次域名迁移访问
假设老网站是 http://old.com(记为 S1),新网站是 http://new.com(记为 S2),用户在浏览器输入 http://old.com/page。
① 客户端向 S1 发起请求
浏览器先和 S1 建立 TCP 连接(三次握手),然后发一个 HTTP 请求:
GET /page HTTP/1.1
Host: old.com
User-Agent: Mozilla/5.0 …
Accept: text/html,…
② S1 收到请求,判断"这是旧地址"
S1 的服务器逻辑发现 /page 已经迁到新站,于是不返回页面内容,而是构造一个重定向响应:
HTTP/1.1 301 Moved Permanently
Location: http://new.com/page
Content-Length: 0
关键点:S1 的响应体是空的。它不转发页面内容,只回一句"搬家了,去这个地址"。
③ 浏览器收到 301,自动发起第二次请求
浏览器解析到状态码是 3xx,且头里有 Location,就自动向 http://new.com/page 发起一次全新的请求——用户通常无感,只看到地址栏从 old.com 变成了 new.com。
GET /page HTTP/1.1
Host: new.com
User-Agent: Mozilla/5.0 … ← 同一个浏览器,UA 不变
这一步是浏览器主动做的,S1 并没有"转发"或"代理"这个请求,S1 的任务在 ② 就结束了。
④ S2 返回真正的内容
S2 收到请求,发现资源存在,正常返回:
HTTP/1.1 200 OK
Content-Type: text/html
Content-Length: 2109
…
浏览器拿到这 2109 字节,渲染页面。用户最终看到的是 S2 的内容。
⑤ 后续:浏览器和搜索引擎各自"记住"这次迁移
- 浏览器侧:因为状态码是 301(永久),浏览器会把 old.com/page → new.com/page 这个映射缓存下来。下次用户再访问 old.com/page,浏览器可能直接本地跳到 new.com,连请求都不发给 S1。
- 搜索引擎侧:爬虫下次来抓 old.com/page 时,看到 301 + Location,会把旧 URL 的收录和权重逐步转移到新 URL,后续抓取改用新地址。这就是"换域名用 301"的真正作用——给爬虫一个可验证的永久映射信号。
如果当时用的是 302(临时),浏览器和爬虫都不会记住,每次访问都会先问 S1,S1 再回 302——适合临时维护,不适合永久换域名。
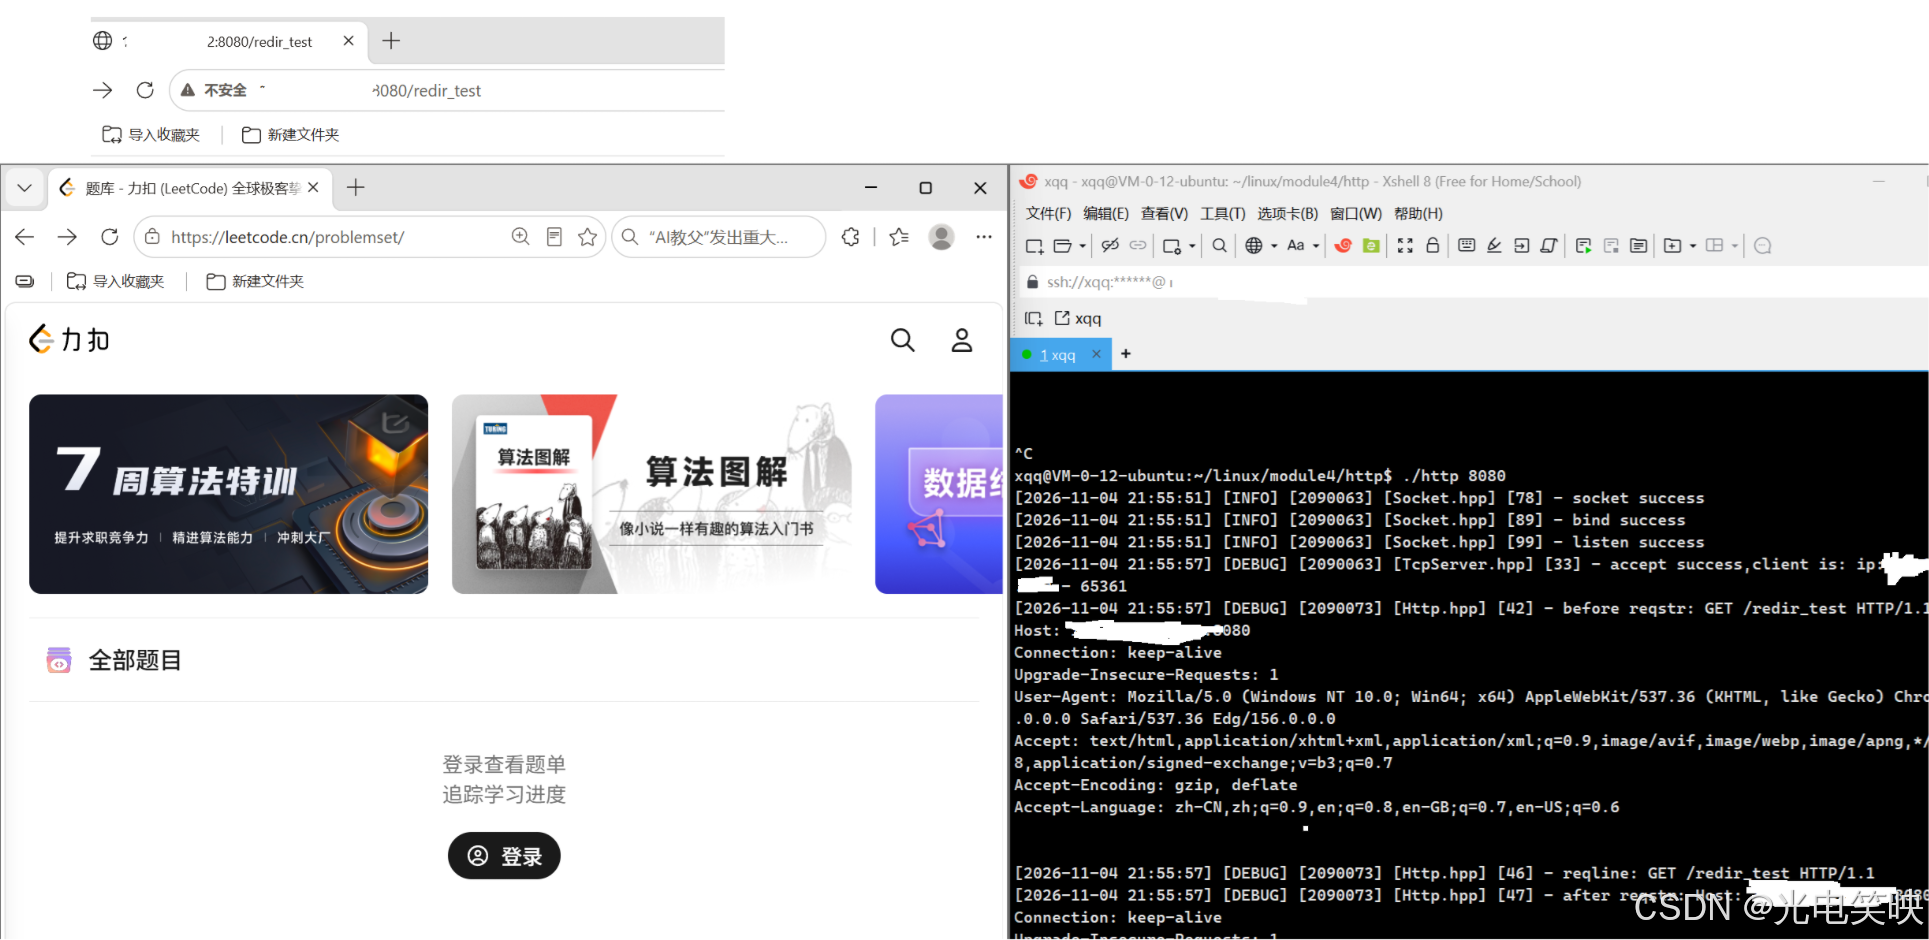
所以重定向的本质,就是让浏览器发起二次请求。
重定向测试
这里简单测试一下,访问 redir_test 时自动跳转到 leetcode 网页:
bool MakeResponse()
{
//。。。
if (_targetfile == "/redir_test")
{
// 做一个临时重定向
SetCode(302);
SetHeader("Location","https://leetcode.cn/problemset/");
SetHeader("Content-Length", "0");
_text.clear();
return true;
}
//….
}
临时重定向与永久重定向(小结)
两者都靠 Location 头告诉浏览器"去别处拿",核心区别是浏览器要不要把这个跳转记下来。
| 状态码 | 301、308 | 302、303、307 |
| 浏览器缓存 | 会缓存,下次直接本地跳转,不再请求服务器 | 默认不缓存,每次都先问服务器 |
| 方法保留 | 301 不保证;308 保证 | 302 不保证;303 强制改 GET;307 保证 |
| 典型场景 | 域名迁移、http→https、URL 永久调整 | 登录后跳转、短链接、A/B 测试、维护页 |
两个实战要点:
- 开发期一律用 302——301 会被浏览器硬缓存,改代码、重启服务器都没用,得手动清缓存才能恢复。等 URL 彻底定下来再换 301。
- POST 跳转别用 301/302——历史上可能被浏览器改成 GET,导致请求体丢失。要保留 POST 用 307/308;POST 后想跳到结果页(避免重复提交)用 303。
落到代码:SetCode 补上 301/302 等描述,构造响应时设 Location + Content-Length: 0,body 留空即可。一句话记:301 是"以后都去那",302 是"这次去那"。
十一、带图片的资源访问与 Content-Type
带图片的资源访问,目录结构如下:
└── wwwroot
├── 404.html
├── img
│ ├── image1.png
│ ├── image2.png
│ └── image3.png
├── index.html
├── login.html
└── register.html
在页面中添加图片链接后:
<div class="footer">
这是一个 HTTP 服务器测试页面
</div>
<img src="/img/image1.png" alt="图片一">
<img src="/img/image2.png" alt="图片二">
<img src="/img/image3.png" alt="图片三">
重新启动服务,再次访问网页,可以发现图片是无法正常显示的。
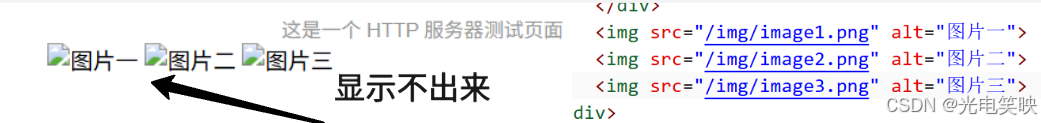
原因主要有三点:
std::string UriSuffix(const std::string &targetfile)
{
//./wwwroot/a/b/c.html
auto pos = targetfile.rfind(".");
if (pos == std::string::npos)
{
return "text/html";
}
std::string suffix = targetfile.substr(pos);
if (suffix == ".html" || suffix == ".htm")
return "text/html";
else if (suffix == ".jpg")
return "image/jpeg";
else if (suffix == ".png")
return "image/png";
else if (suffix == ".txt")
return "text/plain";
// else if….
else
return "";
}
在我们的 Util::ReadFileContent 中,默认是以文本方式读取的,而图片/视频是二进制的,所以之前的代码是有问题的:
static bool ReadFileContent(const std::string &filename, std::string *out)
{
// version1:默认使用文本方式读取文件的,图片是二进制的
// std::ifstream in(filename);
// if (!in.is_open())
// return false;
// std::string line;
// while (std::getline(in, line))
// {
// *out += line;
// }
// in.close();
//version2:以二进制方式读取,严格意义上要用std::vector<char> *out
int filesize = GetFileSize(filename);
if (filesize > 0)
{
std::ifstream in(filename,std::ios::binary);
if (!in.is_open())
return false;
out->resize(filesize);
in.read((char *)out->c_str(), filesize);
in.close();
}
else
return false;
return true;
}
修正后,可以看到图片正常显示了: 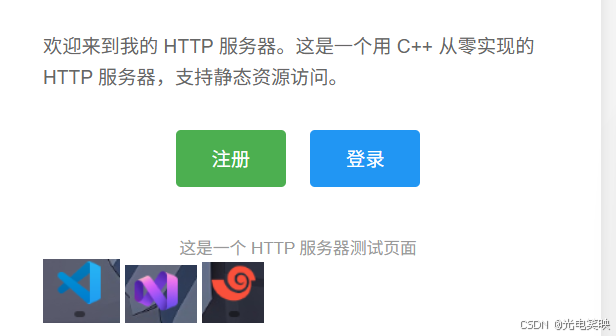
Content-Type 对照表可参考:https://tool.oschina.net/commons
第一次请求访问到首页时,点击按钮就会发起二次请求,此时就必须涵盖 Content-Type,告诉对方有效载荷是什么类型。而之前的报头什么都不带也能正常识别,是因为浏览器足够强大;但返回类型有很多种时,浏览器就无法解析了。
这里再强调两个重要字段:Content-Type 和 Content-Length,它们是 HTTP 请求里两个比较重要的字段。
注意:使用 Microsoft Edge 测试我们的服务器时,可以看到服务器打出的请求中还有一个 GET /favicon.ico HTTP/1.1 这样的请求,这是浏览器想要获取网站的小图标并显示在标签页上。
十二、HTTP 常见 Header
-
Content-Type:数据类型(text/html 等)
-
Content-Length:Body 的长度
-
Host:客户端告知服务器,所请求的资源在哪个主机的哪个端口上
-
User-Agent:声明用户的操作系统和浏览器版本信息;通常客户端请求会携带 User-Agent 字段,该字段包含了客户端浏览器和版本信息、引擎信息、操作系统信息、设备类型等。服务器可能会据此提供不同的服务,比如识别到你的设备是手机,就给你 app 下载包,而不是 Windows 下载包。
注意:一些钓鱼网站可能会利用这些信息,要注意防范。最简单的请求仅需一个请求行即可完成,这意味着在减少信息暴露的前提下,可通过客户端实现网页抓取。
- 爬虫的本质:用 HTTP 客户端,模拟浏览器行为,获取指定链接下的网页。
- 反爬机制:部分服务器会校验 HTTP 请求的完整性(如是否携带 User-Agent、Referer 等字段),若请求不完整(例如缺少 User-Agent),则会判定为非法请求并拒绝响应。
- 绕过反爬机制:伪造 User-Agent 等信息。
- 搜索引擎本质就是爬虫,把首页链接和里面的部分信息留下来呈现给用户。
-
Referer:当前页面是从哪个页面跳转过来的
-
Location:搭配 3xx 状态码使用,告诉客户端接下来要去哪里访问,用来实现重定向功能
-
Cookie:用于在客户端存储少量信息,通常用于实现会话(session)的功能
-
Connection:用于指示连接方式(见下文)
十三、短连接与长连接(Connection 字段)
至此,我们的 HTTP 短连接服务器就写得差不多了。
为什么是短连接?因为 TCP 创建孙进程后,callback 回调到 HandHttpRequest,函数结束后回到 callback,接下来直接 sock->Close() 把套接字关闭、结束连接。浏览器发起一个 request,服务器就返回一个 response,并把套接字关闭。
举个例子,如果我们的网页主页由三张图片构成,请求这个网页时总共就会发起 4 次 HTTP 请求:先请求首页,浏览器发现关联了三个 image 标签,于是继续发起三次请求去获取图片资源。如果采用 HTTP/1.0 的短连接模式,服务器就要受理四次,每一次都要三次 TCP 握手、accept、fork;而我们现在的网页动不动就是几百张图片,开销非常大。怎么解决呢?
在 HTTP/1.1 中,可以基于一条连接向服务器发起多次 HTTP 请求。服务器既然能读取到一个完整报文,就可以按照同样的方式读取多个完整报文——这正是 HTTP 协议报文格式统一的便捷之处。服务器可以读取所有报文,一次性构建并返回多个响应;此时,服务器在给客户端构建完所有应答之前会一直存在,直到构建完所有应答后才关闭套接字。这种通信方案就叫长连接。(所以我们之前写的"网络版计算器"其实就是长连接。)
但服务器或客户端可能是老式的 HTTP/1.0,为了表示双方通信能否正常进行,就引入了 Connection 字段:
Connection: keep-alive # 表示支持长连接
Connection: close # 表示不支持长连接
如果双方通信时发现都支持长连接,那么在 HTTP/1.1 版本下默认交互方式就变成了长连接,也可以通过 Connection 字段显式表示是否支持长连接;如果任何一方不支持,就只能通过短连接进行服务。
对于服务器来说,是否支持长连接是我们自己决定的:拿到客户端套接字后,给它分配执行流、循环等待客户端请求到来而不断开,就是长连接;拿到套接字后,处理完一次请求就断开,这种方式就是短连接。
注意事项:无连接、无状态 vs 长短连接
我们常说 HTTP 协议是一个"无连接、无状态"的协议,指的是它每次请求都是独立的,服务器不会记录客户端的历史状态——服务器不记录客户端是否已经获取过资源,只要有请求就给你发资源。(当然,HTTP 无状态是"服务器不记录",并不代表浏览器不记录;一般的浏览器为了节省带宽,会有缓存。)
要特别注意的是,这个"无连接"很容易和底层 TCP 的"长短连接"搞混。实际上,"长短连接"是 TCP 传输层的特性——TCP 可以通过长连接保持通道不关闭;而 HTTP 作为应用层协议,只关心 Request 和 Response 报文本身,它不维护连接状态。在 HTTP 的视角里,只要把报文发出去、把响应收回来,任务就完成了,底层通道是长是短,它并不关心。
这恰好解释了我们为什么要在代码架构上,将 Http.hpp 和 TcpServer.hpp 彻底分离。这种设计正是软件工程中经典的"分层解耦":TcpServer 只负责底层网络通信,就像个快递员,只负责把 TCP 字节流收上来、发下去,完全不知道里面装的是 HTTP 还是之前写的计算器 JSON;而 Http 模块则是应用层专家,只负责把接收到的字节流解析成 Request,并把 Response 序列化成字节流,完全不需要关心底层用的是 socket 还是 epoll。
如果不分离,把接收数据和协议解析揉在一起,代码不仅会变成一团乱麻,也无法复用。正是因为做了这样的分离,我们之前写的"网络计算器"和现在的"HTTP 服务器"才能完美共用同一个底层网络框架——网络层只管传输,协议层只管解析,业务层只管执行,职责分明,结构清晰。
无状态带来的困扰
某个资源无论你是否已经获取到了,只要你继续访问服务器,它还是会返回给你。这种"无连接、无状态"的特点也会给用户带来困扰:比如要访问网站里的一个内容,访问前需要输入账号密码登录,此时如果要在该网站访问另一个资源,由于 HTTP 是无状态的,这一次资源请求与上一次无关(即不保存客户端信息),又要用户重新登录输入账号密码,非常繁琐。如何解决呢?
十四、Cookie 与 Session
为了解决这种"每次都要重新输入账号密码"的困扰,我们并不是去修改 HTTP 协议让它变成"有状态",而是在 HTTP 的基础之上,引入 Cookie 和 Session 机制(或者现代的 Token/JWT 机制)来"伪造"出状态。
也就是说,某个资源无论你是否已经获取到了,只要你继续访问服务器,它还是会返回给你——这是无状态的特点。具体解决过程是这样的:
第一步:引入 Cookie(客户端存储)
当用户第一次输入账号密码登录成功后,服务器在返回的 HTTP 响应头里加上一个 Set-Cookie 字段,里面存一个唯一标识(比如 session_id=abc123)。浏览器收到后,会自动把这个标识存到本地(有的浏览器也会保存到自己浏览器进程的内存中),我们把这一部分信息叫做 Cookie。之后,只要用户还在这个网站下访问,浏览器每次发 HTTP 请求,都会自动在请求头里带上 Cookie: session_id=abc123。
第二步:引入 Session(服务端存储)
服务器不能光把标识发给客户端,自己也得留个底。所以服务器会在内存(或 Redis 数据库)里开辟一块空间(Session),记录下 abc123 这个标识对应的用户信息(比如:用户名是张三,已经登录)。
第三步:完美闭环
当用户登录后,想去访问该网站的下一个资源时,浏览器会自动带着 Cookie: session_id=abc123 发出请求。服务器一看请求头里有这个标识,去自己的 Session 库里一查,发现"哦,这是张三,他已经登录过了",于是直接返回资源,不再要求输入密码。如果没查到,就会像重定向那样重定向到登录服务,让用户重新登录。也就是说,我们每一次请求资源时,都会对客户的身份进行认证。 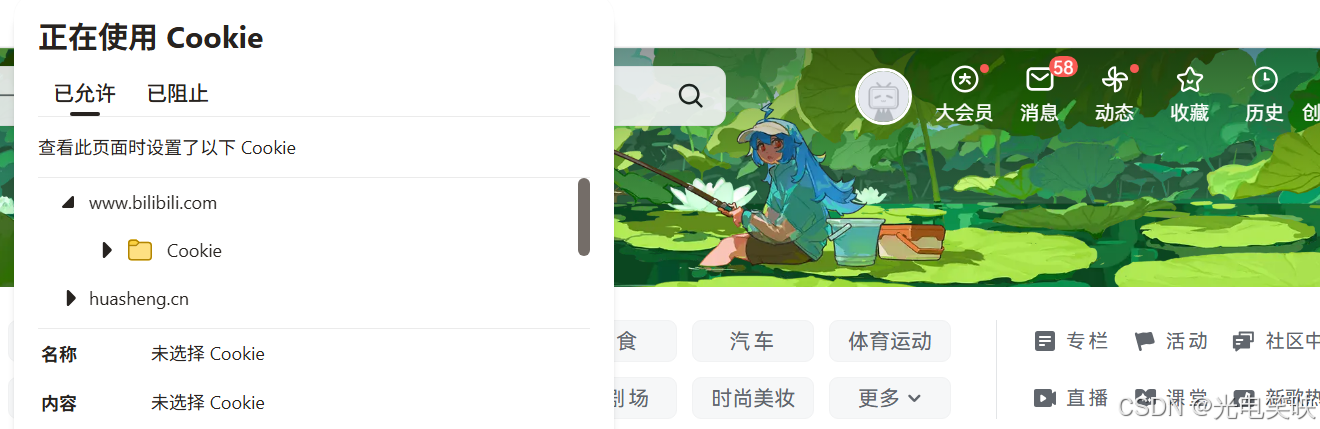
关于区分 Cookie 是文件级还是内存级的方法:如果是文件级的,那么即使关闭浏览器、重启电脑,再访问目标网站,服务器还是认识客户端;如果是内存级的,关闭浏览器后就不认识客户端了,即内存级 Cookie 会随着浏览器关闭自动释放。
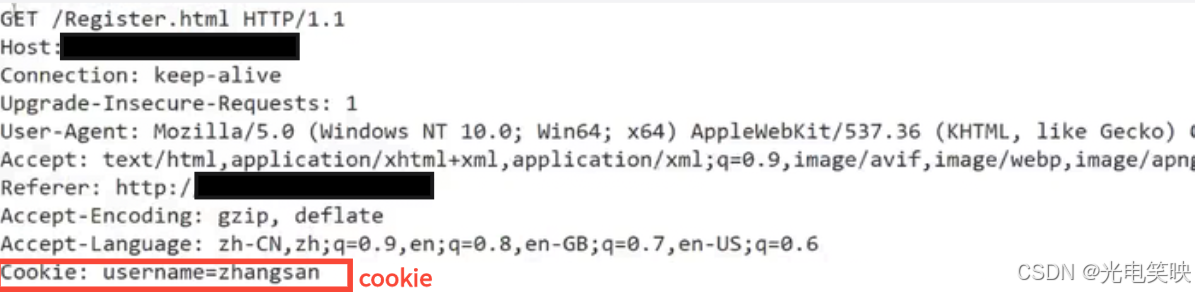
关于 Cookie 的一些安全问题
HTTP 是无状态的,所以我们需要凭证。早期我们直接把账号密码存进 Cookie,但因为其极其容易被窃取和利用(XSS/CSRF),这种做法已被彻底抛弃。现代 Web 的 Cookie 里只存脱敏的"通行证号"(Session ID 或 Token),并配合 HttpOnly、Secure 等安全属性,成为一个安全的"状态载体"。
既然直接让客户端保存账号密码太危险,那我们换个思路:能不能让客户端只拿一张"无字天书",而真正的核心数据留在服务器上? 这就是 Session(会话) 机制诞生的原因。
既然浏览器(客户端)是极其不可信的,我们就不把用户的真实身份数据(比如用户名、角色权限)交给它保存。服务器在内存(或 Redis)中开辟一块空间来保存这些数据,这块空间就叫 Session。同时,服务器生成一个独一无二的、毫无规律的随机字符串(比如 A1B2C3D4),这个字符串被称为 Session ID。
服务器把这个 Session ID 塞进响应头,通过 Set-Cookie 发给浏览器。浏览器乖乖把它存下来,下次再发请求时,就会自动在请求头里带上 Cookie: SessionID=A1B2C3D4。
此时,服务器收到请求,看一眼 Session ID,然后去自己的内存里查表:“哦,拿着 A1B2C3D4 的人,是刚才登录成功的张三”。于是,服务器认出你了。
这就好比去高档洗浴中心: 单纯用 Cookie 就像是把钱包和身份证直接交给你拿着,很容易弄丢或被偷;而 Session 机制,是前台(服务器)替你保管衣物和身份证,只给你发一个手环(Session ID)。你下次去拿东西,只要刷一下手环,前台根据编号去仓库找你的东西。手环丢了没关系,别人拿手环也拿不到你的隐私,而且前台随时可以作废这个手环(Session 过期)。
所以,Cookie 和 Session 通常是配合使用的:
- Cookie 负责在客户端(浏览器)记住你的"手环编号"。
- Session 负责在服务端(服务器)记住你的"真实身份"。
服务端要对这些 Session 进行管理,就是"先描述、再组织",类似于:
// 1. 先描述:定义一个 Session 应该长什么样
class Session
{
public:
// 用户名、状态、创建时间
std::string _usrname;
std::string _status;
uint64_t _create_time;
// std::string _session_id; // 唯一标识
// uint64_t _last_access_time; // 最后一次访问时间,用于实现"30分钟无操作自动过期"
};
using session_ptr = std::shared_ptr<Session>;
// 2. 再组织:定义一个管理器,负责增删改查
class SessionManager
{
private:
// 用一个哈希表,key 是 Session ID,value 是 Session 对象
std::unordered_map<std::string, session_ptr> _sessions;
};
总结:这种"客户端只存凭证,服务端存储状态"的架构,通过会话管理与会话保存,完美弥补了 HTTP 无状态带来的麻烦,同时也彻底解决了单纯使用 Cookie 带来的安全泄露问题。直到今天,这依然是各大传统网站最经典的登录认证方案。
十五、GET 与 POST 方法
1. GET 方法(重点)
- 用途:用于请求(获取)URL 指定的资源,以 URI 方式提交参数
- 示例:
GET /index.html HTTP/1.1
- 特性:指定资源经服务器端解析后返回响应内容。
2. POST 方法(重点)
- 用途:用于传输实体的主体,通常用于提交(上传)表单数据,提交参数以正文的形式提交
- 示例:
POST /submit.cgi HTTP/1.1
我们之前都是进行 GET 数据,那么如果今天要将客户端数据上传到服务器,就可以使用 POST。其实 GET 也可以上传数据,那如何上传数据呢?
我们可以通过一个表单来提交。所谓的表单,就是将静态网页返回给浏览器,浏览器渲染 <form> 这样的元素后,就会出现一个输入框(<input> 是输入框,在 login.html 文件里就有类似的内容):
<body>
<div class="container">
<h2>用户登录</h2>
<form action="/login" method="POST">
<label for="username">用户名</label>
<input type="text" id="username" name="username" placeholder="请输入用户名" required>
<label for="password">密码</label>
<input type="password" id="password" name="password" placeholder="请输入密码" required>
<button type="submit">登录</button>
</form>
<div class="link">
没有账号?<a href="register.html">去注册</a>
</div>
</div>
</body>
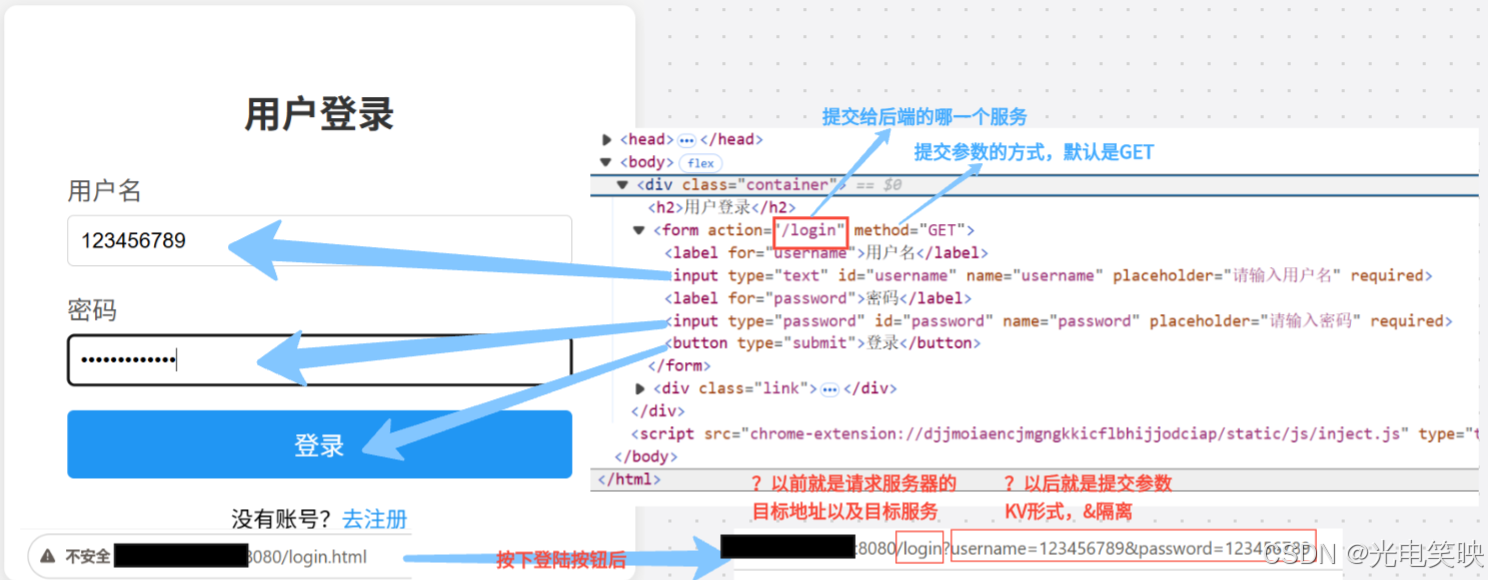
通过上面的图片可以看到,当我们填写完数据后按下提交按钮,网址就改变了。这是因为表单设置了 method="GET"。GET 提交的本质,就是把所有输入框的 name 和对应 value,用 = 连起来,用 & 拼接,然后直接追加到 URL 的 ? 后面。
这就是 HTTP 请求行的起点。当浏览器发生这个跳转时,它发给服务器的 HTTP 请求长这样:
GET /login?username=123456789&password=123456789 HTTP/1.1
Host: 118.89.153.212:8080
…
服务器代码里的 ParseReqLine 函数,通过 ss >> _req_method >> _uri >> _http_verion,会把中间这部分完整地提取到 _uri 变量中。
所以 GET 如果要提交参数,是以 URI 进行提交的。这里注意一下:/login 不是 wwwroot/login.html 这样的文件,而是一种 HTTP 服务。我们的 HTTP 将来不仅仅返回静态资源(如视频、音频文件),还要提供动态交互能力,比如客户端提交一个登录数据请求,服务器要进行处理。
于是我们可以给服务器添加服务函数,在 HTTP 里加一个保存服务的容器 std::unordered_map<std::string, http_func_t> _service;:
using http_func_t = std::function<void(HttpRequest &req, HttpResponse &resp)>;
解耦之后,未来的服务函数(如 Login)就是连接数据库,然后根据用户名在数据库里查——查到了就返回,没查到就返回 404,或者返回"用户不存在"等;其他函数(如 register)也是同样的逻辑。
我们把"由服务器以路径方式注册对应服务"这种风格,理解为:将来要什么服务,就拿着对应服务器域名,后面跟上服务;如果有参数,就 ? 开头、以 & 分隔的 kv。所以 HTTP 给别人提供了一种微服务接口,这种"用 URL 定位服务、用 HTTP 方法表达操作"的请求后端服务的风格,就是 RESTful 风格的网络接口。
当浏览器页面成功渲染出 hello: username=123456789…,我们的服务器也完整打印出了客户端发来的原始请求,这意味着我们的 HTTP 服务器已经跨过了最关键的一道分水岭:它不再只是一个"只会搬运文件的静态服务器",而是进化成了一个"能处理业务逻辑的动态 Web 框架"。
回顾这一阶段的实现,我们完成了三个关键跃升:
1. 洞悉了 GET 请求的本质 通过对比图可以清晰地看到,表单提交时,浏览器将输入框的 name 和 value 用 = 拼接,用 & 串联,并直接追加在请求行的 URL 之后。甚至在图中,邮箱的 @ 符号被浏览器自动 URL 编码成了 %40。这正是 HTTP 协议中 GET 方法传递参数的底层逻辑。
2. 构建了"路由匹配 + 回调分发"机制 在代码层面,当收到 /login?username=… 时,我们的服务器不再盲目地去磁盘寻找同名文件。我们提取出 ? 前面的纯路径 /login,去 _service 路由表中进行精准匹配;匹配成功后,再将 ? 后面的参数提取出来,作为 req.Args() 传递给注册好的回调函数(如 Login 或 Register)。这正是现代 Web 框架(如 Express、Spring)最核心的运行原理。
3. 暴露了 GET 请求的安全隐患 图中的终端日志也给我们敲响了警钟:密码明文死死地印在了 URL 和服务器日志中。这说明在实际的生产环境中,涉及敏感信息的交互(如登录、注册)绝不能使用 GET 方法。它们必须通过 method="POST",将账号密码封装在请求正文(Body)中,配合 Content-Length 来传输。
GET 与 POST 的区别
我们上面使用的是 GET 方法,那么 POST 方法不是也可以上传数据吗,与 GET 有什么区别呢? 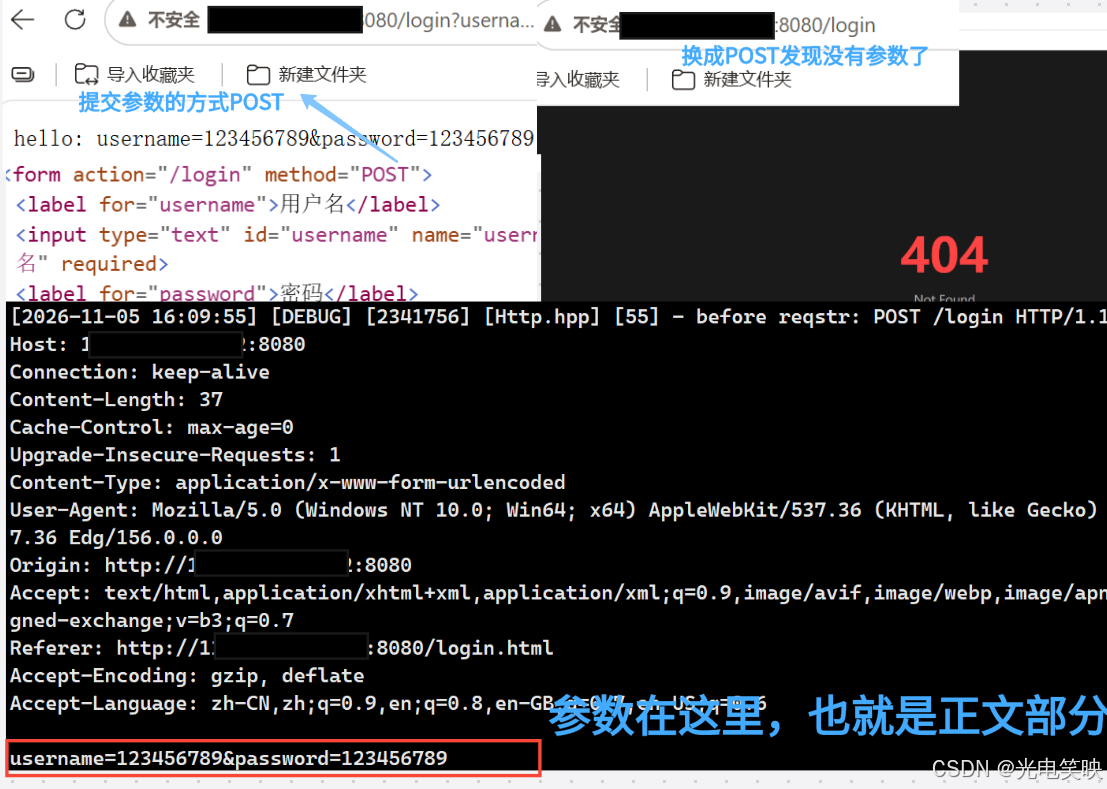
- GET 提交参数建议参数不要过长,因为 URl 长度一般是有限的。
- POST 以正文提交参数,可以提交长数据。
- GET 提交参数会回显参数,POST 不会回显,所以相比之下 POST 更加私密。但两者都不安全,因为都可以抓包(也就是明文传送)。之前说过,我们将来一定处于某个局域网中,所发的消息在该局域网下的其他机器也可以收到。那么尽管是 HTTP 的 POST,在其他主机下也可以通过抓包获取,从而盗取密码和账号。所以要做到真正的安全,我们必须把报文加密,也就是使用 HTTPS 协议(关于 HTTPS 协议,我会单独出一篇博客进行讲解)。
十六、Fiddler 抓包
这里介绍一个软件 Fiddler。Fiddler 是一款非常流行的 HTTP/HTTPS 调试代理工具。你可以把它理解为一个"中间人",它站在你的浏览器(或任何客户端)和服务器之间,截获、查看、甚至修改所有流经它的网络请求和响应。
Fiddler 的本质是一个代理服务器。当你启动 Fiddler 后,它会自动将你的系统代理设置为 127.0.0.1:8888(它自己)。之后,你的请求流程就变成了:
起始浏览器 → Fiddler(拦截并记录) → 目标服务器
目标服务器 → Fiddler(拦截并记录) → 你的浏览器
所以,所有原本直接在客户端和服务器之间传输的数据,都会"绕道"经过 Fiddler,这就给了你一个观察和干预的机会。
Fiddler 的主要功能:
- 抓包与查看(Inspect)
- 构造请求(Composer)
- 断点调试(Breakpoints)
- Mock 与 AutoResponder:拦截特定请求,并直接返回你预先设定好的响应
- 性能分析
运行结果如下: 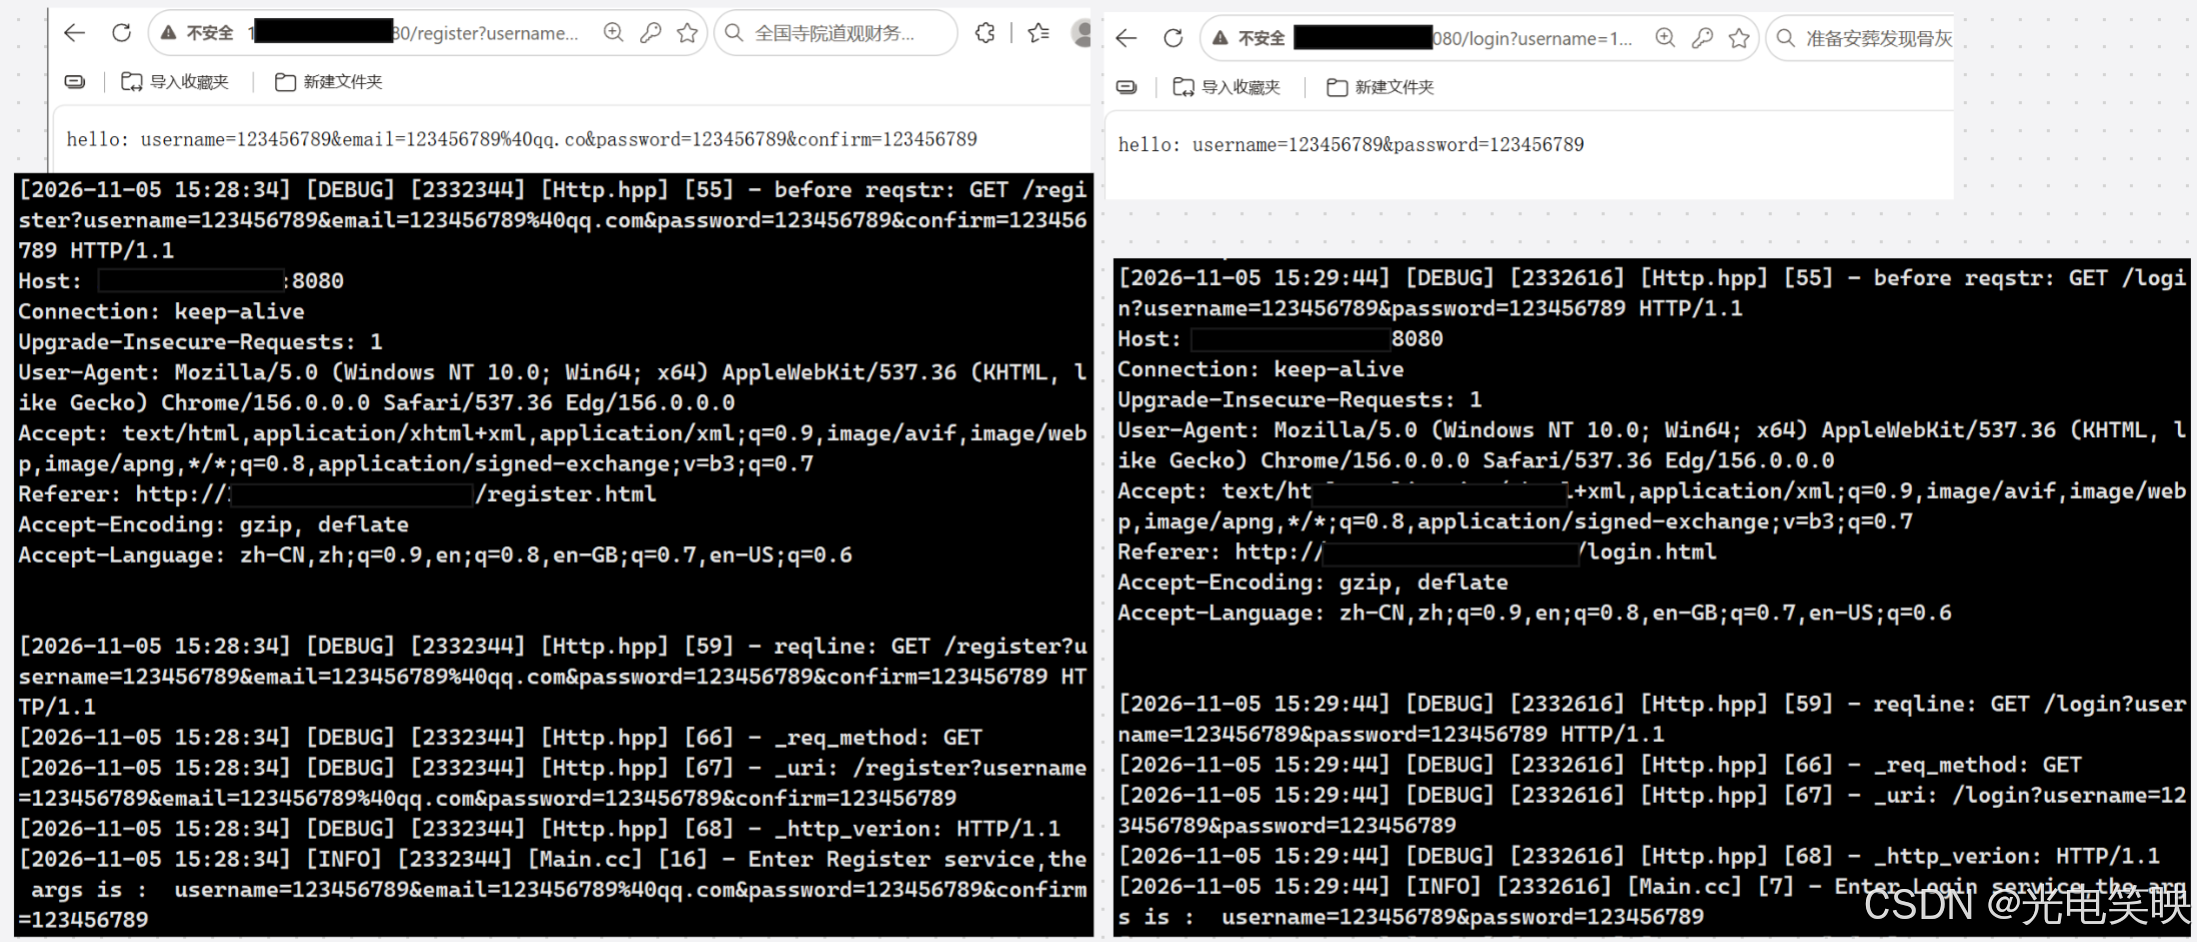
关于 RESTful 风格
在我们刚才实现的 /login 和 /register 接口中,URL 里包含了动词(login、register),参数通过 ? 拼接在 URL 后面。这种基于"动作"的接口设计被称为 RPC(远程过程调用)风格。
在现代 Web 开发中,更主流的是 RESTful 风格。RESTful 的核心原则是:用 URL 定位资源,用 HTTP 方法(GET、POST、PUT、DELETE)表达操作。
例如,同样是针对"用户"这个资源:
- GET /users:获取用户列表
- POST /users:注册新用户
- DELETE /users/123:删除 ID 为 123 的用户
如果我们要让当前这个 C++ 服务器支持 RESTful,其实只需要对路由表做一个微小的升级:把原本仅基于 Path 匹配的 map,改成基于 Method + Path 的二维查找。这样,同一个 /users 路径,发 GET 就走查询逻辑,发 POST 就走注册逻辑。
同时,RESTful 接口往往要求客户端发送 JSON 格式的 Body,这也对我们服务器后续解析 Content-Type 和读取 Content-Length 提出了更高的要求——这就留作未来的拓展方向。
POST 特性:可以发送大量数据给服务器,数据包含在请求体中。
方法总结 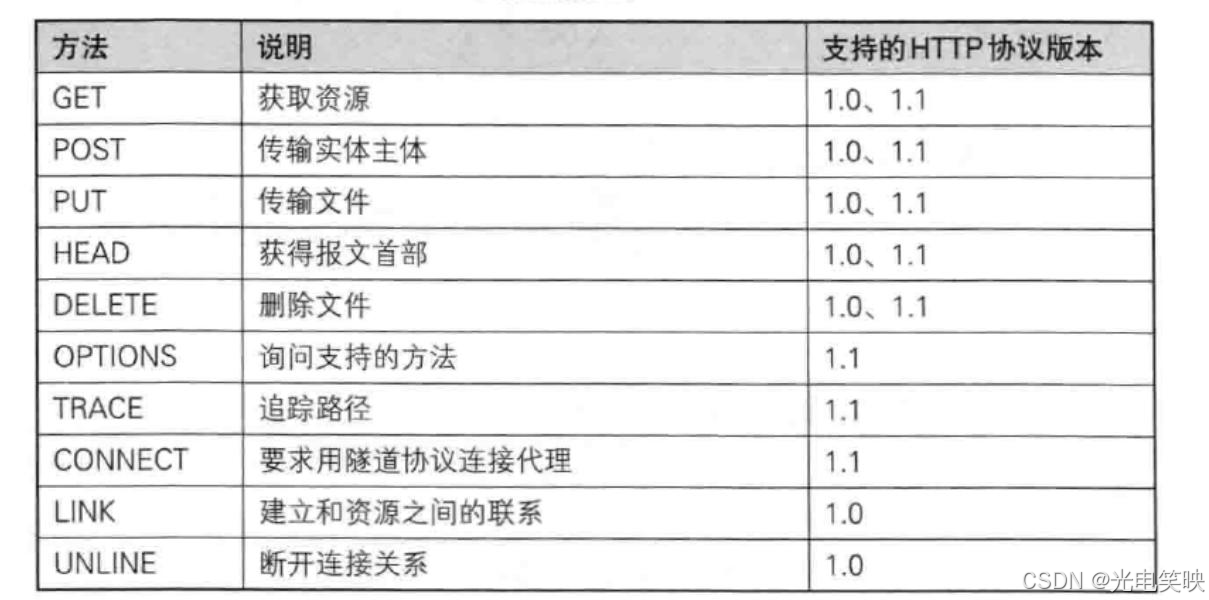
十七、完整代码
整体结构如下:
.
├── Comm.hpp
├── Http.hpp
├── InetAddr.hpp
├── Log.hpp
├── Main.cc
├── Makefile
├── Mutex.hpp
├── Socket.hpp
├── TcpServer.hpp
├── Util.hpp
└── wwwroot
├── 404.html
├── img
│ ├── image1.png
│ ├── image2.png
│ └── image3.png
├── index.html
├── login.html
└── register.html
2 directories, 17 files
里面关键的代码文件如下。
Http.hpp
#include "TcpServer.hpp"
#include <unordered_map>
#include "Util.hpp"
#include <cstring>
#include <sstream>
#include <functional>
const std::string gspace = " ";
const std::string glinespace = "\\r\\n";
const std::string gcolonspace = ": ";
const std::string webroot = "./wwwroot"; // web根目录
const std::string homepage = "/index.html"; // 首页
const std::string page_404 = "/404.html";
const std::string quesmark = "?";
class HttpRequest
{
public:
HttpRequest() : _blankline(glinespace),
_is_interact(false)
{
}
// 序列化:把 HttpRequest 对象转成 HTTP 请求字符串
// (服务端一般不调用,主要用于构造请求或测试)
std::string Serialize()
{
std::string result;
return result;
}
bool IsInteract()
{
return _is_interact;
}
std::string Args()
{
return _args;
}
bool ParseReqLine(std::string &reqline)
{
std::stringstream ss(reqline);
if (!(ss >> _req_method >> _uri >> _http_verion))
{
// 字段不足或格式错误
return false;
}
return true;
}
// 反序列化:把浏览器发来的 HTTP 请求字符串,解析成 HttpRequest 对象
// 服务端重点关注:收到请求后,第一步就是解析请求行、头部、正文
bool Deserialize(std::string &reqstr)
{
LOG(LogModule::LogLevel::DEBUG) << "before reqstr:" << reqstr;
// 1.提取请求行
std::string reqline;
bool res = Util::ExtractOneLine(reqstr, &reqline, glinespace);
LOG(LogModule::LogLevel::DEBUG) << "reqline:" << reqline;
// LOG(LogModule::LogLevel::DEBUG) << "after reqstr:" << reqstr;
// 2.对请求行进行反序列化
/// reqline: GET / HTTP/1.1
ParseReqLine(reqline);
LOG(LogModule::LogLevel::DEBUG) << "_req_method:" << _req_method;
LOG(LogModule::LogLevel::DEBUG) << "_uri:" << _uri;
LOG(LogModule::LogLevel::DEBUG) << "_http_verion:" << _http_verion;
// if(_req_method=="POST")
// {
// _is_interact=true;
// while(true)
// {
// Util::ExtractOneLine(reqstr,&reqline,glinespace);
// if(reqline!=glinespace)
// {
// //获得了request header转成key value
// //Content-Length
// }
// else
// {
// break;
// }
// }
// Util::ExtractOneLine(reqstr,&reqline,glinespace);//正文数据
// }
auto pos = _uri.find(quesmark);
if (pos == std::string::npos)
{ // 没有参数,序列化完成
return true;
}
else // 解析参数
{
//_uri: /login?username=123456789&password=123456789
//_uri: /login _args=username=123456789&password=123456789
_is_interact = true;
_args = _uri.substr(pos + quesmark.size(), std::string::npos);
_uri = _uri.substr(0, pos); //[0,pos)
}
return true;
}
std::string Uri()
{
return _uri;
}
~HttpRequest()
{
}
private:
std::string _req_method; // 请求方法,如 GET、POST
std::string _uri; // 请求路径,如 /index.html
std::string _http_verion; // HTTP 版本,如 HTTP/1.1
std::unordered_map<std::string, std::string> _headers; // 请求头部字段,key: value 形式
std::string _blankline; // 空行,分隔报头和正文
std::string _text; // 请求正文,可有可无
bool _is_interact; // 是否是交互式
std::string _args;
};
class HttpResponse
{
public:
HttpResponse() : _blankline(glinespace), _http_verion("HTTP/1.0")
{
SetCode(200);
}
// 序列化:把 HttpResponse 对象转成 HTTP 响应字符串
// 服务端重点关注:构造响应时,需要拼接状态行、响应头部、空行、正文
std::string Serialize()
{
// 实现:成熟的http序列化/反序列化不依赖任何第三方库
// 状态行
std::string status_line = _http_verion + gspace + std::to_string(_code) + gspace + _code_descriptor + _blankline;
// 响应报头
std::string respheader;
for (auto &header : _headers)
{
respheader += header.first;
respheader += gcolonspace;
respheader += header.second;
respheader += _blankline;
}
return status_line + respheader + _blankline + _text;
}
void SetCode(int code)
{
_code = code;
switch (_code)
{
case 200:
_code_descriptor = "OK";
break;
case 404:
_code_descriptor = "Not Found";
break;
case 301:
_code_descriptor = "Moved Permanently";
break;
case 302:
_code_descriptor = "Found";
break;
default:
break;
}
}
void SetHeader(const std::string &Key, const std::string &Value)
{
auto iterator = _headers.find(Key);
if (iterator != _headers.end())
return;
_headers.insert(std::make_pair(Key, Value));
}
void SetText(const std::string &text)
{
_text = text;
}
std::string UriSuffix(const std::string &targetfile)
{
//./wwwroot/a/b/c.html
auto pos = targetfile.rfind(".");
if (pos == std::string::npos)
{
return "text/html";
}
std::string suffix = targetfile.substr(pos);
if (suffix == ".html" || suffix == ".htm")
return "text/html";
else if (suffix == ".jpg")
return "image/jpeg";
else if (suffix == ".png")
return "image/png";
else if (suffix == ".txt")
return "text/plain";
// else if….
else
return "";
}
bool MakeResponse()
{
std::string path = _targetfile;
if (path == "/")
path = homepage; // "/" -> "/index.html"
std::string filename = webroot + path; // "./wwwroot/index.html"
LOG(LogModule::LogLevel::DEBUG) << "用户请求:" << filename;
LOG(LogModule::LogLevel::DEBUG) << "_targetfile:" << _targetfile;
if (_targetfile == "/redir_test")
{
// 做一个重定向
SetCode(301);
SetHeader("Location", "https://leetcode.cn/problemset/");
SetHeader("Content-Length", "0");
_text.clear();
return true;
}
// 8. 读文件,不存在返回 404
if (!Util::ReadFileContent(filename, &_text))
{
SetCode(404);
_targetfile = webroot + page_404;
Util::ReadFileContent(_targetfile, &_text);
// 也可以直接重定向到404.html
// SetCode(302);
// SetHeader("Location","http://xxx.xxx.xxx.xxx:8080/404.html");
}
else
{
SetCode(200);
}
// 9. 设置 Content-Length和Content-Type
SetHeader("Content-Length", std::to_string(_text.size()));
std::string suffix = UriSuffix(_targetfile);
SetHeader("Content-Type", suffix);
LOG(LogModule::LogLevel::DEBUG) << "code=" << _code
<< " body_size=" << _text.size()
<< " filename=" << filename;
return true;
}
// 反序列化:把 HTTP 响应字符串解析成 HttpResponse 对象
// (客户端/浏览器自动完成,服务端一般不调用,主要用于测试或客户端解析)
bool Deserialize(std::string &respstr)
{
return true;
}
~HttpResponse()
{
}
void SetTargetFile(const std::string &file)
{
_targetfile = file;
}
private:
public:
std::string _http_verion; // HTTP 版本,如 HTTP/1.1
int _code; // 状态码,如 200、404、500
std::string _code_descriptor; // 状态码描述,如 OK、Not Found、Internal Server Error
std::unordered_map<std::string, std::string> _headers; // 响应头部字段,key: value 形式
std::string _blankline; // 空行,分隔报头和正文
std::string _text; // 响应正文,如 HTML、JSON、图片数据
// 其他属性
std::string _targetfile;
};
using http_func_t = std::function<void(HttpRequest &req, HttpResponse &resp)>;
class Http
{
public:
Http(uint16_t port)
{
_tsvrp = std::make_unique<TcpServer>(port);
}
void Start()
{
_tsvrp->Start([this](std::shared_ptr<SocketModule::Socket> &socket, InetAddr &client)
{ this->HandHttpRequest(socket, client); });
}
void RegisterService(const std::string &key, http_func_t server)
{
auto iter = _service.find(key);
if (iter == _service.end())
{
_service.insert(std::make_pair(key, server));
}
}
~Http() {}
// 浏览器发过来的就是一个大的字符串===>序列化===>HttpRequest类对象
// GET /test HTTP/1.1
// Host: xxx.xxx.xxx.xxx:8080
// Connection: keep-alive
// Upgrade-Insecure-Requests: 1
// ….
// 于是让HandHttpRequest进行反序列化
void HandHttpRequest(std::shared_ptr<SocketModule::Socket> &socket, InetAddr &client)
{
std::string httpreqstr;
// 浏览器给我发的是一个大的字符串,tcp面向字节流,不能保障获取的是一个完整的请求
// 但是可以读取到请求的报头=====查找空行,空行以前就是请求行+请求报头,那么请求正文怎么办呢
// 在请求报头中有一个Content-Length的key对应的value就是请求正文的大小(有效载荷的长度)
// 1. 接收数据,先拿到报头
int n = socket->Recv(&httpreqstr);
if (n > 0)
{
// 2. 找空行,分离报头和正文
size_t pos = httpreqstr.find("\\r\\n\\r\\n");
if (pos == std::string::npos)
return;
// 3. 解析 Content-Length
int content_length = 0;
size_t cl_pos = httpreqstr.find("Content-Length: ");
if (cl_pos != std::string::npos)
{
size_t start = cl_pos + strlen("Content-Length: ");
size_t end = httpreqstr.find("\\r\\n", start);
std::string len_str = httpreqstr.substr(start, end – start);
content_length = std::stoi(len_str);
}
// 4. 判断正文是否完整
size_t body_start = pos + 4; // \\r\\n\\r\\n 是 4 字节
size_t total_len = body_start + content_length;
while (httpreqstr.size() < total_len)
{
// 正文不完整,继续收
int m = socket->Recv(&httpreqstr);
if (m <= 0)
return; // 对端关闭或出错
}
// 5. 截取完整请求(报头 + 正文)
std::string complete_request = httpreqstr.substr(0, total_len);
// 6. 反序列化成 HttpRequest 对象
HttpRequest req;
if (!req.Deserialize(complete_request))
{
LOG(LogModule::LogLevel::WARNING) << "Deserialize fail";
return;
}
// 7. 根据请求路径找文件,构造响应
HttpResponse resp;
if (req.IsInteract()) // 交互式
{
if (_service.find(req.Uri()) == _service.end())
{
// 请求的动态资源不存在,_uri: /login,返回404
resp.SetCode(302);
resp.SetHeader("Location", "http://xxx.xxx.xxx.xxx:8080/404.html");
std::string resp_str = resp.Serialize();
socket->Send(resp_str);
}
else
{
_service[req.Uri()](req, resp);
// 回调完成构建response后,序列化发送response
std::string resp_str = resp.Serialize();
socket->Send(resp_str);
}
}
else // 非交互,访问静态资源
{
resp.SetTargetFile(req.Uri());
if (resp.MakeResponse())
{
// 面向对象化
// resp._http_verion = "HTTP/1.1";
// resp._code = 200;
// resp._code_descriptor = "OK";
// 10. 序列化并发送
std::string resp_str = resp.Serialize();
socket->Send(resp_str);
}
else
{
LOG(LogModule::LogLevel::WARNING) << "MakeResponse fail";
}
}
}
// #ifndef DEBUG
// #define DEBUG
#ifdef DEBUG
std::string httpreqstr;
// 浏览器给我发的是一个大的字符串,tcp面向字节流,不能保障获取的是一个完整的请求
socket->Recv(&httpreqstr);
std::cout << "httpreqstr:" << httpreqstr << std::endl;
// debug,直接构建http应答,内存级+固定
HttpResponse resp;
resp._http_verion = "HTTP/1.1";
resp._code = 200; // success
resp._code_descriptor = "OK";
std::string filename = webroot + homepage;
// 不能把html文件硬编码到服务器程序,只是测试
// resp._text =
// "<!DOCTYPE html>\\r\\n"
// "<html>…Hello World…</html>";
bool result = Util::ReadFileContent(filename, &resp._text);
(void)result;
std::string resp_str = resp.Serialize();
socket->Send(resp_str);
#endif
}
private:
std::unique_ptr<TcpServer> _tsvrp;
std::unordered_map<std::string, http_func_t> _service;
};
TcpServer.hpp
#include "Socket.hpp"
#include <iostream>
#include <memory>
#include <sys/wait.h>
#include <functional>
//软件解耦后TcpServer只负责连接和io通信问题
//tcpserver不需要关心所传的信息是什么,这些由上层去负责
//网络版本计算器,由用户决定什么时候退出,所以我们把这个当作一个长服务
using ioserver_t=std::function<void(std::shared_ptr<SocketModule::Socket>&,InetAddr&)>;
class TcpServer
{
public:
TcpServer(uint16_t port)
: _port(port),
_listensockptr(std::make_unique<SocketModule::TcpSocket>()),
_isrunning(false)
{
_listensockptr->BuildTCPSocketMethod(_port);
}
void Start(ioserver_t callback)
{
_isrunning = true;
while (_isrunning)
{
InetAddr client;
auto sock = _listensockptr->Accept(&client); // 得到与客户端通信的sockfd,client网络地址
if (sock == nullptr)
{
continue;
}
LOG(LogModule::LogLevel::DEBUG) << "accept success,client is:"<<client.StringAddr();
// sock&&client信息,这里采用多进程方案
pid_t id = fork();
if (id < 0)
{
LOG(LogModule::LogLevel::FATAL) << "fork fail";
exit(FORK_ERR);
}
else if (id == 0)
{ // 子进程,关闭listensocketfd,面向对象式关闭
_listensockptr->Close();
if(fork()>0)
{
exit(CORRECT);
}
//孙子进程执行任务已经是孤儿了
callback(sock,client);
sock->Close();
_exit(CORRECT);
}
else
{ // 父进程,关闭sockfd
sock->Close();
waitpid(id,nullptr,0);
}
}
_isrunning = false;
}
~TcpServer()
{
}
private:
uint16_t _port;
std::unique_ptr<SocketModule::Socket> _listensockptr;
bool _isrunning;
};
Util.hpp
#pragma once
#include <iostream>
#include <string>
#include <fstream>
#include "Comm.hpp"
// 工具类
class Util
{
public:
static bool ReadFileContent(const std::string &filename, std::string *out)
{
// version1:默认使用文本方式读取文件的,图片是二进制的
// std::ifstream in(filename);
// if (!in.is_open())
// return false;
// std::string line;
// while (std::getline(in, line))
// {
// *out += line;
// }
// in.close();
//version2:以二进制方式读取,严格意义上要用std::vector<char> *out
int filesize = GetFileSize(filename);
if (filesize > 0)
{
std::ifstream in(filename,std::ios::binary);
if (!in.is_open())
return false;
out->resize(filesize);
in.read((char *)out->c_str(), filesize);
in.close();
}
else
return false;
return true;
}
static bool ExtractOneLine(std::string &str, std::string *out, const std::string &sep)
{
size_t pos = str.find(sep);
if (pos == std::string::npos)
return false;
*out = str.substr(0, pos);
str.erase(0, pos + sep.size());
return true;
}
static int GetFileSize(const std::string &filename)
{
// 还有一个方法是系统调用stat,通过struct stat结构体返回文件属性,提取size属性就可以拿到了
// int stat(const char *pathname, struct stat *statbuf);
std::ifstream in(filename, std::ios::binary);
if (!in.is_open())
{
return OPEN_ERR;
}
in.seekg(0, std::ios::end); // 将读写位置从开头移到结尾
int filesize = in.tellg(); // 读取读写位置
in.seekg(0, in.beg); // 恢复读写位置
in.close();
return filesize;
}
};
Main.cc
#include "Http.hpp"
// 这些处理函数也可以面向对象化,封装一个类
void Login(HttpRequest &req, HttpResponse &resp)
{
LOG(LogModule::LogLevel::INFO) << "Enter Login service,the args is : " << req.Args();
std::string text = "hello: " + req.Args();
resp.SetCode(200);
resp.SetHeader("Content-Type", "text/plain");
resp.SetHeader("Content-Length", std::to_string(text.size()));
resp.SetText(text);
}
void Register(HttpRequest &req, HttpResponse &resp)
{
LOG(LogModule::LogLevel::INFO) << "Enter Register service,the args is : " << req.Args();
std::string text = "hello: " + req.Args();
resp.SetCode(200);
resp.SetHeader("Content-Type", "text/plain");
resp.SetHeader("Content-Length", std::to_string(text.size()));
resp.SetText(text);
}
void VipCheck(HttpRequest &req, HttpResponse &resp)
{
LOG(LogModule::LogLevel::INFO) << "Enter VipCheck service,the args is : " << req.Args();
std::string text = "hello: " + req.Args();
resp.SetCode(200);
resp.SetHeader("Content-Type", "text/plain");
resp.SetHeader("Content-Length", std::to_string(text.size()));
resp.SetText(text);
}
// ./http port
int main(int argc, char *argv[])
{
Enable_Console_Log_Strategy();
if (argc != 2)
{
LOG(LogModule::LogLevel::ERROR) << "Usage: ./http port";
exit(USAGE_ERR);
}
uint16_t port = std::stoi(argv[1]);
std::unique_ptr<Http> httpsvr = std::make_unique<Http>(port);
httpsvr->RegisterService("/login", Login);
httpsvr->RegisterService("/register", Register);
httpsvr->RegisterService("/vipcheck", VipCheck);
httpsvr->Start();
return 0;
}
demo 的网址:https://gitee.com/xuquanquan3376259230/linux/tree/master/module4/http
十八、HTTP 历史及版本总结
| HTTP/0.9 | 1991 | 仅支持 GET、纯文本传输、无头信息 | 传输基本 HTML | 互联网起步,网页以文本为主 |
| HTTP/1.0 | 1996 | 引入 POST/HEAD、请求响应头、MIME、缓存、状态码 | 支持多种数据格式和功能 | 网页内容逐渐丰富,但每次 TCP 连接只能发一个请求,性能差 |
| HTTP/1.1 | 1999 | 持久连接、管道化、分块传输、Host 头 | 单个 TCP 连接发多个请求,提高性能 | 网页外部资源增多,HTTP/1.0 性能问题突出 |
| HTTP/2.0 | 2015 | 多路复用、二进制帧、头部压缩、服务器推送 | 一个 TCP 连接允许多个请求,减少传输开销 | 移动互联网、云计算兴起,性能要求更高 |
| HTTP/3.0 | 2022 | QUIC 协议(基于 UDP)、减少握手、解决线头阻塞 | 提高连接建立速度和传输效率 | 5G、物联网发展,实时性要求更高 |


评论前必须登录!
注册