 网硕互联帮助中心
💖💖作者:计算机毕业设计小途 💙💙个人简介:曾长期从事计算机专业培训教学,本人也热爱上课教学,语言擅长Java、微信小程序、Python、Golang、安卓Android等,开发项目包括大数据、深度学习、网站、小程序、安卓、算法。平常会做一些项目定制化开发、代码讲解、答辩教学、文档编写、也懂一些降重方面的技巧。平常喜欢分享一些自己开发中遇到的问题的解决办法,也喜欢交流技术,大家有技术代码这一块的问题可以问我! 💛💛想说的话:感谢大家的关注与支持! 💜💜 网站实战项目 安卓/小程序实战项目 大数据实战项目 深度学习实战项目
目录
- 医院患者问诊数据可视化分析系统介绍
- 医院患者问诊数据可视化分析系统演示视频
- 医院患者问诊数据可视化分析系统演示图片
- 医院患者问诊数据可视化分析系统代码展示
- 医院患者问诊数据可视化分析系统文档展示
医院患者问诊数据可视化分析系统介绍
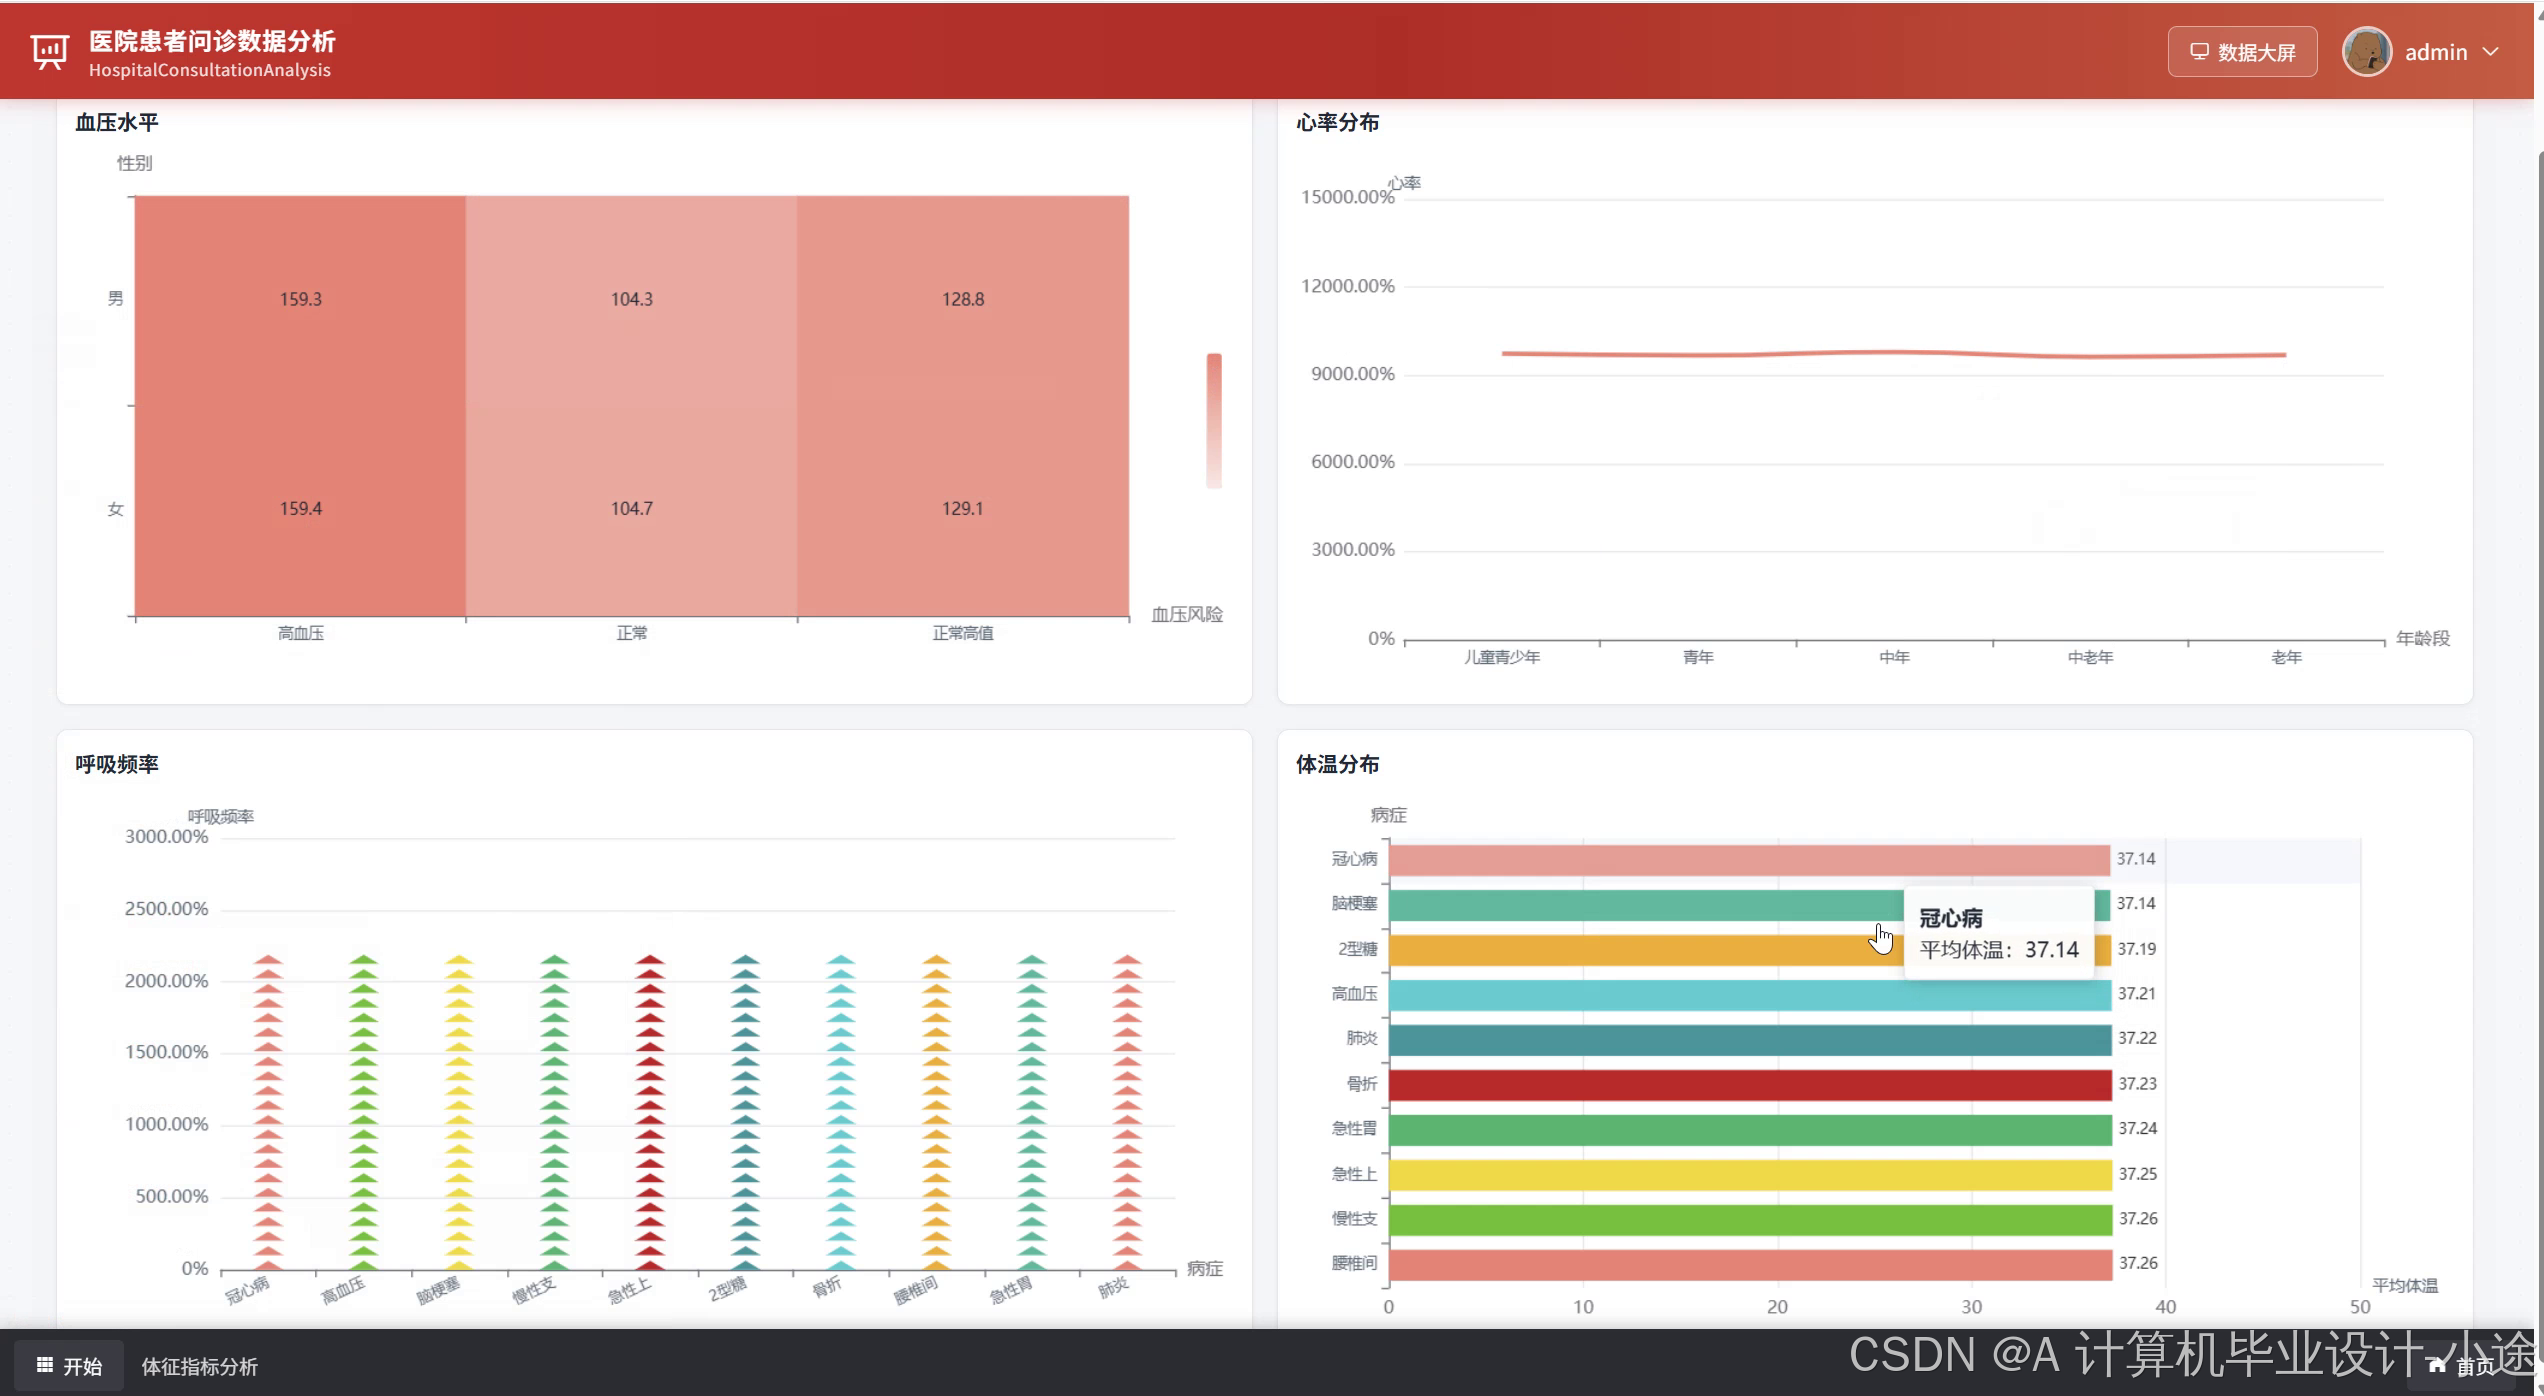
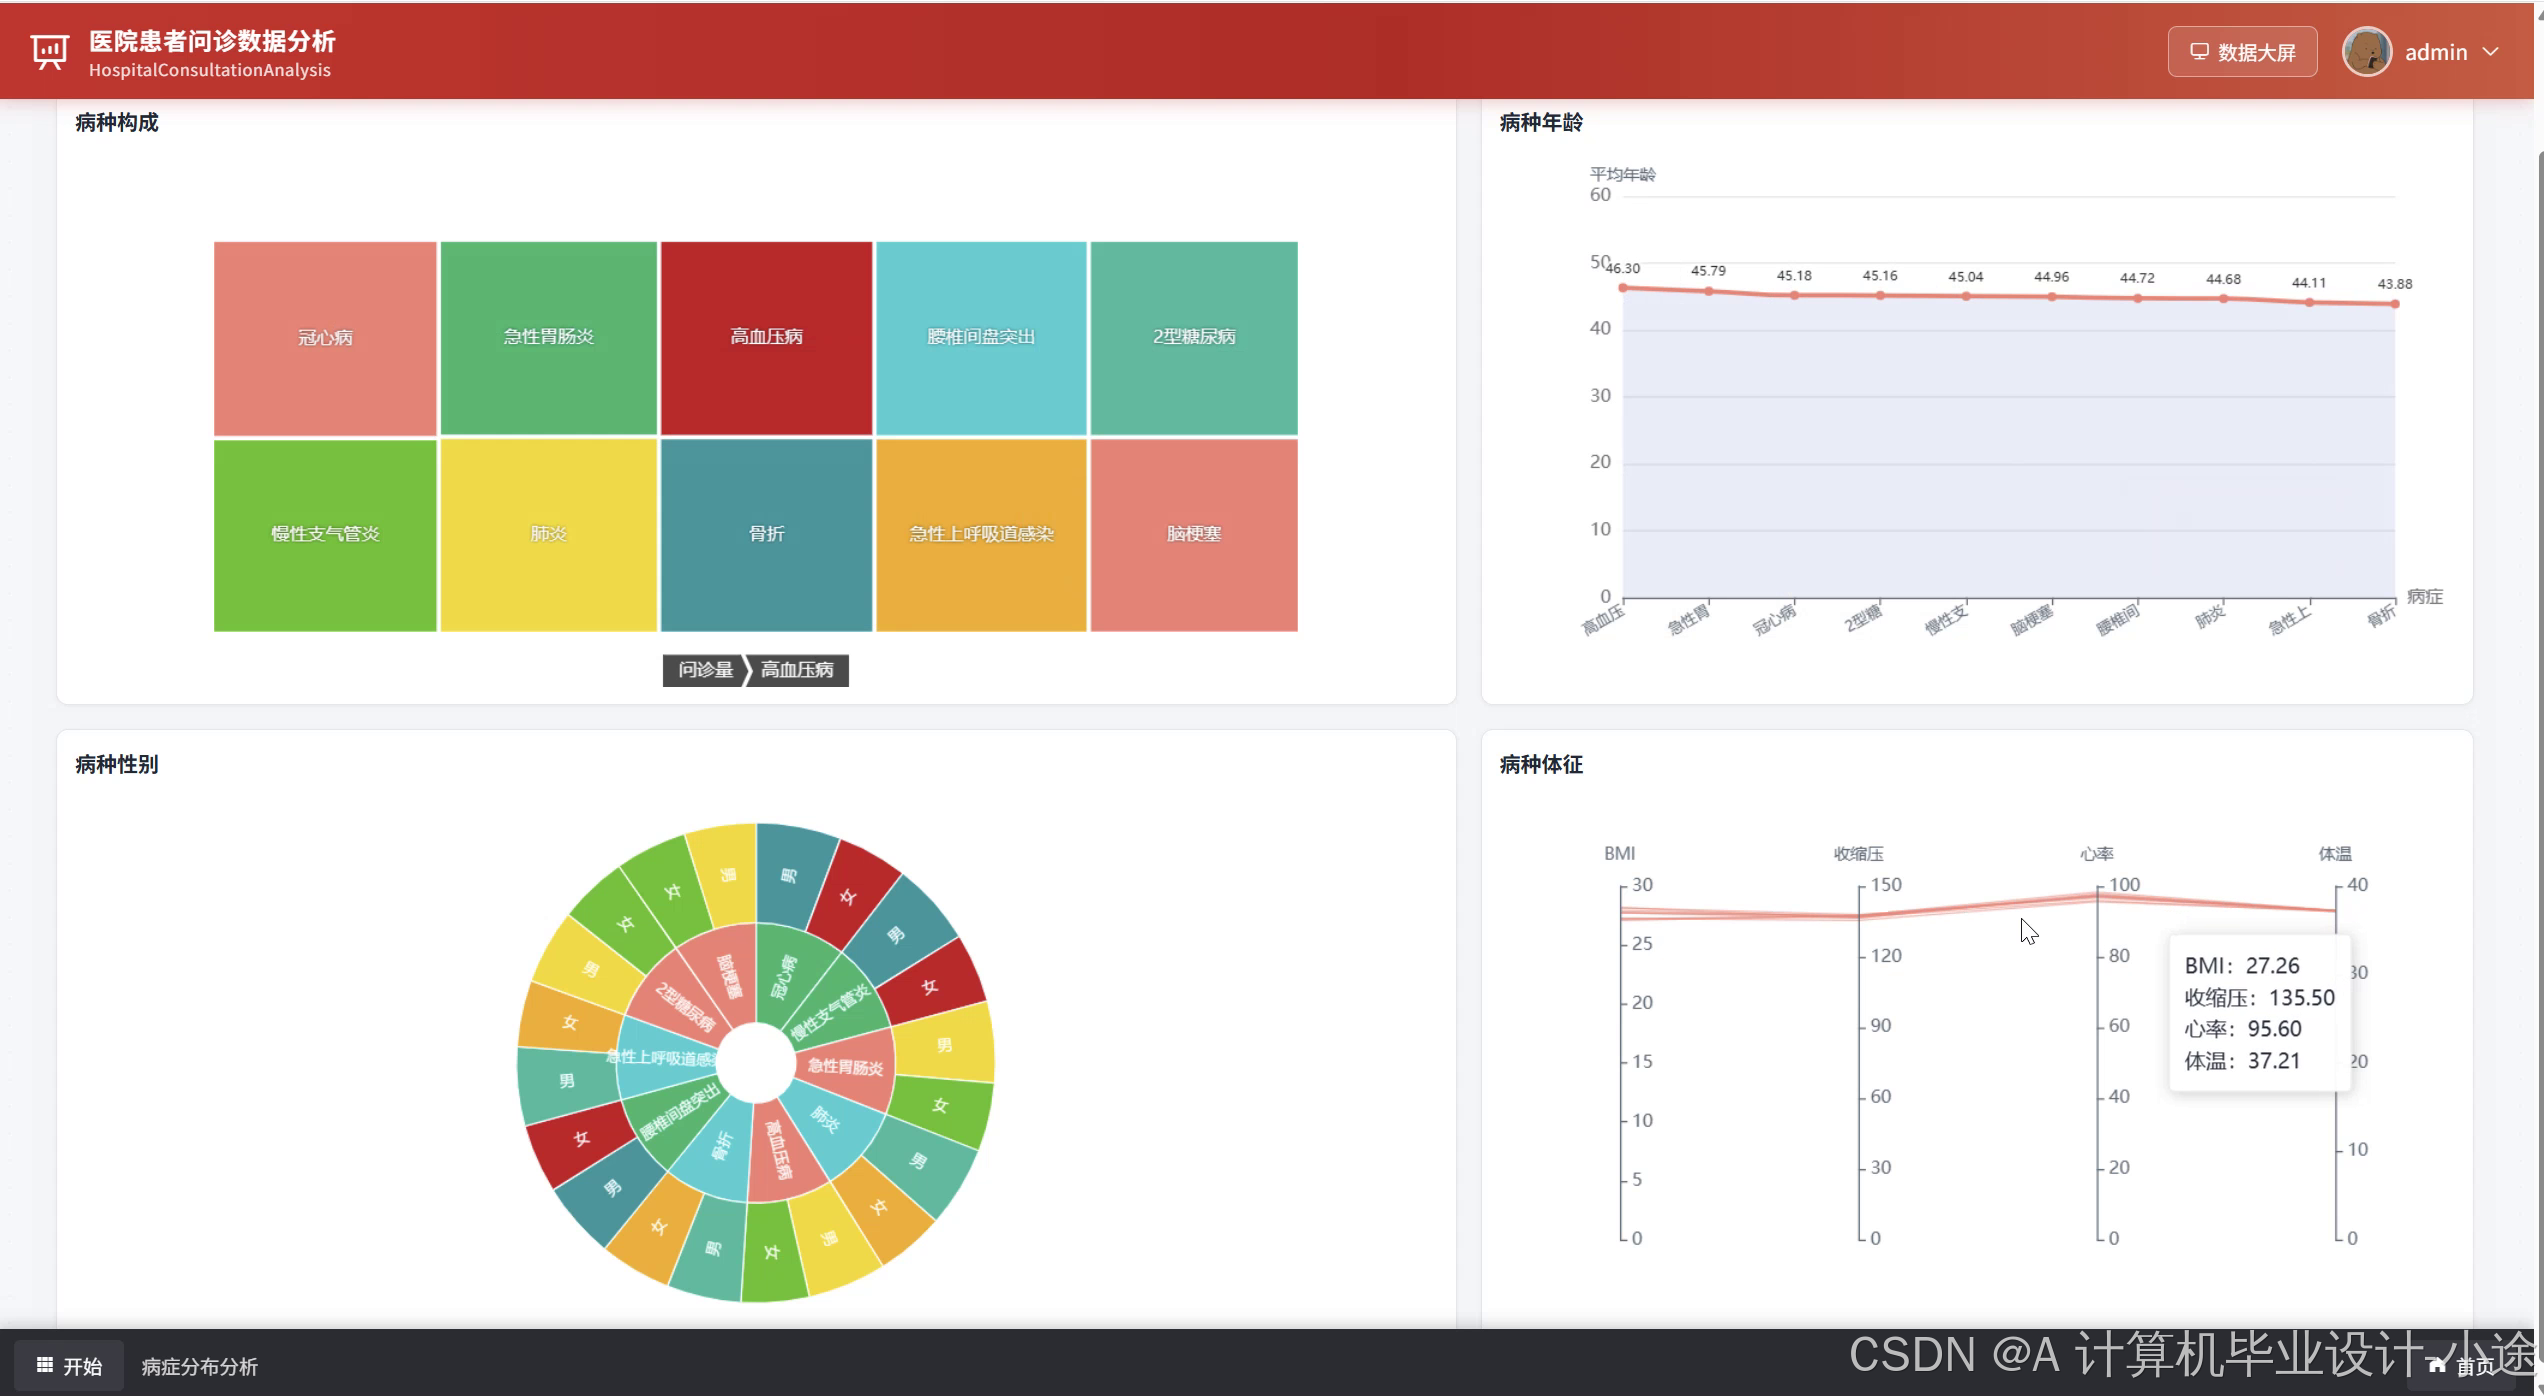
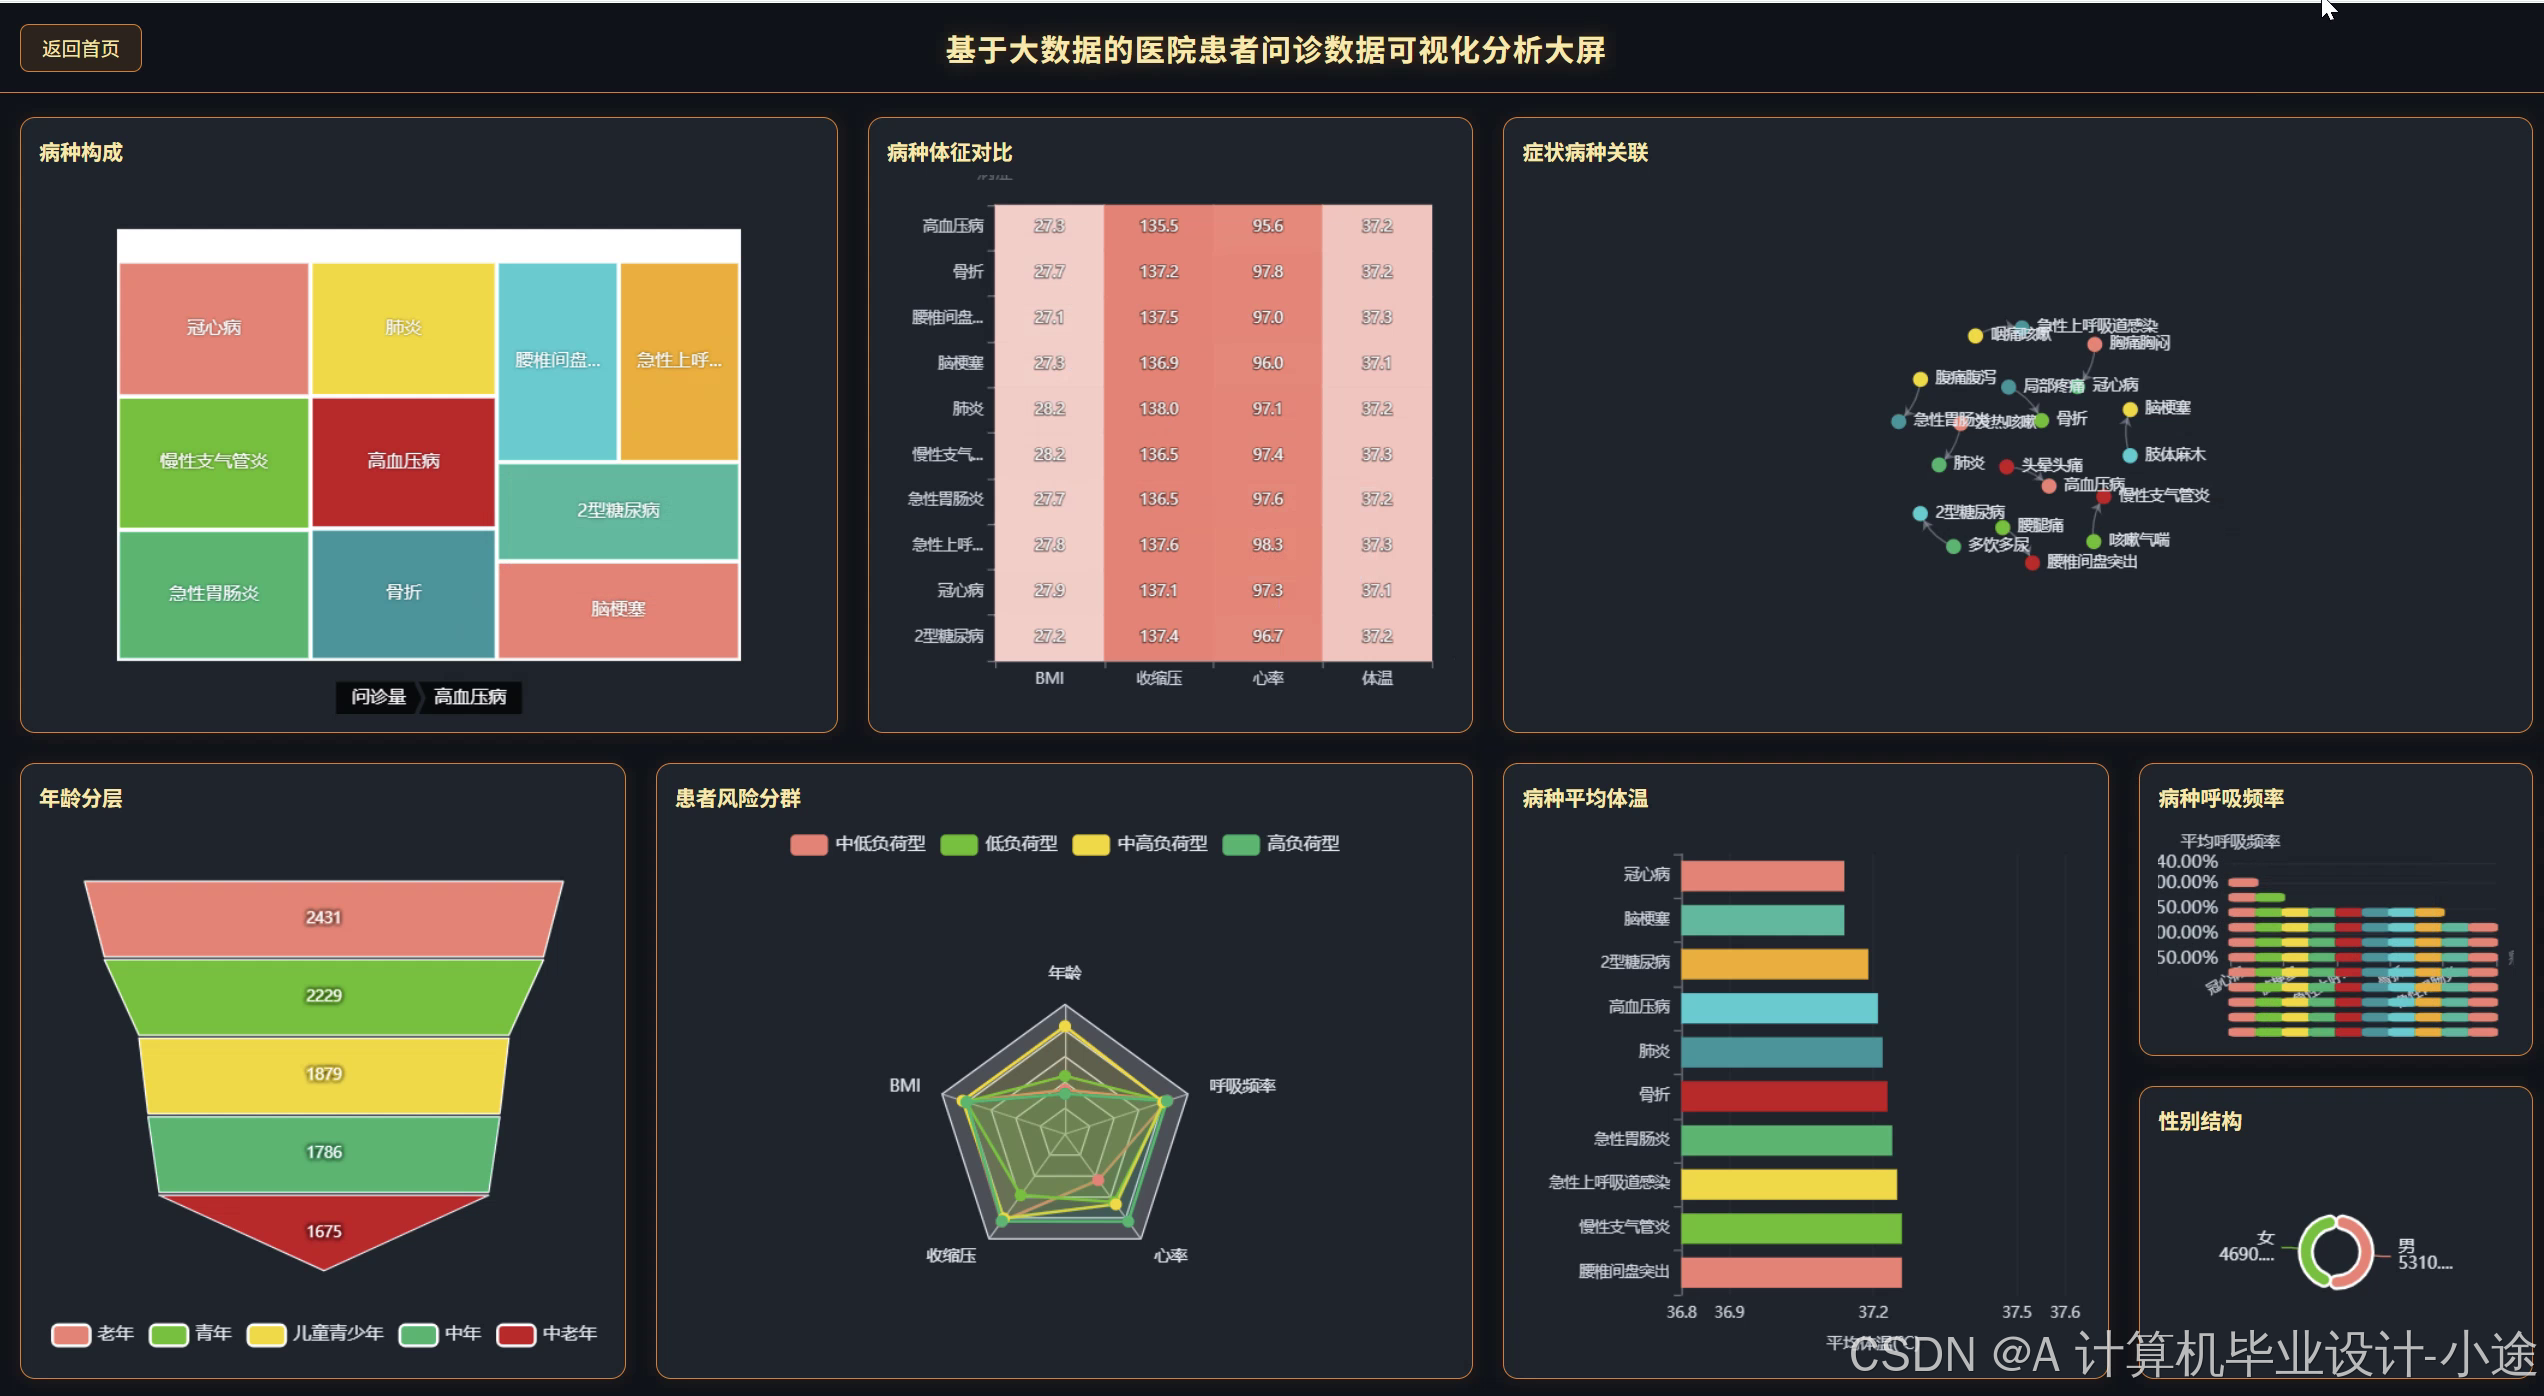
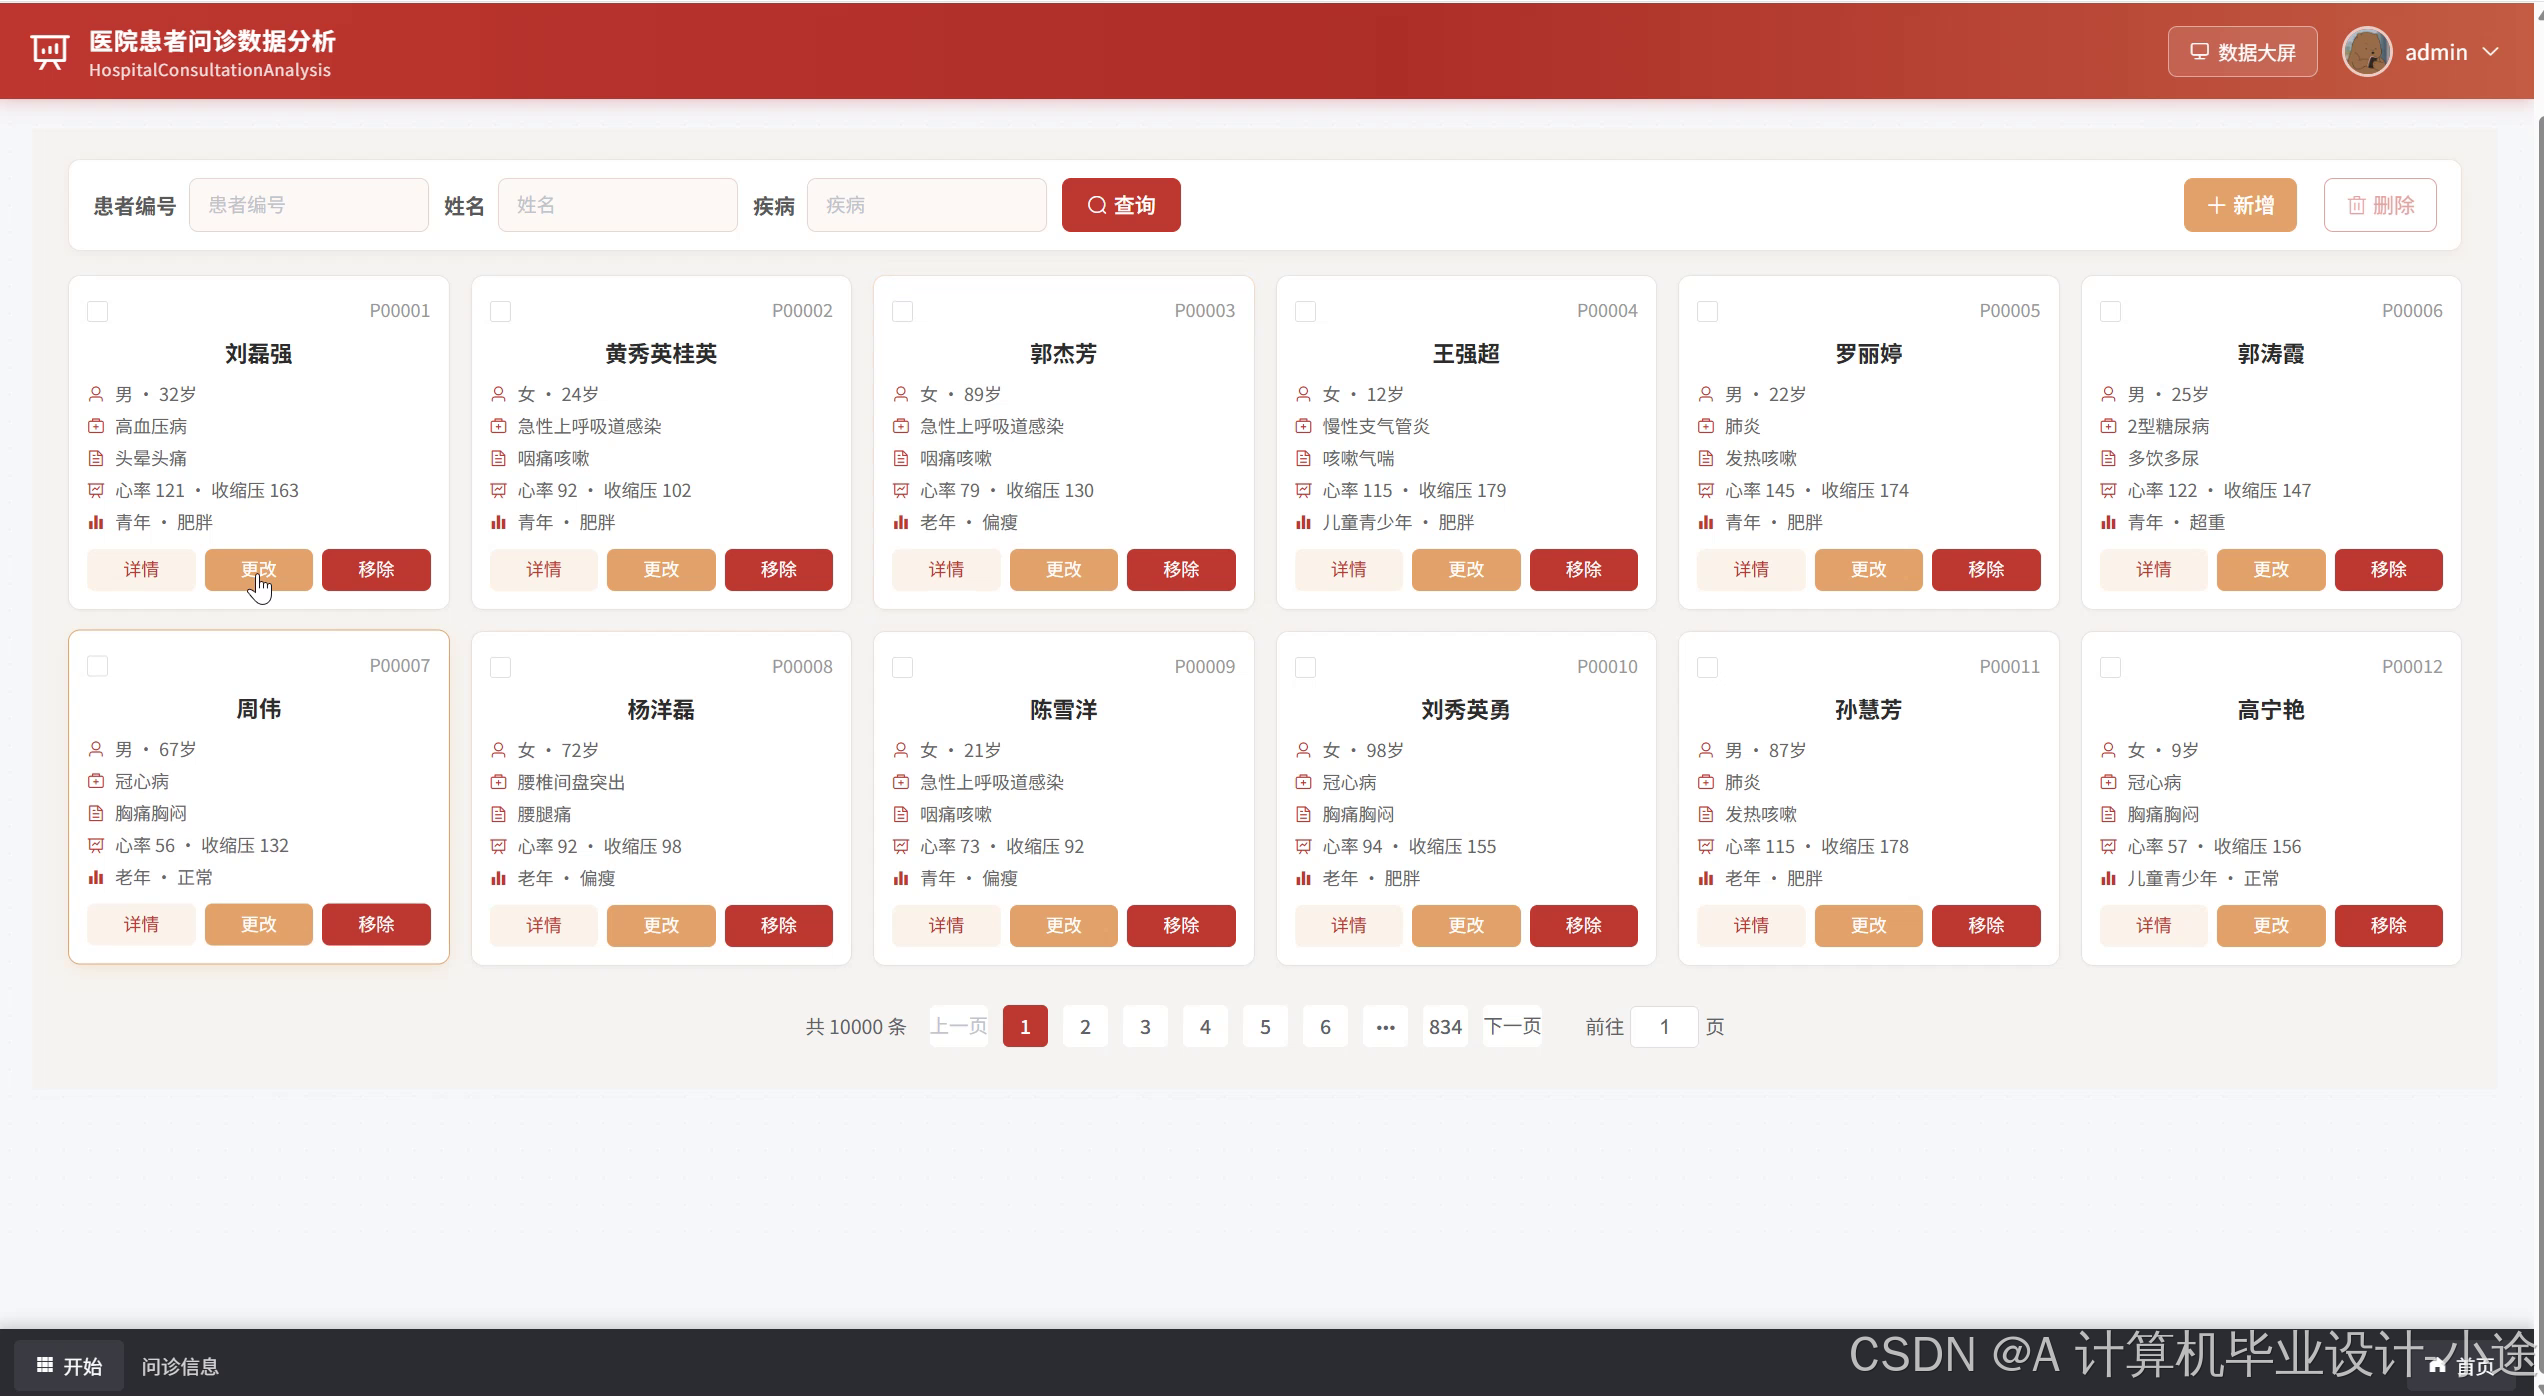
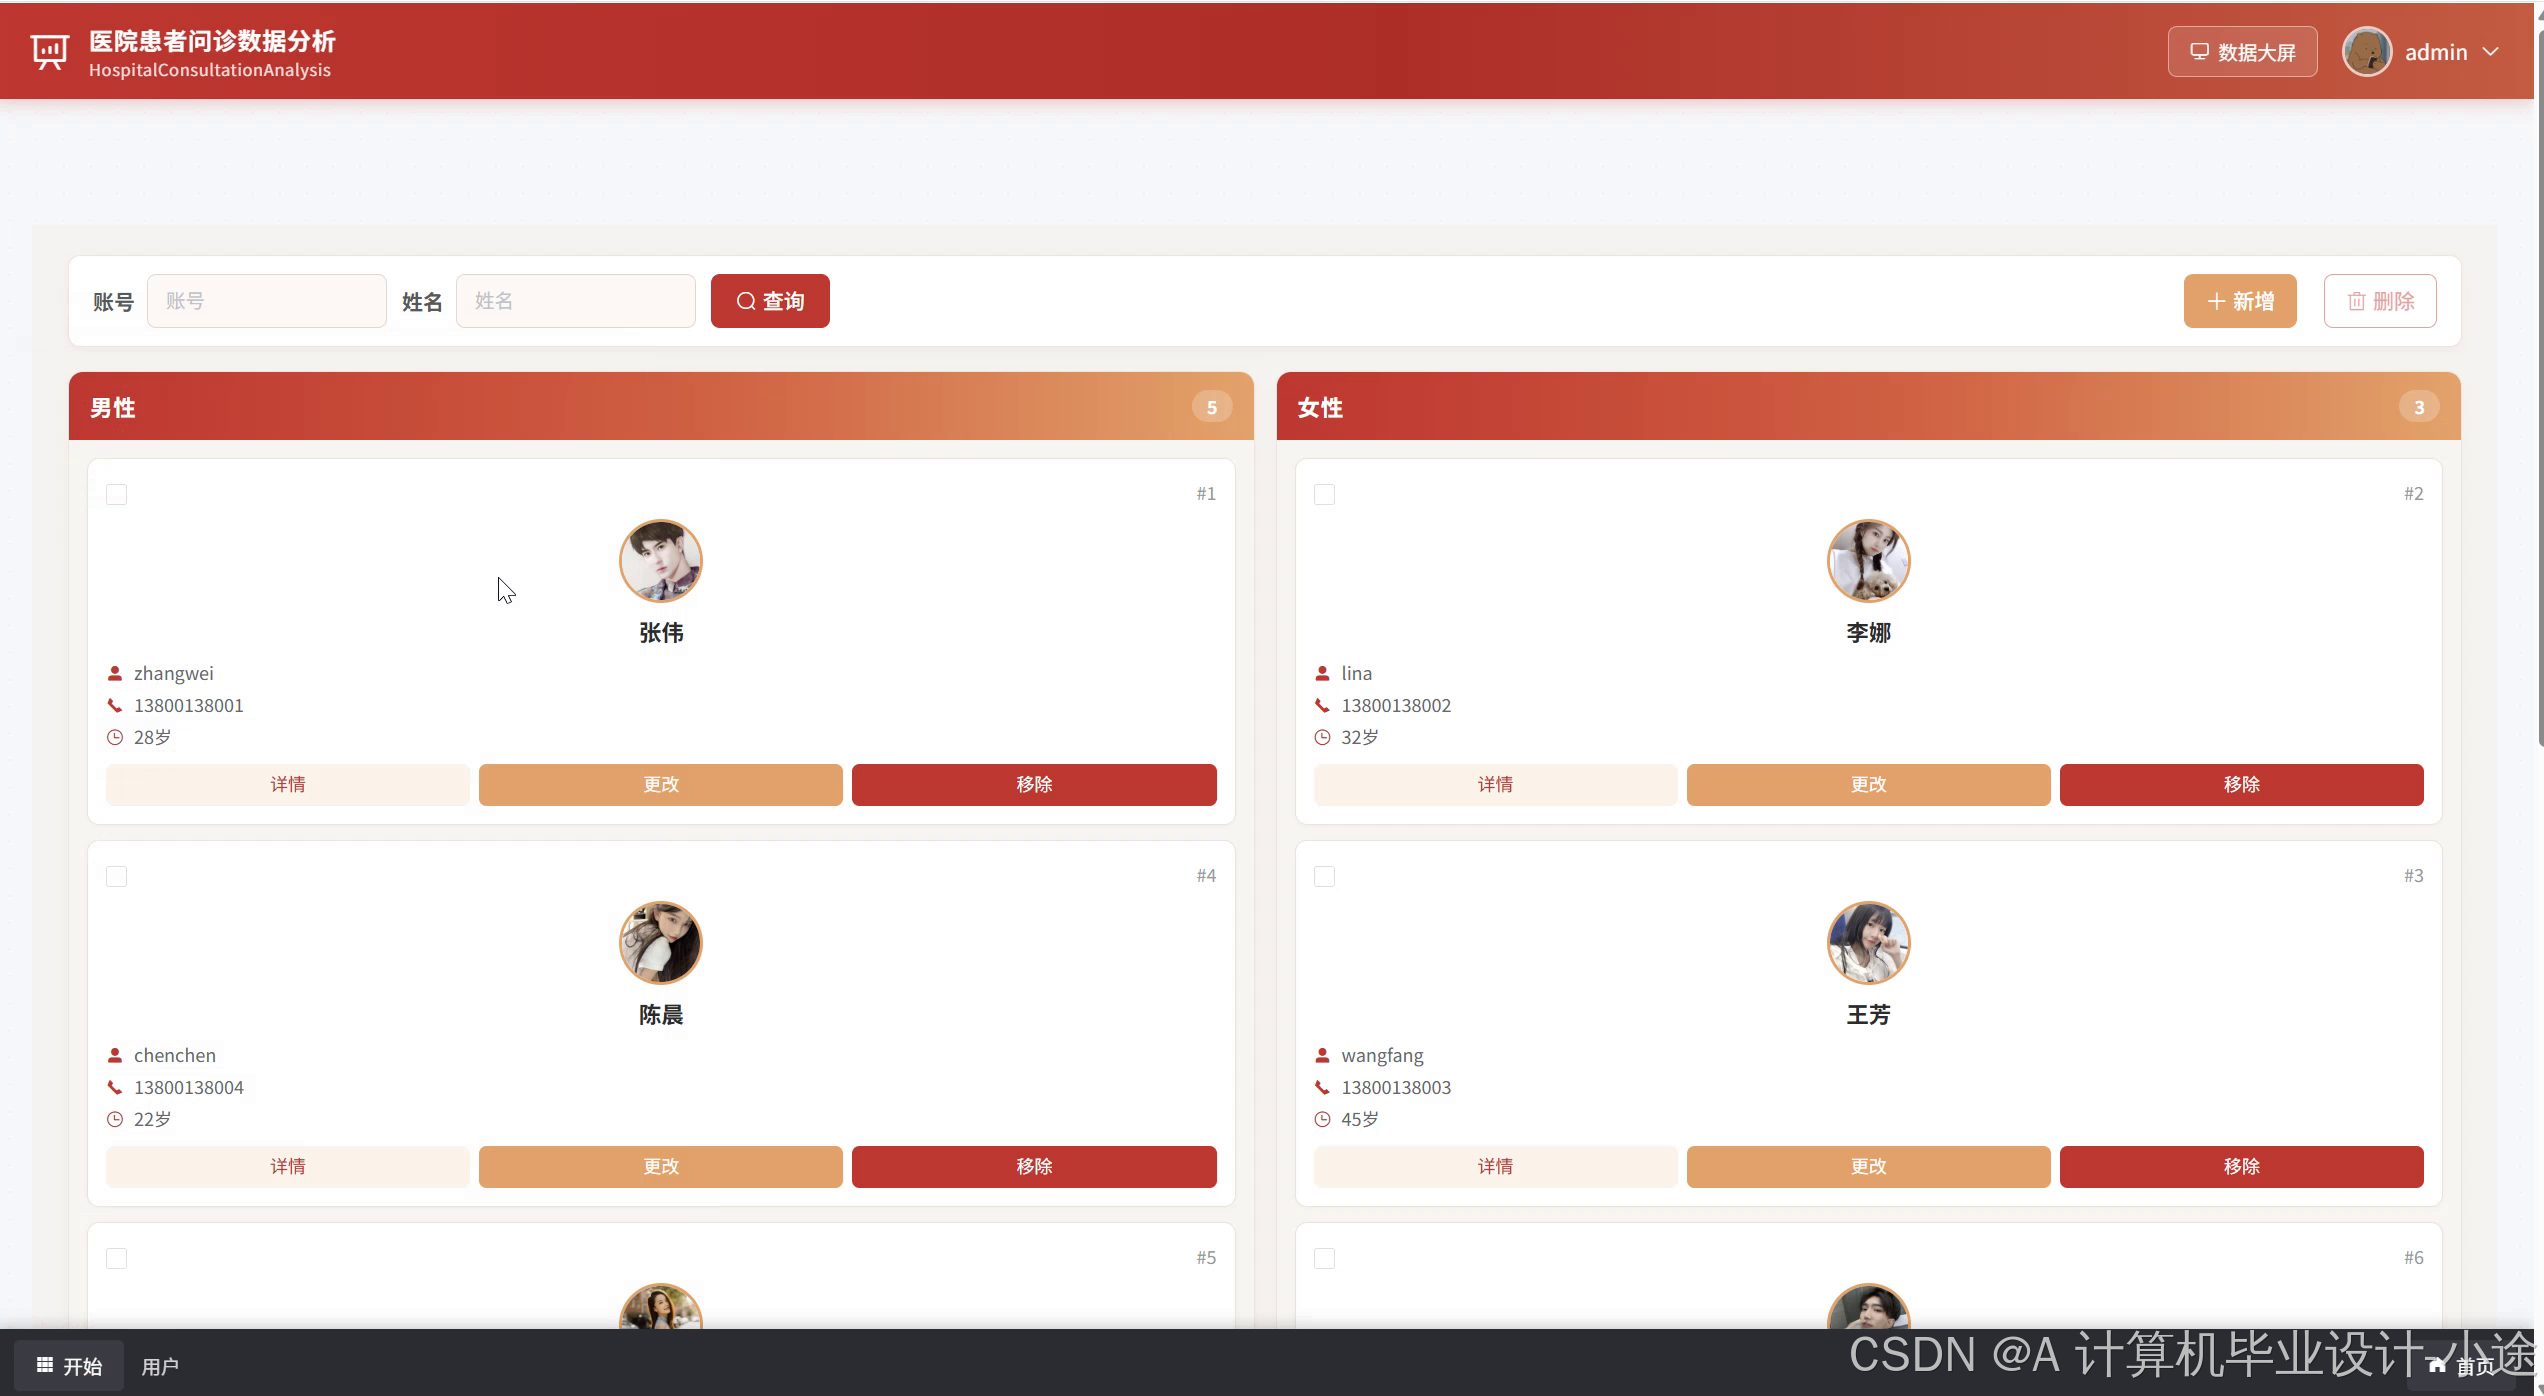
本系统名为《基于大数据的医院患者问诊数据可视化分析》,主要围绕医院问诊数据的整理、统计、分析和可视化展示来设计。系统采用Hadoop+Spark作为大数据处理框架,使用HDFS、Spark SQL、Pandas、NumPy完成问诊数据的读取、清洗、聚合和指标计算,后端提供Python+Django与Java+Spring Boot两个版本,前端使用Vue、ElementUI、Echarts、HTML、CSS、JavaScript、jQuery完成页面交互和图表展示,数据存储使用MySQL。系统包含系统首页、用户、问诊信息、患者画像分析、体征指标分析、病症分布分析、诊疗方案分析、主诉症状分析、风险分群分析、数据大屏、个人信息、修改密码等功能。通过问诊信息和体征指标等数据,系统可以展示患者画像、病症分布、主诉症状和风险分群等分析结果,用图表方式呈现给用户,方便查看和对比。整个系统围绕问诊数据的采集、统计、分析和可视化展开,重点体现Hadoop+Spark在问诊数据分析中的处理过程,适合作为计算机专业毕设项目进行学习和实践。
医院患者问诊数据可视化分析系统演示视频
点击链接观看下面演示视频
医院患者问诊数据可视化分析系统演示图片
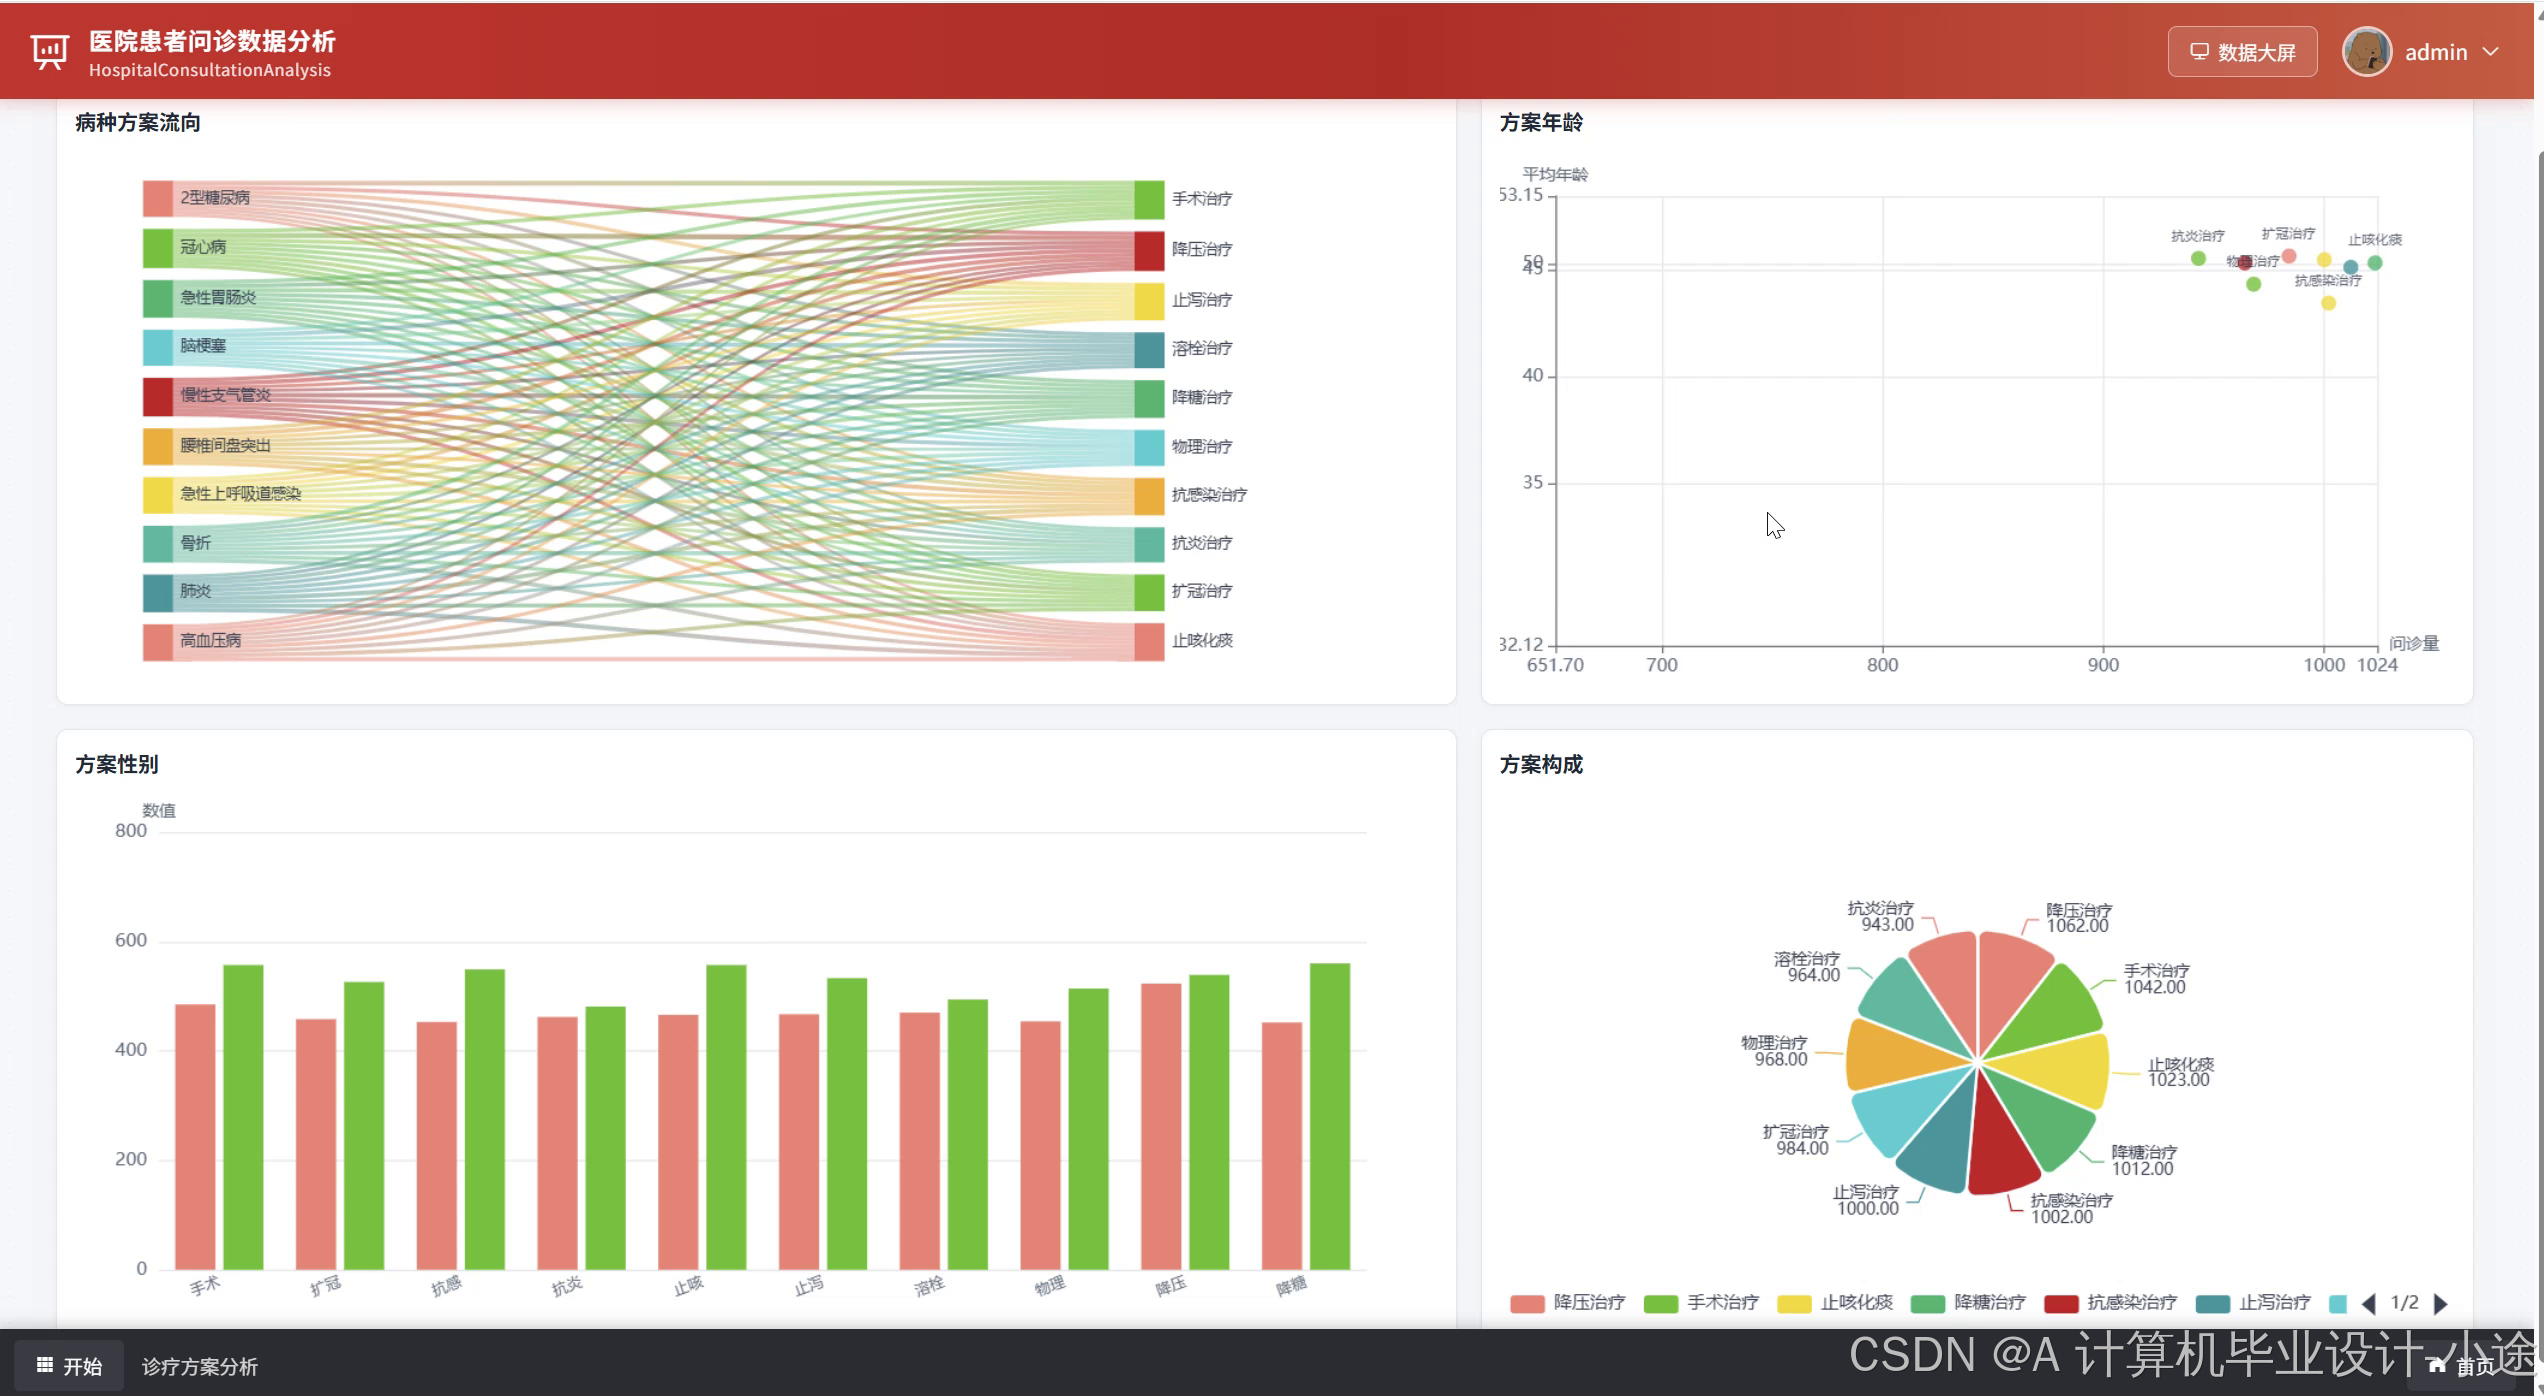
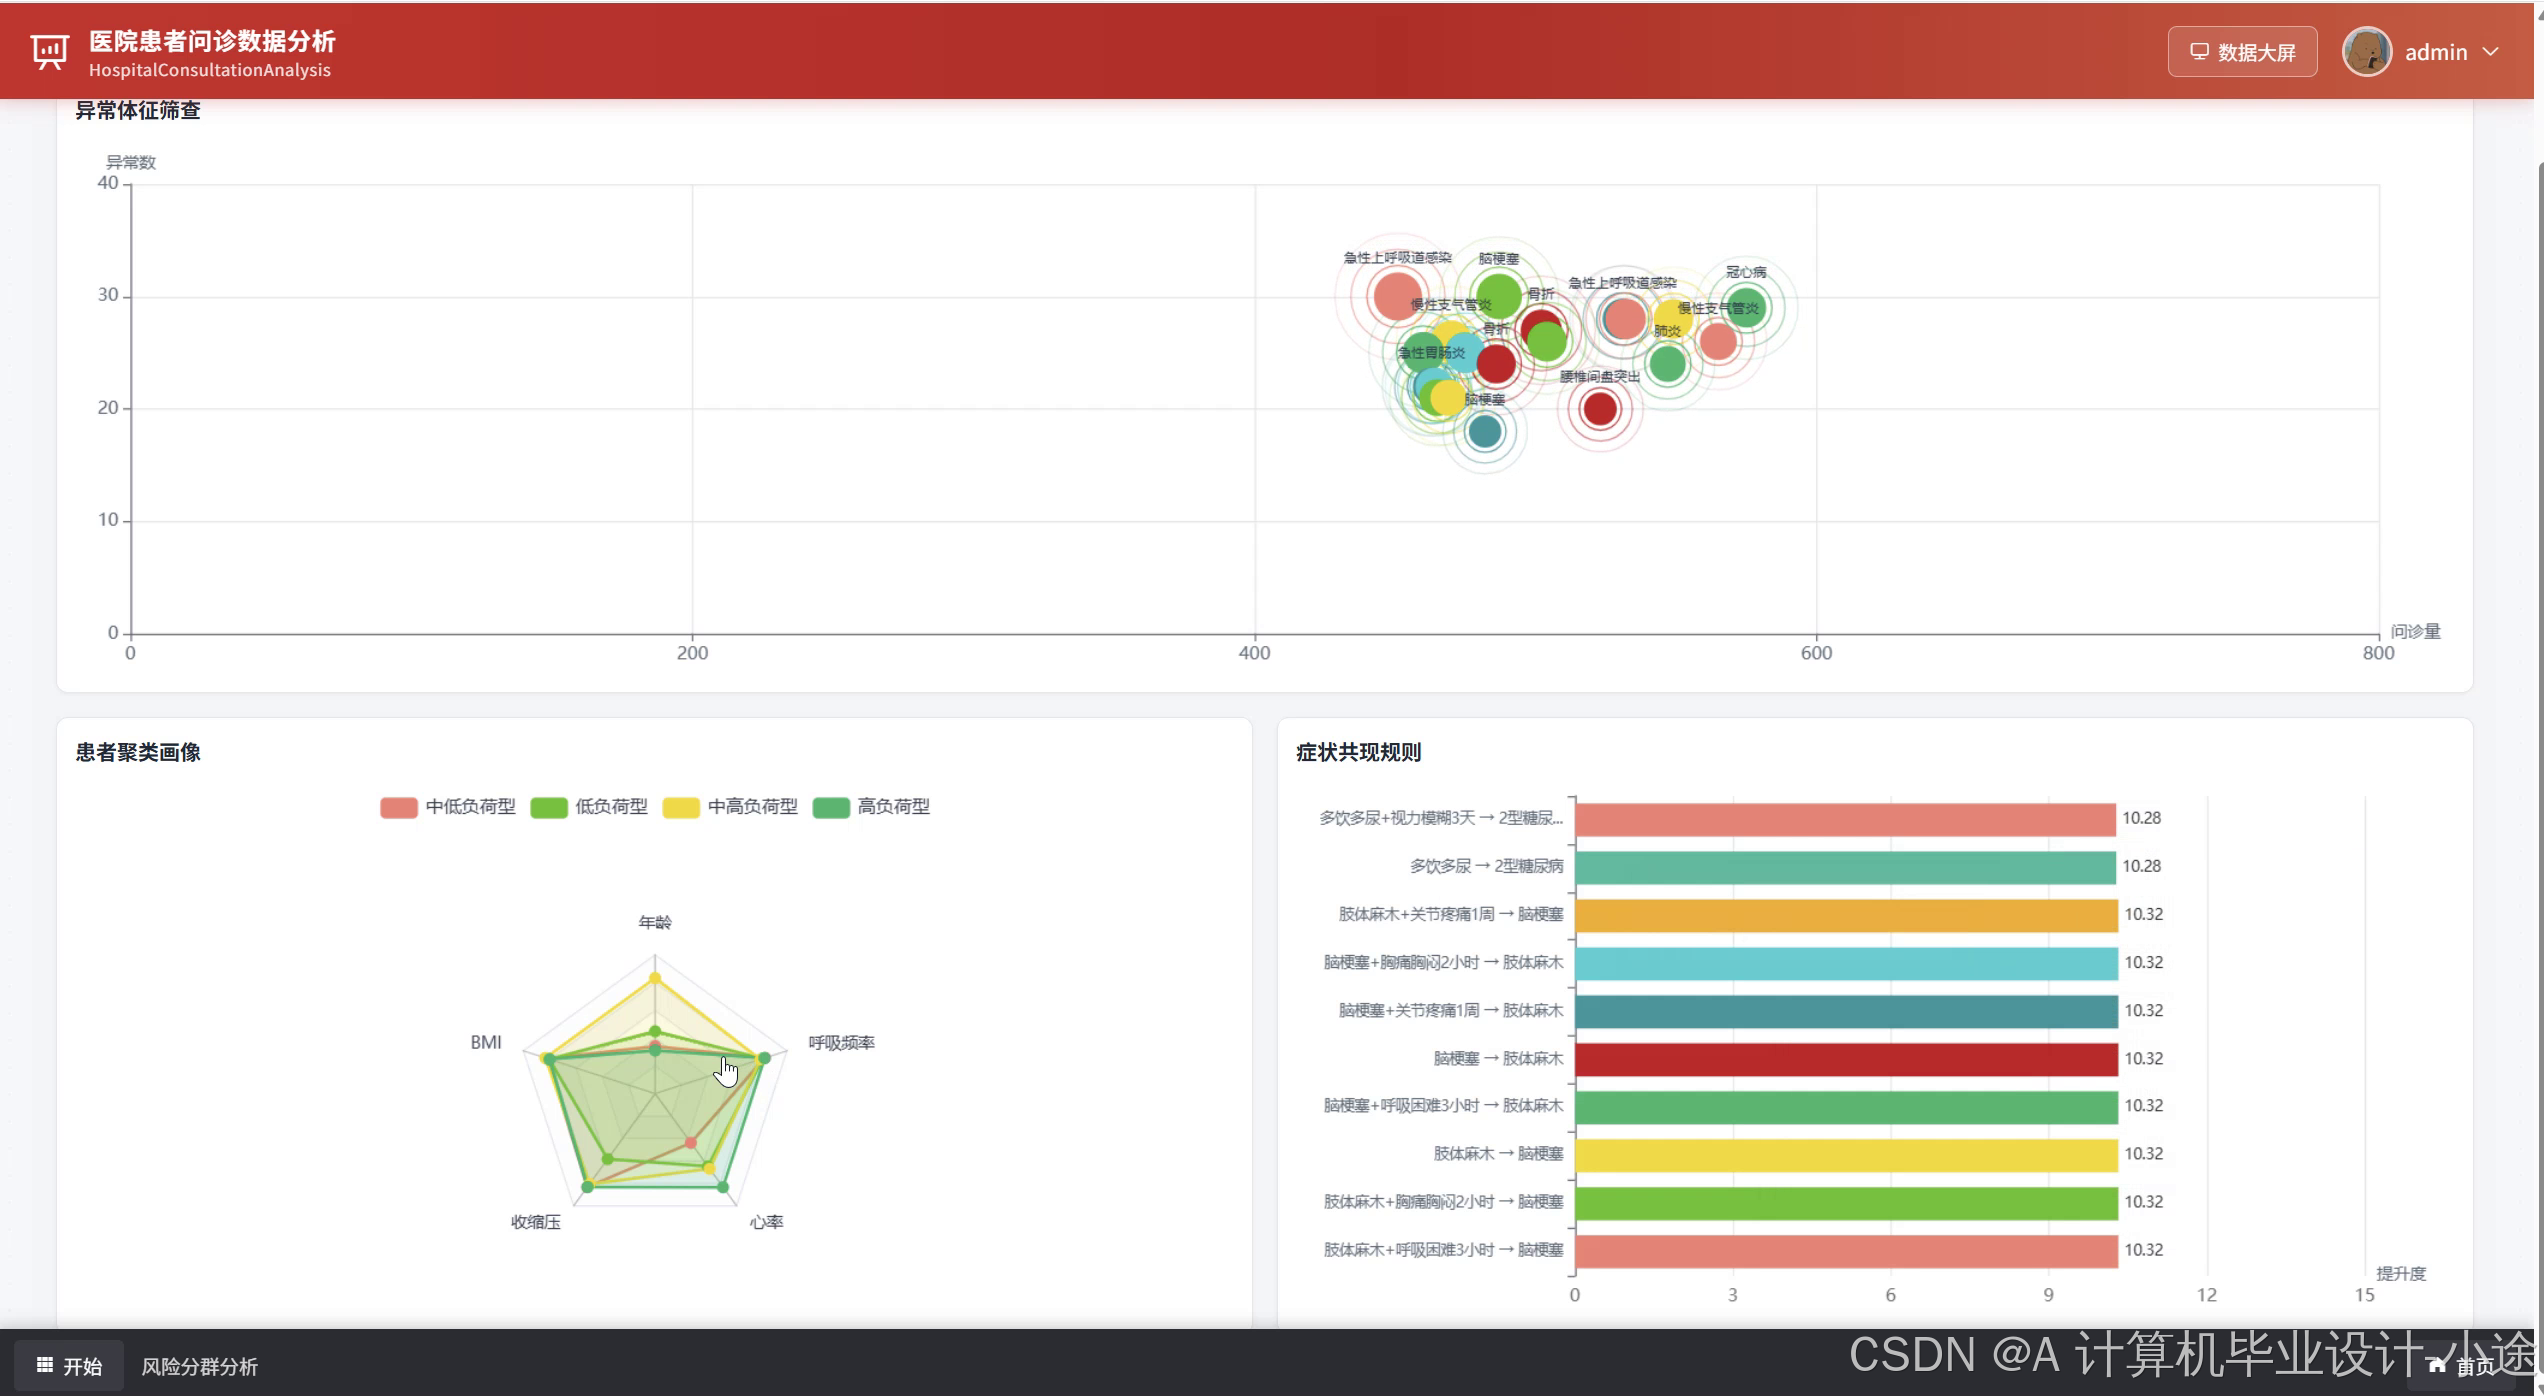
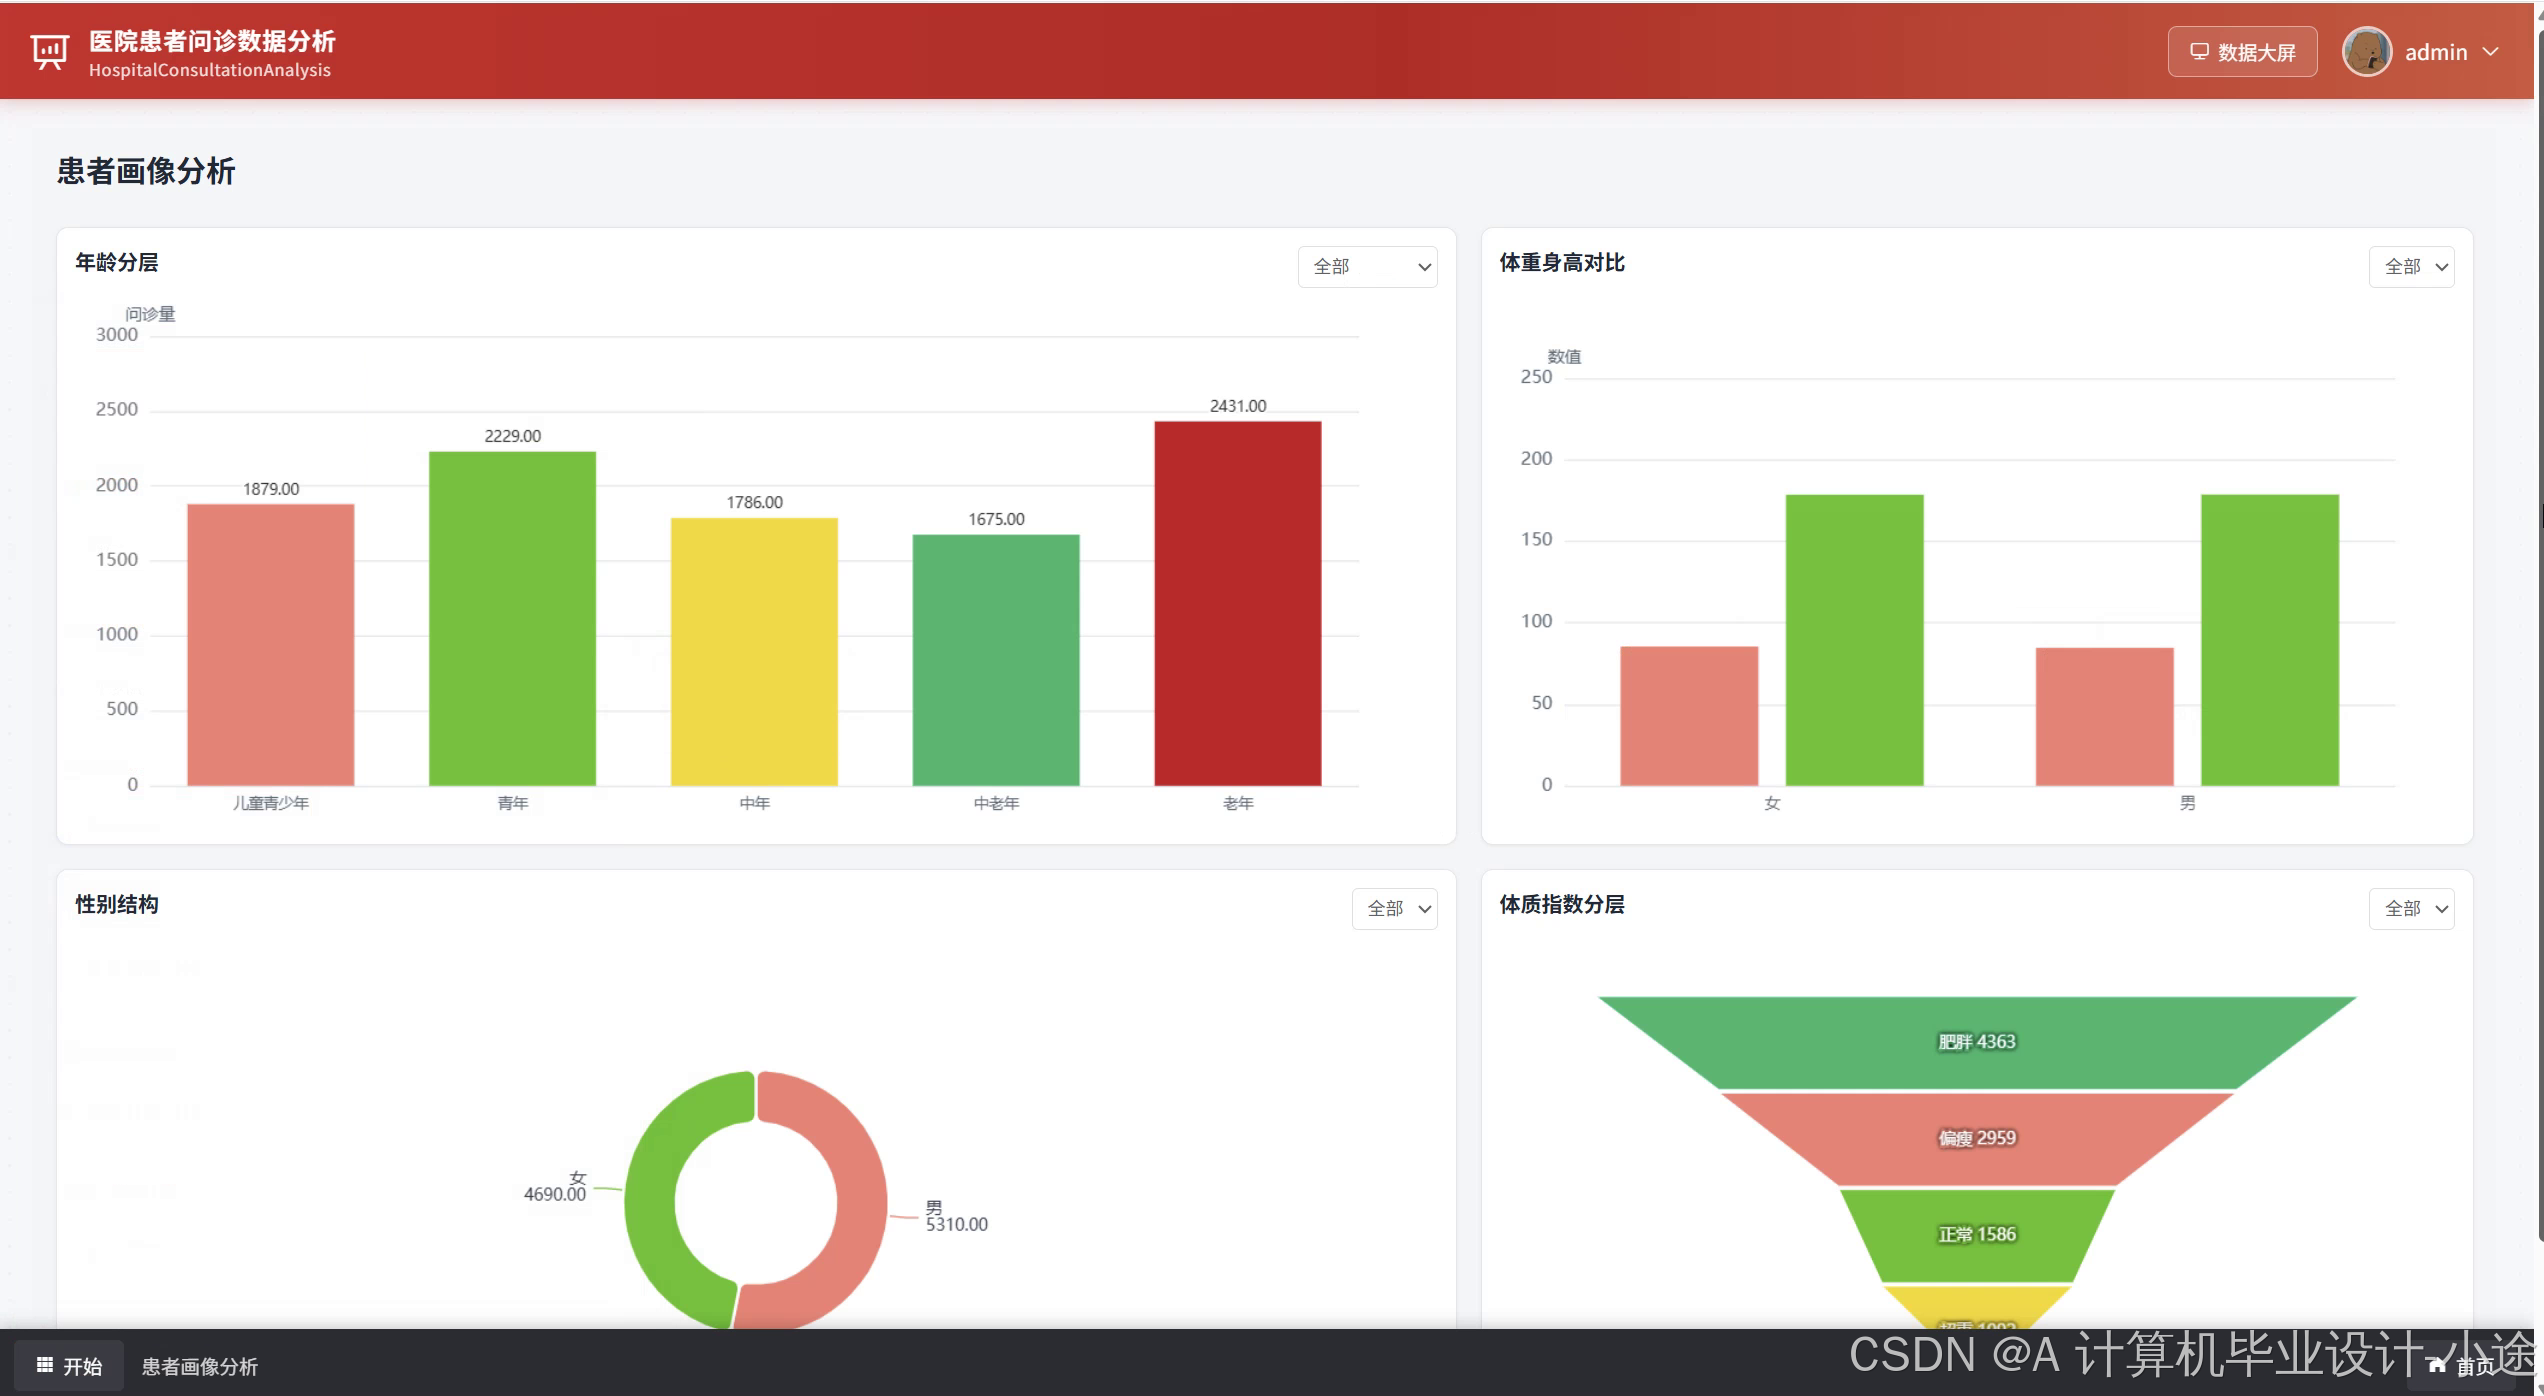
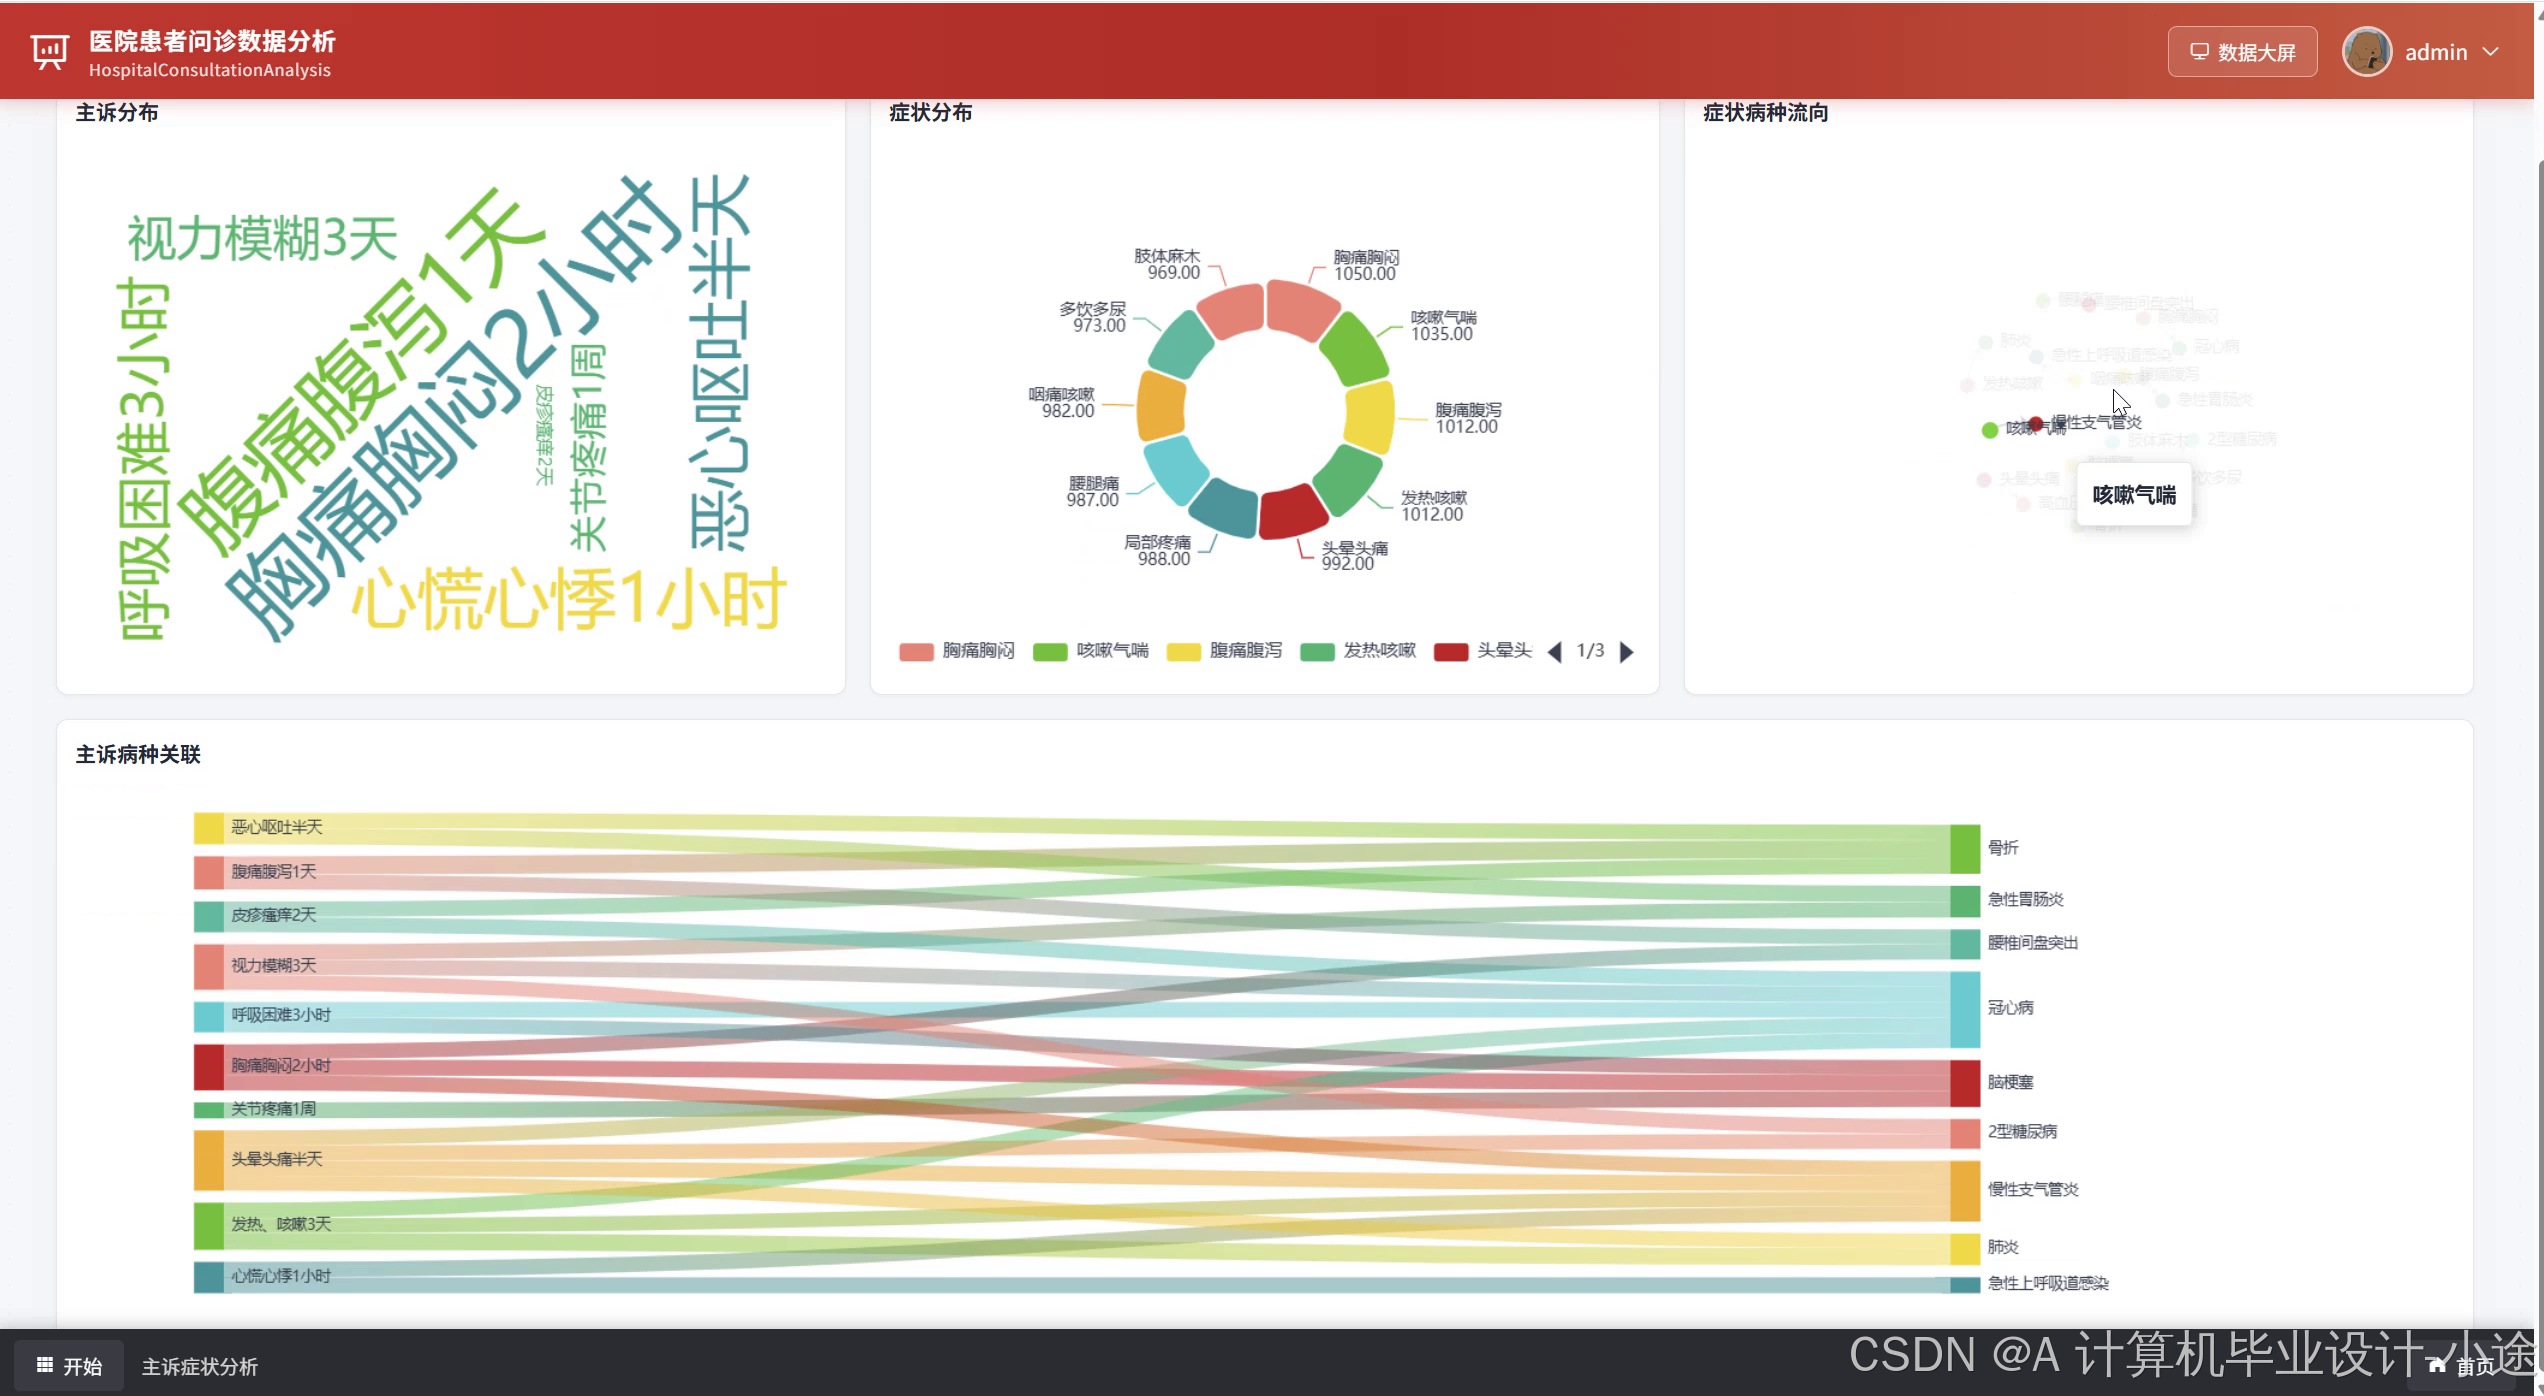
医院患者问诊数据可视化分析系统代码展示
from pyspark.sql import SparkSession
spark = SparkSession.builder.appName("HospitalConsultationBigData").master("local[*]").config("spark.sql.shuffle.partitions", "4").getOrCreate()
def patient_profile_analysis(request):
df = spark.read.format("jdbc").option("url", "jdbc:mysql://localhost:3306/hospital_consult").option("dbtable", "consultation_info").option("user", "root").option("password", "123456").load()
df.createOrReplaceTempView("consultation_info")
profile_df = spark.sql("""
SELECT patient_id,
gender,
CASE WHEN age < 18 THEN '少年'
WHEN age >= 18 AND age <= 35 THEN '青年'
WHEN age >= 36 AND age <= 55 THEN '中年'
ELSE '老年' END AS age_group,
COUNT(*) AS consult_count,
ROUND(AVG(temperature), 2) AS avg_temperature,
ROUND(AVG(heart_rate), 2) AS avg_heart_rate,
ROUND(AVG(systolic_pressure), 2) AS avg_pressure,
CONCAT_WS('、', COLLECT_SET(main_symptom)) AS symptom_text,
CASE WHEN COUNT(*) >= 3 THEN '高频问诊' ELSE '常规问诊' END AS profile_tag
FROM consultation_info
GROUP BY patient_id, gender, age
""")
profile_df.write.mode("overwrite").format("jdbc").option("url", "jdbc:mysql://localhost:3306/hospital_consult").option("dbtable", "patient_profile_result").option("user", "root").option("password", "123456").save()
return {"status": "success", "message": "患者画像分析完成"}
def disease_distribution_analysis(request):
df = spark.read.format("jdbc").option("url", "jdbc:mysql://localhost:3306/hospital_consult").option("dbtable", "consultation_info").option("user", "root").option("password", "123456").load()
df.createOrReplaceTempView("consultation_info")
total_df = spark.sql("SELECT COUNT(*) AS total_count FROM consultation_info WHERE diagnosis IS NOT NULL")
total_df.createOrReplaceTempView("total_count_view")
dist_df = spark.sql("""
SELECT c.diagnosis,
COUNT(*) AS case_count,
COUNT(DISTINCT c.patient_id) AS patient_count,
ROUND(COUNT(*) * 100.0 / t.total_count, 2) AS case_ratio,
ROUND(AVG(c.age), 1) AS avg_age,
SUM(CASE WHEN c.age < 18 THEN 1 ELSE 0 END) AS youth_count,
SUM(CASE WHEN c.age >= 18 AND c.age <= 35 THEN 1 ELSE 0 END) AS young_count,
SUM(CASE WHEN c.age >= 36 AND c.age <= 55 THEN 1 ELSE 0 END) AS middle_count,
SUM(CASE WHEN c.age > 55 THEN 1 ELSE 0 END) AS old_count
FROM consultation_info c
CROSS JOIN total_count_view t
WHERE c.diagnosis IS NOT NULL
GROUP BY c.diagnosis, t.total_count
ORDER BY case_count DESC
""")
dist_df.write.mode("overwrite").format("jdbc").option("url", "jdbc:mysql://localhost:3306/hospital_consult").option("dbtable", "disease_distribution_result").option("user", "root").option("password", "123456").save()
return {"status": "success", "message": "病症分布分析完成"}
def risk_group_analysis(request):
df = spark.read.format("jdbc").option("url", "jdbc:mysql://localhost:3306/hospital_consult").option("dbtable", "consultation_info").option("user", "root").option("password", "123456").load()
df.createOrReplaceTempView("consultation_info")
risk_df = spark.sql("""
SELECT patient_id,
diagnosis,
temperature,
heart_rate,
systolic_pressure,
(CASE WHEN temperature >= 38.5 THEN 2 ELSE 0 END
+ CASE WHEN heart_rate >= 100 THEN 2 ELSE 0 END
+ CASE WHEN systolic_pressure >= 140 THEN 2 ELSE 0 END
+ CASE WHEN age >= 60 THEN 1 ELSE 0 END
+ CASE WHEN diagnosis IN ('重症肺炎', '急性心梗', '脑出血') THEN 3 ELSE 0 END) AS risk_score,
CASE WHEN (CASE WHEN temperature >= 38.5 THEN 2 ELSE 0 END
+ CASE WHEN heart_rate >= 100 THEN 2 ELSE 0 END
+ CASE WHEN systolic_pressure >= 140 THEN 2 ELSE 0 END
+ CASE WHEN age >= 60 THEN 1 ELSE 0 END
+ CASE WHEN diagnosis IN ('重症肺炎', '急性心梗', '脑出血') THEN 3 ELSE 0 END) >= 6 THEN '高风险'
WHEN (CASE WHEN temperature >= 38.5 THEN 2 ELSE 0 END
+ CASE WHEN heart_rate >= 100 THEN 2 ELSE 0 END
+ CASE WHEN systolic_pressure >= 140 THEN 2 ELSE 0 END
+ CASE WHEN age >= 60 THEN 1 ELSE 0 END
+ CASE WHEN diagnosis IN ('重症肺炎', '急性心梗', '脑出血') THEN 3 ELSE 0 END) >= 3 THEN '中风险'
ELSE '低风险' END AS risk_group
FROM consultation_info
""")
risk_df.createOrReplaceTempView("risk_detail_view")
group_df = spark.sql("""
SELECT risk_group,
COUNT(*) AS patient_count,
ROUND(COUNT(*) * 100.0 / SUM(COUNT(*)) OVER (), 2) AS group_ratio,
ROUND(AVG(risk_score), 2) AS avg_risk_score
FROM risk_detail_view
GROUP BY risk_group
""")
group_df.write.mode("overwrite").format("jdbc").option("url", "jdbc:mysql://localhost:3306/hospital_consult").option("dbtable", "risk_group_result").option("user", "root").option("password", "123456").save()
risk_df.write.mode("overwrite").format("jdbc").option("url", "jdbc:mysql://localhost:3306/hospital_consult").option("dbtable", "risk_detail_result").option("user", "root").option("password", "123456").save()
return {"status": "success", "message": "风险分群分析完成"}
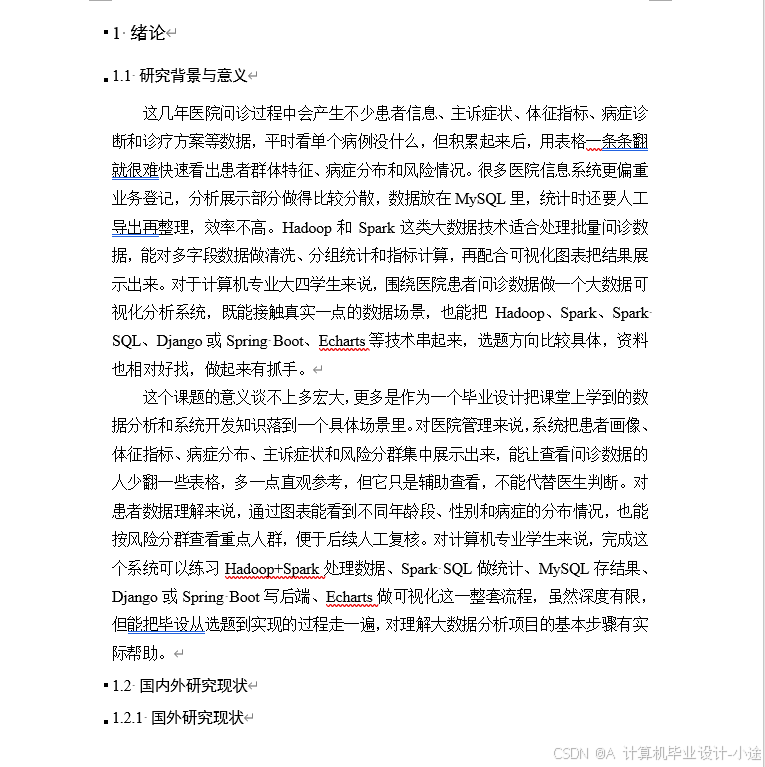
医院患者问诊数据可视化分析系统文档展示
💖💖作者:计算机毕业设计小途 💙💙个人简介:曾长期从事计算机专业培训教学,本人也热爱上课教学,语言擅长Java、微信小程序、Python、Golang、安卓Android等,开发项目包括大数据、深度学习、网站、小程序、安卓、算法。平常会做一些项目定制化开发、代码讲解、答辩教学、文档编写、也懂一些降重方面的技巧。平常喜欢分享一些自己开发中遇到的问题的解决办法,也喜欢交流技术,大家有技术代码这一块的问题可以问我! 💛💛想说的话:感谢大家的关注与支持! 💜💜 网站实战项目 安卓/小程序实战项目 大数据实战项目 深度学习实战项目




评论前必须登录!
注册