 网硕互联帮助中心
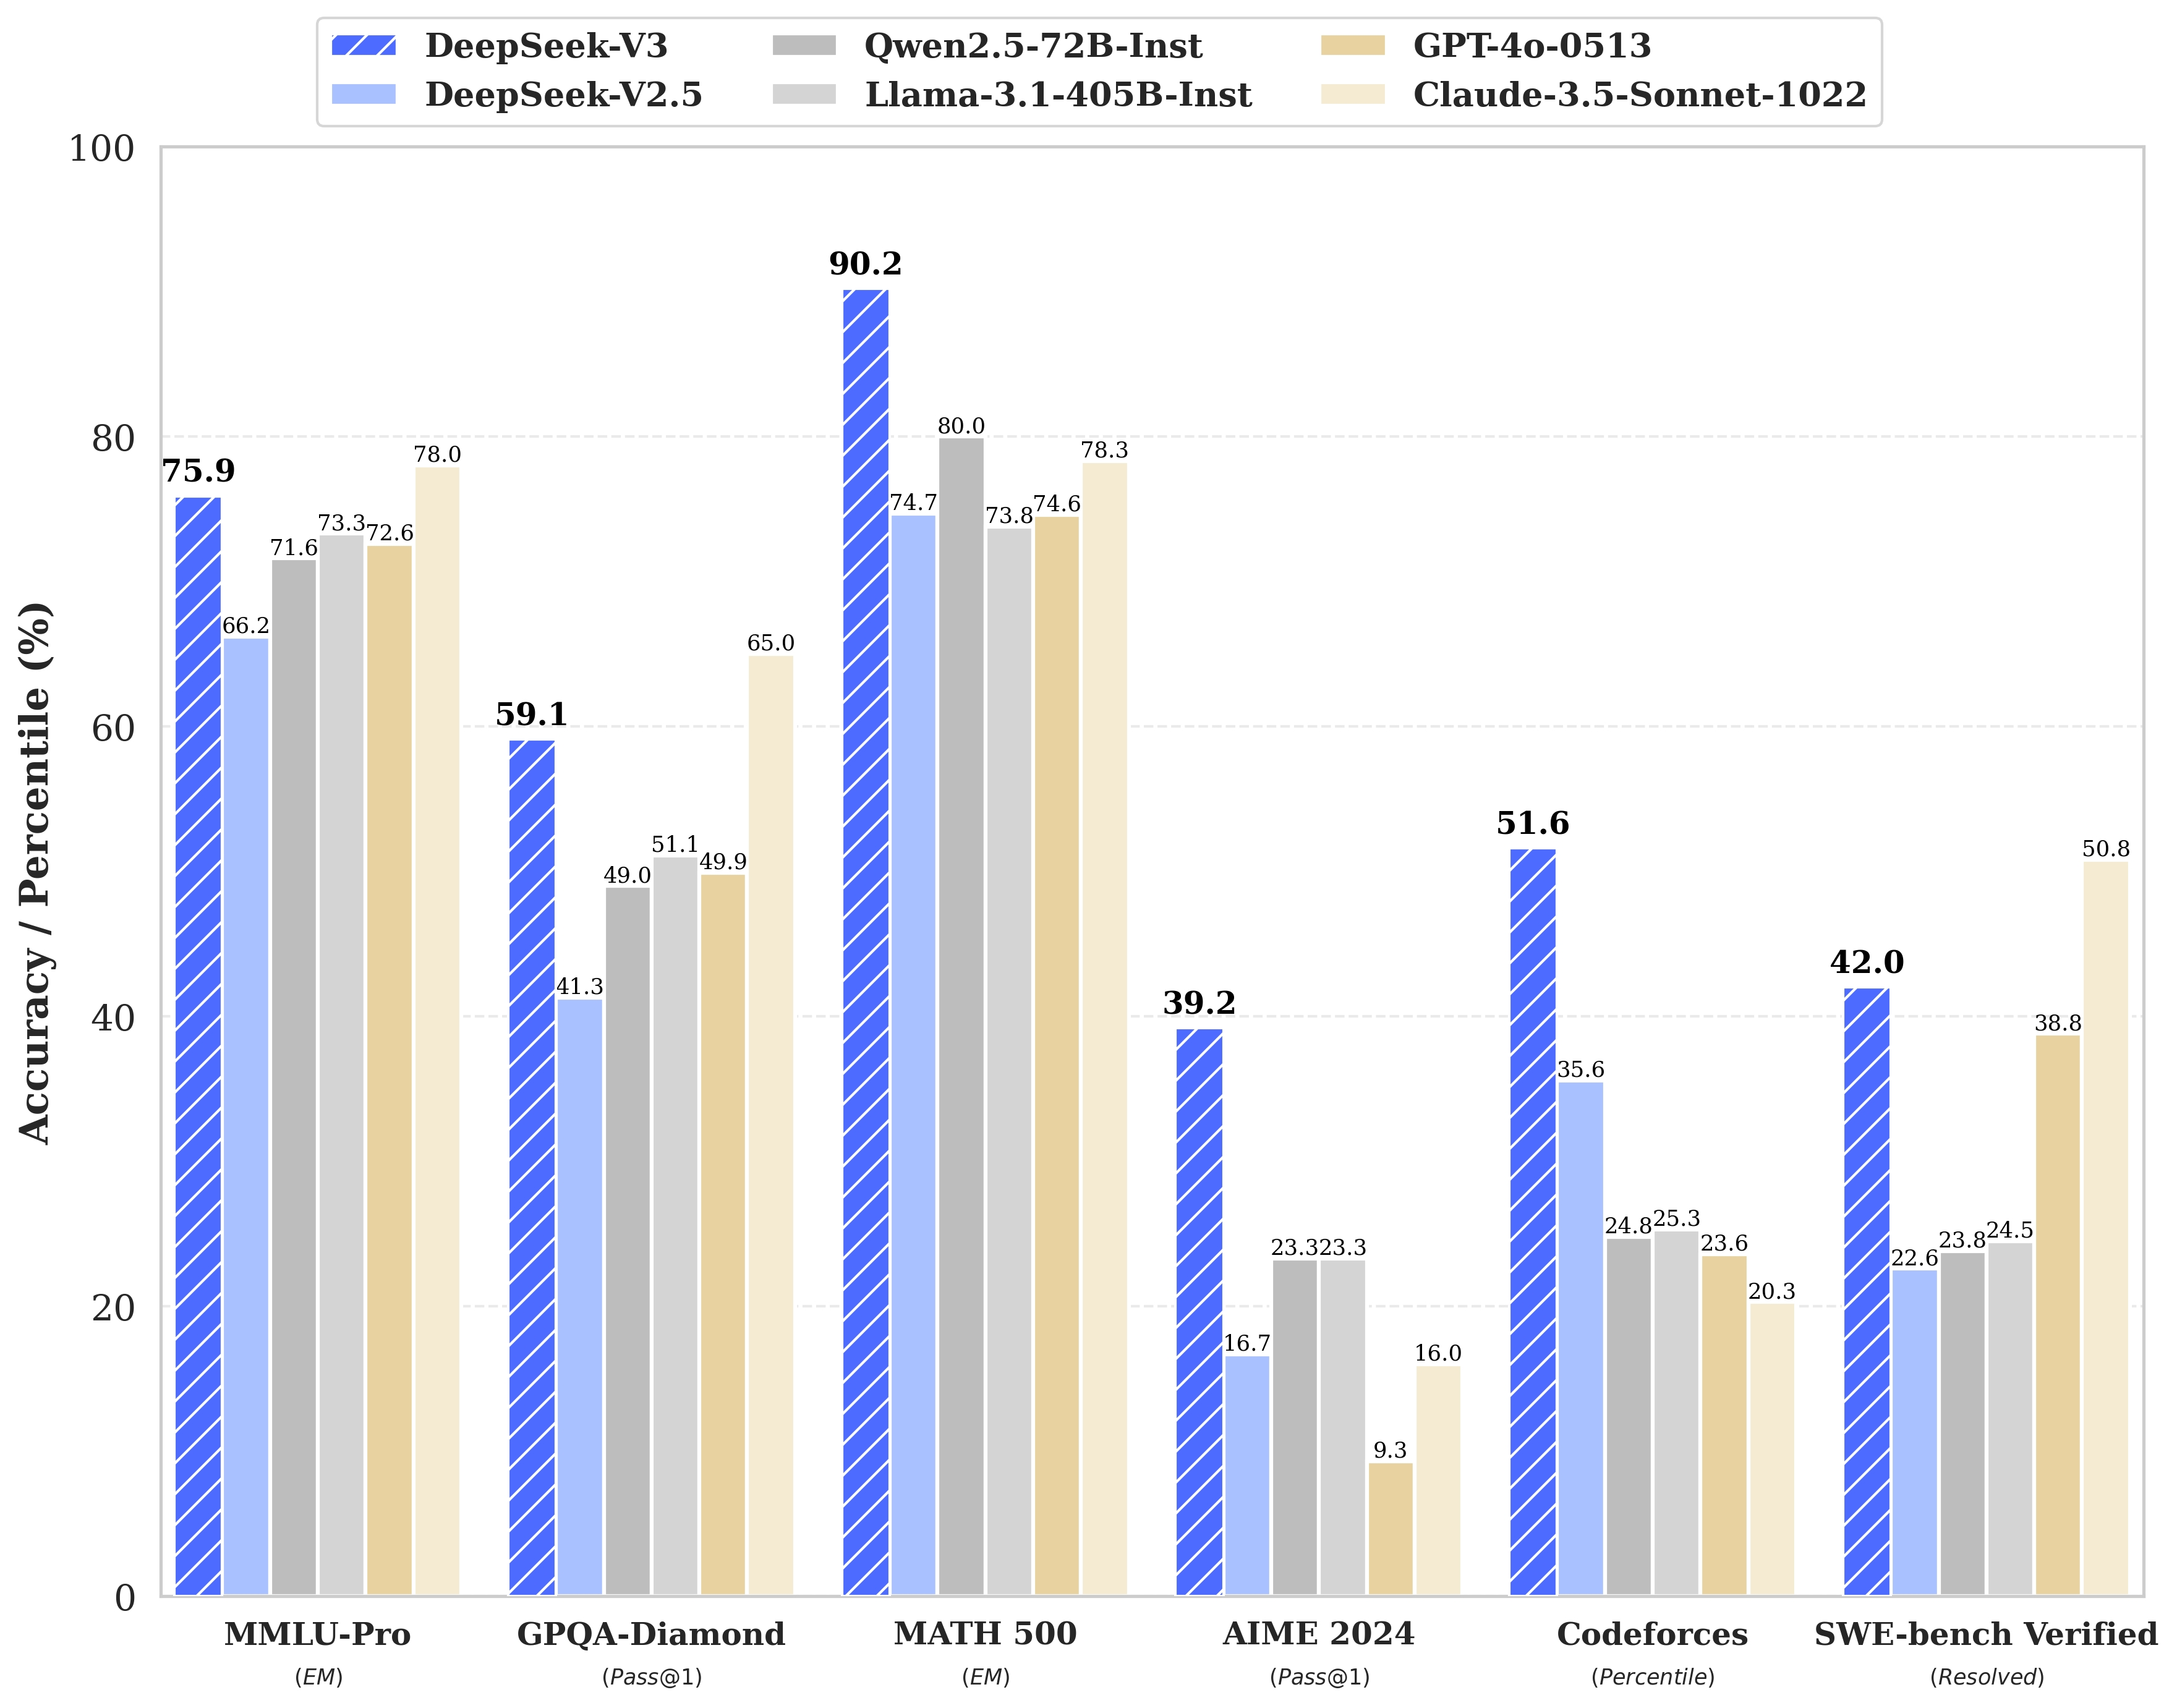
摘要:一个 671B 参数的模型,每个 token 只激活 37B,训练全程 278.8 万 H800 GPU 小时,没有出现一次不可恢复的 loss 尖峰——DeepSeek-V3 用一组近乎“反常识”的数字,把大模型训练从“堆算力”的叙事中拽了出来。本文不满足于列举 MLA、MoE、MTP 这些名词,而是沿着“解耦”这条主线,逐层拆解每一个设计决策背后的约束、取舍与工程实现:为什么 MLA 要把 KV 缓存压进低秩空间,为什么 MoE 要把专家切到 256 个再配上 top-1 路由,为什么 MTP 不是推理加速器而首先是训练信号增稠器,为什么 DualPipe 能把通信“藏”进计算里。最后,回到 1024 程序员节的语境:当“高效”成为 AI 工程的硬约束,我们从 DeepSeek-V3 身上能抄走的不只是某个模块,而是一种在资源边界上做设计的方法论。
1. 一个让硅谷重新算账的数字
2024 年底,DeepSeek-V3 的技术报告给出了一个在当时近乎刺眼的数字:671B 总参数,278.8 万 H800 GPU 小时,按 $2/卡时估算约 558 万美元。作为对照,同等参数规模的稠密模型,训练成本通常是这个数字的数倍到数十倍。
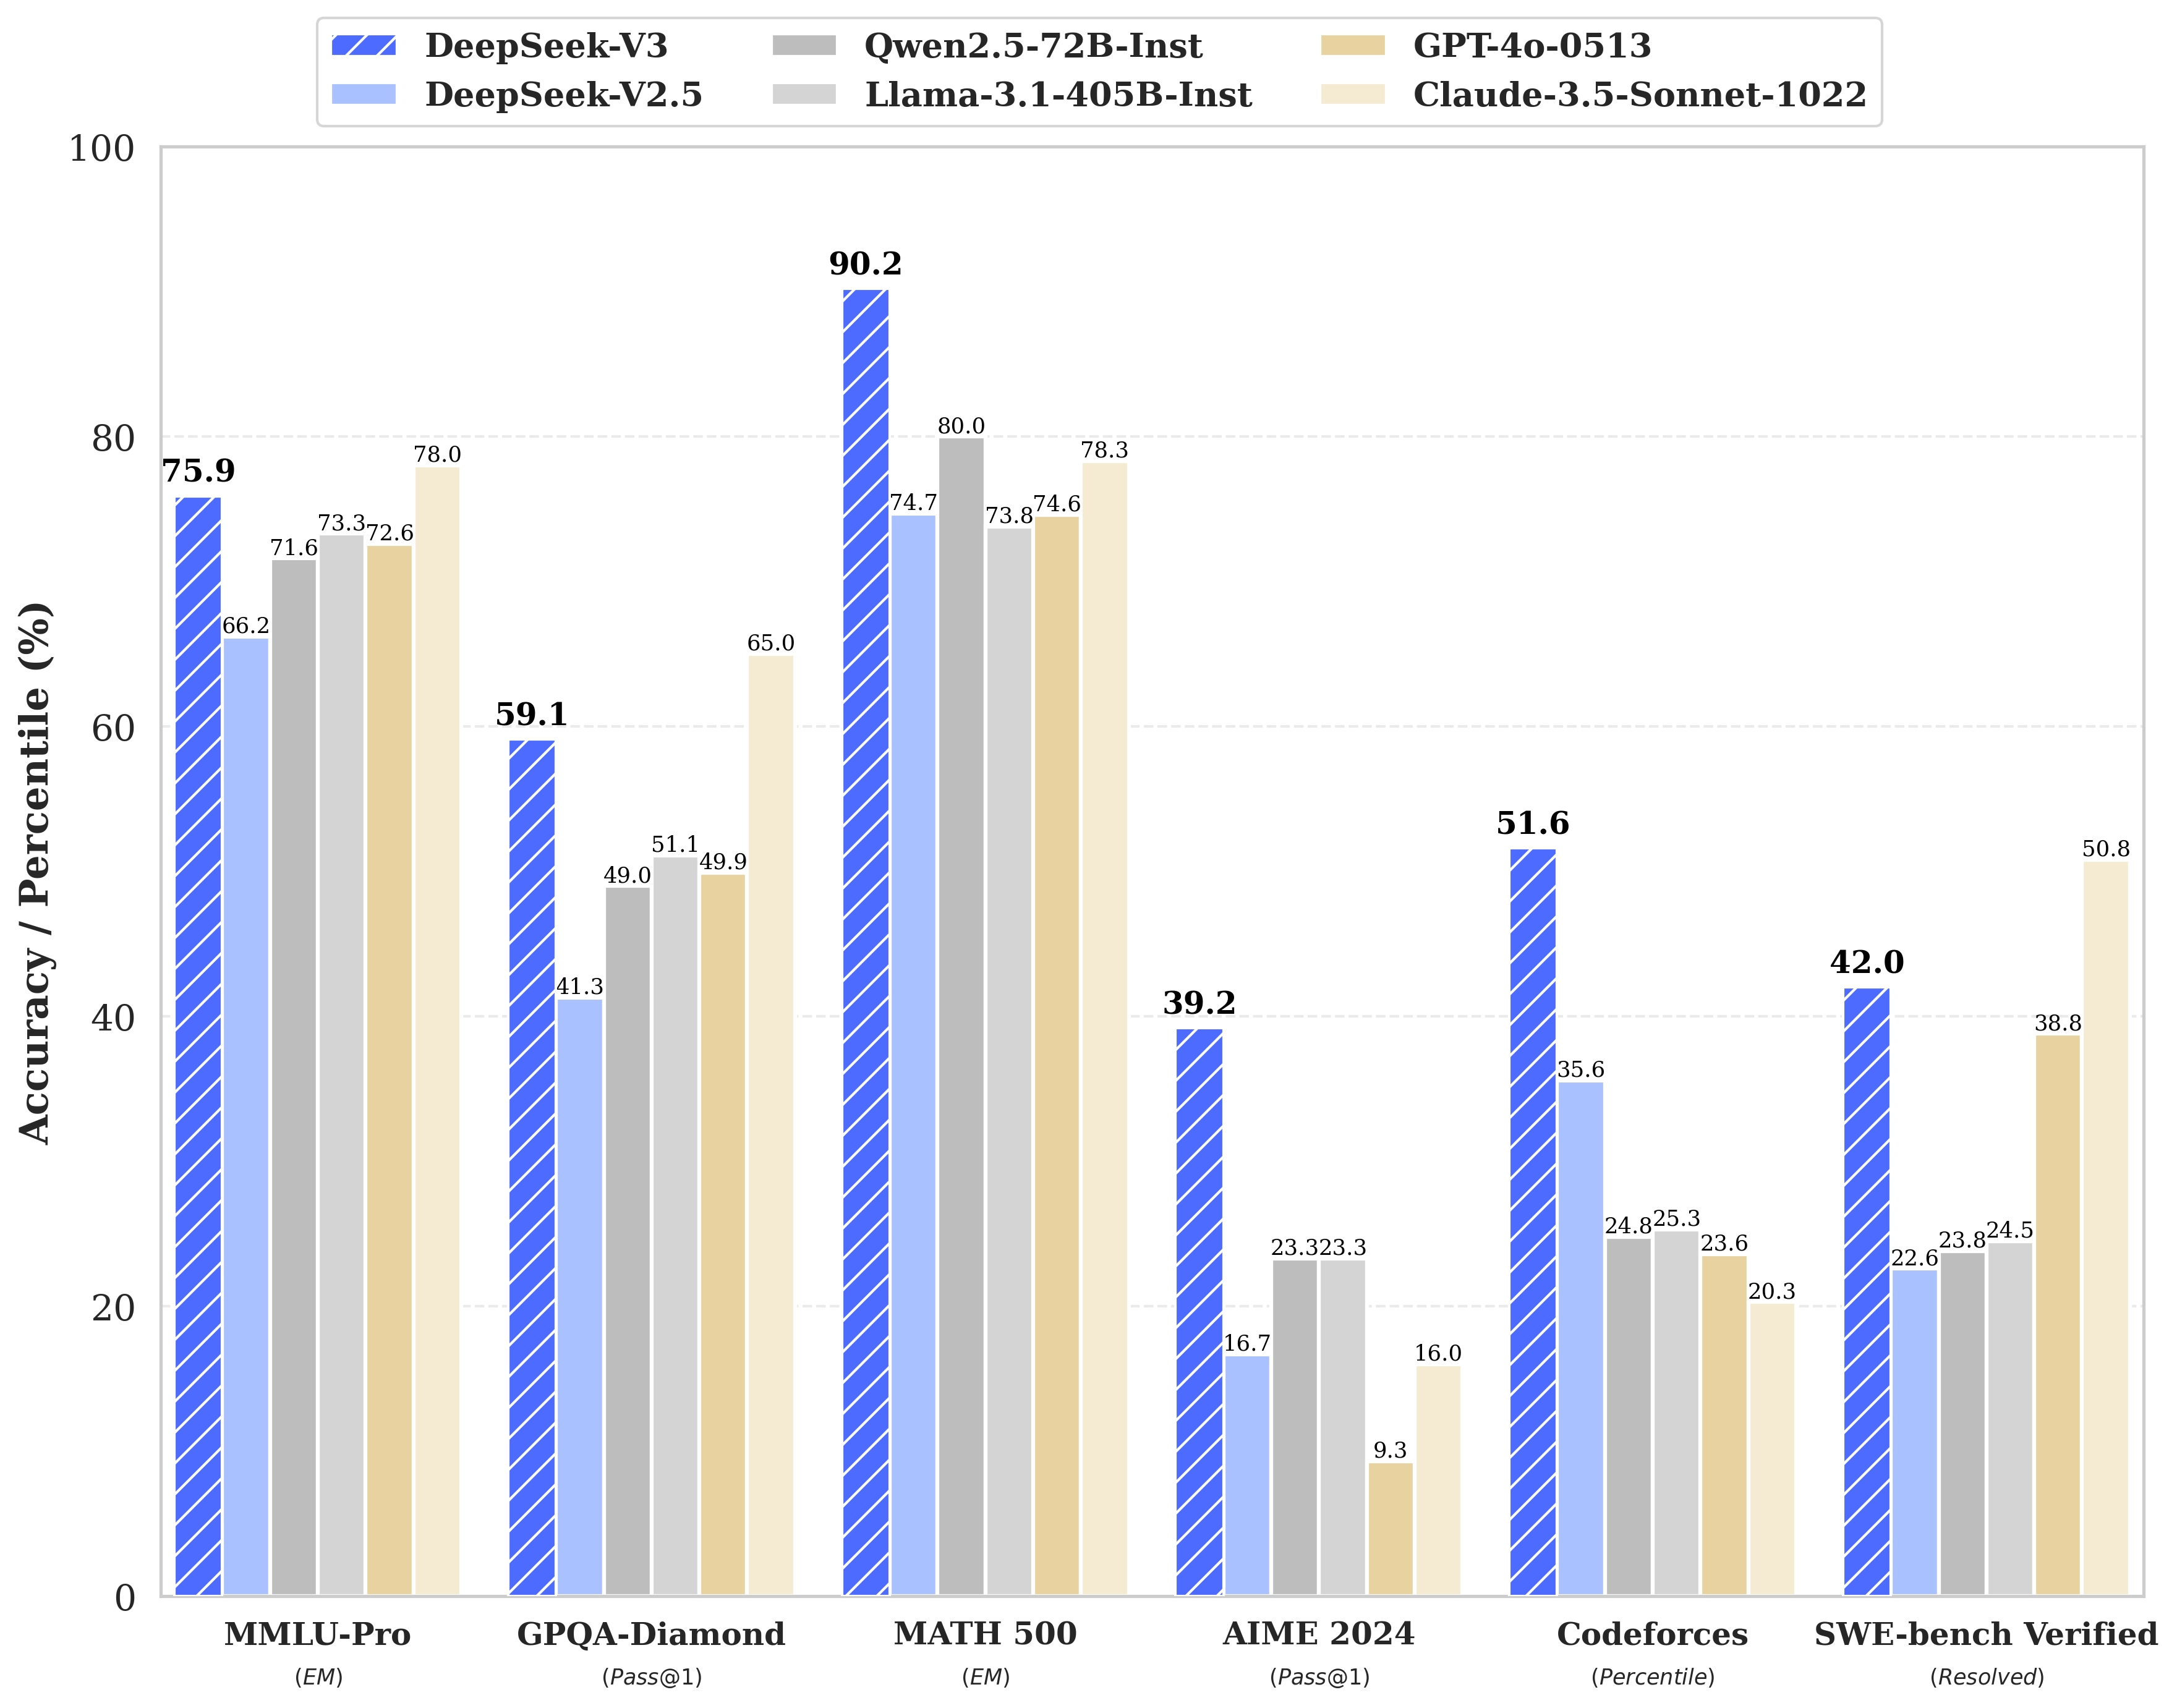
这个成本不是靠“少训”换来的。14.8T token 的训练数据,2048 张 H800 跑约两个月,全程没有出现一次不可恢复的 loss 尖峰,没有做过一次回滚——在大规模 MoE 训练中,这本身就是一个系统稳定性的工程声明。
但真正值得技术人员反复咀嚼的,不是成本数字本身,而是这个数字得以成立的结构性前提:DeepSeek-V3 在四个彼此耦合的层面上,分别做了一次“解耦”。
| 容量 vs 计算 | 细粒度 MoE,671B 总参 / 37B 激活 | 参数量决定知识容量,但每 token 算力不再随参数量线性增长 |
| 内存 vs 精度 | MLA 低秩 KV 压缩 + FP8 混合精度 | KV 缓存从 32768 元素/ token/ 层压到 576,显存带宽不再是推理瓶颈 |
| 训练信号 vs 步数 | 串行 MTP(多 token 预测) | 每个训练位置产生多倍梯度信号,样本效率不再受限于单步单 token 监督 |
| 通信 vs 计算 | DualPipe 双向流水线 | 跨节点专家并行的 all-to-all 通信被“藏”进前向 / 反向计算中 |
这四个解耦不是孤立的优化,而是一套算法-系统协同设计:算法层面的稀疏性选择,必须由系统层面的通信、显存、并行策略来承接;系统层面的硬件约束,反过来约束了算法可以走多远。下面逐层拆开。
2. MoE:把“参数是能力,也是税”这条公式拆掉
2.1 稠密 Transformer 的算力困局
标准稠密 Transformer 中,每个 token 都要流过全部参数。FFN 层的计算量正比于参数总量,模型变大 N 倍,每 token 的训练和推理算力也近似涨 N 倍。GPT-3 的 175B 参数已经让这种线性关系显得昂贵,而到了 671B 量级,如果仍然稠密,每 token 的激活参数就是 671B——训练成本和推理延迟都会变得难以承受。
MoE 的破局思路极其简洁:参数可以很多,但每个 token 只走其中一小部分。把 Transformer 中的 FFN 层替换为一组并行的“专家”网络,每个专家本质上是独立的 FFN,路由器为每个 token 选择少数专家激活,其余专家保持休眠。于是“参数量”和“每 token 算力”被拆成了两个可以独立调节的旋钮:前者决定知识容量,后者决定实际开销。

2.2 DeepSeek-V3 的 MoE:256 个路由专家 + 1 个共享专家
DeepSeek-V3 的每个 MoE 层包含 256 个路由专家和 1 个共享专家,总共 61 层 Transformer,除前三层外 FFN 全部替换为 MoE。共享专家始终激活,承担通用、高频的知识;路由专家则被细粒度切分,每个专家的 FFN 维度只有 2048,负责专用、稀疏的能力。
这里有两个容易被忽略的设计直觉。
第一,为什么要“细粒度”? 传统的 MoE(如 Mixtral 8×7B)使用少量大专家,每个专家参数量很大,路由的选择空间其实有限。DeepSeek-V3 把专家切小、数量拉多,相当于把路由器的“决策分辨率”提高了:同样激活 37B 参数,从 8 个大专家中选,和从 256 个小专家中选,后者能组合出更精细的专家分工。代价是路由和调度更复杂,但这正好由系统层来消化。
第二,为什么要 top-1 路由? 每个 token 经 Sigmoid 门控打分后,只激活分数最高的 1 个路由专家加上共享专家,比 DeepSeek-V2 的 top-2 更激进,把每 token 激活参数压到 37B。top-1 的收益是计算最省,但风险是路由坍缩——路由器倾向于把所有 token 丢给少数专家,其余专家“饿死”。DeepSeek-V3 的应对不是加辅助损失,而是无辅助损失的负载均衡:给每个专家维护一个 bias 项,根据实时负载动态调整,让路由概率在训练过程中自发趋于均衡,而不是用额外的 loss 项去“惩罚”不均衡——后者会在主任务性能上引入退化。下面这段门控代码是这一机制最直接的体现:
class MoEGate(nn.Module):
def __init__(self, hidden_size, n_routed_experts, num_experts_per_tok,
n_group, topk_group, routed_scaling_factor=1.0):
super().__init__()
self.top_k = num_experts_per_tok
self.n_group = n_group
self.topk_group = topk_group
self.weight = nn.Parameter(torch.empty(n_routed_experts, hidden_size))
# bias 是 buffer,不是 parameter:由负载统计更新,不走梯度
self.register_buffer("e_score_correction_bias",
torch.zeros(n_routed_experts))
def forward(self, hidden_states):
bsz, seq_len, h = hidden_states.shape
hidden_states = hidden_states.view(-1, h)
# 关键:用 sigmoid 而非 softmax 打分
logits = F.linear(hidden_states.float(), self.weight.float())
scores = logits.sigmoid()
# bias 只参与“选择”,不参与“加权”
scores_for_choice = scores + self.e_score_correction_bias.unsqueeze(0)
group_scores = (scores_for_choice
.view(bsz * seq_len, self.n_group, -1)
.topk(2, dim=-1)[0].sum(dim=-1))
group_idx = torch.topk(group_scores, k=self.topk_group,
dim=-1, sorted=False)[1]
group_mask = torch.zeros_like(group_scores)
group_mask.scatter_(1, group_idx, 1)
score_mask = (group_mask.unsqueeze(-1)
.expand(bsz * seq_len, self.n_group,
self.n_routed_experts // self.n_group)
.reshape(bsz * seq_len, -1))
tmp_scores = scores_for_choice.masked_fill(~score_mask.bool(), 0.0)
_, topk_idx = torch.topk(tmp_scores, k=self.top_k, dim=-1, sorted=False)
# 权重来自未加 bias 的原始 scores
topk_weight = scores.gather(1, topk_idx)
if self.top_k > 1:
denominator = topk_weight.sum(dim=-1, keepdim=True) + 1e-20
topk_weight = topk_weight / denominator
topk_weight = topk_weight * self.routed_scaling_factor
return topk_idx, topk_weight
2.3 专家并行与 all-to-all:MoE 真正的工程门槛
MoE 在数学上是漂亮的,但在系统上有一个硬骨头:256 个专家不可能全部塞进一张 GPU。采用专家并行后,专家被分布到多张卡上,一个 token 如果被路由到远端卡上的专家,就需要一次跨卡 all-to-all 通信。在 DeepSeek-V3 的训练配置中,跨节点专家并行带来的通信开销一度使计算-通信比接近 1:1——也就是说,GPU 有将近一半的时间在等通信。
all-to-all 在代码里的形态并不复杂,但魔鬼在细节里。下面是从推理 / 训练路径中摘出的核心骨架,它展示了 token 如何按专家分组、跨 rank 交换、计算后再收回:
# 每个 token 被路由到的专家计数
cnts = topk_ids.new_zeros((topk_ids.shape[0], len(self.experts)))
cnts.scatter_(1, topk_ids, 1)
tokens_per_expert = cnts.sum(dim=0)
idxs = topk_ids.view(-1).argsort()
sorted_tokens = x[idxs // topk_ids.shape[1]]
if self.ep_size > 1:
# 先交换“每个 rank 有多少 token 要去哪些专家”的元信息
tokens_per_ep_rank = tokens_per_expert.view(self.ep_size, -1).sum(dim=1)
tokens_per_expert_group = tokens_per_expert.new_empty(tokens_per_expert.shape[0])
dist.all_to_all_single(tokens_per_expert_group, tokens_per_expert)
output_splits = (tokens_per_expert_group.view(self.ep_size, -1)
.sum(1).cpu().numpy().tolist())
gathered_tokens = sorted_tokens.new_empty(
tokens_per_expert_group.sum(dim=0).cpu().item(), sorted_tokens.shape[1])
input_split_sizes = tokens_per_ep_rank.cpu().numpy().tolist()
# 真正的 token 交换
dist.all_to_all(
list(gathered_tokens.split(output_splits)),
list(sorted_tokens.split(input_split_sizes)),
)
# 本地专家计算后,再反向 all_to_all 收回
这就引出了后面的 DualPipe。但在此之前,还有一个同样紧迫的瓶颈:推理侧的 KV 缓存。
3. MLA:把 KV 缓存从 32768 压到 576
3.1 KV 缓存为什么是推理的第一瓶颈
自回归生成中,每生成一个新 token,都需要用之前所有 token 的 Key 和 Value 计算注意力。为了避免重复计算,K 和 V 会被缓存下来。对于一个有 LL 层、HH 个注意力头、头维度 d_{head}dhead 的模型,KV 缓存的内存需求是:
\\text{Memory}_{KV} = 2 \\times L \\times H \\times d_{head} \\times T \\times \\text{bytes}MemoryKV=2×L×H×dhead×T×bytes
以 GPT-3 量级(96 层、96 头、128 维、序列长度 2048、FP16)为例,KV 缓存约 9.6 GB,即使在高端 GPU 上也只够同时服务少数几个用户。在长上下文和高并发场景下,限制部署密度的往往不是算力,而是显存带宽。
标准 MHA 的 KV 缓存大小与头数 HH 和头维度 d_{head}dhead 成正比。GQA 通过让多个 Query 头共享一组 K/V 来压缩,但压缩的粒度是“头级”的。MLA 走了一条更根本的路线:不在头级共享,而是在低秩空间里压缩。
3.2 低秩压缩的数学形式
MLA 的核心观察来自一个经验事实:传统注意力权重矩阵存在显著的低秩特性,典型秩约为隐藏层维度的 15%–20%。既然 K/V 的有效信息集中在一个低维子空间里,就没有必要存储完整的 d_{head}dhead 维表示,而是先压缩到低维潜在向量,需要时再解压缩。
具体来说,MLA 不直接缓存 K 和 V,而是缓存一个低秩压缩后的隐向量:
c_{KV} = \\text{RMSNorm}(W_{dkv} \\cdot x)cKV=RMSNorm(Wdkv⋅x)
其中 W_{dkv}Wdkv 是下投影矩阵,d_{kv}dkv 是低秩维度。在注意力计算时,再通过上投影恢复:
K_{content} = W_{uk} \\cdot c_{KV}, \\quad V = W_{uv} \\cdot c_{KV}Kcontent=Wuk⋅cKV,V=Wuv⋅cKV
只缓存 c_{KV}cKV,而非完整的 K 和 V。KV 缓存的缩减因子为 (2 \\times d_{head}) / d_{kv}(2×dhead)/dkv。-26
真正惊人的是压缩的绝对量级。以 DeepSeek-V3 的量级,每 token 每层的 KV 缓存元素数从标准 MHA 的 32768 压缩到 576,相差 56.89 倍。这 576 维由两部分组成:一个 512 维的压缩隐向量,加上 64 维共享的 RoPE 键分量。RoPE 分量需要保留是为了维持位置编码的完整性,但它只有 64 维,占比较小。
这个压缩比意味着什么?在相同的 H800 显存下,MLA 允许的并发序列数比标准 MHA 高出接近一个数量级。推理成本的决定权从“显存能装多少 KV”回到了“算力能跑多少 FLOPs”——而后者恰恰是 GPU 更充裕的资源。
3.3 MLA 与 MoE 的配合关系
MLA 和 MoE 不是两个独立的“亮点功能”,它们在推理路径上形成互补。MoE 把每 token 的计算量压到 37B 参数的规模,MLA 把每 token 的内存足迹压到 576 元素/层。两者叠加的效果是:一个 671B 总参数的模型,在推理时既能以接近中等稠密模型的算力运行,又能以接近小模型的显存带宽运行。如果没有 MLA,MoE 省下来的计算优势会被 KV 缓存的内存瓶颈吃掉;如果没有 MoE,MLA 省下来的显存又会被稠密 FFN 的计算量淹没。
这种成对设计是 DeepSeek-V3 架构思维的一个缩影:不要孤立地优化一个指标,而要同时看计算和内存两条曲线,让它们在同一个工作点上相遇。
4. MTP:训练信号增稠,而不是推理加速器

4.1 标准自回归训练的信号瓶颈
标准语言模型训练中,每个位置只预测下一个 token,损失函数只在 t_{i+1}ti+1 这一个位置产生梯度。对于一段长度为 TT 的文本,训练信号是“单点”的:模型在每个位置只被告知“下一个词是什么”,而“下下个词、下下下个词”的信息没有直接进入梯度。
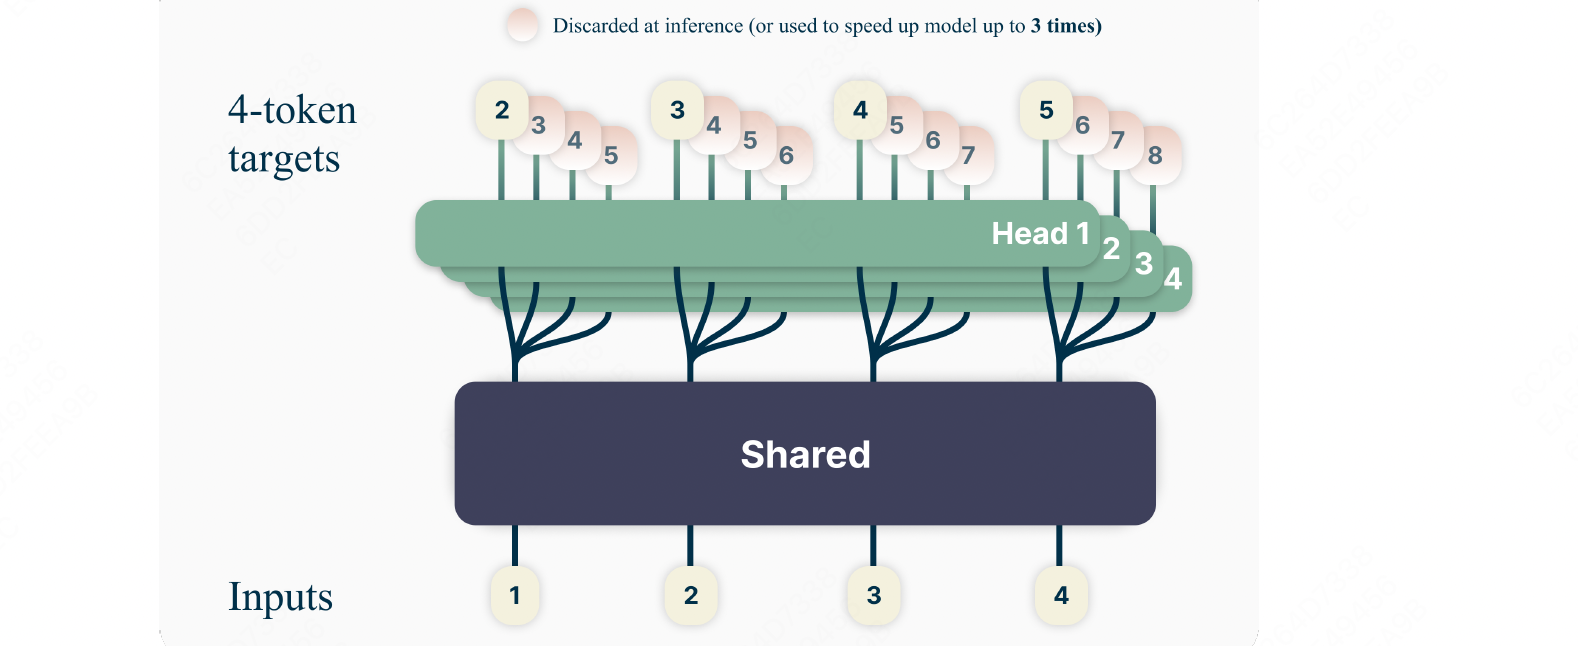
MTP(Multi-Token Prediction)改变了这一点:让每个位置同时或串行地预测未来 nn 个 token,使监督信号从单点变成一段稠密的信号带。同一段文本产生 nn 倍的 next-k 信号,关键转移(choice point)的后果会出现在多个预测头的 loss 中,从而隐式提高模型对重要决策的敏感度。
4.2 DeepSeek-V3 的串行 MTP 与因果链保持
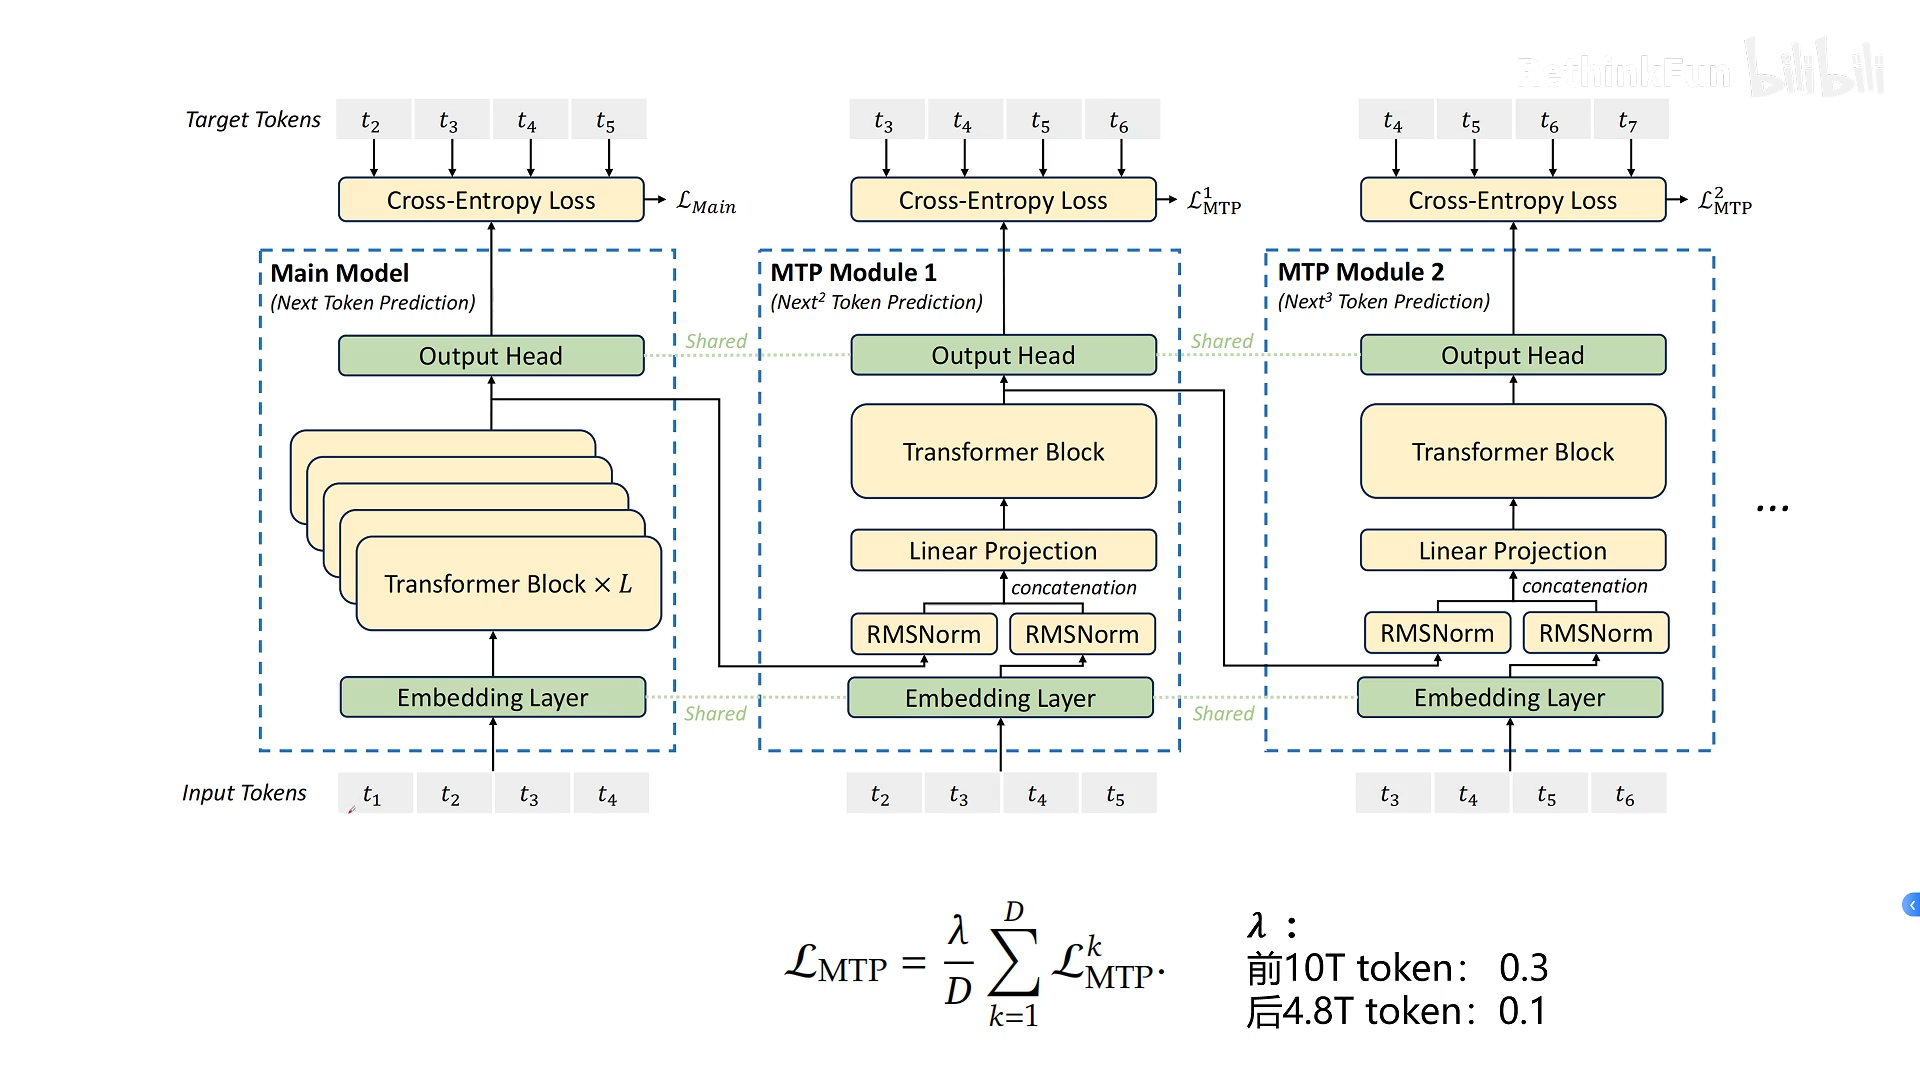
MTP 有两条技术路线。Gloeckle 等人的并行 MTP 使用共享 trunk 加多个独立输出头,各头条件独立预测未来不同位置的 token,t_{t+2}tt+2 的头看不到 t_{t+1}tt+1 的输出。DeepSeek-V3 选择了另一条路:串行 MTP,保持完整的因果链,让第 kk 步的预测依赖前一步的结果,而不是各个头各自为战。
这个选择的关键在于主目标不同。并行 MTP 的额外头在推理时可以拿来做 speculative decoding,但 DeepSeek-V3 的 MTP 首先是训练目标:训练增益是主目标,推理时既可以丢弃额外的预测模块,也可以保留下来当 drafter。串行结构保持了因果性,使得训练信号增稠的过程本身就在教模型“为后面几步预留信息”,而不是简单地并行拟合多个独立目标。
串行 MTP 的实现集中在输入序列的移位和逐深度的 MTP 块上。下面这段 roll_mtp_sequence 的语义,是理解 MTP 训练数据流的最小入口:
# MTP 输入 / 标签按 depth 移位(示意逻辑)
# 主模型: 输入 [t0, t1, t2, t3, t4, t5]
# 标签 [t1, t2, t3, t4, t5, t6]
#
# MTP depth 1: 输入 [t1, t2, t3, t4, t5, FILL]
# 标签 [t2, t3, t4, t5, t6, IGNORE]
#
# MTP depth 2: 输入 [t2, t3, t4, t5, FILL, FILL]
# 标签 [t3, t4, t5, t6, IGNORE, IGNORE]
def roll_mtp_sequence(tokens, positions, shift):
"""沿序列维移位;跨 document 边界的位置填充 IGNORE/FILL。"""
shifted = tokens[…, shift:]
# packed 序列中,position 重置处视为边界
valid_mask = (positions[…, shift:] > positions[…, :-shift])
return shifted, valid_mask
代价是训练时的计算图更长、显存管理更复杂。但 DeepSeek-V3 的系统层再次承接了这个代价——FP8 混合精度把激活值和权重的存储压到 8 位,DualPipe 把额外的计算和通信重叠起来。算法提出需求,系统负责买单,这条分工线在 MTP 上体现得尤为清晰。
4.3 MTP 的真实收益边界
需要诚实地说,MTP 并不是一个“免费午餐”。它在小模型上的收益并不稳定,在 13B 量级才开始明显拉开差距。换句话说,MTP 是一种“大模型才划算”的训练技巧:模型越小,额外预测头带来的 overhead 相对于主任务收益的占比越高;模型越大,信号增稠的收益越能覆盖系统成本。DeepSeek-V3 在 671B 量级上使用 MTP,是在正确的规模上做了正确的选择。
5. 系统层:FP8、DualPipe 与“把通信藏起来”
5.1 FP8 混合精度:显存和带宽的双重松绑
FP8 训练的核心价值不是“算得快”,而是在同样的 GPU 上装下更多东西。DeepSeek-V3 在训练中使用 FP8 精度的计算和存储,大幅降低了 GPU 内存需求和存储带宽压力。在推理侧,FP8 模式下的显存占用只有 BF16 的一半,使得在有限显存下部署 671B 模型成为可能。
@triton.jit
def blockwise_fp8_gemm_kernel(a_ptr, a_s_ptr, b_ptr, b_s_ptr, y_ptr, …):
# 每个 program 处理一块输出;a/b 以 FP8 存储,
# 对应的 scale 以 block 粒度存储并在累加时逐块应用
…
# 概念上:
# a_fp8_block * a_scale_block -> 反量化后的 a_block
# b_fp8_block * b_scale_block -> 反量化后的 b_block
# 累加使用 FP32,输出再按需量化
但 FP8 训练的难点不在格式本身,而在数值稳定性。大规模 MoE 训练中,专家激活值的动态范围差异很大,直接用 FP8 很容易在某个专家上出现溢出或下溢,进而引发 loss 尖峰。DeepSeek-V3 全程没有不可恢复的 loss 尖峰,说明 FP8 的缩放策略和数值边界管理与模型架构是协同设计的,而不是事后套上去的量化方案。
5.2 DualPipe:当通信开销接近 1:1 时
回到第 2 节留下的问题:跨节点专家并行的 all-to-all 通信使计算-通信比接近 1:1,这意味着如果通信和计算串行执行,GPU 有一半时间在空转。
DualPipe 的解法不是“减少通信量”,而是把通信藏进计算里。它构建双向数据流通道,让前向传播和反向传播各自拥有独立的管道,计算任务和通信任务在两条管道上并行推进,实现前向 / 反向计算-通信阶段的完全重叠,同时减少流水线气泡(设备空闲等待)。通过反向传播的依赖分析,可并行计算的梯度节点被提前调度,通信与计算的重叠率提升到 90% 以上。
这里的设计哲学值得单独拎出来:当通信不可避免时,不要去和通信“对抗”,而要重新排列计算图,让通信发生在计算的阴影里。DualPipe 没有发明更快的网络,它改变的是计算和通信的时间关系。
5.3 并行策略的整体拼图
把这些系统组件放回全局,DeepSeek-V3 的并行策略是一张精心配比的拼图:16 路流水线并行、64 路专家并行,跨 8 个物理节点,数据并行采用 ZeRO-1,刻意避开了通信开销较大的张量并行。这个组合不是“能用的最大值”,而是在给定网络拓扑(节点内 NVLink、节点间 InfiniBand)和模型结构下的约束最优解:专家并行必须跨节点,所以用 DualPipe 重叠通信;张量并行通信太贵,所以不用;流水线并行用来切层,数据并行用来扩展吞吐。每一个选择都在回答同一个问题:在这个硬件边界上,哪种并行维度的边际成本最低?
6. 回到 1024:高效创作的方法论
DeepSeek-V3 的技术拆解到这里,可以收束到一条对开发者真正可迁移的主线上。
1024 程序员节的活动主题是“高效创作之道”。在 AI 工程语境下,“高效”很容易被简化为“用更少的卡”或“花更少的钱”。但 DeepSeek-V3 给出的启示恰恰相反:高效不是某一个单点优化的结果,而是一组设计决策在多个层面上彼此对齐之后涌现出来的系统属性。
MoE 的稀疏性要求系统层有专家并行和 all-to-all 优化来承接;MLA 的低秩压缩要求推理引擎有对应的 kernel 和缓存管理来兑现;MTP 的信号增稠要求 FP8 和 DualPipe 把额外的计算与通信成本吸收掉。如果只抄其中一个模块,而不同时调整它所依赖的系统层,收益会被其他层面的瓶颈吃掉。
这也是为什么“算法-系统协同设计”比“追逐单个 SOTA 模块”更难,但也更有长期价值。真正的技术判断力,不在于知道哪个机制在论文里最亮眼,而在于看清一个机制在完整的计算-内存-通信约束下,到底能释放多少、又需要什么来承接。
278.8 万 H800 小时和 558 万美元,是这种判断力的一次集中兑现。它提醒我们:在算力仍然稀缺的年代,最有杠杆率的创作不是写更多的代码,而是在约束的边界上,找到那个让多个维度同时松动的工作点。这大概也是 1024 这个由 0 和 1 构成的节日,在 AI 时代仍然值得被反复提起的原因。
参考文献与延伸阅读
DeepSeek-AI, DeepSeek-V3 Technical Report, arXiv:2412.19437.
MLCommons, DeepSeek-V3: A Large-Scale MoE Pretraining Benchmark for MLPerf Training v6.0, 2026.
Multi-Token Prediction:从训练目标到推理 drafter,llm-infra-atlas.
deepseek-v3-moe-mla:671B 参数只激活 37B,CSDN,2026.
vLLM vs SGLang vs DeepInfer:2026 年部署 DeepSeek 推理框架怎么选,2026.
DeepSeek | DeepSeek-V3 正式发布







评论前必须登录!
注册