 网硕互联帮助中心
摘要:本文从 Palantir 的“本体论”语义框架谈起,分享我们在工业现场落地的一套语义化系统:以数据底座接入 40 多种工业协议,用语义层把工厂抽象成 13 种节点类型并构建语义树,再由智能执行层内置 27 种工业分析算子并开放给 AI Agent 调用,形成“采集 → 建模 → 分析 → 交互”的闭环。系统已在工厂跑通,将故障排查从小时级压缩到分钟级,让分析报告自动生成、老师傅经验得以沉淀、设备数据与业务数据打通,落地时间早于相关国家标准与行业标准的发布。
有视频有图有真相: (视频)
新工业系统演示工业语义图谱落地
(图片)工业语义图谱维护好后得可视化查询界面(多种视图包括2D-3D,导出功能)


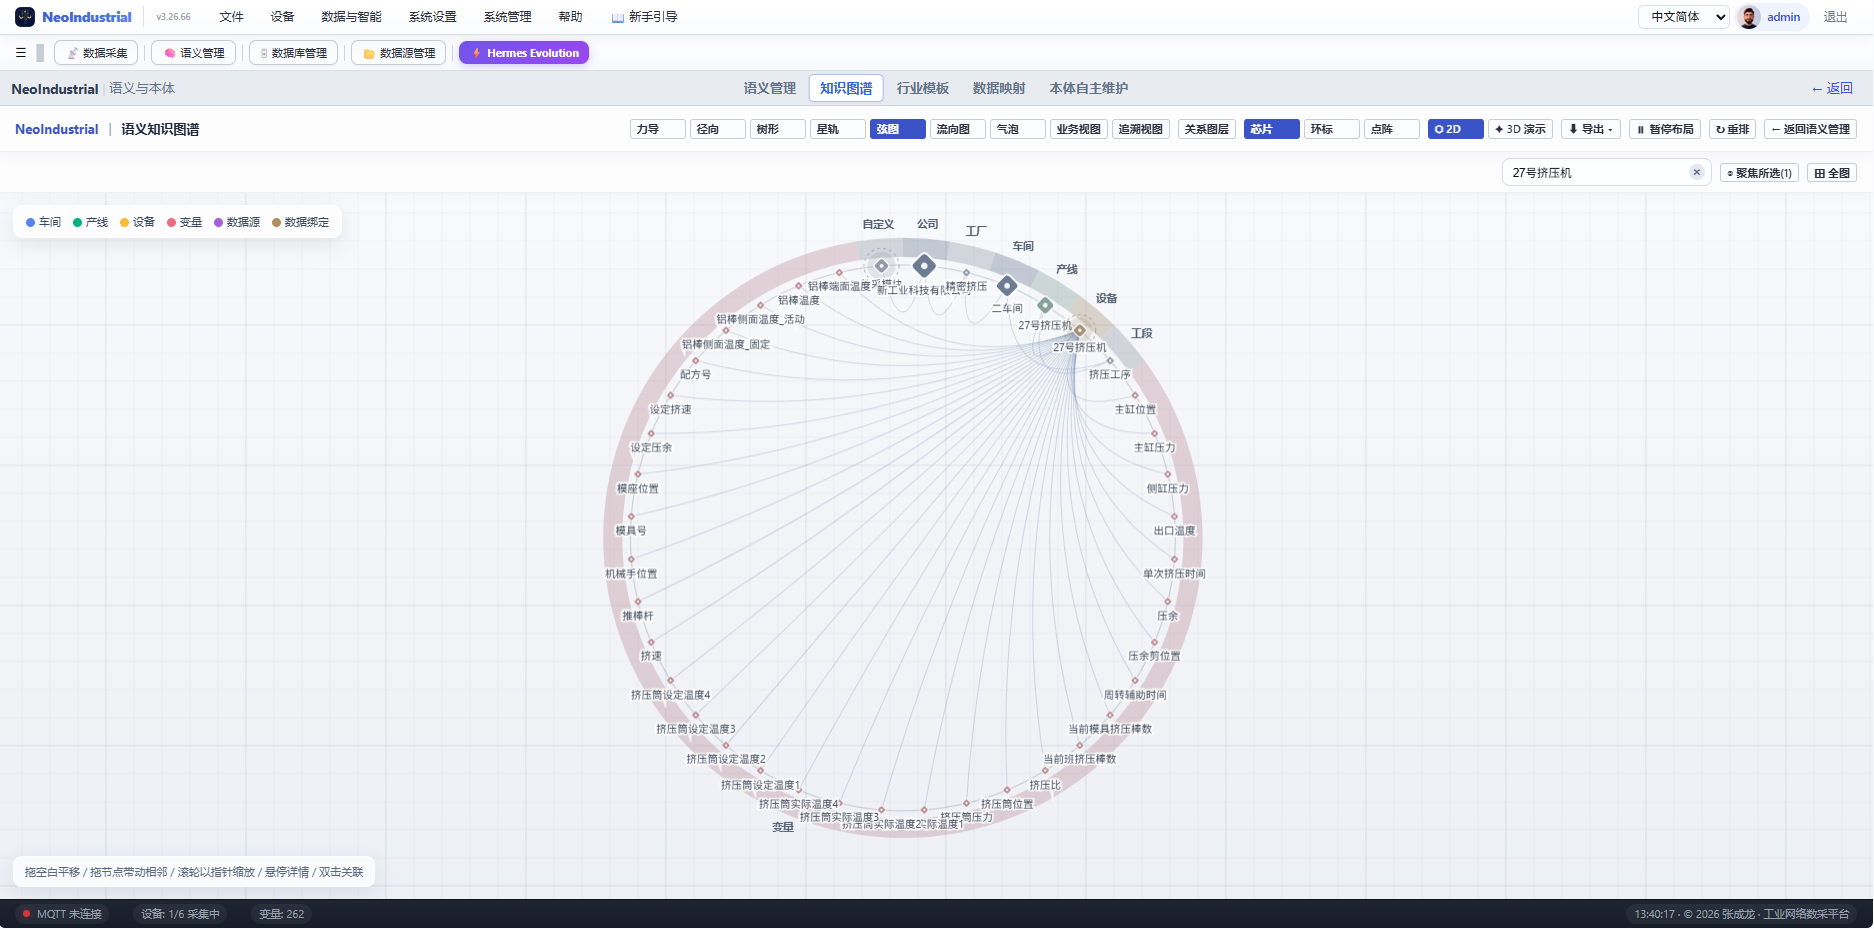
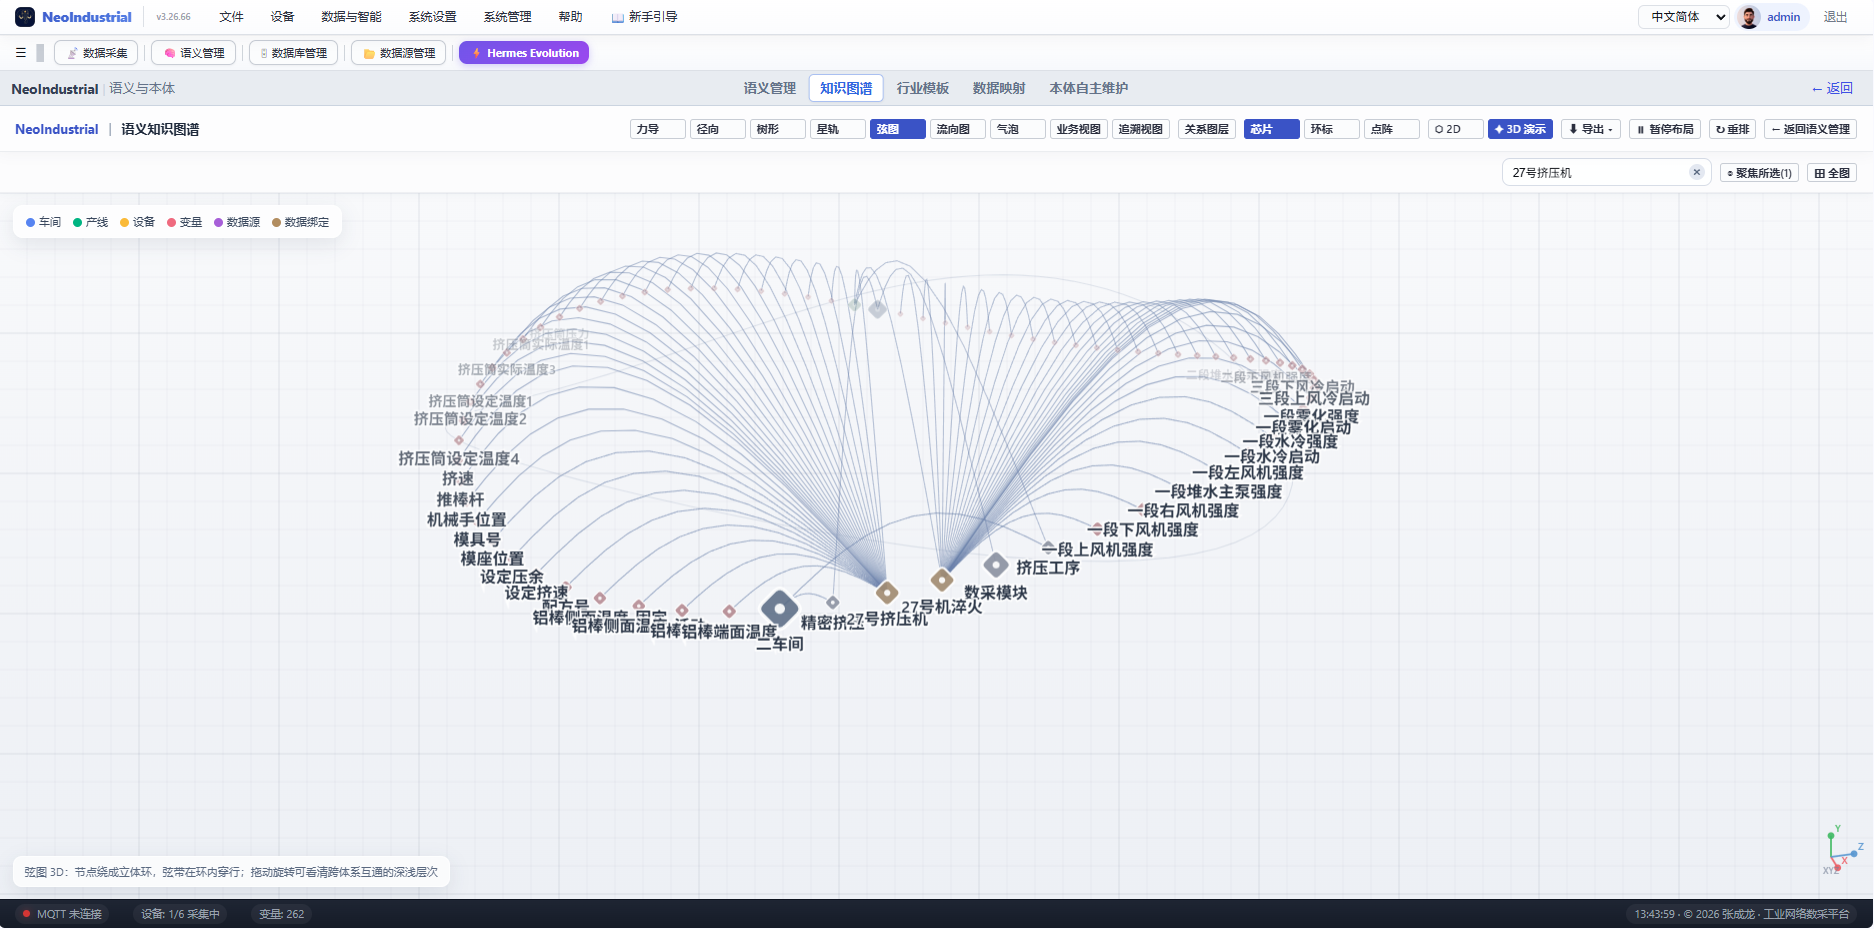
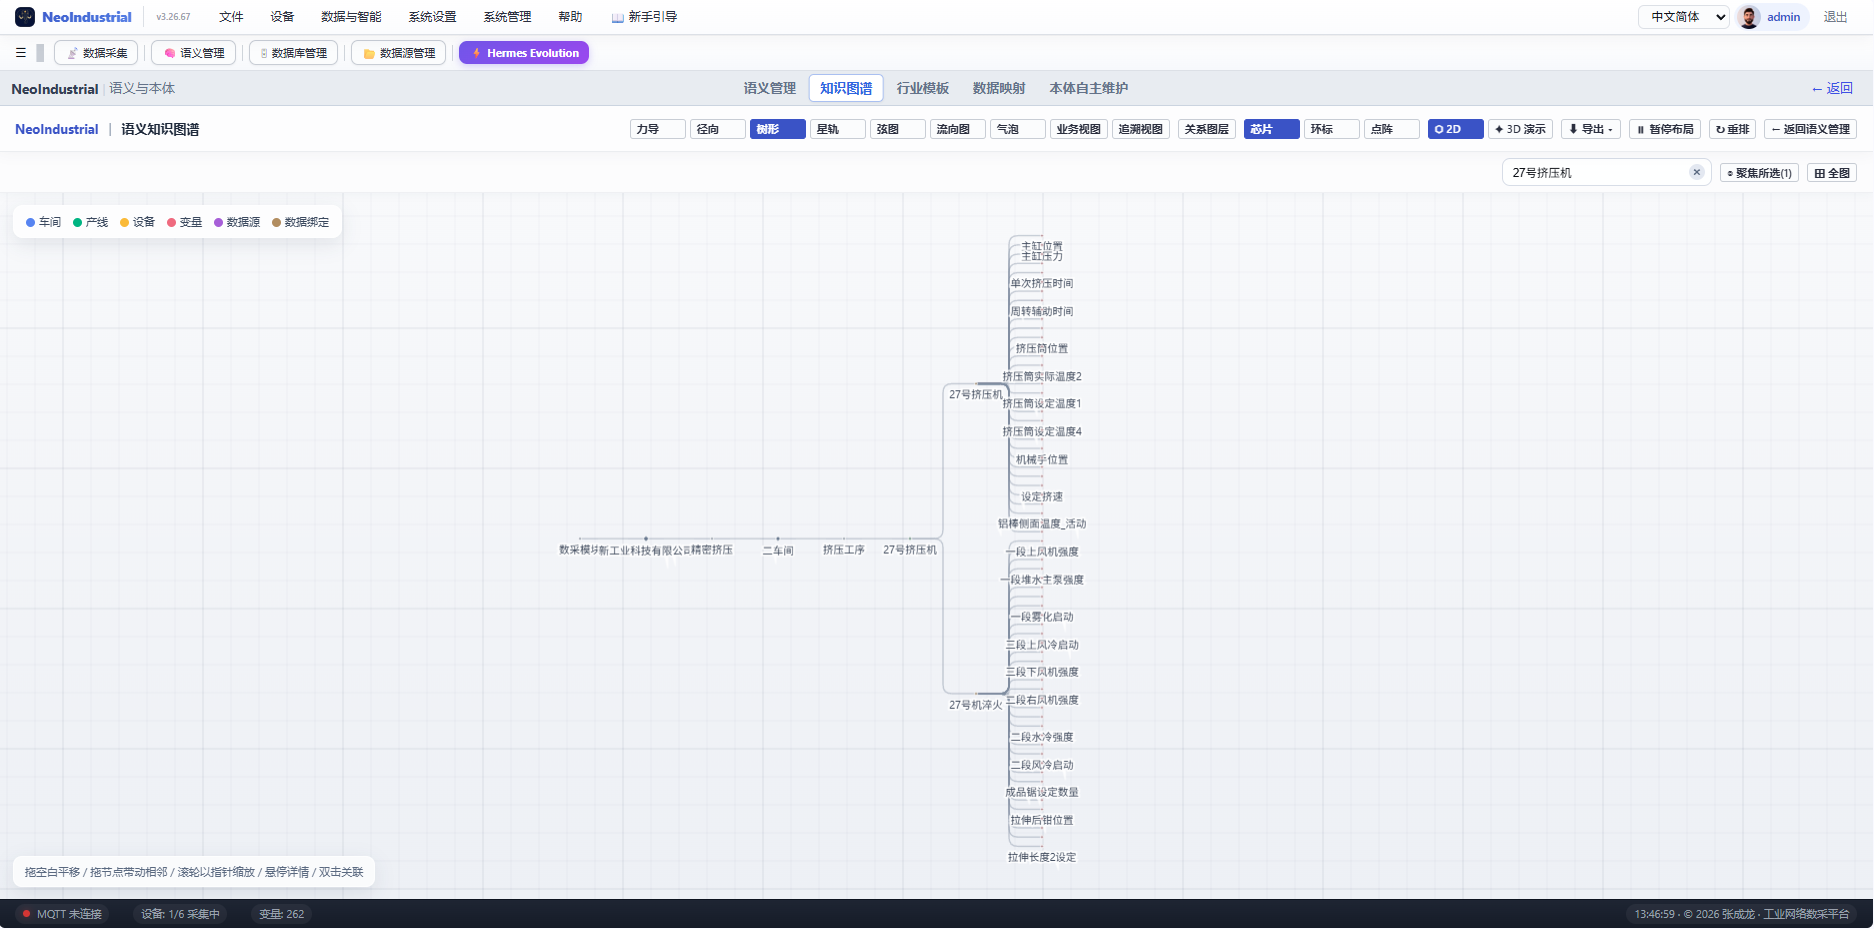
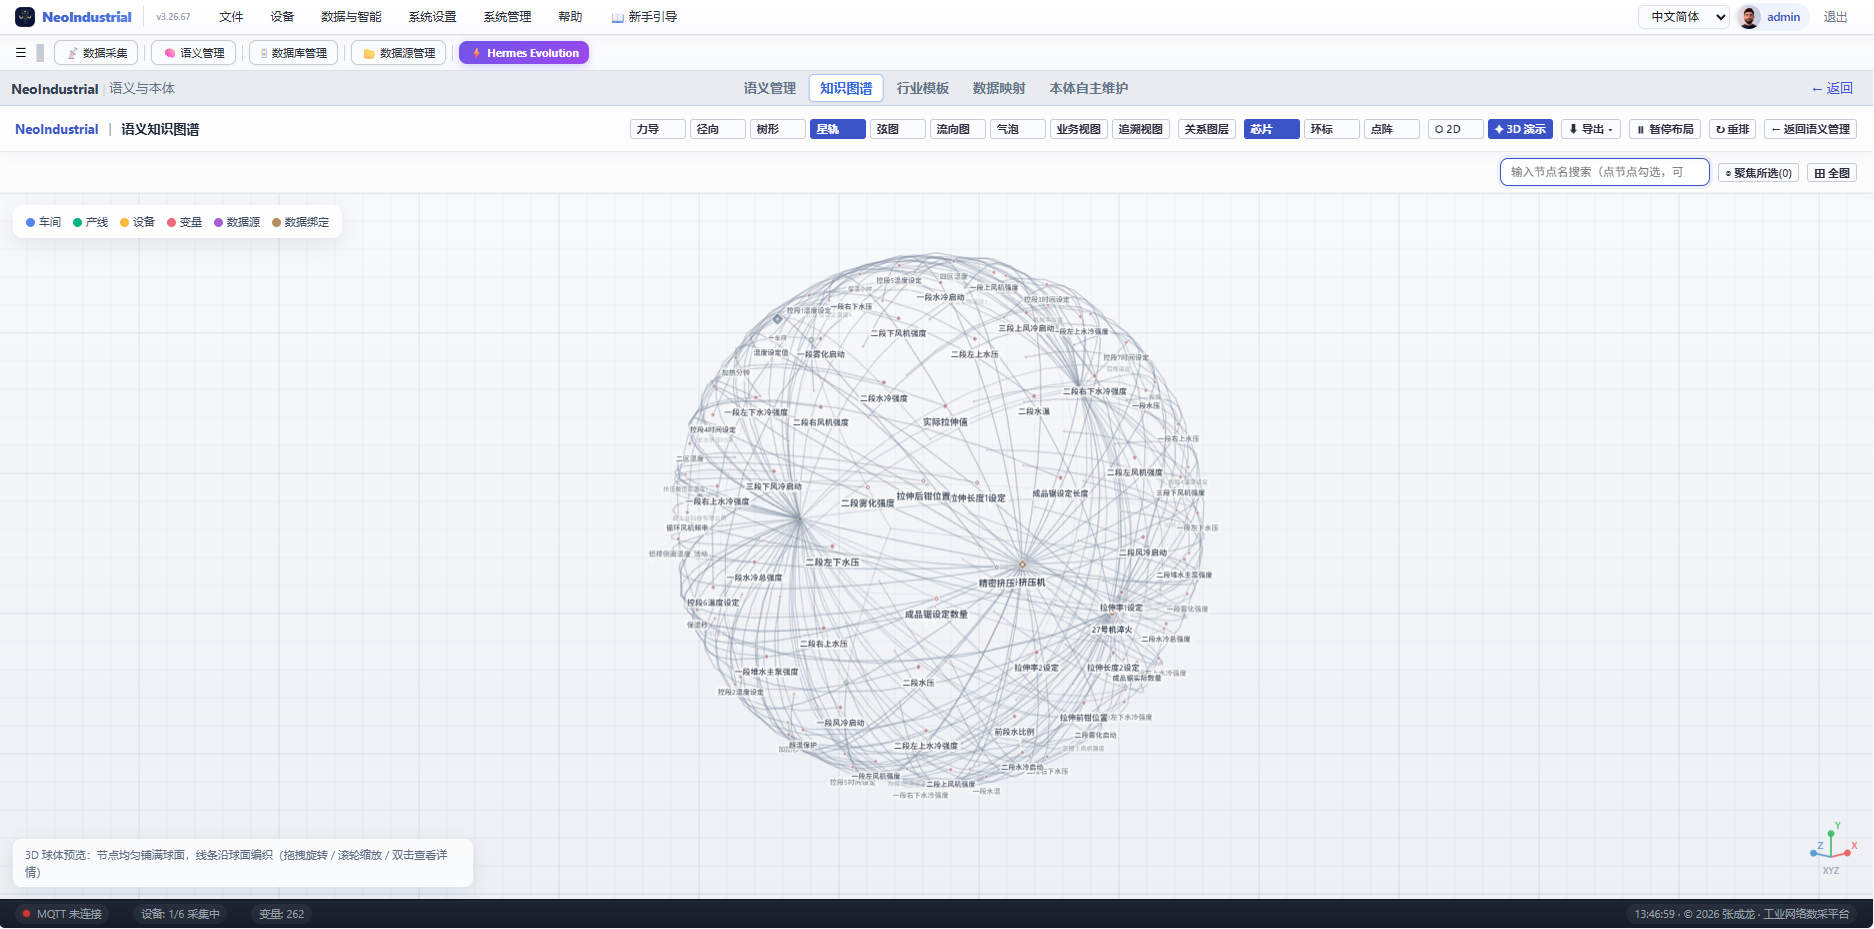
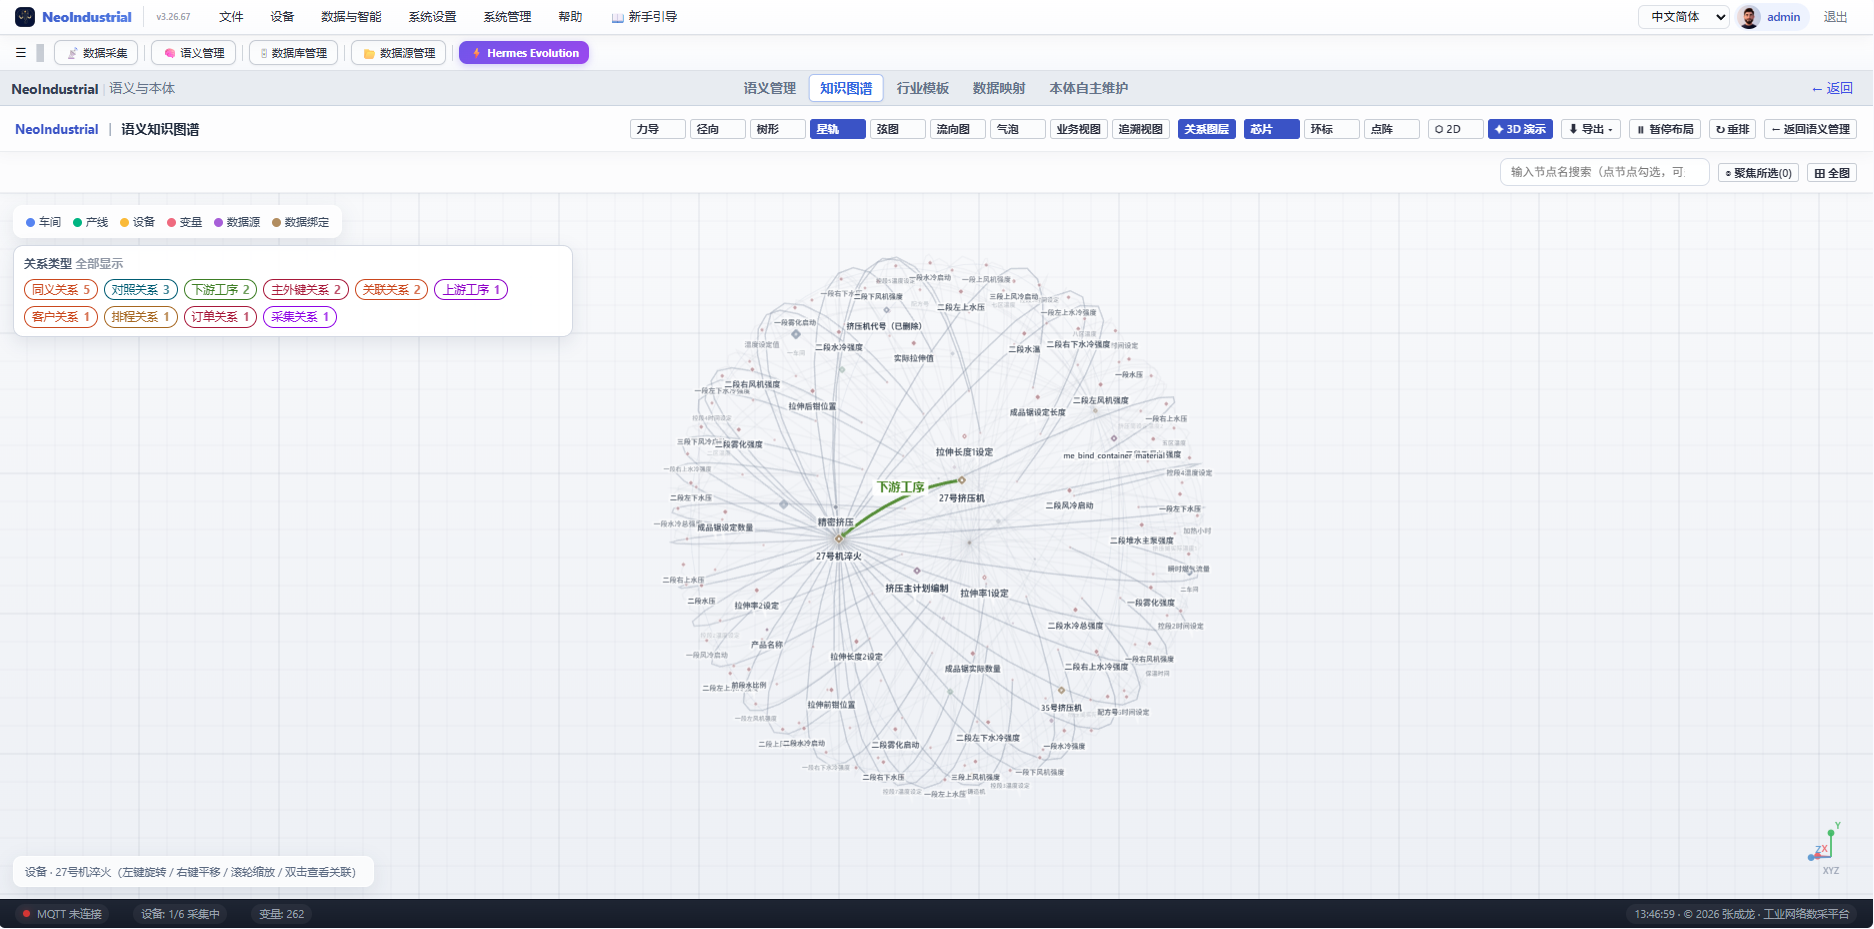
以上只是举例说明更多精彩的演示需要亲自尝试才会感触更深 以上就是AI可观察,可使用的语义图谱可视化,通过MCP服务暴露给内置的 认知进化型Agent,这样AI就可以天然的 ‘懂你的业务’ (目前FDE的活,但是这个平台内AI可以进行自主维护) ,以及每个节点的属性,关系,以及触发事件以及处理方式(报警,发消息,触发AI核算,给ERP抛帐,给业务员发邮件或者短信等,或者通过企业微信,钉钉、飞书进行协作等)不吹牛逼,上图:
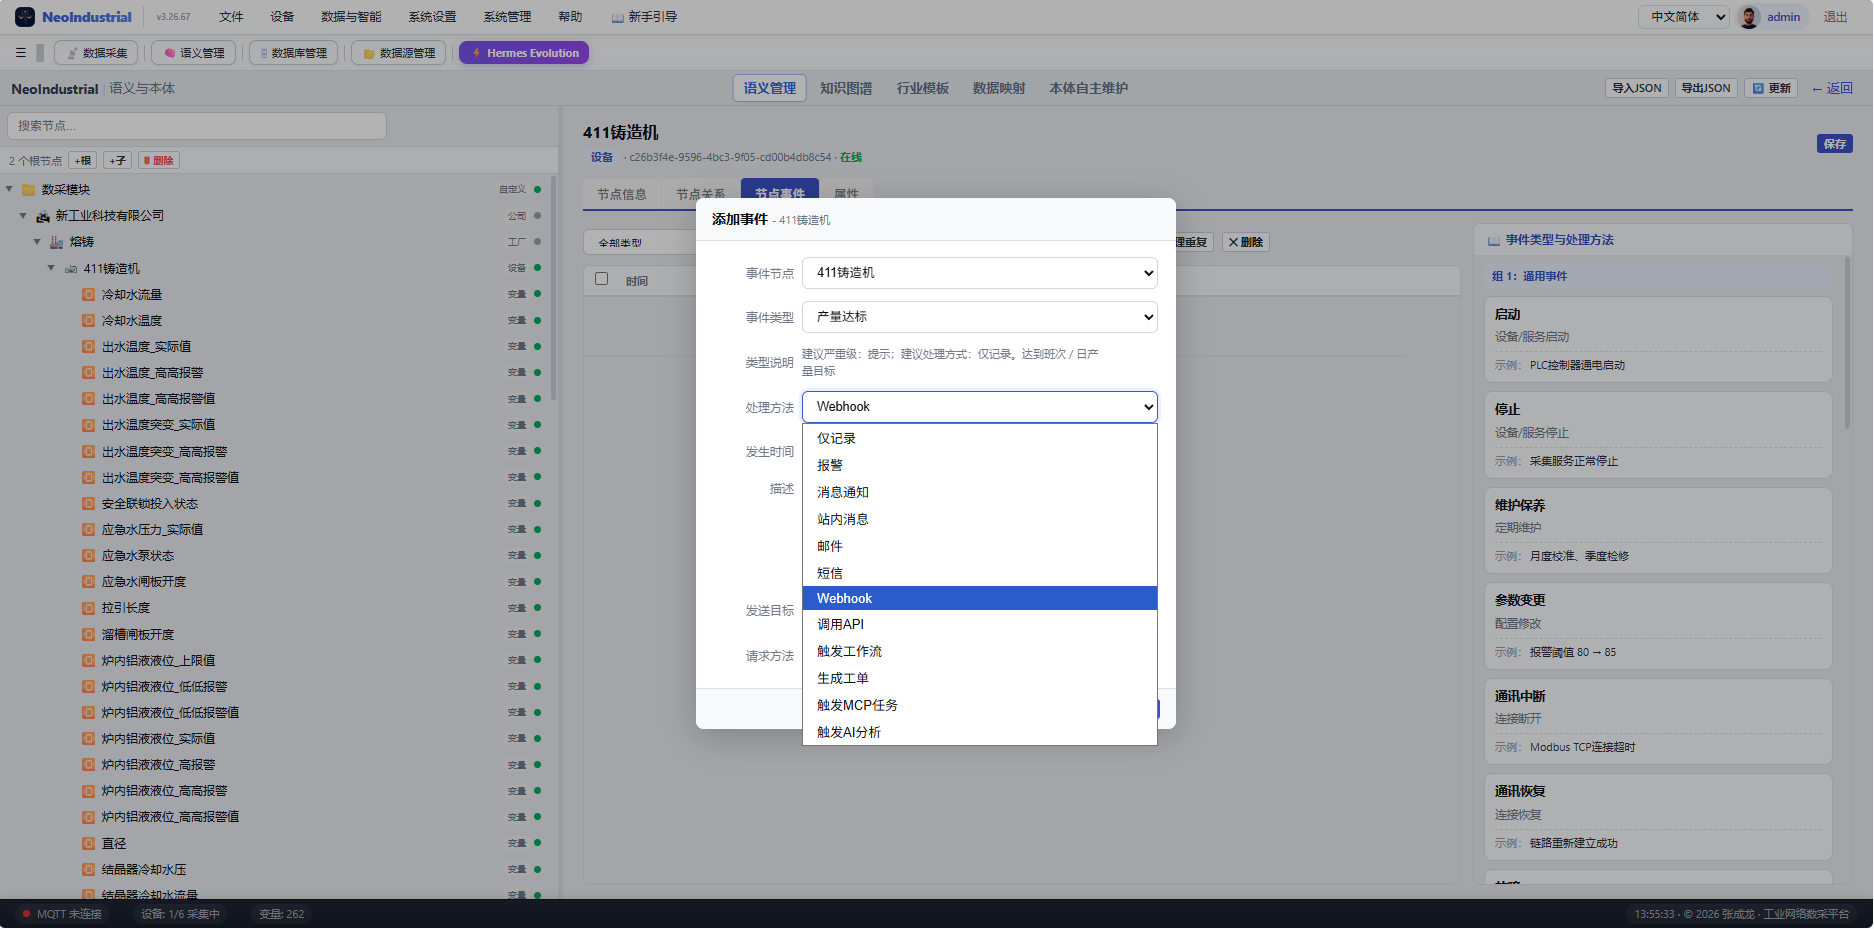 那么语义可视化是怎么编辑维护的呢?(除了人手动维护,AI可以在业务进行后自己归纳总结,自主维护更新语义,下次更 ‘懂’ 业务。) 上图:
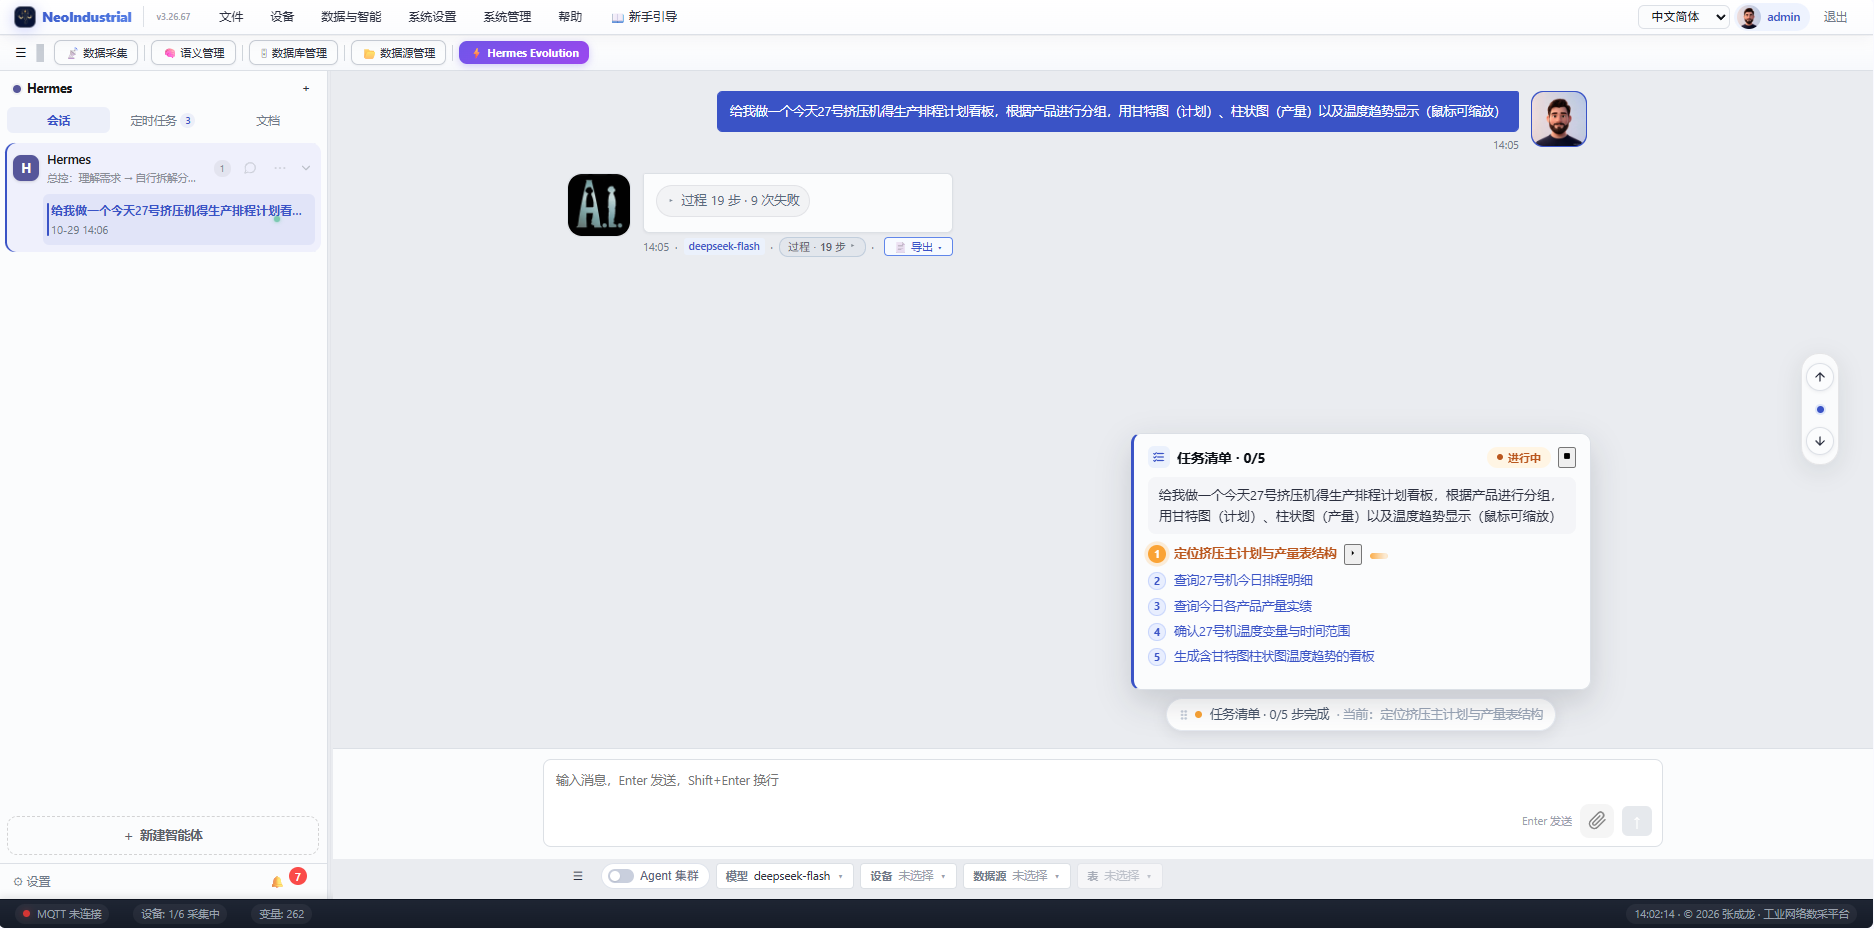
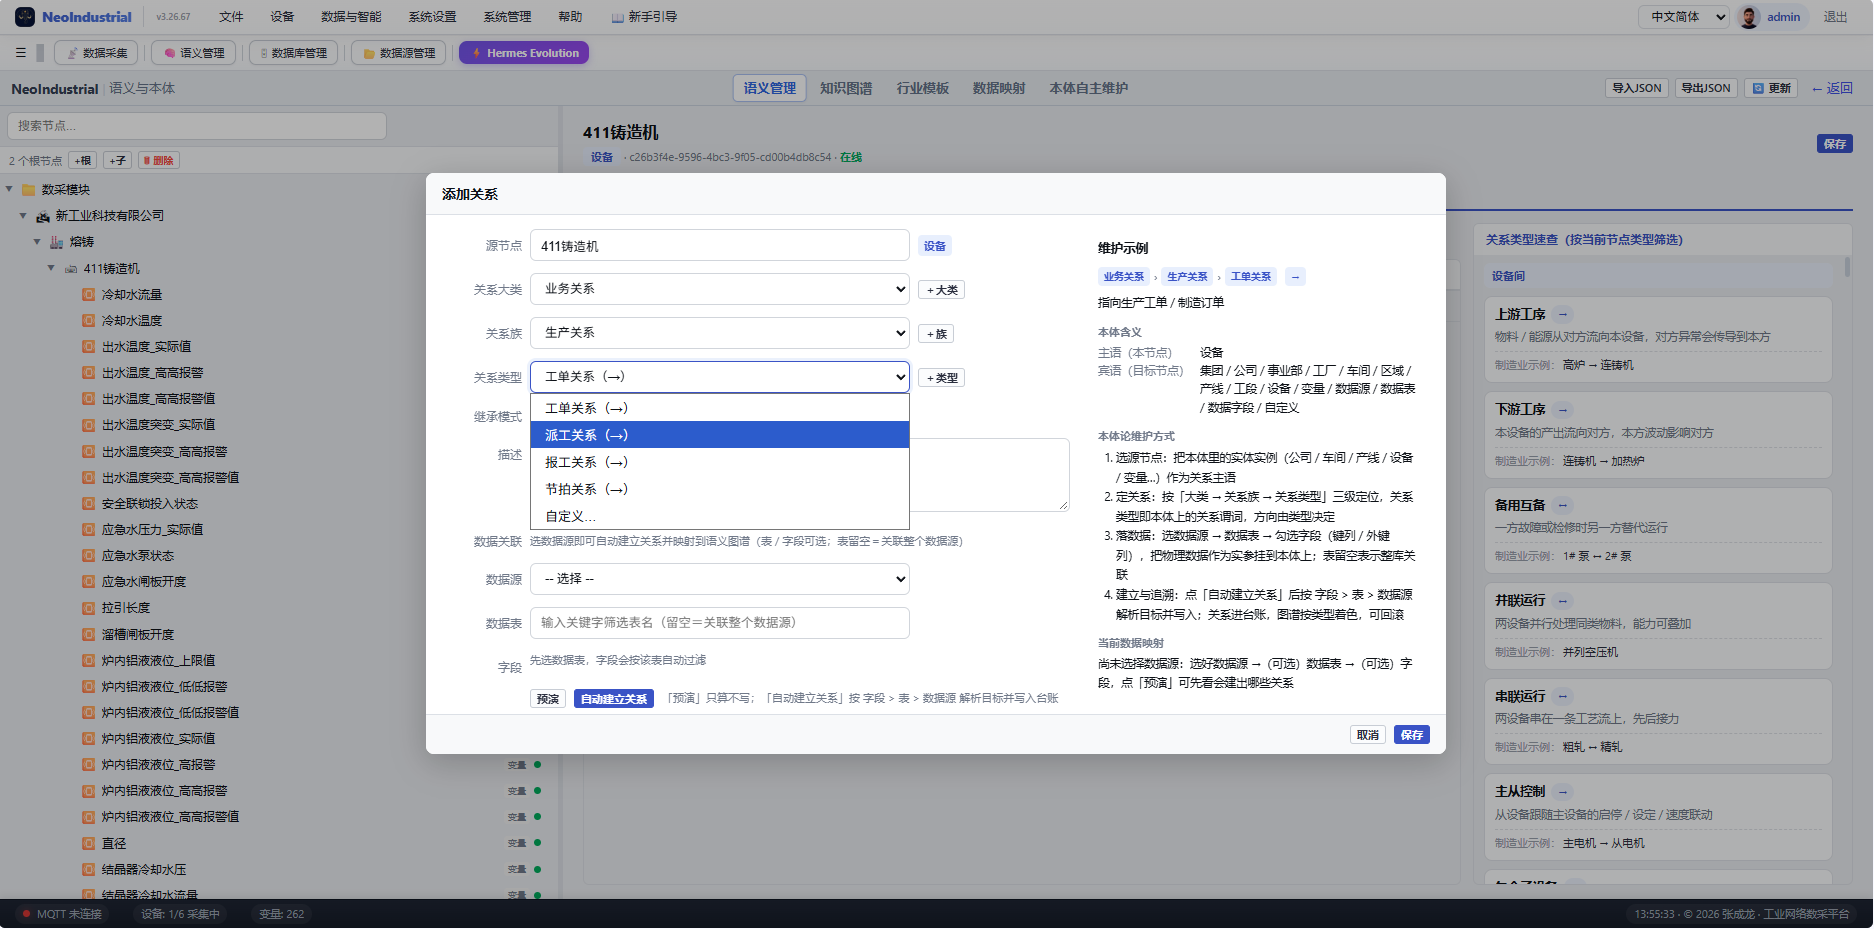 请相信一个十来年的老工程师三个月的心血,我没什么名气,我只知道做对的事,分享出来给懂得人看(不懂勿喷),我是根据自己的判断做的实践,而且已落地,那么,接下来就是AI了,上图:
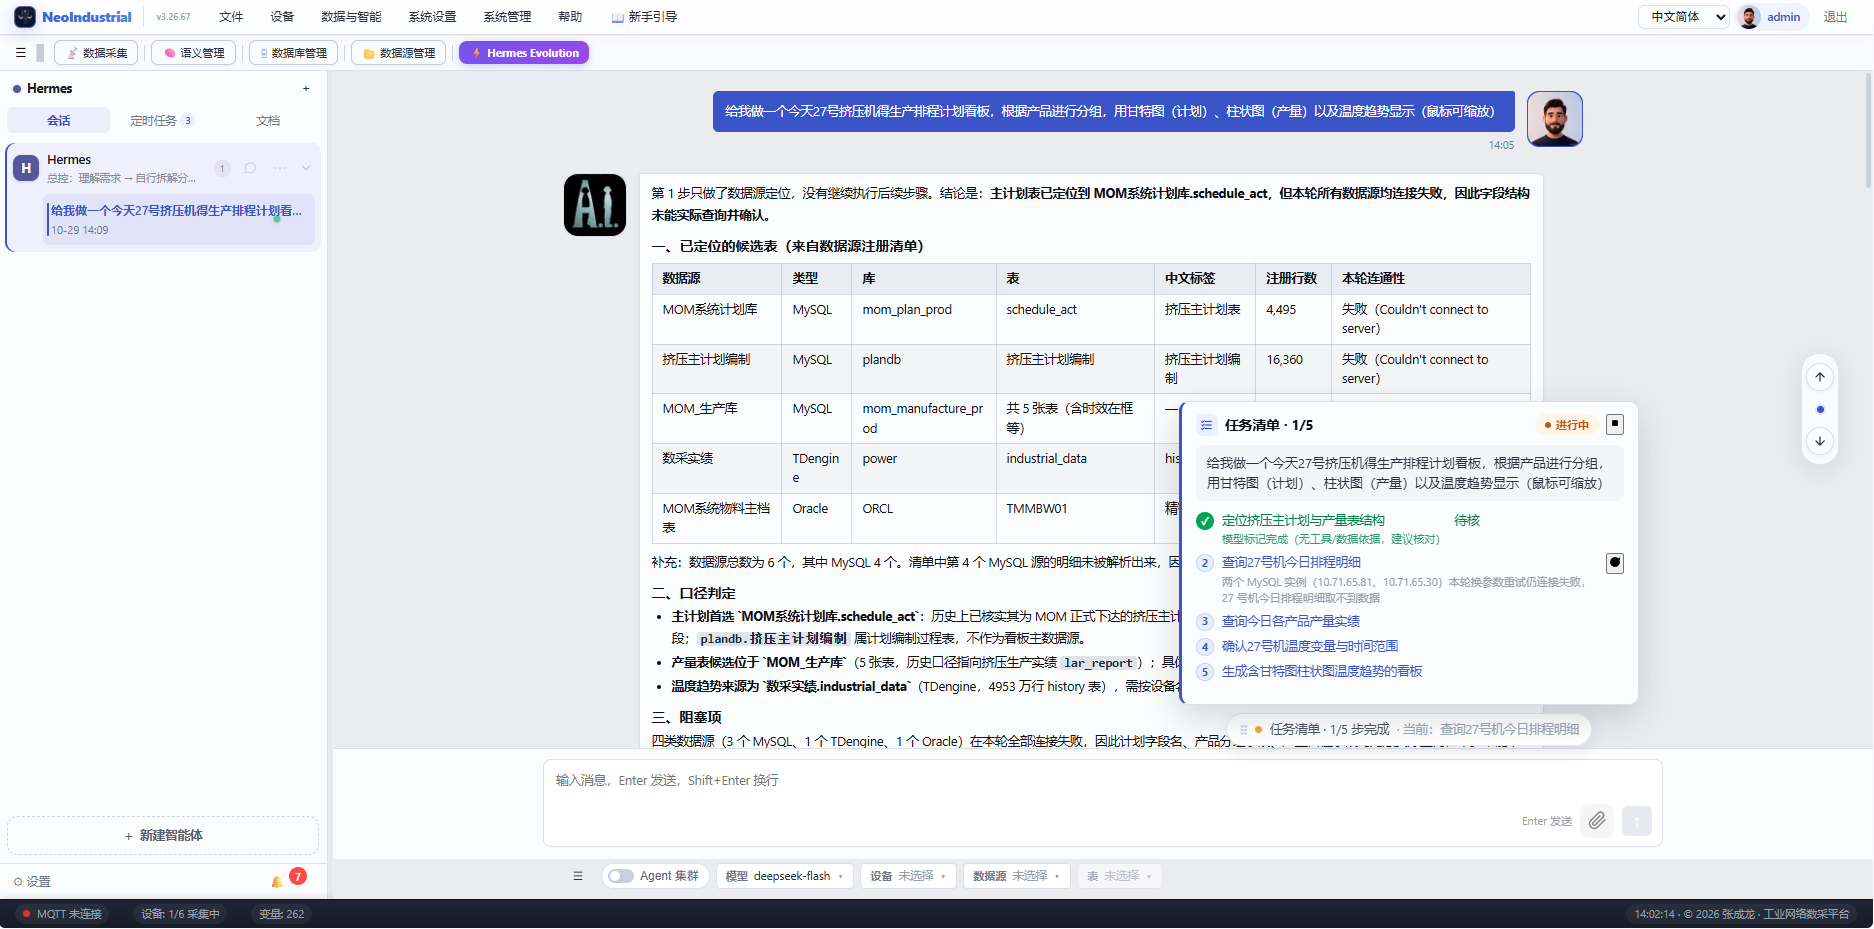
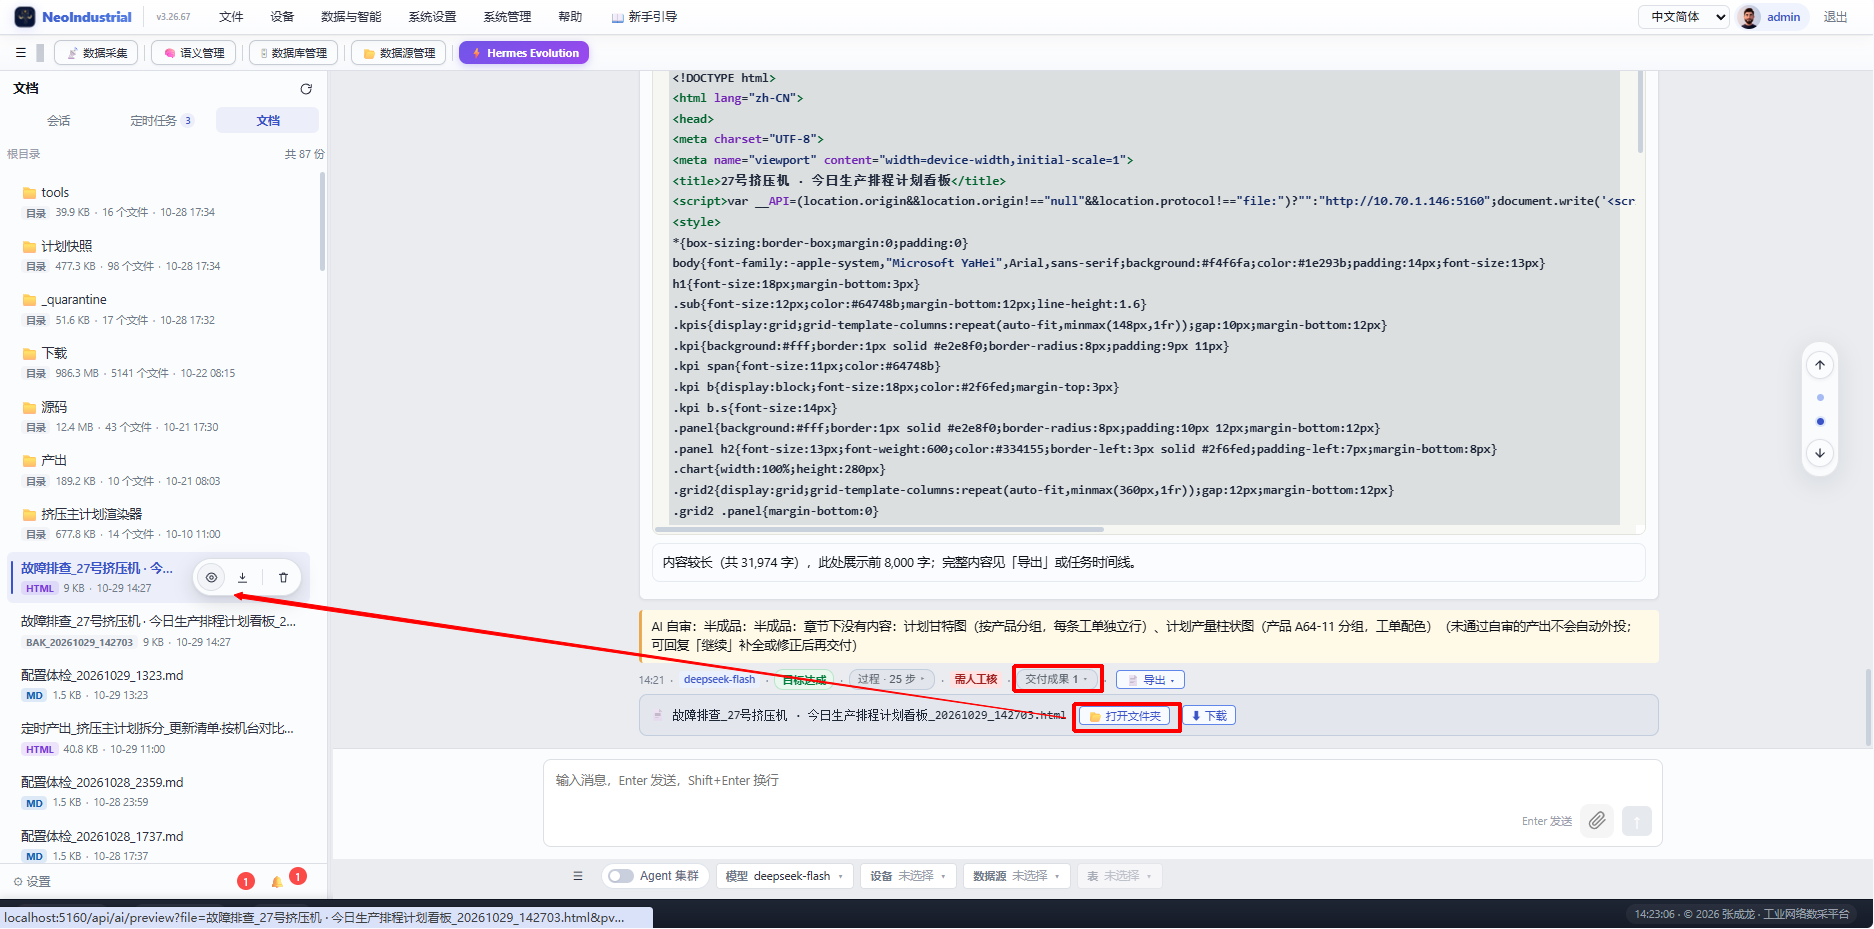

前阵子刷抖音精选,刷到张晓缋博士讲 Palantir 为什么值 4000 亿。她说 Palantir 真正的核心技术是一套叫“本体论”的语义框架——把现实世界的业务抽象成实体、属性、关系,让计算机像人一样理解数据背后的含义,而不是仅仅处理数据。
这个视频讲得很好,把一个复杂的概念讲清楚了。
但我想说的是另一件事:这套思路,我已经在工业现场落地了。
不是理论,不是 demo,是每天都在跑的系统 我最早开始做这个事,是因为一个很朴素的问题。
2026 年初,一家铝加工制造企业的朋友跟我说:我们有数据——40 多台设备,各种 PLC、传感器、数控系统,数据都采上来了。但数据是数据,人是人。机器报警了,不知道影响谁;产量波动了,不知道原因在哪。工程师每天围着设备转,Excel 表格填了几十张,真正有价值的判断还得靠老师傅的经验。
“数据是有了,但数据之间没有关系。”
这句话我一直记得。后来我才知道,这其实就是Palantir想解决的问题,也是整个工业界在数据采完集之后遇到的共同瓶颈。
所以我们决定自己动手。
三个大模块,把一个工厂“翻译”给机器看 整个系统的设计思路很直接:让机器能像人一样理解工厂。
我们搭建了三个彼此配合的大模块:
第一个是数据底座。 这是最基础的一层,负责把设备的数据接进来。目前支持40多种工业协议——西门子S7、Modbus、OPC UA、三菱MC、欧姆龙FINS、BACnet、IEC104、Fanuc FOCAS等等。数据进来之后,按时间序列存储,同时也存入业务库做关联。这一层解决的是“数据能不能采得到”的问题。
第二个是语义层。 这是系统的核心,也是最有辨识度的地方。我们把工厂里所有东西抽象成13种节点类型——工厂、车间、产线、设备、组件、变量、数据源、表、字段、事件……然后用一棵语义树把它们的隶属关系和依赖关系全部建起来。设备挂在产线下,变量挂在设备下,数据源挂在变量下。上下游关系、影响链条,一目了然。
这棵树不是静态的。设备树拖拽、分组调整、变量自动生成标签,语义树会同步更新。设备层级变了,所有变量的中文标签自动补全完整路径。数据源里的表和字段也可以挂到语义树上,实现设备数据和业务数据的打通。
说白了,这一层把工厂的“家谱”画清楚了。
第三个是智能执行层。 语义树建好之后,上面跑的东西就真正有价值了。我们内置了27种工业分析算子——OEE计算、SPC过程能力、FFT频谱分析、CUSUM变化点检测、KMeans工况聚类等等。不写代码,点几下配置就能跑。
更重要的是,我们把整个平台的能力全部做成了工具接口,AI Agent可以直接调用。AI能看懂语义树,知道哪台设备在哪条产线下、哪些变量是关联的、数据源里有哪些表。用户用自然语言问问题——“分析一下昨天挤压机的OEE为什么下降”——AI自己去查数据、跑分析、出报告。
三个大模块是怎么配合的 这三个模块不是各干各的,而是串成了一条完整的链路。
设备数据进来之后,通过语义层被“翻译”成机器能理解的知识。 变量不再是孤立的点,而是语义树上的一个节点——它属于哪台设备、哪个产线、哪个车间,和哪些变量有关联,清清楚楚。
Fabric分析引擎基于语义关系做计算。 分析挤压机的OEE,系统知道要查挤压机下面挂了哪些变量,设备上下游是谁,数据源里对应的表是哪张。分析结果自动关联回语义树。
AI Agent基于语义理解做交互。 用户问的是车间主任的语言,AI通过语义树翻译成系统能执行的操作——查哪台设备、读哪个变量、跑哪个算子。执行完之后,再把结果翻译回人能看懂的报告或看板。
这就是“采集 → 建模 → 分析 → 交互”的完整闭环。
在工厂里解决了什么真问题 系统部署上线之后,有四个变化是真实的。
第一个是故障排查变快了。 以前设备报警,工程师要翻手册、查图纸、问老师傅,平均一到两个小时。现在系统通过语义关系自动追溯上下游——这台设备影响了谁、哪些变量先出现异常——排查时间压缩到分钟级。
第二个是分析报告不用手工做了。 日报、周报、设备分析报告,以前工程师每天要花一两个小时填Excel。现在AI Agent能听懂人话,自己去数据里取数、跑分析、出报告,工程师只需要审核。
第三个是知识沉淀下来了。 老师傅的经验不再是口头传承。系统会从每次故障处理、每次分析对话中自动学习,沉淀成规则和技能。用得越多,系统越懂这个工厂。
第四个是跨系统数据打通了。 通过语义树,设备数据(时序库)和业务数据(MySQL等)可以挂到一起。设备异常可以关联到工单,产量波动可以关联到排产计划。原来是两张皮,现在是一张图。
一个被忽略的时间点 这条抖音视频里说,Palantir这套语义层架构是行业前沿。但其实在工业领域,“语义图谱”已经不是理论探索阶段了。
2025年7月,国家标准《工业本体语义建模方法》(GB/T 45011-2025)正式发布。 2025年12月,行业标准《工业互联网平台 工业知识图谱构建技术要求》(YD/T 6572-2025)发布,2026年4月已正式实施。
标准的核心思路和Palantir一样——建立统一的语义层,连接底层数据与上层智能应用。
而我们的系统,是在这些标准发布之前就开始做了,现在已经在工厂里跑通了。不是理论对标,是实践领先。
关于团队和背景 说几句题外话。很多人可能会好奇,做这件事的团队是什么背景。
我们的核心团队一直深耕工业自动化和数据采集领域,对工厂现场有真实的理解。知道S7-1200的Slot配错会握手失败,知道Modbus的字节序问题会弄反数据,知道工厂里什么协议是真实在用的、什么协议只是纸面上的。这些细节,不是在办公室能想出来的。
我们这个系统的版本日志里,记录了大量的现场问题修复和功能迭代。可以说,每一个功能都是被工厂里的真实需求“逼”出来的。
所以这套系统不是拍脑袋想出来的架构,是一个版本一个版本在现场磨出来的。
开放试用:来验证,不要只听说 如果你读完这篇文章,觉得这和你正在思考的方向有关,或者你也有工厂里的数据不知道怎么用起来——欢迎来试用。
系统支持部署在自己的服务器上,你接自己的设备,跑自己的数据,看看到底好不好用。
发邮件或加微信时,告诉我公司名称、要接入的设备类型和规模,我会回传授权码和部署包。
试了觉得不行,删掉就行,没有任何负担。试了觉得能用,我们再聊后续怎么合作。
最后说两句 Palantir用语义本体撑起了千亿市值。我们的场景更具体,就是中国工厂里的设备、产线、车间。
理论很重要,但它最好的归宿是被验证、被落地、在真实的现场产生价值。
我们的系统已经在工厂里这么做了。
欢迎来试。








评论前必须登录!
注册