 网硕互联帮助中心
MoE训练效率的新思路:当GPU内存成为瓶颈,我们是否应该重新思考负载均衡?
摘要
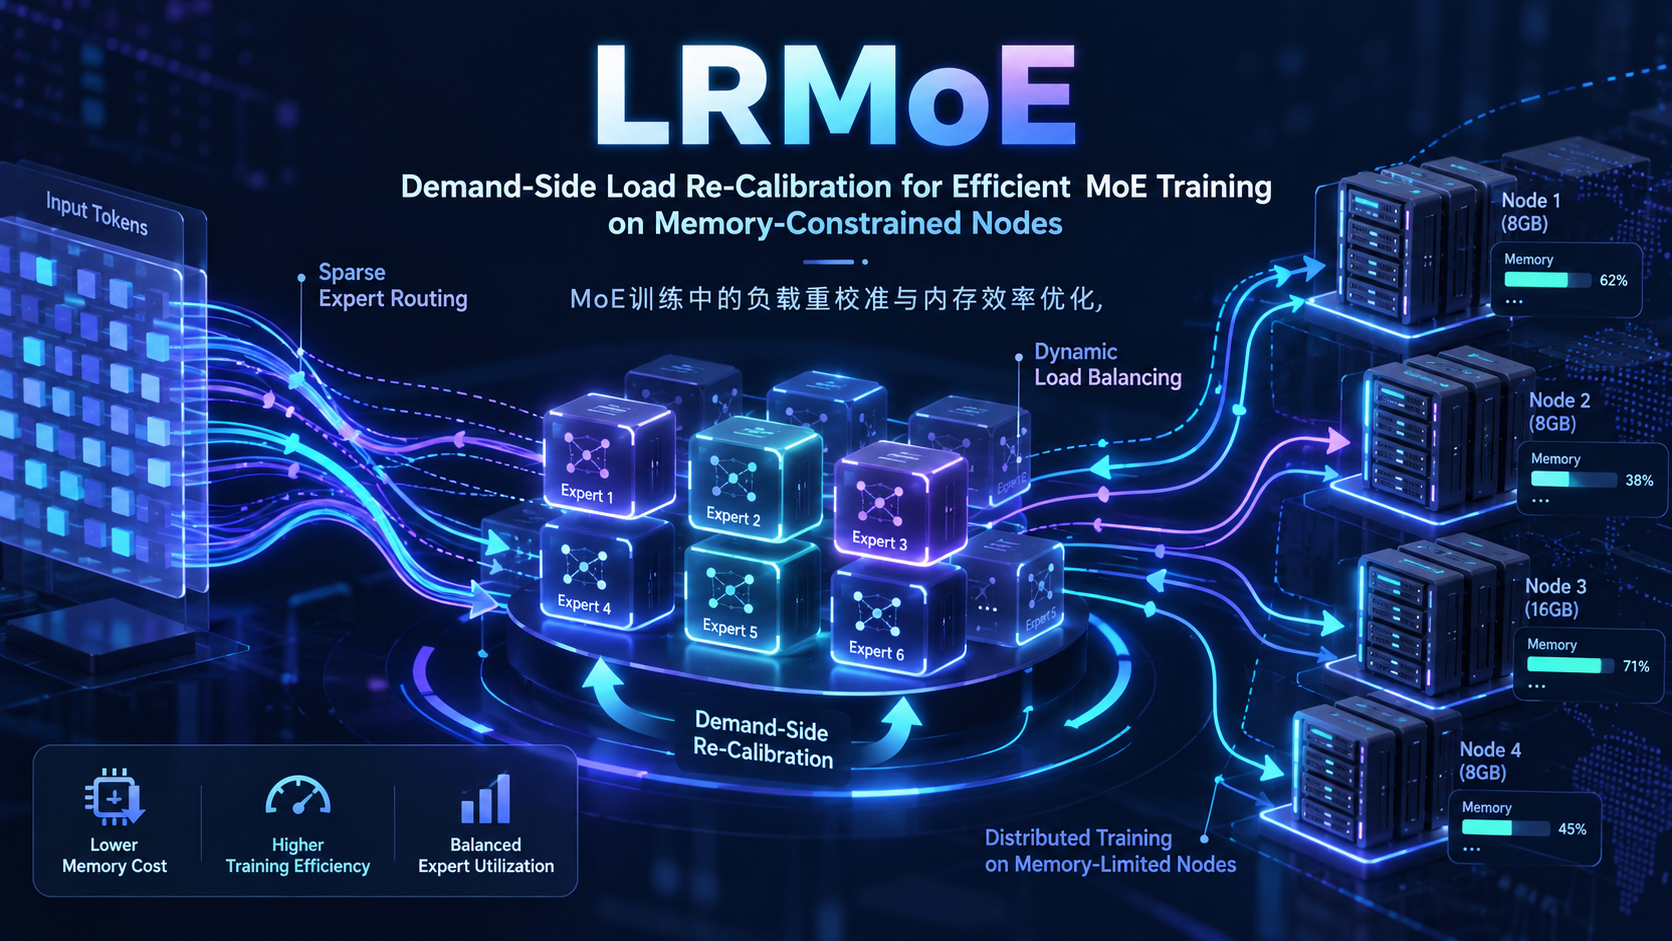
随着大规模语言模型向稀疏混合专家架构发展,MoE训练的瓶颈正逐渐从模型计算转向GPU内存、专家负载分布与跨设备通信。传统负载均衡主要通过专家复制和动态部署重新分配计算任务,却难以消除总计算需求超过硬件承载能力的问题。我认为,更值得关注的方向,是从反向传播的实际需求出发,重新评估每个Token对专家参数更新的贡献,在有限资源下优先保留高价值计算,从而实现计算、通信与内存的协同优化。
一、MoE架构越来越大,为什么GPU反而越来越不够用了?
过去几年,大语言模型的发展基本沿着一个明确的方向前进:扩大模型参数规模、增加训练数据、提升计算能力。但随着模型规模不断增长,传统稠密模型逐渐暴露出一个问题——每次前向计算都需要激活大量参数,计算成本和显存占用随模型规模迅速增加。
Mixture of Experts(MoE,混合专家模型)提供了一种不同的思路。
它不再要求所有参数同时参与计算,而是将模型中的前馈网络拆分为多个相对独立的专家模块(Expert),通过一个路由网络(Router)决定每个Token应该交给哪些专家处理。
例如,一个拥有128个专家的MoE模型,可以通过Top-8路由策略,让每个Token仅激活其中8个专家。这样,模型能够拥有非常庞大的总参数量,同时保持相对可控的激活计算量。
从模型设计角度来看,这似乎是一个非常理想的解决方案。
但问题并没有消失,而是从模型计算转移到了系统层面。
当大量Token经过Router后,不同专家接收到的任务数量并不相同。有些专家可能在一个训练批次中接收到大量Token,而另一些专家则相对空闲。
在分布式训练中,专家通常被部署在不同GPU上。一个Token被分配到某个专家之后,需要通过All-to-All通信将对应的数据发送到专家所在的GPU,完成计算后,再将结果传回原始位置。
这就形成了一个复杂的执行过程:
-
Token首先经过Router进行专家选择;
-
不同Token按照路由结果分配到不同GPU;
-
GPU之间通过All-to-All完成数据交换;
-
专家执行前向计算;
-
反向传播阶段再次进行数据交换和梯度计算;
-
最终完成专家参数梯度聚合与更新。
这里存在一个非常值得关注的问题:MoE训练的实际执行速度,并不取决于GPU平均有多忙,而往往取决于最繁忙的GPU需要等待多久。
假设8张GPU中,7张GPU已经完成计算,但最后一张GPU仍然有大量Token等待处理,那么整个同步过程就必须等待最后一张GPU。
这就是典型的负载不均衡(Load Imbalance)。
更麻烦的是,负载不均衡不仅会影响计算速度,还会增加中间激活、通信缓存以及专家副本的显存占用。
因此,我认为,MoE训练真正需要解决的已经不只是如何让专家分配更加均匀,而是如何让有限的GPU资源承载更多有效训练任务。
二、传统负载均衡存在一个容易被忽略的问题
面对专家负载不均衡,现有系统已经提出了很多解决方案。
其中一个常见思路是Expert Replication,也就是专家复制。
如果某个专家接收到的Token数量过多,可以在其他GPU上创建该专家的副本,将原本集中在一个GPU上的计算任务分散到多个GPU。
这种方法非常直观。
例如,原本Expert 1部署在GPU 0上,但它接收到的Token数量明显高于其他专家。系统可以在GPU 1和GPU 2上创建Expert 1的副本,让不同Token分配到不同副本上执行。
这样就能够降低单张GPU的计算压力。
此外,还有动态专家部署、负载感知的专家重排,以及根据网络拓扑调整专家位置等策略。
这些方法确实能够改善专家并行训练中的负载分布。
但是,我认为其中存在一个更深层次的问题:
如果整个系统需要处理的反向传播任务总量已经超过GPU集群的实际承载能力,那么无论怎样重新分配任务,都无法从根本上解决问题。
举一个简单的例子。
假设8张GPU,每张GPU都拥有80 GiB显存。其中64 GiB已经被模型参数、优化器状态及其他常驻资源占用,剩余16 GiB需要同时容纳Token通信缓存和额外的专家副本。
此时,如果某些专家出现负载集中,系统就必须考虑增加专家副本。
但是,增加副本意味着需要额外存储







评论前必须登录!
注册