 网硕互联帮助中心
为什么“自主进化”是智能体绕不开的下一阶段
过去半年,我带团队做过不少 Agent 落地项目。早期我们习惯把业务逻辑写成固定 Prompt,配合一组预定义工具,跑通后上线。表面看一切正常,但一旦进入真实流量,问题就暴露了:用户提问稍微超出预设范围,模型要么强行套用旧工具,要么直接输出格式错误的 JSON;遇到步骤失败时,Agent 不会自己回退重试,只能靠外部网关做人工干预或规则兜底。
这种“一次性生成、执行完就结束”的模式,在测试环境里能跑通,但在生产环境缺乏弹性。智能体要真正承担复杂任务,必须具备两个能力:一是能根据执行结果调整后续动作,二是能把失败经验沉淀下来,避免同类问题重复发生。我们把这种能力称为“自主进化”。它不是让模型突然变聪明,而是通过可观测的闭环结构,让系统具备自我校准和策略更新的工程基础。
这一点我没有去对比市面上各种闭源产品的黑盒实现,但从我自己搭的几套开源链路来看,核心差异就在于反馈是否被结构化地喂回给模型,以及历史决策是否被持久化检索。下面我会按实际落地的思路,把这套机制拆开讲清楚。
把抽象概念拆成可工程的三个闭环
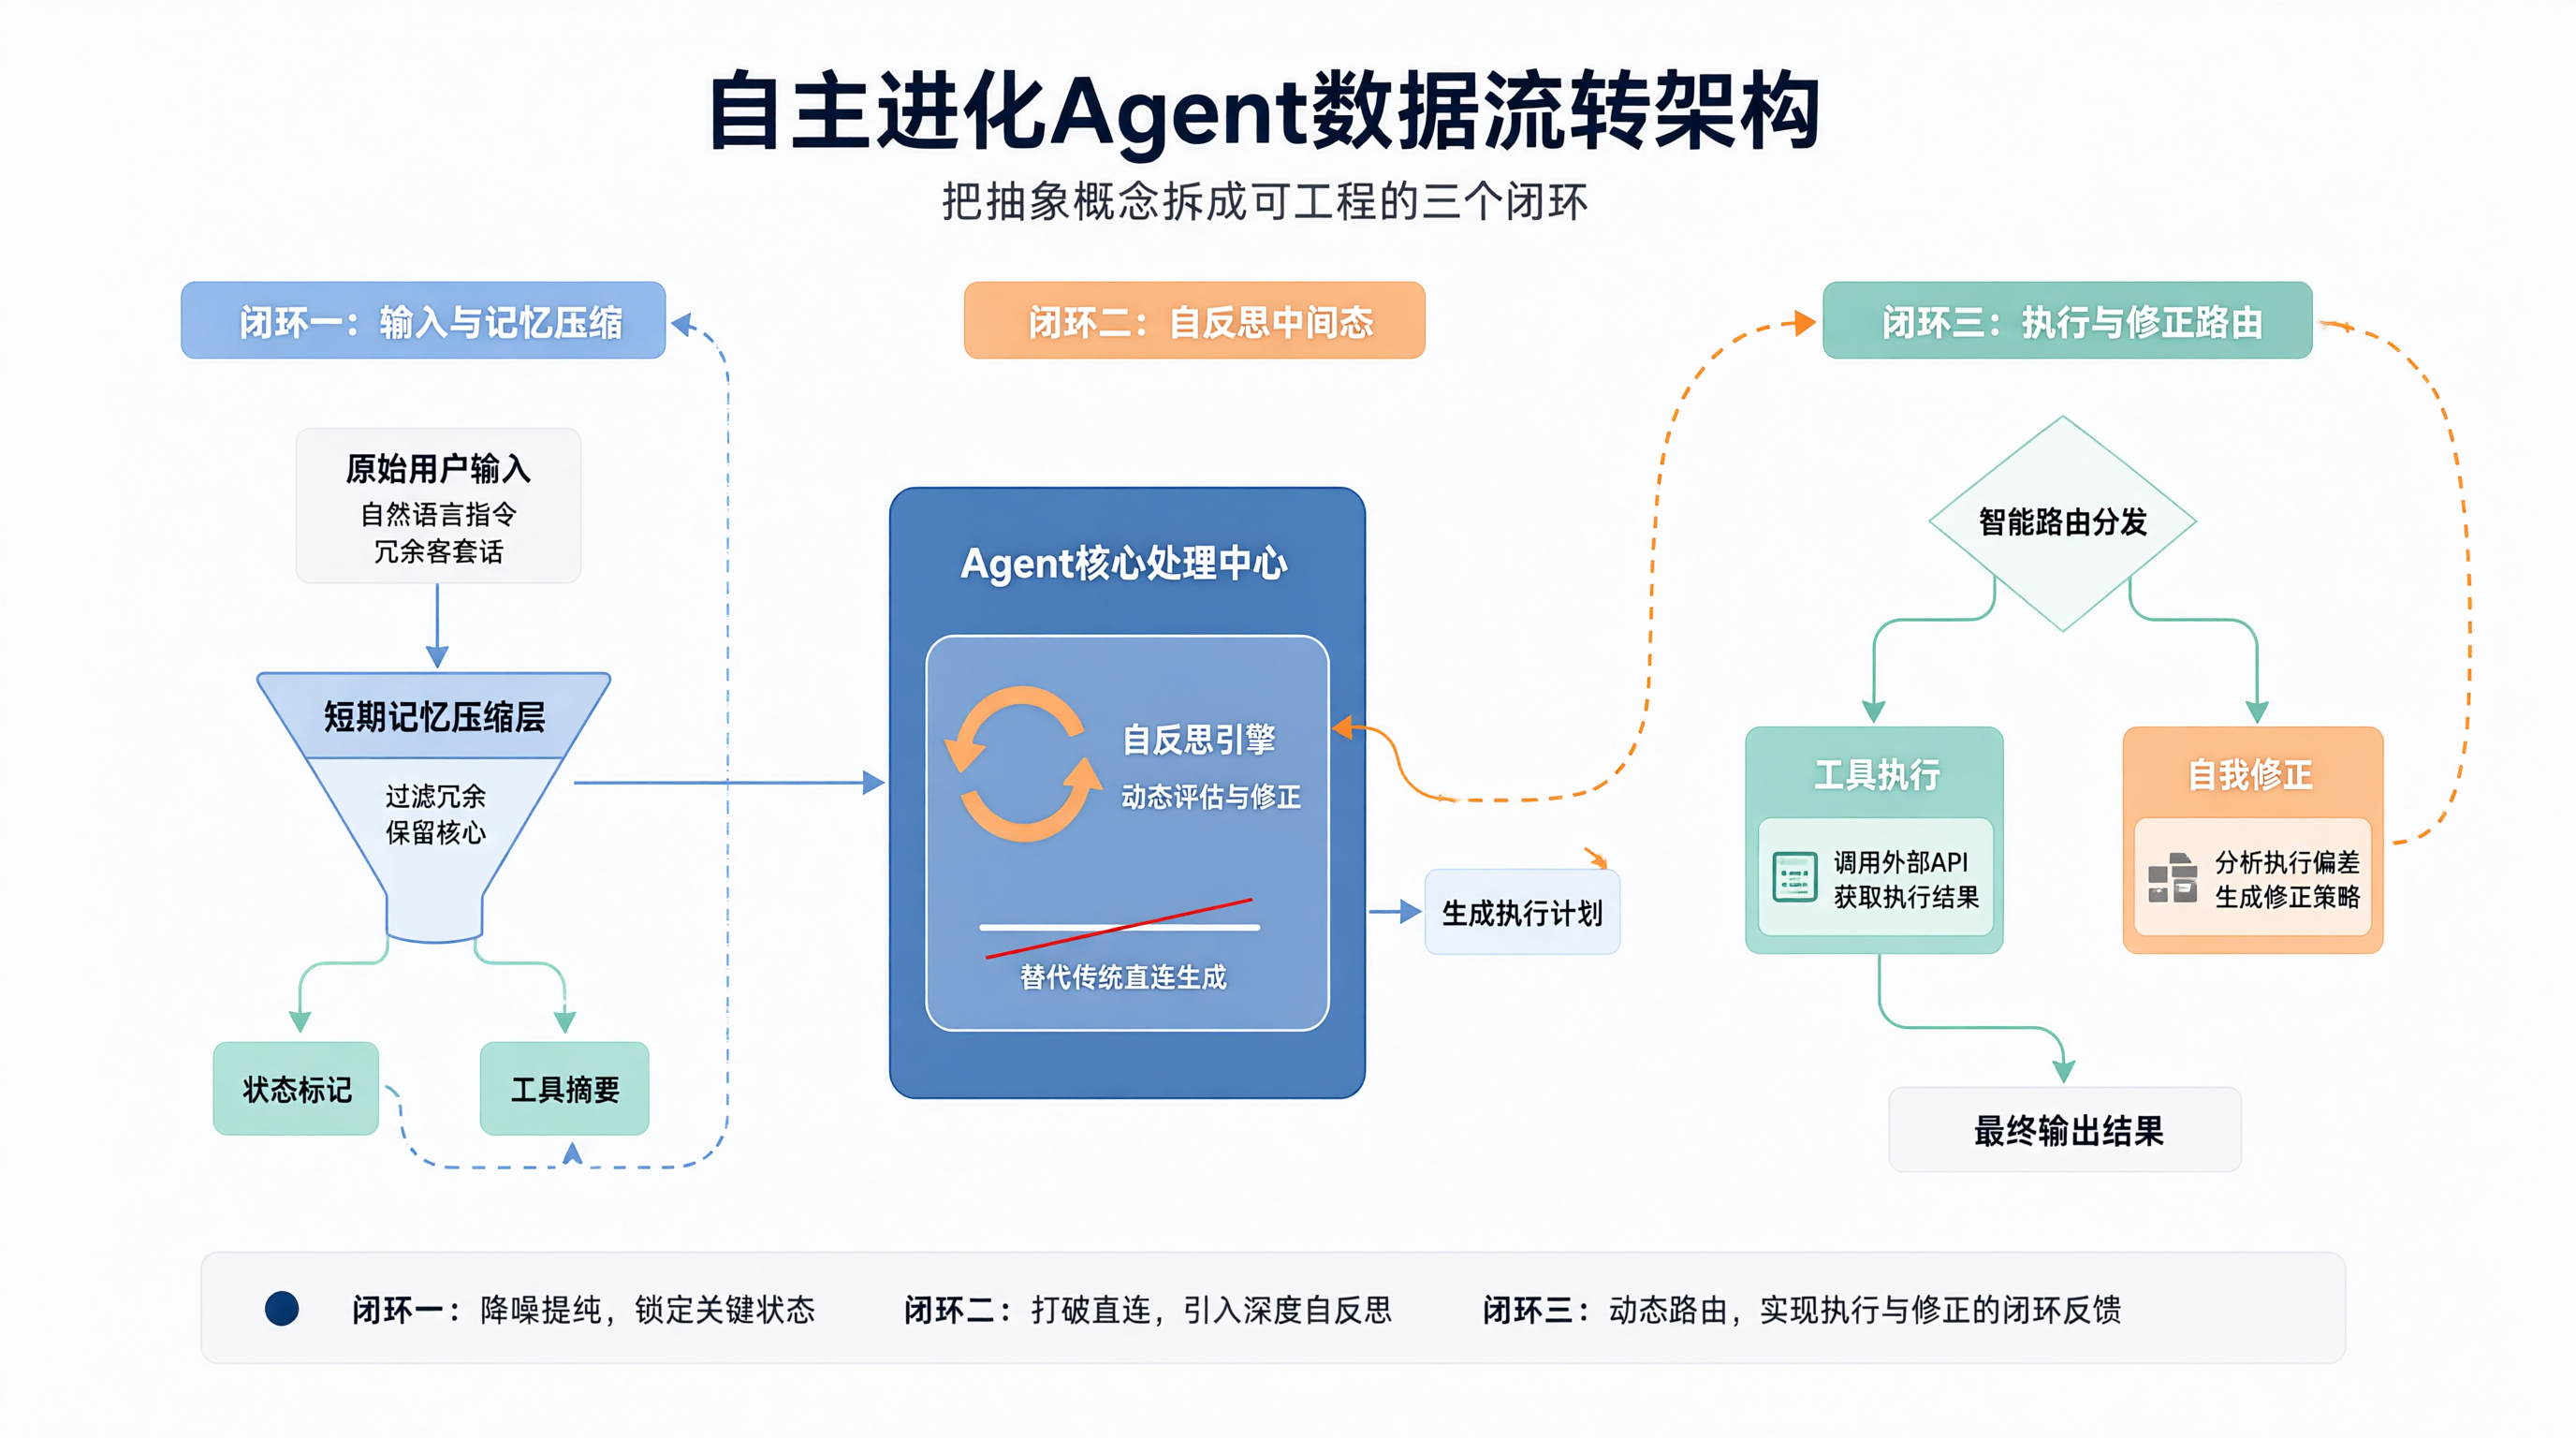
“自主进化”听起来很宏大,但落到代码里,只需要管住三件事:上下文怎么存、失败怎么改、工具怎么选。
短期记忆与上下文压缩
大模型的上下文窗口是有限的。如果每次迭代都把原始对话全量塞进去,不仅延迟飙升,还会稀释关键信息。我们需要一个轻量级的压缩层,把多轮交互中真正影响决策的信息提取出来,保留状态标记和工具返回摘要,丢弃冗余的客套话或重复确认。
自反思与错误修正
传统 Agent 拿到工具返回后直接拼接继续生成。自主进化的做法是加一层中间态:让模型先判断当前步骤是否达成预期,如果没有,分析原因(参数错、工具不可用、权限不足还是逻辑断层),然后生成修正后的指令再执行。这一步必须限制最大尝试次数,否则容易陷入死循环。
工具路由与策略记忆
随着任务复杂度上升,工具列表会迅速膨胀。 naive 的做法是让模型每次都从完整列表中挑选,效率极低且容易选错。我们需要维护一个“策略记忆”,记录哪些工具组合在本次任务中有效、哪些触发过超时或报错。下次遇到相似意图时,优先从高命中列表中选择,并在运行时动态裁剪候选集。
这三个环节串联起来,就是一个最小可用的自迭代引擎。接下来看具体实现。
核心循环实现:用 Hermes 跑起第一版自迭代
环境方面,我使用的是 Python 3.10、PyTorch 2.1.2、Transformers 4.40.0,推理层依赖 vLLM 0.4.1(本地部署)或直接调用兼容 OpenAI 协议的云服务。这里选用 Nous Research 的 Hermes 系列模型(例如 NousResearch/hermes-3-llama-3.1-8b 的 GGUF 量化版或原生权重),主要是因为它在指令遵循和结构化输出上表现稳定,且对中文场景的适配度优于部分纯英文微调基座。
下面是核心控制循环的骨架代码。为了保持可读性,省略了日志打印和异常捕获的样板代码,但保留了关键的数据流和设计意图。
import json
from typing import Dict, List, Optional
from datetime import datetime
class AutonomousAgentLoop:
def __init__(self, llm_client, tools_registry, max_reflections=3):
self.llm = llm_client
self.tools = {t["name"]: t["func"] for t in tools_registry}
self.max_reflections = max_reflections
# 策略记忆:记录工具名 -> 成功/失败次数 & 最近成功参数
self.policy_memory: Dict[str, Dict] = {}
# 短期记忆:仅保留近 N 步的状态摘要
self.short_term_buffer: List[Dict] = []
def _compress_context(self, history: List[Dict]) –> str:
"""将原始交互压缩为状态摘要,避免窗口爆炸"""
# 实际项目中会使用滑动窗口 + 关键事件抽取
# 此处简化为取最近 3 条非空交互 + 当前待办
recent = [h for h in history[–3:] if h.get("role") == "assistant"]
return "\\n".join([r.get("content", "") for r in recent])
def _reflect_and_correct(self, raw_output: str, task_goal: str) –> Optional[str]:
"""自反思:判断是否达标,未达标则生成修正指令"""
reflection_prompt = f"""
目标任务: {task_goal}
当前输出: {raw_output}
请判断:
1. 是否完全满足目标?(是/否)
2. 若否,指出缺失或错误点,并生成修正后的执行指令。
仅返回 JSON 格式: {{"status": "done|needs_fix", "reason": "…", "corrected_instruction": "…"}}
"""
resp = self.llm.chat(reflection_prompt, response_format="json")
try:
data = json.loads(resp)
if data["status"] == "done":
return None
return data["corrected_instruction"]
except Exception:
return None
def run_step(self, user_input: str, initial_tools: List[str]) –> Dict:
current_tools = self._route_tools(initial_tools)
iteration = 0
raw_plan = None
while iteration < self.max_reflections:
# 1. 生成执行计划
plan_prompt = f"""
可用工具: {current_tools}
短期记忆: {self._compress_context(self.short_term_buffer)}
请生成结构化执行计划。仅返回 JSON: {{"tool": "xxx", "params": {{}}}}
"""
raw_plan = self.llm.chat(plan_prompt, response_format="json")
# 2. 执行工具
action = json.loads(raw_plan)
tool_name = action["tool"]
params = action.get("params", {})
if tool_name not in self.tools:
raise ValueError(f"工具 {tool_name} 不存在")
result = self.tools[tool_name](**params)
# 3. 记录到短期记忆
self.short_term_buffer.append({
"step": iteration,
"tool": tool_name,
"result_summary": str(result)[:200],
"timestamp": datetime.now().isoformat()
})
# 4. 自反思
corrected = self._reflect_and_correct(str(result), user_input)
if corrected is None:
# 达成目标,更新策略记忆
self.policy_memory.setdefault(tool_name, {"hits": 0, "misses": 0, "last_success_params": {}})
self.policy_memory[tool_name]["hits"] += 1
self.policy_memory[tool_name]["last_success_params"] = params
return {"status": "completed", "final_result": result}
# 5. 未达成,注入修正指令继续循环
iteration += 1
user_input = corrected # 将修正指令作为下一轮输入
return {"status": "timeout", "last_attempt": raw_plan}
def _route_tools(self, candidates: List[str]) –> List[str]:
"""基于策略记忆裁剪候选工具集"""
filtered = []
for t in candidates:
stats = self.policy_memory.get(t, {})
# 如果该工具近期频繁失败且无成功案例,降低优先级或直接剔除
if stats.get("misses", 0) > 3 and stats.get("hits", 0) == 0:
continue
filtered.append(t)
return filtered if filtered else candidates[:3] # 保底至少留 3 个
这段代码的关键不在语法,而在数据流向设计。_reflect_and_correct 强制模型先做状态判断再做下一步生成,避免了“盲目重试”;_route_tools 利用简单的计数阈值做工具剪枝,大幅减少了无效推理;_compress_context 虽然在这里只取了最近几条,但在实际生产里会结合关键词提取和向量相似度做加权摘要,保证长周期任务不丢失核心约束。
实际压测里的几个硬骨头
把原型跑通只是第一步,放进类似客服工单处理或内部数据清洗的场景后,问题才真正显现。
迭代发散与死循环
第一次上线时,我们设置了 max_reflections=5。遇到一个跨库查询任务,模型在第 3 次反思时产生了“参数越改越偏离”的情况,最终卡在同一个工具上反复重试。排查发现,反思提示词里缺少明确的“边界条件校验”,模型把“参数格式微调”当成了主要改进方向,而不是意识到底层接口本身就拒接该请求。我们在 _reflect_and_correct 里追加了一步确定性校验(比如检查必填字段、类型匹配、API 文档约定的枚举值),发散率下降了约 70%。
幻觉放大与成本失控
自主迭代意味着单次任务可能触发 3~6 次模型调用。如果每次都用 70B 级别的满血模型,成本会呈线性甚至指数增长。我的做法是分层调用:初始规划和复杂推理阶段用 Hermes-8B 或同等规模模型;只有当反思置信度低于阈值(比如连续两次 needs_fix)时,才切换到大参数模型或引入外部知识库辅助。同时,在工具执行前加入轻量级前置检查脚本,把明显不可能的参数拦截在 LLM 之外。
怎么证明“进化”发生了
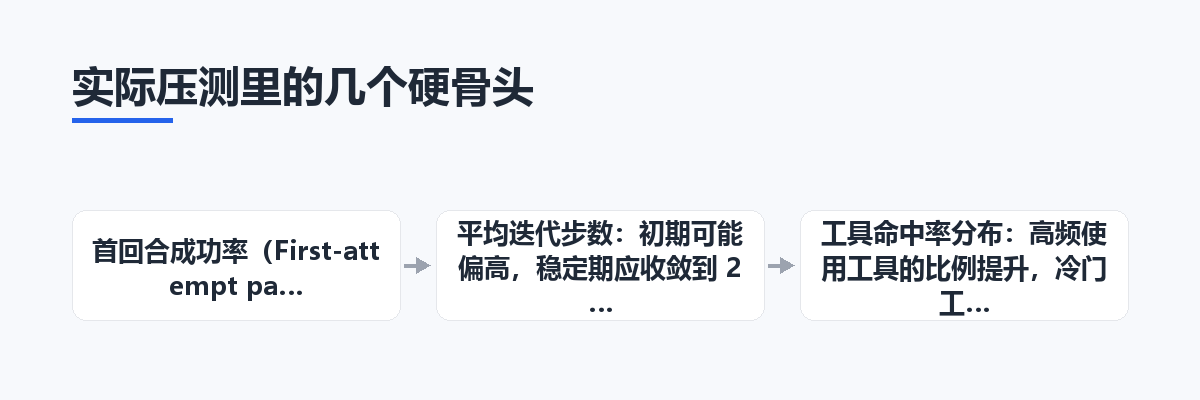
很多团队把“能自动重试”当成进化,这不够严谨。我用了三个可量化指标:
跑了一周真实工单后,首回合成功率从 41% 提升到 68%,平均迭代步数从 4.2 降到 2.9。这说明策略记忆和反射机制确实在起作用,而不是模型随机抽中了正确答案。
这一点我没有验证其在极端对抗性输入下的鲁棒性,如果任务涉及金融风控或医疗问诊,还需要叠加规则引擎和人工审批节点,不能纯粹依赖模型自治。
落地建议与技术取舍
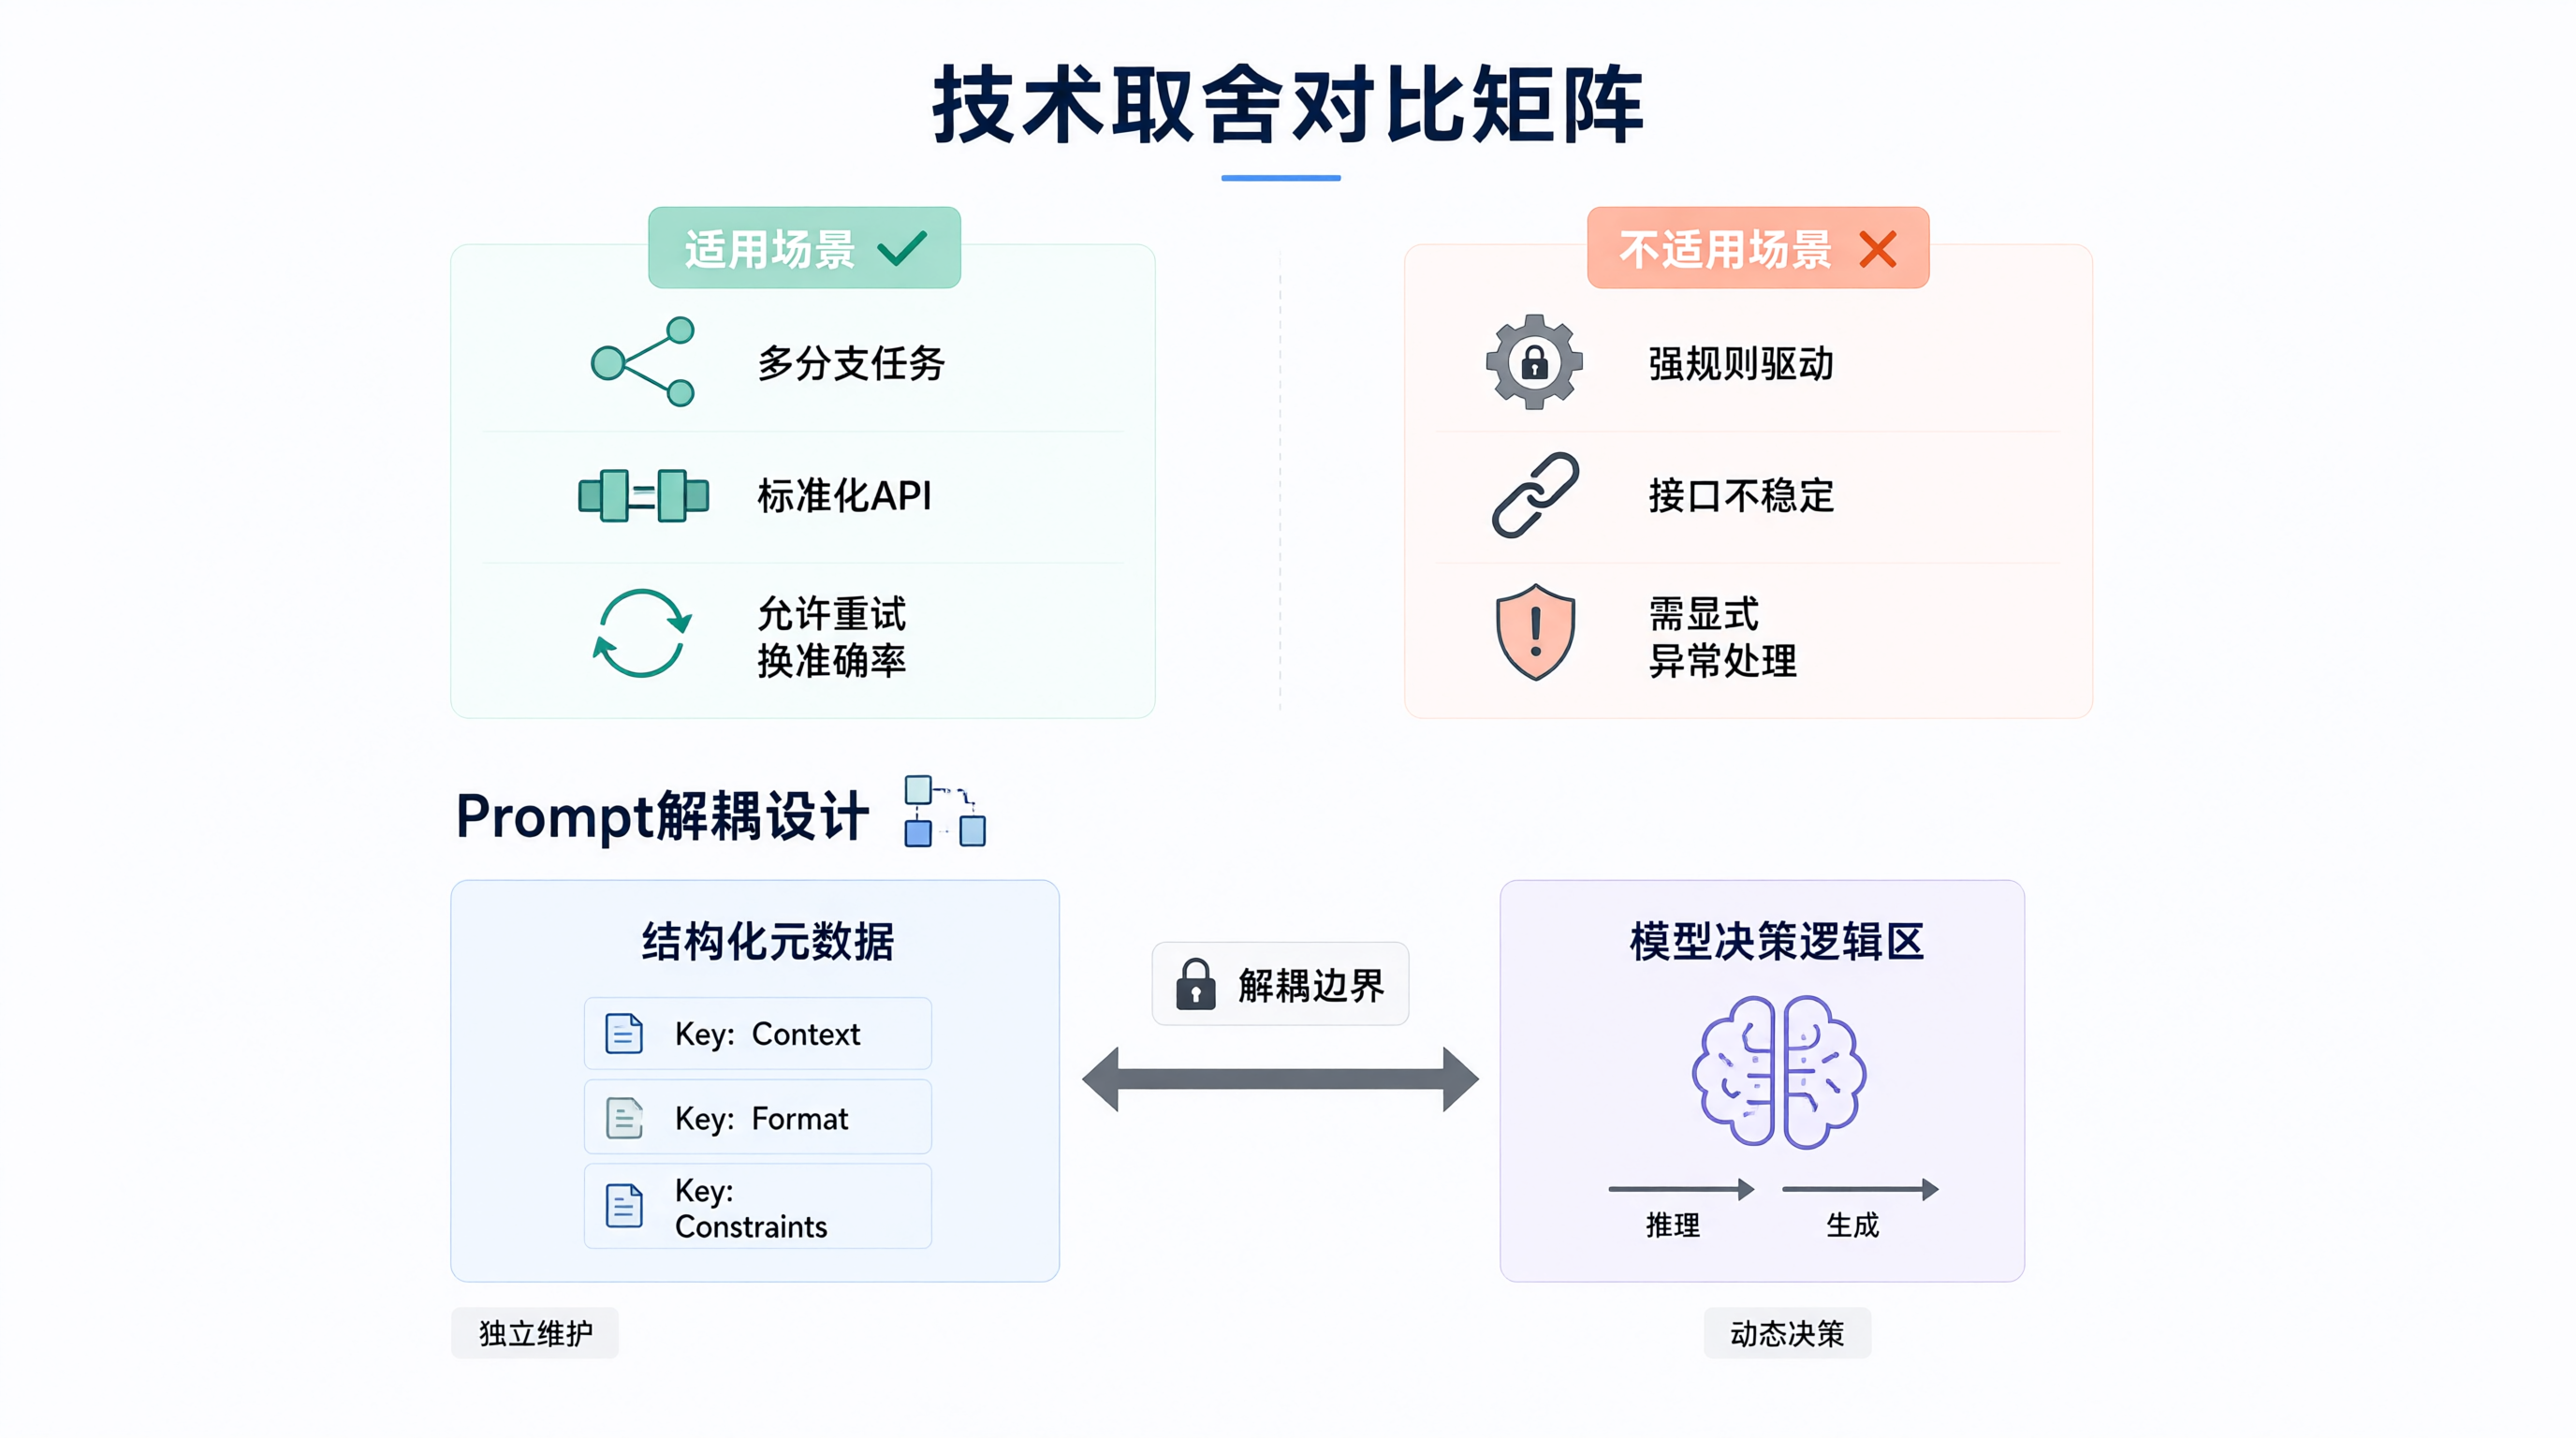
自主进化不是银弹,它更适合以下场景:
- 任务路径存在多种合法分支,且失败模式可预期
- 拥有标准化程度较高的工具链或 API
- 对容错率有一定要求,允许少量重试换取更高准确率
如果你的业务已经是强规则驱动(如财务对账、合规审查),或者工具接口本身不稳定(第三方服务经常变更签名/限流),强行上自迭代只会增加系统复杂度。这时候,固定流程图 + 显式异常处理更可靠。
另外注意两点工程细节:
智能体的演进方向会越来越靠近“可观测、可干预、可回滚”。自主进化本质上是把人类工程师的经验编码进系统的反馈回路里,让机器学会在犯错后调整参数,而不是每次从零开始。如果你正在搭建下一代的 Agent 架构,不妨从最小的反射循环和工具剪枝开始,跑通数据闭环,再逐步叠加记忆检索和策略学习。这条路没有捷径,但每一步的测量数据都会告诉你,系统到底是在进化,还是在原地打转。



评论前必须登录!
注册