 网硕互联帮助中心
大模型做化学反应贝叶斯优化先验:并非万能,有效性不等于对齐性
📄 论文预印本:Auditing LLM Chemical Priors for Multi‑Objective Bayesian Optimization of Chemical Reactions: A Validity, Alignment, and Diversity Benchmark ⚠️ ChemRxiv预印本,欢迎大家讨论
前言
将大语言模型(LLM)作为先验知识,实现化学反应贝叶斯优化的冷启动,是如今自动驾驶实验室、高通量反应优化领域非常火热的方案。 大家普遍认为:LLM阅读了海量化学文献,在没有任何实测数据的优化初期,可以直接给出高质量反应条件,减少昂贵的实验次数。
但LLM作为优化先验的真实收益、潜在风险,在多目标化学反应优化场景下一直缺少系统、大规模的定量基准。 这篇预印本工作就围绕这个问题开展大规模评测:LLM什么时候能够帮到贝叶斯优化?什么时候不起作用?甚至什么时候会拖垮整个优化流程?
完整论文原文: 👉 Auditing LLM Chemical Priors for Multi‑Objective Bayesian Optimization of Chemical Reactions: A Validity, Alignment, and Diversity Benchmark
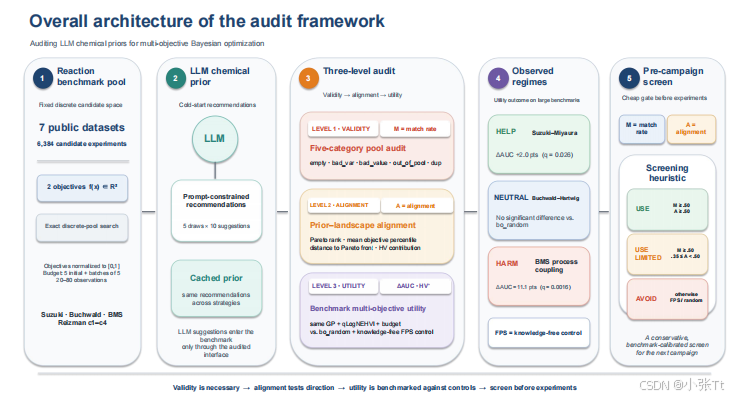
实验方案设计
本文搭建了一套完整的基准测试框架,一共使用7套公开化学反应数据集,合计6384个候选实验,包含Suzuki‑Miyaura、Buchwald‑Hartwig、工业BMS偶联工艺以及4组微流控Suzuki反应案例。
一共对比9种优化策略:LLM初始化贝叶斯优化、LLAMBO、EDBO+、TSEMO、随机初始化BO,还有一个非常关键的对照组:FPS最远点采样BO。
FPS:完全不使用任何化学领域知识,仅仅在特征空间做多样性采样,用来区分性能提升到底来自LLM的化学知识,还是单纯采样多样性。
整个实验共计1480轮优化任务,每个配置重复20个随机种子,采用超体积完成度HV、AUC采样效率积分作为核心评价指标,并且使用Wilcoxon检验与Benjamini‑Hochberg做严格的统计显著性校正。
同时本文提出一个五分类诊断审计协议,可以自动识别LLM输出的五类问题:空输出、错误变量、非法数值、池外候选、重复候选。 能够把LLM的静默式失败转化成可量化、可审计的指标,不需要消耗任何真实实验成本。
三大核心实验现象:帮助、中性、有害
通过大规模基准,论文观察到LLM充当先验会出现三种截然不同的结果。
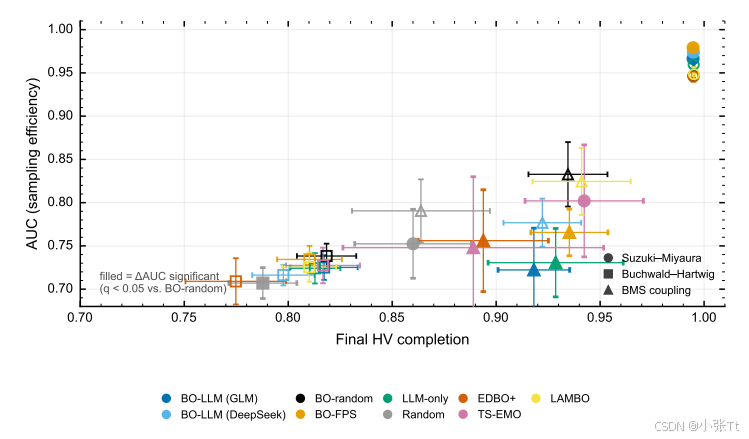
✅ 有益场景:Suzuki‑Miyaura反应 LLM初始化能够显著提升贝叶斯优化的采样效率(ΔAUC +2.0)。 但一个反直觉的事实:该场景下LLM输出池外率高达45%,大量建议不在候选池内; 并且,无任何化学知识的FPS多样性初始化效果甚至优于LLM初始化。 这说明这里LLM带来的收益,很大程度来自采样多样性,而不是模型学到的化学专业知识。
⚪ 中性场景:Buchwald‑Hartwig反应 LLM输出全部合法有效,池外率为0,但是最终优化效果和随机初始化的贝叶斯优化没有统计学差异。 大模型内置的化学知识,在该反应场景下无法给优化带来增益。
❌ 有害场景:BMS工艺偶联反应 这是全文最值得警惕的结论:LLM输出100%合法,没有任何池外幻觉,但是严重破坏优化效率,ΔAUC直接下降11.1点。 LLM推荐的反应条件方向和真实的帕累托优化景观背道而驰。优化最早期宝贵的实验预算被消耗,后续贝叶斯优化需要花费大量预算才能缓慢挽回劣势。
重点警示:输出语法合法、没有幻觉,不等于推荐的条件对优化任务有用。池外失效不是最大风险;完全合法但是方向错误的建议更危险。
三层评估框架:有效性‑对齐‑效用
基于实验结果,本文提出有效性Validity → 对齐Alignment → 效用Utility三层评估框架:
对齐程度,才是决定LLM先验好坏的核心,而不是有效性。 在多个测试案例中,仅靠FPS多样性采样,就可以复现甚至超过LLM初始化带来的全部性能收益。
零实验成本:预 campaign 筛查启发式规则
论文给出一套可以在做实验之前直接运行的筛查流程,不需要做任何真实实验,用来判断要不要启用LLM作为BO初始化。
| M≥0.5 并且 A≥0.5 | 可以完整使用LLM先验 |
| M≥0.5 并且 0.35 ≤ A <0.5 | 有限使用LLM,搭配多样性采样补齐初始点 |
| 其他全部情况 | 禁用LLM,改用FPS或者随机初始化 |
注意:这套阈值是在现有7个数据集上回溯得到,主要用于风险规避,不是普适通用的黄金标准,遇到全新化学反应体系需要重新校准。在本次基准中,这条规则成功拦截了全部有害与完全失效的案例。
给科研人员的实操建议
研究局限性
总结
欢迎大家评论区交流讨论,对自驱动实验室、贝叶斯优化+大模型方向感兴趣可以一起探讨。






评论前必须登录!
注册