 网硕互联帮助中心
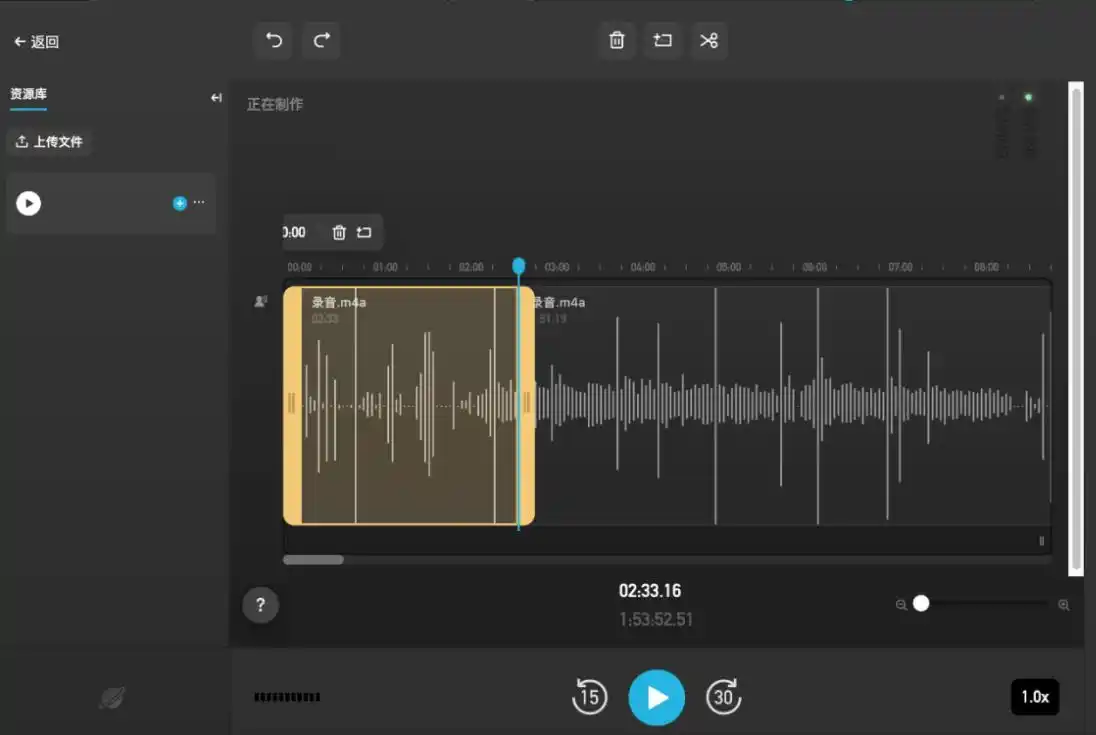
吉他手扒 solo,把整段放慢到 0.75 倍。速度是降下来了,可镲片从「叮」变成一片沙,钢琴的起音像被吸进去,人声尾音带上一股金属味;再往 0.5 倍走,鼓组彻底散架,重音找不到位置。软件明明标着「变速不变调」,为什么音色还是被改写了?
破除误解:变速不变调不是把波形拉长
直觉上,慢放就是把波形横向拉长,音高不变是因为「只动了时间轴」。这个理解错了两处。
第一,波形拉长必然改变周期长度,周期一变,音高就跟着变。要在时长变化的同时保持周期不变,只能改周期的数量——复制一些周期,或者丢掉一些周期。
第二,复制和丢弃都不是无损操作。波形在拼接点上未必连续,相位一跳,谐波结构就被破坏。所谓「变速不变调」,本质是用一层统计模型去猜「这个周期该复制几次、下一段该从哪里接」,猜错的部分就是失真。
底层原理:时域拼接与相位声码器
时间伸缩有两条主流路线。
时域路线是 OLA / WSOLA:在波形上按相似度找拼接点,把相邻段重叠相加。它保留原始相位,瞬态友好;代价是周期性强的素材会出现重影,拼接点处理不好会有轻微的相位跳变。
频域路线是相位声码器(phase vocoder):先做 STFT,逐帧估计每个频带的瞬时频率,再按伸缩因子 α 推进相位,最后逆变换合成。
φ(m+1, k) = φ(m, k) + α · ω_k · H
ω_k 是第 k 个频带的中心频率,H 是帧移,α 是时间伸缩因子。α = 0.75 表示放慢到 0.75 倍:帧与帧之间的相位走得慢一些,用更多帧覆盖同样长的时间。
这条公式对「稳定的正弦」非常准。问题在于,真实音乐里有一大半能量并不符合「一个频带一个正弦」这个假设——瞬态不是,混响不是,镲片不是。三个失真都从这条假设的裂缝里长出来。
失真一:瞬态被摊开成一段斜坡
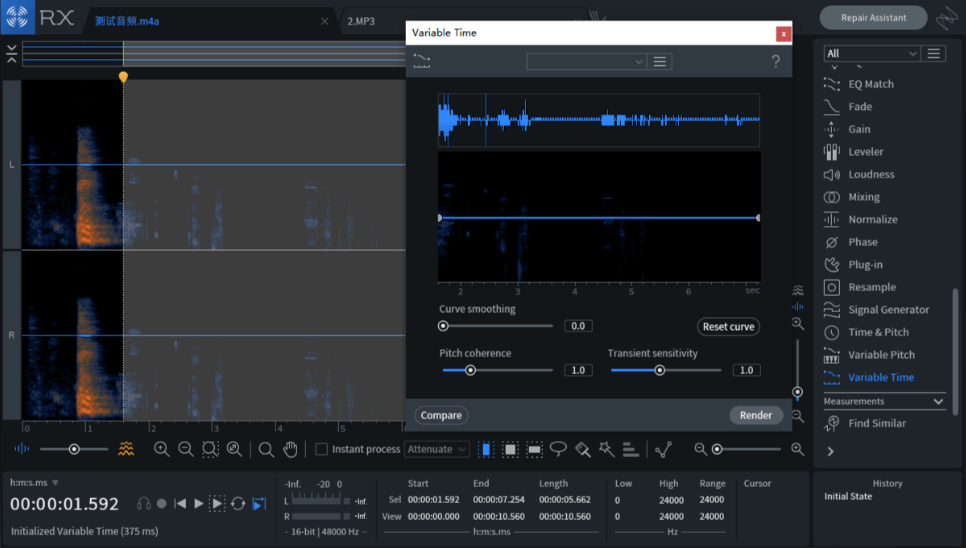
起音(attack)只有几毫秒,频谱是宽带的,相位是整齐的。相位声码器按帧处理,1024 点、44.1kHz 下一帧约 23ms,比整个起音还长。
起音落在两三帧里,每帧都按自己的相位推进重新合成,结果同一个起音被「唱」了两三遍,叠在一起变成一段有斜坡的爬升。
听感上的变化很具体:鼓从「打」变成「推」,钢琴从「敲」变成「按」,贝斯的手指噪声变成一声呼。
α 越小越明显。0.9 倍还能忍,0.75 倍开始糊,0.5 倍基本没有瞬态可言。这也是练琴放慢到 0.5 倍时节拍感先崩的原因——不是速度问题,是起音位置被抹平后,重音不再清晰。
缓解只有两条路:换时域算法,或者分段处理,把鼓点密集的段落切短,每段单独伸缩,别让一次长伸缩把整个时间轴算一遍。
失真二:相位不相干带来的金属味
相位声码器假设每一帧里、每个频带只有一个正弦分量。真实的混响尾音、合唱人声、弦乐群奏,一个频带里同时挤着好几个分量,相位各不相同。
帧间做相位推进时,这些分量被强行按同一个 ω_k 往前推,误差逐帧累积。合成时相邻帧重叠相加,误差表现为频带内的干涉:某些频率被加强,某些被抵消,形成周期性的梳状起伏。
听感就是那股金属味或者水声,尤其在混响尾巴上——正常应该是平滑衰减,处理后变成一串有节奏的抖动。工程上把这种失真叫 phasiness,缓解手段是相位锁定(phase locking):以谱峰为锚,让峰附近的频带共享同一个相位推进量,牺牲一点频率精度换相位连续性。
失真三:宽带噪声被节奏化
镲片、气声、齿音、呼吸,这些成分没有稳定谐波,频谱是连续的。相位声码器把它们当成一堆靠得很近的正弦,每个都按自己的 ω_k 推进,合成后相对相位被打乱,能量在时间轴上重新分布。
结果就是噪声从「持续的沙」变成「有节奏的沙」:一串跟着帧率走的脉冲。帧移 256 点、44.1kHz 下大约每秒 172 帧,听感像轻微的门限抖动。
这条失真没法靠调 α 解决,只能减少处理次数——一次伸缩,别叠第二次。先变速再变调,等于把同一段素材过了两遍相位重建,金属味会成倍累积。
正确做法:把变速放在分离之后
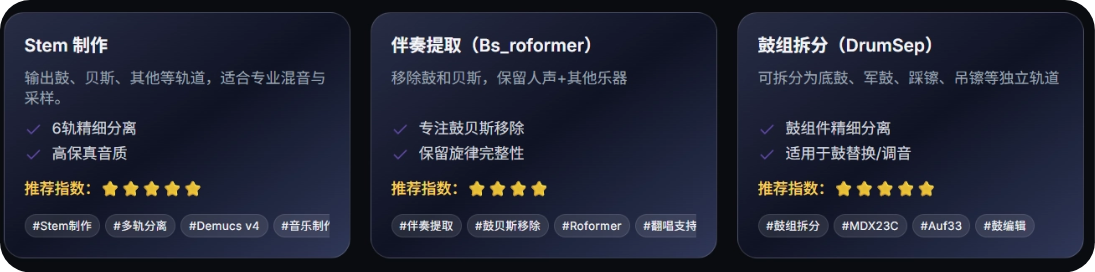
顺序一般要反过来:先分离,再只对伴奏做时间伸缩,人声不动。
原因很直接。人声对相位失真最敏感,一点点 phasiness 就听得出电音味;伴奏里的鼓和贝斯对起音敏感,但对相位不敏感,容忍度高得多。两条轨的容忍度不同,就该分开处理,而不是整曲一起过一遍。
在 AIFooler 里,先上传本地文件做多轨分离,拿到伴奏轨后单独进变速或变调环节,人声轨保持原样。
认知收尾
时间伸缩的失真不是 bug,是「用正弦模型描述非正弦信号」的必然结果。知道哪类素材在哪个倍率上会坏、坏在哪一层,比继续找一个万能倍率更实用。参数表能省试错,但省不掉判断。


评论前必须登录!
注册