 网硕互联帮助中心
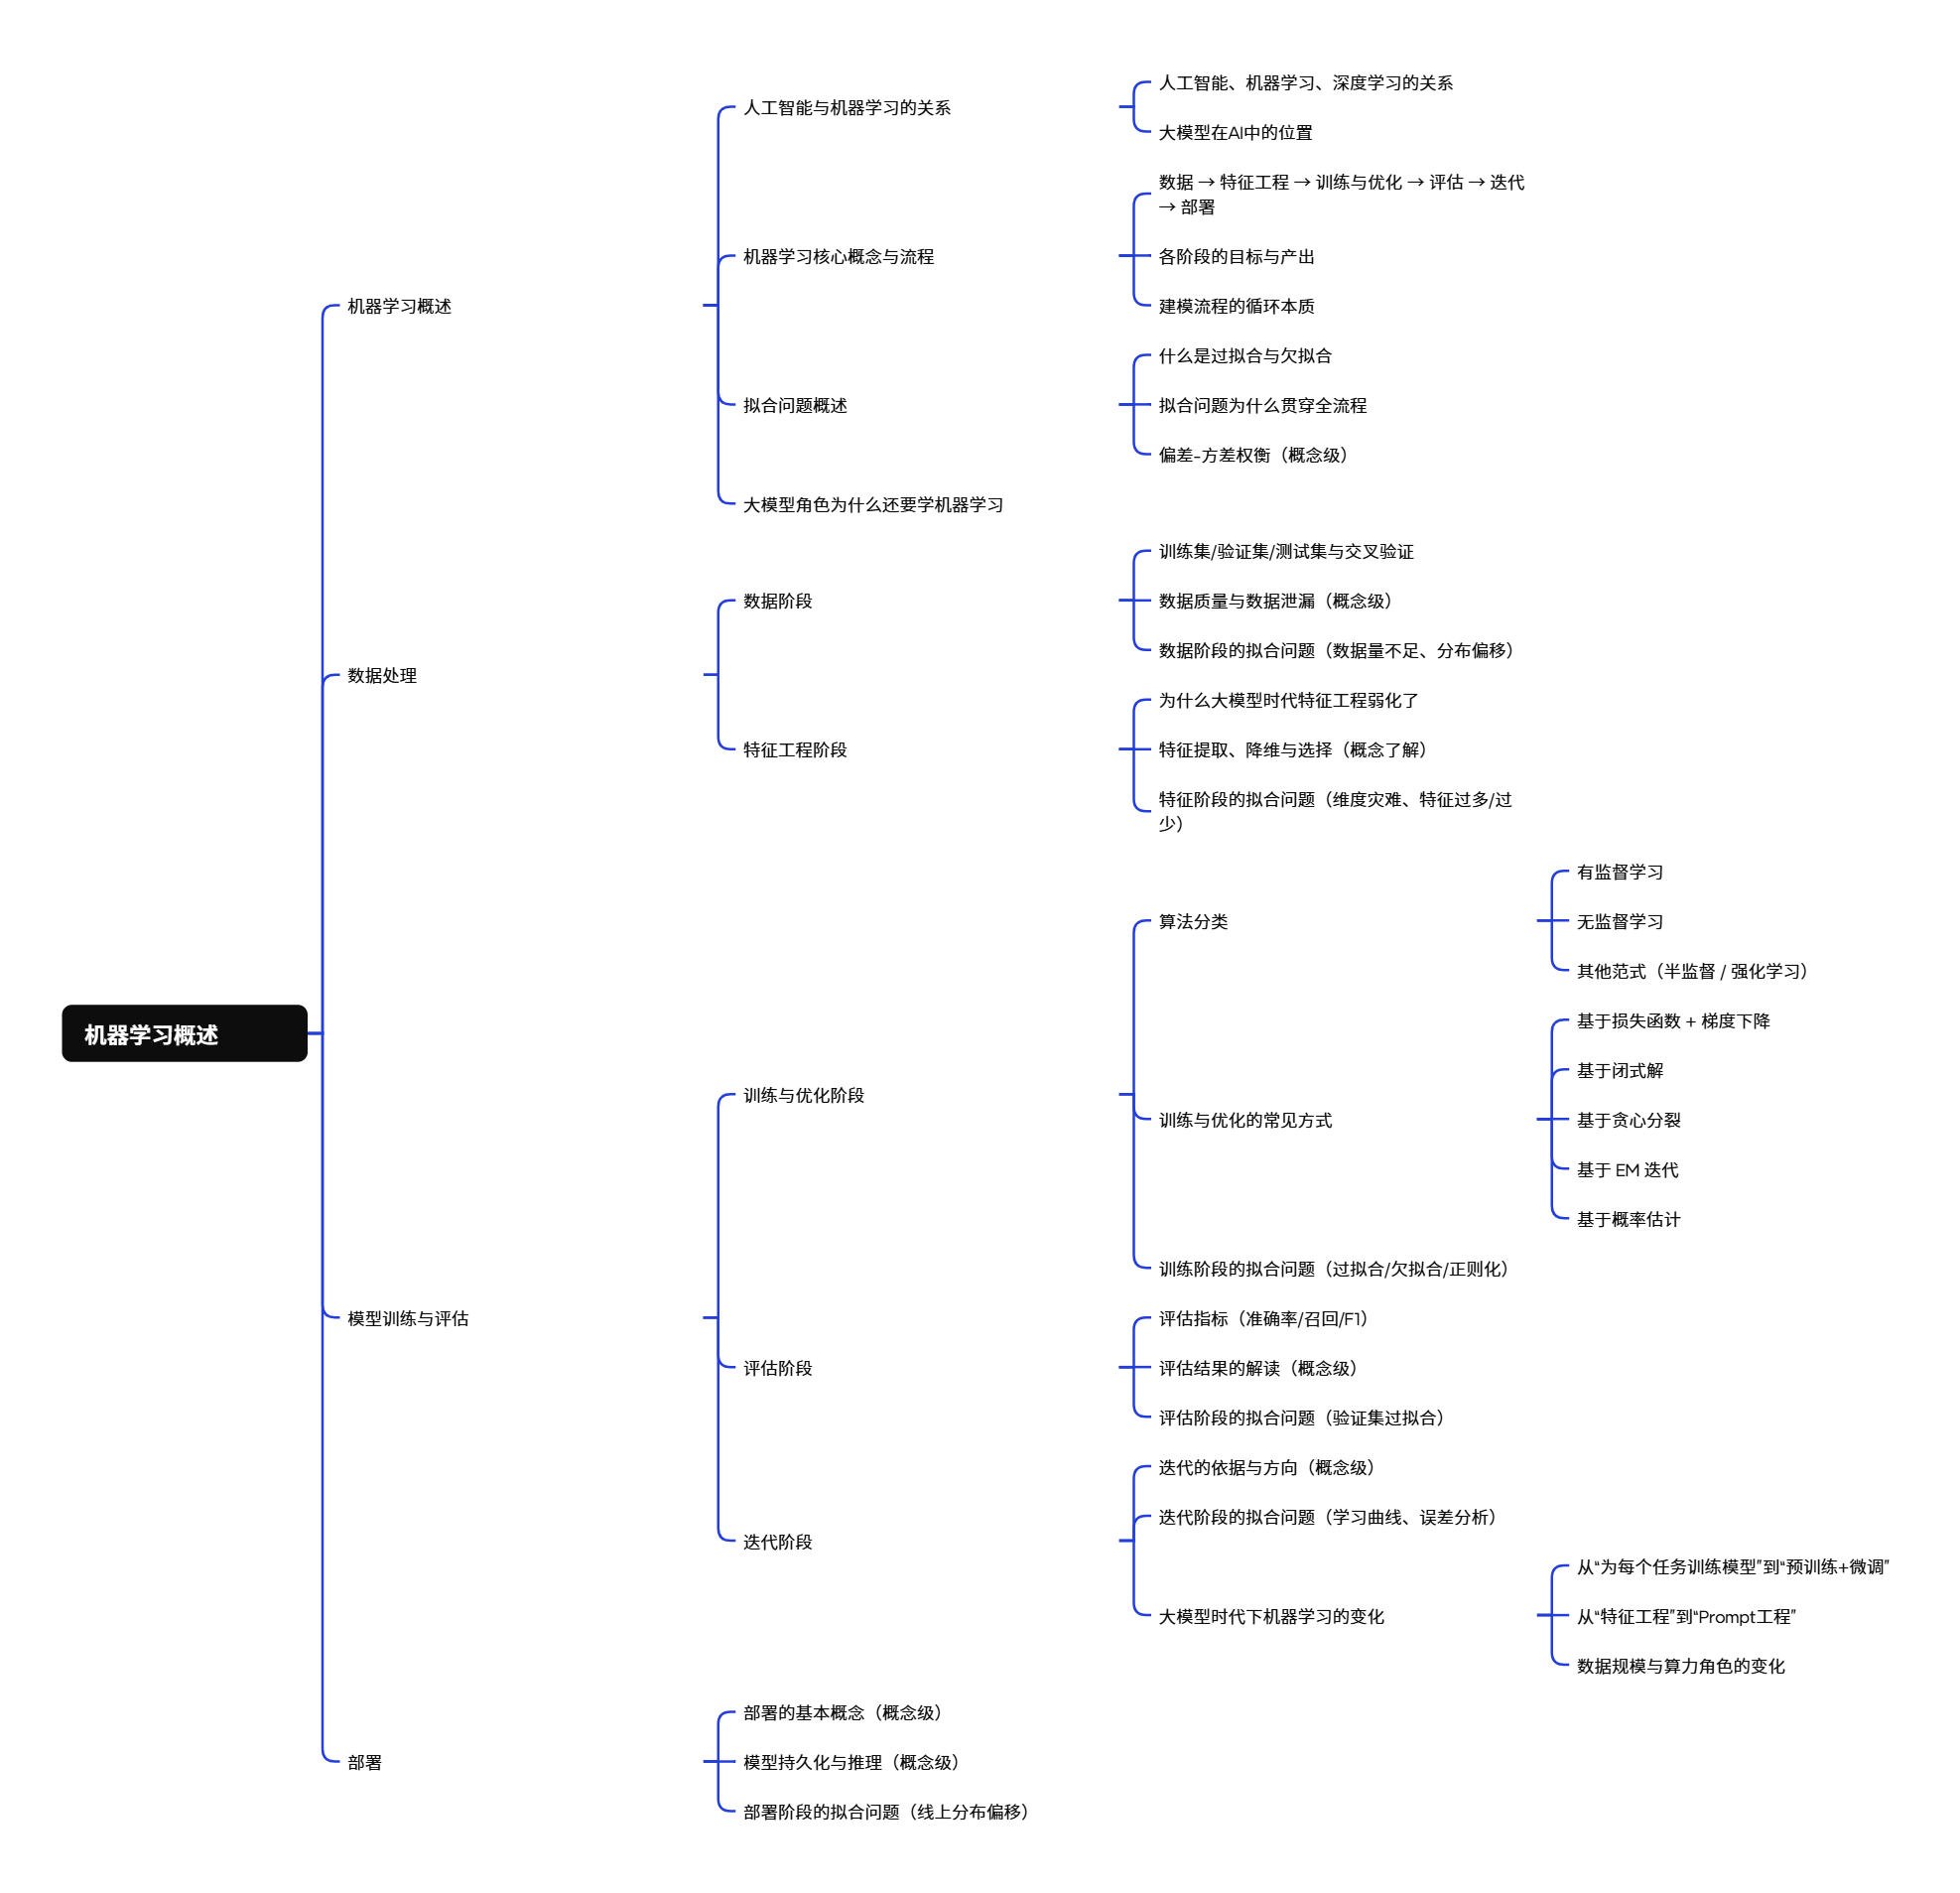
摘要:本文是机器学习模块的总览,旨在为后续算法章节建立全局认知。内容分为六部分:AI 与 ML 的关系明确人工智能、机器学习、深度学习、大模型的包含关系,理解大模型的定位;核心流程贯穿「数据 → 特征工程 → 训练与优化 → 评估 → 迭代 → 部署」六阶段,每个阶段有明确目标和产出,建模是循环迭代的过程;拟合问题是本章主线,介绍过拟合与欠拟合、偏差-方差权衡,并说明拟合问题贯穿数据、特征、训练、评估、迭代、部署全流程;数据处理涵盖训练/验证/测试集划分、交叉验证、数据质量与数据泄漏、特征工程;模型训练与评估介绍四种学习范式、五种优化方式训练阶段拟合问题与对策、迭代工具(学习曲线、误差分析);部署简述模型持久化、推理、线上分布偏移问题。
本章还重点讲解大模型时代的变化:从「为每个任务训练模型」到「预训练 + 微调」,从「特征工程」到「Prompt 工程」,数据规模与算力角色的转变。学完本章,应能理解机器学习的完整流程、核心概念(拟合问题、评估、迭代),为后续按算法分类学习打下基础。
目录
一、机器学习
1.1 机器学习概述
1.1.1 人工智能与机器学习的关系
1.1.2 机器学习核心概念与流程
1.1.3 拟合问题概述
1.1.4 大模型角色为什么还要学机器学习
1.2 数据处理
1.2.1 数据阶段
1.2.2 特征工程阶段
1.3 模型训练与评估
1.3.1 训练与优化阶段
1.3.2 评估阶段)
1.3.3 迭代阶段
1.4 部署
1.4.1 部署的基本概念(概念级)
1.4.2 模型持久化与推理(概念级)
1.4.3 部署阶段的拟合问题(线上分布偏移)
一、机器学习
1.1 机器学习概述
本章主要为讲解概念,实现再后续章节
1.1.1 人工智能与机器学习的关系
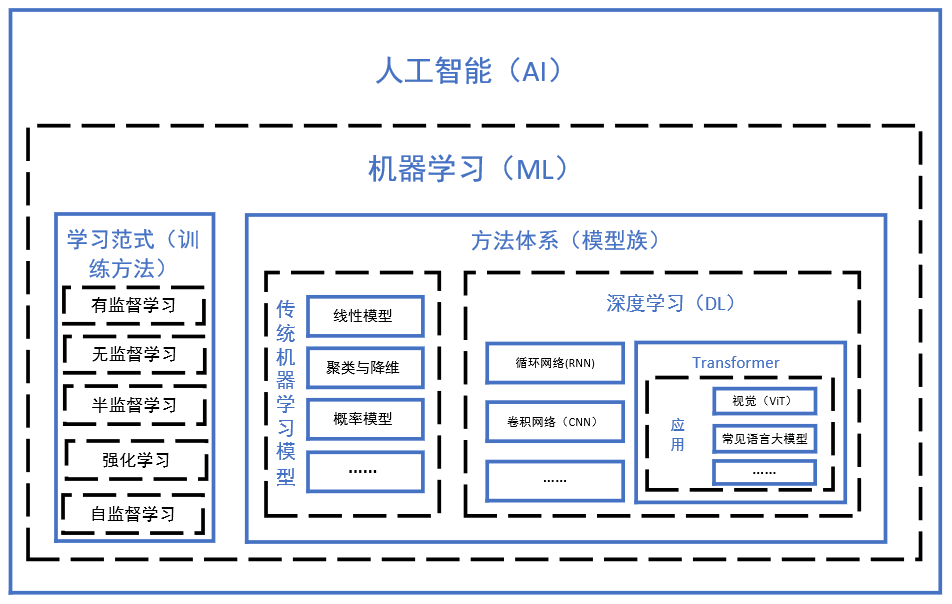
1.1.1.1 人工智能、机器学习、深度学习的关系
人工智能、机器学习、深度学习是层层包含的关系。
| 人工智能(AI) | 让机器模拟人类智能的统称 | 最大范畴 |
| 机器学习(ML) | 从数据中自动学习规律的方法 | AI 的子集 |
| 深度学习(DL) | 用神经网络自动提取特征的方法 | ML 的子集 |
1.1.1.2 大模型在AI中的位置
大模型(LLM)是深度学习的一个分支,基于 Transformer 架构,通过海量数据预训练获得通用能力。
1.1.2 机器学习核心概念与流程
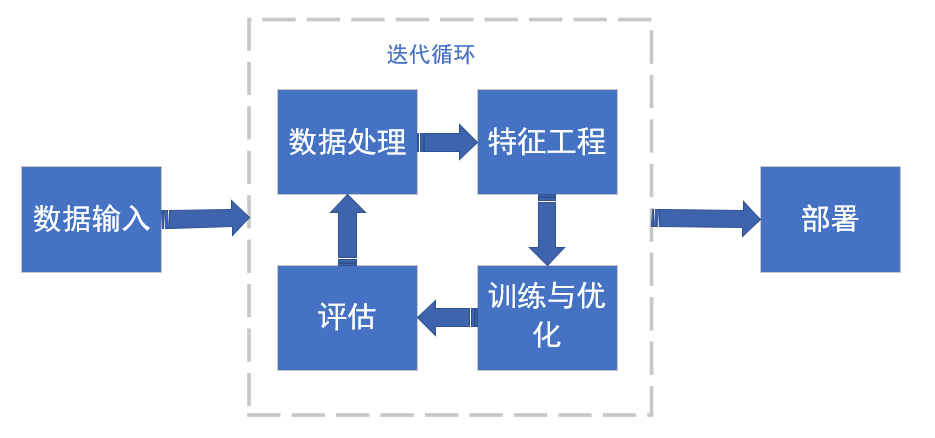
1.1.2.1 数据→ 特征工程 → 训练与优化 → 评估 → 迭代 → 部署
| 数据 | 获取、清洗、划分数据 |
| 特征工程 | 提取、选择、转换特征 |
| 训练与优化 | 学习模型参数 |
| 评估 | 衡量模型效果 |
| 迭代 | 优化模型 |
| 部署 | 上线服务 |
1.1.2.2 各阶段的目标与产出
每个阶段都有明确的目标和产出。
| 数据 | 获取高质量数据 | 训练集/验证集/测试集 |
| 特征工程 | 提取有效特征 | 特征矩阵 |
| 训练与优化 | 学习模型参数 | 训练好的模型 |
| 评估 | 衡量模型效果 | 评估指标(准确率、召回、F1) |
| 迭代 | 优化模型 | 改进的模型 |
| 部署 | 上线服务 | API / 服务 |
1.1.2.3 建模流程的循环本质
建模不是一次性的,而是循环迭代的过程。每个阶段都可能发现问题,回到前面的阶段重新调整。
| 数据量不足 | 数据阶段 |
| 特征无效 | 特征工程阶段 |
| 评估指标差 | 迭代阶段 |
| 线上效果差 | 数据 / 特征 / 训练阶段 |
1.1.3 拟合问题概述
1.1.3.1 什么是过拟合与欠拟合
拟合是指模型学习数据规律的过程。拟合问题分为两种:欠拟合(学得不够)和过拟合(学得过头)。
| 欠拟合 | 模型太简单,没学好 | 训练集和测试集都差 |
| 正常拟合 | 模型复杂度合适 | 训练集和测试集都好 |
| 过拟合 | 模型太复杂,学过头 | 训练集好,测试集差 |
举例1:学生备考
| 欠拟合 | 只背了课本目录 | 考试题稍微变化就不会 |
| 正常拟合 | 理解了知识点,能举一反三 | 考试题变化也能应对 |
| 过拟合 | 背了所有习题答案 | 遇到新题就不会 |
举例2:看图识物
| 欠拟合 | 只认识"有毛的是猫" | 遇到无毛猫就认不出 |
| 正常拟合 | 认识猫的特征(耳朵、胡须、体型) | 各种猫都能认出 |
| 过拟合 | 只认识自家那只猫 | 别人家的猫就认不出 |
举例3:预测房价
| 欠拟合 | 只看面积 | 预测不准 |
| 正常拟合 | 看面积、地段、楼层 | 预测较准 |
| 过拟合 | 看面积、地段、楼层、门牌号、房东姓名 | 训练数据准,新数据不准 |
1.1.3.2 拟合问题为什么贯穿全流程
拟合问题不只出现在训练阶段,而是贯穿数据、特征、训练、评估、迭代、部署全流程。
各阶段的拟合问题
| 数据 | 数据量不足、分布偏移 | 数据太少导致过拟合 |
| 特征 | 维度灾难、特征过多/过少 | 特征过多导致过拟合 |
| 训练 | 过拟合/欠拟合、正则化 | 模型复杂度问题 |
| 评估 | 验证集过拟合 | 反复调参导致验证集过拟合 |
| 迭代 | 学习曲线、误差分析 | 通过曲线判断拟合状态 |
| 部署 | 线上分布偏移 | 线上数据分布与训练不同 |
1.1.3.3 偏差-方差权衡
偏差(Bias) 和 方差(Variance) 是描述拟合问题的两个核心概念。
| 偏差 | 模型预测与真实值的偏离程度 | 欠拟合 |
| 方差 | 模型对不同数据的敏感程度 | 过拟合 |
1.1.4 大模型角色为什么还要学机器学习
大模型应用开发工程师的日常工作,是围绕大模型构建可上线的应用:选型与接入、提示工程、RAG、工具调用、微调适配、评估监控、成本与延迟优化。这些工作表面上“调 API 即可”,实际上每一步都涉及机器学习的基本概念与方法。学机器学习不是为了从头训练基座模型,而是为了在应用层做出可解释、可评估、可排障的工程决策。
1.2 数据处理
1.2.1 数据阶段
1.2.1.1 训练集/验证集/测试集与交叉验证
数据阶段的第一步是划分数据集:训练集、验证集、测试集,各有分工。
| 训练集 | 训练模型参数 | 60%~80% |
| 验证集 | 调参、选择模型 | 10%~20% |
| 测试集 | 最终评估 | 10%~20% |
1.2.1.2 数据质量与数据泄漏
数据质量和数据泄漏是数据阶段的两大核心问题。
数据质量
| 缺失值 | 数据不完整 | 模型无法训练 |
| 异常值 | 数据偏离正常范围 | 模型偏差 |
| 噪声 | 数据随机误差 | 模型不稳定 |
| 不一致 | 数据格式不统一 | 处理困难 |
数据泄漏
数据泄漏是指训练时用到了测试时不可用的信息,导致评估结果虚高。
| 目标泄漏 | 特征包含目标信息 | 用"是否违约"预测"是否违约" |
| 时间泄漏 | 用了未来数据 | 用未来数据预测过去 |
| 预处理泄漏 | 预处理用了全部数据 | 归一化时用了测试集 |
1.2.1.3 数据阶段的拟合问题(数据量不足、分布偏移)
数据阶段的两大拟合问题:数据量不足和分布偏移。
数据量不足
| 数据太少 | 样本数量不足 | 模型学到噪声 → 过拟合 |
| 类别不平衡 | 某类样本过少 | 模型偏向多数类 |
分布偏移
| 协变量偏移 | 输入分布变化 | 训练集是年轻人,测试集是老年人 |
| 标签偏移 | 标签分布变化 | 训练集正负样本 1:1,测试集 1:9 |
| 概念偏移 | 输入与标签关系变化 | 用户偏好随时间变化 |
1.2.2 特征工程阶段
| 特征Feature | 描述样本属性的输入变量,是模型用来做判断的依据。通常是表格中的列(除标签列外)。特征工程就是对这部分数据做加工。 | 预测房价时:房屋面积、所在城市、房间数、房龄识别图片时:像素值、颜色分布、边缘信息 |
| 标签Label | 样本的真实答案 / 目标输出,是模型最终要预测的结果。有标签 → 监督学习;无标签 → 无监督学习。 | 预测房价时:实际成交价格(万元)垃圾邮件识别时:是垃圾邮件 / 不是垃圾邮件 |
| 样本Sample | 一条完整的数据记录,由「一组特征 + 对应标签」组成。通常是表格中的一行。所有样本合在一起构成数据集。 | 一条样本:特征 = {面积: 100㎡, 城市:杭州,房间数: 3}标签 = {房价: 300 万} |
1.2.2.1 为什么大模型时代特征工程弱化了
传统机器学习需要人工提取特征,而大模型通过自动特征提取(深度学习)大幅弱化了特征工程的重要性。
传统 ML vs 大模型
| 特征提取 | 人工设计 | 自动提取 |
| 特征工程 | 核心工作 | 大幅弱化 |
| Prompt 工程 | — | 新的"特征工程" |
| 典型工作 | 提取、选择、转换特征 | 设计 Prompt |
1.2.2.2 特征提取、降维与选择
特征工程包括五个核心操作:特征提取、特征组合、特征预处理、降维、特征选择。
| 特征提取 | 从原始数据中提取特征 | 将原始数据转为特征 |
| 特征组合 | 组合多个特征生成新特征 | 增强特征表达能力 |
| 特征预处理 | 标准化、归一化、编码 | 统一特征尺度 |
| 降维 | 减少特征数量 | 避免维度灾难 |
| 特征选择 | 选择有效特征 | 去除无关特征 |
① 特征提取
说明: 从原始数据中提取特征。
常见方法:
| 文本 | 词袋、TF-IDF、Word2Vec |
| 图片 | 边缘、颜色、纹理 |
| 数值 | 直接使用 |
② 特征组合
说明: 组合多个特征生成新特征,增强表达能力。
常见方法:
| 算术组合 | 加减乘除 | A + B、A * B |
| 交叉组合 | 类别交叉 | 城市_月份 |
| 多项式组合 | 多项式特征 | A²、A × B |
说明: 特征组合可以增强模型表达能力,但也可能引入噪声。
③ 特征预处理
说明: 统一特征尺度,使模型更好地学习。
| 标准化 | 均值为 0,标准差为 1 | 大多数模型 |
| 归一化 | 缩放到 [0, 1] | 神经网络 |
| 独热编码 | 类别转 0/1 向量 | 类别特征 |
| 标签编码 | 类别转整数 | 有序类别 |
说明: 特征预处理是特征工程的重要步骤,统一尺度有助于模型收敛。
④ 降维
说明: 减少特征数量,避免维度灾难。
常见方法:
| PCA | 主成分分析,线性降维 |
| t-SNE | 非线性降维,可视化 |
⑤ 特征选择
说明: 选择有效特征,去除无关特征。
常见方法:
| 方差选择 | 去除方差小的特征 |
| 卡方检验 | 选择与目标相关的特征 |
| 递归特征消除 | 递归去除不重要特征 |
注意:以上为五个方法而非五个步骤,即没有先后顺序之分与使用次数限制,根据实际场景随意排列组合
1.2.2.3 特征阶段的拟合问题(维度灾难、特征过多/过少)
特征阶段的两大拟合问题:维度灾难和特征过多/过少。
维度灾难
核心描述: 特征维度太高时,数据变得稀疏,模型难以学习。
影响:
| 数据稀疏 | 高维空间数据稀疏 |
| 距离失效 | 高维空间中距离不再有效 |
| 过拟合 | 特征太多,模型学到噪声 |
特征过多/过少
| 特征过多 | 无关特征太多 | 过拟合 |
| 特征过少 | 有效特征不足 | 欠拟合 |
1.3 模型训练与评估
传统机器学习算法按学习方式分为四大类:有监督学习、无监督学习、半监督/强化学习。(深度学习在此不做说明)
| 有监督学习 | 有标签 | 学习输入→输出映射 | 逻辑回归、决策树、SVM |
| 无监督学习 | 无标签 | 发现数据内在结构 | K-Means、PCA |
| 半监督学习 | 部分标签 | 利用少量标签+大量无标签 | — |
| 强化学习 | 无标签,有奖励 | 通过试错学习策略 | Q-Learning |
1.3.1 训练与优化阶段
1.3.1.1 算法分类
① 有监督学习
有监督学习是有标签的学习方式,模型学习输入到输出的映射。
| 数据 | 有标签(输入 + 输出) |
| 目标 | 学习映射关系 |
| 任务 | 分类、回归 |
| 评估 | 准确率、召回、F1、MSE |
常见算法
| 分类 | 逻辑回归、决策树、随机森林、KNN、朴素贝叶斯、SVM、XGBoost |
| 回归 | 线性回归、多项式回归、岭回归、Lasso、GBDT、XGBoost |
应用场景
| 垃圾邮件分类 | 邮件 → 垃圾/正常 |
| 房价预测 | 房屋特征 → 价格 |
| 图像分类 | 图片 → 类别 |
| 情感分析 | 文本 → 情感 |
② 无监督学习
无监督学习是无标签的学习方式,模型发现数据的内在结构。
| 数据 | 无标签 |
| 目标 | 发现数据内在结构 |
| 任务 | 聚类、降维、异常检测 |
| 评估 | 轮廓系数、可视化 |
常见算法
| 聚类 | K-Means、DBSCAN、层次聚类 |
| 降维 | PCA、t-SNE |
| 异常检测 | 孤立森林 |
应用场景
| 用户分群 | 根据行为聚类 |
| 数据降维 | 高维数据可视化 |
| 异常检测 | 发现异常数据 |
③ 其他范式(半监督 / 强化学习/自监督)
半监督学习
核心描述: 结合少量标签数据和大量无标签数据。
| 数据 | 少量标签 + 大量无标签 |
| 目标 | 利用无标签数据提升效果 |
| 场景 | 标注成本高时 |
强化学习
核心描述: 通过试错和奖励学习策略。
| 数据 | 无标签,有奖励信号 |
| 目标 | 学习最优策略 |
| 场景 | 游戏 AI、机器人控制 |
自监督学习
核心描述: 从无标签数据自身构造监督信号,让模型自己“出题自己解”,学习通用表征。
| 数据 | 完全无标签,无需人工标注(监督信号由数据内部生成) |
| 目标 | 学习可迁移的通用表征,为下游任务提供良好初始化 |
| 场景 | 大规模无标注数据预训练(如 NLP、CV 基础模型),标注昂贵或下游任务多样时 |
1.3.1.2 训练与优化的常见方式
机器学习的训练与优化有五种常见方式,不同算法采用不同方式。
| 损失函数 + 梯度下降 | 最小化损失函数 | 线性回归、逻辑回归、神经网络 |
| 闭式解 | 直接求解最优参数 | 线性回归(最小二乘) |
| 贪心分裂 | 逐步选择最优分裂 | 决策树、随机森林 |
| EM 迭代 | 交替估计隐变量和参数 | 高斯混合模型 |
| 概率估计 | 基于统计估计概率 | 朴素贝叶斯 |
① 基于损失函数
损失函数
损失函数衡量模型预测与真实值的差距,梯度下降通过迭代更新参数,使损失最小化。
常用公式:
| 均方误差 MSE / L2 | 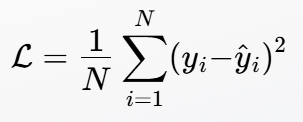 |
对异常值敏感;高斯噪声假设下的 MLE |
| 平均绝对误差 MAE / L1 | 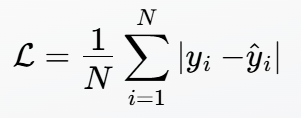 |
对异常值鲁棒;拉普拉斯噪声假设 |
| Huber 损失 | 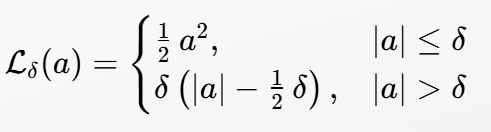 |
小误差像 MSE,大误差像 MAE |
| 0-1 损失 | 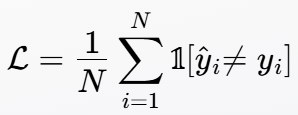 |
直接对应错误率;不可导,一般只作评价指标 |
| Hinge 损失 | 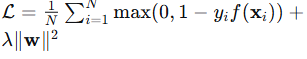 |
SVM;yi∈{−1,+1}yi∈{−1,+1} |
| 多分类交叉熵 | 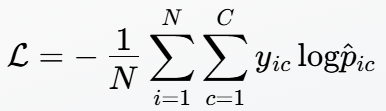 |
Softmax 回归;深度学习分类标配 |
注意:损失函数中使用的公式部分再评估指标时也会使用,但需严格注意这只是公式再不同情况下的使用,并非用损失函数做评估指标
下面给出两者求解损失函数最小值的方法:
梯度下降(Gradient Descent)
梯度下降法主要是用来求解优化问题的,具体来说,是求解目标函数的最小值(或最大值)。在机器学习中,最常见的就是最小化损失函数,从而得到模型的最优参数。
梯度下降(Gradient Descent)的核心公式非常简洁:
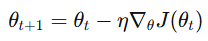
其中:
-
θt:第 t 步的模型参数(可以是向量,如权重 w和偏置 b)
-
η:学习率(learning rate),控制步长
-
J(θ):损失函数(目标函数)
-
∇θJ(θt):损失函数在当前参数处的梯度,即损失函数在当前位置的偏导(偏导数具体查阅高等数学的多元函数)
-
θt+1:更新后的参数
梯度下降变体
| 批量梯度下降(BGD) | 用全部数据计算梯度 | 稳定,但慢 | 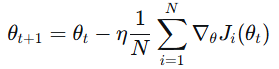 |
| 随机梯度下降(SGD) | 用单条数据计算梯度 | 快,但震荡 | 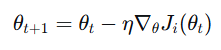 |
| 小批量梯度下降(Mini-batch) | 用小批量数据 | 平衡 | 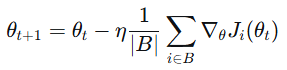 |
② 基于闭式解
闭式解是直接通过数学公式求解最优参数,无需迭代。
优缺点
| 一步到位 | 需要矩阵求逆 |
| 无学习率 | 计算复杂度高(O(n³)) |
| 精确解 | 特征多时慢 |
代表算法
| 线性回归 | 最小二乘 |
| 岭回归 | 加正则项的闭式解 |
说明: 闭式解也常用来求解损失函数,闭解式适合特征少的场景,特征多时用梯度下降。
③ 基于贪心分裂
贪心分裂是决策树的核心优化方式:每一步选择当前最优的分裂点,逐步构建树。
分裂准则
| 信息增益 | 熵的减少量 | ID3 |
| 信息增益率 | 信息增益 / 分裂信息 | C4.5 |
| 基尼指数 | 基尼不纯度 | CART |
代表算法
| 决策树 | ID3、C4.5、CART |
| 随机森林 | 多棵树集成 |
| GBDT / XGBoost | 梯度提升树 |
说明: 贪心分裂是树模型的核心,后续决策树章节详细说明。
④ 基于 EM 迭代
EM(Expectation-Maximization) 用于含隐变量的概率模型:交替执行 E 步和 M 步,逐步逼近最优参数。
代表算法
| 高斯混合模型(GMM) | 软聚类 |
| 隐马尔可夫模型(HMM) | 序列建模 |
说明: EM 适合含隐变量的场景,了解即可。
⑤ 基于概率估计
概率估计基于统计方法直接估计概率分布,无需迭代优化。
代表算法
| 朴素贝叶斯 | 基于贝叶斯公式 |
| 贝叶斯网络 | 概率图模型 |
说明: 概率估计适合文本分类等场景,后续朴素贝叶斯章节详细说明。
1.3.1.3 训练阶段的拟合问题
训练阶段是拟合问题最集中的阶段,核心表现为过拟合和欠拟合。训练阶段的目标是找到模型复杂度的平衡点。
| 欠拟合 | 训练误差高,测试误差高 | 模型太简单、训练不足 |
| 过拟合 | 训练误差低,测试误差高 | 模型太复杂、训练过度 |
训练阶段的拟合问题来源
| 模型复杂度 | 参数太多/太少 | 过拟合/欠拟合 |
| 训练轮数 | 训练太久/太短 | 过拟合/欠拟合 |
| 学习率 | 太大/太小 | 震荡/收敛慢 |
| 数据量 | 数据太少 | 过拟合 |
| 特征数量 | 特征太多/太少 | 过拟合/欠拟合 |
常见对策:
正则化
模型太复杂时,会把训练数据里的噪声也当成规律记住,导致训练误差很低但测试误差很高,这就是过拟合。正则化减少这些异常值的影响(降低权重)。
注:调整时候,算法并不知道某个特征影响,而是去调整参数得出优化的解
| L1 正则化 | L + λ·Σ|θ| | 稀疏解,特征选择 |
| L2 正则化 | L + λ·Σθ² | 平滑解,防止过拟合 |
数学形式
一般形式:
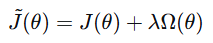
其中:
-
J(θ):原始损失函数
-
Ω(θ):正则项(惩罚项)
-
λ:正则化强度,控制惩罚大小
常见正则项:
| L1 | 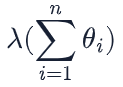 |
特征选择,约束区域是菱形,最优解容易落在坐标轴上(权重为0),所以产生稀疏解。 |
| L2 | 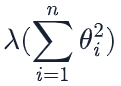 |
平滑解,权重收缩,约束区域是圆形,最优解一般不在坐标轴上,所以权重平滑收缩。 |
| 弹性网 | 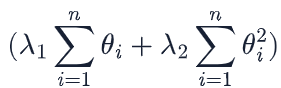 |
兼顾稀疏与平滑 |
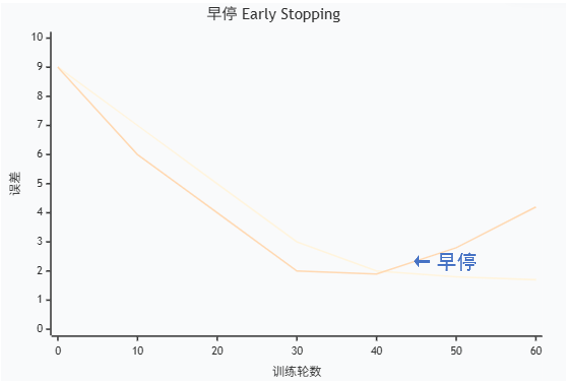
早停(Early Stopping)
在验证集误差开始上升时提前停止训练。
数据增强
通过变换数据增加训练样本,缓解过拟合。
| 图像 | 旋转、翻转、裁剪 |
| 文本 | 同义词替换、回译 |
| 数值 | 加噪声、插值 |
交叉验证
用交叉验证评估模型,避免验证集过拟合。
全部数据分成 5 份:
┌────┬────┬────┬────┬────┐
│ 1 │ 2 │ 3 │ 4 │ 5 │
└────┴────┴────┴────┴────┘
第1折:验证集=1,训练集=2+3+4+5
第2折:验证集=2,训练集=1+3+4+5
第3折:验证集=3,训练集=1+2+4+5
第4折:验证集=4,训练集=1+2+3+5
第5折:验证集=5,训练集=1+2+3+4
1.3.2 评估阶段
1.3.2.1 评估指标(准确率/召回/F1)
分类任务的评估指标主要有:准确率(Accuracy)、精确率(Precision)、召回率(Recall)、F1 分数。
混淆矩阵
| 实际正 | TP(真正例) | FN(假负例) |
| 实际负 | FP(假正例) | TN(真负例) |
说明:
- 真实值是 正例 的样本中,被分类为 正例 的样本数量有多少,叫做真正例(TP,True Positive)
- 真实值是 正例 的样本中,被分类为 假例 的样本数量有多少,叫做伪反例(FN,False Negative)
- 真实值是 假例 的样本中,被分类为 正例 的样本数量有多少,叫做伪正例(FP,False Positive)
- 真实值是 假例 的样本中,被分类为 假例 的样本数量有多少,叫做真反例(TN,True Negative)
四个核心指标
| 准确率(Accuracy) | (TP + TN) / (TP + TN + FP + FN) | 预测正确的比例 |
| 精确率(Precision) | TP / (TP + FP) | 预测为正的样本中,实际为正的比例 |
| 召回率(Recall) | TP / (TP + FN) | 实际为正的样本中,被正确预测的比例 |
| F1 分数 | 2 × P × R / (P + R) | 精确率和召回率的调和平均 |
指标选择
| 类别平衡 | 准确率 | 整体表现 |
| 误报代价高 | 精确率 | 宁缺毋滥(如垃圾邮件) |
| 漏报代价高 | 召回率 | 宁可错杀(如疾病检测) |
| 综合 | F1 | 平衡精确率和召回率 |
说明: 准确率在类别不平衡时可能失真(如 99% 负样本,全预测负也有 99% 准确率)。
1.3.2.3 评估阶段的拟合问题(验证集过拟合)
验证集过拟合是指反复用验证集调参,导致模型在验证集上表现好,但测试集上表现差。
| 限制调参次数 | 减少对验证集的依赖 |
| 交叉验证 | 用交叉验证替代单一验证集 |
| 独立测试集 | 测试集只用一次 |
| 增加数据 | 更多数据减少过拟合 |
1.3.3 迭代阶段
1.3.3.1 迭代的依据与方向(概念级)
迭代是建模流程的循环核心,根据评估结果决定下一步优化方向。
迭代依据
| 训练误差 | 模型在训练集上的表现 | 高 → 欠拟合 |
| 验证误差 | 模型在验证集上的表现 | 高 → 过拟合或欠拟合 |
| 学习曲线 | 误差随数据量/训练轮数的变化 | 判断拟合状态 |
| 误差分析 | 分析错误样本 | 找出改进方向 |
迭代方向
| 欠拟合 | 增加模型复杂度、增加特征 |
| 过拟合 | 正则化、增加数据、简化模型 |
| 验证集过拟合 | 交叉验证、独立测试集 |
| 数据问题 | 回到数据阶段 |
说明: 迭代不是盲目调参,而是基于评估结果有方向地优化。
1.3.3.2 迭代阶段的拟合问题(学习曲线、误差分析)
迭代阶段的两大工具:学习曲线和误差分析。
学习曲线
核心描述: 学习曲线展示训练误差和验证误差随数据量或训练轮数的变化,用于判断拟合状态。
误差分析
核心描述: 分析错误样本,找出模型的薄弱环节。
| 错误类型 | 哪些类别容易错 |
| 错误模式 | 错误样本的共同特征 |
| 错误分布 | 错误是否集中在某区域 |
| 改进方向 | 根据错误找优化点 |
1.3.3.3 大模型时代下机器学习的变化
① 从"为每个任务训练模型"到"预训练+微调"
核心描述: 传统 ML 为每个任务单独训练模型,大模型通过预训练 + 微调解决多任务。
变化:
| 训练方式 | 从头训练 | 预训练 + 微调 |
| 模型数量 | 每任务一个 | 一个模型多任务 |
| 数据需求 | 任务数据 | 海量预训练数据 |
| 开发成本 | 高 | 低 |
② 从"特征工程"到"Prompt 工程"
核心描述: 传统 ML 需要人工设计特征,大模型通过Prompt 设计引导模型输出。
变化:
| 核心工作 | 特征工程 | Prompt 工程 |
| 人工介入 | 提取特征 | 设计 Prompt |
| 自动化程度 | 低 | 高 |
| 门槛 | 高 | 低 |
③ 数据规模与算力角色的变化
核心描述: 大模型时代,数据规模和算力成为核心竞争力。
对比:
| 数据规模 | 中小规模 | 海量(TB~PB) |
| 算力需求 | 低(CPU) | 高(GPU 集群) |
| 算力角色 | 次要 | 核心 |
| 训练时间 | 分钟~小时 | 天~月 |
| 成本 | 低 | 高 |
1.4 部署
1.4.1 部署的基本概念(概念级)
部署是将训练好的模型上线到生产环境,对外提供服务的过程。
部署的核心环节
| 模型持久化 | 保存训练好的模型 |
| 模型加载 | 在生产环境加载模型 |
| 推理服务 | 接收请求,返回预测 |
| 监控 | 监控线上表现 |
| 更新 | 模型迭代后重新部署 |
常见部署方式
| 本地部署 | 模型在本地运行 | 小规模、隐私要求高 |
| API 服务 | 模型封装为 API | Web 应用 |
| 云服务 | 部署到云平台 | 大规模、弹性扩展 |
| 边缘部署 | 部署到设备 | 低延迟、离线 |
说明: 部署是模型从实验室到生产的关键一步。
1.4.2 模型持久化与推理(概念级)
模型持久化是保存模型,推理是用模型预测新数据。
模型持久化
| Pickle | Python 原生序列化 | .pkl |
| Joblib | 适合大模型 | .joblib |
| ONNX | 跨平台格式 | .onnx |
| SavedModel | TensorFlow 格式 | 目录 |
模型推理
核心描述: 推理是用训练好的模型对新数据进行预测。
推理优化
| 批处理 | 批量推理,提升吞吐 |
| 量化 | 降低精度,减少计算 |
| 蒸馏 | 小模型替代大模型 |
| 缓存 | 缓存常见请求结果 |
说明: 推理优化是大模型部署的核心挑战。
1.4.3 部署阶段的拟合问题(线上分布偏移)
线上分布偏移是指线上数据分布与训练数据分布不一致,导致模型效果下降。
问题来源
| 协变量偏移 | 输入分布变化 | 训练集是年轻人,线上是老年人 |
| 标签偏移 | 标签分布变化 | 训练集正负 1:1,线上 1:9 |
| 概念偏移 | 输入与标签关系变化 | 用户偏好随时间变化 |


评论前必须登录!
注册